التفضيلات
خصوصيتك مهمة بالنسبة لنا، لذلك لديك خيار تعطيل أنواع معينة من التخزين التي قد لا تكون ضرورية للوظائف الأساسية للموقع. قد يؤثر حظر الفئات على تجربتك في الموقع. مزيد من المعلومات
خصوصيتك مهمة بالنسبة لنا، لذلك لديك خيار تعطيل أنواع معينة من التخزين التي قد لا تكون ضرورية للوظائف الأساسية للموقع. قد يؤثر حظر الفئات على تجربتك في الموقع. مزيد من المعلومات

لماذا تتغير إجابات بحث الذكاء الاصطناعي في كل تشغيل، وبأي مقدار تتحرك، وكيف تقيس حضور علامتك عبر الأسئلة بدل مطاردة ترتيب واحد.
أدوات

باختصار
تقلّب بحث الذكاء الاصطناعي هو مدى تغيّر العلامات التجارية والروابط وترتيبها في إجابة الذكاء الاصطناعي من تشغيل إلى آخر، ومن أسبوع إلى آخر. قد يعيد السؤال نفسه قائمة علامات مختلفة واستشهادات مختلفة وترتيبًا مختلفًا، لأن الإجابة تُولَّد بعنصر عشوائي وخطوة الاسترجاع تتغير أيضًا. لذلك لا يصلح موقع العلامة داخل الإجابة مقياسًا جيدًا. قِس عدد مرات ظهور علامتك عبر عدد كبير من الأسئلة وعدد كبير من التشغيلات، ثم ابنِ المصادر التي تجعل حضورها ثابتًا.
هل تريد التعمق أكثر؟ اسأل
اختبار سريع
كيف تجعل ChatGPT وأدوات الذكاء الاصطناعي الأخرى تذكرك؟
Sorank يناسب إجاباتك


جرّبه 3 أيام على موقعك واعرف أين تقف في Google وChatGPT وأدوات الذكاء الاصطناعي الأخرى.
ابدأ تجربة مجانية لمدة 3 أيام3 أيام مجانًا، ثم توقف متى شئت. ضمان النتائج لمدة 90 يومًا، تطبق الشروط.
في البحث العضوي في Google، يعني التقلّب أن ترتيب موقعك لكلمة مفتاحية يصعد ويهبط. أما في بحث الذكاء الاصطناعي فالأمر أوسع من ذلك. الإجابة نفسها تختلف في كل تشغيل. وقد تتغيّر الإجابة المتقلّبة بثلاث طرق: العلامات التجارية التي تذكرها، والروابط التي تستشهد بها، والترتيب الذي تعرضها به. ويمكن أن يتغيّر أيٌّ منها دون أي تعديل على موقعك.
الفرق مهم لأن الترتيب في البحث التقليدي مخرج ثابت لحظة معينة. فـ Google تعيد قائمة مرتبة، وفي السوق نفسه للسؤال نفسه تكون هذه القائمة قابلة للتكرار في معظم الأحيان. أما نموذج الذكاء الاصطناعي فيعيد عينة واحدة من مجموعة إجابات محتملة. ولعلامتك احتمال بأن تظهر ضمن هذه المجموعة. وهذا الاحتمال هو ما يمكنك قياسه، وهو ما يمكنك تحسينه.
تُظهر رقمان من دراسة نُشرت في عام 2026 حجم هذا التأثير. عمل Rand Fishkin من SparkToro مع Patrick O'Donnell من Gumshoe.ai. شارك نحو 600 متطوع في تشغيل 12 سؤالًا عبر ChatGPT و Claude وذكاء Google الاصطناعي، بإجمالي 2961 تشغيلًا. ووجد الباحثون أن فرصة حصول ChatGPT أو ذكاء Google الاصطناعي على قائمة العلامات نفسها مرتين أقل من 1 من كل 100. وكانت فرصة تكرار القائمة نفسها بالترتيب نفسه نحو 1 من كل 1000 تشغيل. يغطي تقرير SparkToro، المنشور بتاريخ 28 يناير 2026، بيانات جُمعت في نوفمبر وديسمبر 2025.
ما مدى ثبات قوائم العلامات في الذكاء الاصطناعي؟
المصدر: SparkToro و Gumshoe.ai، يناير 2026
بعد أن تقبل أن المخرج عينة، يجب أن يتغير أسلوب التتبع. المقارنة أدناه تلخص العقليتين، وهي الفكرة الأساسية في هذا الدليل كله.
تتبّع ترتيب واحد مقابل تتبّع الحضور
أوضح تغيير هو قائمة العلامات نفسها. قد يذكر سؤال مثل "أفضل أداة لإدارة المشاريع لفريق من 10 أشخاص" خمس علامات في تشغيل، ثم خمس علامات مختلفة في التشغيل التالي. بعض العلامات تعود كثيرًا، وأخرى تدخل القائمة وتخرج منها. الحضور داخل المجموعة أكثر ثباتًا من الموقع داخلها، ولهذا ينصح الباحثون بتتبّع الحضور لا الترتيب.
لهذا أثر عملي. إذا فحصت سؤالًا مرة واحدة ورأيت علامتك في المركز الثاني، فأنت لا تعرف الكثير. أما إذا فحصته 60 مرة ورأيت علامتك في 40 إجابة، فهذا يعني شيئًا مفيدًا: أنت خيار متكرر لهذا السؤال.
الاستشهادات هي الروابط التي يعرضها نموذج الذكاء الاصطناعي كمصادر. وتتحرك أكثر من قائمة العلامات عندما يُجري النموذج بحثًا مباشرًا على الويب، لأن كل تشغيل قد يسترجع مجموعة مختلفة من الصفحات. وخسارة استشهاد لا تعني دائمًا خسارة حقيقية. فقد تبقى علامتك مذكورة في النص دون رابط. لذلك يجب أن تتبع أمرين منفصلين: الذكر المسمّى والرابط المستشهد به.
موقع العلامة داخل الإجابة هو العنصر الأقل ثباتًا. قد يضع نموذج الذكاء الاصطناعي علامتك أولًا في تشغيل، ورابعة في التشغيل التالي، دون أي تغيير حقيقي في طريقة رؤيته لك. عامل الترتيب كضجيج ما لم يتحرك في اتجاه واحد عبر عشرات التشغيلات.
ثلاث آليات تقود معظم التغيير. لا يمكنك إيقافها، لكن معرفتها تخبرك بما تقيسه وما تتجاهله.
لا يختار نموذج اللغة إجابة واحدة هي الأفضل. إنه يختار كل كلمة تالية من توزيع احتمالي. وإعداد اسمه درجة الحرارة (temperature) يحدد مدى اتساع هذا الاختيار. عند قيمة منخفضة يقترب الناتج من التكرار، وعند قيمة مرتفعة يتنوع أكثر. يمكن للمطورين ضبط درجة الحرارة عبر الواجهة البرمجية، لكن تطبيقات المستهلك التي يستخدمها معظم مشتريك لا تعرضها. افترض أن أخذ العينات يعمل دائمًا. وقد أبقى متطوعو SparkToro إعداداتهم المعتادة، المخصصة أو الافتراضية، ولهذا تصف نتائجهم ما يراه المستخدم العادي.
عندما يبحث نموذج الذكاء الاصطناعي في الويب، لا يرسل سؤالك الحرفي إلى محرك بحث. بل يعيد صياغة السؤال إلى عدة استعلامات فرعية، ويسترجع صفحات لكل واحد منها. تغيير بسيط في الصياغة، أو صفحة فهرسها Google ذلك الصباح، أو نتيجة مختلفة لاستعلام فرعي واحد، كلها قد تغيّر المصادر التي تصل إلى الإجابة النهائية. والروابط التي تُستشهد بها هي نتاج خطوة استرجاع تتحرك. يشرح دليلنا عن كيف تختار نماذج الذكاء الاصطناعي مصادرها الآلية، ومتتبّع Sorank لما يبحث عنه الذكاء الاصطناعي فعلًا مصمَّم للإجابة عن هذا السؤال بالضبط.
تحدّث الجهات المزودة نماذجها والأنظمة المحيطة بها دون إشعار كبير. نسخة جديدة من النموذج، أو تغيير في الوقت الذي يقرر فيه النموذج البحث، أو تحول في فهرس الويب، كلها قد تغيّر الإجابات في موضوع كامل في يوم واحد. وعندما تُظهر بياناتك قفزة مفاجئة، تحقق أولًا من تحديث محتمل، ثم قارن بخط الأساس قبل أن تتصرف.
| الآلية | ما الذي يتحرك | كيف تظهر | ما الذي تفعله |
|---|---|---|---|
| أخذ العينات | قائمة العلامات والصياغة والترتيب | إجابات مختلفة للسؤال نفسه في اليوم نفسه | قِس عبر تشغيلات كثيرة وأبلغ عن نسبة |
| الاسترجاع | الروابط المستشهد بها | مصادر مختلفة يُستشهد بها من أسبوع إلى آخر | قوِّ الصفحات والمصادر الخارجية التي تُسترجع جيدًا |
| تحديثات النموذج والفهرس | أسلوب الإجابة كاملًا والعلامات المفضلة | قفزة واضحة في تاريخ محدد | احتفظ بخط أساس وسجّل كل تحديث تستطيع تحديده |
الأرقام المقاسة ما زالت نادرة، ومعظمها يأتي من شركات SEO ومنصات ظهور الذكاء الاصطناعي. يستحق مصدران قراءة متأنية. الأول دراسة لمنصة SEO باسم Authoritas قارنت نتائج AI Overviews بالنتائج العضوية. والثاني قياسات من BrightEdge قارنت AI Overviews مع AI Mode.
قاست Authoritas تقلّب الترتيب بدرجة. كلما ارتفعت الدرجة زادت تغيرات النتائج خلال الفترة. بالنسبة إلى AI Overviews بلغت الدرجة 0.68 عند 8 أسابيع و0.73 عند 13 أسبوعًا. أما النتائج العضوية فبلغت 0.49 و0.55. وذكر Digital Information World، الذي نشر الدراسة في فبراير 2025، أن نحو 70% من نتائج AI Overviews تغيّرت خلال شهرين إلى ثلاثة أشهر. لم يذكر ذلك المقال حجم عينة الكلمات المفتاحية أو تواريخ القياس، لذا تحقّق من تقرير Authoritas الأصلي قبل أن تستشهد بالرقم في عرض لعميل.
نتائج AI Overviews التي تغيّرت خلال شهرين إلى ثلاثة أشهر
المصدر: دراسة Authoritas، نقلتها Digital Information World، فبراير 2025
قاست BrightEdge السؤال نفسه من زاوية أخرى. وجد تحليلها المنشور في أغسطس 2025 أن تقلّب ذكر العلامات في AI Overviews أعلى بنسبة 16.7% منه في AI Mode. ووجد أيضًا أن AI Overviews أبقت 24% من روابطها دون تغيير، مقابل 20% في AI Mode. يضع الجدول هذه الأرقام جنبًا إلى جنب.
| المقياس | AI Overviews | المقارنة | المصدر |
|---|---|---|---|
| درجة التقلّب، 8 أسابيع | 0.68 | 0.49 للنتائج العضوية | Authoritas |
| درجة التقلّب، 13 أسبوعًا | 0.73 | 0.55 للنتائج العضوية | Authoritas |
| تقلّب ذكر العلامات | أعلى بنسبة 16.7% | مقارنة بـ AI Mode | BrightEdge، أغسطس 2025 |
| الروابط التي لم تتغير | 24% | 20% في AI Mode | BrightEdge، أغسطس 2025 |
تظهر AI Overviews داخل صفحة نتائج Google المعتادة لجزء من الاستعلامات. أما AI Mode فواجهة منفصلة تشبه المحادثة. تشير أرقام BrightEdge إلى أن AI Overviews تتأرجح أكثر في العلامات التي تذكرها، بينما تحافظ AI Mode على روابط أقل ثباتًا. الدرس العملي هو فحص كل سطح على حدة. فرقم واحد باسم "ذكاء Google الاصطناعي" يخفي الفرق، والفرق هو بالضبط ما تحتاج إلى التخطيط حوله. يغطي مقارنتنا بين وضع الذكاء الاصطناعي في Google وAI Overviews ما يعنيه كل منهما لتحسين محركات البحث.
النقطة الأساسية أنه لا يمكنك أن تفترض أن الثبات العضوي سينتقل إلى الذكاء الاصطناعي. فالنتائج العضوية أقل تقلبًا من AI Overviews في بيانات Authoritas، لكنها ليست ساكنة. فالصفحة التي تحافظ على المركز الثالث لشهر كامل قد تهبط بعد تحديث جوهري، لذلك تحتاج إلى منهج يفصل التغيير الحقيقي عن الحركة العادية على السطحين معًا.
معظم أدوات تتبّع الترتيب صُممت لـ Google، حيث للكلمة المفتاحية قائمة مرتبة واحدة تتغير ببطء. وعند تطبيق المنطق نفسه على نموذج ذكاء اصطناعي ينتج رقمًا مبنيًا على عينة واحدة. فإذا جاءت علامتك في المركز الثالث في تشغيل وفي الثامن في التالي، فإن متوسط التشغيلين لا يخبرك بالكثير. والأداة التي تقول "أنت رقم 3 في ChatGPT" تقدّم سحبة واحدة كأنها حقيقة. يغطي دليلنا لتتبّع الترتيب الطريقة الكلاسيكية، ويشرح هذا المقال ما الذي يتغير حين تُولَّد الإجابة بدلًا من أن تُعرض في قائمة.
خلاصة SparkToro أن المنتجات التي تعتمد على مواقع ثابتة تقيس الضجيج. ونصيحة الدراسة هي تتبّع الحضور بدل الترتيب. وتعدّ نسبة الظهور مقياسًا معقولًا عندما تُقاس عبر عشرات إلى مئات الأسئلة، وكل سؤال يُشغَّل عدة مرات. اطلب من أي مزود أن يُظهر حجم العينة والمنهج خلف الدرجة قبل أن تثق بها.
سؤال واحد، لقطة شاشة واحدة مقابل نسبة مقاسة
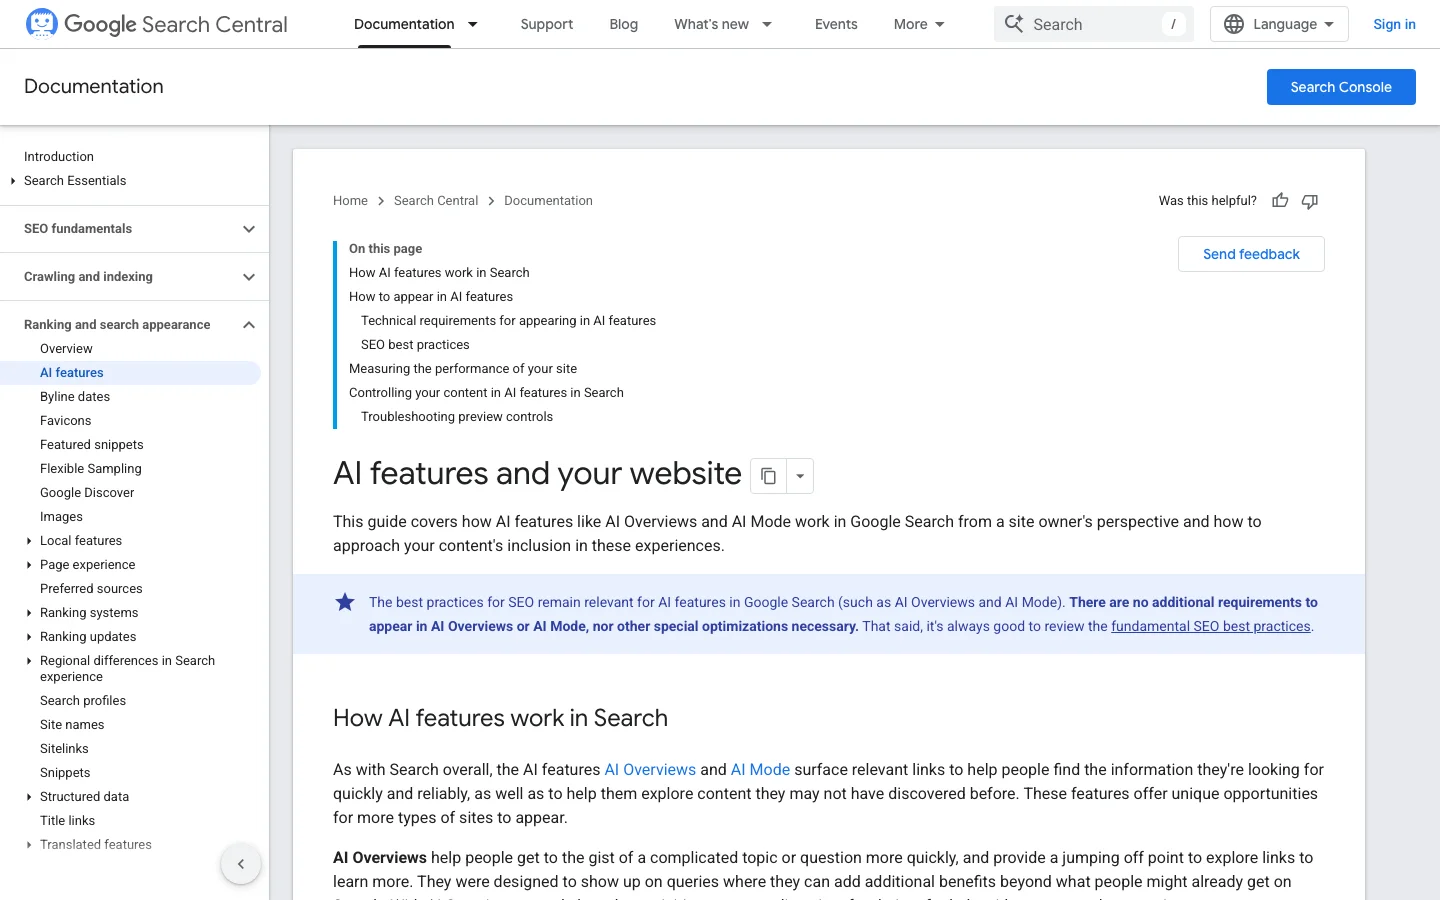
وثائق Google نفسها تشير إلى الاتجاه نفسه، لسبب مختلف. تقول Google إن الصفحة يجب أن تكون مفهرسة ومؤهلة للظهور في البحث مع مقتطف، حتى تُستخدم في AI Overviews أو AI Mode. وتقول أيضًا إنه لا توجد علامات خاصة ولا ملف خاص بالذكاء الاصطناعي تحتاج إلى إضافته. لا يوجد إعداد "ترتيب الذكاء الاصطناعي" لتحسينه، لذا فالعمل هو أن تكون حاضرًا وموثوقًا عبر مصادر كثيرة، وأن تقيس هذا الحضور بأمانة.
يحتاج المنهج أدناه إلى بضعة أيام للإعداد ودقائق قليلة أسبوعيًا للمتابعة. ويمكنك تنفيذه في جدول بيانات. الأدوات المتخصصة توفر عليك التكرار أساسًا، لا التفكير.
منهج القياس من خمس خطوات
نسبة الظهور هي حصة الإجابات التي تذكر علامتك. وهامش الخطأ يخبرك بمقدار التغيير الحقيقي. استخدم هامش خطأ بمستوى ثقة 95% مبنيًا على الخطأ المعياري للنسبة:
visibility rate = answers that name your brand / total answers
standard error = sqrt(p x (1 - p) / n)     where p is the visibility rate and n the number of runs
95% margin of error = 1.96 x standard error
هذا مثال توضيحي بأرقام مختلقة وليس قياسًا فعليًا. تظهر علامتك في 37 تشغيلًا من أصل 80، إذن نسبة الظهور 46%. الخطأ المعياري 5.6 نقطة، فيعطي هامش خطأ بمستوى ثقة 95% يقارب 11 نقطة. أبلغ عن النتيجة بوصفها 46% زائد أو ناقص 11 نقطة. إذا أظهرت الدفعة التالية 40%، فهذا يقع داخل النطاق، ولا يعني أنك يجب أن تعيد كتابة صفحاتك.
يمكن أن تُذكر علامة دون رابط، أو تُربط دون أن تُوصى بها، أو تُوصى بها في جملة لا تذكر منافسًا. سجّل هذه الحالات منفصلة: مذكورة وموصى بها، ومذكورة فقط، ومستشهد بها فقط. تتحرك حصصها لأسباب مختلفة، ويحتاج كل منها إلى إصلاح مختلف. الاستشهاد دون ذكر مشكلة مصادر. والذكر دون توصية مشكلة تموضع.
ورقة القياس الأولى
ملاحظة
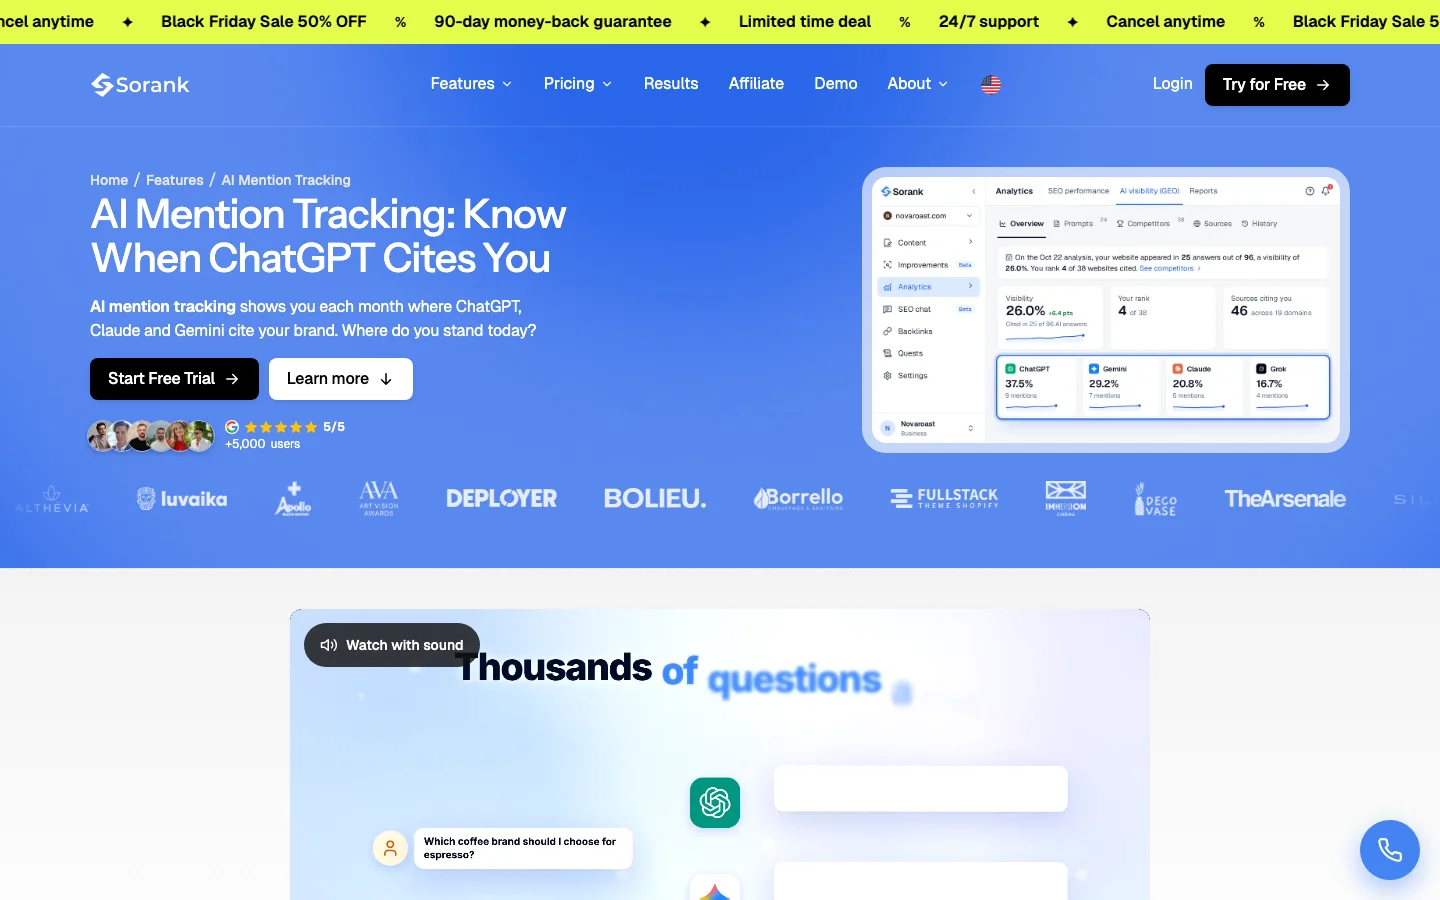
تكرار كل سؤال يدويًا يصبح مملًا بعد أسابيع قليلة. تعرض ميزة تتبّع الذكر بالذكاء الاصطناعي في Sorank لكل سؤال تتابعه عدد مرات ذكر ChatGPT و Claude و Gemini لعلامتك، مع المصادر والبحوث وراء كل إجابة. وتعمل مرة في الشهر، وهذا عينة رقيقة لسؤال واحد، لذا اقرأ اتجاهها عبر عدة أشهر، وأضف تشغيلاتك المتكررة للأسئلة الأهم.
يجب أن يجيب التقرير الشهري عن سؤال واحد: هل يتحرك حضورك، وهل الحركة أكبر من الضجيج؟ اعرض نسبة الظهور لكل مجموعة أسئلة مع هامش خطأها، لا رقمًا واحدًا. وأضف توزيع المواقع، أي عدد مرات ظهور علامتك في المركز الأول أو الثاني أو أدنى، في الإجابات التي تُذكر فيها، حتى يظهر الترتيب كانتشار لا كرتبة. التذبذب حول اتجاه ثابت أو صاعد أمر طبيعي. أما الهبوط المتواصل عبر عدة دفعات فليس طبيعيًا، ويستحق فحص الأسئلة وملاحظات إصدار النموذج والمصادر المستشهد بها قبل أن يعيد أحد كتابة أي صفحة. واكتب قاعدة القرار داخل التقرير نفسه: يُعدّ التغيير حقيقيًا فقط إذا تجاوز هامش الخطأ في دفعتين متتاليتين.
لا يمكنك إيقاف التقلّب، لكن يمكنك جعل حضورك أكثر اتساقًا. يزداد الحضور عندما تُوصف علامتك بالطريقة نفسها في عدة مصادر تستخدمها نماذج الذكاء الاصطناعي أصلًا. وتقدّم وثائق Google الأساس لما تحتاجه ميزاتها الخاصة.
توجيه Google حول AI Overviews وAI Mode قصير. يجب أن تكون الصفحة مفهرسة ومؤهلة لعرض مقتطف. وما زالت أساسيات الموقع تنطبق: قواعد robots.txt القابلة للزحف، والروابط الداخلية، والنص المرئي للقارئ، والبيانات المنظمة (structured data) المتطابقة مع النص الظاهر. وتقول Google إنك لا تحتاج إلى ملفات جديدة مقروءة آليًا، ولا ملفات نصية خاصة بالذكاء الاصطناعي، ولا مخطط خاص لكي تظهر.
تبني نماذج الذكاء الاصطناعي صورة للعلامة من أماكن كثيرة في وقت واحد. إذا اختلف اسمك وفئتك وحالة الاستخدام الرئيسية والموقع بين موقعك وملفاتك الشخصية وقوائم الأدلة، تصبح الصورة غامضة، وتصبح قائمة العلامات أقل ثباتًا. اكتب وصفًا واحدًا قصيرًا ووقائعيًا لشركتك، مع الفئة وحالات الاستخدام، وأعد استخدامه في كل مكان تستطيع فيه التحكم بالنص. وراجعه كل ربع سنة.
التأكيد المتبادل يعني أن عدة مصادر مستقلة تقول الشيء نفسه عنك. والمراجعات ومقالات المقارنة وأدلة القطاع والمنشورات المتخصصة في مجالك هي الأماكن المعتادة. اكسب هذه الإشارات بعمل مفيد، مثل بيانات أصلية أو مقارنة واضحة للمنتجات أو أداة يستخدمها الناس فعلًا. ولا تشترِها. فالمواضع المدفوعة تضيف ضجيجًا، وهي نمط ينكسر فور توقف الدفع.
تستخرج نماذج الذكاء الاصطناعي فقرات لا صفحات كاملة. الصفحة التي تقدم تعريفًا قصيرًا في الفقرة الأولى، وإجابة مباشرة عن السؤال الرئيسي، وخطوة تالية واضحة، أسهل في الاستخراج وأدق في الاستشهاد. يسرد قائمة GEO لدينا النقاط التي يجب فحصها في كل صفحة.
قائمة الثبات لعلامتك
تتعامل الفرق مع التقلّب بأربع طرق شائعة. لكل طريقة استخدام وحدود. اقرأها كخيارات يمكن الجمع بينها، لا كترتيب لأفضلها. ومعظم الفرق تستخدم الأولى والأخيرة معًا.
المبدأ: اسأل سؤالًا واحدًا كل يوم وسجّل موقع علامتك في الإجابة. متى تستخدمه: تريد إنذارًا مبكرًا عندما يتغير سؤال معين بحدة. المزايا: مألوف ورخيص وسهل الرسم البياني. الحدود: إنه عينة واحدة في اليوم، ولا يستطيع التمييز بين خسارة حقيقية وسحبة عادية. مثال: يذكر سؤال علامتك يوم الاثنين ولا يذكرها يوم الأربعاء. يُظهر الرسم هبوطًا، لكن تشغيلًا واحدًا لا يستطيع أن يخبرك هل هي خسارة موقع أم تغير عادي.
المبدأ: شغّل أسئلة كثيرة مرات كثيرة، وأبلغ عن حصة الإجابات التي تذكر علامتك مع هامش خطئها. متى تستخدمه: تحتاج رقمًا للتقارير أو لقرار استثمار في المحتوى. المزايا: يطابق طريقة توليد المخرج ويعطيك نطاقًا بدل نقطة زائفة. الحدود: يتطلب تشغيلات أكثر، ويتطلب انضباطًا في الحفاظ على مجموعة أسئلة ثابتة. مثال: نسبة ظهورك 46% زائد أو ناقص 11 نقطة عبر 80 تشغيلًا. الشهر القادم تصبح 52%. يمكنك القول إن الاتجاه صاعد، لكن لا يمكنك القول بعد إنه مكسب حقيقي، لذا تنتظر دفعة أخرى.
المبدأ: اجعل الادعاءات الدقيقة نفسها تظهر على عدة مصادر مستقلة. متى تستخدمه: تموضعك واضح وتريد توصيات تصمد. المزايا: يساعد في إجابات الذكاء الاصطناعي وفي البحث التقليدي، وأثره يدوم. الحدود: إنه بطيء، ونادرًا ما يظهر نتيجة خلال شهر واحد. مثال: تحصل شركة برمجيات على وصف حالات استخدامها في مراجعتين وصفحة مقارنة ودليل قطاع، فتكرر نماذج الذكاء الاصطناعي الوصف نفسه عبر أسئلة مختلفة.
المبدأ: حدّث الصفحات التي تجيب عن أسئلتك الرئيسية، بحيث تكون الإجابة واضحة ودقيقة ومؤرخة. متى تستخدمه: صفحتك مستشهد بها لكن بوصف خاطئ، أو تُستشهد بصفحة منافس حيث يجب أن تُستشهد بصفحتك. المزايا: سريع التنفيذ، ويحسّن طريقة استخراج الفقرات. الحدود: الصفحة الأفضل لا تضمن الذكر، والتغييرات تحتاج وقتًا لتظهر في بياناتك. مثال: تحصل صفحة مسرد على تعريف من جملة واحدة في الأعلى، وجدول مقارنة قصير، وملاحظة تحديث ظاهرة، فتُظهر دفعة القياس التالية الوصف الصحيح.
| الطريقة | ما الذي تخبرك به | ثبات الإشارة | الجهد | الأنسب لـ |
|---|---|---|---|---|
| الترتيب اليومي | موقع واحد في يوم واحد | منخفض | منخفض | رصد حركة حادة في سؤال واحد |
| الحضور عبر التشغيلات | حصة الإجابات التي تذكر علامتك | مرتفع، مع هامش خطأ | متوسط إلى مرتفع | التقارير وقرارات الميزانية |
| التأكيد المتبادل | مدى اتساق المصادر في وصفك | مرتفع عبر أشهر | مرتفع | التوصيات طويلة الأمد |
| تحديث الصفحة | مدى إجابة صفحاتك الأساسية عن السؤال | متوسط | متوسط | إصلاح وصف خاطئ أو ناقص |
نتائج Google العضوية وإجابات الذكاء الاصطناعي تحتاجان إلى أدوات مختلفة. الخلط بينهما يؤدي إلى استنتاجات خاطئة، لذا أبقهما منفصلتين في تقاريرك.
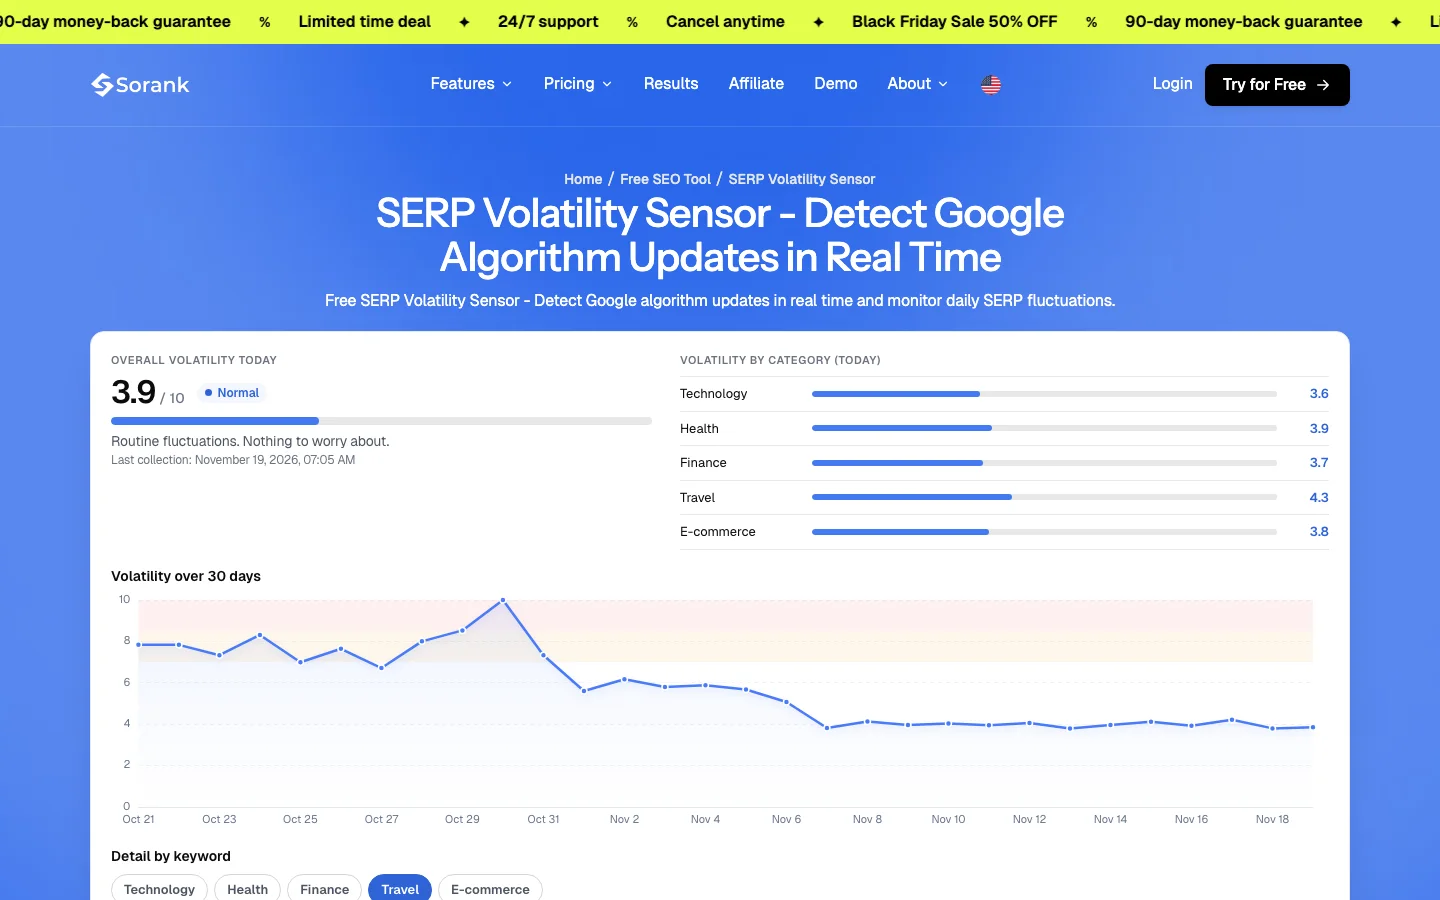
تغطي أداة Sorank المجانية SERP Volatility Sensor النوع الأول. كل صباح تجمع أفضل 10 نتائج عضوية لـ 20 كلمة مفتاحية إنجليزية في الولايات المتحدة عبر خمسة قطاعات، وتقارنها باليوم السابق، وتعطي درجة من 0 إلى 10، إجمالية ولكل قطاع. وهي تُظهر مقدار تحرك الصفحة الأولى من Google، ما يجعلها إشارة مبكرة مفيدة لتغييرات الخوارزميات. لكنها لا تقيس إجابات الذكاء الاصطناعي، فلا تحل محل المنهج القائم على الأسئلة الموضح أعلاه. وللجانب الخاص بـ Google من السؤال، اقرأ الأداة على صفحتها، واحتفظ بها بجوار بيانات ترتيبك، لا بجوار أرقام ظهورك في الذكاء الاصطناعي.
تُقدّم Search Console و Google Analytics تقارير عن نقرات Google والزيارات المُحالة. وتعرض أدوات تتبّع الترتيب مواقع Google. لا أي منها يُظهر إجابات الذكاء الاصطناعي التي ذكرت علامتك. لذلك تحتاج إلى إجابات مسجلة أو أداة تسجلها. وبالنسبة للزيارات القادمة من نماذج الذكاء الاصطناعي، يغطي جانب الإحالة دليلنا عن تقارير GEO.
معظم أخطاء التقلّب تأتي من قراءة الضجيج كإشارة. يوضح كل خطأ أدناه كيف يبدو، وكيف تكتشفه في بياناتك، وكيف تصلحه.
ما هو: لقطة شاشة واحدة أو إجابة واحدة تُقدَّم كموقعك. كيف تكتشفه: يعرض التقرير موقعًا دون حجم عينة ولا نطاق تاريخ ولا هامش خطأ. كيف تصلحه: أبلغ عن نسبة الظهور عبر 30 تشغيلًا على الأقل لكل سؤال، مع هامش الخطأ ونطاق التاريخ.
ما هو: إعادة صياغة سؤال بين فحصين، مثل "أفضل CRM" في أسبوع و"أفضل CRM للشركات الناشئة" في الأسبوع التالي، ثم قراءة النتيجة كاتجاه. كيف تكتشفه: نص السؤال في الجدول يختلف بين تاريخين للصف نفسه. كيف تصلحه: جمّد مجموعة الأسئلة وأعطها أرقام إصدار. أضف السؤال الجديد كصف جديد ولا تعدّل سؤالًا قديمًا أبدًا.
ما هو: إعادة كتابة صفحة بعد هبوط بخمس نقاط. كيف تكتشفه: التغيير أصغر من هامش الخطأ لذلك السؤال. كيف تصلحه: تصرف فقط عندما يتجاوز التغيير هامش الخطأ في دفعتين متتاليتين، ودوّن ما تغير أيضًا في الفترة نفسها، مثل تحديث نموذج أو إطلاق منافس.
ما هو: تسجيل كل رابط إلى موقعك كانتصار، حتى عندما تذكر الإجابة علامتك كخيار يجب تجنبه أو كحاشية. كيف تكتشفه: لا أحد يقرأ الجملة المحيطة بالاستشهاد. كيف تصلحه: سجّل الحالات الثلاث منفصلة (مذكورة وموصى بها، ومذكورة فقط، ومستشهد بها فقط)، واقرأ الجملة قبل أن تضع علامة في الخانة.
ما هو: أسئلة يكتبها فريق التسويق لتقرير ما. كيف تكتشفه: الأسئلة تستخدم أسماء منتجات داخلية أو مصطلحات لا يستخدمها العملاء أبدًا. كيف تصلحه: خذ الأسئلة من مكالمات المبيعات ومحادثات الدعم واستعلامات Search Console، وتحقق من بعضها مع عملاء حقيقيين.
ما هو: افتراض أن نسبة ظهور أعلى ستجلب زيارات أكثر تلقائيًا. كيف تكتشفه: ترتفع نسبة الظهور بينما تبقى جلسات الإحالة ثابتة. كيف تصلحه: قِس زيارات الإحالة منفصلة، وتحقق من أي نماذج ذكاء اصطناعي ومن أي صفحات ترسل الزيارات، واربط البيانات في تقرير شهري واحد.
ما هو: إطلاق مشروع لملف نصي خاص بالذكاء الاصطناعي أو لعلامات جديدة، على أمل أن يُشغّل الاستشهادات. كيف تكتشفه: المشروع لا يتضمن فحصًا للفهرسة أو أهلية المقتطف. كيف تصلحه: ابدأ بتوجيه Google. تأكد أن الصفحات الأساسية مفهرسة ومؤهلة لعرض مقتطف، ثم أصلح النص والروابط الداخلية قبل أي شيء آخر.
| الخطأ | العلامة في بياناتك | الإصلاح |
|---|---|---|
| تشغيل واحد يُقدَّم كنتيجة | لا حجم عينة ولا هامش خطأ | أبلغ عن نسبة عبر 30 تشغيلًا على الأقل |
| أسئلة تُعدَّل بين الفحوص | الصف نفسه بنص مختلف وتواريخ مختلفة | جمّد مجموعة الأسئلة وأعطها أرقام إصدار |
| التفاعل داخل هامش الخطأ | تغيير أصغر من الهامش | تصرّف على تغييرات تستمر عبر دفعتين |
| عدّ الاستشهاد توصية | لا قراءة للجملة المحيطة | سجّل الحالات الثلاث منفصلة |
| أسئلة لا يكتبها أحد | مصطلحات داخلية في قائمة الأسئلة | استخرج الأسئلة من لغة العملاء الحقيقية |
| معاملة الظهور كزيارات | ظهور يرتفع وإحالات ثابتة | قِس الإحالات بشكل مستقل |
لا تحتاج إلى برنامج كامل لتبدأ. الأسبوع الأول يتعلق بإعداد القياس، حتى تكون الأشهر الستة التالية قابلة للقراءة. نفّذ هذه الخطوات بالترتيب.
أسبوعك الأول
بمجرد أن يصبح لديك خط أساس، يتوقف التقلّب عن كونه مصدر قلق. ويصبح نطاقًا يمكنك قياسه، ومجموعة من التغييرات يمكنك التخطيط حولها.
تختار نماذج اللغة كل كلمة من توزيع احتمالي، فقد يعطي السؤال نفسه صياغة وقوائم علامات وترتيبًا مختلفة. كما يتغير الاسترجاع، لأن النموذج يعيد صياغة السؤال إلى استعلامات فرعية، والصفحات التي يسترجعها قد تتغير بين التشغيلات.
قاست Authoritas AI Overviews بدرجة تقلّب 0.68 عند 8 أسابيع و0.73 عند 13 أسبوعًا، مقابل 0.49 و0.55 للنتائج العضوية. ووجدت SparkToro أن فرصة إعادة ChatGPT أو ذكاء Google الاصطناعي القائمة نفسها مرتين أقل من 1 من كل 100.
الموقع الواحد داخل إجابة الذكاء الاصطناعي غير ثابت بما يكفي لتبني عليه قرارًا. تتبّع عدد مرات ظهور علامتك عبر أسئلة وتشغيلات كثيرة، وأبلغ عن هذه النسبة كنسبة مئوية مع هامش خطئها، واحتفظ بتتبّع الترتيب التقليدي لنتائج Google العضوية، حيث تتحرك المواقع ببطء أكبر.
نحلّل منافسيك وموقعك وظهورك في الذكاء الاصطناعي لنعدّ لك خطة محتوى مخصّصة مجانًا.
 مولد موجز المحتوى بالذكاء الاصطناعي
 مولد مخطط الأسئلة الشائعة
 مولد أفكار المقالات بالذكاء الاصطناعي
 مدقق البيانات المنظمة (مدقق Schema)
 مدقق النص البديل
 محلل الروابط الداخلية
 تحدي الروابط الخلفية
 مولّد الوصف التعريفي بالذكاء الاصطناعي
 مولّد عناوين المدونات بالذكاء الاصطناعي
 أداة فحص قابلية الفهرسة في Google
 مولّد مخطط المقالات بالذكاء الاصطناعي
 مولّد روابط UTM
 أداة تجميع الكلمات المفتاحية
 أداة فحص وسم الرابط الأساسي
 مولّد خريطة موقع XML
 أداة فحص الروابط المعطلة
 مولّد عناوين SEO بالذكاء الاصطناعي
 محلل العناوين
 أداة معاينة نتائج البحث
 فاحص إعادة التوجيه
 مولّد وسوم hreflang
 محلّل بنية العناوين
 أداة فحص ترويسات HTTP
 أداة استخراج Favicon
 حاسبة حصة الصوت في SEO
 حاسبة توقّعات زيارات وإيرادات SEO
 حاسبة ميزانية SEO
 حاسبة محاكاة الارتقاء في الترتيب
 حاسبة الاستثمار في محتوى GEO
 حاسبة CTR
 حاسبة توفير SEO مقابل البحث المدفوع
 حاسبة درجة فرصة الكلمة المفتاحية
 أداة تقدير الزيارات الواردة من ChatGPT
 حاسبة حصة الصوت في الذكاء الاصطناعي
 أداة الترتيب في Gemini
 مولّد llms.txt
 أداة فحص خريطة الموقع
 محول صفحات الويب إلى Markdown
 عدّاد الكلمات
 مولّد ترميز Schema
 معاينة Open Graph
 أداة ضغط الصور
 أداة تحليل الروابط الخلفية
 حاسبة نقطة التعادل في SEO
 حاسبة وقت القراءة
 حاسبة GEO ROI
 حاسبة ROI الروابط الخلفية
 تدقيق البيانات المنظّمة لنماذج LLM
 تدقيق GEO
 مستشعر تقلّب نتائج البحث
 مولّد روابط URL
 مولّد وسوم الميتا
 أداة البحث عن الكلمات المفتاحية
 حاسبة SERP CTR
 حاسبة ROI في SEO
 حاسبة نسبة LTV إلى CAC
 أداة تقدير الزيارات الطبيعية وفحص زيارات المواقع
 حاسبة تكلفة بناء الروابط
 حاسبة القيمة الدائمة للعميل
 حاسبة تكلفة المقال
 حاسبة معدل التحويل
 حاسبة معدل الارتداد
 حاسبة قيمة الزيارات القادمة من الذكاء الاصطناعي
 أداة فحص AI Overview وتتبع الترتيب في AI Overviews
 تدقيق SEO بالذكاء الاصطناعي
 تدقيق تحسين الظهور في إجابات الذكاء الاصطناعي
 حاسبة ROI في SEO لشركات SaaS
 حاسبة ROAS
 حاسبة ROI لـSEO المحلي
 حاسبة قيمة الكلمة المفتاحية
 حاسبة كثافة الكلمات المفتاحية
 حاسبة ROI في SEO للتجارة الإلكترونية
 حاسبة تكلفة اكتساب العميل
 حاسبة ROI في تسويق المحتوى
 حاسبة درجة الظهور في الذكاء الاصطناعي
 حاسبة تكلفة الغياب عن إجابات الذكاء الاصطناعي
 حاسبة معدل الاستشهاد في إجابات الذكاء الاصطناعي
 أداة فحص الاستشهاد في نماذج LLM
 تدقيق السيو داخل الصفحة: أداة فحص السيو وتحليله
 حاسبة قيمة الزيارات الطبيعية
 أداة التحقق من llms.txt
 اختبار قابلية القراءة للذكاء الاصطناعي
 اختبار الجاهزية لـ SearchGPT
 تدقيق زحف روبوتات الذكاء الاصطناعي
 لماذا لا يوصي ChatGPT بموقعكم
 أداة فحص الترتيب في Perplexity
 اختبار الظهور في البحث بالذكاء الاصطناعي
 فاحص الظهور في ChatGPT
 مستخرج الروابط
 أداة فحص حجم الصفحة
 مولّد robots.txt
 مولّد Favicon
 أداة فحص robots.txt
 فاحص سلطة النطاق
 “نحن وكالة إعلانات (Ads) وأردنا أخيرًا إعادة تنظيم الـ SEO لدينا بشكل نهائي. قدّمت لنا Sorank رؤية واضحة لموقعنا، وساعدتنا على ترتيب أولويات التحسينات وهيكلة المحتوى بشكل صحيح. الأداة سهلة الاستخدام، ومصممة جيدًا للعمل الجماعي، وعملية جدًا لتجميع المتابعة دون الحاجة إلى التنقل بين عدة منصات. أساس متين جدًا لبداية جديدة مع الـ SEO لدينا.”
 Gaspard Madouiوكالة إعلانات (Ads)“على مدى عامين، جاء 100% من عملائي من LinkedIn. النشر يوميًا، والتعليق، ومتابعات الرسائل المباشرة... اعتماد كامل على الخوارزمية. كنت أعلم أنني بحاجة إلى العمل على SEO لكنني كنت أؤجله دائمًا: طويل جدًا، وتقني جدًا، وليس مجال عملي. مع Sorank، اتخذت الخطوة أخيرًا. خلال 4 أشهر، أصبحت أولد 15 عميلًا محتملًا عضويًا شهريًا دون نشر أي شيء. لا يزال الأمر ليس مناصفة مع LinkedIn، لكنني أنام بشكل أفضل لعلمي أن لدي الآن مصدر عملاء ثانيًا ينمو تلقائيًا.”

 Valentin Thomyoffbound.fr
 “تركت برنامج Sorank يقوم بعمله فقط، والآن أصبح تقييم DR لموقعي 25 وصفحتي تحتل مرتبة أعلى.”
 Lucas Flandrefoundertrace.fr“حل ممتاز لإدارة SEO دون صداع. عمليات التدقيق سريعة، والواجهة واضحة، وترى بسرعة الإجراءات التي يجب تنفيذها. لقد أصبح أداة أساسية لتتبع وتحسين SEO الخاص بمواقعي. أوصي به بشدة.”
 Xavرائد أعمال