La confidentialité est importante pour nous. Vous avez donc la possibilité de désactiver certains types de stockage qui peuvent ne pas être nécessaires au fonctionnement de base du site Web. Le blocage des catégories peut avoir un impact sur votre expérience sur le site Web. Plus d'informations (Politique de cookies)
Merci ! Vos choix ont bien été enregistrés.
Oups ! Une erreur s'est produite lors de l'envoi du formulaire.
Volatilité de la recherche IA : pourquoi les réponses changent et comment réagir
Pourquoi les réponses de l'IA changent à chaque exécution, à quel point elles bougent, et comment mesurer la présence de votre marque sur plusieurs prompts.
Points bleus sur une grille blanche, la plupart se déplaçant tandis qu'un seul reste ancré, illustrant la volatilité de la recherche IA.
Outils
Sur cette page
En bref
la volatilité de la recherche IA mesure à quel point les marques, les URL et l'ordre d'une réponse IA changent d'une exécution à l'autre, et d'une semaine à l'autre. La même question peut renvoyer une liste de marques différente, d'autres citations et un autre ordre, car la réponse est générée avec de l'aléatoire et l'étape de récupération change aussi. La position dans une réponse IA est donc une mauvaise mesure. Mesurez à quelle fréquence votre marque apparaît sur de nombreux prompts et de nombreuses exécutions, puis construisez les sources qui rendent cette présence stable.
3 jours offerts, puis vous arrêtez quand vous voulez. Garantie résultats 90 jours, sous conditions.
Ce que signifie la volatilité de la recherche IA
Dans la recherche organique de Google, la volatilité signifie que votre position sur un mot-clé monte et descend. Dans la recherche IA, c'est plus que cela. La réponse elle-même est différente à chaque exécution. Une réponse IA volatile peut changer de trois façons : les marques qu'elle nomme, les URL qu'elle cite et l'ordre dans lequel elle les présente. Chacun de ces éléments peut bouger sans la moindre modification de votre site.
La différence compte, car un classement est un résultat fixe à un instant donné. Google renvoie une liste ordonnée, et pour la même requête, sur le même marché, cette liste est en grande partie reproductible. Un modèle d'IA renvoie un seul échantillon parmi une gamme de réponses possibles. Votre marque a une probabilité d'apparaître dans cette gamme. C'est cette probabilité que vous pouvez mesurer, et c'est elle que vous pouvez faire évoluer.
Deux chiffres d'une étude publiée en 2026 montrent l'ampleur de l'effet. Rand Fishkin, de SparkToro, a travaillé avec Patrick O'Donnell, de Gumshoe.ai. Environ 600 volontaires ont envoyé 12 prompts à ChatGPT, Claude et l'IA de Google, soit 2961 exécutions au total. Les chercheurs ont constaté moins d'une chance sur 100 que ChatGPT ou l'IA de Google renvoie deux fois la même liste de marques. La probabilité d'obtenir la même liste dans le même ordre était d'environ une sur 1000 exécutions. Le rapport SparkToro, daté du 28 janvier 2026, couvre des données collectées en novembre et décembre 2025.
Dans quelle mesure les listes de marques IA sont-elles stables ?
2961exécutions sur 12 prompts et trois systèmes d'IA
<1%chance que ChatGPT ou l'IA de Google renvoie deux fois la même liste de marques
<0,1%chance d'obtenir la même liste de marques dans le même ordre
Source : SparkToro et Gumshoe.ai, janvier 2026
Une fois admis que la réponse est un échantillon, la manière de la suivre doit changer. Le comparatif ci-dessous résume les deux logiques. C'est l'idée centrale de tout ce guide.
Suivre un classement ou suivre la présence
Une position isolée
Change à presque chaque exécution
Une seule réponse apprend très peu
Part des exécutions
Mesurée sur des dizaines de prompts
Montre une tendance sur laquelle agir
La volatilité des listes de marques
Le changement le plus visible concerne la liste de marques elle-même. Un prompt comme « meilleur outil de gestion de projet pour une équipe de 10 personnes » peut citer cinq marques dans une exécution, puis cinq autres à la suivante. Certaines marques reviennent souvent, d'autres entrent et sortent. La présence dans l'ensemble est plus stable que la position à l'intérieur de celui-ci, c'est pourquoi les chercheurs conseillent de suivre la présence plutôt que le rang.
Cela a une conséquence pratique. Si vous testez un prompt une fois et voyez votre marque en deuxième position, vous ne savez presque rien. Si vous le testez 60 fois et voyez votre marque dans 40 réponses, vous savez quelque chose d'utile : vous êtes un choix régulier pour cette question.
La volatilité des citations
Les citations sont les liens qu'un modèle d'IA affiche comme sources. Elles bougent encore plus que la liste de marques lorsque le modèle effectue une recherche web en direct, car chaque exécution peut récupérer un ensemble de pages différent. Une citation qui disparaît n'est pas toujours une perte. Votre marque peut rester citée dans le texte sans lien. C'est pourquoi il faut suivre deux choses séparément : la mention nommée et l'URL citée.
La volatilité de l'ordre
La position dans une réponse est l'élément le moins stable. Un modèle d'IA peut placer votre marque en première position dans une exécution, puis en quatrième dans la suivante, sans que son opinion sur vous ait réellement changé. Considérez l'ordre comme du bruit, sauf s'il évolue dans une seule direction sur des dizaines d'exécutions.
Pourquoi des questions identiques reçoivent des réponses différentes
Trois mécanismes expliquent l'essentiel des changements. Vous ne pouvez pas les désactiver, mais les connaître vous dit quoi mesurer et quoi ignorer.
L'échantillonnage
Un modèle de langage ne choisit pas une seule meilleure réponse. Il choisit chaque mot suivant dans une distribution de probabilités. Un réglage appelé température contrôle l'ampleur de ce choix. À faible valeur, la sortie est plus proche d'être reproductible, à valeur élevée elle varie davantage. Les développeurs peuvent régler la température dans une API, mais les applications grand public qu'utilisent la plupart de vos acheteurs ne l'exposent pas. Supposez que l'échantillonnage est toujours actif. Les volontaires de SparkToro ont gardé leurs réglages habituels, personnalisés ou par défaut, ce qui explique pourquoi leurs résultats décrivent ce que voit un utilisateur ordinaire.
Récupération et sous-requêtes
Quand un modèle d'IA effectue une recherche sur le web, il n'envoie pas votre question exacte à un moteur. Il la reformule en plusieurs sous-requêtes et récupère des pages pour chacune. Une petite différence de formulation, une page indexée le matin même ou un résultat différent pour une seule sous-requête peuvent changer les sources qui arrivent dans la réponse finale. Les URL d'où vous êtes cité sont le produit d'une étape de récupération qui bouge. Notre guide sur la manière dont les modèles d'IA choisissent leurs sources explique le mécanisme, et l'outil de suivi de Sorank sur ce que l'IA recherche réellement répond précisément à cette question.
Mises à jour des modèles et des index
Les fournisseurs mettent à jour les modèles et les systèmes qui les entourent sans grand préavis. Une nouvelle version de modèle, un changement dans le moment où un modèle décide de chercher, ou une évolution de l'index web peuvent modifier les réponses sur tout un thème en une seule journée. Quand vos données montrent un changement brutal, vérifiez d'abord une mise à jour probable, puis comparez avec votre référence avant de réagir.
Mécanisme
Ce qui bouge
Comment cela apparaît
Ce qu'il faut faire
Échantillonnage
Liste de marques, formulation et ordre
Réponses différentes au même prompt le même jour
Mesurer sur de nombreuses exécutions et publier une part
Récupération
URL citées
Sources différentes citées d'une semaine à l'autre
Renforcer les pages et les sources tierces qui se récupèrent bien
Mises à jour des modèles et des index
Style général des réponses et marques favorisées
Un changement brutal à une date précise
Conserver une référence et noter chaque mise à jour identifiable
Les réponses IA bougent d'une exécution à l'autre. La présence sur de nombreuses exécutions est ce que vous pouvez suivre et construire.
Dans quelle mesure les réponses IA bougent
Les chiffres mesurés restent rares, et la plupart viennent d'éditeurs d'outils de SEO et de visibilité IA. Deux sources méritent une lecture attentive. La première est une étude de la plateforme SEO Authoritas, qui a comparé les AI Overviews aux résultats organiques. La seconde est un ensemble de mesures de BrightEdge, qui a comparé les AI Overviews au mode IA.
Authoritas a mesuré la volatilité des classements avec un score. Plus le score est élevé, plus les résultats ont changé sur la période. Pour les AI Overviews, le score était de 0,68 à 8 semaines et de 0,73 à 13 semaines. Pour les résultats organiques, il était de 0,49 et 0,55. Digital Information World, qui a relayé l'étude en février 2025, indiquait aussi qu'environ 70% des résultats des AI Overviews avaient changé en deux à trois mois. Cet article ne précisait ni l'échantillon de mots-clés ni les dates de mesure. Vérifiez donc le rapport original d'Authoritas avant de citer un chiffre dans un document client.
Score de volatilité des classements à 8 semaines
AI Overviews0,68
Résultats organiques0,49
Source : étude Authoritas, relayée par Digital Information World, février 2025
Résultats des AI Overviews qui ont changé en 2 à 3 mois
70%des résultats des AI Overviews suivis
Source : étude Authoritas, relayée par Digital Information World, février 2025
BrightEdge a mesuré la même question sous un autre angle. Son analyse d'août 2025 a relevé une volatilité des mentions de marque supérieure de 16,7% pour les AI Overviews par rapport au mode IA. Elle a aussi constaté que les AI Overviews conservaient 24% de leurs URL inchangées, contre 20% pour le mode IA. Le tableau met ces chiffres côte à côte.
Mesure
AI Overviews
Comparaison
Source
Score de volatilité, 8 semaines
0,68
0,49 pour les résultats organiques
Authoritas
Score de volatilité, 13 semaines
0,73
0,55 pour les résultats organiques
Authoritas
Volatilité des mentions de marque
16,7% de plus
Par rapport au mode IA
BrightEdge, août 2025
URL inchangées
24%
20% pour le mode IA
BrightEdge, août 2025
Pourquoi les AI Overviews et le mode IA se comportent différemment
Les AI Overviews apparaissent dans la page de résultats Google habituelle pour un sous-ensemble de requêtes. Le mode IA est une interface distincte, de type conversationnel. Les chiffres de BrightEdge suggèrent que les AI Overviews varient davantage dans les marques qu'elles citent, alors que le mode IA conserve moins de ses URL stables. La leçon pratique est de vérifier chaque surface séparément. Un seul chiffre « IA de Google » masque la différence, et c'est précisément cette différence qu'il faut anticiper. Notre comparatif de Google AI Mode et des AI Overviews explique ce que chacun implique pour le SEO.
Le point clé est qu'on ne peut pas supposer que la stabilité organique se transfère. Les résultats organiques sont moins volatils que les AI Overviews dans les données d'Authoritas, mais ils ne sont pas figés. Une page qui garde la position 3 pendant un mois peut tout de même chuter après une mise à jour majeure. Il faut donc une méthode qui sépare les vrais changements des mouvements ordinaires sur les deux surfaces.
Pourquoi le suivi de positions ne fonctionne plus dans la recherche IA
La plupart des outils de suivi de positions ont été conçus pour Google, où un mot-clé a une liste ordonnée unique qui change lentement. Appliquée à un modèle d'IA, la même logique produit un chiffre fondé sur un seul échantillon. Si votre marque est troisième dans une exécution et huitième dans la suivante, une moyenne de ces deux exécutions ne vous apprend presque rien. Un outil qui affiche « vous êtes numéro 3 dans ChatGPT » présente un tirage unique comme un fait. Notre guide du suivi de positions couvre la méthode classique, et cet article explique ce qui change une fois la réponse générée plutôt que listée.
La conclusion de SparkToro est que les produits de suivi de positions fondés sur des rangs fixes mesurent du bruit. L'étude conseille de suivre la présence plutôt que le rang. Elle juge raisonnable un pourcentage de visibilité mesuré sur des dizaines à des centaines de prompts, chacun exécuté plusieurs fois. Demandez à tout éditeur de montrer la taille de l'échantillon et la méthode derrière un score avant de lui faire confiance.
Un prompt, une capture d'écran ou une part mesurée
Avant
Affiche une seule position
Change à l'exécution suivante
Aucune marge d'erreur, donc chaque mouvement paraît réel
Après
Affiche la part des exécutions qui nomment votre marque
Montre une tendance sur plusieurs semaines
Indique l'ampleur qu'un changement doit avoir pour compter
La documentation de Google va dans le même sens, pour une autre raison. Google indique qu'une page doit être indexée et éligible à l'affichage dans la Recherche, avec un extrait, pour être utilisée dans les AI Overviews ou le mode IA. Il indique aussi qu'il n'existe aucun balisage spécial ni fichier propre à l'IA à ajouter. Il n'y a pas de réglage de « classement IA » à optimiser : le travail consiste à être présent et digne de confiance sur de nombreuses sources, et à mesurer honnêtement cette présence.
Comment mesurer la volatilité de la recherche IA, étape par étape
La méthode ci-dessous demande quelques jours de mise en place et quelques minutes par semaine pour l'entretenir. Vous pouvez la faire dans un tableur. Les outils dédiés vous épargnent surtout la répétition, pas la réflexion.
La méthode de mesure en cinq étapes
Constituer un jeu de promptsChoisissez 20 à 50 questions que de vrais acheteurs posent. Prenez-les dans vos appels commerciaux, vos conversations de support et vos requêtes Search Console.
Exécuter chaque prompt plusieurs foisRépétez chaque prompt au moins 30 fois par modèle d'IA, idéalement 60 à 100 comme l'équipe de SparkToro. Gardez les mêmes réglages et répartissez les exécutions sur plusieurs jours.
Consigner chaque réponseNotez si votre marque est nommée, si elle est recommandée ou seulement mentionnée, sa position et les URL citées.
Calculer le taux de visibilitéDivisez le nombre de réponses qui nomment votre marque par le nombre total de réponses, puis ajoutez la marge d'erreur pour chaque prompt et chaque modèle d'IA.
Lire la tendance chaque semaineTracez le taux dans le temps et annotez les mises à jour des modèles, vos changements de contenu et les lancements de concurrents.
La formule, avec un exemple chiffré
Le taux de visibilité est la part des réponses qui nomment votre marque. La marge d'erreur indique quelle part d'un changement est réelle. Utilisez une marge d'erreur à 95% fondée sur l'erreur type d'une proportion :
taux de visibilité = réponses qui nomment votre marque / total des réponses
erreur type = racine(p x (1 - p) / n)     où p est le taux de visibilité et n le nombre d'exécutions
marge d'erreur à 95% = 1,96 x erreur type
Voici un exemple illustratif, avec des chiffres fictifs et non une mesure. Votre marque apparaît dans 37 exécutions sur 80, soit un taux de visibilité de 46%. L'erreur type est de 5,6 points, ce qui donne une marge d'erreur à 95% d'environ 11 points. Présentez le résultat sous la forme 46% plus ou moins 11 points. Si le lot suivant affiche 40%, ce chiffre se situe dans la fourchette, et ce n'est pas un signal pour réécrire vos pages.
Cité, recommandé et nommé sont trois états différents
Une marque peut être nommée sans lien, liée sans être recommandée, ou recommandée dans une phrase qui ne nomme jamais un concurrent. Consignez ces états séparément : nommée et recommandée, nommée seulement, et citée seulement. Leurs parts évoluent pour des raisons différentes, et chacune appelle une correction différente. Une citation sans mention est un problème de sources. Une mention sans recommandation est un problème de positionnement.
Votre première feuille de mesure
Liste de prompts figée et datée, avec les nouveaux prompts ajoutés en nouvelles lignes
Exécutions consignées par modèle d'IA, avec la date et les réglages utilisés
Trois états enregistrés : nommée et recommandée, nommée seulement, citée seulement
Taux de visibilité et marge d'erreur calculés pour chaque prompt
Note
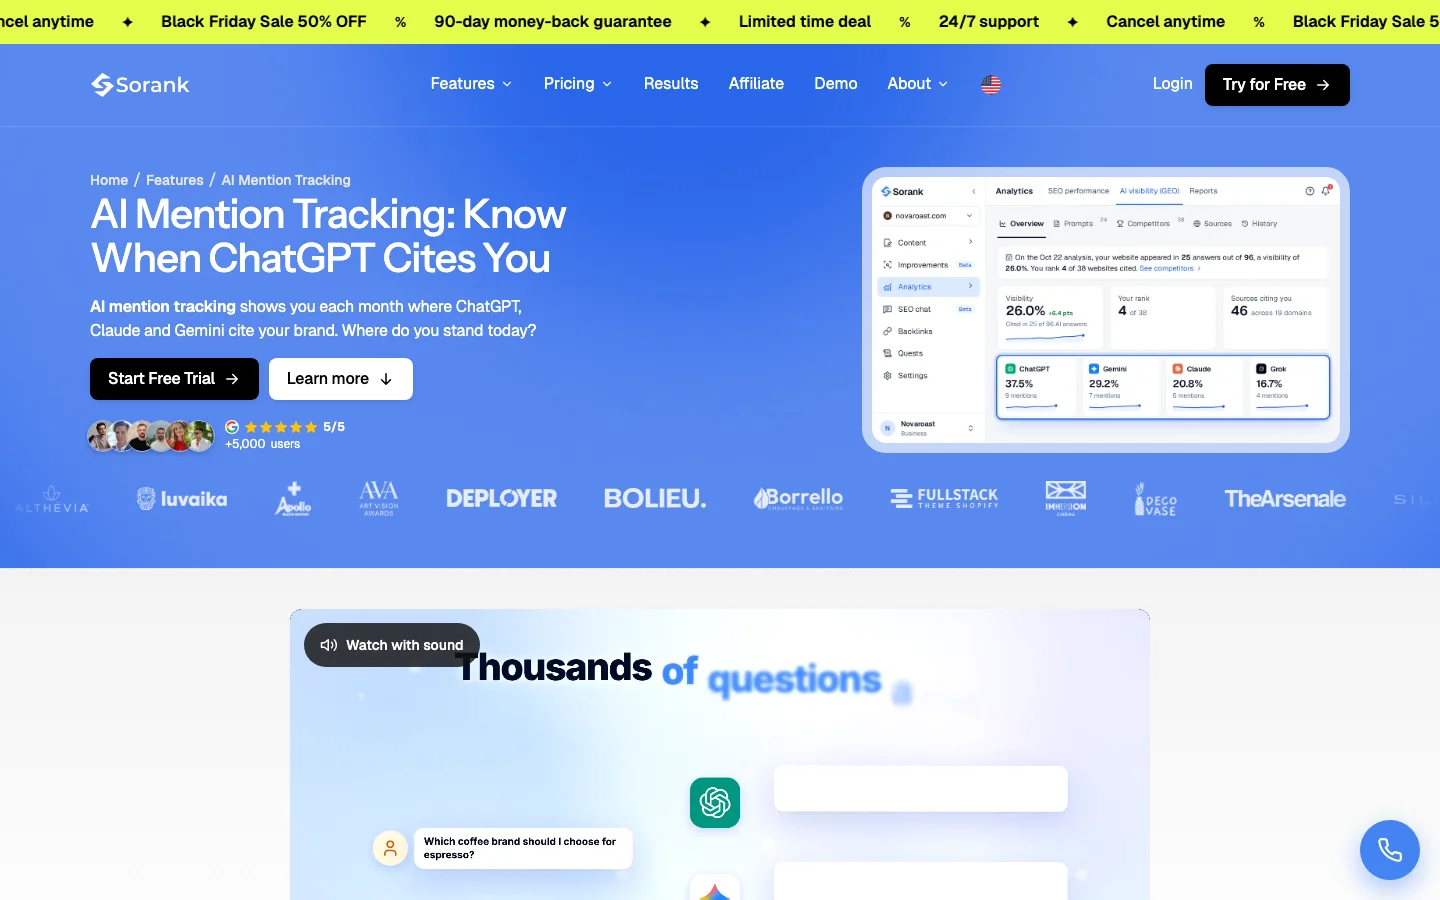
Répéter chaque prompt à la main devient fastidieux après quelques semaines. Le suivi des mentions IA de Sorank indique, pour chaque prompt suivi, à quelle fréquence ChatGPT, Claude et Gemini mentionnent votre marque, avec les sources et les recherches derrière chaque réponse. Son exécution est mensuelle, ce qui fait un échantillon mince pour un seul prompt. Lisez sa tendance sur plusieurs mois, et ajoutez vos propres exécutions répétées pour les prompts les plus importants.
AI Mention Tracking indique à quelle fréquence ChatGPT, Claude et Gemini citent votre marque.
Le rapporter à ceux qui le financent
Un rapport mensuel doit répondre à une seule question : votre présence évolue-t-elle, et le mouvement est-il plus grand que le bruit ? Montrez le taux de visibilité par groupe de prompts avec sa marge d'erreur, pas un chiffre unique. Ajoutez la répartition des positions, c'est-à-dire la fréquence à laquelle votre marque apparaît en premier, en deuxième ou plus bas dans les réponses où elle est nommée, afin que l'ordre apparaisse comme une dispersion plutôt que comme un classement. Les oscillations autour d'une tendance stable ou en hausse sont normales. Une baisse régulière sur plusieurs lots ne l'est pas : elle justifie de vérifier les prompts, les notes de version des modèles et les sources citées avant de réécrire quoi que ce soit. Inscrivez la règle d'action dans le rapport lui-même : un changement n'est réel que s'il dépasse la marge d'erreur sur deux lots consécutifs.
Comment rendre votre présence plus stable
Vous ne pouvez pas supprimer la volatilité, mais vous pouvez rendre votre présence plus constante. La présence progresse lorsque votre marque est décrite de la même façon sur plusieurs sources que les modèles d'IA utilisent déjà. La documentation de Google donne la référence minimale de ce dont ses propres fonctions IA ont besoin.
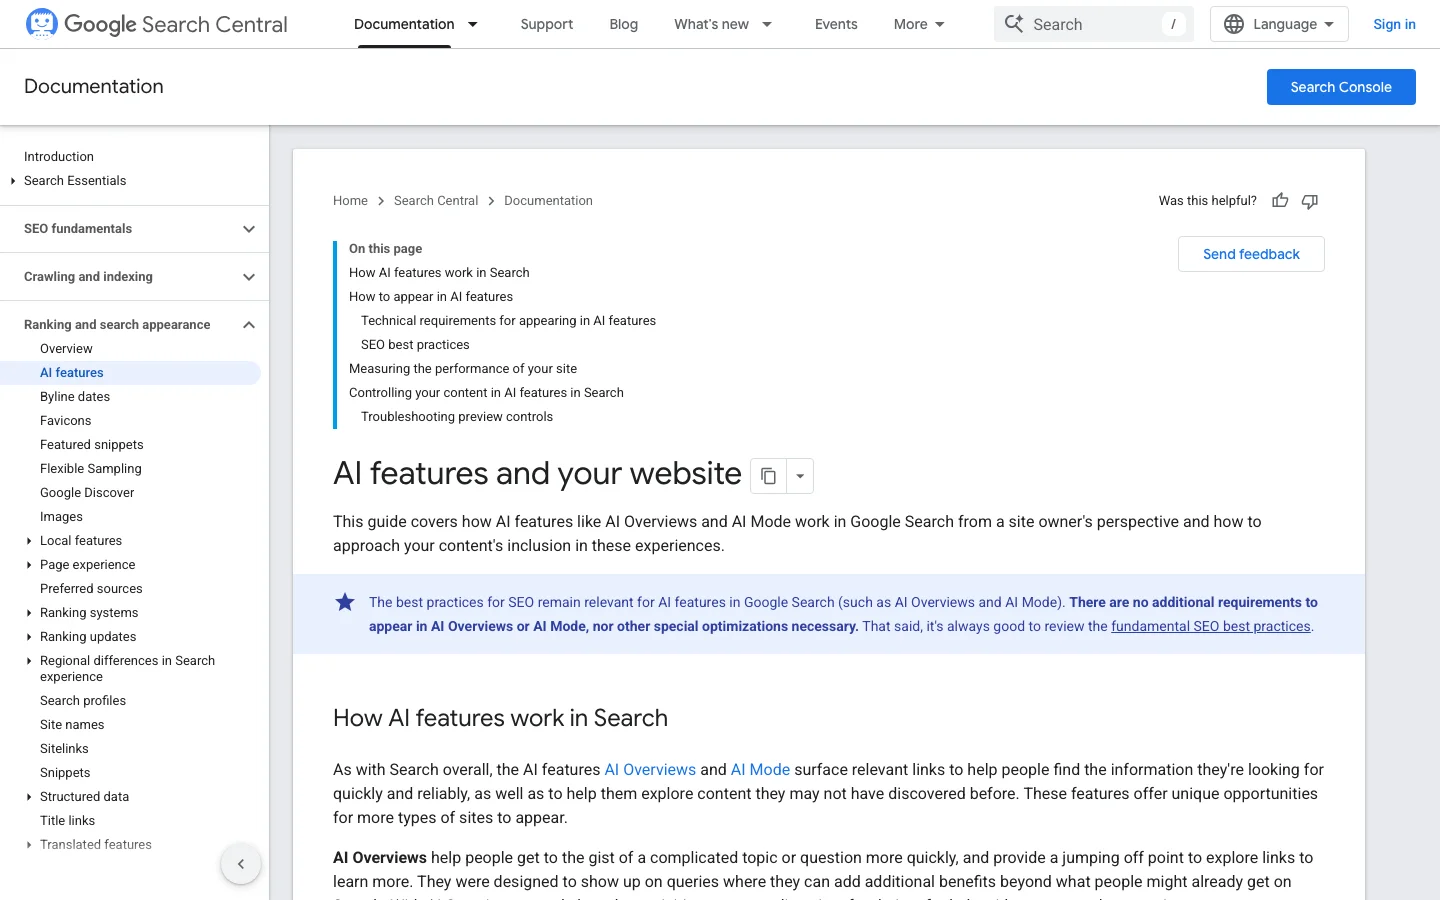
Les recommandations de Google sur les AI Overviews et le mode IA sont brèves. Une page doit être indexée et éligible à l'affichage d'un extrait. Les fondamentaux restent valables : règles robots.txt accessibles aux robots, liens internes, texte visible pour les lecteurs, et données structurées qui correspondent au texte affiché. Google indique qu'il n'est pas nécessaire de créer de nouveaux fichiers lisibles par machine, de fichiers texte pour l'IA ou un balisage spécial pour apparaître.
Les recommandations de Google sur les AI Overviews et le mode IA : aucune optimisation spécifique n'est requise.
Décrire votre marque de la même façon partout
Les modèles d'IA se font une image d'une marque à partir de nombreux endroits à la fois. Si votre nom, votre catégorie, votre cas d'usage principal et votre localisation diffèrent entre votre site, vos profils et vos annuaires, l'image se brouille et la liste de marques devient moins stable. Rédigez une description courte et factuelle de votre entreprise, avec sa catégorie et ses cas d'usage, et réutilisez-la partout où vous contrôlez le texte. Vérifiez-la chaque trimestre.
Gagner des mentions sur des sources déjà fiables
La corroboration signifie que plusieurs sources indépendantes disent la même chose de vous. Les avis, les articles comparatifs, les annuaires sectoriels et les médias professionnels de votre niche sont les endroits habituels. Obtenez ces mentions grâce à un travail utile, comme des données originales, un comparatif de produits clair ou un outil que les gens utilisent vraiment. Ne les achetez pas. Les placements payants ajoutent du bruit, et ce sont le type de schéma qui se casse dès que les paiements s'arrêtent.
Répondre à la question principale sur chaque page clé
Les modèles d'IA extraient des passages, pas des pages entières. Une page qui donne une courte définition dans le premier paragraphe, une réponse directe à la question principale et une étape suivante claire est plus facile à extraire et à citer avec exactitude. Notre checklist GEO énumère les points à vérifier sur chaque page.
Liste de contrôle de la stabilité de votre marque
Pages clés indexées et éligibles à l'affichage d'un extrait
Même nom de marque et même catégorie sur chaque profil et chaque annuaire
Mentions sur plusieurs sites indépendants, pas seulement sur le vôtre
Données structurées qui correspondent au texte visible par le lecteur
Une réponse directe dans le premier paragraphe de chaque page clé
Quatre façons de réagir à la volatilité
Les équipes réagissent à la volatilité de quatre façons courantes. Chacune a un usage et une limite. Lisez-les comme des options combinables, pas comme un classement de la meilleure. La plupart des équipes utilisent la première et la dernière ensemble.
Suivre le rang quotidien
Principe : interroger un prompt chaque jour et noter la position de votre marque dans la réponse. Quand l'utiliser : vous voulez une alerte précoce quand une requête précise change brutalement. Avantages : c'est familier, peu coûteux et facile à tracer. Limites : c'est un seul échantillon par jour, et il ne permet pas de distinguer une vraie perte d'un tirage ordinaire. Exemple : un prompt nomme votre marque le lundi et non le mercredi. Le graphique montre une baisse, mais une seule exécution ne permet pas de savoir s'il s'agit d'une position perdue ou d'une variation normale.
Suivre la présence sur de nombreuses exécutions
Principe : exécuter de nombreux prompts plusieurs fois et publier la part des réponses qui nomment votre marque, avec sa marge d'erreur. Quand l'utiliser : vous avez besoin d'un chiffre pour un rapport ou pour une décision d'investissement éditorial. Avantages : cela correspond à la façon dont la réponse est générée et donne une fourchette au lieu d'un faux point. Limites : cela coûte plus d'exécutions et exige de la rigueur pour garder le jeu de prompts stable. Exemple : votre taux de visibilité est de 46% plus ou moins 11 points sur 80 exécutions. Le mois suivant, il est de 52%. Vous pouvez dire que la tendance est à la hausse, mais pas encore affirmer qu'il s'agit d'un vrai gain : vous attendez un autre lot.
Construire une corroboration entre sources
Principe : faire apparaître les mêmes affirmations exactes sur plusieurs sources indépendantes. Quand l'utiliser : votre positionnement est clair et vous voulez des recommandations qui tiennent. Avantages : cela aide dans les réponses IA comme dans la recherche traditionnelle, et l'effet dure. Limites : c'est lent, et cela montre rarement un résultat en un mois. Exemple : une société de logiciels voit ses cas d'usage décrits dans deux avis, une page comparative et un annuaire sectoriel, de sorte que les modèles d'IA répètent la même description pour différents prompts.
Rafraîchir les pages clés avec des réponses directes
Principe : mettre à jour les pages qui répondent à vos questions principales pour que la réponse soit claire, exacte et datée. Quand l'utiliser : votre page est citée mais mal décrite, ou une page concurrente est citée à la place de la vôtre. Avantages : c'est rapide à faire et cela améliore l'extraction des passages. Limites : une meilleure page ne garantit pas une mention, et les changements mettent du temps à apparaître dans vos données. Exemple : une page de glossaire reçoit une définition en une phrase en tête, un court tableau comparatif et une note de mise à jour visible, et le lot de mesure suivant montre la description correcte.
Méthode
Ce qu'elle indique
Stabilité du signal
Effort
Idéale pour
Rang quotidien
Une position un jour donné
Faible
Faible
Repérer une baisse brutale sur une requête
Présence sur plusieurs exécutions
Part des réponses qui nomment votre marque
Élevée, avec une marge d'erreur
Moyen à élevé
Rapports et décisions budgétaires
Corroboration
Cohérence de la description par les sources
Élevée sur plusieurs mois
Élevé
Recommandations à long terme
Rafraîchissement de page
Qualité de réponse de vos pages clés à la question
Moyenne
Moyen
Corriger une description fausse ou absente
Des outils pour deux types de volatilité
Les résultats organiques de Google et les réponses IA demandent des instruments différents. Les confondre mène à de mauvaises conclusions, gardez-les donc séparés dans vos rapports.
Le Capteur de volatilité des SERP gratuit de Sorank couvre le premier type. Chaque matin, il collecte les 10 premiers résultats organiques de 20 mots-clés en anglais aux États-Unis, répartis sur cinq secteurs, les compare à la veille et donne un score de 0 à 10, global et par secteur. Il montre à quel point la première page de Google a bougé, ce qui en fait un signal précoce utile pour les changements d'algorithme. Il ne mesure pas les réponses IA et ne remplace donc pas la méthode fondée sur les prompts ci-dessus. Pour le volet Google de la question, lisez le capteur sur sa propre page, et gardez-le à côté de vos données de classement plutôt qu'à côté de vos chiffres de visibilité IA.
Le Capteur de volatilité des SERP gratuit suit les résultats organiques de Google, pas les réponses IA.
Search Console et Google Analytics rendent compte des clics Google et des visites par référencement. Un outil de suivi de positions rend compte des positions sur Google. Aucun ne montre quelles réponses IA ont cité votre marque. Pour cela, il faut des réponses consignées ou un outil qui les consigne. Pour les visites venant des modèles d'IA, le volet référent est couvert dans notre guide sur le reporting GEO.
Erreurs courantes et comment les corriger
La plupart des erreurs de volatilité viennent de la lecture du bruit comme un signal. Chaque erreur ci-dessous montre à quoi elle ressemble, comment la repérer dans vos données et comment la corriger.
Présenter une seule exécution comme un résultat
Ce que c'est : une capture d'écran ou une réponse unique présentée comme votre position. Comment la repérer : le rapport affiche une position sans taille d'échantillon, sans période et sans marge d'erreur. Comment la corriger : publiez le taux de visibilité sur au moins 30 exécutions par prompt, avec la marge d'erreur et la période.
Modifier les prompts entre deux contrôles
Ce que c'est : reformuler un prompt entre deux contrôles, par exemple « meilleur CRM » une semaine puis « meilleur CRM pour startups » la suivante, puis lire le résultat comme une tendance. Comment la repérer : le texte du prompt dans le tableur diffère entre deux dates pour la même ligne. Comment la corriger : figez le jeu de prompts et versionnez-le. Ajoutez un nouveau prompt comme une nouvelle ligne et ne modifiez jamais une ancienne.
Réagir à des mouvements dans la marge d'erreur
Ce que c'est : réécrire une page après une baisse de cinq points. Comment la repérer : le changement est plus petit que la marge d'erreur de ce prompt. Comment la corriger : n'agissez que lorsqu'un changement dépasse la marge d'erreur sur deux lots consécutifs, et notez ce qui a changé par ailleurs sur la même période, comme une mise à jour de modèle ou le lancement d'un concurrent.
Compter une citation comme une recommandation
Ce que c'est : consigner chaque lien vers votre site comme une victoire, même quand la réponse présente votre marque comme une option à éviter ou comme une simple note de bas de page. Comment la repérer : personne ne lit la phrase qui entoure la citation. Comment la corriger : consignez les trois états séparément (nommée et recommandée, nommée seulement, citée seulement), et lisez la phrase avant de cocher la case.
Suivre des prompts que personne ne tape
Ce que c'est : des prompts rédigés par l'équipe marketing pour un rapport. Comment la repérer : les prompts utilisent des noms de produits internes ou du jargon que les clients n'emploient jamais. Comment la corriger : prenez les prompts dans les appels commerciaux, les conversations de support et les requêtes Search Console, et testez-en quelques-uns avec de vrais clients.
Attendre que la visibilité IA génère seule des clics
Ce que c'est : supposer qu'un taux de visibilité plus élevé apportera automatiquement plus de visites. Comment la repérer : le taux de visibilité monte pendant que les sessions de référencement restent stables. Comment la corriger : mesurez séparément les visites référentes, vérifiez quels modèles d'IA et quelles pages les envoient, et reliez les deux jeux de données dans un même rapport mensuel.
Ajouter des fichiers spécifiques à l'IA pour courir après les réponses IA
Ce que c'est : lancer un projet de fichier texte pour l'IA ou de nouveau balisage, en espérant déclencher des citations. Comment la repérer : le projet ne contrôle ni l'indexation ni l'éligibilité aux extraits. Comment la corriger : commencez par les recommandations de Google. Confirmez que les pages clés sont indexées et éligibles à l'affichage d'un extrait, puis corrigez d'abord le texte et les liens internes.
Erreur
Signe dans vos données
Correction
Une exécution présentée comme un résultat
Aucune taille d'échantillon ni marge d'erreur
Publier une part sur au moins 30 exécutions
Prompts modifiés entre deux contrôles
Même ligne, texte différent, dates différentes
Figer et versionner le jeu de prompts
Réagir dans la marge d'erreur
Changement plus petit que la marge
N'agir que sur les changements qui persistent sur deux lots
Citation comptée comme recommandation
Aucune lecture de la phrase qui l'entoure
Consigner les trois états séparément
Prompts que personne ne tape
Jargon interne dans la liste de prompts
Tirer les prompts du langage réel des clients
Visibilité traitée comme du trafic
Visibilité en hausse, visites référentes stables
Mesurer les visites référentes à part
Ce qu'il faut faire cette semaine
Vous n'avez pas besoin d'un programme complet pour commencer. La première semaine consiste à mettre en place la mesure afin que les six mois suivants soient lisibles. Suivez ces étapes dans l'ordre.
Votre première semaine
Choisir 20 promptsPrenez-les dans le langage réel de vos clients, et figez la liste avec une date.
Exécuter chaque prompt 30 foisUtilisez les modèles d'IA qu'emploient vos acheteurs, et consignez les trois états pour chaque réponse.
Calculer le taux de visibilitéCalculez le taux et sa marge d'erreur pour chaque prompt, puis écrivez une phrase par prompt qui dit ce qu'il montre.
Comparer vos pages clésConfrontez-les aux descriptions que donne l'IA, et notez chaque affirmation fausse ou manquante.
Programmer le lot suivantLancez-le deux semaines plus tard, pour comparer les mêmes prompts à un rythme régulier.
Une fois la référence établie, la volatilité cesse d'être une source d'inquiétude. Elle devient une fourchette que vous pouvez mesurer, et un ensemble de changements auxquels vous pouvez vous préparer.
Questions fréquentes
Pourquoi ChatGPT donne-t-il des réponses différentes à la même question ?
Les modèles de langage choisissent chaque mot dans une distribution de probabilités, donc le même prompt peut produire une formulation, une liste de marques et un ordre différents. La récupération change aussi : le modèle reformule la question en sous-requêtes, et les pages récupérées peuvent varier d'une exécution à l'autre.
Dans quelle mesure les réponses de la recherche IA changent-elles dans le temps ?
Authoritas a mesuré pour les AI Overviews un score de volatilité de 0,68 à 8 semaines et de 0,73 à 13 semaines, contre 0,49 et 0,55 pour les résultats organiques. SparkToro a constaté moins d'une chance sur 100 que ChatGPT ou l'IA de Google renvoie deux fois la même liste de marques.
Faut-il encore suivre son rang dans la recherche IA ?
Une position isolée dans une réponse IA est trop instable pour agir dessus. Suivez à quelle fréquence votre marque apparaît sur de nombreux prompts et exécutions, publiez cette part en pourcentage avec sa marge d'erreur, et gardez le suivi de positions classique pour les résultats organiques de Google, où les positions bougent plus lentement.
y!
Recevez gratuitement votre plan de contenu pour 30 jours
Nous analysons vos concurrents, votre site et votre visibilité dans les IA pour créer gratuitement un plan de contenu sur mesure.
“J'ai testé Sorank sur un vrai site client et c'est dingue. Il fait tout ce qu'une agence facture 1'500€ par mois. Là, ça part en production sur ce client.”Guillaume Guersanguersanguillaume.com
“Nous sommes une agence Ads et nous voulions remettre notre SEO sur les rails une bonne fois pour toutes. Sorank nous a donné une vue claire de notre site, nous a aidés à prioriser les optimisations et à structurer correctement notre contenu. L'outil est facile à utiliser, bien pensé pour une équipe et très pratique pour centraliser le suivi sans avoir à jongler entre plusieurs plateformes. Une base très solide pour repartir à zéro avec notre SEO.”Gaspard MadouiAgence Publicitaire
Dominiqueflight-sensations-idf.comLoisirs et aviation
“J'ai simplement laissé le logiciel Sorank faire son travail, et aujourd'hui mon DR est de 25 et ma page se positionne mieux.”Lucas Flandrefoundertrace.fr
“Je me suis spécialisée en GEO grâce à Sorank. Le GEO Leaderboard me permet de montrer à mes clients leur positionnement vs leurs concurrents sur ChatGPT. C'est un vrai différenciateur commercial.”MélanieSEO indépendant
“Excellent service, fonctionne bien pour notre site web et nous aide à comprendre comment l'améliorer pour mieux nous positionner sur Google et ailleurs. Félicitations, continuez, je vous le recommande.”Hugo T.Marchand en ligne