AI 搜索答案为何每次运行都会变化,变化幅度有多大,以及如何跨提示词衡量品牌的出现率,而不是追逐一个排名。
工具

简而言之
AI 搜索波动,是指 AI 回答中的品牌、网址和排列顺序在每次运行之间、以及每周之间变化的程度。同一个问题可能返回不同的品牌列表、不同的引用和不同的顺序,因为回答是带有随机性生成的,而检索步骤也在变化。因此,品牌在 AI 回答中的位置是一个糟糕的指标。应当衡量你的品牌在大量提示词和大量运行中出现的频率,然后建设能让这种出现保持稳定的来源。
想深入了解?请询问
快速测验
如何让 ChatGPT 和其他 AI 提到您?
Sorank 符合您的回答


在您自己的网站上试用 3 天,看看您在 Google、ChatGPT 和其他 AI 中的位置。
开始 3 天免费试用免费 3 天,之后可随时停止。90 天效果保证,需符合条件。
在 Google 自然搜索中,波动意味着你的关键词排名上下浮动。在 AI 搜索中,情况更复杂。答案本身每次运行都不同。一个波动的 AI 回答可能以三种方式变化:它提到哪些品牌、引用哪些网址,以及列出它们的顺序。这三者中任何一项都可能在你的网站没有任何改动的情况下发生变化。
这种区别很重要,因为排名是某一时刻的固定输出。Google 返回一个有序列表,同一市场中的同一查询,这个列表大多是可以重复的。而 AI 模型只返回众多可能答案中的一个样本。你的品牌在这个答案范围内有一定的出现概率。这个概率才是你可以衡量的,也是你可以改变的。
2026 年发表的一项研究中的两个数字说明了这种效应有多强。SparkToro 的 Rand Fishkin 与 Gumshoe.ai 的 Patrick O'Donnell 合作,约 600 名志愿者通过 ChatGPT、Claude 和 Google 的 AI 运行了 12 个提示词,总计 2961 次运行。研究人员发现,ChatGPT 或 Google 的 AI 两次返回相同品牌列表的概率不到 100 分之 1。相同品牌列表且顺序也相同的概率约为 1000 次运行中有 1 次。SparkToro 报告发布于 2026 年 1 月 28 日,其数据收集于 2025 年 11 月和 12 月。
AI 品牌列表有多稳定?
来源:SparkToro 与 Gumshoe.ai,2026 年 1 月
一旦你接受输出只是一个样本,追踪方式就必须改变。下面的对比概括了两种思路。这是本指南的核心观点。
追踪排名与追踪出现
最明显的变化是品牌列表本身。像"10 人团队最好的项目管理工具"这样的提示词,可能在一次运行中列出五个品牌,下一次又列出另外五个。有些品牌经常出现,另一些则进进出出。集合中的出现比集合内的位置更稳定,这正是研究人员建议追踪出现而非排名的原因。
这带来一个实际后果。如果你只检查一次某个提示词,并看到品牌位于第二位,你几乎什么也不知道。如果你检查了 60 次,并在其中 40 个答案中看到你的品牌,那你就知道了一些有用的东西:在这个问题上,你是一个经常被选择的对象。
引用是 AI 模型作为来源展示的链接。当模型运行实时网络搜索时,引用的变化甚至比品牌列表更大,因为每次运行都可能检索到不同的页面组合。消失的引用并不总是损失。你的品牌可能仍然在文本中被提及,只是没有链接。因此,你应当分别追踪两件事:被提及的名称,以及被引用的网址。
答案中的位置是最不稳定的元素。AI 模型可能在一次运行中把你的品牌排在第一,在下一次排在第四,而它对你的看法实际上并没有真正改变。除非顺序在数十次运行中朝同一方向移动,否则应把顺序视为噪声。
三种机制驱动了大部分变化。你无法将它们关闭,但了解它们能告诉你该测量什么、忽略什么。
语言模型并不会挑选一个最佳答案。它是从概率分布中逐个选择下一个词。一个称为温度(temperature)的设置控制着这种选择的宽窄。数值较低时,输出更接近可重复;数值较高时,变化更大。开发者可以通过 API 设置温度,但你的大多数买家使用的消费级应用并不开放这一设置。应假定采样始终在起作用。SparkToro 的志愿者保留了他们平时的设置,无论是个性化的还是默认的,因此他们的结果描述的是普通用户所看到的内容。
当 AI 模型搜索网络时,它不会把你的原始问题发送给搜索引擎。它会把问题改写成若干子查询,并为每个子查询检索页面。措辞上的微小变化、当天新被索引的页面,或某个子查询的不同结果,都可能改变哪些来源最终进入答案。你被引用的网址,是一个不断移动的检索步骤的产物。我们关于AI 模型如何选择来源的指南解释了其机制,而 Sorank 的 AI 实际搜索内容追踪器正是为这个问题而构建的。
服务商会在几乎不做提前通知的情况下更新模型及其周边系统。新的模型版本、AI 模型决定是否搜索的时机发生变化,或网络索引的转变,都可能在某一天改变整个主题的答案。当你的数据出现突然的阶跃变化时,应先检查是否可能存在某次更新,然后再与基线比较,之后再做出反应。
| 机制 | 变化的内容 | 表现形式 | 你该怎么做 |
|---|---|---|---|
| 采样 | 品牌列表、措辞和顺序 | 同一天对同一提示词给出不同答案 | 在多次运行中测量,并报告占比 |
| 检索 | 被引用的网址 | 每周引用的来源不同 | 强化那些检索效果好的页面和第三方来源 |
| 模型与索引更新 | 整体答案风格和被偏好的品牌 | 在特定日期出现阶跃变化 | 保留基线,并标注你能识别出的每次更新 |
可测量的数据仍然稀少,其中大多数来自 SEO 与 AI 可见度服务商。有两个来源值得仔细阅读。第一个是 SEO 平台 Authoritas 的一项研究,它比较了 AI Overviews 与自然结果。第二个是 BrightEdge 的一组测量,它比较了 AI Overviews 与 AI Mode。
Authoritas 用一个分数来衡量排名波动。分数越高,说明该时段内结果变化越大。对于 AI Overviews,8 周时分数为 0.68,13 周时为 0.73。对于自然结果,分别为 0.49 和 0.55。Digital Information World 于 2025 年 2 月报道了这项研究,并称大约 70% 的 AI Overviews 结果在两到三个月内发生了变化。该文章没有说明关键词样本或测量日期,因此在客户报告中引用这一数字之前,请先核对 Authoritas 的原始报告。
在 2 到 3 个月内发生变化的 AI Overviews 结果
来源:Authoritas 研究,由 Digital Information World 报道,2025 年 2 月
BrightEdge 从另一个角度测量了同一问题。它在 2025 年 8 月的分析中发现,AI Overviews 的品牌提及波动比 AI Mode 高 16.7%。它还发现,AI Overviews 有 24% 的网址保持不变,而 AI Mode 为 20%。下表将这些数字并列放置。
| 指标 | AI Overviews | 对比 | 来源 |
|---|---|---|---|
| 波动分数,8 周 | 0.68 | 自然结果为 0.49 | Authoritas |
| 波动分数,13 周 | 0.73 | 自然结果为 0.55 | Authoritas |
| 品牌提及波动 | 高 16.7% | 与 AI Mode 相比 | BrightEdge,2025 年 8 月 |
| 保持不变的网址 | 24% | AI Mode 为 20% | BrightEdge,2025 年 8 月 |
AI Overviews 会在部分查询的常规 Google 结果页面内出现。AI Mode 则是一个独立的、对话式界面。BrightEdge 的数据表明,AI Overviews 在它们提及的品牌上波动更大,而 AI Mode 保持稳定的网址更少。实践中的教训是分别检查每个界面。一个笼统的"Google AI"数字掩盖了这种差异,而这种差异恰恰是你需要规划的依据。我们对Google AI Mode 与 AI Overviews的比较,说明了每一种对 SEO 意味着什么。
关键在于,你不能假定自然结果的稳定性会延续到 AI 中。在 Authoritas 的数据中,自然结果的波动小于 AI Overviews,但它们也并非静止不动。一个连续一个月保持第三位的页面,在一次核心更新后仍可能下跌,因此你需要一种方法,在两个界面上都能把真实变化与正常波动区分开来。
大多数排名追踪工具是为 Google 设计的,在那里一个关键词对应一个有序列表,并且变化缓慢。把同样的逻辑应用于 AI 模型,就会得到一个基于单次样本的数字。如果你的品牌在一次运行中排第三,在下一次排第八,那么这两次的平均值几乎说明不了什么。一个声称"你在 ChatGPT 中排第 3"的工具,是把一次抽样当成了事实。我们的排名追踪指南介绍了经典方法,而本文解释当答案是被生成而不是被列出时,有哪些地方发生了改变。
SparkToro 的结论是,基于固定位置的排名追踪产品衡量的是噪声。研究建议追踪出现而非排名。研究认为,当出现率在数十到数百个提示词上测量、每个提示词运行多次时,它是一个合理的指标。在信任任何分数之前,请要求服务商展示样本量和得出分数的方法。
一个提示词、一张截图,还是测量出的占比
Google 自己的文档指向同一方向,只是理由不同。Google 表示,页面必须被索引,并且有资格以摘要片段的形式出现在搜索中,才能被用于 AI Overviews 或 AI Mode。它还表示,无需添加任何特殊标记或 AI 专用文件。并不存在可以优化的"AI 排名"设置,因此工作重点是在众多来源中保持存在感并获得信任,并诚实地衡量这种存在感。
以下方法需要几天时间搭建,之后每周只需几分钟维护。你可以在电子表格中运行它。专用工具主要帮你省去重复劳动,而不是省去思考。
五步测量方法
出现率是提及你品牌的答案占比。误差范围告诉你有多少变化是真实的。使用基于比例标准误差的 95% 误差范围:
visibility rate = answers that name your brand / total answers
standard error = sqrt(p x (1 - p) / n)     where p is the visibility rate and n the number of runs
95% margin of error = 1.96 x standard error
这是一个示意性的例子,数字是虚构的,并非实际测量。你的品牌在 80 次运行中出现了 37 次,因此出现率为 46%。标准误差为 5.6 个百分点,给出的 95% 误差范围约为 11 个百分点。应将结果报告为 46% 加减 11 个百分点。如果下一批显示为 40%,那就在该范围之内,并不意味着你需要重写页面。
一个品牌可能被提及但没有链接,有链接但未被推荐,或者在一句没有提到竞争对手的话中被推荐。应分别记录这些状态:提及并推荐、仅提及、仅被引用。它们的占比因不同原因而变化,每种状态需要不同的修正方式。只有引用没有提及,是来源问题。只有提及没有推荐,是定位问题。
你的第一份测量表
注意
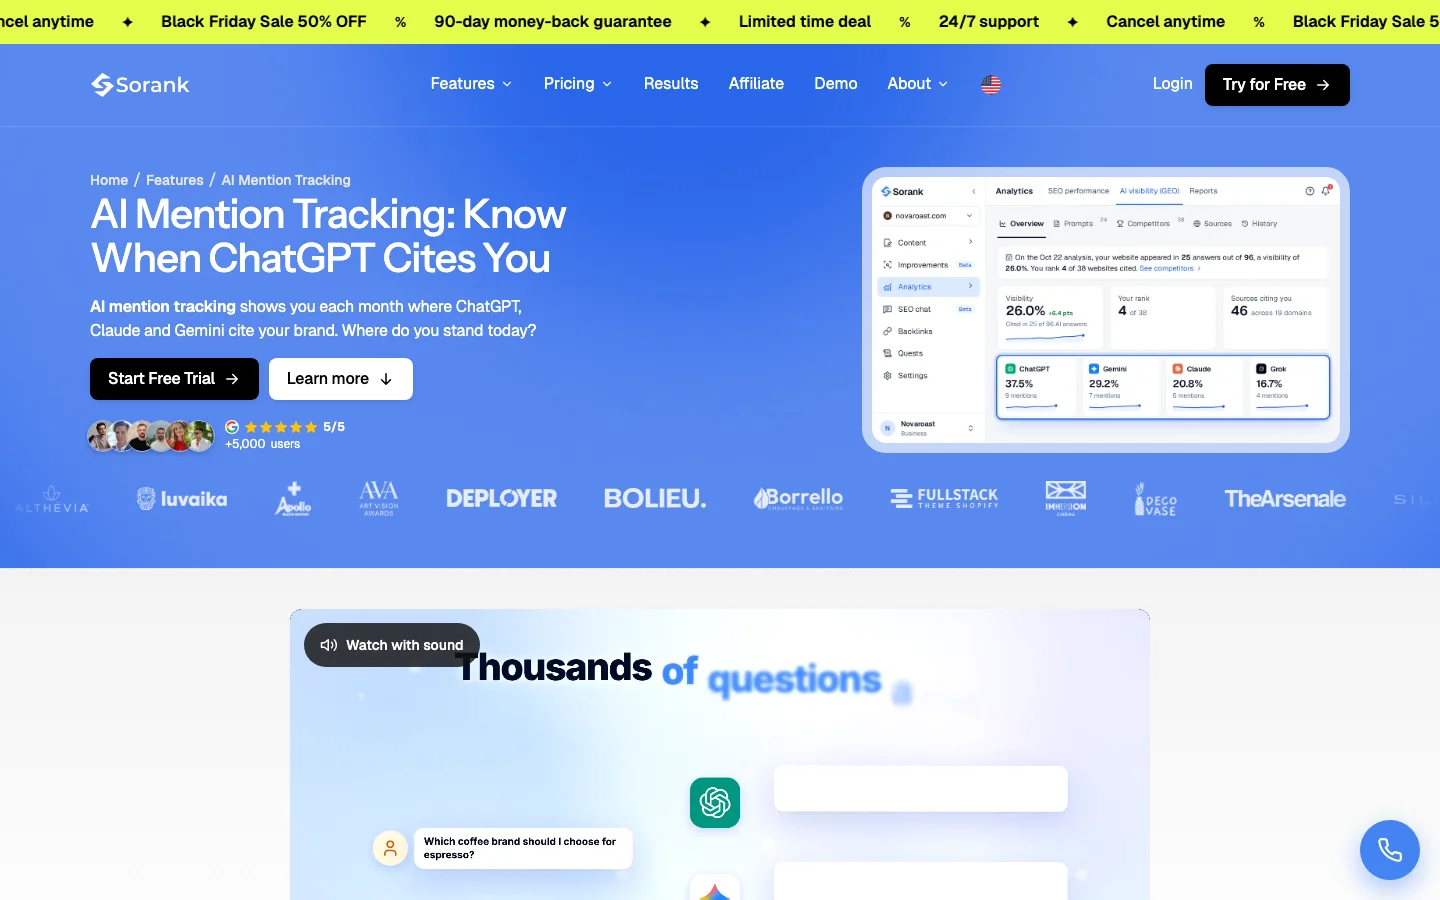
几周之后,手动重复每个提示词会变得单调乏味。Sorank 的 AI 提及追踪会针对你追踪的每个提示词,报告 ChatGPT、Claude 和 Gemini 提及你品牌的频率,并附上每个答案背后的来源和搜索。它每月运行一次,对单个提示词而言样本偏少,因此应结合数月的趋势阅读,并为最重要的提示词添加你自己的重复运行。
月度报告应回答一个问题:你的出现是否在变化,而且这种变化是否大于噪声?按提示词组展示出现率及其误差范围,而不是单一数字。加入位置分布,即在提及你品牌的答案中,它排在第一、第二或更靠后的频率,使顺序以分布的形式呈现,而不是一个排名。在平稳或上升趋势中出现起伏是正常的。连续数批的持续下降则不正常,在有人重写页面之前,应先检查提示词、模型发布说明以及被引用的来源。将行动规则写入报告本身:只有在连续两批中超过误差范围的变化,才算作真实变化。
你无法关闭波动,但可以让你的出现更加一致。当你的品牌在多个 AI 模型已经使用的来源中被以相同方式描述时,出现的稳定性就会增强。Google 的文档为其 AI 功能所需的内容提供了基础。
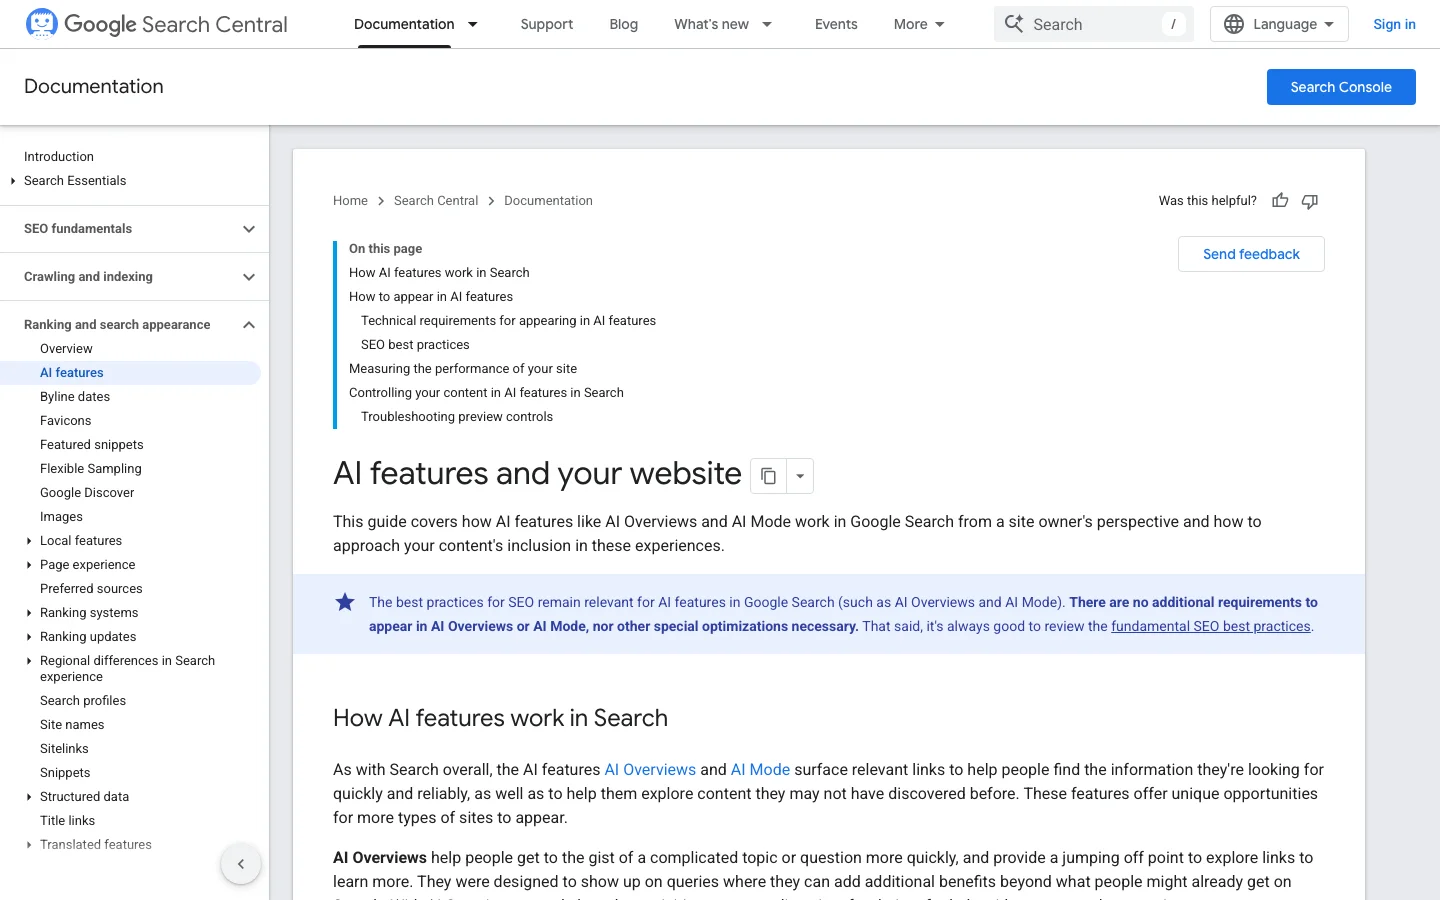
Google 关于 AI Overviews 和 AI Mode 的指导很简短。页面必须被索引,并且有资格显示摘要片段。标准的基础要求依然适用:允许抓取的 robots.txt 规则、内部链接、读者可见的文本内容,以及与可见文本相符的结构化数据。Google 表示,你无需新的机器可读文件、AI 文本文件或特殊架构就能出现在结果中。
AI 模型同时从多个地方构建对一个品牌的认知。如果你的名称、类别、主要用例和所在地在你的网站、个人资料和目录列表中各不相同,这幅画面就会模糊,品牌列表也会变得不稳定。撰写一段简短、客观的公司描述,包含类别和用例,并在你能控制文本的地方重复使用。每季度检查一次。
相互印证意味着多个独立来源对你说的是同一件事。评测、比较文章、行业目录和你所在领域的专业刊物是常见的场所。通过有用的工作赢得这些提及,例如原创数据、清晰的产品比较,或人们真正使用的工具。不要购买它们。付费展示会增加噪声,而且这种模式在付款停止后就会失效。
AI 模型提取的是段落,而不是整个页面。一个在第一段给出简短定义、直接回答核心问题并给出明确下一步的页面,更容易被提取,也更容易被准确引用。我们的 GEO 清单列出了每个页面应检查的要点。
品牌稳定性清单
团队应对波动通常有四种常见方式。每种都有其用途和局限。请把它们视为可以组合使用的选项,而不是最佳方案的排名。大多数团队会同时使用第一种和最后一种。
原则:每天查询一个提示词,并记录你的品牌在答案中的位置。适用时机:你希望在某个特定查询发生剧烈变化时获得早期预警。优点:熟悉、成本低,且容易绘制图表。局限:这是每天一个样本,无法区分真正的损失和普通的随机波动。示例:某提示词周一提到了你的品牌,周三却没有。图表显示下跌,但单次运行无法判断是失去了位置还是正常波动。
原则:对大量提示词进行多次运行,并报告提及你品牌的答案占比及其误差范围。适用时机:你需要一个用于报告的数字,或用于内容投资的决策。优点:与输出的生成方式相匹配,并给出一个范围,而不是虚假的单点。局限:需要更多运行,并且需要保持提示词集稳定的纪律性。示例:你的出现率在 80 次运行中为 46% 加减 11 个百分点。下个月为 52%。你可以说趋势在上升,但还不能说这是真正的收益,因此需要等待另一批数据。
原则:让同样准确的说法出现在多个独立来源上。适用时机:你的定位清晰,并希望得到经得起考验的推荐。优点:对 AI 回答和传统搜索都有帮助,且效果持久。局限:进展缓慢,通常一个月内难以看到结果。示例:一家软件公司的用例在两篇评测、一个比较页面和一个行业目录中都得到了描述,因此 AI 模型在不同提示词中都会重复相同的描述。
原则:更新那些回答你核心问题的页面,使答案清晰、准确并标注日期。适用时机:你的页面被引用但描述有误,或者本该引用你的页面却引用了竞争对手的页面。优点:操作快速,并能改善段落的提取效果。局限:更好的页面并不保证被提及,而且变化需要时间才能反映在你的数据中。示例:一个术语页面在顶部加入了一句话的定义、一张简短的对比表,并附上可见的更新说明,下一批测量就显示了正确的描述。
| 方法 | 它告诉你什么 | 信号稳定性 | 投入 | 最适合 |
|---|---|---|---|---|
| 每日排名 | 某一天的一个位置 | 低 | 低 | 发现单个查询的剧烈变化 |
| 多次运行的出现 | 提及你品牌的答案占比 | 高,带误差范围 | 中到高 | 报告与预算决策 |
| 相互印证 | 来源描述你的一致程度 | 数月内保持高 | 高 | 长期推荐 |
| 页面刷新 | 关键页面回答问题的效果 | 中 | 中 | 修正错误或缺失的描述 |
Google 自然结果和 AI 回答需要不同的工具。混为一谈会导致错误结论,因此在报告中应将它们分开。
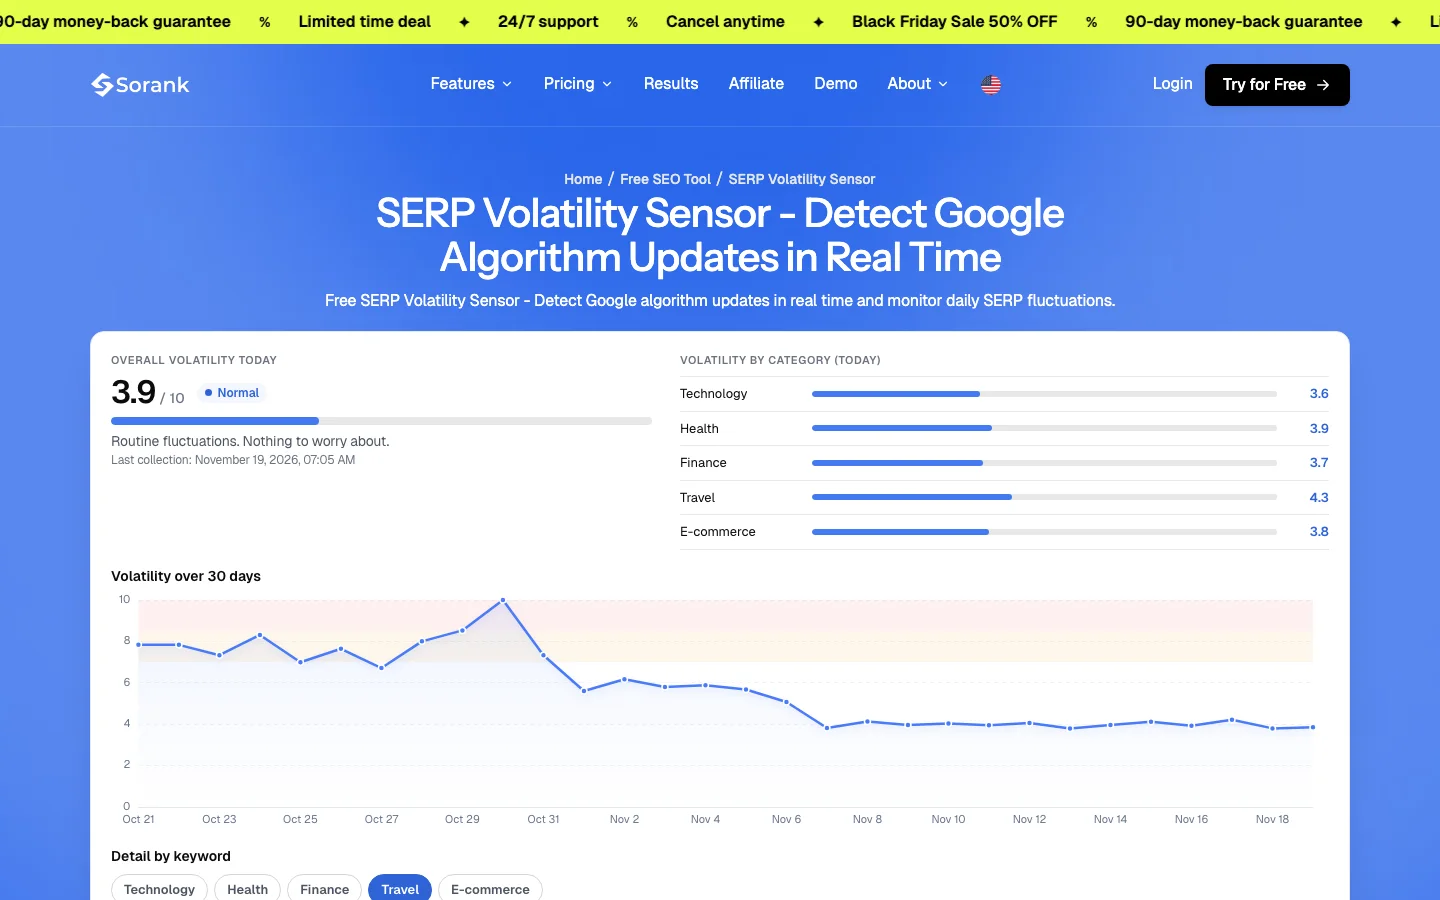
Sorank 的免费 SERP 波动传感器覆盖的是第一种。它每天早上收集美国市场五个行业中 20 个英文关键词的自然结果前 10 名,与前一天进行比较,并给出 0 到 10 的分数,包括总分和各行业分数。它显示 Google 首页的移动幅度,因此是算法变化的一个有用早期信号。但它不衡量 AI 回答,因此无法替代上面基于提示词的方法。关于 Google 这一部分,请阅读该传感器的专门页面,并将它与你的排名数据放在一起,而不是与你的 AI 可见度数字放在一起。
Search Console 和 Google Analytics 报告的是 Google 的点击和引荐访问。排名追踪工具报告的是 Google 上的位置。它们都无法显示哪些 AI 回答提到了你的品牌。为此,你需要记录下来的回答,或能够记录它们的工具。对于来自 AI 模型的访问,引荐部分在我们关于GEO 报告的指南中有所介绍。
大多数波动相关的错误,都源于把噪声当成了信号。下面每个错误都说明了它看起来如何、如何在你的数据中发现它,以及如何修正。
是什么:一张截图或一个答案,被当作你的排名来展示。如何发现:报告中显示了一个位置,却没有样本量、日期范围或误差范围。如何修正:报告每个提示词至少 30 次运行的出现率,并附上误差范围和日期范围。
是什么:在两次检查之间改写提示词,例如一周用"best CRM",下一周用"best CRM for startups",然后把结果当作趋势来解读。如何发现:同一行在两个日期的提示词文本不同。如何修正:冻结并为提示词集做版本管理。新提示词作为新行添加,绝不编辑旧提示词。
是什么:因为下降了五个百分点就重写页面。如何发现:变化小于该提示词的误差范围。如何修正:只有当变化在连续两批中超过误差范围时才采取行动,并记录同一时期的其他变化,例如模型更新或竞争对手发布。
是什么:把每一个指向你网站的链接都记为胜利,即使答案把你的品牌列为应避免的选项,或只是一个脚注。如何发现:没有人阅读引用周围的句子。如何修正:分别记录三种状态(提及并推荐、仅提及、仅被引用),并在勾选之前阅读句子。
是什么:营销团队为报告而编写的提示词。如何发现:提示词使用了客户从不使用的内部产品名称或行话。如何修正:从销售通话、客服对话和 Search Console 查询中获取提示词,并与真实客户核对其中一部分。
是什么:假定出现率更高就会自动带来更多访问。如何发现:出现率上升,而引荐会话保持平稳。如何修正:单独衡量引荐访问,检查哪些 AI 模型和哪些页面带来了访问,并在一份月度报告中将两组数据连接起来。
是什么:启动一个项目来制作 AI 文本文件或新的标记,期望它能触发引用。如何发现:该项目没有检查索引或摘要片段资格。如何修正:从 Google 的指导开始。确认关键页面已被索引并有资格显示摘要片段,然后在其他事情之前先修复文本和内部链接。
| 错误 | 在你数据中的迹象 | 修正 |
|---|---|---|
| 单次运行被当作结果 | 没有样本量或误差范围 | 报告至少 30 次运行的占比 |
| 检查之间修改提示词 | 同一行,文本不同,日期不同 | 冻结并为提示词集做版本管理 |
| 对误差范围内的变化反应过度 | 变化小于误差范围 | 只针对连续数批都存在的变化采取行动 |
| 把引用当作推荐 | 没有阅读周围的句子 | 分别记录三种状态 |
| 没人输入的提示词 | 提示词列表中有内部行话 | 从真实客户的语言中提取提示词 |
| 把可见度当作流量 | 可见度上升而引荐持平 | 单独衡量引荐 |
你不需要完整的方案就能开始。第一周的重点是建立测量体系,让之后六个月的数据可以读懂。请按顺序完成以下步骤。
你的第一周
一旦你有了基线,波动就不再是焦虑的来源。它会变成一个可以测量的范围,以及一组可以据此规划的变化。
语言模型从概率分布中选择每个词,因此同一提示词可能产生不同的措辞、品牌列表和顺序。检索也会变化,因为 AI 模型会把问题改写成子查询,而它检索到的页面可能在不同运行之间有所不同。
Authoritas 测得 AI Overviews 在 8 周时的波动分数为 0.68,13 周时为 0.73,而自然结果分别为 0.49 和 0.55。SparkToro 发现,ChatGPT 或 Google 的 AI 两次返回相同品牌列表的概率不到 100 分之 1。
AI 答案中的单一位置太不稳定,无法据此行动。应跟踪你的品牌在大量提示词和运行中出现的频率,将该占比以百分比报告并附上误差范围,同时对 Google 自然结果保留经典的排名追踪,因为那里的位置变化更慢。
我们免费分析您的竞争对手、网站和 AI 可见度,为您制定专属内容计划。
 AI 内容简报生成器
 FAQ 结构化数据生成器
 AI 文章选题生成器
 结构化数据验证工具(Schema 验证器)
 图片替代文本检查工具
 内部链接分析工具
 外链挑战
 AI meta 描述生成器
 AI 博客标题生成器
 Google 可收录性检查工具
 AI 文章大纲生成器
 UTM 链接生成器
 关键词聚类工具
 规范标签检查工具
 XML 站点地图生成器
 死链检查工具
 AI SEO 标题生成器
 标题评分工具
 搜索结果预览工具
 重定向检查工具
 hreflang 标签生成器
 标题结构分析工具
 HTTP 响应头检测工具
 Favicon 提取工具
 SEO 流量与收入预测计算器
 SEO 预算计算器
 排名提升模拟器
 关键词机会得分计算器
 GEO 内容投入计算器
 客户终身价值计算器
 点击率计算器
 AI 流量价值计算器
 AI 声量份额计算器
 Gemini 排名查询工具
 ROAS 计算器
 自然流量价值计算器
 本地 SEO 投资回报计算器
 外链建设成本计算器
 关键词密度计算器
 客户获取成本计算器
 单篇文章成本计算器
 跳出率计算器
 AI 引用率计算器
 结构化数据大语言模型审计
 llms.txt 生成器
 站点地图检查工具
 SERP 波动监测器
 字数统计工具
 结构化数据生成器
 关键词研究工具
 SEO 盈亏平衡计算器
 阅读时长计算器
 自然流量预估工具与网站流量查询
 ChatGPT 引荐流量估算器
 AI 曝光度得分计算器
 LLM 可读性检查器
 SearchGPT 就绪度检测工具
 ChatGPT 为什么不推荐我的网站
 URL 提取工具
 网页转 Markdown
 Robots 生成器
 OG 预览
 页面 SEO 审核:SEO 检查与 SEO 分析工具
 LTV 与 CAC 比率计算器
 GEO 回报率计算器
 转化率计算器
 网站可抓取性 AI 审计
 AI 搜索曝光度测试
 页面体积检测工具
 URL Slug 生成器
 Meta 标签生成器
 图片压缩工具
 网站图标生成器
 域名权重查询工具
 SERP 点击率计算器
 电商 SEO 投资回报率计算器
 内容营销投资回报率计算器
 AI 隐形成本计算器
 AI Overview 检查工具与 AI Overviews 排名检查
 Robots.txt 检查工具
 AI SEO 审核
 Perplexity 引用检测工具
 回答引擎优化审核
 ChatGPT 可见度检测工具
 外链分析工具
 SEO 与付费搜索省钱计算器
 SEO 声量占比计算器
 SaaS SEO ROI 计算器
 反向链接投资回报率计算器
 llms.txt 验证器
 LLM 引用检查器
 GEO 审核
 SEO ROI 计算器
 关键词价值计算器
 “两年来,我 100% 的客户都来自 LinkedIn。每天发帖、评论、私信跟进……完全依赖算法。我知道自己需要做 SEO,但总是往后拖:太花时间、太技术、不是我的本行。有了 Sorank,我终于迈出了这一步。4 个月里,我在什么都不发的情况下每月获得 15 个自然线索。目前还没有做到和 LinkedIn 各占一半,但知道自己现在有了第二个能自动增长的线索来源,我睡得更踏实了。”

 Valentin Thomyoffbound.fr
 “我是开发者,不是做市场的。我的 Shopify 主题此前只靠口碑和广告在卖。有了 Sorank,我终于明白该如何搭建自己的 SEO,以及怎样写出能获得排名的文章。审计发现我的产品页面太慢了。两个月内,我的自然流量翻了一倍,当人们搜索 Shopify 主题时,我也开始出现在 ChatGPT 的回答里。而这一切每周只花大约 2 小时。”
 Thème FullStackgo.themefullstack.com
 “对市场营销机构来说是个很棒的工具!用它来审计网站、找出加载慢的页面、确定需要补充哪些内容以及补在哪里,都非常快。”
 Thomas Giraudthe-deployer.fr“我们是一家广告代理商,想要一劳永逸地把 SEO 重新做起来。Sorank 让我们清楚地看到自己网站的情况,帮助我们排定优化的优先级,并把内容结构梳理好。这个工具易于使用,很适合团队,而且非常实用,可以集中跟踪,不用在多个平台之间来回切换。这是我们重新开始做 SEO 的一个非常扎实的基础。”
 Gaspard Madoui广告代理商