Præferencer
Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information
Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information

Hvorfor AI-svar ændrer sig ved hver kørsel, hvor meget de bevæger sig, og hvordan du måler dit brands tilstedeværelse over mange prompts i stedet for én rangering.

Værktøjer

In short
AI-søgevolatilitet er, hvor meget brands, webadresser og rækkefølgen i et AI-svar ændrer sig fra et kørsel til det næste og fra en uge til den næste. Det samme spørgsmål kan give en anden brandliste, andre kilder og en anden rækkefølge, fordi svaret genereres med tilfældighed, og hentningstrinnet ændrer sig også. En plads inde i et AI-svar er derfor en dårlig måleenhed. Mål, hvor ofte dit brand optræder på tværs af mange prompts og mange kørsler, og byg derefter de kilder, der gør din tilstedeværelse stabil.
Vil du vide mere? Spørg
Hurtig quiz
Hvordan får du nævnt af ChatGPT og andre AI-assistenter?
Sorank matcher dine svar


Test det i 3 dage på dit eget site, og se, hvor du står på Google, ChatGPT og de andre AI'er.
Start prøveperiode på 3 dage3 dage gratis, derefter stopper du, når du vil. 90 dages resultatgaranti, betingelser gælder.
I den organiske Google-søgning betyder volatilitet, at din placering for et søgeord går op og ned. I AI-søgning er det mere end som så. Selve svaret er forskelligt ved hver kørsel. Et volatilt AI-svar kan ændre sig på tre måder: hvilke brands det nævner, hvilke webadresser det citerer, og i hvilken rækkefølge de står. Hvad som helst af det kan flytte sig uden én eneste ændring på din hjemmeside.
Forskellen betyder noget, fordi en rangering er et fast output for et bestemt øjeblik. Google returnerer en ordnet liste, og for den samme forespørgsel på det samme marked er listen for det meste gentagelig. En AI-model returnerer ét udsnit af en række mulige svar. Dit brand har en sandsynlighed for at optræde i det spænd. Den sandsynlighed er det, du kan måle, og det er det, du kan flytte.
To tal fra en undersøgelse offentliggjort i 2026 viser, hvor stor effekten er. Rand Fishkin fra SparkToro arbejdede sammen med Patrick O'Donnell fra Gumshoe.ai. Omkring 600 frivillige kørte 12 prompts gennem ChatGPT, Claude og Googles AI, i alt 2961 kørsler. Forskerne fandt under 1 chance ud af 100 for, at ChatGPT eller Googles AI returnerer den samme brandliste to gange. Chancen for den samme brandliste i samme rækkefølge var omkring 1 ud af 1000 kørsler. SparkToro-rapporten, dateret 28. januar 2026, dækker data indsamlet i november og december 2025.
Hvor stabile er AI's brandlister?
Kilde: SparkToro og Gumshoe.ai, januar 2026
Når du accepterer, at output er et udsnit, skal måden, du følger det på, ændre sig. Sammenligningen nedenfor opsummerer de to tankegange. Den er kernen i hele denne guide.
At følge en rangering kontra at følge tilstedeværelse
Den mest synlige ændring er selve brandlisten. En prompt som "bedste projektstyringsværktøj til et team på 10 personer" kan nævne fem brands i én kørsel og fem andre i den næste. Nogle brands kommer igen ofte, andre skifter ind og ud. Tilstedeværelse på listen er mere stabil end placeringen på listen, og det er grunden til, at forskerne anbefaler at følge tilstedeværelse frem for rangering.
Det har en praktisk konsekvens. Hvis du tjekker en prompt én gang og ser dit brand på andenpladsen, ved du næsten ingenting. Hvis du tjekker den 60 gange og ser dit brand i 40 af svarene, ved du noget brugbart: du er et fast valg til det spørgsmål.
Citeringer er de links, en AI-model viser som kilder. De flytter sig endnu mere end brandlisten, når modellen laver en live websøgning, fordi hver kørsel kan hente et andet sæt sider. En citering, der forsvinder, er ikke altid et tab. Dit brand kan stadig nævnes i teksten uden link. Derfor bør du følge to ting adskilt: den navngivne omtale og den citerede URL.
Placeringen inde i et svar er det mest ustabile element. En AI-model kan nævne dit brand først i én kørsel og fjerde i den næste, uden at dens syn på dig reelt har ændret sig. Behandl rækkefølgen som støj, medmindre den bevæger sig i samme retning over snesevis af kørsler.
Tre mekanismer står for det meste af ændringen. Du kan ikke slå dem fra, men hvis du kender dem, ved du, hvad du skal måle, og hvad du kan ignorere.
En sprogmodel vælger ikke ét bedste svar. Den vælger hvert næste ord ud fra en sandsynlighedsfordeling. En indstilling, der kaldes temperatur, styrer, hvor bredt valget er. Ved en lav værdi er output tættere på at være gentageligt, og ved en høj værdi varierer det mere. Udviklere kan sætte temperatur i en API, men de forbrugerapps, de fleste af dine købere bruger, eksponerer den ikke. Antag, at sampling altid er slået til. SparkToro-frivillige beholdt deres sædvanlige indstillinger, personaliserede eller standard, og derfor beskriver deres resultater, hvad en almindelig bruger ser.
Når en AI-model søger på nettet, sender den ikke dit præcise spørgsmål til en søgemaskine. Den omskriver spørgsmålet til flere delforespørgsler og henter sider for hver enkelt. En lille ændring i ordlyden, en side indekseret den morgen eller et andet resultat for én delforespørgsel kan ændre, hvilke kilder der når det endelige svar. De URL'er, du bliver citeret fra, er output fra et hentningstrin, der flytter sig. Vores guide om hvordan AI-modeller vælger deres kilder forklarer mekanikken, og Sorank's værktøj til, hvad AI faktisk søger efter, er bygget netop til det spørgsmål.
Udbydere opdaterer modeller og systemerne omkring dem uden særlig varsling. En ny modelversion, en ændring i hvornår en AI-model beslutter at søge, eller et skift i webindekset kan ændre svarene for et helt emne på én dag. Når dine data viser et pludseligt spring, så tjek først efter en sandsynlig opdatering, og sammenlign derefter med din baseline, før du reagerer.
| Mekanisme | Hvad der flytter sig | Sådan viser det sig | Hvad du gør |
|---|---|---|---|
| Sampling | Brandliste, formulering og rækkefølge | Forskellige svar på samme prompt samme dag | Mål over mange kørsler og rapporter en andel |
| Hentning | Citerede URL'er | Forskellige kilder citeres fra en uge til den næste | Styrk de sider og tredjepartskilder, der henter godt |
| Model- og indeksopdateringer | Hele svarstilen og hvilke brands der favoriseres | Et spring på en bestemt dato | Behold en baseline og notér hver opdatering, du kan identificere |
Målte tal er stadig sjældne, og de fleste kommer fra leverandører af SEO og AI-synlighed. To kilder er værd at læse nøje. Den første er en undersøgelse fra SEO-platformen Authoritas, som sammenlignede AI-oversigter med organiske resultater. Den anden er målinger fra BrightEdge, som sammenlignede AI-oversigter med AI Mode.
Authoritas målte rangeringsvolatilitet med en score. Jo højere score, desto mere ændrede resultaterne sig i perioden. For AI-oversigter var scoren 0,68 efter 8 uger og 0,73 efter 13 uger. For organiske resultater var den 0,49 og 0,55. Digital Information World, som omtalte undersøgelsen i februar 2025, skrev også, at omkring 70 % af AI-oversigtsresultaterne ændrede sig inden for to til tre måneder. Artiklen oplyste ikke søgeordsudvalget eller målingsdatoerne, så tjek den oprindelige Authoritas-rapport, før du citerer et tal i en kundepræsentation.
AI-oversigtsresultater, der ændrede sig inden for 2 til 3 måneder
Kilde: Authoritas-undersøgelse, omtalt af Digital Information World, februar 2025
BrightEdge målte det samme spørgsmål fra en anden vinkel. Deres analyse fra august 2025 fandt 16,7 % mere volatilitet i brandomtaler for AI-oversigter end for AI Mode. Den fandt også, at AI-oversigter holdt 24 % af deres URL'er uændrede, mod 20 % for AI Mode. Tabellen sætter tallene side om side.
| Mål | AI-oversigter | Sammenligning | Kilde |
|---|---|---|---|
| Volatilitetsscore, 8 uger | 0,68 | 0,49 for organiske resultater | Authoritas |
| Volatilitetsscore, 13 uger | 0,73 | 0,55 for organiske resultater | Authoritas |
| Volatilitet i brandomtaler | 16,7 % højere | Sammenlignet med AI Mode | BrightEdge, august 2025 |
| Uændrede URL'er | 24 % | 20 % for AI Mode | BrightEdge, august 2025 |
AI-oversigter vises inde på den almindelige Google-resultatside for en delmængde af forespørgsler. AI Mode er en separat, samtalelignende grænseflade. BrightEdge-tallene tyder på, at AI-oversigter svinger mere i, hvilke brands de nævner, mens AI Mode holder færre af sine URL'er stabile. Den praktiske lære er at kontrollere hver flade for sig. Et enkelt "Google AI"-tal skjuler forskellen, og netop forskellen er det, du skal planlægge efter. Vores sammenligning af Google AI Mode og AI-oversigter dækker, hvad hver af dem betyder for SEO.
Pointen er, at du ikke kan antage, at organisk stabilitet følger med. Organiske resultater er mindre volatile end AI-oversigter i Authoritas' data, men de står ikke stille. En side, der holder position 3 i en måned, kan stadig falde efter en core update, så du har brug for en metode, der skelner reel ændring fra almindelig bevægelse på begge flader.
De fleste rangeringsværktøjer blev bygget til Google, hvor et søgeord har én ordnet liste, der ændrer sig langsomt. Anvendt på en AI-model giver den samme logik et tal baseret på ét udsnit. Hvis dit brand er tredje i én kørsel og ottende i den næste, siger et gennemsnit af de to næsten ingenting. Et værktøj, der rapporterer "du er nummer 3 i ChatGPT", præsenterer ét træk som et faktum. Vores guide til rangeringsmåling dækker den klassiske metode, og denne artikel forklarer, hvad der ændrer sig, når svaret genereres i stedet for at blive listet.
SparkToro-konklusionen er, at rangeringsprodukter baseret på faste placeringer måler støj. Rådet fra undersøgelsen er at følge tilstedeværelse frem for rangering. Den kalder en synlighedsprocent et rimeligt mål, når den måles på tværs af snesevis til hundredvis af prompts, hver kørt flere gange. Bed enhver leverandør om at vise stikprøvestørrelsen og metoden bag en score, før du stoler på den.
Én prompt, ét skærmbillede kontra en målt andel
Googles egen dokumentation peger i samme retning, af en anden grund. Google siger, at en side skal være indekseret og berettiget til at optræde i søgningen med et uddrag for at blive brugt i AI-oversigter eller AI Mode. Den siger også, at der ikke findes nogen særlig markup eller AI-specifik fil at tilføje. Der er ingen indstilling for "AI-rangering" at optimere, så arbejdet består i at være til stede og betroet på tværs af mange kilder, og at måle den tilstedeværelse ærligt.
Metoden nedenfor tager et par dage at opsætte og et par minutter om ugen at vedligeholde. Du kan køre den i et regneark. Dedikerede værktøjer sparer mest gentagelsen, ikke tænkningen.
Målemetoden i fem trin
Synlighedsraten er andelen af svar, der nævner dit brand. Fejlmargenen viser, hvor meget af en ændring der er reel. Brug en fejlmargen på 95 % baseret på andelens standardfejl:
synlighedsrate = svar, der nævner dit brand / alle svar
standardfejl = kvadratroden af (p x (1 - p) / n)     hvor p er synlighedsraten og n antallet af kørsler
fejlmargen på 95 % = 1,96 x standardfejl
Her er et illustrativt eksempel med opdigtede tal, ikke en måling. Dit brand optræder i 37 af 80 kørsler, så synlighedsraten er 46 %. Standardfejlen er 5,6 procentpoint, hvilket giver en fejlmargen på 95 % på omkring 11 procentpoint. Rapportér resultatet som 46 % plus eller minus 11 procentpoint. Hvis næste batch viser 40 %, ligger det inden for intervallet, og det er ikke et signal om at omskrive dine sider.
Et brand kan nævnes uden link, linkes uden at blive anbefalet, eller anbefales i en sætning, der aldrig nævner en konkurrent. Log disse tilstande adskilt: nævnt og anbefalet, kun nævnt og kun citeret. Deres andele flytter sig af forskellige grunde, og hver kræver en anden rettelse. En citering uden omtale er et kildeproblem. En omtale uden anbefaling er et positioneringsproblem.
Dit første målearket
Bemærk
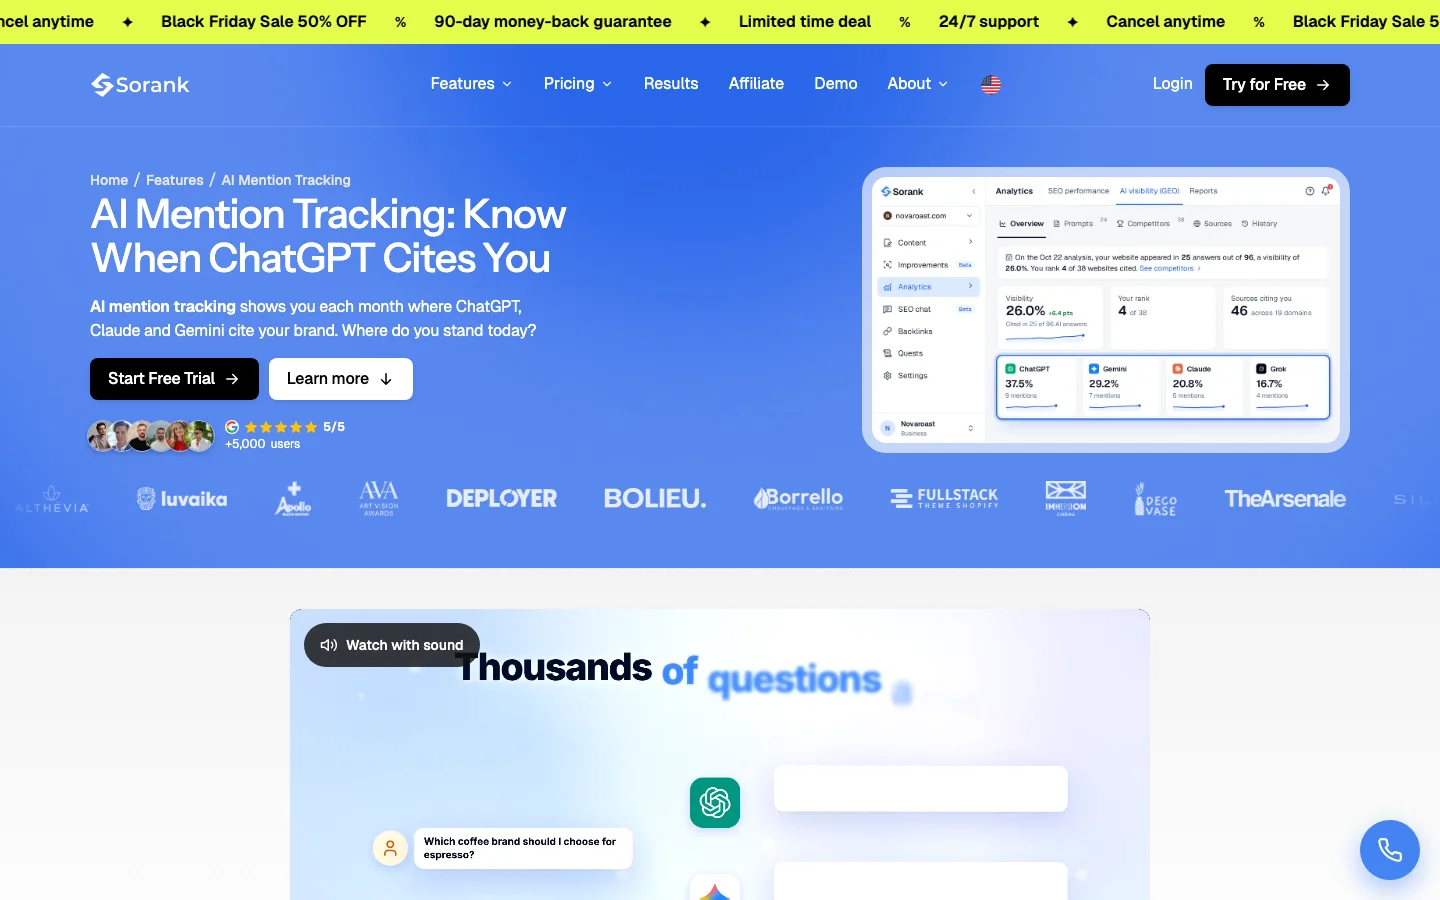
At gentage hver prompt i hånden bliver kedeligt efter nogle uger. Sorank's AI Mention Tracking viser for hver prompt, du følger, hvor ofte ChatGPT, Claude og Gemini nævner dit brand, med kilderne og søgningerne bag hvert svar. Kørslen er månedlig, hvilket er en tynd stikprøve for én prompt, så læs tendensen over flere måneder, og tilføj dine egne gentagne kørsler for de prompts, der betyder mest.
En månedlig rapport bør besvare ét spørgsmål: bevæger din tilstedeværelse sig, og er bevægelsen større end støjen? Vis synlighedsraten pr. promptgruppe med dens fejlmargen, ikke ét enkelt tal. Tilføj placeringsfordelingen, altså hvor ofte dit brand står først, andet eller lavere i de svar, hvor det nævnes, så rækkefølgen vises som en spredning frem for en rangering. At svinge op og ned omkring en flad eller stigende tendens er normalt. Et jævnt fald over flere batcher er det ikke, og det fortjener et tjek af prompts, modellens udgivelsesnoter og de citerede kilder, før nogen omskriver en side. Skriv handlingsreglen ind i selve rapporten: en ændring tæller kun som reel, når den overstiger fejlmargenen i to batcher i træk.
Du kan ikke slå volatilitet fra, men du kan gøre din tilstedeværelse mere konsistent. Tilstedeværelse vokser, når dit brand beskrives ens på flere kilder, som AI-modeller allerede bruger. Googles dokumentation giver udgangspunktet for, hvad dets egne AI-funktioner kræver.
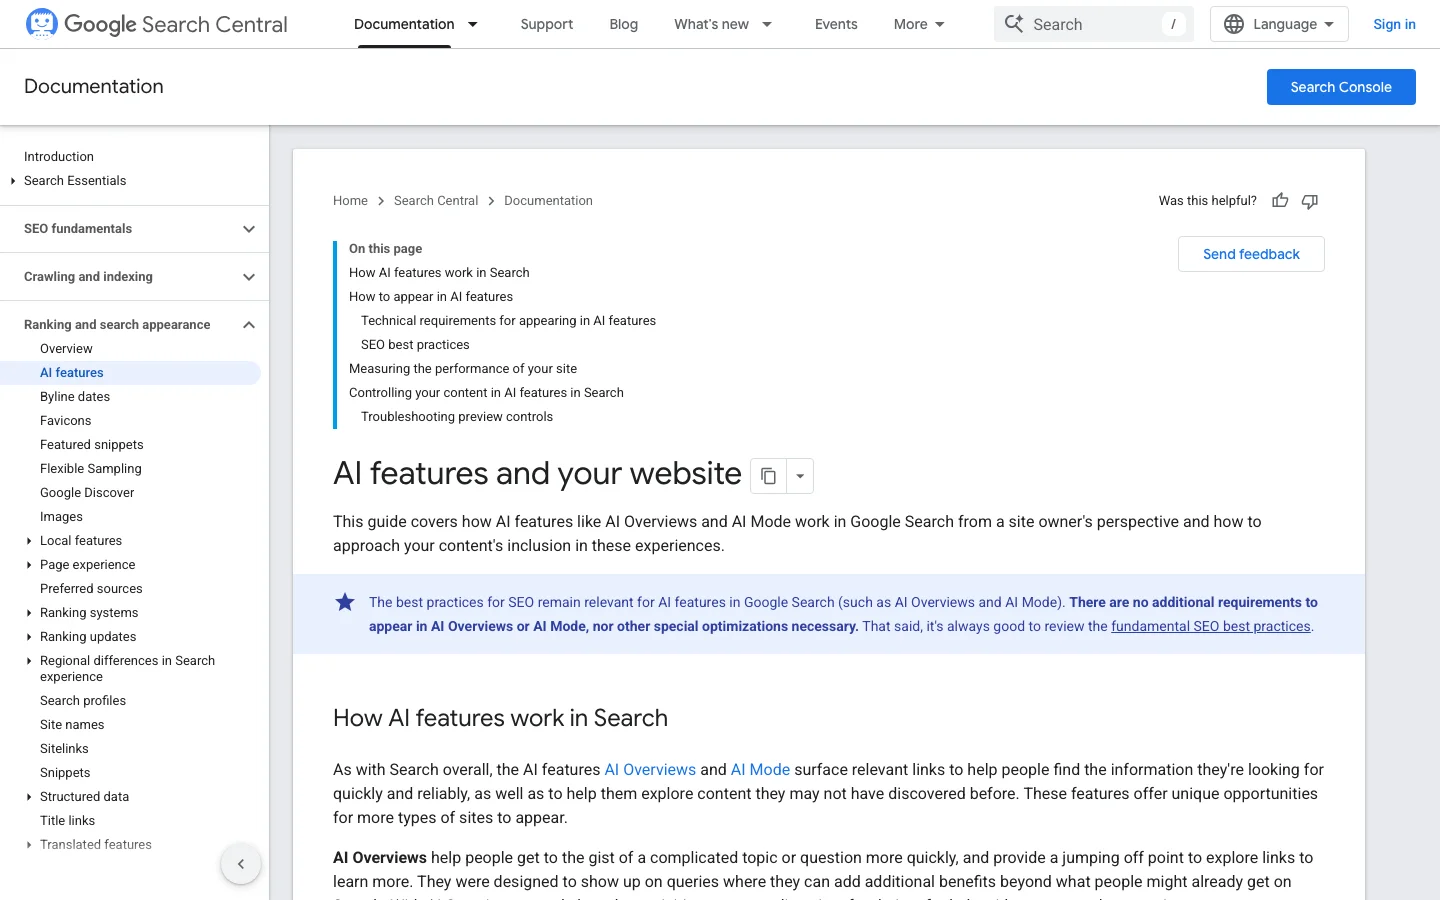
Googles vejledning om AI-oversigter og AI Mode er kort. En side skal være indekseret og berettiget til at vise et uddrag. De grundlæggende principper gælder stadig: robots.txt-regler, der tillader crawling, interne links, tekstindhold der er synligt for læsere, og struktureret data, der stemmer overens med den synlige tekst. Google siger, at du ikke behøver nye maskinlæsbare filer, AI-tekstfiler eller særligt skema for at optræde.
AI-modeller bygger et billede af et brand ud fra mange steder samtidig. Hvis dit navn, din kategori, dit hovedbrugsscenarie og din placering adskiller sig mellem din hjemmeside, dine profiler og dine kataloglister, bliver billedet utydeligt, og brandlisten bliver mindre stabil. Skriv en kort, faktuel beskrivelse af virksomheden med kategori og brugsscenarier, og genbrug den, hvor du kan styre teksten. Kontroller den hvert kvartal.
Bekræftelse betyder, at flere uafhængige kilder siger det samme om dig. Anmeldelser, sammenligningsartikler, branchekataloger og fagmedier i din niche er de sædvanlige steder. Optjen disse omtaler gennem brugbart arbejde, som originale data, en klar produktsammenligning eller et værktøj folk faktisk bruger. Køb dem ikke. Betalte placeringer tilføjer støj, og det er den slags mønster, der bryder sammen, så snart betalingerne stopper.
AI-modeller udtrækker afsnit, ikke hele sider. En side, der giver en kort definition i første afsnit, et direkte svar på hovedspørgsmålet og et klart næste skridt, er lettere at udtrække og lettere at citere korrekt. Vores GEO-tjekliste viser, hvad du skal kontrollere på hver side.
Tjekliste for brandets stabilitet
Teams reagerer på volatilitet på fire almindelige måder. Hver har en anvendelse og en begrænsning. Læs dem som muligheder, du kan kombinere, ikke som en rangering af den bedste. De fleste teams ender med at bruge den første og den sidste sammen.
Princip: forespørg én prompt hver dag og registrér dit brands placering i svaret. Hvornår du bruger det: du vil have en hurtig tidlig advarsel, når en bestemt forespørgsel ændrer sig kraftigt. Fordele: det er velkendt, billigt og let at tegne i en graf. Begrænsninger: det er ét udsnit pr. dag, og det kan ikke skelne et reelt tab fra en almindelig tilfældig variation. Eksempel: en prompt nævner dit brand på mandag, men ikke på onsdag. Grafen viser et fald, men en enkelt kørsel kan ikke afgøre, om det er en tabt placering eller normal variation.
Princip: kør mange prompts mange gange og rapportér andelen af svar, der nævner dit brand, med fejlmargen. Hvornår du bruger det: du har brug for et tal til rapportering eller en beslutning om indholdsinvesteringer. Fordele: det matcher, hvordan output genereres, og giver et interval i stedet for et falsk punkt. Begrænsninger: det koster flere kørsler, og det kræver disciplin at holde promptsættet stabilt. Eksempel: din synlighedsrate er 46 % plus eller minus 11 procentpoint over 80 kørsler. Næste måned er den 52 %. Du kan sige, at tendensen er op, men du kan ikke endnu sige, at det er en reel gevinst, så du venter på endnu en batch.
Princip: få de samme korrekte påstande til at optræde på flere uafhængige kilder. Hvornår du bruger det: din positionering er klar, og du vil have anbefalinger, der holder. Fordele: det hjælper i AI-svar og i traditionel søgning, og effekten varer ved. Begrænsninger: det er langsomt, og det viser sjældent et resultat inden for en måned. Eksempel: en softwarevirksomhed får sine brugsscenarier beskrevet i to anmeldelser, en sammenligningsside og et branchekatalog, så AI-modeller gentager den samme beskrivelse på tværs af forskellige prompts.
Princip: opdatér de sider, der besvarer dine hovedspørgsmål, så svaret er klart, korrekt og dateret. Hvornår du bruger det: din side bliver citeret, men beskrevet forkert, eller en konkurrents side bliver citeret, hvor din burde være. Fordele: det er hurtigt at gøre og forbedrer, hvordan afsnit udtrækkes. Begrænsninger: en bedre side garanterer ikke en omtale, og ændringer tager tid at vise sig i dine data. Eksempel: en ordliste-side får en definition på én sætning øverst, en kort sammenligningstabel og en synlig opdateringsnote, og næste målebatch viser den korrekte beskrivelse.
| Metode | Hvad den viser | Signalets stabilitet | Indsats | Bedst til |
|---|---|---|---|---|
| Daglig rangering | Én placering på én dag | Lav | Lav | At spotte et skarpt skift på én forespørgsel |
| Tilstedeværelse på tværs af kørsler | Andel af svar, der nævner dit brand | Høj, med fejlmargen | Mellem til høj | Rapportering og budgetbeslutninger |
| Bekræftelse | Hvor ens kilderne beskriver dig | Høj over måneder | Høj | Langsigtede anbefalinger |
| Sideopdatering | Hvor godt dine nøglesider besvarer spørgsmålet | Middel | Middel | At rette en forkert eller manglende beskrivelse |
Organiske Google-resultater og AI-svar kræver forskellige instrumenter. Hvis du blander dem sammen, drager du forkerte konklusioner, så hold dem adskilt i din rapportering.
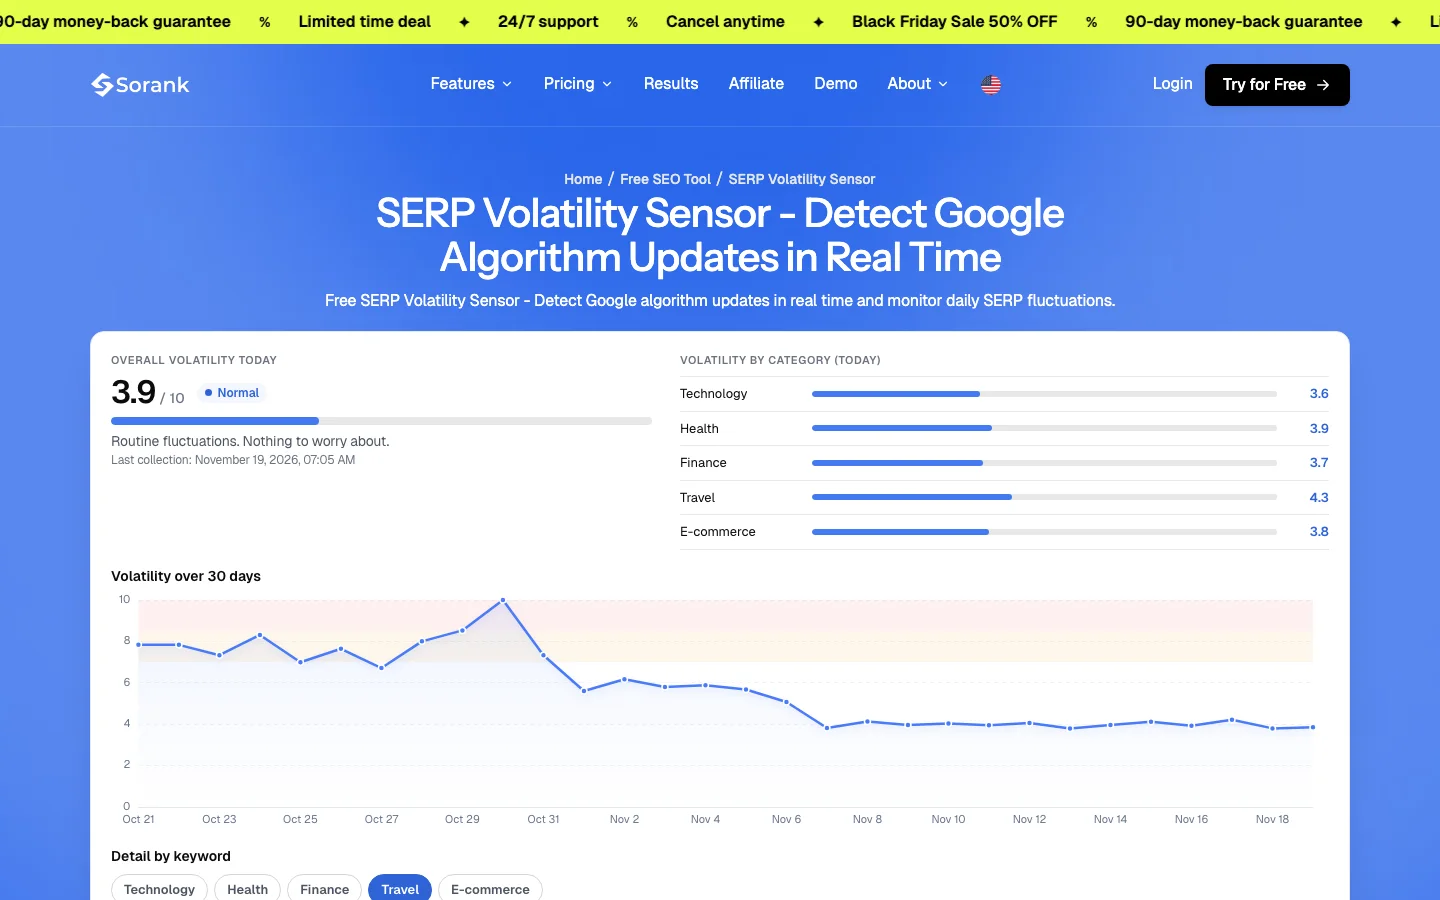
Sorank's gratis SERP Volatility Sensor dækker den første type. Hver morgen indsamler den de ti øverste organiske resultater for 20 engelsksprogede søgeord i USA på tværs af fem brancher, sammenligner dem med dagen før og giver en score fra 0 til 10, samlet og pr. branche. Den viser, hvor meget den første side på Google bevægede sig, hvilket gør den til et nyttigt tidligt signal om algoritmeændringer. Den måler ikke AI-svar, så den erstatter ikke den promptbaserede metode ovenfor. For Google-siden af spørgsmålet, læs sensoren på sin egen side, og hold den ved siden af dine rangeringsdata frem for ved siden af dine AI-synlighedstal.
Search Console og Google Analytics rapporterer Google-klik og henvisningsbesøg. Et rangeringsværktøj rapporterer placeringer på Google. Ingen af dem viser, hvilke AI-svar der nævnte dit brand. Til det har du brug for logget svar eller et værktøj, der logger dem. For besøg, der kommer fra AI-modeller, er henvisningssiden dækket i vores guide til GEO-rapportering.
De fleste volatilitetsfejl kommer af, at støj læses som signal. Hver fejl nedenfor viser, hvordan den ser ud, hvordan du opdager den i dine data, og hvordan du retter den.
Hvad det er: ét skærmbillede eller ét svar præsenteret som din placering. Sådan opdager du det: rapporten viser en placering uden stikprøvestørrelse, datointerval eller fejlmargen. Sådan retter du det: rapportér synlighedsraten over mindst 30 kørsler pr. prompt, med fejlmargen og datointervallet.
Hvad det er: at omformulere en prompt mellem to kontroller, for eksempel "bedste CRM" en uge og "bedste CRM til startups" den næste, og derefter læse resultatet som en tendens. Sådan opdager du det: promptteksten i regnearket er forskellig mellem to datoer for den samme række. Sådan retter du det: frys promptsættet og versionér det. Tilføj en ny prompt som en ny række, og redigér aldrig en gammel.
Hvad det er: at omskrive en side efter et fald på fem procentpoint. Sådan opdager du det: ændringen er mindre end fejlmargenen for den prompt. Sådan retter du det: handl kun, når en ændring overstiger fejlmargenen i to batcher i træk, og skriv ned, hvad der ellers ændrede sig i samme periode, for eksempel en modelopdatering eller en konkurrents lancering.
Hvad det er: at logge hvert link til dit site som en gevinst, selv når svaret lister dit brand som et alternativ at undgå eller som en fodnote. Sådan opdager du det: ingen læser sætningen omkring citeringen. Sådan retter du det: log de tre tilstande adskilt (nævnt og anbefalet, kun nævnt, kun citeret), og læs sætningen, før du sætter kryds.
Hvad det er: prompts skrevet af marketingteamet til en rapport. Sådan opdager du det: prompts bruger interne produktnavne eller jargon, som kunderne aldrig bruger. Sådan retter du det: hent prompts fra salgsopkald, supportsamtaler og Search Console-forespørgsler, og tjek nogle af dem med rigtige kunder.
Hvad det er: at antage, at en højere synlighedsrate automatisk giver flere besøg. Sådan opdager du det: synlighedsraten stiger, mens henvisningssessionerne står stille. Sådan retter du det: mål henvisningsbesøg separat, tjek hvilke AI-modeller og hvilke sider der sender dem, og forbind de to datasæt i én månedlig rapport.
Hvad det er: at starte et projekt med en AI-tekstfil eller ny markup i den tro, at det udløser citeringer. Sådan opdager du det: projektet har ingen kontrol af indeksering eller berettigelse til uddrag. Sådan retter du det: start med Googles vejledning. Bekræft, at nøglesider er indekseret og berettiget til at vise et uddrag, og ret derefter teksten og de interne links før alt andet.
| Fejl | Tegn i dine data | Rettelse |
|---|---|---|
| Enkelt kørsel rapporteret som resultat | Ingen stikprøvestørrelse eller fejlmargen | Rapportér en andel over mindst 30 kørsler |
| Prompts redigeret mellem kontroller | Samme række, anden tekst, andre datoer | Frys og versionér promptsættet |
| Reaktion inden for fejlmargenen | Ændring mindre end marginen | Handl på ændringer, der holder i to batcher |
| Citering talt som anbefaling | Ingen læsning af sætningen omkring den | Log de tre tilstande adskilt |
| Prompts ingen skriver | Internt jargon i promptlisten | Hent prompts fra kundernes eget sprog |
| Synlighed behandlet som trafik | Stigende synlighed, flade henvisninger | Mål henvisninger separat |
Du behøver ikke et fuldt program for at komme i gang. Den første uge handler om at opsætte målingen, så de næste seks måneder kan læses. Tag trinene i rækkefølge.
Din første uge
Når du har en baseline, holder volatilitet op med at være en kilde til bekymring. Den bliver et interval, du kan måle, og et sæt ændringer, du kan planlægge efter.
Sprogmodeller vælger hvert ord ud fra en sandsynlighedsfordeling, så den samme prompt kan give forskellig formulering, brandlister og rækkefølge. Hentningen ændrer sig også, fordi modellen omskriver spørgsmålet til delforespørgsler, og de sider den henter kan skifte mellem kørsler.
Authoritas målte volatilitetsscoren for AI-oversigter til 0,68 efter 8 uger og 0,73 efter 13 uger, mod 0,49 og 0,55 for organiske resultater. SparkToro fandt under 1 procent chance for, at ChatGPT eller Googles AI returnerer den samme brandliste to gange.
En enkelt placering i et AI-svar er for ustabil til at handle på. Følg hvor ofte dit brand optræder på tværs af mange prompts og kørsler, rapportér andelen i procent med fejlmargin, og behold klassisk rangeringsmåling til Google-søgeresultater, hvor placeringerne bevæger sig langsommere.
Vi analyserer dine konkurrenter, dit website og din synlighed i AI for at lave en skræddersyet indholdsplan gratis.
 AI-generator til indholdsbrief
 FAQ-schemagenerator
 AI-generator til blogidéer
 Validator for struktureret data (schema-validator)
 Tjek af alt-tekst
 Analyse af interne links
 Backlink-udfordringen
 AI-generator til metabeskrivelser
 AI-generator til blogtitler
 Tjek af indekserbarhed
 AI-generator til blogdispositioner
 UTM-linkgenerator
 Værktøj til søgeordsclustering
 Tjek af canonical-tag
 XML-sitemap-generator
 Tjek af ødelagte links
 AI-generator til SEO-titler
 Overskriftsanalysator
 SERP-forhåndsvisning
 Redirect-tjekker
 Hreflang-generator
 Overskriftsanalysator
 HTTP-headertjekker
 Favicon-udtrækker
 SERP CTR-beregner
 Beregner for besparelse ved SEO vs. betalt søgning
 Beregner af SEO-synlighedsandel
 Beregner af SEO-afkast
 Beregner af SEO-trafik- og omsætningsprognose
 Beregner af SEO-budget
 Beregner af SEO-break-even
 Beregner af SaaS-SEO-afkast
 Beregner af ROAS
 Beregner af læsetid
 Simulator for placeringsgevinst
 Beregner for værdi af organisk trafik
 Estimator for organisk trafik og tjek af webstedstrafik
 Beregner for LTV/CAC-forhold
 Beregner for lokal SEO-afkast
 Beregner for linkbuilding-omkostninger
 Beregner for søgeordsværdi
 Beregner for søgeordsmulighed
 Beregner for nøgleordstæthed
 Beregner for GEO-ROI
 Beregner for investering i GEO-indhold
 Ecommerce SEO-ROI-beregner
 Beregner for kundens levetidsværdi
 CAC-beregner
 Beregner for CTR
 Beregner for omkostning pr. artikel
 Beregner for konverteringsrate
 Beregner for ROI på content marketing
 Estimator for henvisningstrafik fra ChatGPT
 Beregner for bounce rate
 Beregner for backlinks ROI
 Beregner for AI-synlighedsscore
 AI-trafikværdi-beregner
 AI-share of voice-beregner
 Beregner for omkostningen ved AI-usynlighed
 AI-citationsrate-beregner
 llms.txt-validator
 AI Overview-tjekker og rangeringstjekker for AI Overviews
 Robots.txt-tjekker
 AI-SEO-audit
 LLM-læsbarhedstjek
 SearchGPT-klartjek
 LLM-audit af strukturerede data
 AI-crawlbarhedsaudit for websites
 Hvorfor anbefaler ChatGPT ikke mit website?
 Gemini-rangeringsværktøj
 Perplexity-placeringstjek
 LLM-citeringstjek
 AEO-audit
 GEO-audit
 Test af synlighed i AI-søgning
 Tjek af ChatGPT-synlighed
 llms.txt-generator
 URL-udtrækker
 Webside til Markdown
 Sitemap-tjek
 SERP-volatilitetsmåler
 Sidestørrelsestjek
 Ordtæller
 Slug-generator
 Schema-generator
 Robotgenerator
 OG-forhåndsvisning
 Metatag-generator
 Billedkompressor
 Favicon-generator
 On-page SEO-audit: SEO-tjek og SEO-analyse
 Backlinkanalyseværktøj
 Værktøj til søgeordsanalyse
 Domain Authority-tjek
 “Jeg testede Sorank på en rigtig kundes site, og det er vanvittigt. Det gør alt, et bureau ville opkræve dig 1500 dollar om måneden for. Det går nu i produktion på den kunde.”

 Guillaume Guersanguersanguillaume.com“Vi er et annoncebureau, og vi ville have vores SEO på rette spor en gang for alle. Sorank gav os et klart overblik over vores site, hjalp os med at prioritere optimeringer og strukturere vores indhold ordentligt. Værktøjet er nemt at bruge, velegnet til et team og meget praktisk til at samle opfølgningen et sted uden at jonglere med flere platforme. Et meget solidt fundament til at starte forfra med vores SEO.”
 Gaspard MadouiAnnoncebureau
 “Jeg lod bare Sorank-softwaren gøre sit arbejde, og nu er min DR 25, og min side rangerer højere.”
 Lucas Flandrefoundertrace.fr“Jeg specialiserede mig i GEO takket være Sorank. GEO-ranglisten gør det muligt at vise mine kunder deres placering i forhold til konkurrenterne på ChatGPT. Det er en reel kommerciel fordel.”
 MélanieSEO-freelancer“Fantastisk service, den virker godt til vores hjemmeside og hjælper os med at forstå, hvordan vi kan forbedre den for at rangere bedre på Google og andre steder. Tillykke, bliv ved, jeg anbefaler det.”
 Hugo T.Netbutiksejer