Præferencer
Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information

Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information

Sådan vælger AI-assistenter deres kilder: hentning, query fan-out, hvad OpenAI, Google, Perplexity, Anthropic og Microsoft dokumenterer, og hvad vores data viser.

Værktøjer

Kort fortalt
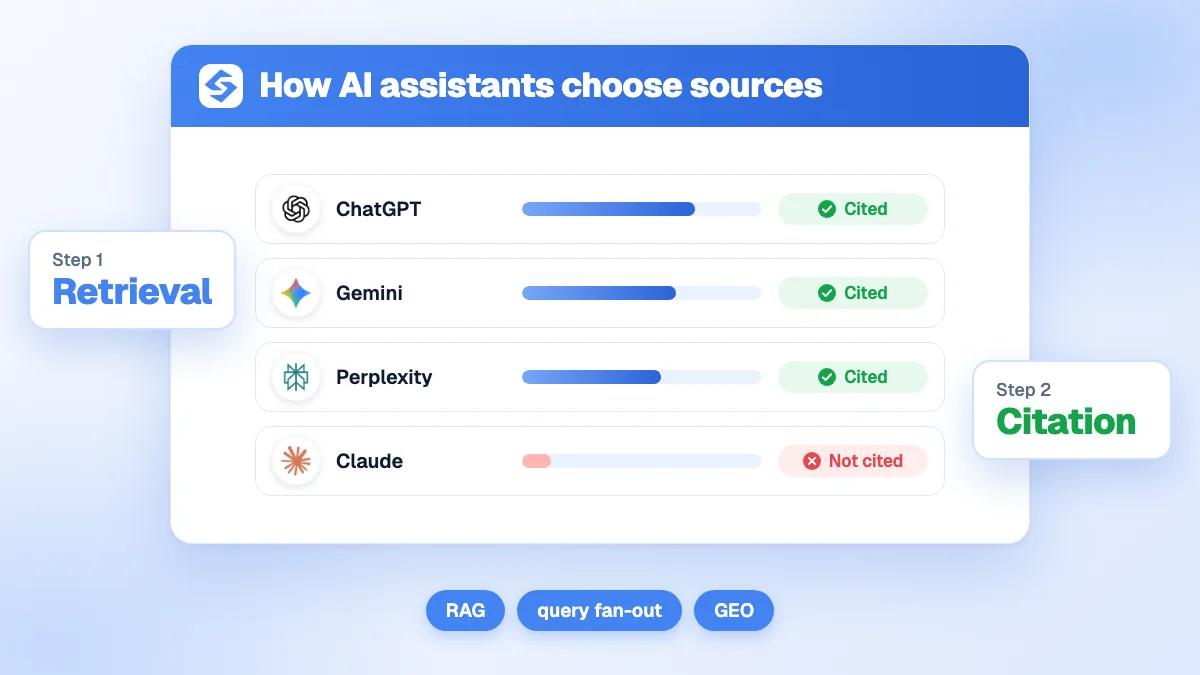
AI-assistenter vælger deres kilder i to trin. Først henter de: modellen omsætter spørgsmålet til en eller flere websøgninger (query fan-out) og trækker kandidatsider fra et søgeindeks (Google, Bing, Brave eller deres eget). Derefter udvælger de: modellen læser passager, beholder dem, der svarer klart og med belæg på et delspørgsmål, og citerer dem. En side skal derfor kunne crawles af assistentens bot, være indekseret, være relevant for de skjulte delforespørgsler og være let at citere, og hver assistent foretrækker forskellige typer sites.
Vil du vide mere? Spørg
Hurtig quiz
Hvordan får du nævnt af ChatGPT og andre AI-assistenter?
Sorank matcher dine svar


Test det i 3 dage på dit eget site, og se, hvor du står på Google, ChatGPT og de andre AI'er.
Start prøveperiode på 3 dage3 dage gratis, derefter stopper du, når du vil. 90 dages garanti: resultater eller pengene tilbage.
At forstå hvordan AI-assistenter vælger deres kilder er udgangspunktet for alt arbejde med AI-synlighed. Den gode nyhed er, at leverandørerne dokumenterer mere, end de fleste tror. Google skriver i sin dokumentation om AI-funktioner, at AI-oversigter og AI-tilstand kan udføre flere relaterede søgninger på tværs af delemner, og at en side kun skal være indekseret og berettiget til et uddrag for at blive vist som et understøttende link. OpenAI, Perplexity, Anthropic og Microsoft offentliggør lignende regler for deres egne assistenter. Denne guide samler det, der er officielt, skiller det fra gætteri og tilføjer det, vi har målt på 301.025 AI-svar.
Næsten alle assistenter med webadgang følger det samme mønster, kaldet retrieval-augmented generation (RAG): modellen svarer ikke kun ud fra hukommelsen, den henter først dokumenter og skriver derefter ud fra dem. Trinnene er følgende.
To konsekvenser følger heraf. En side, der ikke er i det indeks, assistenten bruger, kommer aldrig med i kapløbet, uanset hvor god den er. Og en side kan rangere først på Google for brugerens præcise spørgsmål og alligevel miste citatet, fordi assistenten søgte efter noget andet.
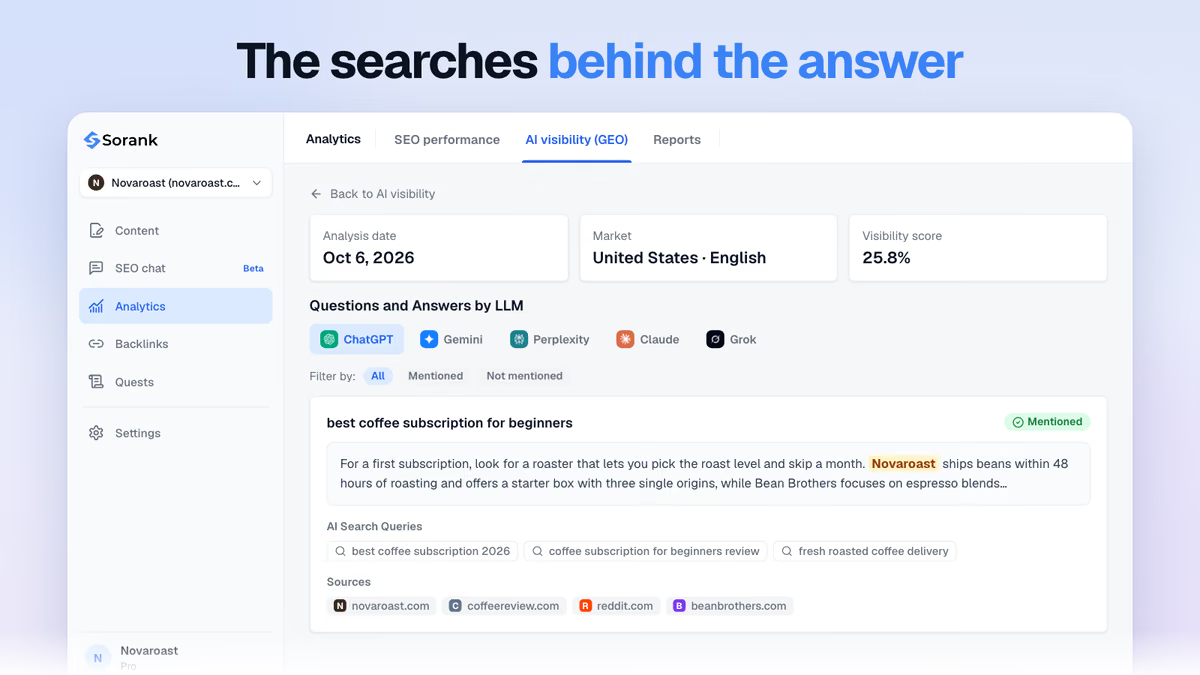
Ingen af de fem offentliggør en rangeringsformel. Hver af dem offentliggør dog regler om adgang, indeksering og citering, og disse regler er det eneste faste grundlag.
| Assistent | Hvor kandidaterne kommer fra | Hvad leverandøren dokumenterer |
|---|---|---|
| Google (AI-oversigter, AI-tilstand) | Googles indeks | Query fan-out på tværs af delemner; en side skal være indekseret og berettiget til et uddrag; ingen særlig fil, markering eller schema er påkrævet |
| ChatGPT-søgning | Egen crawl og søgepartnere | Sites, der fravælger OAI-SearchBot, vises ikke i ChatGPT-søgesvar; GPTBot vedrører kun træning |
| Perplexity | Eget indeks bygget af PerplexityBot | PerplexityBot finder og linker til websites i sine resultater; Perplexity-User henter en side, når en brugers spørgsmål kræver det |
| Claude | Et eksternt søgeindeks (Brave, ifølge meldinger) plus Anthropics egne bots | Claude afgør, hvornår der skal søges, kan søge flere gange pr. forespørgsel og vedhæfter altid citater |
| Microsoft Copilot | Bings indeks | Citater udløses af forankringsforespørgsler, rapporteret i Bing Webmaster Tools; frisk, struktureret og kildebelagt indhold anbefales |
OpenAIs dokumentation af deres crawlere skelner mellem tre agenter. OAI-SearchBot bygger søgeindekset: sites, der blokerer den, vises ikke i ChatGPT-søgesvar. GPTBot indsamler træningsdata, og at blokere den har ingen effekt på søgningen. ChatGPT-User besøger en side på en brugers vegne og afgør ikke, hvad der vises i søgningen. Vores guide til at rangere i ChatGPT gennemgår resten.
Google er det mest eksplicitte: AI-funktioner bruger det samme indeks og de samme kvalitetssystemer som den klassiske søgning, de kan køre en fan-out af relaterede søgninger, og de kan vise et bredere sæt understøttende links end ti blå links. Der findes ingen AI-specifik markering, man skal tilføje. Google-SEO er med andre ord stadig billetten ind til Googles AI-svar.
Perplexitys botdokumentation angiver, at PerplexityBot findes for at finde og linke til websites i sine resultater, og at den ikke bruges til at træne grundmodeller. Perplexity-User henter sider i realtid til en brugers spørgsmål. At tillade PerplexityBot i robots.txt er betingelsen for at komme med i dets indeks.
Anthropics dokumentation om websøgning beskriver løkken præcist: Claude afgør ud fra prompten, hvornår der skal søges, søgningen kan gentages flere gange inden for én forespørgsel, og det endelige svar bærer altid citater, hver med op til 150 tegn fra kilden. Claude søger efter aktuelle priser, nylige begivenheder og oplysninger om bestemte organisationer eller produkter, og besvarer stabil viden uden at søge. Vores guide til at rangere i Claude dækker dens crawlere og indeks.
Copilot er forankret i Bing. Siden februar 2026 har Bing Webmaster Tools en AI-præstationsrapport, der viser, hvor ofte et site citeres i Copilot, og de forankringsforespørgsler, der hentede dets sider. Microsofts råd i samme meddelelse: hold indholdet friskt (med IndexNow), strukturer det med klare overskrifter, tabeller og FAQ'er, og understøt påstande med data og kilder. Se vores guide til at rangere i Copilot og den om at rangere i Grok, xAI's assistent, som dokumenterer langt mindre.
Bemærk
Mange artikler opremser »rangeringsfaktorer« for AI-svar med vægte i procent. Ingen leverandør har offentliggjort sådanne vægte. Behandl enhver præcis formel som en hypotese, og stol på de dokumenterede regler ovenfor plus dine egne målinger.
Ved at kombinere den officielle dokumentation med det, man kan observere i svarene, forklarer seks kriterier de fleste citater. De to første er dokumenterede krav; de øvrige er gentagne mønstre.
Assistentens søgebot skal være tilladt, og siden skal være i det indeks, der forespørges: Googles til Gemini og AI-oversigter, Bings til Copilot, OpenAIs og Perplexitys egne indeks, Brave til Claude. Tjek dine regler med vores guide til robots.txt for AI-crawlere.
Hentningen sker på fan-out-forespørgslerne, ikke på brugerens sætning. En side, der svarer generelt på »bedste CRM«, kan tabe til en side, der svarer på »CRM til et ejendomsmæglerfirma med 5 ansatte, pris pr. bruger«, fordi det var det, assistenten søgte efter.
Assistenter citerer passager. Et afsnit, der åbner med et direkte svar, en definition, en tabelrække eller et nummereret trin, kan løftes ud af siden og stadig give mening. En vag indledning kan ikke.
Claude søger netop, når oplysninger kan have ændret sig, og Microsoft anbefaler at understøtte påstande med data og kilder. Daterede tal, navngivne kilder, priser »tjekket« på en given dato og synlige opdateringsdatoer gør en side tryggere at citere.
En assistent, der finder samme faktum på flere uafhængige sites, kan fremsætte det med sikkerhed. Det er enighed om entiteten: anmeldelser, sammenligninger, kataloger og presseomtaler, der beskriver dit brand på samme måde.
Hver assistent har sine egne vaner. Nogle lægger vægt på encyklopædiske kilder, andre på video, fora eller anmeldelsesplatforme. Næste afsnit viser, hvor store forskellene er.
Tip
Før du skriver en side til AI-synlighed, så stil spørgsmålet til to eller tre assistenter og notér de søgninger, de kører, og de sites, de citerer. Søgningerne fortæller dig, hvilken vinkel du skal dække; de citerede sites fortæller dig, hvilket format der vinder.
Vores undersøgelse af citering på tværs af platforme analyserede 301.025 svar fra ChatGPT, Gemini, Perplexity, Claude og Grok, indsamlet mellem august 2025 og august 2026 på et panel af købsspørgsmål (79% stillet på fransk). Den talte 1.820.738 AI-citater, der pegede på 131.349 forskellige domæner. To fund er vigtige for valg af kilder.
For det første citerer assistenter ikke lige mange kilder. Gemini nævner i gennemsnit 11,1 kilder pr. svar, Grok 7,1, ChatGPT 4,1, Claude 3,5 og Perplexity 3,3. Ved de sidste tre har et spørgsmål tre eller fire pladser, så at være den næstbedste side betyder ofte, at man slet ikke bliver citeret.
| Platform | ChatGPT | Gemini | Perplexity | Claude | Grok |
|---|---|---|---|---|---|
| Wikipedia | 3,43% | 1,38% | 0,19% | 0,03% | 1,08% |
| YouTube | 0,04% | 3,69% | 3,46% | 0% | 2,76% |
| 0,33% | 2,5% | 1,51% | 0% | 4,11% | |
| Trustpilot | 2,7% | 4,33% | 1,21% | 1,57% | 1,8% |
For det andet er de foretrukne kildetyper fuldstændigt forskellige fra den ene assistent til den anden. Wikipedia optræder i 3,43% af ChatGPTs svar og 0,03% af Claudes svar; YouTube i 3,69% af Geminis svar og 0,04% af ChatGPTs svar. Kun 6 platforme citeres af alle fem modeller. Vores undersøgelse af ChatGPT-citater viser også, at udvælgelsen ændrer sig over tid: ChatGPT gik fra 5,8 til 4,1 kilder pr. svar i perioden, med et lavpunkt på 1,7 i juni 2026.
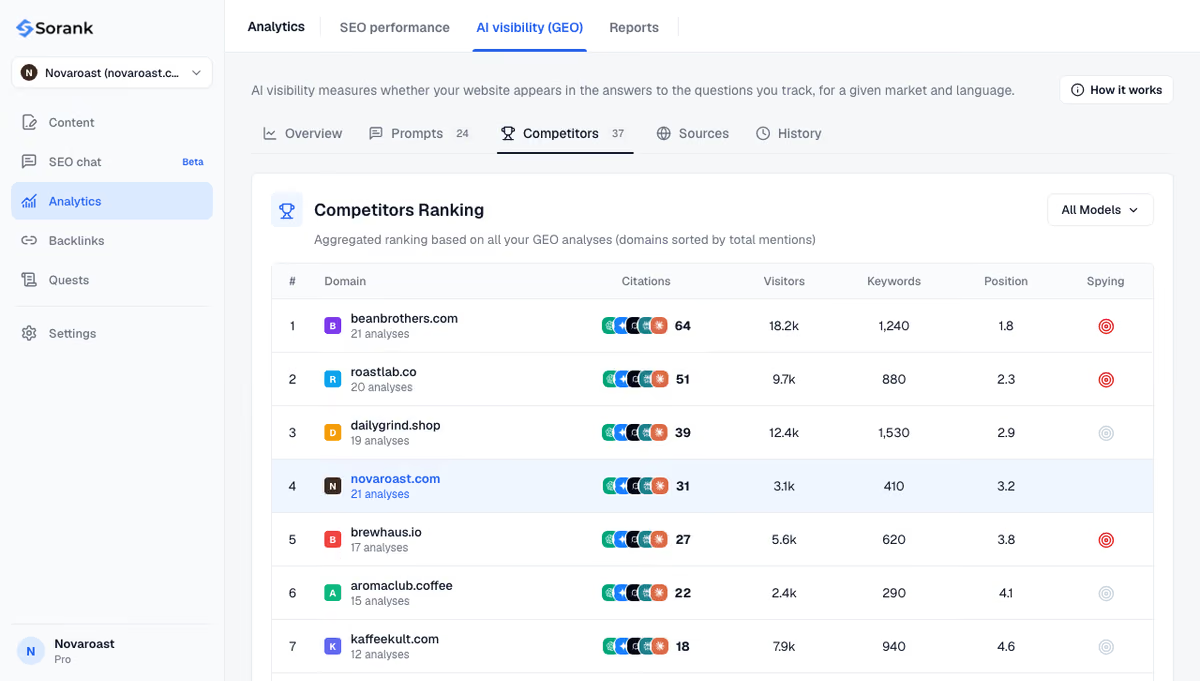
Udvælgelsesprocessen oversættes til en kort liste af handlinger, der gælder for Google og for AI'erne alike.
Eksempel
En køber spørger »hvilket regnskabsprogram til en freelancer i Danmark?«. Assistenten søger efter »regnskabsprogram freelancer Danmark pris« og »sammenligning af faktureringsprogrammer til enkeltmandsvirksomhed«. En softwareleverandør med en offentlig prisside og en sammenligningsside dateret i år matcher begge søgninger; en med kun en slogan på forsiden matcher ingen.
Svarene varierer fra den ene kørsel til den næste, så kildeudvælgelse observeres bedst over uger. Sorank sporing af AI-query fan-out registrerer de søgninger, hver assistent kører på dine prompter, og tæller dem over tid, mens AI-omtaleovervågning viser, om dit brand bliver citeret, og hvilke kilder der tager pladsen, når det ikke sker. AI-assistenter vælger de sider, de kan nå, der matcher deres skjulte søgninger, og som beviser det, de siger: mål de tre ting på dine egne spørgsmål, og du ved, hvad der skal rettes.

Det afhænger af assistenten. Googles AI-oversigter, AI-tilstand og Gemini bygger på Googles indeks, Microsoft Copilot bygger på Bing, ChatGPT og Perplexity kører deres egne crawlere og indeks, og Claude er ifølge meldinger baseret på Brave Search. En side, der er godt indekseret på Google og Bing, dækker de fleste tilfælde, men hver assistents bot skal også være tilladt.
Nej. Assistenter søger med deres egne omformulerede forespørgsler og citerer passager, ikke rangeringer. En side, der rangerer først for brugerens præcise spørgsmål, kan blive sprunget over, hvis den ikke besvarer det delspørgsmål, assistenten søgte efter, eller hvis en anden side giver svaret klarere og med belæg. Gode placeringer på Google øger chancen, men garanterer intet.
De bruger forskellige indeks, kører forskellige søgninger og har forskellige kildepræferencer. Vores undersøgelse af 301.025 svar viser for eksempel, at Wikipedia optræder i 3,43% af ChatGPTs svar, men 0,03% af Claudes svar, mens YouTube er hyppig hos Gemini og næsten fraværende hos ChatGPT. Optimering til én assistent overføres ikke automatisk til de andre.
Vi analyserer dine konkurrenter, dit website og din synlighed i AI for at lave en skræddersyet indholdsplan gratis.
 AI-generator til indholdsbrief
 FAQ-schemagenerator
 AI-generator til blogidéer
 Validator for struktureret data (schema-validator)
 Tjek af alt-tekst
 Analyse af interne links
 Backlink-udfordringen
 AI-generator til metabeskrivelser
 AI-generator til blogtitler
 Tjek af indekserbarhed
 AI-generator til blogdispositioner
 UTM-linkgenerator
 Værktøj til søgeordsclustering
 Tjek af canonical-tag
 XML-sitemap-generator
 Tjek af ødelagte links
 AI-generator til SEO-titler
 Overskriftsanalysator
 SERP-forhåndsvisning
 Redirect-tjekker
 Hreflang-generator
 Overskriftsanalysator
 HTTP-headertjekker
 Favicon-udtrækker
 SERP CTR-beregner
 Beregner for besparelse ved SEO vs. betalt søgning
 Beregner af SEO-synlighedsandel
 Beregner af SEO-afkast
 Beregner af SEO-trafik- og omsætningsprognose
 Beregner af SEO-budget
 Beregner af SEO-break-even
 Beregner af SaaS-SEO-afkast
 Beregner af ROAS
 Beregner af læsetid
 Simulator for placeringsgevinst
 Beregner for værdi af organisk trafik
 Estimator for organisk trafik og tjek af webstedstrafik
 Beregner for LTV/CAC-forhold
 Beregner for lokal SEO-afkast
 Beregner for linkbuilding-omkostninger
 Beregner for søgeordsværdi
 Beregner for søgeordsmulighed
 Beregner for nøgleordstæthed
 Beregner for GEO-ROI
 Beregner for investering i GEO-indhold
 Ecommerce SEO-ROI-beregner
 Beregner for kundens levetidsværdi
 CAC-beregner
 Beregner for CTR
 Beregner for omkostning pr. artikel
 Beregner for konverteringsrate
 Beregner for ROI på content marketing
 Estimator for henvisningstrafik fra ChatGPT
 Beregner for bounce rate
 Beregner for backlinks ROI
 Beregner for AI-synlighedsscore
 AI-trafikværdi-beregner
 AI-share of voice-beregner
 Beregner for omkostningen ved AI-usynlighed
 AI-citationsrate-beregner
 llms.txt-validator
 AI Overview-tjekker og rangeringstjekker for AI Overviews
 Robots.txt-tjekker
 AI-SEO-audit
 LLM-læsbarhedstjek
 SearchGPT-klartjek
 LLM-audit af strukturerede data
 AI-crawlbarhedsaudit for websites
 Hvorfor anbefaler ChatGPT ikke mit website?
 Gemini-rangeringsværktøj
 Perplexity-placeringstjek
 LLM-citeringstjek
 AEO-audit
 GEO-audit
 Test af synlighed i AI-søgning
 Tjek af ChatGPT-synlighed
 llms.txt-generator
 URL-udtrækker
 Webside til Markdown
 Sitemap-tjek
 SERP-volatilitetsmåler
 Sidestørrelsestjek
 Ordtæller
 Slug-generator
 Schema-generator
 Robotgenerator
 OG-forhåndsvisning
 Metatag-generator
 Billedkompressor
 Favicon-generator
 On-page SEO-audit: SEO-tjek og SEO-analyse
 Backlinkanalyseværktøj
 Værktøj til søgeordsanalyse
 Domain Authority-tjek
DE PRØVEDE SORANK, FØR DU GJORDE DET
 “Jeg testede Sorank på en rigtig kundes site, og det er vanvittigt. Det gør alt, et bureau ville opkræve dig 1500 dollar om måneden for. Det går nu i produktion på den kunde.”

 Guillaume Guersanguersanguillaume.com“Vi er et annoncebureau, og vi ville have vores SEO på rette spor en gang for alle. Sorank gav os et klart overblik over vores site, hjalp os med at prioritere optimeringer og strukturere vores indhold ordentligt. Værktøjet er nemt at bruge, velegnet til et team og meget praktisk til at samle opfølgningen et sted uden at jonglere med flere platforme. Et meget solidt fundament til at starte forfra med vores SEO.”
 Gaspard MadouiAnnoncebureau
 “Jeg lod bare Sorank-softwaren gøre sit arbejde, og nu er min DR 25, og min side rangerer højere.”
 Lucas Flandrefoundertrace.fr“Jeg specialiserede mig i GEO takket være Sorank. GEO-ranglisten gør det muligt at vise mine kunder deres placering i forhold til konkurrenterne på ChatGPT. Det er en reel kommerciel fordel.”
 MélanieSEO-freelancer“Fantastisk service, den virker godt til vores hjemmeside og hjælper os med at forstå, hvordan vi kan forbedre den for at rangere bedre på Google og andre steder. Tillykke, bliv ved, jeg anbefaler det.”
 Hugo T.Netbutiksejer