A magánszféra fontos számunkra, ezért lehetőséged van kikapcsolni bizonyos típusú tárolókat, amelyekre a weboldal alapvető működéséhez nincs szükség. A kategóriák letiltása befolyásolhatja a weboldal használatának élményét. További információ (Sütikezelési szabályzat)
Hogyan választják forrásaikat az AI-asszisztensek: RAG, query fan-out és idézési szempontok
Hogyan választják forrásaikat az AI-asszisztensek: a lekérés, a query fan-out, amit az OpenAI, a Google, a Perplexity, az Anthropic és a Microsoft dokumentál, és amit az adataink mutatnak.
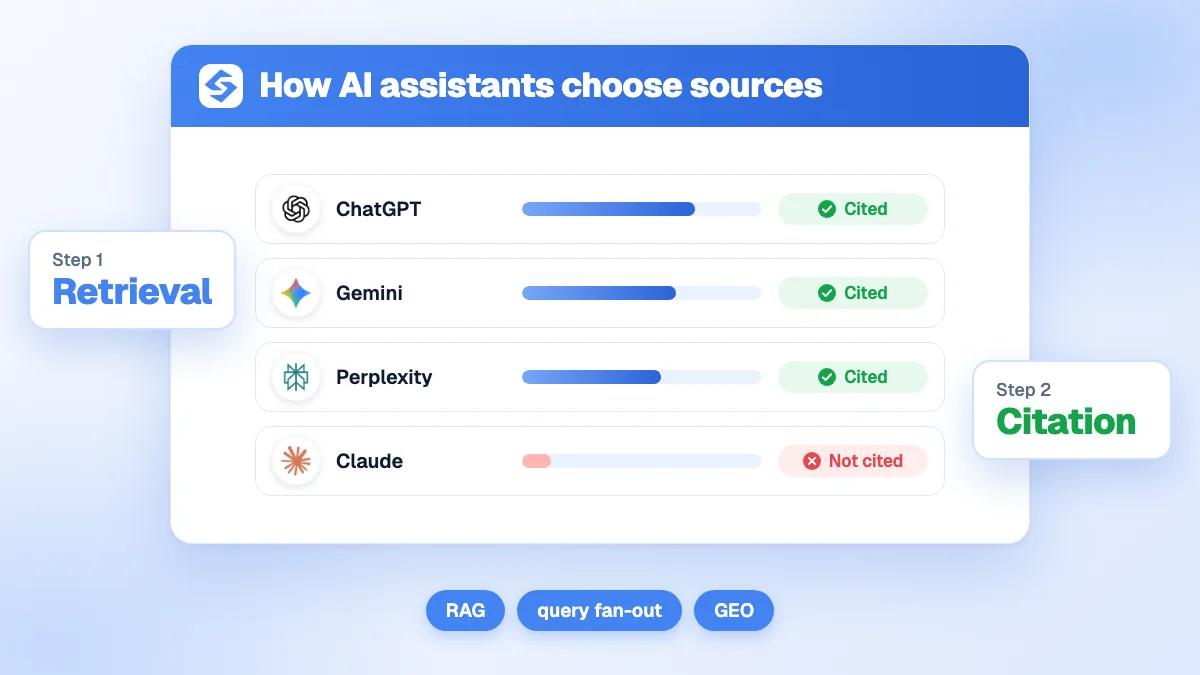
Kék fejlécű kártya sávokkal a ChatGPT, a Gemini, a Perplexity és a Claude számára, három zölddel Idézve jelölve, a Claude pirossal Nincs idézve jelölve
Eszközök
Ezen az oldalon
Röviden
Az AI-asszisztensek két szakaszban választják ki a forrásaikat. Először lekérnek: a modell a kérdést egy vagy több webes keresésre bontja (query fan-out), és jelölt oldalakat húz egy keresőindexből (Google, Bing, Brave vagy saját index). Utána kiválasztanak: a modell végigolvassa a részleteket, megtartja azokat, amelyek egy részkérdésre világosan és bizonyítékokkal válaszolnak, és ezekre hivatkozik. Egy oldalnak ezért bejárhatónak kell lennie az asszisztens botja számára, indexelve kell lennie, relevánsnak kell lennie a rejtett részkeresésekre, és könnyen idézhetőnek kell lennie, az egyes asszisztensek pedig más típusú webhelyeket részesítenek előnyben.
3 nap ingyen, utána bármikor leállhatsz. 90 napos eredménygarancia visszatérítéssel.
Annak megértése, hogyan választják az AI-asszisztensek a forrásaikat, minden AI-láthatósági munka kiindulópontja. A jó hír az, hogy a szolgáltatók többet dokumentálnak, mint sokan gondolnák. A Google AI-funkciókra vonatkozó dokumentációjában rögzíti, hogy az AI Overviews és az AI Mode több, egymással összefüggő keresést indíthat résztémák szerint, és hogy egy oldalnak csak indexeltnek és részletre alkalmasnak kell lennie ahhoz, hogy támogató linkként megjelenjen. Az OpenAI, a Perplexity, az Anthropic és a Microsoft hasonló szabályokat tesz közzé a saját asszisztenseire. Ez az útmutató összegyűjti, ami hivatalos, elválasztja a találgatástól, és hozzáteszi, amit 301,025 AI-válaszon mértünk.
Mi történik a kérdés és a hivatkozott válasz között?
Szinte minden webes hozzáféréssel rendelkező asszisztens ugyanazt a mintát követi, amelyet lekérésen alapuló generálásnak (retrieval-augmented generation, RAG) hívnak: a modell nem csak a memóriájából válaszol, hanem először dokumentumokat kér le, és azokból ír. A lépések a következők.
Eldönti, hogy keressen-e. Egy állandó tényt (definíció, matematikai szabály) a tanítóadatokból válaszol. Árakra, termékekre, friss eseményekre vagy egy megnevezett cégre vonatkozó kérdés keresést indít.
Átírja és szétágaztatja. A modell a felhasználó mondatát egy vagy több rövidebb lekérdezésre bontja, mindegyik a kérdés egy-egy oldalára fókuszál. Ez a query fan-out.
Jelölt oldalakat keres elő. Minden lekérdezés egy keresőindexbe kerül, amely oldalak listáját adja vissza. Csak az a oldal kerülhet elő, amely már benne van ebben az indexben.
Olvassa és szűri a részleteket. A modell (vagy egy szűrőlépés) végigolvassa az találatokat, és megtartja a részleteket, amelyek egy részkérdésre válaszolnak. Az oldalak részletenként versenyeznek, ezért a részletek rangsorolása fontosabb, mint az egész oldal rangsora.
Ír és hivatkozik. A választ a megtartott részletekből állítja össze, a forrásoldalakra mutató linkekkel.
Két következmény adódik. Egy oldal, amely nincs az asszisztens által használt indexben, soha nem kerül a versenybe, bármilyen jó is. És egy oldal lehet elsőként a Google-ben a felhasználó pontos kérdésére, mégis elveszítheti az idézést, mert az asszisztens mást keresett.
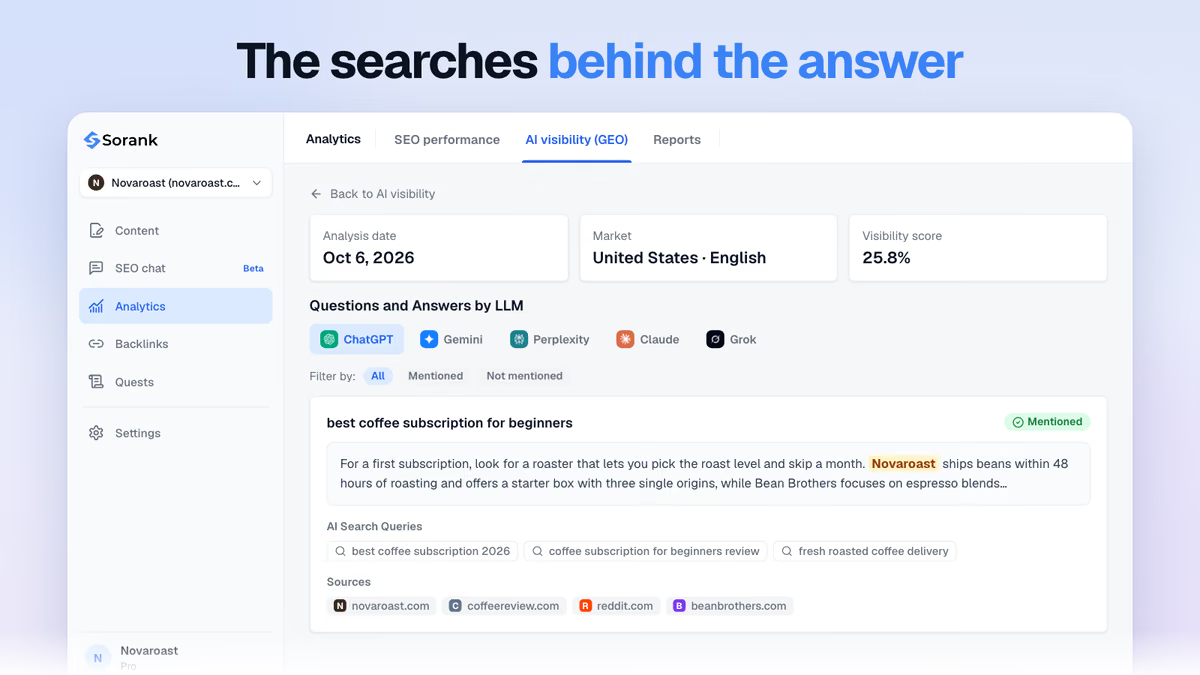
A Soranknál minden követett válasz megmutatja, milyen keréseket futtatott le a háttérben az AI: azok a lekérdezések, amelyekre az oldalaidnak illeszkednie kell ahhoz, hogy lekérhetők legyenek.
Mit dokumentál az OpenAI, a Google, a Perplexity, az Anthropic és a Microsoft?
Az öt szolgáltató egyike sem tesz közzé rangsorolási képletet. Mindegyikük közzétesz viszont szabályokat a hozzáférésről, az indexelésről és az idézésről, és ezek a szabályok az egyetlen szilárd talaj.
Asszisztens
Honnan jönnek a jelöltek
Mit dokumentál a szolgáltató
Google (AI Overviews, AI Mode)
A Google indexe
Query fan-out résztémák szerint; az oldalnak indexeltnek és részletre alkalmasnak kell lennie; nincs szükség külön fájlra, jelölésre vagy sémára
ChatGPT-keresés
Saját feltérképezés és keresőpartnerek
Azok a webhelyek, amelyek kizárják az OAI-SearchBot-ot, nem jelennek meg a ChatGPT-keresés válaszaiban; a GPTBot csak a tanítást érinti
Perplexity
Saját, a PerplexityBot által épített index
A PerplexityBot megjeleníti és linkeli a webhelyeket az találatokban; a Perplexity-User akkor tölt le egy oldalt, ha a felhasználó kérdése ezt megkívánja
Claude
Külső keresőindex (állítólag Brave) plusz az Anthropic botjai
A Claude dönti el, mikor keres, egy kérésen belül többször is kereshet, és mindig csatol idézeteket
Microsoft Copilot
A Bing indexe
Az idézéseket megalapozó lekérdezések váltják ki, amelyeket a Bing Webmaster Tools jelent; friss, strukturált és forrásolt tartalom ajánlott
OpenAI (ChatGPT)
Az OpenAI feltérképezőinek dokumentációja három ügynököt különít el. Az OAI-SearchBot építi a keresőindexet: az azt blokkoló webhelyek nem jelennek meg a ChatGPT-keresés válaszaiban. A GPTBot tanítóadatokat gyűjt, és ennek blokkolása nincs hatással a keresésre. A ChatGPT-User a felhasználó megbízásából látogat meg egy oldalt, és nem dönti el, mi jelenik meg a keresésben. A rangsorolás a ChatGPT-ben útmutatónk részletezi a többit.
Google (AI Overviews és AI Mode)
A Google a legegyértelműbb: az AI-funkciók ugyanazt az indexet és ugyanazokat a minőségi rendszereket használják, mint a klasszikus keresés, futtathatnak egymáshoz kapcsolódó keresésekből álló fan-outot, és a tíz kék linknél szélesebb támogató linkkészletet mutathatnak. Nincs hozzáadandó AI-specifikus jelölés. Más szóval a Google SEO továbbra is a belépőjegy a Google AI-válaszaihoz.
Perplexity
A Perplexity botdokumentációja szerint a PerplexityBot azért létezik, hogy megjelenítse és linkelje a webhelyeket a találataiban, és nem alap-modellek tanítására használják. A Perplexity-User valós időben tölt le oldalakat a felhasználó kérdéséhez. Ahhoz, hogy a Perplexity indexében szerepelj, a robots.txt-ben engedélyezned kell a PerplexityBot-ot.
Anthropic (Claude)
Az Anthropic webes keresési dokumentációja pontosan leírja a ciklust: a Claude a kérdés alapján dönti el, mikor keres, a keresés egy kérésen belül többször is megismétlődhet, és a végső válasz mindig idézeteket tartalmaz, mindegyik legfeljebb 150 karakter erejéig idézve a forrásból. A Claude aktuális árakat, friss eseményeket és konkrét szervezetekre vagy termékekre vonatkozó információkat keres, az állandó tudást pedig keresés nélkül válaszolja meg. A rangsorolás a Claude-ban útmutatónk a feltérképezőit és indexét tárgyalja.
Microsoft (Copilot)
A Copilot a Bingen alapul. 2026 februárja óta a Bing Webmaster Tools tartalmaz egy AI-teljesítmény jelentést, amely megmutatja, milyen gyakran idézik a webhelyet a Copilotban, és mely lekérdezések hozták elő az oldalait. A Microsoft ugyanebben a bejelentésben azt javasolja: tartsd frissen a tartalmat (IndexNow-val), strukturáld világos címsorokkal, táblázatokkal és GYIK-kel, és támaszd alá az állításokat adatokkal és forrásokkal. Lásd a rangsorolás a Copilotban útmutatónkat, és a rangsorolás a Grokban útmutatónkat az xAI asszisztenséről, amelyről jóval kevesebbet dokumentálnak.
Megjegyzés
Sok cikk sorolja fel az AI-válaszok „rangsorolási tényezőit” százalékos súlyokkal. Egyetlen szolgáltató sem tett közzé ilyen súlyokat. Kezelj minden pontos képletet hipotézisként, és támaszkodj a fent dokumentált szabályokra és a saját méréseidre.
Mely szempontok döntik el, kit idéznek?
A hivatalos dokumentáció és a válaszokban megfigyelhető jelenségek együtt hat szempontot magyaráznak a legtöbb idézést. Az első kettő dokumentált követelmény; a többi következetes minta.
1. Hozzáférés és indexelés
Az asszisztens keresőbotjának engedélyezve kell lennie, és az oldalnak benne kell lennie az indexben, amelyet lekérdez: a Google indexében a Gemini és az AI Overviews számára, a Bing indexében a Copilot számára, az OpenAI és a Perplexity saját indexeiben, a Brave indexében a Claude számára. A szabályaidat a robots.txt AI-feltérképezőknek útmutatónkkal ellenőrizheted.
2. Egyezés a rejtett részkeresésekkel
A lekérés a fan-out lekérdezéseken történik, nem a felhasználó mondatán. Az az oldal, amely általánosan válaszol a „legjobb CRM” kérdésre, veszíthet egy olyan oldallal szemben, amely a „CRM 5 fős ingatlanirodának, ár felhasználónként” kérdésre válaszol, mert ezt kereste az asszisztens.
3. Önmagukban idézhető részletek
Az asszisztensek részleteket idéznek. Egy szakasz, amely közvetlen válasszal, definícióval, táblázatsorral vagy számozott lépéssel indul, kiemelhető az oldalból, és akkor is értelmes marad. Egy homályos bevezető nem.
4. Bizonyíték és frissesség
A Claude pontosan akkor keres, amikor az információ megváltozhatott, a Microsoft pedig adatokkal és forrásokkal alátámasztott állításokat ajánl. A dátumozott számok, a megnevezett források, egy adott napon „ellenőrzött” árak és a látható frissítési dátumok biztonságosabbá teszik az oldal idézését.
5. Megerősítés másutt
Ha egy asszisztens ugyanazt a tényt több független webhelyen találja, magabiztosan közölheti. Ez az entitás-konszenzus: vélemények, összehasonlítások, címtárak és sajtóemlítések, amelyek a márkádat ugyanúgy írják le.
6. A forrástípus, amelyet az egyes modellek előnyben részesítenek
Minden asszisztensnek megvannak a saját szokásai. Egyesek enciklopédikus forrásokra támaszkodnak, mások videóra, fórumokra vagy véleményportálokra. A következő szakasz megmutatja, mekkorák ezek a különbségek.
Tipp
Mielőtt AI-láthatóságra írnál oldalt, tedd fel a kérdést két-három asszisztensnek, és jegyezd fel, milyen keréseket futtatnak és mely webhelyeket idézik. A keresések megmutatják, melyik szöget kell lefedni; az idézett webhelyek megmutatják, melyik formátum nyer.
Mit mutatnak az idézési vizsgálataink?
A platformidézési tanulmányunk 301,025 választ elemzett a ChatGPT, a Gemini, a Perplexity, a Claude és a Grok részéről, 2025 augusztusa és 2026 augusztusa között, a vásárlói kérdések egy panelén (a kérdések 79%-a franciául szerepelt). 1,820,738 AI-idézést számolt, amelyek 131,349 különböző domainre mutattak. A forrásválasztás szempontjából két megállapítás fontos.
Először, az asszisztensek nem ugyanannyi forrást idéznek. A Gemini válaszonként átlagosan 11.1 forrást nevez meg, a Grok 7.1-et, a ChatGPT 4.1-et, a Claude 3.5-öt és a Perplexity 3.3-at. Az utolsó három esetében egy kérdésnél három-négy hely van, így a második legjobb oldal lenni gyakran azt jelenti, hogy egyáltalán nem idézik.
Platform
ChatGPT
Gemini
Perplexity
Claude
Grok
Wikipedia
3.43%
1.38%
0.19%
0.03%
1.08%
YouTube
0.04%
3.69%
3.46%
0%
2.76%
Reddit
0.33%
2.5%
1.51%
0%
4.11%
Trustpilot
2.7%
4.33%
1.21%
1.57%
1.8%
Másodszor, a előnyben részesített forrástípusok teljesen eltérnek egyik asszisztenstől a másikig. A Wikipedia a ChatGPT válaszainak 3.43%-ában, a Claude válaszainak 0.03%-ában jelenik meg; a YouTube a Gemini válaszainak 3.69%-ában, a ChatGPT válaszainak 0.04%-ában. Csak 6 platformot idéz mind az öt modell. A ChatGPT-idézési tanulmányunk azt is megmutatja, hogy a kiválasztás idővel változik: a ChatGPT válaszonkénti forrásainak száma az időszak alatt 5.8-ról 4.1-re csökkent, 2026 júniusában pedig 1.7-es mélypontot ért el.
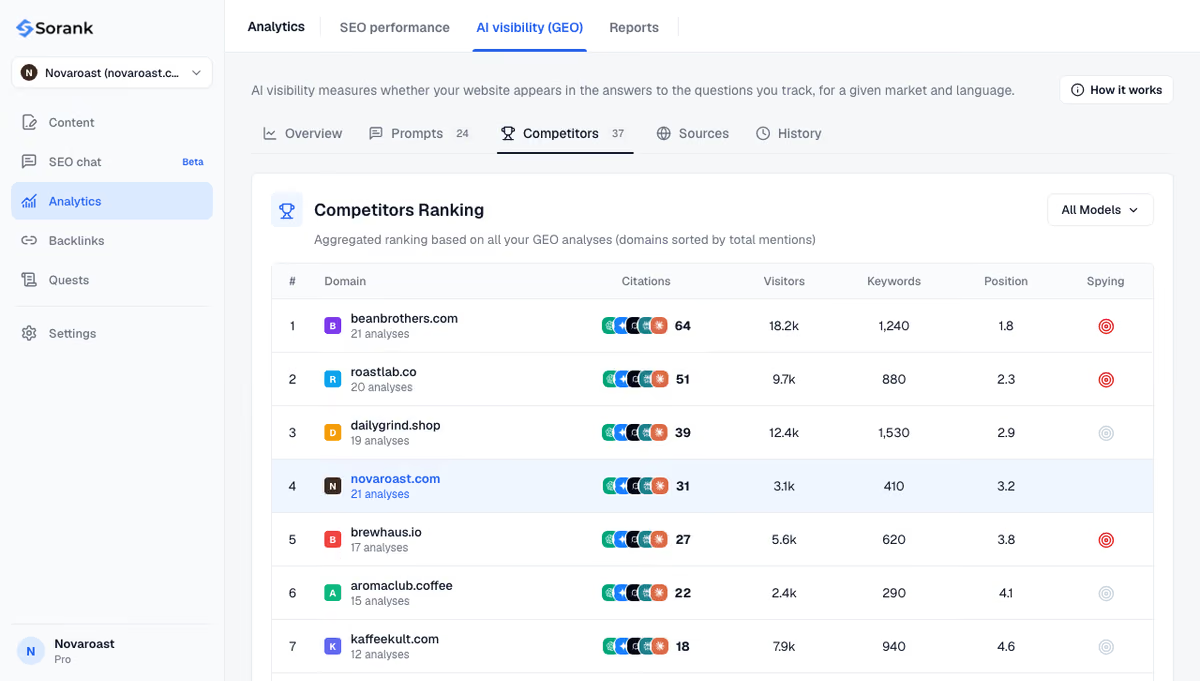
A Sorank GEO-ranglistája rangsorolja azokat a domaineket, amelyeket az AI-k a legtöbbet idéznek a piacod kérdéseire, így látod, ki tölti be a helyeket.
Hogyan válsz azzá a forrássá, amelyet az AI-asszisztensek kiválasztanak?
A kiválasztási folyamat rövid cselekvési listára fordítható, amely a Google-re és az AI-kra egyaránt érvényes.
Nyisd meg az ajtókat: engedélyezd az OAI-SearchBot, a PerplexityBot, a Claude-SearchBot, a Claude-User, a Googlebot és a Bingbot számára; ellenőrizd, hogy a CDN-ed nem blokkolja őket.
Legyél indexelve ott, ahol számít: Google Search Console és Bing Webmaster Tools, tiszta oldaltérkép, gyors frissítésekhez IndexNow.
Fedd le a részkereséseket: egy oldal minden pontos kérdésre, az asszisztensek tényleges keresései alapján.
Írj válasz-elsőként részleteket: minden szakasz tetején közvetlen válasz, összehasonlításhoz táblázatok, szakaszonként egy gondolat, ahogy a tartalom optimalizálása AI-keresésre útmutatónkban.
Bizonyíts és datálj: források, számok, szerzők, látható frissítési dátumok.
Szerezz megerősítést: vélemények és említések azokon a platformokon, amelyeket a vásárlóid asszisztensei ténylegesen idéznek.
Példa
Egy vásárló megkérdezi: „melyik könyvelőprogram kell egy szabadúszónak Franciaországban?”. Az asszisztens ilyen keresésekre kérdez rá: „szabadúszó könyvelőprogram Franciaország ár” és „mikro-vállalkozói számlázóprogram összehasonlítás”. Egy szoftvergyártó, akinek nyilvános árazási oldala és az idén datált összehasonlító oldala van, mindkét keresésre illeszkedik; egy olyan, amelynek csak a kezdőlapon van egy szlogen, egyikre sem.
A válaszok a futtatásonként változnak, ezért a forrásválasztást érdemes hetekig megfigyelni. A Sorank AI query fan-out követője rögzíti, milyen keréseket futtat minden asszisztens a kérdéseiden, és időben összesíti őket, az AI-említések követése pedig megmutatja, hogy a márkád idéződik-e, és ha nem, melyik forrás foglalja el a helyet. Az AI-asszisztensek azokat az oldalakat választják, amelyeket elérnek, amelyek illeszkednek a rejtett keresésükre, és amelyek bizonyítják, amit állítanak: mérd ezt a három dolgot a saját kérdéseiden, és tudni fogod, mit kell javítanod.
Gyakran ismételt kérdések
Az AI-asszisztensek a Google-t használják források keresésére?
Ez az asszisztenstől függ. A Google AI Overviews, AI Mode és Gemini funkciói a Google indexére támaszkodnak, a Microsoft Copilot a Bingre, a ChatGPT és a Perplexity saját feltérképezőket és indexeket működtet, a Claude állítólag a Brave Search-öt használja. Egy jól indexelt oldal a Google-ben és a Bingben a legtöbb esetet lefedi, de minden asszisztens botjának engedélyezve kell lennie.
A Google-keresés első helye garantálja az idézést az AI-válaszokban?
Nem. Az asszisztensek a saját átfogalmazott lekérdezéseikkel keresnek, és részleteket idéznek, nem rangsorokat. Egy oldal, amely elsőként áll a felhasználó pontos kérdésére, kimaradhat, ha nem válaszol arra a részkérdésre, amelyre az asszisztens keresett, vagy ha egy másik oldal bizonyítékokkal világosabban közli a választ. A jó Google-rangsor növeli az esélyeket, de semmit nem garantál.
Miért idéz a ChatGPT, a Gemini és a Claude más webhelyeket ugyanarra a kérdésre?
Más indexeket használnak, más keresésekre futnak, és eltérő a forrásokkal kapcsolatos preferenciájuk. A 301,025 válaszról készült vizsgálatunk például azt mutatja, hogy a Wikipedia a ChatGPT válaszainak 3.43%-ában jelenik meg, de a Claude válaszainak csak 0.03%-ában, míg a YouTube gyakori a Geminin és szinte hiányzik a ChatGPT-ből. Egy asszisztensre való optimalizálás nem terjed át automatikusan a többire.
y!
Ingyenes SEO- és GEO-audit
Kérd ingyen a 30 napos tartalomtervedet
Elemezzük a versenytársaidat, a weboldalad és az AI-láthatóságodat, hogy ingyen készítsünk neked testre szabott tartalomtervet.
“Teszteltem a Sorankot egy valódi ügyfél oldalán, és őrület. Mindent megtesz, amiért egy ügynökség $1500-t kérne havonta. Most ennél az ügyfélnél már éles üzemben van.”Guillaume Guersanguersanguillaume.com
“Egy hirdetési ügynökség vagyunk, és végre rendbe akartuk tenni a SEO-nkat. A Sorank tiszta képet adott az oldalunkról, segített sorrendbe állítani az optimalizálásokat, és segített rendesen felépíteni a tartalmainkat. Az eszköz könnyen kezelhető, csapatra jól szabott, és nagyon praktikus, hogy több platform közötti ugrálás nélkül egy helyen követhetjük a munkát. Nagyon szilárd alap ahhoz, hogy újrakezdjük a SEO-nkat.”Gaspard MadouiHirdetési ügynökség
“A Soranknak köszönhetően GEO-szakértő lettem. A GEO-ranglista segítségével megmutathatom az ügyfeleimnek, hol állnak a versenytársakhoz képest a ChatGPT-ben. Ez valódi kereskedelmi előny.”MélanieSEO szabadúszó
“Remek szolgáltatás, jól működik a weboldalunkon, és segít megérteni, hogyan lehet javítani, hogy jobban szerepeljünk a Google-on és másutt. Gratulálok, így tovább, ajánlom.”Hugo T.E-kereskedelmi kereskedő