आपकी गोपनीयता हमारे लिए महत्वपूर्ण है, इसलिए आपके पास कुछ प्रकार के स्टोरेज को बंद करने का विकल्प है जो वेबसाइट के बुनियादी कामकाज के लिए ज़रूरी नहीं हो सकते। कुछ श्रेणियों को बंद करने से वेबसाइट पर आपके अनुभव पर असर पड़ सकता है। अधिक जानकारी (कुकी नीति)
AI असिस्टेंट अपने स्रोत कैसे चुनते हैं: RAG, क्वेरी फ़ैन-आउट और उद्धरण के मानदंड
AI असिस्टेंट अपने स्रोत कैसे चुनते हैं: रिट्रीवल, क्वेरी फ़ैन-आउट, OpenAI, Google, Perplexity, Anthropic और Microsoft क्या दस्तावेज़ित करते हैं, और हमारा डेटा क्या दिखाता है।
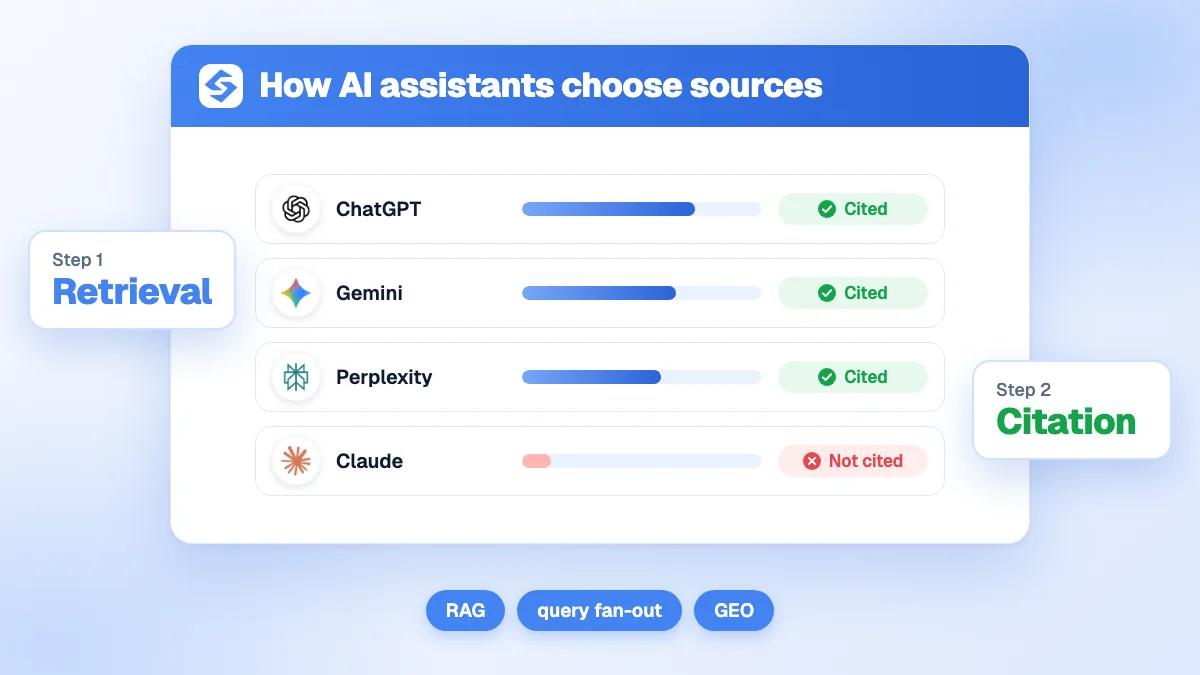
नीले शीर्षक वाला कार्ड, जिसमें ChatGPT, Gemini, Perplexity और Claude के बार हैं, तीन पर हरे रंग में Cited लिखा है और Claude पर लाल रंग में Not cited लिखा है
3 दिन मुफ़्त, फिर जब चाहें बंद करें। 90 दिन की नतीजे-या-रिफ़ंड गारंटी।
संक्षेप में: AI असिस्टेंट अपने स्रोत दो चरणों में चुनते हैं। पहले वे रिट्रीव करते हैं: मॉडल सवाल को एक या कई वेब सर्च में बदलता है (क्वेरी फ़ैन-आउट) और सर्च इंडेक्स (Google, Bing, Brave या उनका अपना) से उम्मीदवार पेज खींचता है। फिर वे चुनते हैं: मॉडल पैसेज पढ़ता है, जो पैसेज किसी उप-सवाल का साफ़ और प्रमाण वाला जवाब देते हैं उन्हें रखता है, और उन्हें उद्धृत करता है। इसलिए किसी पेज को असिस्टेंट के बॉट के लिए क्रॉल करने योग्य, इंडेक्स में, छिपे हुए उप-क्वेरी से जुड़ा और उद्धृत करने में आसान होना चाहिए, और हर असिस्टेंट अलग तरह की साइटों को पसंद करता है।
AI असिस्टेंट अपने स्रोत कैसे चुनते हैं, यह समझना AI विज़िबिलिटी के किसी भी काम की शुरुआत है। अच्छी बात यह है कि विक्रेता उससे ज़्यादा दस्तावेज़ित करते हैं जितना ज़्यादातर लोग सोचते हैं। Google अपने AI फ़ीचर के दस्तावेज़ में बताता है कि AI Overviews और AI Mode उप-विषयों पर कई संबंधित सर्च चला सकते हैं, और किसी पेज को सहायक लिंक के रूप में दिखाने के लिए सिर्फ़ इंडेक्स में होना और स्निपेट के योग्य होना काफ़ी है। OpenAI, Perplexity, Anthropic और Microsoft अपने असिस्टेंट के लिए मिलते-जुलते नियम प्रकाशित करते हैं। यह गाइड आधिकारिक बातों को इकट्ठा करती है, उन्हें अनुमान से अलग करती है, और जोड़ती है कि हमने 301,025 AI उत्तरों पर क्या मापा।
सवाल और उद्धृत उत्तर के बीच क्या होता है?
वेब एक्सेस वाला लगभग हर असिस्टेंट एक ही पैटर्न पर चलता है, जिसे retrieval-augmented generation (RAG) कहते हैं: मॉडल अकेले अपनी याद से जवाब नहीं देता, पहले दस्तावेज़ खोजता है और फिर उन्हीं से लिखता है। चरण ये हैं।
तय करें कि खोजना है या नहीं। स्थिर तथ्य (कोई परिभाषा, गणित का नियम) प्रशिक्षण डेटा से जवाब पाते हैं। कीमतों, उत्पादों, हाल की घटनाओं या किसी नामित कंपनी वाला सवाल सर्च शुरू करता है।
दोबारा लिखें और फ़ैन-आउट करें। मॉडल उपयोगकर्ता के वाक्य को एक या कई छोटी क्वेरी में बदलता है, जिनमें से हर एक सवाल के एक पहलू को कवर करती है। इसे query fan-out कहते हैं।
उम्मीदवार रिट्रीव करें। हर क्वेरी एक सर्च इंडेक्स को भेजी जाती है, जो पेजों की सूची लौटाता है। केवल वे पेज रिट्रीव हो सकते हैं जो उस इंडेक्स में पहले से हैं।
पैसेज पढ़ें और छानें। मॉडल (या कोई फ़िल्टरिंग चरण) नतीजे पढ़ता है और वे पैसेज रखता है जो किसी उप-सवाल का जवाब देते हैं। पेज पैसेज-दर-पैसेज प्रतिस्पर्धा करते हैं, इसीलिए passage ranking पूरे पेज से ज़्यादा मायने रखती है।
लिखें और उद्धृत करें। जवाब रखे गए पैसेज से बनता है, और जिन पेजों से वे आए हैं उनके लिंक के साथ।
इससे दो नतीजे निकलते हैं। जो पेज असिस्टेंट के इस्तेमाल किए इंडेक्स में नहीं है, वह चाहे कितना भी अच्छा हो, दौड़ में कभी नहीं आता। और कोई पेज उपयोगकर्ता के ठीक सवाल पर Google में पहले नंबर पर हो सकता है, फिर भी उद्धरण खो सकता है, क्योंकि असिस्टेंट ने कुछ और सर्च किया था।
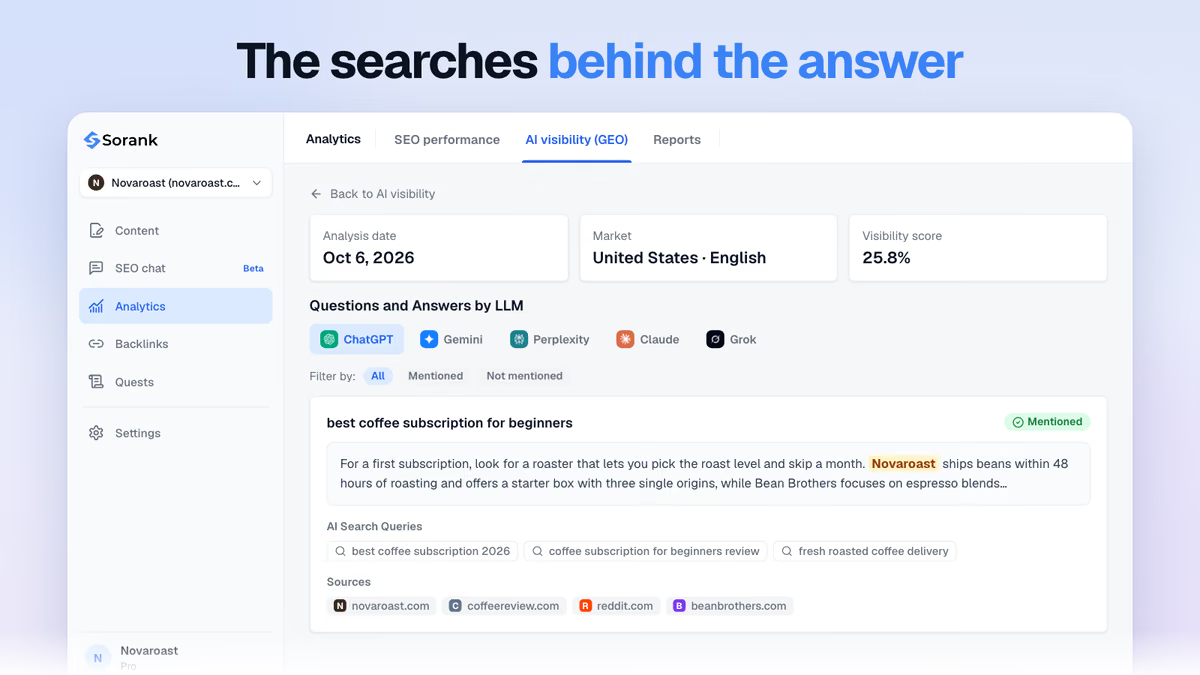
Sorank में, हर ट्रैक किए गए उत्तर में दिखता है कि AI ने पर्दे के पीछे कौन सी सर्च चलाईं: वे क्वेरी जिनसे आपके पेज मेल खाने चाहिए ताकि उन्हें रिट्रीव किया जा सके।
OpenAI, Google, Perplexity, Anthropic और Microsoft क्या दस्तावेज़ित करते हैं?
इन पाँचों में से कोई भी रैंकिंग फ़ॉर्मूला प्रकाशित नहीं करता। हर एक पहुँच, इंडेक्सिंग और उद्धरण के नियम ज़रूर प्रकाशित करता है, और यही नियम अकेली पक्की ज़मीन हैं।
असिस्टेंट
उम्मीदवार कहाँ से आते हैं
विक्रेता क्या दस्तावेज़ित करता है
Google (AI Overviews, AI Mode)
Google का इंडेक्स
उप-विषयों पर क्वेरी फ़ैन-आउट; पेज इंडेक्स में और स्निपेट के योग्य होना चाहिए; कोई विशेष फ़ाइल, मार्कअप या स्कीमा ज़रूरी नहीं
ChatGPT सर्च
उसका अपना क्रॉल और सर्च पार्टनर
जो साइटें OAI-SearchBot से बाहर निकलती हैं, वे ChatGPT सर्च उत्तरों में नहीं दिखतीं; GPTBot केवल प्रशिक्षण से जुड़ा है
Perplexity
PerplexityBot द्वारा बनाया गया उसका अपना इंडेक्स
PerplexityBot नतीजों में वेबसाइटें दिखाता है और उनसे लिंक करता है; जब उपयोगकर्ता के सवाल को ज़रूरत हो, तो Perplexity-User पेज लाता है
Claude
एक बाहरी सर्च इंडेक्स (Brave की रिपोर्ट के अनुसार) और Anthropic के बॉट
Claude तय करता है कब सर्च करना है, एक अनुरोध में कई बार सर्च कर सकता है, और हमेशा उद्धरण जोड़ता है
Microsoft Copilot
Bing का इंडेक्स
उद्धरण ग्राउंडिंग क्वेरी से आते हैं, जिन्हें Bing Webmaster Tools में रिपोर्ट किया जाता है; ताज़ा, संरचित और स्रोत वाले कंटेंट की सलाह दी जाती है
OpenAI (ChatGPT)
OpenAI का अपने क्रॉलर का दस्तावेज़ तीन एजेंट अलग करता है। OAI-SearchBot सर्च इंडेक्स बनाता है: जो साइटें उसे ब्लॉक करती हैं, वे ChatGPT सर्च उत्तरों में नहीं दिखतीं। GPTBot प्रशिक्षण डेटा इकट्ठा करता है, और उसे ब्लॉक करने का सर्च पर कोई असर नहीं होता। ChatGPT-User उपयोगकर्ता की ओर से पेज देखता है और तय नहीं करता कि सर्च में क्या दिखे। बाकी के लिए, हमारी ChatGPT में रैंक करने वाली गाइड विस्तार से बताती है।
Google (AI Overviews और AI Mode)
Google सबसे स्पष्ट है: AI फ़ीचर वही इंडेक्स और वही क्वालिटी सिस्टम इस्तेमाल करते हैं जो क्लासिक सर्च में हैं, वे संबंधित सर्च का फ़ैन-आउट चला सकते हैं, और दस नीले लिंक से ज़्यादा सहायक लिंक दिखा सकते हैं। जोड़ने के लिए कोई AI-विशेष मार्कअप नहीं है। यानी Google SEO अब भी Google के AI उत्तरों में प्रवेश का टिकट है।
Perplexity
Perplexity के बॉट दस्तावेज़ बताते हैं कि PerplexityBot का काम वेबसाइटों को नतीजों में दिखाना और उनसे लिंक करना है, और इसे फ़ाउंडेशन मॉडल के प्रशिक्षण में इस्तेमाल नहीं किया जाता। Perplexity-User उपयोगकर्ता के सवाल के लिए वास्तविक समय में पेज लाता है। robots.txt में PerplexityBot की अनुमति देना उसके इंडेक्स में होने की शर्त है।
Anthropic (Claude)
Anthropic का वेब सर्च दस्तावेज़ यह चक्र सटीक रूप से समझाता है: Claude प्रॉम्प्ट के आधार पर तय करता है कि कब सर्च करना है, सर्च एक अनुरोध के भीतर कई बार दोहराई जा सकती है, और अंतिम उत्तर में हमेशा उद्धरण होते हैं, जिनमें से हर एक स्रोत के 150 अक्षर तक उद्धृत करता है। Claude मौजूदा कीमतों, हाल की घटनाओं और किसी खास संगठन या उत्पाद की जानकारी के लिए सर्च करता है, और स्थिर ज्ञान का जवाब बिना सर्च के देता है। उसके क्रॉलर और इंडेक्स के बारे में, Claude में रैंक कैसे करें गाइड बताती है।
Microsoft (Copilot)
Copilot Bing पर आधारित है। फ़रवरी 2026 से, Bing Webmaster Tools में एक AI Performance रिपोर्ट है, जो दिखाती है कि Copilot में कोई साइट कितनी बार उद्धृत हुई और किन ग्राउंडिंग क्वेरी ने उसके पेज रिट्रीव किए। उसी घोषणा में Microsoft की सलाह है: कंटेंट को ताज़ा रखें (IndexNow के साथ), स्पष्ट हेडिंग, तालिकाओं और FAQ से संरचित करें, और दावों को डेटा और स्रोतों से पुष्ट करें। Copilot में रैंक करने की गाइड देखें, और xAI के असिस्टेंट Grok के लिए Grok में रैंक करने वाली गाइड भी, जो कम दस्तावेज़ित है।
नोट
कई लेख AI उत्तरों के लिए प्रतिशत में वज़न वाले “रैंकिंग फ़ैक्टर” सूचीबद्ध करते हैं। किसी भी विक्रेता ने ऐसे वज़न प्रकाशित नहीं किए हैं। किसी भी सटीक फ़ॉर्मूले को परिकल्पना मानें, और ऊपर बताए दस्तावेज़ित नियमों के साथ अपने मापन पर भरोसा करें।
कौन से मानदंड तय करते हैं कि किसे उद्धृत किया जाए?
आधिकारिक दस्तावेज़ों को उन चीज़ों के साथ जोड़ें जो उत्तरों में देखी जा सकती हैं, तो छह मानदंड ज़्यादातर उद्धरणों को समझाते हैं। पहले दो दस्तावेज़ित ज़रूरतें हैं; बाकी लगातार दिखने वाले पैटर्न हैं।
1. पहुँच और इंडेक्सिंग
असिस्टेंट के सर्च बॉट को अनुमति होनी चाहिए और पेज उस इंडेक्स में होना चाहिए जिसे वह क्वेरी करता है: Gemini और AI Overviews के लिए Google का, Copilot के लिए Bing का, OpenAI और Perplexity के अपने इंडेक्स, Claude के लिए Brave। अपने नियम AI क्रॉलर के लिए robots.txt गाइड से जाँचें।
2. छिपी उप-क्वेरी से मेल
रिट्रीवल उपयोगकर्ता के वाक्य पर नहीं, फ़ैन-आउट क्वेरी पर होता है। जो पेज आम तौर पर “सबसे अच्छा CRM” का जवाब देता है, वह उस पेज से हार सकता है जो “5 लोगों की रियल एस्टेट एजेंसी के लिए CRM, प्रति यूज़र कीमत” का जवाब देता है, क्योंकि असिस्टेंट ने वही सर्च किया था।
3. अकेले उद्धृत करने योग्य पैसेज
असिस्टेंट पैसेज उद्धृत करते हैं। ऐसा सेक्शन जो सीधे जवाब, परिभाषा, तालिका की पंक्ति या क्रमांकित चरण से शुरू होता है, पेज से निकालकर भी समझ में आता है। धुंधली भूमिका नहीं आती।
4. प्रमाण और ताज़गी
Claude ठीक तब सर्च करता है जब जानकारी बदल सकती है, और Microsoft दावों को डेटा और स्रोतों से पुष्ट करने की सलाह देता है। तारीख वाले आँकड़े, नामित स्रोत, किसी दिन “जाँची गई” कीमतें और दिखने वाली अपडेट तारीखें किसी पेज को उद्धृत करने में ज़्यादा सुरक्षित बनाती हैं।
5. दूसरी जगहों से पुष्टि
जो असिस्टेंट एक ही तथ्य कई स्वतंत्र साइटों पर पाता है, वह उसे भरोसे के साथ कह सकता है। इसे entity consensus कहते हैं: समीक्षाएँ, तुलनाएँ, डायरेक्टरी और प्रेस उल्लेख जो आपके ब्रांड को एक ही तरीके से बताते हैं।
6. हर मॉडल किस प्रकार का स्रोत पसंद करता है
हर असिस्टेंट की अपनी आदतें हैं। कुछ विश्वकोश स्रोतों पर टिकते हैं, कुछ वीडियो, फ़ोरम या समीक्षा प्लेटफ़ॉर्म पर। अगला हिस्सा दिखाता है कि ये अंतर कितने बड़े हैं।
टिप
AI विज़िबिलिटी के लिए पेज लिखने से पहले, दो या तीन असिस्टेंट से सवाल पूछें और नोट करें कि वे कौन सी सर्च चलाते हैं और किन साइटों को उद्धृत करते हैं। सर्च बताती हैं कि कौन सा कोण कवर करना है; उद्धृत साइटें बताती हैं कि कौन सा प्रारूप जीतता है।
हमारे उद्धरण अध्ययन क्या दिखाते हैं?
हमारे प्लेटफ़ॉर्म उद्धरण अध्ययन ने ChatGPT, Gemini, Perplexity, Claude और Grok के 301,025 उत्तरों का विश्लेषण किया, जो अगस्त 2025 और अगस्त 2026 के बीच खरीदारों के सवालों के एक पैनल पर इकट्ठा किए गए (79% फ़्रेंच में पूछे गए)। इसने 131,349 अलग-अलग डोमेन की ओर इशारा करते हुए 1,820,738 AI उद्धरण गिने। स्रोत चुनने के लिए दो नतीजे मायने रखते हैं।
पहला, असिस्टेंट एक जैसी संख्या में स्रोत नहीं उद्धृत करते। Gemini औसतन प्रति उत्तर 11.1 स्रोत नामित करता है, Grok 7.1, ChatGPT 4.1, Claude 3.5 और Perplexity 3.3। आखिरी तीन पर, एक सवाल में तीन या चार स्थान होते हैं, इसलिए दूसरे नंबर का सबसे अच्छा पेज होने का मतलब अक्सर उद्धृत न होना होता है।
प्लेटफ़ॉर्म
ChatGPT
Gemini
Perplexity
Claude
Grok
Wikipedia
3.43%
1.38%
0.19%
0.03%
1.08%
YouTube
0.04%
3.69%
3.46%
0%
2.76%
Reddit
0.33%
2.5%
1.51%
0%
4.11%
Trustpilot
2.7%
4.33%
1.21%
1.57%
1.8%
दूसरा, पसंदीदा स्रोत प्रकार एक असिस्टेंट से दूसरे में पूरी तरह अलग हैं। Wikipedia ChatGPT के 3.43% उत्तरों में आता है और Claude के 0.03% में; YouTube Gemini के 3.69% उत्तरों में और ChatGPT के 0.04% में। पाँचों मॉडलों द्वारा केवल 6 प्लेटफ़ॉर्म उद्धृत होते हैं। हमारा ChatGPT उद्धरण अध्ययन यह भी दिखाता है कि चयन समय के साथ बदलता है: इस अवधि में ChatGPT प्रति उत्तर 5.8 से 4.1 स्रोत पर आ गया, जून 2026 में 1.7 के निचले स्तर के साथ।
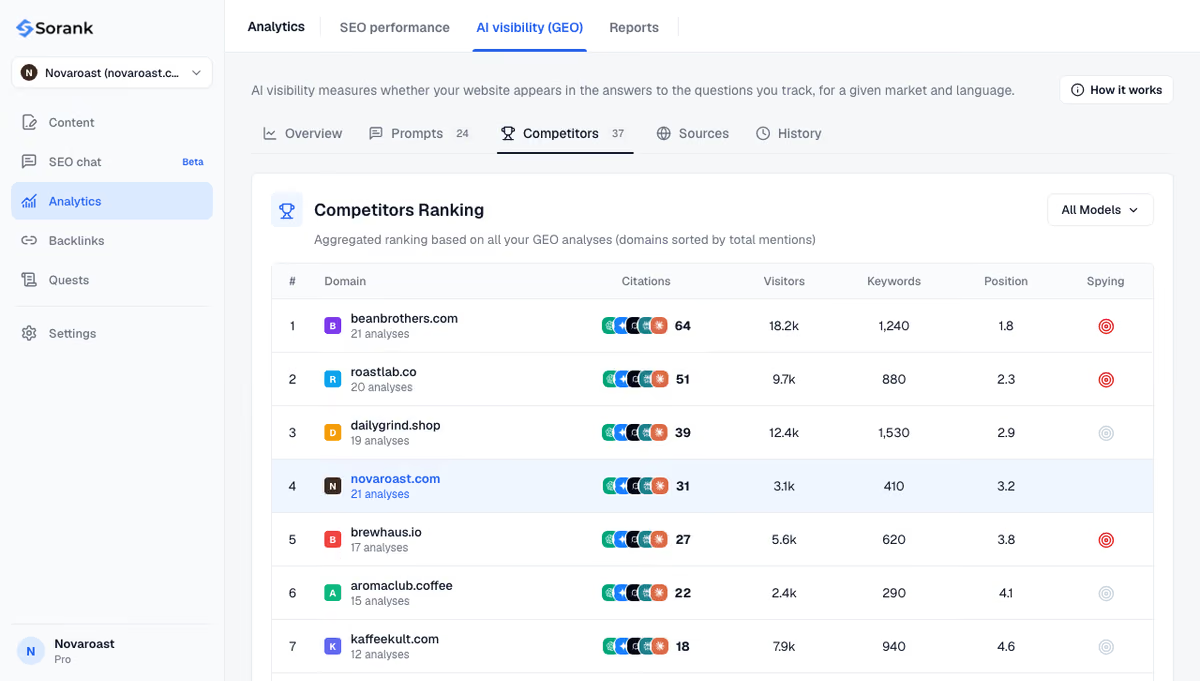
Sorank GEO लीडरबोर्ड उन डोमेन की रैंकिंग करता है जिन्हें AI आपके बाज़ार के सवालों पर सबसे ज़्यादा उद्धृत करते हैं, ताकि आप देख सकें कि स्थान किसके पास है।
आप उन स्रोतों में कैसे शामिल हों जिन्हें AI असिस्टेंट चुनते हैं?
चयन की प्रक्रिया कार्रवाइयों की एक छोटी सूची में बदलती है, जो Google और AI दोनों के लिए मान्य है।
दरवाज़े खोलें: OAI-SearchBot, PerplexityBot, Claude-SearchBot, Claude-User, Googlebot और Bingbot की अनुमति दें; जाँचें कि आपका CDN उन्हें ब्लॉक न करे।
जहाँ मायने रखता है वहाँ इंडेक्स में रहें: Google Search Console और Bing Webmaster Tools, एक साफ़ साइटमैप, तेज़ अपडेट के लिए IndexNow।
उप-क्वेरी कवर करें: हर सटीक सवाल के लिए एक पेज, उन सर्च से बना जो असिस्टेंट सचमुच चलाते हैं।
जवाब-पहले पैसेज लिखें: हर सेक्शन के ऊपर सीधा जवाब, तुलनाओं के लिए तालिकाएँ, हर सेक्शन में एक विचार, जैसा कि AI सर्च के लिए कंटेंट ऑप्टिमाइज़ करने की हमारी गाइड में है।
प्रमाण दें और तारीख लिखें: स्रोत, आँकड़े, लेखक, दिखने वाली अपडेट तारीखें।
पुष्टि अर्जित करें: उन प्लेटफ़ॉर्म पर समीक्षाएँ और उल्लेख जिन्हें आपके खरीदारों के असिस्टेंट सचमुच उद्धृत करते हैं।
उदाहरण
एक खरीदार पूछता है “फ़्रांस में फ़्रीलांसर के लिए कौन सा अकाउंटिंग सॉफ़्टवेयर?”। असिस्टेंट “freelance accounting software France price” और “micro-entrepreneur invoicing software comparison” सर्च करता है। एक सॉफ़्टवेयर विक्रेता जिसके पास सार्वजनिक कीमत वाला पेज और इस साल की तारीख वाला तुलना पेज है, दोनों सर्च से मेल खाता है; जिसके पास सिर्फ़ होम पेज का नारा है, उसका कोई मेल नहीं होता।
उत्तर एक रन से दूसरे रन में बदलते हैं, इसलिए स्रोत चयन को हफ़्तों में देखना सबसे अच्छा है। Sorank का AI क्वेरी फ़ैन-आउट ट्रैकर दर्ज करता है कि हर असिस्टेंट आपके प्रॉम्प्ट पर कौन सी सर्च चलाता है और समय के साथ उन्हें गिनता है, और AI मेंशन ट्रैकिंग दिखाती है कि आपका ब्रांड उद्धृत हो रहा है या नहीं, और न होने पर कौन से स्रोत वह स्थान ले लेते हैं। AI असिस्टेंट वे पेज चुनते हैं जो उन तक पहुँचे जा सकें, जो उनकी छिपी सर्च से मेल खाएँ और जो अपनी बात को प्रमाणित करें: अपने सवालों पर इन तीनों चीज़ों को मापें, तो आपको पता होगा कि क्या ठीक करना है।
अक्सर पूछे जाने वाले सवाल
क्या AI असिस्टेंट स्रोत ढूँढने के लिए Google का इस्तेमाल करते हैं?
यह असिस्टेंट पर निर्भर करता है। Google के AI Overviews, AI Mode और Gemini Google के इंडेक्स पर चलते हैं, Microsoft Copilot Bing पर, ChatGPT और Perplexity अपने क्रॉलर और इंडेक्स चलाते हैं, और Claude के बारे में बताया गया है कि वह Brave Search इस्तेमाल करता है। Google और Bing पर अच्छी तरह इंडेक्स पेज ज़्यादातर मामलों को कवर करता है, लेकिन हर असिस्टेंट के बॉट की अनुमति भी ज़रूरी है।
क्या Google पर पहले नंबर पर होने से AI उत्तरों में उद्धरण की गारंटी मिलती है?
नहीं। असिस्टेंट अपनी दोबारा लिखी क्वेरी से सर्च करते हैं और रैंकिंग नहीं, पैसेज उद्धृत करते हैं। उपयोगकर्ता के ठीक सवाल पर पहले नंबर वाला पेज छोड़ा जा सकता है, अगर वह उस उप-सवाल का जवाब नहीं देता जिसे असिस्टेंट ने सर्च किया था, या अगर कोई और पेज प्रमाण के साथ जवाब को ज़्यादा साफ़ बताता है। Google पर अच्छी रैंकिंग संभावना बढ़ाती है, पर कुछ भी पक्का नहीं करती।
ChatGPT, Gemini और Claude एक ही सवाल पर अलग-अलग साइटें क्यों उद्धृत करते हैं?
वे अलग इंडेक्स इस्तेमाल करते हैं, अलग सर्च चलाते हैं और उनकी स्रोत पसंद अलग है। हमारा 301,025 उत्तरों का अध्ययन दिखाता है, उदाहरण के लिए, कि Wikipedia ChatGPT के 3.43% उत्तरों में आता है लेकिन Claude के 0.03% में, जबकि YouTube Gemini पर अक्सर है और ChatGPT पर लगभग नहीं है। किसी एक असिस्टेंट के लिए ऑप्टिमाइज़ करना बाकी पर अपने-आप लागू नहीं होता।
y!
मुफ़्त SEO और GEO ऑडिट
30 दिनों का अपना कंटेंट प्लान मुफ़्त में पाएँ
हम आपके प्रतिस्पर्धियों, आपकी वेबसाइट और आपकी AI दृश्यता का विश्लेषण करते हैं, ताकि मुफ़्त में आपके लिए एक अनुकूल कंटेंट योजना बनाई जा सके।
“मैंने Sorank को एक असली क्लाइंट की साइट पर आज़माया और यह कमाल का है। यह वह सब कुछ करता है जिसके लिए एक एजेंसी आपसे हर महीने $1500 वसूलती है। अब उस क्लाइंट के लिए इसे प्रोडक्शन में डाला जा रहा है।”Guillaume Guersanguersanguillaume.com
“हम एक Ads एजेंसी हैं और हम अपने SEO को एक बार और हमेशा के लिए सही रास्ते पर लाना चाहते थे। Sorank ने हमें हमारी साइट की साफ तस्वीर दी, ऑप्टिमाइज़ेशन को प्राथमिकता देने में मदद की, और हमारे कंटेंट को सही तरीके से व्यवस्थित किया। टूल इस्तेमाल में आसान है, टीम के लिए अच्छी तरह डिज़ाइन किया गया है, और कई प्लेटफ़ॉर्म के बीच भागदौड़ किए बिना ट्रैकिंग को एक जगह रखने के लिए बहुत व्यावहारिक है। नए सिरे से SEO शुरू करने के लिए एक बहुत मज़बूत आधार।”Gaspard MadouiAds एजेंसी
“Sorank की बदौलत मैं GEO में विशेषज्ञ बन गई। GEO रैंकिंग मुझे ChatGPT पर क्लाइंट्स को उनकी प्रतियोगियों के मुकाबले उनकी पोज़िशन दिखाने देती है। यह एक असली व्यावसायिक अंतर है।”Mélanieफ्रीलांस SEO
“बेहतरीन सेवा है, हमारी वेबसाइट के लिए अच्छा काम करती है, और यह समझने में मदद करती है कि इसे कैसे सुधारें ताकि Google और दूसरी जगहों पर बेहतर रैंक हो। बधाई, ऐसे ही आगे बढ़ते रहिए। इसकी सिफ़ारिश है।”Hugo T.E-commerce व्यापारी