Integritet är viktigt för oss, så du kan välja att inaktivera vissa typer av lagring som kanske inte är nödvändig för webbplatsens grundläggande funktioner. Om du blockerar kategorier kan det påverka din upplevelse av webbplatsen. Mer information (Cookiepolicy)
Hur AI-assistenter väljer sina källor: RAG, query fan-out och kriterier för citering
Så väljer AI-assistenter sina källor: hämtning, query fan-out, vad OpenAI, Google, Perplexity, Anthropic och Microsoft dokumenterar och vad våra data visar.
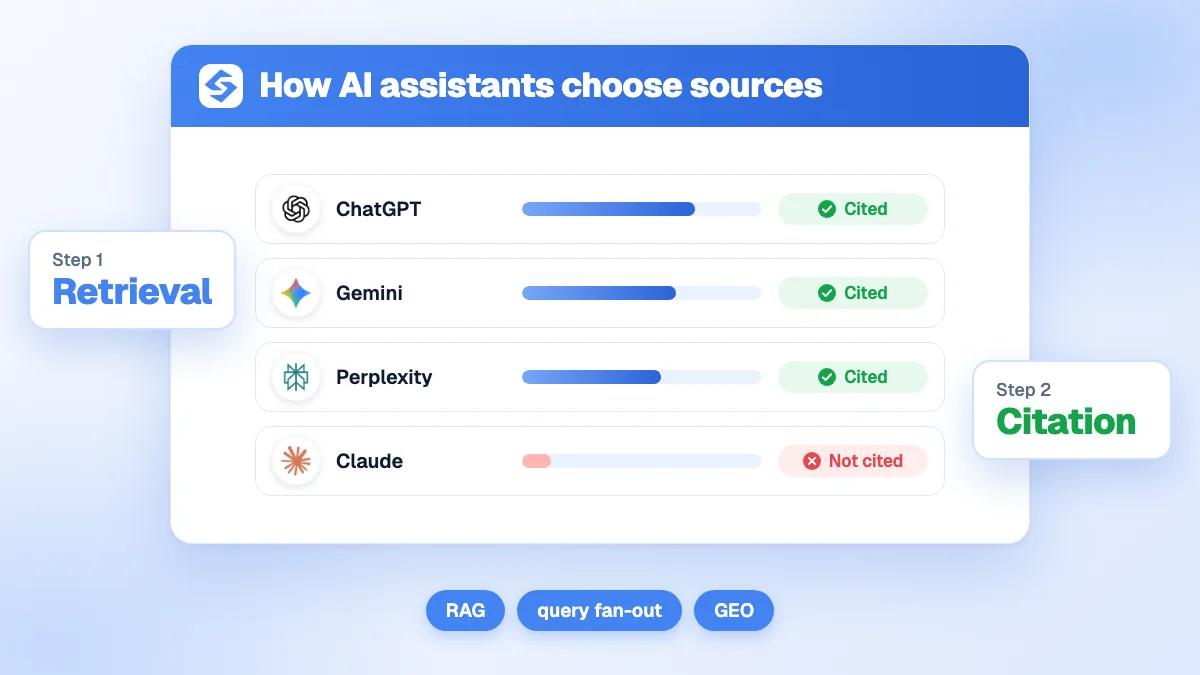
Blåhuvudat kort med staplar för ChatGPT, Gemini, Perplexity och Claude, tre markerade Citerad i grönt och Claude markerad Ej citerad i rött
Verktyg
På den här sidan
Kort sagt
AI-assistenter väljer sina källor i två steg. Först hämtar de: modellen omvandlar frågan till en eller flera webbsökningar (query fan-out) och plockar kandidatsidor från ett sökindex (Google, Bing, Brave eller ett eget). Sedan väljer de: modellen läser stycken, behåller de som svarar tydligt och med belägg på en delfråga, och citerar dem. En sida måste därför kunna crawlas av assistentens bot, vara indexerad, vara relevant för de dolda delfrågorna och vara lätt att citera, och varje assistent föredrar olika typer av sajter.
3 dagar gratis, sedan kan du avsluta när du vill. 90 dagars garanti med pengarna tillbaka om du inte ser resultat.
Att förstå hur AI-assistenter väljer sina källor är utgångspunkten för allt arbete med synlighet i AI. Den goda nyheten är att leverantörerna dokumenterar mer än de flesta tror. Google anger i sin dokumentation om AI-funktioner att AI-översikter och AI-läget kan skicka flera relaterade sökningar över delämnen, och att en sida bara behöver vara indexerad och berättigad till ett utdrag för att visas som stödjande länk. OpenAI, Perplexity, Anthropic och Microsoft publicerar liknande regler för sina egna assistenter. Den här guiden samlar det som är officiellt, skiljer det från gissningar och lägger till det vi mätt på 301,025 AI-svar.
Vad händer mellan en fråga och ett citerat svar?
Nästan alla assistenter med webbåtkomst följer samma mönster, kallat sökförstärkt generering (RAG): modellen svarar inte bara från minnet, den hämtar först dokument och skriver sedan utifrån dem. Stegen är följande.
Avgör om den ska söka. Ett stabilt faktum (en definition, en matematisk regel) besvaras från träningsdata. En fråga om priser, produkter, nyheter eller ett namngivet företag utlöser en sökning.
Skriv om och dela upp. Modellen omvandlar användarens mening till en eller flera kortare sökningar, där var och en täcker en aspekt av frågan. Det här är query fan-out.
Hämta kandidater. Varje sökning skickas till ett sökindex, som returnerar en lista med sidor. Bara sidor som redan finns i det indexet kan hämtas.
Läs och filtrera stycken. Modellen (eller ett filtreringssteg) läser resultaten och behåller de stycken som svarar på en delfråga. Sidor tävlar stycke för stycke, vilket är anledningen till att rangordning av stycken är viktigare än den övergripande sidan.
Skriv och citera. Svaret sätts ihop av de bevarade styckena, med länkar till sidorna de kom från.
Två konsekvenser följer. En sida som inte finns i assistentens index deltar aldrig i loppet, hur bra den än är. Och en sida kan ranka först på Google för användarens exakta fråga men ändå förlora citeringen, eftersom assistenten sökte efter något annat.
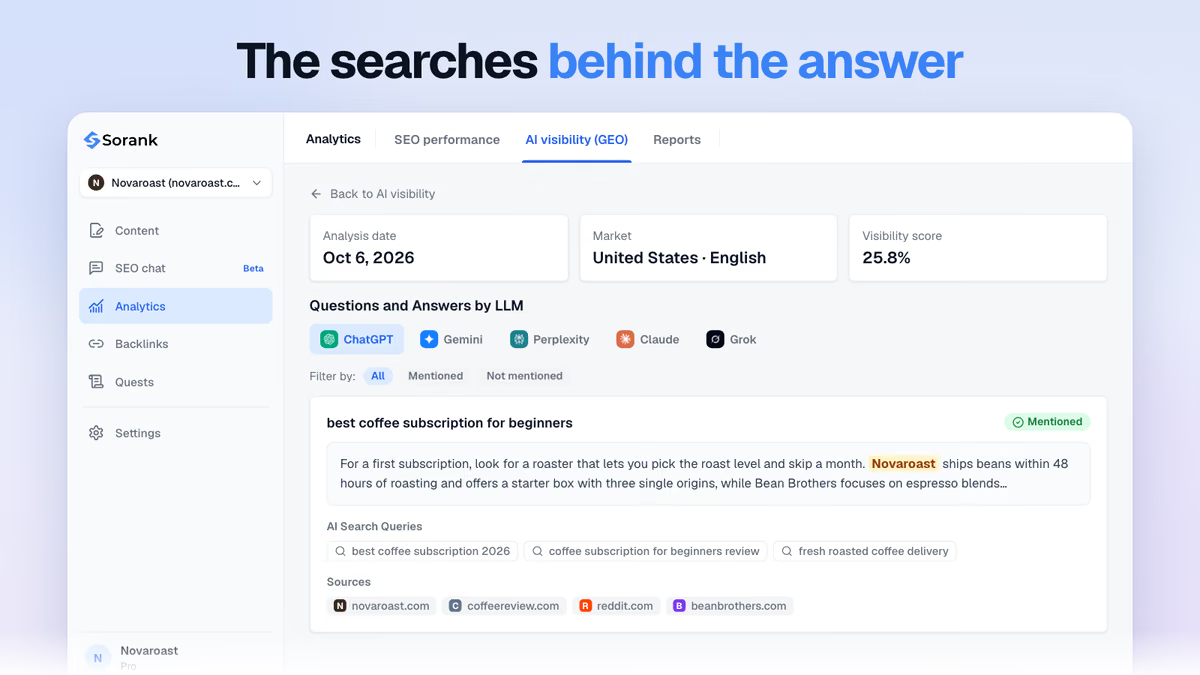
I Sorank visar varje uppföljt svar de sökningar som AI:n gjorde bakom kulisserna: de frågor dina sidor måste matcha för att hämtas.
Vad dokumenterar OpenAI, Google, Perplexity, Anthropic och Microsoft?
Ingen av de fem publicerar en rankingformel. Var och en publicerar däremot regler om åtkomst, indexering och citering, och dessa regler är det enda fasta underlaget.
Assistent
Varifrån kandidaterna kommer
Vad leverantören dokumenterar
Google (AI-översikter, AI-läget)
Googles index
Query fan-out över delämnen; en sida måste vara indexerad och berättigad till utdrag; ingen särskild fil, markering eller schemamarkering krävs
ChatGPT-sökning
Egen crawl och sökpartners
Sajter som väljer bort OAI-SearchBot visas inte i svar från ChatGPT-sökning; GPTBot gäller bara träning
Perplexity
Eget index byggt av PerplexityBot
PerplexityBot visar och länkar webbplatser i sina resultat; Perplexity-User hämtar en sida när en användares fråga kräver det
Claude
Ett externt sökindex (Brave, enligt uppgift) plus Anthropics botar
Claude avgör när den ska söka, kan söka flera gånger inom en förfrågan och bifogar alltid källhänvisningar
Microsoft Copilot
Bings index
Citeringar utlöses av grundningssökningar, som rapporteras i Bing Webmaster Tools; färskt, strukturerat och källbelagt innehåll rekommenderas
OpenAI (ChatGPT)
OpenAI:s dokumentation om sina crawlers skiljer på tre agenter. OAI-SearchBot bygger sökindexet: sajter som blockerar den visas inte i svar från ChatGPT-sökning. GPTBot samlar träningsdata, och att blockera den påverkar inte sökningen. ChatGPT-User besöker en sida för en användares räkning och avgör inte vad som visas i sökningen. Vår guide om hur du rankar i ChatGPT går igenom resten.
Google (AI-översikter och AI-läget)
Google är tydligast: AI-funktionerna använder samma index och samma kvalitetssystem som den klassiska sökningen, de kan köra en serie relaterade sökningar, och de kan visa fler stödjande länkar än tio blå länkar. Det finns ingen AI-specifik markering att lägga till. Med andra ord förblir Google-SEO inträdesbiljetten till Googles AI-svar.
Perplexity
Perplexitys dokumentation om sina botar anger att PerplexityBot finns för att visa och länka webbplatser i sina resultat och inte används för att träna grundmodeller. Perplexity-User hämtar sidor i realtid för en användares fråga. Att tillåta PerplexityBot i robots.txt är villkoret för att finnas i dess index.
Anthropic (Claude)
Anthropics dokumentation om webbsökning beskriver loopen exakt: Claude avgör utifrån prompten när den ska söka, sökningen kan upprepas flera gånger inom en och samma förfrågan, och det slutliga svaret bär alltid citeringar, där var och en citerar upp till 150 tecken från källan. Claude söker efter aktuella priser, senaste händelser och information om specifika organisationer eller produkter, och svarar på stabil kunskap utan att söka. Vår guide om hur du rankar i Claude behandlar dess crawlers och index.
Microsoft (Copilot)
Copilot bygger på Bing. Sedan februari 2026 innehåller Bing Webmaster Tools en rapport om AI-prestanda som visar hur ofta en webbplats citeras i Copilot och de grundningssökningar som hämtade dess sidor. Microsofts råd i samma tillkännagivande: håll innehållet färskt (med IndexNow), strukturera det med tydliga rubriker, tabeller och FAQ, och stötta påståenden med data och källor. Se vår guide om hur du rankar i Copilot, och den om hur du rankar i Grok för xAI:s assistent, som dokumenterar betydligt mindre.
Obs
Många artiklar listar ”rankingfaktorer” för AI-svar med vikter i procent. Ingen leverantör har publicerat sådana vikter. Behandla varje exakt formel som en hypotes, och lita på de dokumenterade reglerna ovan och på dina egna mätningar.
Vilka kriterier avgör vem som blir citerad?
Genom att kombinera den officiella dokumentationen med det som går att observera i svaren förklarar sex kriterier de flesta citeringar. De två första är dokumenterade krav; de övriga är återkommande mönster.
1. Åtkomst och indexering
Assistentens sökbot måste få vara med och sidan måste finnas i indexet den frågar: Googles för Gemini och AI-översikter, Bings för Copilot, OpenAI:s och Perplexitys egna index, Brave för Claude. Kontrollera dina regler med vår guide om robots.txt för AI-crawlers.
2. Matchning med de dolda delfrågorna
Hämtningen sker på fan-out-frågorna, inte på användarens mening. En sida som svarar på ”bästa CRM” i allmänhet kan förlora mot en sida som svarar på ”CRM för ett fastighetsbolag med 5 anställda, pris per användare”, eftersom det är vad assistenten sökte efter.
3. Stycken som går att citera för sig
Assistenter citerar stycken. Ett avsnitt som öppnar med ett direkt svar, en definition, en tabellrad eller ett numrerat steg kan lyftas ur sidan och ändå vara begripligt. En vag inledning kan inte det.
4. Belägg och färskhet
Claude söker just när information kan ha ändrats, och Microsoft rekommenderar att påståenden stöds med data och källor. Daterade siffror, namngivna källor, priser ”kontrollerade” vid ett visst datum och synliga uppdateringsdatum gör en sida tryggare att citera.
5. Bekräftelse på andra håll
En assistent som hittar samma fakta på flera oberoende sajter kan påstå det med säkerhet. Det här är entitetskonsensus: recensioner, jämförelser, kataloger och pressomnämnanden som beskriver ditt varumärke på samma sätt.
6. Vilken typ av källa varje modell föredrar
Varje assistent har sina vanor. En del lutar sig mot uppslagsverk, andra mot video, forum eller recensionsplattformar. Nästa avsnitt visar hur stora skillnaderna är.
Tips
Innan du skriver en sida för synlighet i AI, ställ frågan till två eller tre assistenter och anteckna de sökningar de gör och de sajter de citerar. Sökningarna visar vilken vinkel du ska täcka; de citerade sajterna visar vilket format som vinner.
Vad visar våra studier av citeringar?
Vår studie av citeringar per plattform analyserade 301,025 svar från ChatGPT, Gemini, Perplexity, Claude och Grok, insamlade mellan augusti 2025 och augusti 2026 på en panel av köparfrågor (79% ställda på franska). Den räknade 1,820,738 AI-citeringar som pekade mot 131,349 unika domäner. Två resultat är viktiga för valet av källor.
För det första citerar assistenterna inte lika många källor. Gemini nämner i genomsnitt 11.1 källor per svar, Grok 7.1, ChatGPT 4.1, Claude 3.5 och Perplexity 3.3. Hos de tre sista får en fråga tre eller fyra platser, så att vara den näst bästa sidan betyder ofta att inte bli citerad alls.
Plattform
ChatGPT
Gemini
Perplexity
Claude
Grok
Wikipedia
3.43%
1.38%
0.19%
0.03%
1.08%
YouTube
0.04%
3.69%
3.46%
0%
2.76%
Reddit
0.33%
2.5%
1.51%
0%
4.11%
Trustpilot
2.7%
4.33%
1.21%
1.57%
1.8%
För det andra skiljer sig de föredragna källtyperna helt åt mellan assistenterna. Wikipedia förekommer i 3.43% av ChatGPT-svaren och 0.03% av Claude-svaren; YouTube i 3.69% av Gemini-svaren och 0.04% av ChatGPT-svaren. Bara 6 plattformar citeras av alla fem modellerna. Vår studie av ChatGPT-citeringar visar också att urvalet förändras över tid: ChatGPT gick från 5.8 till 4.1 källor per svar under perioden, med en lägsta nivå på 1.7 i juni 2026.
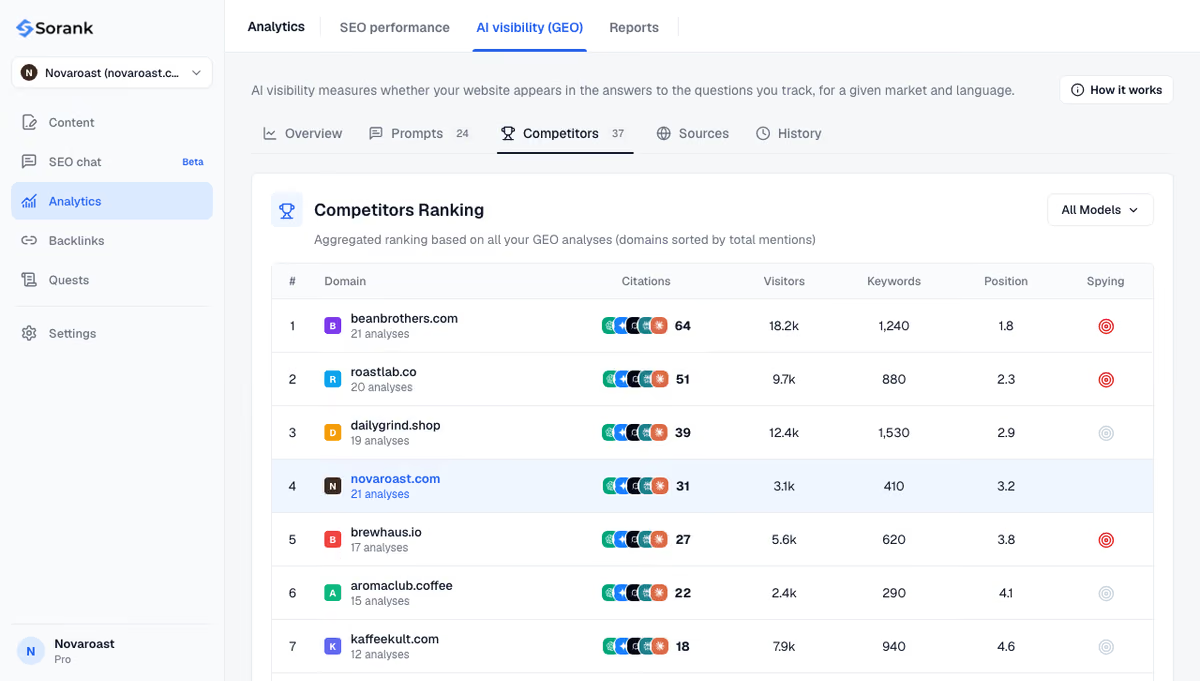
Sorank GEO-ranking visar vilka domäner AI:n citerar mest på din marknads frågor, så att du ser vem som håller platserna.
Hur blir du en av de källor som AI-assistenter väljer?
Urvalsprocessen omsätts i en kort lista med åtgärder, giltiga för Google och för AI:erna.
Öppna dörrarna: tillåt OAI-SearchBot, PerplexityBot, Claude-SearchBot, Claude-User, Googlebot och Bingbot; kontrollera att din CDN inte blockerar dem.
Var indexerad där det räknas: Google Search Console och Bing Webmaster Tools, en ren sitemap, IndexNow för snabba uppdateringar.
Täck delfrågorna: en sida per precis fråga, byggd på de sökningar assistenterna faktiskt gör.
Skriv stycken som börjar med svaret: ett direkt svar överst i varje avsnitt, tabeller för jämförelser, en idé per avsnitt, som i vår guide om hur du optimerar innehåll för AI-sökning.
Bevisa och datera: källor, siffror, författare, synliga uppdateringsdatum.
Skaffa bekräftelse: recensioner och omnämnanden på de plattformar som dina köpares assistenter faktiskt citerar.
Exempel
En köpare frågar ”vilket bokföringsprogram för en frilansare i Frankrike?”. Assistenten söker efter ”freelance accounting software France price” och ”micro-entrepreneur invoicing software comparison”. En programleverantör med en offentlig prissida och en jämförelsesida daterad i år matchar båda sökningarna; en med bara en slogan på startsidan matchar ingen.
Svaren varierar från en körning till nästa, så urvalet av källor observeras bäst under veckor. Soranks uppföljning av AI-frågor (query fan-out) registrerar de sökningar varje assistent gör på dina prompter och räknar dem över tid, och uppföljning av AI-omnämnanden visar om ditt varumärke citeras och vilka källor som tar platsen när det inte gör det. AI-assistenter väljer de sidor de kan nå, som matchar deras dolda sökningar och som bevisar det de påstår: mät dessa tre saker på dina egna frågor, så vet du vad du ska åtgärda.
Vanliga frågor
Använder AI-assistenter Google för att hitta källor?
Det beror på assistenten. AI-översikter, AI-läget och Gemini bygger på Googles index, Microsoft Copilot bygger på Bing, ChatGPT och Perplexity kör egna crawlers och index, och Claude har enligt uppgift använt Brave Search. En sida som är väl indexerad på Google och Bing täcker de flesta fall, men varje assistents bot måste också vara tillåten.
Garanterar en förstaplats på Google en citering i AI-svar?
Nej. Assistenter söker med sina egna omformulerade frågor och citerar stycken, inte rankingar. En sida som ligger först för användarens exakta fråga kan hoppas över om den inte svarar på den delfråga assistenten sökte efter, eller om en annan sida formulerar svaret tydligare och med belägg. Bra placeringar på Google höjer chanserna men garanterar ingenting.
Varför citerar ChatGPT, Gemini och Claude olika sajter för samma fråga?
De använder olika index, kör olika sökningar och har olika källpreferenser. Vår studie av 301,025 svar visar till exempel att Wikipedia förekommer i 3.43% av ChatGPT-svaren men i 0.03% av Claude-svaren, medan YouTube är vanligt hos Gemini och nästan frånvarande hos ChatGPT. Optimering för en assistent överförs inte automatiskt till de andra.
y!
Gratis SEO- och GEO-granskning
Få din innehållsplan för 30 dagar gratis
Vi analyserar dina konkurrenter, din webbplats och din synlighet i AI för att skapa en skräddarsydd innehållsplan, gratis.
“Jag testade Sorank på en riktig kundsajt och det är helt otroligt. Det gör allt som en byrå skulle ta 1500 dollar i månaden för. Den används nu i produktion för den kunden.”Guillaume Guersanguersanguillaume.com
“Vi är en annonsbyrå och ville få igång vår SEO på rätt spår en gång för alla. Sorank gav oss en tydlig bild av vår webbplats, hjälpte oss att prioritera optimeringarna och att strukturera vårt innehåll på rätt sätt. Verktyget är lätt att använda, väl genomtänkt för ett team och mycket praktiskt för att samla uppföljningen på ett ställe utan att jonglera med flera plattformar. En mycket stabil grund för att börja om från början med vår SEO.”Gaspard MadouiAnnonsbyrå
“Jag specialiserade mig på GEO tack vare Sorank. GEO-rankningen gör det möjligt för mig att visa mina kunder deras position jämfört med konkurrenterna i ChatGPT. Det är en verklig konkurrensfördel.”MélanieFrilans SEO-konsult
“Bra service, den fungerar bra för vår webbplats och hjälper oss att förstå hur vi kan förbättra den för att rankas bättre på Google och på andra ställen. Grattis, fortsätt så, jag rekommenderar det.”Hugo T.Handlare inom e-handel