Innstillinger
Personvern er viktig for oss, så du kan velge å slå av enkelte typer lagring som ikke er nødvendig for at nettstedet skal fungere grunnleggende. Blokkering av kategorier kan påvirke opplevelsen din på nettstedet. Mer informasjon

Personvern er viktig for oss, så du kan velge å slå av enkelte typer lagring som ikke er nødvendig for at nettstedet skal fungere grunnleggende. Blokkering av kategorier kan påvirke opplevelsen din på nettstedet. Mer informasjon

Slik velger AI-assistenter kildene sine: henting, forgrening av søk, hva OpenAI, Google, Perplexity, Anthropic og Microsoft dokumenterer, og hva våre data viser.

Verktøy

Kort fortalt
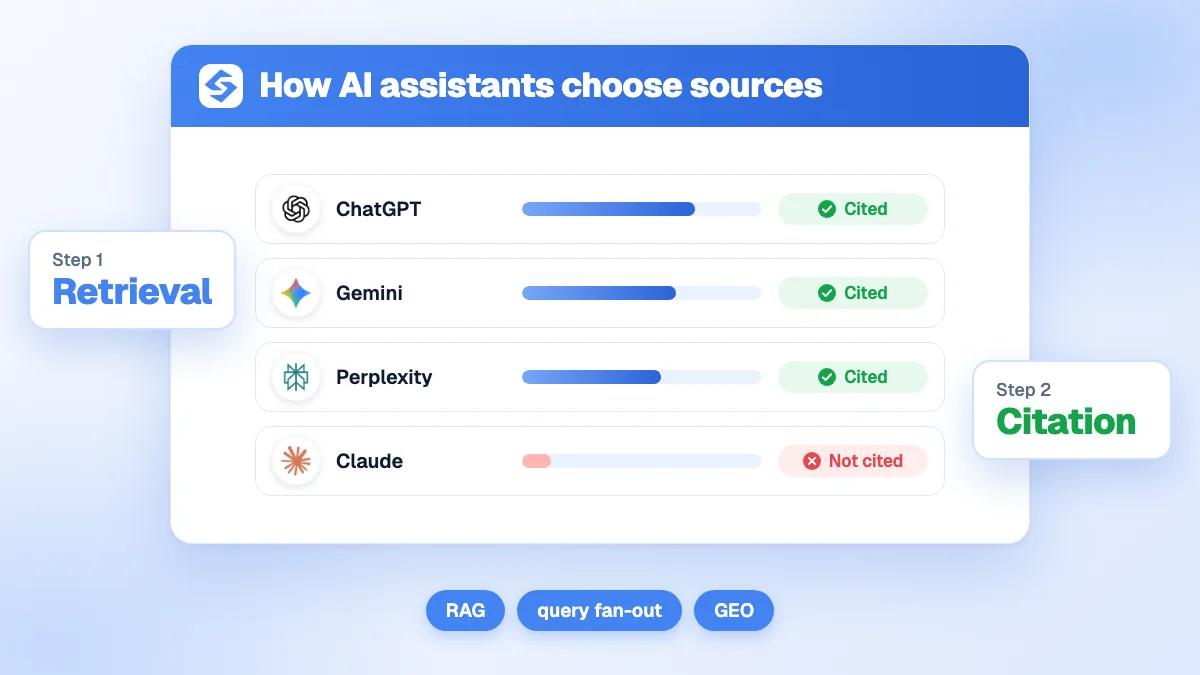
AI-assistenter velger kildene sine i to trinn. Først henter de: modellen gjør spørsmålet om til ett eller flere websøk (forgrening av søk, query fan-out) og henter kandidatsider fra en søkeindeks (Google, Bing, Brave eller egen indeks). Deretter velger de: modellen leser avsnittene, beholder dem som svarer på et delspørsmål tydelig og med dokumentasjon, og siterer dem. En side må derfor kunne gjennomsøkes av assistentens robot, være indeksert, være relevant for de skjulte delsøkene og være lett å sitere, og hver assistent foretrekker ulike typer nettsteder.
Vil du vite mer? Spør
Rask quiz
Hvordan får du omtale fra ChatGPT og andre AI-assistenter?
Sorank passer til svarene dine


Prøv det i 3 dager på ditt eget nettsted, og se hvor du står på Google, ChatGPT og de andre AI-assistentene.
Start en gratis prøveperiode på 3 dager3 dager gratis, deretter kan du stoppe når du vil. Resultatgaranti i 90 dager, ellers pengene tilbake.
Å forstå hvordan AI-assistenter velger kildene sine er utgangspunktet for alt arbeid med synlighet i AI. Den gode nyheten er at leverandørene dokumenterer mer enn de fleste tror. Google skriver i sin dokumentasjon om AI-funksjoner at AI Overviews og AI Mode kan kjøre flere beslektede søk på tvers av delemner, og at en side bare må være indeksert og kvalifisert for et utdrag for å vises som støttelenke. OpenAI, Perplexity, Anthropic og Microsoft publiserer lignende regler for sine egne assistenter. Denne guiden samler det som er offisielt, skiller det fra gjetning, og legger til det vi har målt på 301025 AI-svar.
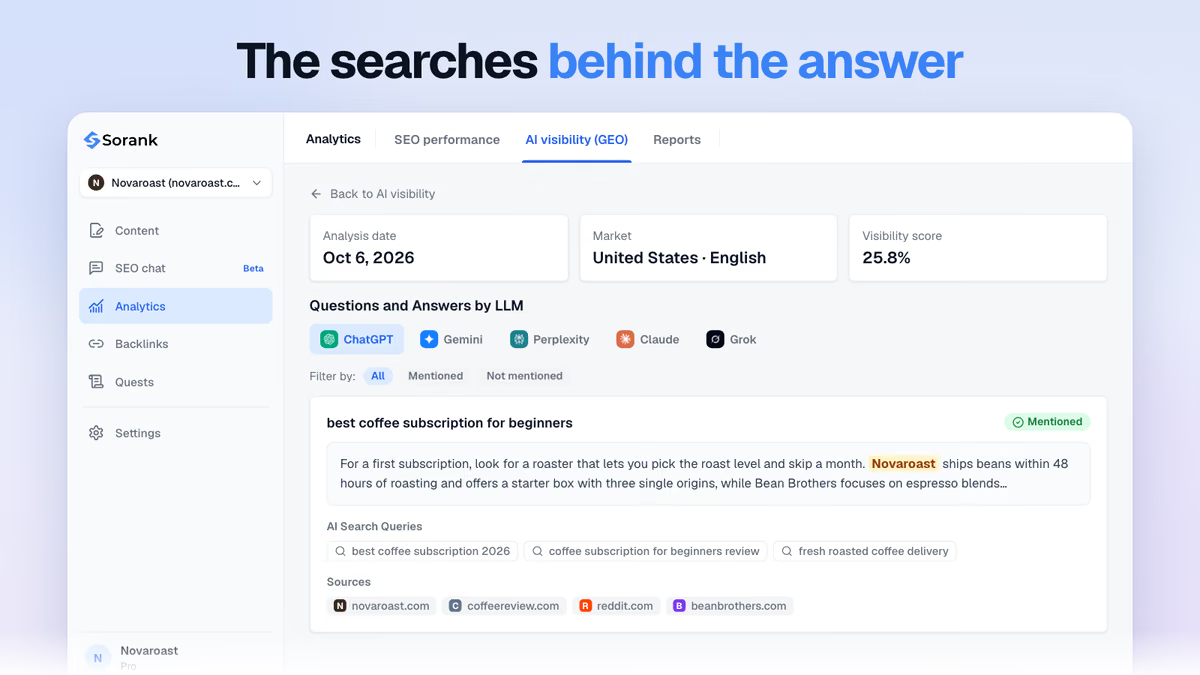
Nesten alle assistenter med tilgang til nettet følger samme mønster, kalt hentingsforsterket generering (RAG): modellen svarer ikke bare fra hukommelsen, den henter først dokumenter og skriver deretter ut fra dem. Stegene er følgende.
To konsekvenser følger av dette. En side som ikke er i indeksen assistenten bruker, kommer aldri med i kappløpet, uansett hvor god den er. Og en side kan ligge på førsteplass i Google for brukerens nøyaktige spørsmål, men likevel tape siteringen, fordi assistenten søkte etter noe annet.
Ingen av de fem publiserer en rangeringsformel. Hver av dem publiserer imidlertid regler for tilgang, indeksering og sitering, og disse reglene er det eneste faste grunnlaget.
| Assistent | Hvor kandidatene kommer fra | Hva leverandøren dokumenterer |
|---|---|---|
| Google (AI Overviews, AI Mode) | Googles indeks | Forgrening av søk på tvers av delemner; en side må være indeksert og kvalifisert for utdrag; ingen spesiell fil, markering eller skjema kreves |
| ChatGPT-søk | Egen gjennomsøking og søkepartnere | Nettsteder som sier nei til OAI-SearchBot vises ikke i svar fra ChatGPT-søk; GPTBot gjelder bare trening |
| Perplexity | Egen indeks bygget av PerplexityBot | PerplexityBot viser og lenker til nettsteder i resultatene; Perplexity-User henter en side når brukerens spørsmål krever det |
| Claude | En ekstern søkeindeks (Brave er oppgitt) pluss Anthropics roboter | Claude avgjør når den skal søke, kan søke flere ganger per forespørsel, og legger alltid ved siteringer |
| Microsoft Copilot | Bings indeks | Siteringer utløses av forankringssøk, som rapporteres i Bing Webmaster Tools; ferskt, strukturert og dokumentert innhold anbefales |
OpenAIs dokumentasjon av sine robotter skiller tre agenter. OAI-SearchBot bygger søkeindeksen: nettsteder som blokkerer den, vises ikke i svar fra ChatGPT-søk. GPTBot samler inn treningsdata, og å blokkere den har ingen effekt på søk. ChatGPT-User besøker en side på vegne av en bruker og bestemmer ikke hva som vises i søk. Guiden vår om rangering i ChatGPT går nærmere inn på resten.
Google er den mest eksplisitte: AI-funksjonene bruker samme indeks og samme kvalitetssystemer som vanlig søk, de kan kjøre en forgrening av beslektede søk, og de kan vise et bredere sett støttelenker enn ti blå lenker. Det finnes ingen AI-spesifikk markering å legge til. Med andre ord er SEO for Google fortsatt billetten inn til Googles AI-svar.
Perplexitys dokumentasjon om roboter sier at PerplexityBot finnes for å vise og lenke til nettsteder i resultatene, og at den ikke brukes til å trene grunnmodeller. Perplexity-User henter sider i sanntid for brukerens spørsmål. At PerplexityBot er tillatt i robots.txt, er forutsetningen for å være med i indeksen.
Anthropics dokumentasjon om websøk beskriver løkken presist: Claude avgjør når den skal søke ut fra forespørselen, søket kan gjentas flere ganger innenfor én forespørsel, og det endelige svaret har alltid siteringer, der hver siterer opptil 150 tegn fra kilden. Claude søker etter aktuelle priser, nylige hendelser og opplysninger om bestemte organisasjoner eller produkter, og svarer på stabil kunnskap uten å søke. Guiden vår om rangering i Claude dekker robotene og indeksen.
Copilot bygger på Bing. Siden februar 2026 har Bing Webmaster Tools en rapport kalt AI Performance som viser hvor ofte et nettsted siteres i Copilot, og forankringssøkene som hentet sidene. Microsofts råd i samme kunngjøring: hold innholdet ferskt (med IndexNow), strukturer det med tydelige overskrifter, tabeller og vanlige spørsmål, og støtt påstander med data og kilder. Se guiden vår om rangering i Copilot, og den om rangering i Grok for xAIs assistent, som dokumenterer mye mindre.
Merk
Mange artikler lister «rangeringsfaktorer» for AI-svar med vekter i prosent. Ingen leverandør har publisert slike vekter. Behandle enhver presis formel som en hypotese, og stol på reglene over og på dine egne målinger.
Ved å kombinere den offisielle dokumentasjonen med det man kan observere i svarene, forklarer seks kriterier det meste av siteringene. De to første er dokumenterte krav, de andre er konsekvente mønstre.
Assistentens søkerobot må være tillatt, og siden må være i indeksen den spør: Googles for Gemini og AI Overviews, Bings for Copilot, OpenAIs og Perplexitys egne indekser, Brave for Claude. Sjekk reglene dine med guiden vår om robots.txt for AI-roboter.
Hentingen skjer på søkene fra forgreningen, ikke på brukerens setning. En side som svarer på «beste CRM» i generelle termer, kan tape mot en side som svarer på «CRM for et eiendomsmeglerfirma med 5 ansatte, pris per bruker», fordi det er det assistenten søkte etter.
Assistenter siterer avsnitt. Et avsnitt som åpner med et direkte svar, en definisjon, en tabellrad eller et nummerert steg, kan hentes ut av siden og fortsatt gi mening. En vag innledning kan ikke det.
Claude søker nettopp når opplysninger kan ha endret seg, og Microsoft anbefaler å støtte påstander med data og kilder. Daterte tall, navngitte kilder, priser «kontrollert» på en gitt dato og synlige oppdateringsdatoer gjør en side tryggere å sitere.
En assistent som finner det samme faktumet på flere uavhengige nettsteder, kan fremstille det med tillit. Dette er entitetskonsensus: anmeldelser, sammenligninger, kataloger og pressomtaler som beskriver merkevaren din likt.
Hver assistent har sine vaner. Noen lener seg på leksikonkilder, andre på video, forum eller anmeldelsesplattformer. Neste avsnitt viser hvor store disse forskjellene er.
Tips
Før du skriver en side for synlighet i AI, still spørsmålet til to eller tre assistenter og noter søkene de kjører, og nettstedene de siterer. Søkene forteller deg hvilken vinkel du må dekke, og de siterte nettstedene forteller deg hvilket format som vinner.
Vår studie av plattformsiteringer analyserte 301025 svar fra ChatGPT, Gemini, Perplexity, Claude og Grok, samlet inn mellom august 2025 og august 2026 på et panel av kjøperspørsmål (79% stilt på fransk). Den talte 1820738 AI-siteringer som peker til 131349 ulike domener. To funn er viktige for valg av kilder.
For det første siterer ikke assistentene like mange kilder. Gemini nevner i gjennomsnitt 11,1 kilder per svar, Grok 7,1, ChatGPT 4,1, Claude 3,5 og Perplexity 3,3. For de tre siste har et spørsmål tre eller fire plasser, så å være den nest beste siden betyr ofte at du ikke blir sitert i det hele tatt.
| Plattform | ChatGPT | Gemini | Perplexity | Claude | Grok |
|---|---|---|---|---|---|
| Wikipedia | 3,43% | 1,38% | 0,19% | 0,03% | 1,08% |
| YouTube | 0,04% | 3,69% | 3,46% | 0% | 2,76% |
| 0,33% | 2,5% | 1,51% | 0% | 4,11% | |
| Trustpilot | 2,7% | 4,33% | 1,21% | 1,57% | 1,8% |
For det andre er de foretrukne kildetypene helt ulike fra én assistent til en annen. Wikipedia dukker opp i 3,43% av svarene fra ChatGPT og 0,03% av svarene fra Claude; YouTube i 3,69% av svarene fra Gemini og 0,04% av svarene fra ChatGPT. Bare 6 plattformer siteres av alle fem modellene. Vår studie av siteringer i ChatGPT viser også at valget endrer seg over tid: ChatGPT gikk fra 5,8 til 4,1 kilder per svar i perioden, med et lavpunkt på 1,7 i juni 2026.
Utvalgsprosessen oversettes til en kort liste med tiltak, som gjelder både for Google og for AI-ene.
Eksempel
En kjøper spør «hvilket regnskapsprogram passer for en frilanser i Norge?». Assistenten søker etter «regnskapsprogram frilanser pris» og «sammenligning av fakturaprogram for enkeltpersonforetak». En programvareleverandør med en offentlig prisside og en sammenligningsside datert i år treffer begge søkene, mens en med bare et slagord på forsiden ikke treffer noen.
Svarene varierer fra én kjøring til den neste, så valg av kilder best observeres over uker. Sorank sin overvåking av forgrening av søk i AI registrerer søkene hver assistent kjører på prompterne dine, og teller dem over tid. Overvåking av AI-omtaler viser om merkevaren din siteres, og hvilke kilder som tar plassen når den ikke gjør det. AI-assistenter velger sidene de kan nå, som samsvarer med de skjulte søkene deres, og som dokumenterer det de sier: mål disse tre tingene på dine egne spørsmål, så vet du hva du må fikse.

Det avhenger av assistenten. Google AI Overviews, AI Mode og Gemini bygger på Googles indeks, Microsoft Copilot bygger på Bing, ChatGPT og Perplexity kjører egne roboter og indekser, og for Claude er det oppgitt at Brave Search brukes. En side som er godt indeksert på Google og Bing dekker de fleste tilfeller, men robotene til hver assistent må også være tillatt.
Nei. Assistenter søker med egne omskrevne søk og siterer avsnitt, ikke rangeringer. En side som ligger først for brukerens nøyaktige spørsmål, kan bli hoppet over hvis den ikke svarer på delspørsmålet assistenten søkte etter, eller hvis en annen side sier svaret tydeligere og med dokumentasjon. Gode Google-rangeringer øker sjansene, men garanterer ingenting.
De bruker ulike indekser, kjører ulike søk og har ulike preferanser for kilder. Vår studie av 301025 svar viser for eksempel at Wikipedia dukker opp i 3,43% av svarene fra ChatGPT, men 0,03% av svarene fra Claude, mens YouTube er hyppig hos Gemini og nesten fraværende hos ChatGPT. Optimalisering for én assistent overføres ikke automatisk til de andre.
Vi analyserer konkurrentene dine, nettstedet ditt og synligheten din i AI for å lage en skreddersydd innholdsplan, gratis.
 KI-generator for innholdsbrief
 Generator for FAQ-schema
 Generator for blogg-ideer med AI
 Validator for strukturerte data (schema-validator)
 Sjekk av alt-tekst
 Analyse av interne lenker
 Lenkeutfordringen
 KI-generator for metabeskrivelser
 KI-generator for bloggtitler
 Indekserbarhetssjekker for Google
 KI-generator for bloggdisposisjon
 Generator for UTM-lenker
 Verktøy for gruppering av søkeord
 Sjekk av kanonisk tagg
 XML-sitemap-generator
 Sjekk av ødelagte lenker
 KI-generator for SEO-tittel
 Overskriftsanalyse
 SERP-forhåndsvisning
 Kontroll av omdirigeringer
 Generator for hreflang-tagger
 Analyse av overskriftsstruktur
 Kontroll av HTTP-headere
 Favikon-henter
 SERP CTR-kalkulator
 Sparekalkulator: SEO mot betalt søk
 Kalkulator for SEO-synlighetsandel
 ROI-kalkulator for SEO
 SEO-prognosekalkulator for trafikk og inntekter
 SEO-budsjettkalkulator
 SEO-nullpunktkalkulator
 ROI-kalkulator for SaaS-SEO
 ROAS-kalkulator
 Lesetidskalkulator
 Simulator for rangeringsgevinst
 Kalkulator for verdien av organisk trafikk
 Estimator for organisk trafikk og sjekk av nettstedstrafikk
 Kalkulator for LTV til CAC-forhold
 Kalkulator for avkastning på lokal SEO
 Kalkulator for kostnad ved lenkebygging
 Kalkulator for søkeordverdi
 Kalkulator for poengsum for søkeordmuligheter
 Kalkulator for tetthet av søkeord
 Kalkulator for GEO-avkastning
 Kalkulator for investering i GEO-innhold
 Kalkulator for SEO-avkastning i netthandel
 Kalkulator for kundens levetidsverdi
 Kalkulator for kundeanskaffelseskostnad
 CTR-kalkulator
 Kalkulator for kostnad per artikkel
 Kalkulator for konverteringsrate
 Kalkulator for ROI i innholdsmarkedsføring
 Estimator for ChatGPT-trafikk
 Kalkulator for avvisningsrate
 Kalkulator for backlink-ROI
 Kalkulator for AI-synlighetspoeng
 Kalkulator for verdien av AI-trafikk
 Kalkulator for AI-synlighetsandel
 Kalkulator for kostnaden av AI-usynlighet
 Kalkulator for AI-siteringsrate
 llms.txt-validator
 AI Overview-sjekker og rangeringssjekker for AI Overviews
 Robots.txt-sjekker
 KI-SEO-revisjon
 Sjekk av lesbarhet for LLM
 Sjekk av klargjøring for SearchGPT
 Revisjon av strukturerte data for LLM
 KI-revisjon av crawlbarhet
 Hvorfor ChatGPT ikke anbefaler nettstedet mitt
 Gemini-rangeringsverktøy
 Sjekk av rangering i Perplexity
 Sjekk av LLM-sitater
 AEO-revisjon
 GEO-revisjon
 Test av synlighet i AI-søk
 Sjekk av synlighet i ChatGPT
 llms.txt-generator
 URL-uttrekker
 Nettside til Markdown
 Sjekk av sitemap
 Sensor for SERP-volatilitet
 Sidestørrelsessjekk
 Ordteller
 Slug-generator
 Schema-generator
 Robotgenerator
 OG-forhåndsvisning
 Generator for metatagger
 Bildekomprimerer
 Favicon-generator
 Revisjon av on-page SEO: SEO-sjekk og SEO-analyse
 Verktøy for analyse av tilbakelenker
 Verktøy for søkeordforslag
 Sjekk av domeneautoritet
DE PRØVDE SORANK FØR DEG
 “Jeg testet Sorank på et ekte kundenettsted, og det er helt utrolig. Det gjør alt et byrå ville tatt deg $1500 i måneden for. Nå går det i produksjon på den kunden.”

 Guillaume Guersanguersanguillaume.com“Vi er et annonsebyrå, og vi ville få SEO-en vår på rett spor en gang for alle. Sorank ga oss en tydelig oversikt over nettstedet vårt, hjalp oss å prioritere optimaliseringene og å strukturere innholdet vårt på riktig måte. Verktøyet er enkelt å bruke, godt utformet for et team, og veldig praktisk for å samle oppfølgingen på ett sted uten å jonglere med flere plattformer. Et veldig solid grunnlag for å starte på nytt med SEO.”
 Gaspard MadouiAnnonsebyrå
 “Jeg lot bare Sorank-programvaren gjøre jobben sin, og nå er DR-en min 25, og siden min rangerer høyere.”
 Lucas Flandrefoundertrace.fr“Jeg spesialiserte meg på GEO takket være Sorank. GEO-rangeringen lar meg vise kundene mine hvor de står mot konkurrentene på ChatGPT. Det er en reell kommersiell fordel.”
 MélanieSEO-frilanser“Kjempebra service, den fungerer godt for nettstedet vårt og hjelper oss å forstå hvordan vi kan forbedre det for å rangere bedre på Google og andre steder. Gratulerer, fortsett slik, jeg anbefaler det.”
 Hugo T.Netthandler