आपकी गोपनीयता हमारे लिए महत्वपूर्ण है, इसलिए आपके पास कुछ प्रकार के स्टोरेज को बंद करने का विकल्प है जो वेबसाइट के बुनियादी कामकाज के लिए ज़रूरी नहीं हो सकते। कुछ श्रेणियों को बंद करने से वेबसाइट पर आपके अनुभव पर असर पड़ सकता है। अधिक जानकारी (कुकी नीति)
धन्यवाद! आपका फ़ॉर्म सफलतापूर्वक प्राप्त हो गया है!
AI search volatility: उत्तर क्यों बदलते रहते हैं और उन पर कैसे प्रतिक्रिया दें
AI search के उत्तर हर रन पर क्यों बदलते हैं, वे कितना हिलते हैं, और एक ही रैंकिंग का पीछा करने के बजाय कई prompts पर अपने ब्रांड की उपस्थिति कैसे मापें।
3 दिन मुफ़्त, फिर जब चाहें बंद करें। 90 दिन की परिणाम गारंटी, शर्तें लागू।
संक्षेप में: AI search volatility का मतलब है कि AI उत्तर में दिखने वाले ब्रांड, URL और उनका क्रम एक रन से दूसरे रन में, और एक हफ्ते से दूसरे हफ्ते में, कितना बदलता है। एक ही सवाल पर अलग ब्रांड सूची, अलग citations और अलग क्रम आ सकता है, क्योंकि उत्तर randomness के साथ बनता है और retrieval का चरण भी बदलता रहता है। इसलिए AI उत्तर के भीतर किसी स्थिति को मापने का तरीका अच्छा नहीं है। मापिए कि कई prompts और कई runs में आपका ब्रांड कितनी बार दिखता है, फिर वे स्रोत बनाइए जो इस उपस्थिति को स्थिर रखें।
AI search volatility का मतलब क्या है
Google के organic search में volatility का मतलब है कि किसी keyword पर आपकी रैंकिंग ऊपर-नीचे होती है। AI search में बात इससे आगे जाती है। हर रन पर उत्तर ही अलग होता है। एक volatile AI उत्तर तीन तरह से बदल सकता है: वह कौन से ब्रांड का नाम लेता है, कौन से URL का हवाला देता है, और किस क्रम में उन्हें रखता है। इनमें से कोई भी बदलाव आपकी वेबसाइट में एक भी परिवर्तन किए बिना हो सकता है।
यह अंतर मायने रखता है, क्योंकि रैंकिंग किसी एक क्षण का स्थिर परिणाम होती है। Google एक क्रमबद्ध सूची लौटाता है, और उसी बाज़ार में उसी query के लिए वह सूची ज़्यादातर दोहराई जा सकती है। AI model संभावित उत्तरों की एक श्रृंखला में से एक नमूना लौटाता है। आपके ब्रांड के उस श्रृंखला में आने की एक संभावना होती है। वही संभावना है जिसे आप माप सकते हैं और बदल सकते हैं।
2026 में प्रकाशित एक अध्ययन की दो संख्याएँ बताती हैं कि यह प्रभाव कितना बड़ा है। SparkToro के Rand Fishkin ने Gumshoe.ai के Patrick O'Donnell के साथ काम किया। लगभग 600 स्वयंसेवकों ने ChatGPT, Claude और Google के AI पर 12 prompts चलाए, कुल 2961 runs। शोधकर्ताओं को पाया कि ChatGPT या Google के AI के दो बार एक ही ब्रांड सूची लौटाने की संभावना 100 में से 1 से भी कम है। एक ही ब्रांड सूची, एक ही क्रम में, आने की संभावना लगभग 1000 runs में 1 थी। SparkToro की रिपोर्ट, 28 जनवरी 2026 की है, और नवंबर व दिसंबर 2025 के डेटा पर आधारित है।
AI ब्रांड सूचियाँ कितनी स्थिर हैं?
296112 prompts और तीन AI सिस्टम में कुल runs
<1%ChatGPT या Google के AI के दो बार एक ही ब्रांड सूची लौटाने की संभावना
<0.1%एक ही ब्रांड सूची, एक ही क्रम में, आने की संभावना
स्रोत: SparkToro और Gumshoe.ai, जनवरी 2026
जब आप मान लेते हैं कि आउटपुट एक नमूना है, तो उसे ट्रैक करने का तरीका भी बदलना होगा। नीचे की तुलना दोनों सोच का सार है। यह पूरी गाइड का मूल विचार है।
रैंक ट्रैक करना बनाम उपस्थिति ट्रैक करना
एक अकेली स्थिति
लगभग हर रन पर बदल जाती है
एक उत्तर से बहुत कम पता चलता है
रनों में हिस्सा
दर्जनों prompts पर मापा जाता है
एक ऐसा रुझान दिखाती है जिस पर आप कार्रवाई कर सकें
ब्रांड सूचियों में volatility
सबसे साफ़ बदलाव ब्रांड सूची में होता है। "10 लोगों की टीम के लिए सबसे अच्छा project management tool" जैसा prompt एक रन में पाँच ब्रांड दे सकता है और अगले रन में पाँच अलग। कुछ ब्रांड बार-बार लौटते हैं, कुछ अंदर-बाहर होते रहते हैं। सूची के भीतर की स्थिति की तुलना में सूची में होना अधिक स्थिर है, इसीलिए शोधकर्ता रैंक की जगह उपस्थिति ट्रैक करने की सलाह देते हैं।
इसका व्यावहारिक असर है। अगर आपने कोई सवाल एक बार जाँचा और आपका ब्रांड दूसरे स्थान पर दिखा, तो आप लगभग कुछ नहीं जानते। अगर उसे 60 बार जाँचा और 40 उत्तरों में आपका ब्रांड दिखा, तो आप कुछ उपयोगी जानते हैं: उस सवाल पर आप एक नियमित पसंद हैं।
citations में volatility
Citations वे links हैं जिन्हें AI model स्रोत के रूप में दिखाता है। जब model live web search करता है, तो citations ब्रांड सूची से भी ज़्यादा हिलते हैं, क्योंकि हर रन अलग pages खींच सकता है। कोई citation गायब हो जाए तो हमेशा नुकसान नहीं होता। आपका ब्रांड बिना link के भी text में नाम से आ सकता है। इसीलिए दो चीज़ें अलग-अलग ट्रैक करें: नाम से उल्लेख और citation वाला URL।
क्रम में volatility
उत्तर के भीतर स्थिति सबसे कम स्थिर तत्व है। AI model एक रन में आपके ब्रांड को पहले रख सकता है और अगले रन में चौथे, बिना इसके कि उसकी आपके बारे में समझ सच में बदली हो। जब तक क्रम दर्जनों रनों में एक ही दिशा में न खिसके, उसे शोर मानें।
एक ही सवाल पर अलग उत्तर क्यों आते हैं
ज़्यादातर बदलाव तीन तंत्रों से आते हैं। आप इन्हें बंद नहीं कर सकते, लेकिन इन्हें जानने से पता चलता है कि क्या मापना है और क्या नज़रअंदाज़ करना है।
Sampling
Language model एक "सबसे अच्छा" उत्तर नहीं चुनता। वह हर अगला शब्द एक probability distribution से चुनता है। temperature नाम की एक सेटिंग तय करती है कि यह चुनाव कितना चौड़ा है। कम मान पर आउटपुट दोहराए जाने के ज़्यादा करीब होता है, और ज़्यादा मान पर ज़्यादा बदलता है। डेवलपर API में temperature सेट कर सकते हैं, लेकिन आपके ज़्यादातर खरीदार जिन consumer apps का इस्तेमाल करते हैं, उनमें यह सेटिंग नहीं होती। मान लीजिए कि sampling हमेशा चालू रहती है। SparkToro के स्वयंसेवकों ने अपनी सामान्य सेटिंग रखी, चाहे वह personalized हो या default, इसलिए उनके नतीजे वही बताते हैं जो एक आम उपयोगकर्ता देखता है।
Retrieval और sub-queries
जब AI model वेब खोजता है, तो वह आपका सटीक सवाल किसी search engine को नहीं भेजता। वह उसे कई sub-queries में दोबारा लिखता है और हर एक के लिए pages लाता है। शब्दों में थोड़ा-सा बदलाव, उस सुबह index हुआ कोई page, या किसी एक sub-query का अलग परिणाम, इनमें से कोई भी तय कर सकता है कि अंतिम उत्तर तक कौन से स्रोत पहुँचेंगे। जिन URLs से आपको cite किया जाता है, वे एक हिलते हुए retrieval चरण का आउटपुट हैं। AI models अपने स्रोत कैसे चुनते हैं, इसकी व्याख्या हमारी गाइड में है, और Sorank का ट्रैकर कि AI असल में क्या खोजता है, ठीक इसी सवाल के लिए बना है।
Model और index के अपडेट
प्रदाता बिना ज़्यादा सूचना के models और उनके आसपास के सिस्टम अपडेट करते हैं। एक नया model version, इस बात में बदलाव कि model कब खोजने का फैसला करता है, या web index में बदलाव, ये सब एक ही दिन में पूरे विषय के उत्तर बदल सकते हैं। जब आपके डेटा में अचानक एक बड़ा कदम दिखे, तो प्रतिक्रिया देने से पहले किसी संभावित अपडेट की जाँच करें, और फिर अपने baseline से तुलना करें।
तंत्र
क्या बदलता है
कैसे दिखता है
आप क्या करें
Sampling
ब्रांड सूची, शब्द और क्रम
एक ही दिन एक ही prompt पर अलग उत्तर
कई runs में मापें और एक हिस्सा (share) रिपोर्ट करें
Retrieval
Cite किए गए URLs
हफ्ते-हफ्ते अलग स्रोत cite होना
वे pages और third-party स्रोत मज़बूत करें जो अच्छी तरह retrieve होते हैं
Model और index अपडेट
पूरा उत्तर-शैली और कौन से ब्रांड पसंद किए जाते हैं
किसी खास तारीख पर एक बड़ा बदलाव
baseline रखें और हर पहचाने जा सकने वाले अपडेट को नोट करें
AI उत्तर हर रन पर बदलते हैं। जिसे ट्रैक और विकसित किया जा सकता है, वह है कई रनों में उपस्थिति।
AI उत्तर कितने हिलते हैं
मापे गए आँकड़े अभी कम हैं, और उनमें से ज़्यादातर SEO और AI visibility vendors से आते हैं। दो स्रोत ध्यान से पढ़ने लायक हैं। पहला SEO platform Authoritas का अध्ययन है, जिसने AI Overviews की तुलना organic results से की। दूसरा BrightEdge के माप हैं, जिन्होंने AI Overviews की तुलना AI Mode से की।
Authoritas ने ranking volatility को एक score से मापा। score जितना ऊँचा, उतने ही ज़्यादा नतीजे उस अवधि में बदले। AI Overviews के लिए score 8 हफ्तों पर 0.68 और 13 हफ्तों पर 0.73 था। organic results के लिए यह 0.49 और 0.55 था। Digital Information World, जिसने फरवरी 2025 में इस अध्ययन की रिपोर्ट दी, ने यह भी कहा कि AI Overview के लगभग 70% परिणाम दो से तीन महीनों में बदल गए। उस लेख ने keyword sample या माप की तारीखें नहीं बताईं, इसलिए क्लाइंट डेक में कोई आँकड़ा देने से पहले मूल Authoritas रिपोर्ट जाँचें।
8 हफ्तों पर ranking volatility score
AI Overviews0.68
Organic results0.49
स्रोत: Authoritas अध्ययन, Digital Information World द्वारा रिपोर्ट, फरवरी 2025
वे AI Overview परिणाम जो 2 से 3 महीनों में बदल गए
70%ट्रैक किए गए AI Overview परिणामों में से
स्रोत: Authoritas अध्ययन, Digital Information World द्वारा रिपोर्ट, फरवरी 2025
BrightEdge ने वही सवाल दूसरे कोण से मापा। उसके अगस्त 2025 के विश्लेषण में पाया गया कि AI Overviews में ब्रांड mentions की volatility AI Mode से 16.7% अधिक है। उसे यह भी मिला कि AI Overviews ने अपने 24% URLs को अपरिवर्तित रखा, जबकि AI Mode के लिए यह 20% था। नीचे की तालिका ये आँकड़े एक साथ रखती है।
माप
AI Overviews
तुलना
स्रोत
Volatility score, 8 हफ्ते
0.68
organic results के लिए 0.49
Authoritas
Volatility score, 13 हफ्ते
0.73
organic results के लिए 0.55
Authoritas
Brand mention volatility
16.7% अधिक
AI Mode की तुलना में
BrightEdge, अगस्त 2025
अपरिवर्तित URLs
24%
AI Mode के लिए 20%
BrightEdge, अगस्त 2025
AI Overviews और AI Mode अलग व्यवहार क्यों करते हैं
AI Overviews कुछ queries के लिए नियमित Google results page के भीतर दिखते हैं। AI Mode एक अलग, बातचीत जैसा interface है। BrightEdge के आँकड़े बताते हैं कि AI Overviews अपने बताए गए ब्रांड्स में ज़्यादा हिलते हैं, जबकि AI Mode अपने URLs को कम स्थिर रखता है। व्यावहारिक सबक यह है कि हर surface को अलग-अलग जाँचें। "Google AI" की एक संख्या यह फर्क छिपा देती है, और यही फर्क योजना बनाने के लिए ज़रूरी है। Google AI Mode और AI Overviews की तुलना बताती है कि हर एक का SEO के लिए क्या अर्थ है।
मुख्य बात यह है कि organic स्थिरता को AI तक ले जाने की धारणा नहीं बनाई जा सकती। Authoritas के डेटा में organic results AI Overviews से कम बदलते हैं, पर वे स्थिर नहीं हैं। जो page एक महीने तक तीसरे स्थान पर रहा, वह core update के बाद गिर सकता है, इसलिए दोनों surfaces पर ऐसा तरीका चाहिए जो असली बदलाव और सामान्य उतार-चढ़ाव को अलग कर सके।
AI search में rank tracking क्यों टूटती है
ज़्यादातर rank trackers Google के लिए बने थे, जहाँ एक keyword की एक क्रमबद्ध सूची होती है जो धीरे बदलती है। वही तर्क AI model पर लगाने से एक ऐसा आँकड़ा बनता है जो एक ही नमूने पर आधारित है। अगर आपका ब्रांड एक रन में तीसरा और अगले में आठवाँ है, तो उन दोनों का औसत आपको लगभग कुछ नहीं बताता। जो tool कहता है "आप ChatGPT में नंबर 3 हैं", वह एक ही पासे के फेंक को तथ्य की तरह पेश कर रहा है। हमारी rank tracking गाइड पारंपरिक तरीका समझाती है, और यह लेख बताता है कि जब उत्तर सूची की तरह दिखाए जाने की बजाय बनाया जाता है, तब क्या बदल जाता है।
SparkToro का निष्कर्ष है कि निश्चित स्थितियों पर आधारित rank-tracking उत्पाद शोर को माप रहे हैं। अध्ययन की सलाह है कि rank की जगह उपस्थिति को ट्रैक करें। यह visibility percentage को उचित मानता है, जब उसे दर्जनों से सैकड़ों prompts पर मापा जाए और हर prompt कई बार चलाया जाए। किसी भी vendor के score पर भरोसा करने से पहले उससे sample size और उस score के पीछे का तरीका दिखाने को कहें।
एक prompt, एक screenshot बनाम मापा गया हिस्सा
पहले
एक अकेली स्थिति दिखाता है
अगले रन पर बदल जाती है
कोई margin of error नहीं, इसलिए हर हलचल असली लगती है
बाद में
उन रनों का हिस्सा दिखाता है जिनमें आपका ब्रांड आता है
कई हफ्तों में रुझान दिखाता है
बताता है कि कोई बदलाव कितना बड़ा होना चाहिए ताकि वह मायने रखे
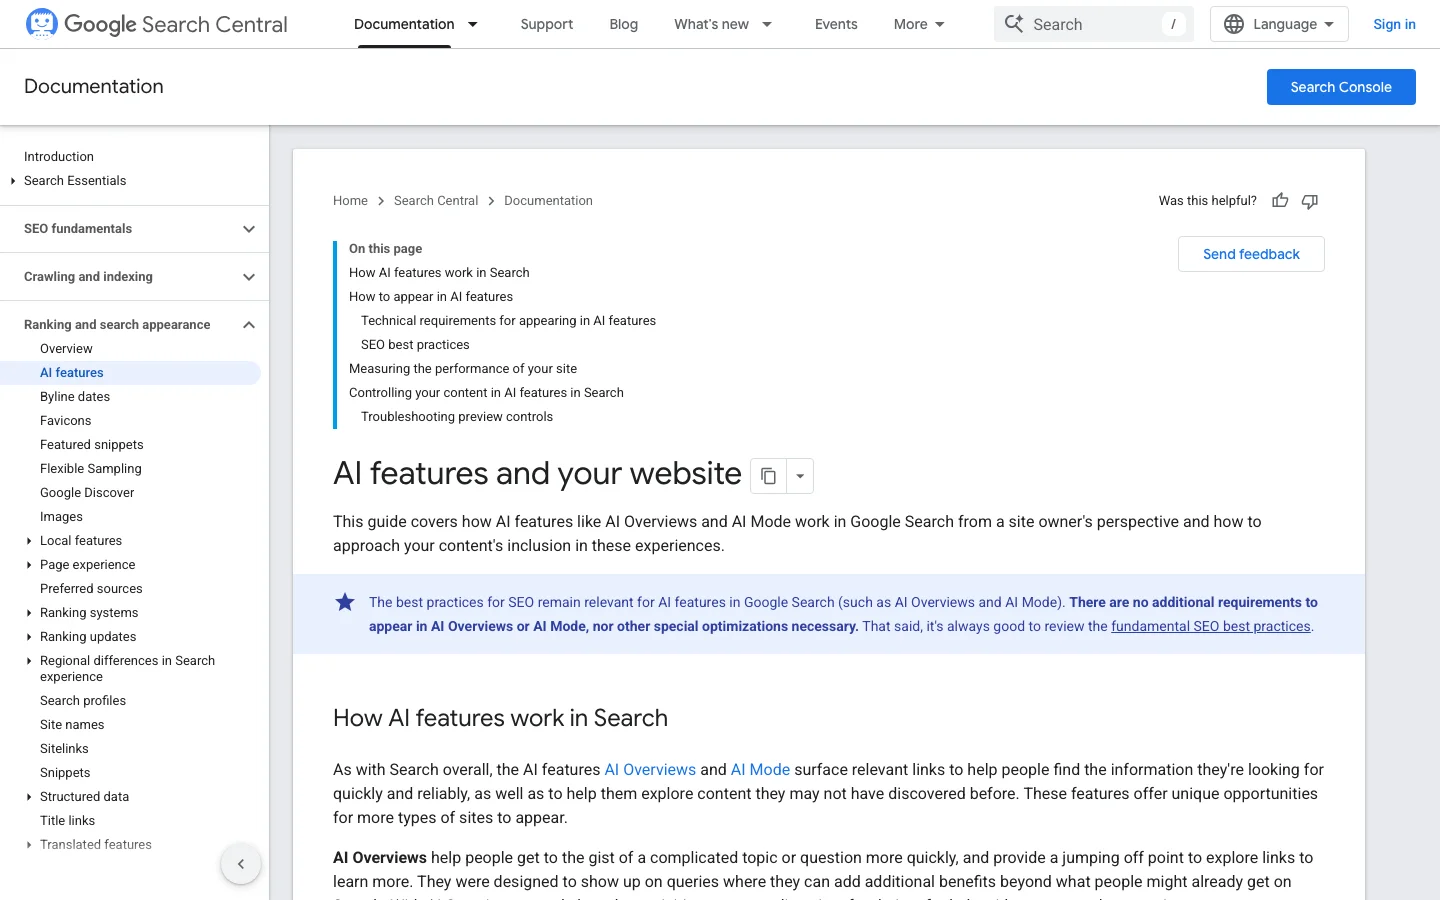
Google का अपना documentation एक अलग कारण से उसी दिशा में इशारा करता है। Google कहता है कि किसी page को AI Overviews या AI Mode में इस्तेमाल होने के लिए indexed और snippet के साथ Search में दिखने योग्य होना चाहिए। वह यह भी कहता है कि कोई खास markup या AI-specific file जोड़ने की ज़रूरत नहीं है। optimize करने के लिए कोई "AI ranking" सेटिंग नहीं है, इसलिए काम यह है कि आप कई स्रोतों पर मौजूद रहें और भरोसेमंद बनें, और उस उपस्थिति को ईमानदारी से मापें।
AI search volatility को चरण-दर-चरण कैसे मापें
नीचे का तरीका सेटअप में कुछ दिन और बनाए रखने में हर हफ्ते कुछ मिनट लेता है। आप इसे spreadsheet में चला सकते हैं। खास tools ज़्यादातर दोहराव बचाते हैं, सोचने का काम नहीं।
पाँच चरणों की माप विधि
Prompt set बनाएँ20 से 50 ऐसे सवाल चुनें जो असली खरीदार पूछते हैं। इन्हें sales calls, support chats और Search Console queries से लें।
हर prompt को कई बार चलाएँहर AI model पर हर prompt को कम से कम 30 बार चलाएँ, और आदर्श रूप से SparkToro टीम की तरह 60 से 100 बार। एक ही सेटिंग रखें और runs को कई दिनों में फैलाएँ।
हर उत्तर दर्ज करेंरिकॉर्ड करें कि आपका ब्रांड नाम से आया या नहीं, सिफारिश के रूप में आया या सिर्फ़ ज़िक्र हुआ, उसकी स्थिति क्या थी, और कौन से URLs cite हुए।
Visibility rate निकालेंजिन उत्तरों में आपका ब्रांड नाम से आया, उन्हें सभी उत्तरों से भाग दें, फिर हर prompt और हर AI model के लिए margin of error जोड़ें।
रुझान हर हफ्ते पढ़ेंसमय के साथ rate का ग्राफ बनाएँ, और model updates, अपने content बदलावों और competitor launches को नोट करें।
सूत्र, एक गणना के उदाहरण सहित
Visibility rate वह हिस्सा है जिन उत्तरों में आपका ब्रांड नाम से आता है। margin of error बताता है कि कितना बदलाव असली है। अनुपात की standard error पर आधारित 95% margin of error इस्तेमाल करें:
visibility rate = answers that name your brand / total answers
standard error = sqrt(p x (1 - p) / n)     where p is the visibility rate and n the number of runs
95% margin of error = 1.96 x standard error
यह एक काल्पनिक उदाहरण है, जिसमें संख्याएँ बनाई गई हैं, असली माप नहीं। आपका ब्रांड 80 में से 37 runs में दिखता है, तो visibility rate 46% है। standard error 5.6 points है, जिससे 95% margin of error लगभग 11 points आता है। परिणाम को "46% प्लस-माइनस 11 points" के रूप में रिपोर्ट करें। अगला बैच 40% दिखाए, तो वह इस दायरे में है, और यह पेज दोबारा लिखने का संकेत नहीं है।
नाम से आया, सिफारिश हुई और cite हुआ, ये तीन अलग स्थितियाँ हैं
कोई ब्रांड बिना link के नाम से आ सकता है, link के साथ आ सकता है पर सिफारिश न हो, या ऐसे वाक्य में सिफारिश हो सकती है जिसमें कोई प्रतियोगी नाम न हो। इन स्थितियों को अलग-अलग दर्ज करें: नाम से और सिफारिश के साथ, केवल नाम से, और केवल cite। इनके हिस्से अलग कारणों से हिलते हैं, और हर एक को अलग सुधार चाहिए। बिना नाम वाला citation एक स्रोत की समस्या है। बिना सिफारिश वाला ज़िक्र एक positioning की समस्या है।
आपकी पहली माप शीट
Prompt सूची तारीख के साथ जमी हुई हो, नए prompts नई पंक्तियों के रूप में जुड़ें
हर AI model के runs तारीख और इस्तेमाल की गई सेटिंग के साथ दर्ज हों
तीनों स्थितियाँ दर्ज हों: नाम से और सिफारिश, केवल नाम, केवल cite
हर prompt के लिए visibility rate और margin of error निकाले गए हों
नोट
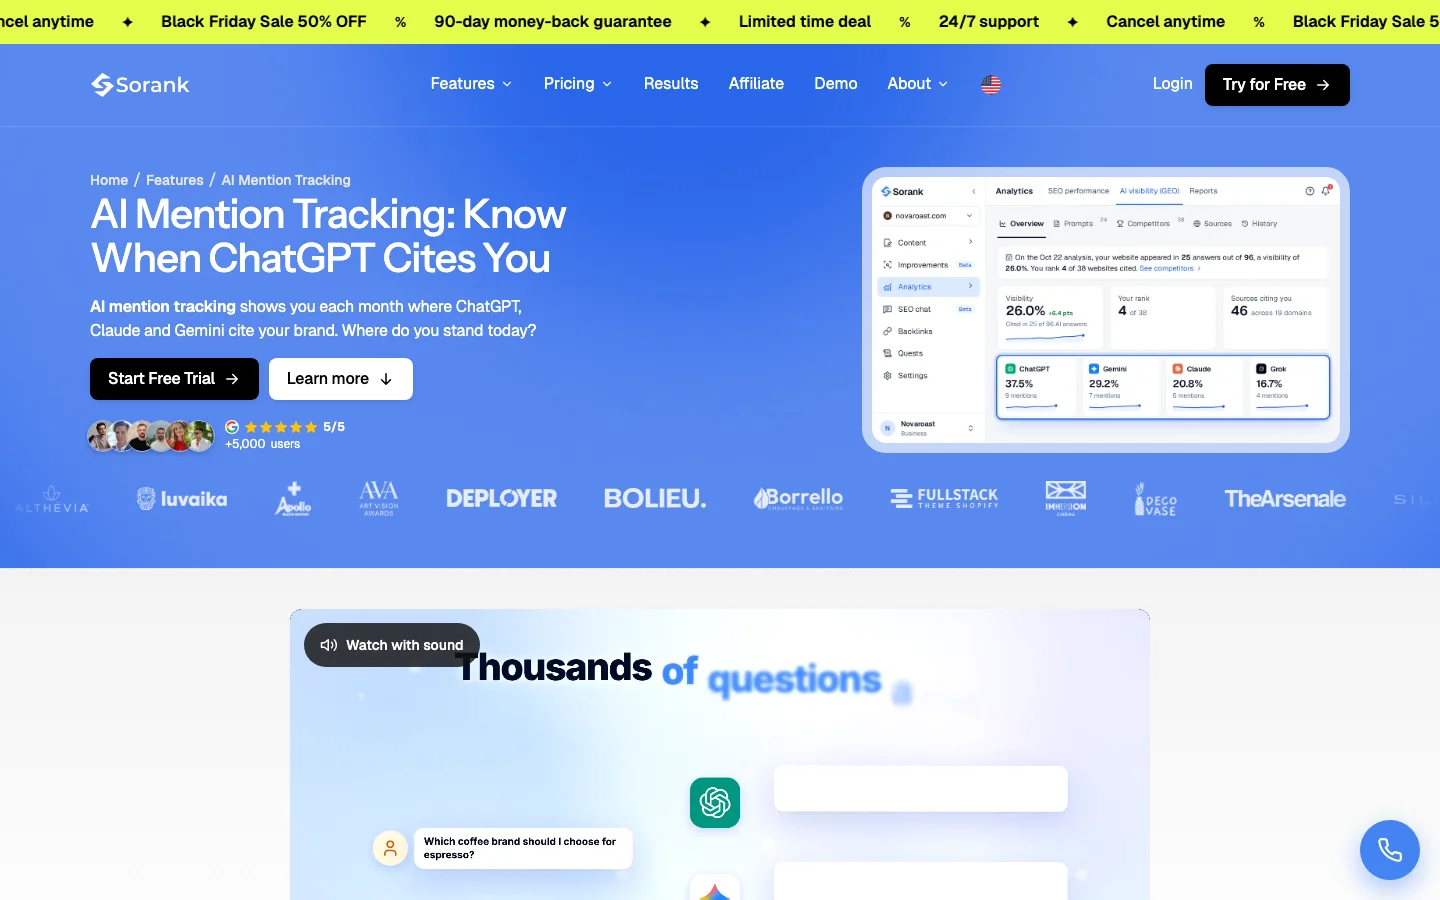
हर prompt को हाथ से दोहराना कुछ हफ्तों बाद थकाऊ हो जाता है। Sorank का AI Mention Tracking आपके ट्रैक किए गए हर prompt के लिए बताता है कि ChatGPT, Claude और Gemini आपके ब्रांड का ज़िक्र कितनी बार करते हैं, साथ में हर उत्तर के पीछे के स्रोत और searches। इसका रन मासिक होता है, जो एक prompt के लिए पतला नमूना है, इसलिए इसका रुझान कई महीनों में पढ़ें, और सबसे ज़रूरी prompts के लिए अपने दोहराए गए runs जोड़ें।
AI Mention Tracking बताता है कि ChatGPT, Claude और Gemini आपके ब्रांड का हवाला कितनी बार देते हैं।
जो लोग इसका भुगतान करते हैं, उन्हें रिपोर्ट करना
मासिक रिपोर्ट को एक सवाल का जवाब देना चाहिए: क्या आपकी उपस्थिति बदल रही है, और क्या वह बदलाव शोर से बड़ा है? एक अकेला आँकड़ा नहीं, बल्कि हर prompt समूह की visibility rate उसके margin of error के साथ दिखाएँ। साथ में position distribution जोड़ें, यानी उन उत्तरों में जहाँ आपका ब्रांड आया, वह कितनी बार पहले, दूसरे या उसके नीचे आया, ताकि क्रम एक रैंक की बजाय एक फैलाव के रूप में दिखे। सपाट या बढ़ते रुझान में उतार-चढ़ाव सामान्य है। कई बैचों में लगातार गिरावट सामान्य नहीं है, और किसी के पेज दोबारा लिखने से पहले prompts, model release notes और cite किए गए स्रोतों की जाँच करने योग्य है। कार्रवाई का नियम रिपोर्ट में ही लिखें: कोई बदलाव तभी असली माना जाएगा जब वह लगातार दो बैचों में margin of error को पार करे।
उपस्थिति को अधिक स्थिर कैसे बनाएँ
आप volatility को बंद नहीं कर सकते, लेकिन आप अपनी उपस्थिति को अधिक सुसंगत बना सकते हैं। उपस्थिति तब बढ़ती है जब आपका ब्रांड उन कई स्रोतों पर एक ही तरह से वर्णित हो, जिन्हें AI models पहले से इस्तेमाल करते हैं। Google का documentation उसकी अपनी AI features की ज़रूरतों का आधार देता है।
AI Overviews और AI Mode पर Google का मार्गदर्शन छोटा है। page को indexed होना चाहिए और snippet दिखाने के योग्य होना चाहिए। बुनियादी बातें अब भी लागू होती हैं: crawl की अनुमति देने वाले robots.txt नियम, internal links, पाठक को दिखने वाला text content, और ऐसा structured data जो दिखने वाले text से मेल खाए। Google कहता है कि दिखने के लिए आपको नई machine-readable फ़ाइलों, AI text फ़ाइलों या विशेष schema की ज़रूरत नहीं है।
AI Overviews और AI Mode पर Google का मार्गदर्शन: किसी विशेष optimization की ज़रूरत नहीं है।
अपने ब्रांड को हर जगह एक ही तरह से बताएँ
AI models एक ब्रांड की तस्वीर कई जगहों से एक साथ बनाते हैं। अगर आपके वेबसाइट, प्रोफ़ाइल और directory listings में नाम, श्रेणी, मुख्य use case और स्थान अलग-अलग हैं, तो तस्वीर धुंधली हो जाती है और ब्रांड सूची कम स्थिर। एक छोटा, तथ्यपरक विवरण लिखें, जिसमें श्रेणी और use cases हों, और उसे हर उस जगह दोबारा इस्तेमाल करें जहाँ आप text नियंत्रित कर सकते हैं। हर तिमाही उसकी जाँच करें।
पहले से भरोसेमंद स्रोतों पर उल्लेख कमाएँ
corroboration का मतलब है कि कई स्वतंत्र स्रोत आपके बारे में एक ही बात कहें। reviews, तुलना लेख, उद्योग directories और आपके क्षेत्र की trade publications आम जगहें हैं। ये उल्लेख उपयोगी काम से कमाएँ, जैसे मूल डेटा, साफ़ product comparison, या ऐसा tool जिसे लोग सच में इस्तेमाल करें। इन्हें खरीदें नहीं। paid placements शोर जोड़ते हैं, और वे ऐसा पैटर्न हैं जो भुगतान रुकते ही टूट जाता है।
हर मुख्य पेज पर मुख्य सवाल का सीधा जवाब दें
AI models पूरे पेज नहीं, बल्कि passages निकालते हैं। जो पेज पहले पैराग्राफ़ में छोटी परिभाषा, मुख्य सवाल का सीधा उत्तर और एक साफ़ अगला कदम दे, उसे निकालना और सही ढंग से cite करना आसान होता है। हमारी GEO checklist हर पेज पर जाँचने वाले बिंदु बताती है।
आपके ब्रांड के लिए स्थिरता checklist
मुख्य पेज indexed हैं और snippet दिखाने योग्य हैं
हर profile और directory पर एक ही ब्रांड नाम और श्रेणी है
सिर्फ़ अपनी साइट पर नहीं, कई स्वतंत्र साइटों पर उल्लेख हैं
Structured data वही दिखाता है जो पाठक को दिखता है
हर मुख्य पेज के पहले पैराग्राफ़ में सीधा उत्तर है
volatility पर प्रतिक्रिया के चार तरीके
टीमें volatility पर चार आम तरीकों से प्रतिक्रिया देती हैं। हर एक का उपयोग और सीमा है। इन्हें सबसे अच्छे की रैंकिंग की तरह नहीं, बल्कि मिलाकर इस्तेमाल होने वाले विकल्पों की तरह पढ़ें। ज़्यादातर टीमें पहला और आखिरी साथ इस्तेमाल करती हैं।
रोज़ की रैंक ट्रैक करें
सिद्धांत: हर दिन एक prompt पूछें और उत्तर में अपने ब्रांड की स्थिति दर्ज करें। कब इस्तेमाल करें: जब किसी खास query में तेज़ बदलाव का शुरुआती संकेत चाहिए। फायदे: परिचित है, सस्ता है, और ग्राफ़ बनाना आसान है। सीमाएँ: यह हर दिन एक नमूना है, और यह असली नुकसान और सामान्य उतार-चढ़ाव में फर्क नहीं कर सकता। उदाहरण: एक prompt सोमवार को आपके ब्रांड का नाम लेता है, बुधवार को नहीं। ग्राफ़ गिरावट दिखाता है, पर एक run यह नहीं बता सकता कि स्थिति खोई गई या यह सामान्य विचलन है।
कई runs में उपस्थिति ट्रैक करें
सिद्धांत: बहुत सारे prompts को कई बार चलाएँ और उन उत्तरों का हिस्सा रिपोर्ट करें जो आपके ब्रांड का नाम लेते हैं, उसके margin of error के साथ। कब इस्तेमाल करें: रिपोर्टिंग के लिए एक संख्या चाहिए, या content निवेश का फैसला करना है। फायदे: यह उसी तरह मेल खाता है जैसे आउटपुट बनता है, और एक झूठे बिंदु की बजाय एक सीमा देता है। सीमाएँ: ज़्यादा runs लगते हैं, और prompt set को स्थिर रखने में अनुशासन चाहिए। उदाहरण: 80 runs में आपकी visibility rate 46% प्लस-माइनस 11 points है। अगले महीने यह 52% है। आप कह सकते हैं कि रुझान ऊपर है, पर अभी यह नहीं कह सकते कि यह असली लाभ है, इसलिए अगले बैच का इंतज़ार करते हैं।
कई स्रोतों पर corroboration बनाएँ
सिद्धांत: वही सटीक दावे कई स्वतंत्र स्रोतों पर दिखें। कब इस्तेमाल करें: आपकी positioning साफ़ है और आप ऐसी सिफारिशें चाहते हैं जो टिकें। फायदे: यह AI उत्तरों और पारंपरिक search दोनों में मदद करता है, और असर लंबे समय तक रहता है। सीमाएँ: यह धीमा है, और एक महीने में शायद ही कोई नतीजा दिखता है। उदाहरण: एक software कंपनी के use cases दो reviews, एक comparison page और एक industry directory में वर्णित हुए, इसलिए AI models अलग-अलग prompts में एक ही विवरण दोहराते हैं।
सीधे उत्तरों के साथ मुख्य पेज रिफ़्रेश करें
सिद्धांत: उन pages को अपडेट करें जो आपके मुख्य सवालों का जवाब देते हैं, ताकि उत्तर साफ़, सटीक और तारीख वाला हो। कब इस्तेमाल करें: आपका पेज cite होता है पर गलत तरीके से वर्णित है, या जहाँ आपका पेज cite होना चाहिए वहाँ किसी competitor का पेज cite होता है। फायदे: यह जल्दी होता है, और passages निकालने में सुधार करता है। सीमाएँ: बेहतर पेज उल्लेख की गारंटी नहीं है, और बदलाव को आपके डेटा में दिखने में समय लगता है। उदाहरण: एक glossary page के ऊपर एक-वाक्य की परिभाषा, एक छोटा तुलना table और एक दिखने वाला update note जोड़ा गया, और अगले माप बैच में सही विवरण दिखा।
तरीका
यह क्या बताता है
संकेत की स्थिरता
प्रयास
सबसे उपयुक्त
रोज़ की रैंक
एक दिन की एक स्थिति
कम
कम
एक query में तेज़ बदलाव पकड़ना
कई runs में उपस्थिति
उत्तरों का हिस्सा जो आपके ब्रांड का नाम लेते हैं
अधिक, margin of error के साथ
मध्यम से अधिक
रिपोर्टिंग और बजट के फैसले
Corroboration
स्रोत आपका वर्णन कितनी लगातार करते हैं
महीनों तक अधिक
अधिक
लंबे समय की सिफारिशें
Page refresh
मुख्य pages सवाल का कितना अच्छा जवाब देते हैं
मध्यम
मध्यम
गलत या गायब वर्णन ठीक करना
दो तरह की volatility के लिए tools
Google के organic results और AI उत्तरों के लिए अलग उपकरण चाहिए। दोनों को मिलाने से गलत निष्कर्ष निकलते हैं, इसलिए अपनी रिपोर्टिंग में उन्हें अलग रखें।
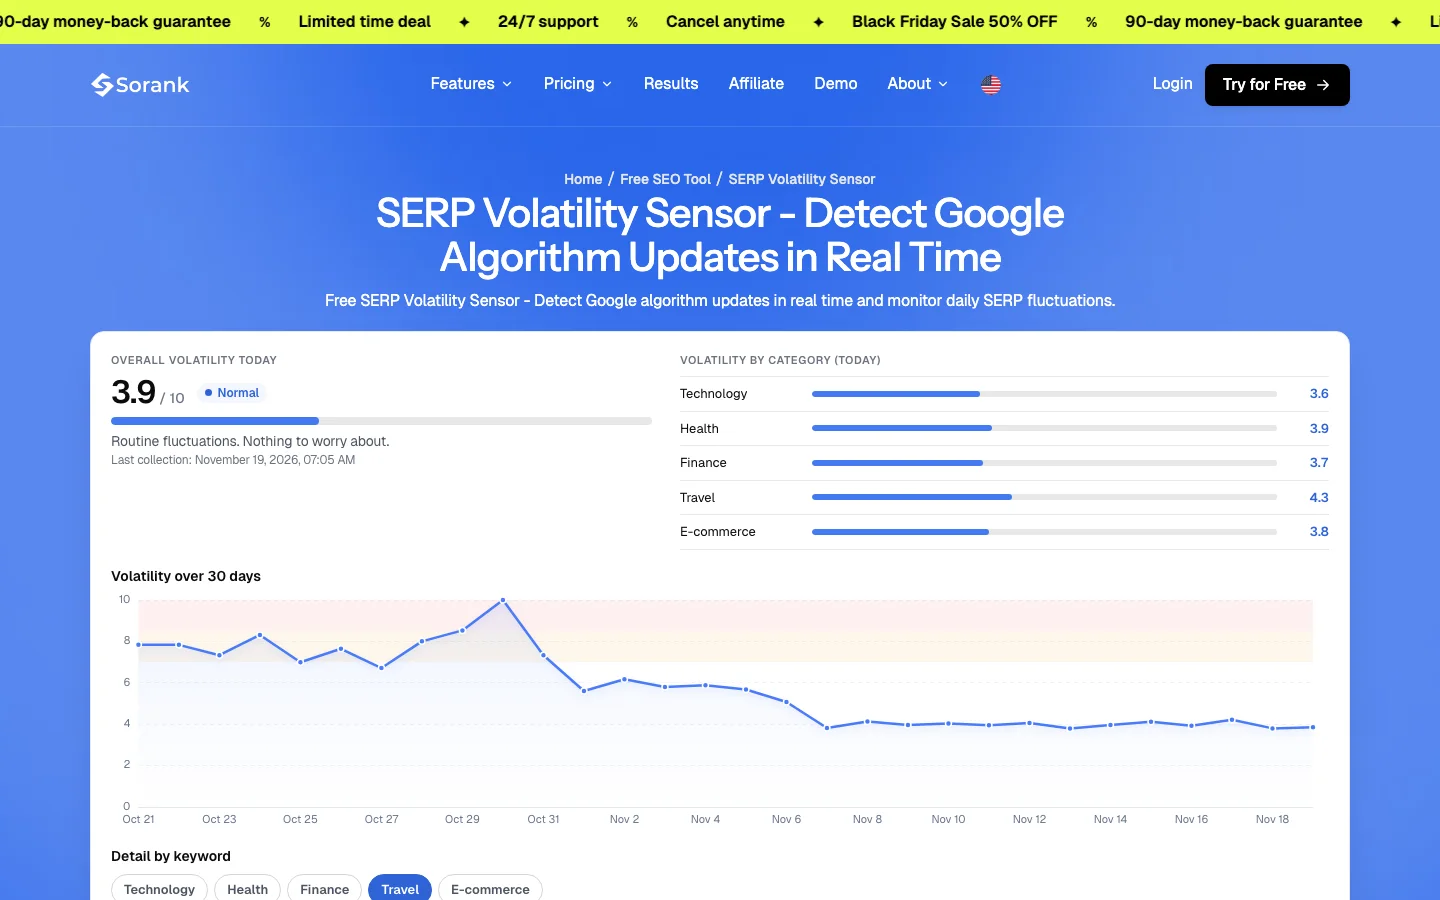
Sorank का मुफ़्त SERP Volatility Sensor पहली तरह को कवर करता है। हर सुबह यह अमेरिका में अंग्रेज़ी के 20 keywords के लिए पाँच उद्योगों में organic results के शीर्ष 10 परिणाम इकट्ठा करता है, उन्हें पिछले दिन से तुलना करता है, और 0 से 10 तक का score देता है, कुल और हर उद्योग के लिए अलग। यह दिखाता है कि Google का पहला पेज कितना हिला, इसलिए यह algorithm बदलावों का एक उपयोगी शुरुआती संकेत है। लेकिन यह AI उत्तर नहीं मापता, इसलिए यह ऊपर बताए गए prompt-आधारित तरीके की जगह नहीं लेता। Google वाले हिस्से के लिए, sensor को उसके अपने पेज पर पढ़ें, और उसे अपने AI visibility आँकड़ों के बजाय अपने रैंकिंग डेटा के साथ रखें।
मुफ़्त SERP Volatility Sensor Google के organic results को ट्रैक करता है, AI उत्तरों को नहीं।
Search Console और Google Analytics Google क्लिक और referral visits की रिपोर्ट देते हैं। rank trackers Google पर स्थितियों की रिपोर्ट देते हैं। इनमें से कोई भी यह नहीं दिखाता कि कौन से AI उत्तरों ने आपके ब्रांड का नाम लिया। इसके लिए दर्ज किए गए उत्तर चाहिए, या उन्हें दर्ज करने वाला tool। AI models से आने वाली visits के लिए referral वाला पक्ष हमारी GEO reporting गाइड में समझाया गया है।
आम गलतियाँ और उनके सुधार
ज़्यादातर volatility की गलतियाँ शोर को संकेत मानकर पढ़ने से आती हैं। नीचे हर गलती बताती है कि वह कैसी दिखती है, आपके डेटा में उसे कैसे पहचानें, और उसे कैसे ठीक करें।
एक run को परिणाम मानकर रिपोर्ट करना
क्या है: एक screenshot या एक उत्तर को अपनी स्थिति के रूप में पेश करना। कैसे पहचानें: रिपोर्ट में स्थिति है, पर sample size, date range या margin of error नहीं है। कैसे ठीक करें: हर prompt के लिए कम से कम 30 runs पर visibility rate रिपोर्ट करें, margin of error और date range के साथ।
जाँचों के बीच prompts बदलना
क्या है: दो जाँचों के बीच prompt की शब्दावली बदल देना, जैसे एक हफ्ते "best CRM" और अगले हफ्ते "best CRM for startups", और फिर परिणाम को रुझान मान लेना। कैसे पहचानें: spreadsheet की एक ही पंक्ति में दो तारीखों के बीच prompt का text अलग है। कैसे ठीक करें: prompt set को जमाएँ और उसका version रखें। नया prompt नई पंक्ति के रूप में जोड़ें, और पुराने को कभी न बदलें।
margin of error के भीतर की हलचलों पर प्रतिक्रिया देना
क्या है: पाँच points की गिरावट के बाद पेज दोबारा लिख देना। कैसे पहचानें: बदलाव उस prompt के margin of error से छोटा है। कैसे ठीक करें: तभी कार्य करें जब बदलाव लगातार दो बैचों में margin of error से बड़ा हो, और लिखें कि उसी अवधि में और क्या बदला, जैसे model update या competitor launch।
citation को recommendation मानना
क्या है: अपनी साइट के हर link को जीत मान लेना, भले ही उत्तर आपके ब्रांड को बचने योग्य विकल्प के रूप में दिखाए या footnote की तरह। कैसे पहचानें: कोई citation के आसपास का वाक्य नहीं पढ़ता। कैसे ठीक करें: तीनों स्थितियाँ अलग-अलग दर्ज करें (नाम से और सिफारिश, केवल नाम, केवल cite), और box tick करने से पहले वाक्य पढ़ें।
ऐसे prompts ट्रैक करना जिन्हें कोई नहीं लिखता
क्या है: रिपोर्ट के लिए marketing टीम द्वारा लिखे गए prompts। कैसे पहचानें: prompts में internal product नाम या ऐसा jargon है जिसे ग्राहक कभी इस्तेमाल नहीं करते। कैसे ठीक करें: prompts को sales calls, support conversations और Search Console queries से लें, और उनमें से कुछ को असली ग्राहकों से जाँचें।
उम्मीद करना कि AI visibility अपने आप clicks लाएगी
क्या है: यह मान लेना कि ऊँची visibility rate अपने आप ज़्यादा visits लाएगी। कैसे पहचानें: visibility rate बढ़ती है, पर referral sessions सपाट रहते हैं। कैसे ठीक करें: referral visits को अलग से मापें, देखें कि कौन से AI models और कौन से pages visits भेजते हैं, और दोनों datasets को एक मासिक रिपोर्ट में जोड़ें।
AI उत्तरों के पीछे भागने के लिए AI-विशेष फ़ाइलें जोड़ना
क्या है: AI text file या नया markup बनाने का प्रोजेक्ट शुरू करना, यह उम्मीद करते हुए कि इससे citations आएँगे। कैसे पहचानें: प्रोजेक्ट में indexing या snippet eligibility की कोई जाँच नहीं है। कैसे ठीक करें: Google के मार्गदर्शन से शुरू करें। पुष्टि करें कि मुख्य pages indexed हैं और snippet दिखाने योग्य हैं, फिर किसी भी और चीज़ से पहले text और internal links ठीक करें।
गलती
आपके डेटा में संकेत
सुधार
एक run को परिणाम मानना
sample size या margin of error नहीं
कम से कम 30 runs पर हिस्सा रिपोर्ट करें
जाँचों के बीच prompts बदलना
वही पंक्ति, अलग text, अलग तारीखें
prompt set जमाएँ और उसका version रखें
margin के भीतर की हलचल पर प्रतिक्रिया
margin से छोटा बदलाव
केवल लगातार दो बैचों में टिके बदलावों पर कार्य करें
citation को recommendation गिनना
आसपास का वाक्य नहीं पढ़ा गया
तीनों स्थितियाँ अलग दर्ज करें
ऐसे prompts जो कोई नहीं लिखता
prompt सूची में internal jargon
prompts असली ग्राहकों की भाषा से लें
visibility को traffic मानना
visibility बढ़ती, referrals सपाट
referrals अलग से मापें
इस हफ्ते क्या करें
शुरुआत के लिए आपको पूरे कार्यक्रम की ज़रूरत नहीं है। पहला हफ्ता माप को ऐसे सेट करने के बारे में है कि आने वाले छह महीने पढ़ने योग्य हों। इन चरणों को क्रम से लें।
आपका पहला हफ्ता
20 prompts चुनेंउन्हें असली ग्राहक की भाषा से लें, और सूची को तारीख के साथ जमा दें।
हर prompt 30 बार चलाएँवे AI models इस्तेमाल करें जिन्हें आपके खरीदार उपयोग करते हैं, और हर उत्तर के लिए तीनों स्थितियाँ दर्ज करें।
Visibility rate निकालेंहर prompt के लिए rate और उसका margin of error निकालें, फिर हर prompt के बारे में एक वाक्य लिखें कि वह क्या दिखाता है।
अपने मुख्य pages की तुलना करेंउन्हें उन विवरणों के सामने रखें जो AI देता है, और हर गलत या छूटे हुए दावे को नोट करें।
अगला बैच तय करेंउसे दो हफ्ते बाद चलाएँ, ताकि आप वही prompts एक नियमित लय में तुलना कर सकें।
एक बार बेसलाइन हो जाए, तो volatility चिंता का स्रोत नहीं रहती। वह एक ऐसी सीमा बन जाती है जिसे आप माप सकते हैं, और बदलावों का एक ऐसा समूह जिसके आसपास आप योजना बना सकते हैं।
अक्सर पूछे जाने वाले सवाल
ChatGPT एक ही सवाल पर अलग-अलग उत्तर क्यों देता है?
भाषा मॉडल हर शब्द एक probability distribution से चुनते हैं, इसलिए एक ही prompt अलग शब्द, ब्रांड सूची और क्रम दे सकता है। retrieval भी बदलता है, क्योंकि AI model सवाल को sub-queries में दोबारा लिखता है, और जो pages वह लाता है वे हर रन में अलग हो सकते हैं।
AI search के उत्तर समय के साथ कितना बदलते हैं?
Authoritas ने AI Overviews के लिए 8 हफ्तों पर 0.68 और 13 हफ्तों पर 0.73 का volatility score मापा, जबकि organic results के लिए यह 0.49 और 0.55 था। SparkToro ने पाया कि ChatGPT या Google के AI के दो बार एक ही ब्रांड सूची लौटाने की संभावना 100 में से 1 से भी कम है।
क्या AI search में अब भी अपनी rank ट्रैक करनी चाहिए?
AI उत्तर में एक अकेली स्थिति इतनी अस्थिर है कि उस पर कार्रवाई नहीं की जा सकती। कई prompts और runs में यह ट्रैक करें कि आपका ब्रांड कितनी बार आता है, उस हिस्से को उसके margin of error के साथ प्रतिशत में रिपोर्ट करें, और Google organic results के लिए पारंपरिक rank tracking रखें, जहाँ स्थितियाँ धीरे बदलती हैं।
y!
30 दिनों का अपना कंटेंट प्लान मुफ़्त में पाएँ
हम आपके प्रतिस्पर्धियों, आपकी वेबसाइट और आपकी AI दृश्यता का विश्लेषण करते हैं, ताकि मुफ़्त में आपके लिए एक अनुकूल कंटेंट योजना बनाई जा सके।
“मैंने Sorank को एक असली क्लाइंट की साइट पर आज़माया और यह कमाल का है। यह वह सब कुछ करता है जिसके लिए एक एजेंसी आपसे हर महीने $1500 वसूलती है। अब उस क्लाइंट के लिए इसे प्रोडक्शन में डाला जा रहा है।”Guillaume Guersanguersanguillaume.com
“हम एक Ads एजेंसी हैं और हम अपने SEO को एक बार और हमेशा के लिए सही रास्ते पर लाना चाहते थे। Sorank ने हमें हमारी साइट की साफ तस्वीर दी, ऑप्टिमाइज़ेशन को प्राथमिकता देने में मदद की, और हमारे कंटेंट को सही तरीके से व्यवस्थित किया। टूल इस्तेमाल में आसान है, टीम के लिए अच्छी तरह डिज़ाइन किया गया है, और कई प्लेटफ़ॉर्म के बीच भागदौड़ किए बिना ट्रैकिंग को एक जगह रखने के लिए बहुत व्यावहारिक है। नए सिरे से SEO शुरू करने के लिए एक बहुत मज़बूत आधार।”Gaspard MadouiAds एजेंसी
“Sorank की बदौलत मैं GEO में विशेषज्ञ बन गई। GEO रैंकिंग मुझे ChatGPT पर क्लाइंट्स को उनकी प्रतियोगियों के मुकाबले उनकी पोज़िशन दिखाने देती है। यह एक असली व्यावसायिक अंतर है।”Mélanieफ्रीलांस SEO
“बेहतरीन सेवा है, हमारी वेबसाइट के लिए अच्छा काम करती है, और यह समझने में मदद करती है कि इसे कैसे सुधारें ताकि Google और दूसरी जगहों पर बेहतर रैंक हो। बधाई, ऐसे ही आगे बढ़ते रहिए। इसकी सिफ़ारिश है।”Hugo T.E-commerce व्यापारी