A privacidade é importante para nós, então você tem a opção de desativar certos tipos de armazenamento que podem não ser necessários para o funcionamento básico do site. O bloqueio de categorias pode afetar sua experiência no site. Mais informações (Política de cookies)
Pontos azuis numa grelha branca, a maioria em movimento enquanto um permanece fixo, ilustrando a volatilidade da pesquisa com IA.
Ferramentas
Nesta página
Em resumo
a volatilidade da pesquisa com IA mede o quanto as marcas, os URLs e a ordem de uma resposta de IA mudam de uma execução para outra e de uma semana para a seguinte. A mesma pergunta pode devolver uma lista de marcas diferente, outras citações e outra ordem, porque a resposta é gerada com aleatoriedade e a etapa de recuperação também muda. Por isso, a posição dentro de uma resposta de IA é uma métrica fraca. Meça com que frequência a sua marca aparece em muitos prompts e muitas execuções e, depois, construa as fontes que tornam essa presença estável.
3 dias grátis, depois você para quando quiser. Garantia de resultados de 90 dias, sujeita a condições.
O que significa volatilidade na pesquisa com IA
Na pesquisa orgânica do Google, volatilidade significa que a sua posição para uma palavra-chave sobe e desce. Na pesquisa com IA, é mais do que isso. A própria resposta é diferente a cada execução. Uma resposta de IA volátil pode mudar de três formas: quais marcas nomeia, quais URLs cita e em que ordem as apresenta. Qualquer uma dessas coisas pode mudar sem que o seu site sofra uma única alteração.
A diferença importa porque um ranking é um resultado fixo num dado momento. O Google devolve uma lista ordenada, e para a mesma consulta no mesmo mercado essa lista é, em grande parte, repetível. Um modelo de IA devolve uma amostra de um leque de respostas possíveis. A sua marca tem uma probabilidade de aparecer nesse leque. É essa probabilidade que pode medir e é essa que pode mover.
Dois números de um estudo publicado em 2026 mostram a força do efeito. Rand Fishkin, da SparkToro, trabalhou com Patrick O'Donnell, da Gumshoe.ai. Cerca de 600 voluntários enviaram 12 prompts ao ChatGPT, ao Claude e à IA do Google, num total de 2961 execuções. Os investigadores encontraram menos de uma probabilidade em 100 de que o ChatGPT ou a IA do Google devolvam duas vezes a mesma lista de marcas. A probabilidade da mesma lista na mesma ordem foi de cerca de uma em 1000 execuções. O relatório da SparkToro, datado de 28 de janeiro de 2026, cobre dados recolhidos em novembro e dezembro de 2025.
Quão estáveis são as listas de marcas da IA?
2961execuções com 12 prompts e três sistemas de IA
<1%probabilidade de o ChatGPT ou a IA do Google devolverem duas vezes a mesma lista de marcas
<0,1%probabilidade da mesma lista de marcas na mesma ordem
Fonte: SparkToro e Gumshoe.ai, janeiro de 2026
Quando se aceita que o resultado é uma amostra, a forma de o acompanhar tem de mudar. A comparação abaixo resume as duas mentalidades. É a ideia central de todo este guia.
Acompanhar uma posição ou acompanhar a presença
Uma posição isolada
Muda em quase todas as execuções
Uma única resposta diz muito pouco
Percentagem de execuções
Medida em dezenas de prompts
Mostra uma tendência em que se pode agir
Volatilidade nas listas de marcas
A mudança mais visível é a própria lista de marcas. Um prompt como «melhor ferramenta de gestão de projetos para uma equipa de 10 pessoas» pode nomear cinco marcas numa execução e outras cinco na seguinte. Algumas marcas voltam com frequência, outras entram e saem. A presença no conjunto é mais estável do que a posição dentro dele, e é por isso que os investigadores recomendam acompanhar a presença em vez do ranking.
Daqui sai uma consequência prática. Se testar um prompt uma só vez e vir a sua marca em segundo lugar, não sabe quase nada. Se o testar 60 vezes e vir a marca em 40 respostas, sabe algo útil: é uma escolha regular para essa pergunta.
Volatilidade nas citações
As citações são as ligações que um modelo de IA mostra como fontes. Mudam ainda mais do que a lista de marcas quando o modelo faz uma pesquisa web em tempo real, porque cada execução pode recuperar um conjunto diferente de páginas. Uma citação que desaparece nem sempre é uma perda. A sua marca pode continuar mencionada no texto sem ligação. Por isso, convém registar duas coisas em separado: a menção pelo nome e o URL citado.
Volatilidade na ordem
A posição dentro de uma resposta é o elemento menos estável. Um modelo de IA pode colocar a sua marca em primeiro numa execução e em quarto na seguinte, sem que a forma como o vê tenha mudado de facto. Trate a ordem como ruído, a menos que se mova numa só direção ao longo de dezenas de execuções.
Porque é que perguntas idênticas recebem respostas diferentes
Três mecanismos explicam a maior parte das mudanças. Não é possível desligá-los, mas conhecê-los diz-lhe o que medir e o que ignorar.
Amostragem
Um modelo de linguagem não escolhe uma única melhor resposta. Escolhe cada palavra seguinte a partir de uma distribuição de probabilidades. Uma definição chamada temperatura controla a amplitude dessa escolha. Com um valor baixo, o resultado aproxima-se de ser repetível, com um valor alto varia mais. Os programadores podem definir a temperatura numa API, mas as aplicações de consumo que a maioria dos seus compradores usa não a expõem. Assuma que a amostragem está sempre ativa. Os voluntários da SparkToro mantiveram as definições habituais, personalizadas ou por defeito, e por isso os resultados descrevem o que vê um utilizador comum.
Recuperação e subconsultas
Quando um modelo de IA pesquisa na web, não envia a sua pergunta exata a um motor de busca. Reescreve-a em várias subconsultas e recupera páginas para cada uma. Uma pequena mudança de redação, uma página indexada nessa manhã ou um resultado diferente para uma única subconsulta podem alterar as fontes que chegam à resposta final. Os URLs de onde é citado são o resultado de uma etapa de recuperação que se move. O nosso guia sobre como os modelos de IA escolhem as suas fontes explica o mecanismo, e o rastreador da Sorank sobre o que a IA pesquisa realmente foi criado precisamente para essa pergunta.
Atualizações de modelos e de índices
Os fornecedores atualizam os modelos e os sistemas à volta deles sem grande aviso prévio. Uma nova versão do modelo, uma mudança no momento em que um modelo decide pesquisar ou uma alteração no índice web podem alterar as respostas de um tema inteiro num só dia. Quando os seus dados mostrarem uma mudança brusca, verifique primeiro se há uma atualização provável e compare com a sua referência antes de reagir.
Mecanismo
O que muda
Como se manifesta
O que fazer
Amostragem
Lista de marcas, redação e ordem
Respostas diferentes ao mesmo prompt no mesmo dia
Medir em muitas execuções e reportar uma percentagem
Recuperação
URLs citados
Fontes diferentes citadas de uma semana para a outra
Reforçar as páginas e as fontes de terceiros que são bem recuperadas
Atualizações de modelos e índices
Estilo geral da resposta e marcas favorecidas
Uma mudança brusca numa data específica
Manter uma referência e anotar cada atualização identificável
As respostas de IA mudam de uma execução para outra. A presença em muitas execuções é o que pode medir e construir.
Quanto mudam as respostas da IA
Os números medidos ainda são escassos, e a maioria vem de fornecedores de SEO e de visibilidade em IA. Há duas fontes que merecem uma leitura atenta. A primeira é um estudo da plataforma de SEO Authoritas, que comparou as AI Overviews com os resultados orgânicos. A segunda são as medições da BrightEdge, que compararam as AI Overviews com o modo IA.
A Authoritas mediu a volatilidade dos rankings com uma pontuação. Quanto mais alta a pontuação, mais os resultados mudaram no período. Para as AI Overviews, a pontuação foi de 0,68 às 8 semanas e de 0,73 às 13 semanas. Para os resultados orgânicos, foi de 0,49 e 0,55. A Digital Information World, que divulgou o estudo em fevereiro de 2025, também indicou que cerca de 70% dos resultados das AI Overviews mudaram em dois a três meses. Esse artigo não indicava a amostra de palavras-chave nem as datas de medição, por isso verifique o relatório original da Authoritas antes de citar um número numa apresentação para um cliente.
Pontuação de volatilidade dos rankings às 8 semanas
AI Overviews0,68
Resultados orgânicos0,49
Fonte: estudo da Authoritas, divulgado pela Digital Information World, fevereiro de 2025
Resultados das AI Overviews que mudaram em 2 a 3 meses
70%dos resultados das AI Overviews acompanhados
Fonte: estudo da Authoritas, divulgado pela Digital Information World, fevereiro de 2025
A BrightEdge mediu a mesma questão de outro ângulo. A sua análise de agosto de 2025 encontrou mais 16,7% de volatilidade nas menções de marca das AI Overviews do que no modo IA. Também constatou que as AI Overviews mantinham 24% dos seus URLs sem alterações, contra 20% do modo IA. A tabela coloca estes números lado a lado.
Medida
AI Overviews
Comparação
Fonte
Pontuação de volatilidade, 8 semanas
0,68
0,49 nos resultados orgânicos
Authoritas
Pontuação de volatilidade, 13 semanas
0,73
0,55 nos resultados orgânicos
Authoritas
Volatilidade das menções de marca
16,7% a mais
Face ao modo IA
BrightEdge, agosto de 2025
URLs sem alterações
24%
20% no modo IA
BrightEdge, agosto de 2025
Porque é que as AI Overviews e o modo IA se comportam de forma diferente
As AI Overviews aparecem dentro da página de resultados normal do Google para um subconjunto de consultas. O modo IA é uma interface separada, em estilo de conversa. Os números da BrightEdge sugerem que as AI Overviews oscilam mais nas marcas que mencionam, enquanto o modo IA mantém menos URLs estáveis. A lição prática é verificar cada superfície em separado. Um único número de «IA do Google» esconde a diferença, e é precisamente essa diferença que precisa de ter em conta. A nossa comparação entre o Google AI Mode e as AI Overviews explica o que cada um significa para o SEO.
O ponto-chave é que não se pode assumir que a estabilidade orgânica se transfere. Os resultados orgânicos são menos voláteis do que as AI Overviews nos dados da Authoritas, mas não estão parados. Uma página que mantém a posição 3 durante um mês pode cair depois de uma atualização principal, por isso precisa de um método que separe as mudanças reais do movimento normal nas duas superfícies.
Porque é que o acompanhamento de posições falha na pesquisa com IA
A maioria dos rastreadores de posições foi concebida para o Google, onde uma palavra-chave tem uma única lista ordenada que muda devagar. Aplicada a um modelo de IA, a mesma lógica produz um número baseado numa única amostra. Se a sua marca estiver em terceiro numa execução e em oitavo na seguinte, a média dessas duas execuções diz-lhe quase nada. Uma ferramenta que reporta «está em 3.º lugar no ChatGPT» apresenta um único lançamento como se fosse um facto. O nosso guia de acompanhamento de posições cobre o método clássico, e este artigo explica o que muda quando a resposta é gerada em vez de listada.
A conclusão da SparkToro é que os produtos de acompanhamento de posições baseados em posições fixas medem ruído. O conselho do estudo é acompanhar a presença em vez do ranking. Considera razoável uma percentagem de visibilidade quando é medida em dezenas a centenas de prompts, cada um executado várias vezes. Peça a qualquer fornecedor que mostre o tamanho da amostra e o método por trás de uma pontuação antes de confiar nela.
Um prompt, uma captura de ecrã ou uma percentagem medida
Antes
Reporta uma única posição
Muda na execução seguinte
Sem margem de erro, por isso cada movimento parece real
Depois
Reporta a percentagem de execuções que nomeiam a sua marca
Mostra uma tendência ao longo de várias semanas
Indica quanto deve mudar algo para contar
A documentação do próprio Google aponta na mesma direção, por outra razão. O Google diz que uma página tem de estar indexada e elegível para aparecer na Pesquisa com um excerto para ser usada nas AI Overviews ou no modo IA. Diz também que não é preciso acrescentar nenhum marcador especial nem um ficheiro específico para IA. Não existe uma definição de «ranking de IA» para otimizar, por isso o trabalho consiste em estar presente e ser fiável em muitas fontes, e em medir essa presença com honestidade.
Como medir a volatilidade da pesquisa com IA, passo a passo
O método abaixo demora alguns dias a configurar e alguns minutos por semana a manter. Pode executá-lo numa folha de cálculo. As ferramentas dedicadas poupam-lhe sobretudo a repetição, não o raciocínio.
O método de medição em cinco passos
Construa um conjunto de promptsEscolha entre 20 e 50 perguntas que compradores reais fazem. Tire-as de chamadas comerciais, conversas de suporte e consultas do Search Console.
Execute cada prompt muitas vezesRepita cada prompt pelo menos 30 vezes por modelo de IA, idealmente de 60 a 100, como a equipa da SparkToro. Use as mesmas definições e distribua as execuções por vários dias.
Registe cada respostaAnote se a sua marca é nomeada, se é recomendada ou apenas mencionada, a sua posição e os URLs citados.
Calcule a taxa de visibilidadeDivida as respostas que nomeiam a sua marca pelo total de respostas e acrescente a margem de erro de cada prompt e de cada modelo de IA.
Leia a tendência todas as semanasRepresente a taxa ao longo do tempo e anote as atualizações dos modelos, as suas alterações de conteúdo e os lançamentos dos concorrentes.
A fórmula, com um exemplo resolvido
A taxa de visibilidade é a proporção de respostas que nomeiam a sua marca. A margem de erro indica quanto de uma mudança é real. Use uma margem de erro a 95% baseada no erro-padrão de uma proporção:
taxa de visibilidade = respostas que nomeiam a sua marca / total de respostas
erro-padrão = raiz(p x (1 - p) / n)     onde p é a taxa de visibilidade e n o número de execuções
margem de erro a 95% = 1,96 x erro-padrão
Eis um exemplo ilustrativo, com números inventados e não uma medição. A sua marca aparece em 37 de 80 execuções, por isso a taxa de visibilidade é de 46%. O erro-padrão é de 5,6 pontos, o que dá uma margem de erro a 95% de cerca de 11 pontos. Apresente o resultado como 46% mais ou menos 11 pontos. Se o lote seguinte mostrar 40%, esse valor está dentro do intervalo, e não é um sinal para reescrever as suas páginas.
Nomeada, recomendada e citada são três estados diferentes
Uma marca pode ser nomeada sem ligação, ligada sem ser recomendada, ou recomendada numa frase que nunca nomeia um concorrente. Registe estes estados em separado: nomeada e recomendada, apenas nomeada e apenas citada. As suas proporções mudam por razões diferentes, e cada uma pede uma correção diferente. Uma citação sem menção é um problema de fontes. Uma menção sem recomendação é um problema de posicionamento.
A sua primeira folha de medição
Lista de prompts congelada e datada, com os novos prompts acrescentados como novas linhas
Execuções registadas por modelo de IA, com a data e as definições usadas
Três estados registados: nomeada e recomendada, apenas nomeada, apenas citada
Taxa de visibilidade e margem de erro calculadas para cada prompt
Nota
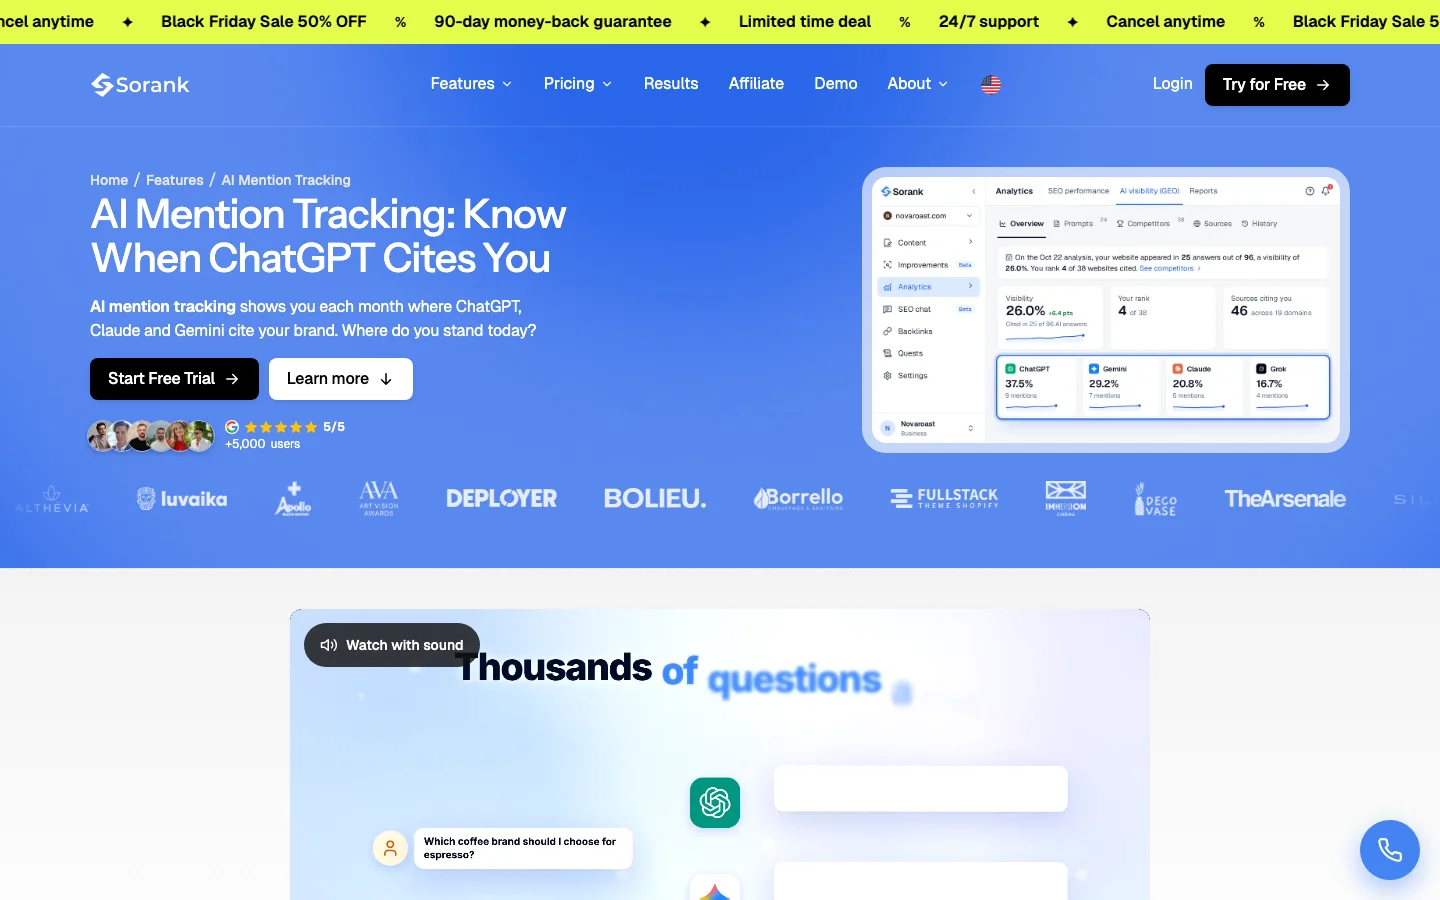
Repetir cada prompt à mão torna-se fastidioso ao fim de algumas semanas. O AI Mention Tracking da Sorank indica, para cada prompt acompanhado, com que frequência o ChatGPT, o Claude e o Gemini mencionam a sua marca, com as fontes e as pesquisas por trás de cada resposta. A execução é mensal, o que representa uma amostra fina para um único prompt. Leia por isso a tendência ao longo de vários meses e acrescente as suas próprias execuções repetidas para os prompts mais importantes.
O AI Mention Tracking indica com que frequência o ChatGPT, o Claude e o Gemini citam a sua marca.
Reportar a quem paga por isso
Um relatório mensal deve responder a uma só pergunta: a sua presença está a mudar, e a mudança é maior do que o ruído? Mostre a taxa de visibilidade por grupo de prompts com a respetiva margem de erro, e não um número único. Acrescente a distribuição das posições, ou seja, com que frequência a sua marca aparece em primeiro, em segundo ou mais abaixo nas respostas em que é nomeada, para que a ordem surja como uma dispersão e não como um ranking. Oscilar em torno de uma tendência plana ou crescente é normal. Uma queda constante ao longo de vários lotes não é, e justifica verificar os prompts, as notas de lançamento dos modelos e as fontes citadas antes de alguém reescrever uma página. Escreva a regra de ação no próprio relatório: uma mudança só conta como real se ultrapassar a margem de erro em dois lotes consecutivos.
Como tornar a sua presença mais estável
Não consegue desligar a volatilidade, mas pode tornar a sua presença mais consistente. A presença cresce quando a sua marca é descrita da mesma forma em várias fontes que os modelos de IA já utilizam. A documentação do Google indica a base do que as suas próprias funcionalidades de IA precisam.
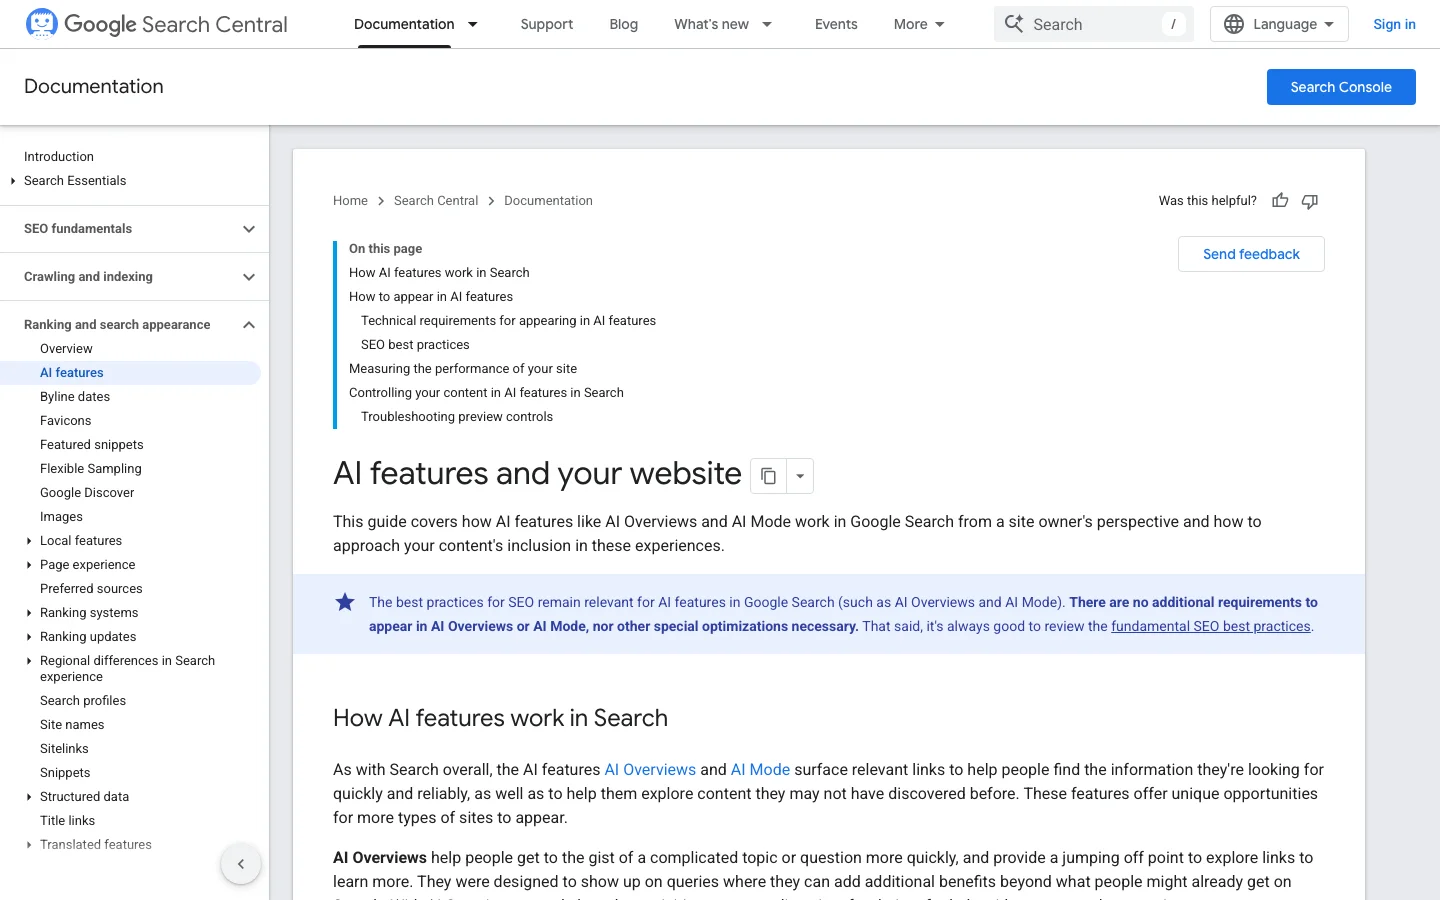
As orientações do Google sobre as AI Overviews e o modo IA são curtas. Uma página tem de estar indexada e ser elegível para mostrar um excerto. Os fundamentos continuam a aplicar-se: regras do robots.txt que permitam o rastreio, ligações internas, texto visível para os leitores e dados estruturados que correspondam ao texto visível. O Google diz que não são necessários novos ficheiros legíveis por máquinas, ficheiros de texto para IA nem um esquema especial para aparecer.
As orientações do Google sobre as AI Overviews e o modo IA: não é necessária nenhuma otimização específica.
Descreva a sua marca da mesma forma em todo o lado
Os modelos de IA formam a imagem de uma marca a partir de muitos sítios ao mesmo tempo. Se o seu nome, a sua categoria, o seu caso de uso principal e a sua localização diferirem entre o site, os perfis e os diretórios, a imagem fica difusa e a lista de marcas torna-se menos estável. Escreva uma descrição curta e factual da empresa, com a categoria e os casos de uso, e reutilize-a sempre que controlar o texto. Reveja-a todos os trimestres.
Ganhe menções em fontes que já são fiáveis
A corroboração significa que várias fontes independentes dizem a mesma coisa sobre si. Avaliações, artigos comparativos, diretórios do setor e publicações especializadas do seu nicho são os sítios habituais. Conquiste estas menções com trabalho útil, como dados originais, uma comparação de produtos clara ou uma ferramenta que as pessoas usem de facto. Não as compre. Os conteúdos pagos acrescentam ruído, e esse tipo de padrão desmorona-se assim que os pagamentos param.
Responda à pergunta principal em cada página-chave
Os modelos de IA extraem passagens, não páginas inteiras. Uma página que dá uma definição breve no primeiro parágrafo, uma resposta direta à pergunta principal e um próximo passo claro é mais fácil de extrair e de citar com exatidão. A nossa checklist GEO lista os pontos a verificar em cada página.
Checklist de estabilidade para a sua marca
Páginas-chave indexadas e elegíveis para mostrar um excerto
Mesmo nome de marca e mesma categoria em cada perfil e diretório
Menções em vários sites independentes, não apenas no seu
Dados estruturados que correspondam ao texto que o leitor vê
Uma resposta direta no primeiro parágrafo de cada página-chave
Quatro formas de responder à volatilidade
As equipas reagem à volatilidade de quatro formas comuns. Cada uma tem uma utilidade e um limite. Leia-as como opções que pode combinar, e não como um ranking da melhor. A maioria das equipas usa a primeira e a última em conjunto.
Acompanhar o ranking diário
Princípio: consultar um prompt por dia e registar a posição da sua marca na resposta. Quando usar: quer um alerta precoce rápido quando uma consulta específica muda bruscamente. Vantagens: é familiar, barato e fácil de representar num gráfico. Limites: é uma amostra por dia e não consegue separar uma perda real de uma variação normal. Exemplo: um prompt nomeia a sua marca à segunda-feira e não à quarta. O gráfico mostra uma descida, mas uma única execução não permite saber se perdeu uma posição ou se se trata de uma variação normal.
Acompanhar a presença em muitas execuções
Princípio: executar muitos prompts muitas vezes e reportar a percentagem de respostas que nomeiam a sua marca, com a respetiva margem de erro. Quando usar: precisa de um número para um relatório ou para uma decisão sobre investimento em conteúdos. Vantagens: corresponde à forma como a resposta é gerada e dá um intervalo em vez de um falso ponto. Limites: custa mais execuções e exige disciplina para manter o conjunto de prompts estável. Exemplo: a sua taxa de visibilidade é de 46% mais ou menos 11 pontos em 80 execuções. No mês seguinte é de 52%. Pode dizer que a tendência é de subida, mas ainda não pode afirmar que é um ganho real, por isso espera por outro lote.
Construir corroboração entre fontes
Princípio: fazer aparecer as mesmas afirmações corretas em várias fontes independentes. Quando usar: o seu posicionamento é claro e quer recomendações que se aguentem. Vantagens: ajuda tanto nas respostas de IA como na pesquisa tradicional, e o efeito dura. Limites: é lento e raramente mostra resultados num só mês. Exemplo: uma empresa de software vê os seus casos de uso descritos em duas avaliações, numa página comparativa e num diretório do setor, pelo que os modelos de IA repetem a mesma descrição em prompts diferentes.
Atualizar as páginas-chave com respostas diretas
Princípio: atualizar as páginas que respondem às suas perguntas principais, para que a resposta seja clara, exata e datada. Quando usar: a sua página é citada mas descrita de forma errada, ou é citada uma página de um concorrente no lugar da sua. Vantagens: é rápido de fazer e melhora a extração de passagens. Limites: uma página melhor não garante uma menção, e as alterações demoram a aparecer nos seus dados. Exemplo: uma página de glossário recebe no topo uma definição de uma frase, uma tabela comparativa curta e uma nota visível de atualização, e o lote de medição seguinte mostra a descrição correta.
Método
O que indica
Estabilidade do sinal
Esforço
Ideal para
Ranking diário
Uma posição num dia
Baixa
Baixo
Detetar uma mudança brusca numa consulta
Presença em muitas execuções
Percentagem de respostas que nomeiam a sua marca
Alta, com margem de erro
Médio a alto
Relatórios e decisões orçamentais
Corroboração
Consistência com que as fontes o descrevem
Alta ao longo de meses
Alto
Recomendações de longo prazo
Atualização de página
Qualidade com que as páginas-chave respondem à pergunta
Média
Médio
Corrigir uma descrição errada ou em falta
Ferramentas para dois tipos de volatilidade
Os resultados orgânicos do Google e as respostas de IA precisam de instrumentos diferentes. Confundi-los leva a conclusões erradas, por isso mantenha-os separados nos seus relatórios.
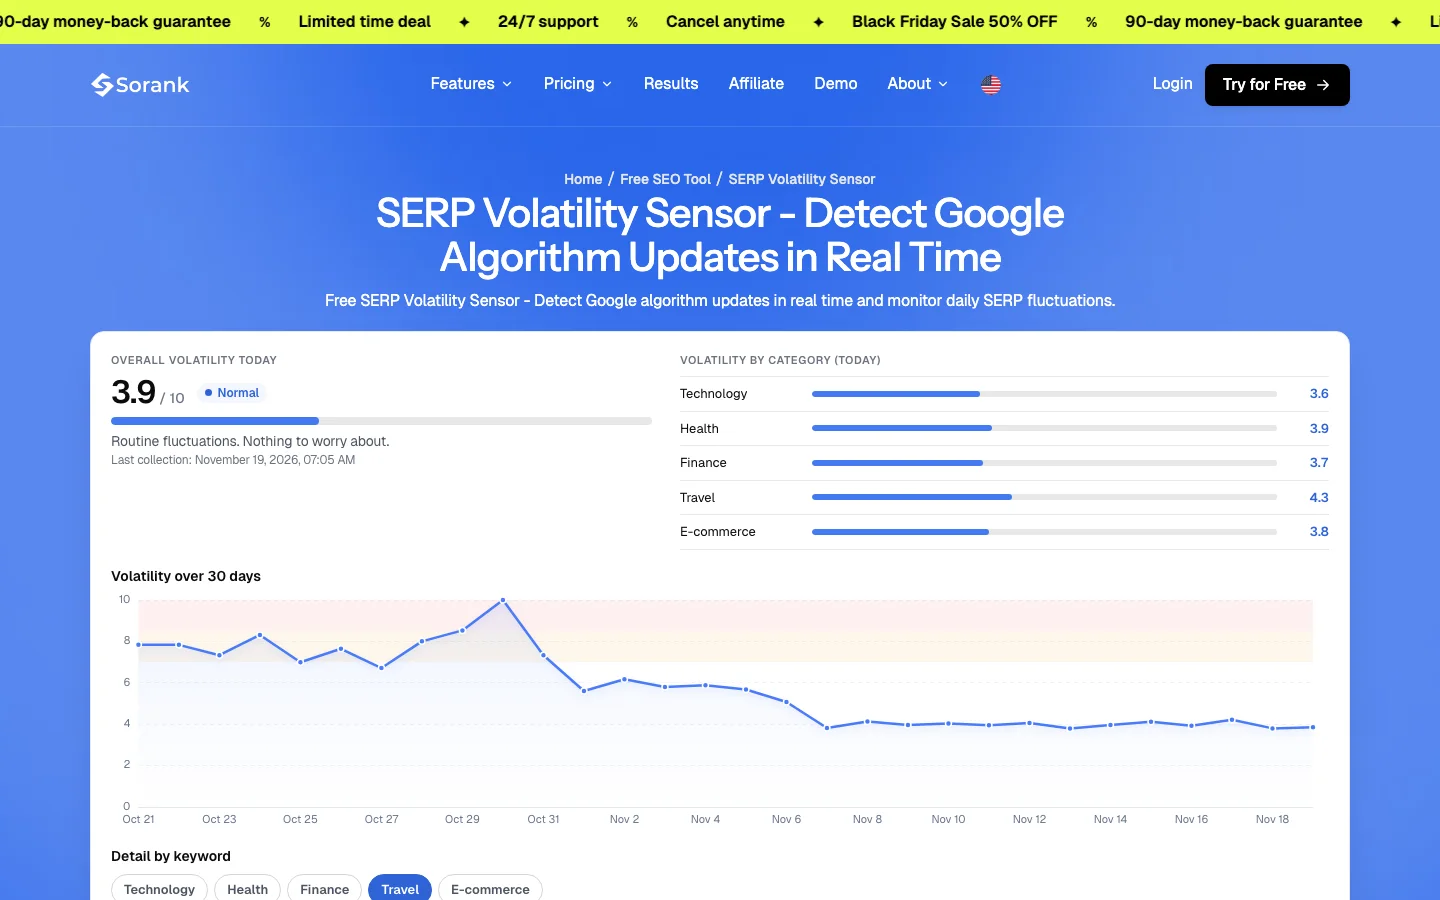
O SERP Volatility Sensor gratuito da Sorank cobre o primeiro tipo. Todas as manhãs recolhe os 10 primeiros resultados orgânicos de 20 palavras-chave em inglês dos Estados Unidos, distribuídas por cinco setores, compara-os com a véspera e atribui uma pontuação de 0 a 10, global e por setor. Mostra quanto se mexeu a primeira página do Google, o que o torna um sinal precoce útil para as mudanças de algoritmo. Não mede as respostas de IA, por isso não substitui o método baseado em prompts acima. Para a parte do Google da questão, leia o sensor na sua página própria, e mantenha-o ao lado dos dados de ranking, não ao lado dos números de visibilidade em IA.
O SERP Volatility Sensor gratuito acompanha os resultados orgânicos do Google, não as respostas de IA.
O Search Console e o Google Analytics reportam cliques do Google e visitas por referência. Um rastreador de posições reporta posições no Google. Nenhum deles mostra que respostas de IA nomearam a sua marca. Para isso precisa de respostas registadas ou de uma ferramenta que as registe. Para as visitas que chegam de modelos de IA, a parte das referências está coberta no nosso guia sobre reporting GEO.
Erros comuns e como corrigi-los
A maioria dos erros de volatilidade vem de ler ruído como se fosse sinal. Cada erro abaixo mostra o seu aspeto, como o detetar nos seus dados e como o corrigir.
Reportar uma única execução como resultado
O que é: uma captura de ecrã ou uma resposta isolada apresentada como a sua posição. Como detetar: o relatório mostra uma posição sem tamanho de amostra, sem período e sem margem de erro. Como corrigir: reporte a taxa de visibilidade em pelo menos 30 execuções por prompt, com a margem de erro e o período.
Alterar os prompts entre duas verificações
O que é: reformular um prompt entre duas verificações, por exemplo «melhor CRM» numa semana e «melhor CRM para startups» na seguinte, e depois ler o resultado como tendência. Como detetar: o texto do prompt na folha difere entre duas datas na mesma linha. Como corrigir: congele o conjunto de prompts e versione-o. Acrescente um prompt novo como nova linha e nunca edite um antigo.
Reagir a movimentos dentro da margem de erro
O que é: reescrever uma página após uma descida de cinco pontos. Como detetar: a mudança é menor do que a margem de erro desse prompt. Como corrigir: atue apenas quando uma mudança ultrapassar a margem de erro em dois lotes seguidos, e registe o que mais mudou no mesmo período, como uma atualização de modelo ou o lançamento de um concorrente.
Contar uma citação como recomendação
O que é: registar cada ligação para o seu site como uma vitória, mesmo quando a resposta apresenta a sua marca como uma opção a evitar ou como uma nota de rodapé. Como detetar: ninguém lê a frase em torno da citação. Como corrigir: registe os três estados em separado (nomeada e recomendada, apenas nomeada, apenas citada) e leia a frase antes de marcar a caixa.
Acompanhar prompts que ninguém escreve
O que é: prompts escritos pela equipa de marketing para um relatório. Como detetar: os prompts usam nomes internos de produtos ou jargão que os clientes nunca usam. Como corrigir: tire os prompts de chamadas comerciais, conversas de suporte e consultas do Search Console, e teste alguns com clientes reais.
Esperar que a visibilidade em IA gere cliques por si
O que é: assumir que uma taxa de visibilidade mais alta traz automaticamente mais visitas. Como detetar: a taxa de visibilidade sobe enquanto as sessões por referência ficam estáveis. Como corrigir: meça as visitas por referência em separado, verifique que modelos de IA e que páginas as enviam, e junte os dois conjuntos de dados num único relatório mensal.
Acrescentar ficheiros específicos para IA para perseguir respostas de IA
O que é: lançar um projeto para um ficheiro de texto para IA ou um novo marcador, na expectativa de provocar citações. Como detetar: o projeto não verifica a indexação nem a elegibilidade para excerto. Como corrigir: comece pelas orientações do Google. Confirme que as páginas-chave estão indexadas e são elegíveis para mostrar um excerto, e depois corrija primeiro o texto e as ligações internas.
Erro
Sinal nos seus dados
Correção
Uma execução reportada como resultado
Sem tamanho de amostra nem margem de erro
Reportar uma percentagem em pelo menos 30 execuções
Prompts editados entre verificações
Mesma linha, texto diferente, datas diferentes
Congelar e versionar o conjunto de prompts
Reagir dentro da margem de erro
Mudança menor do que a margem
Agir apenas sobre mudanças que persistem em dois lotes
Citação contada como recomendação
Nenhuma leitura da frase que a envolve
Registar os três estados em separado
Prompts que ninguém escreve
Jargão interno na lista de prompts
Retirar os prompts da linguagem real dos clientes
Visibilidade tratada como tráfego
Visibilidade em alta, referências estáveis
Medir as referências em separado
O que fazer esta semana
Não precisa de um programa completo para começar. A primeira semana serve para montar a medição de forma a que os seis meses seguintes sejam legíveis. Siga estes passos por ordem.
A sua primeira semana
Escolha 20 promptsTire-os da linguagem real dos seus clientes e congele a lista com uma data.
Execute cada prompt 30 vezesUse os modelos de IA que os seus compradores utilizam e registe os três estados de cada resposta.
Calcule a taxa de visibilidadeDetermine a taxa e a respetiva margem de erro para cada prompt e escreva depois uma frase por prompt a dizer o que mostra.
Compare as suas páginas-chaveConfronte-as com as descrições que a IA dá e anote cada afirmação errada ou em falta.
Agende o lote seguinteExecute-o duas semanas depois, para comparar os mesmos prompts num ritmo regular.
Quando tiver uma referência, a volatilidade deixa de ser uma fonte de ansiedade. Passa a ser um intervalo que pode medir e um conjunto de mudanças para as quais pode planear.
Perguntas frequentes
Porque é que o ChatGPT dá respostas diferentes à mesma pergunta?
Os modelos de linguagem escolhem cada palavra a partir de uma distribuição de probabilidades, por isso o mesmo prompt pode produzir redações, listas de marcas e ordens diferentes. A recuperação também muda, porque o modelo de IA reescreve a pergunta em subconsultas e as páginas recuperadas podem variar de uma execução para outra.
Quanto mudam as respostas da pesquisa com IA ao longo do tempo?
A Authoritas mediu para as AI Overviews uma pontuação de volatilidade de 0,68 às 8 semanas e de 0,73 às 13 semanas, contra 0,49 e 0,55 nos resultados orgânicos. A SparkToro encontrou menos de uma probabilidade em 100 de o ChatGPT ou a IA do Google devolverem duas vezes a mesma lista de marcas.
Ainda faz sentido acompanhar o ranking na pesquisa com IA?
Uma posição isolada numa resposta de IA é demasiado instável para agir sobre ela. Meça com que frequência a sua marca aparece em muitos prompts e execuções, reporte essa percentagem com a respetiva margem de erro e mantenha o acompanhamento clássico de posições para os resultados orgânicos do Google, onde as posições se movem mais devagar.
y!
Receba gratuitamente o seu plano de conteúdo para 30 dias
Analisamos seus concorrentes, seu site e sua visibilidade nas IA para criar, gratuitamente, um plano de conteúdo sob medida.
“Testei o Sorank no site real de um cliente e é uma loucura. Faz tudo aquilo que uma agência cobra 1.500 € por mês. Agora vai para produção nesse cliente.”Guillaume Guersanguersanguillaume.com
“Somos uma agência de publicidade e queríamos colocar nosso SEO nos trilhos de uma vez por todas. A Sorank nos deu uma visão clara do nosso site, ajudou-nos a priorizar as otimizações e estruturar corretamente nosso conteúdo. A ferramenta é fácil de usar, bem projetada para uma equipe e muito prática para centralizar o acompanhamento sem ter que fazer malabarismos entre várias plataformas. Uma base muito sólida para recomeçar do zero com nosso SEO.”Gaspard MadouiAgência de Publicidade
“Me especializei em GEO graças à Sorank. O GEO Leaderboard me permite mostrar aos meus clientes o seu posicionamento em relação aos concorrentes no ChatGPT. É um verdadeiro diferencial comercial.”MélanieFreelancer SEO
“Excelente serviço, funciona bem para o nosso site e nos ajuda a entender como melhorá-lo para nos posicionarmos melhor no Google e em outros lugares. Parabéns, continuem assim, eu recomendo.”Hugo T.Comerciante de e-commerce