La privacy è importante per noi, quindi hai la possibilità di disabilitare alcuni tipi di archiviazione che potrebbero non essere necessari per il funzionamento di base del sito web. Il blocco delle categorie può influire sulla tua esperienza sul sito web. Ulteriori informazioni (Politica sui cookie)
Grazie! La tua richiesta è stata ricevuta!
Ops! Qualcosa è andato storto durante l'invio del modulo.
Come fare un audit SEO: un metodo passo passo che trova ciò che costa traffico
Un audit SEO completo, in ordine: scansione, indicizzazione, dati di Search Console, Core Web Vitals e IA, con le correzioni che fanno muovere il traffico.
Un taccuino con una checklist di audit SEO e grafici stampati su una scrivania.
Strumenti
In questa pagina
In breve
Un audit SEO è una verifica strutturata di tutto ciò che impedisce alle sue pagine di essere scansionate, indicizzate, comprese, cliccate e citate. Lo svolga seguendo un ordine fisso: scansione, indicizzazione, dati di ricerca, velocità, contenuti on-page, link, e infine visibilità nelle IA. Valuti ogni risultato in base al traffico che blocca e trasformi i primi dieci in attività con una scadenza e un responsabile. Un audit mirato si può completare in pochi giorni. Un audit completo di un sito grande richiede più tempo, e il suo risultato deve essere un piano, non un elenco.
3 giorni gratis, poi smetti quando vuoi. Garanzia di risultati di 90 giorni, soggetta a condizioni.
Che cos'è un audit SEO, e che cosa non è
Un audit SEO risponde a una sola domanda: quali problemi tecnici, di contenuto e di autorevolezza le stanno costando visite in questo momento, e in quale ordine conviene risolverli? Non è un elenco di tutte le buone pratiche esistenti. Una checklist di 40 punti le dice che cosa guardare. Un audit le dice che cosa non funziona nel suo sito, quanto pesa e che cosa fare per primo.
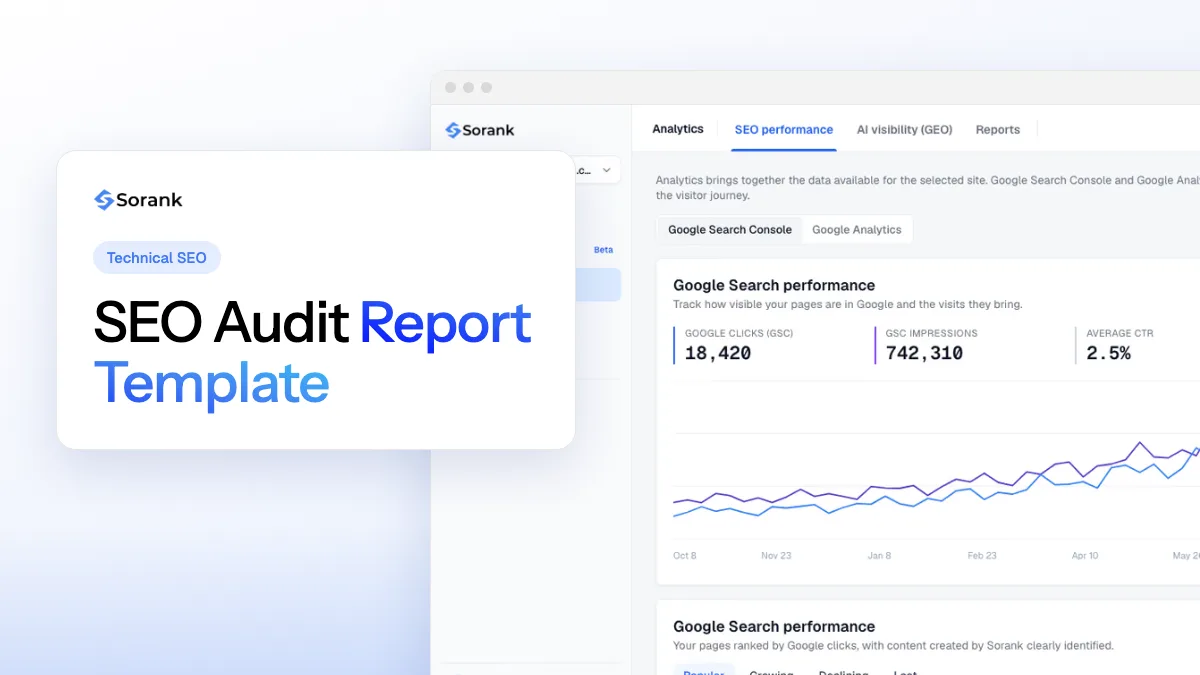
Si confondono spesso tre cose: l'audit (la diagnosi), la checklist (l'elenco dei controlli) e il report (ciò che consegna a un cliente o a un responsabile). Il nostro modello di report di audit SEO riguarda il report, mentre la checklist SEO tecnica copre i controlli. Questo articolo parla del metodo che collega le due cose e dei dati necessari per decidere che cosa conta.
Due modi di impostare lo stesso audit
Richiesta vaga
Controllare il sito alla ricerca di problemi SEO
Risultato: un lungo elenco di avvisi che nessuno legge
Richiesta mirata
Trovare le pagine che hanno perso clic negli ultimi 90 giorni
Risultato: dieci correzioni ordinate per traffico a rischio
La differenza non sta nell'impegno. Sta nella domanda. Una richiesta mirata indica le pagine, il periodo e la decisione, così ogni controllo ha una ragione d'essere.
Prima di iniziare: accessi, perimetro e una base di partenza
La maggior parte degli audit fallisce prima della prima scansione, perché nessuno ha concordato il perimetro né salvato un punto di partenza. Chiarisca tre cose prima di aprire uno strumento.
Perimetro. Quali domini e sottodomini, quali paesi e lingue, e quali tipi di pagina contano. Per un e-commerce significa home, categorie, schede prodotto, blog ed eventuali landing page. Li annoti.
Accessi. Accesso da proprietario a Search Console per ogni proprietà (versioni http, https, www e senza www, se esistono), accesso in lettura al suo strumento di analytics e accesso al CMS o ai log del server, se li ha. I log del server mostrano che cosa richiedono davvero i crawler, cosa che nessuna simulazione di scansione può rivelare.
Base di partenza. Una fotografia di clic, impressioni, posizione media e delle pagine che portano più clic, salvata in un foglio con la data. Senza di essa non potrà dimostrare che una correzione ha funzionato.
Prima di scansionare qualsiasi cosa
Confermare l'accesso da proprietario a Search Console per ogni proprietà
Esportare 90 giorni di dati su query e pagine e salvarli con la data di oggi
Elencare i principali tipi di pagina e un URL di esempio per ciascuno
Scrivere l'obiettivo in una frase: più clic sulle pagine che generano ricavi, meno errori, modelli di pagina più veloci
Scegliere il crawler e i suoi limiti (vedi la sezione sulla scansione più sotto)
Un audit esamina l'intera struttura di un sito prima di correggere una qualsiasi pagina.
Il metodo in ordine: sette fasi
L'ordine conta. La scansione le dice che cosa esiste nel sito. L'indicizzazione le dice che cosa Google conserva. I dati di ricerca le dicono che cosa trovano le persone e su che cosa cliccano. Velocità, contenuti e link spiegano poi perché una pagina rende poco. Se fa il contrario, passerà ore a riscrivere una pagina che Google non può nemmeno indicizzare.
Le sette fasi di un audit SEO
Scansionare il sitoElencare ogni URL con codice di stato, title, canonical, direttive robots e link interni.
Verificare l'indicizzazioneConfrontare ciò che pubblica con ciò che Google indicizza, e leggere il motivo di ogni esclusione.
Leggere i dati di ricercaIndividuare le pagine e le query che guadagnano o perdono clic, e quelle vicine alla vetta della prima pagina.
Testare velocità e mobileMisurare i Core Web Vitals su ogni modello di pagina, partendo dai dati di campo degli utenti reali.
Esaminare i contenuti on-pageControllare title, titoli, profondità, duplicazioni e link interni, pagina per pagina e modello per modello.
Valutare autorevolezza e linkAnalizzare nel tempo i domini che linkano, i link persi, i testi di ancora e i segnali di spam.
Verificare la visibilità nelle IAConfermare che i crawler delle IA raggiungono le sue pagine, e verificare se i motori di risposta la citano.
Controlli SEO pre-audit: che cosa confermare prima di fidarsi dei dati
I controlli SEO pre-audit verificano che il sito che sta per auditare sia quello che vedono Google e i visitatori, e che i dati siano abbastanza affidabili da permettere di agire. Dedichi circa un'ora a questi controlli prima di qualsiasi scansione. Una proprietà sbagliata, una regola di staging ancora attiva o un tracciamento rotto possono rendere errato ogni risultato successivo, e una scansione non rivelerà nulla di tutto ciò.
Confermare quale versione del sito è online
Richieda ogni variante del suo dominio: http, https, con e senza www, con e senza barra finale. Ogni variante dovrebbe arrivare allo stesso indirizzo finale, idealmente dopo un solo redirect. Due versioni online dividono link e segnali, e un crawler le segnalerà entrambe come sane.
Legga l'header Location di ogni risposta. Deve puntare direttamente al suo indirizzo preferito, non a un secondo redirect. Ripeta il controllo sulla home page e su una pagina profonda, perché le regole di redirect spesso differiscono tra i modelli.
Verificare che nessuna impostazione di test sia finita sul sito live
Le impostazioni di staging sono una delle cause più comuni di un calo improvviso. Controlli il robots.txt live, il meta tag robots e l'header X-Robots-Tag sulla home page e su un articolo. Una regola disallow su tutto il sito, o un noindex rimasto da una build di test, possono nascondere intere sezioni alla ricerca mentre le pagine continuano a caricarsi per i visitatori. Se ne trova una, la corregga prima di auditare quelle sezioni, perché ogni risultato successivo descriverebbe un sito che Google non può vedere.
Tenere un registro delle modifiche prima di diagnosticare un calo
Scriva un elenco datato di ogni rilascio, restyling, aggiornamento del CMS, migrazione e modifica a robots o noindex degli ultimi sei mesi. Poi confronti queste date con l'inizio di ogni variazione di traffico. Un calo che inizia il giorno del rilascio di un modello indica quel modello. Un calo senza modifiche vicine può dipendere da un aggiornamento della ricerca e richiede un controllo diverso. Senza il registro, si incolpa ciò che si è guardato per ultimo. Per le modifiche che riguardano gli URL, la checklist di migrazione SEO elenca che cosa registrare.
Controllare i dati su cui si baserà l'audit
Confronti i clic di Search Console con le sessioni organiche nei suoi analytics per gli stessi 90 giorni. Le due linee non devono coincidere, ma dovrebbero muoversi nella stessa direzione. Se divergono, controlli i tag sulle pagine chiave, il banner dei cookie e il filtro dei bot prima di diagnosticare il sito. Il confronto tra i due strumenti spiega che cosa misura ciascuno.
Fase 1: scansionare il sito e correggere ciò che trova il crawler
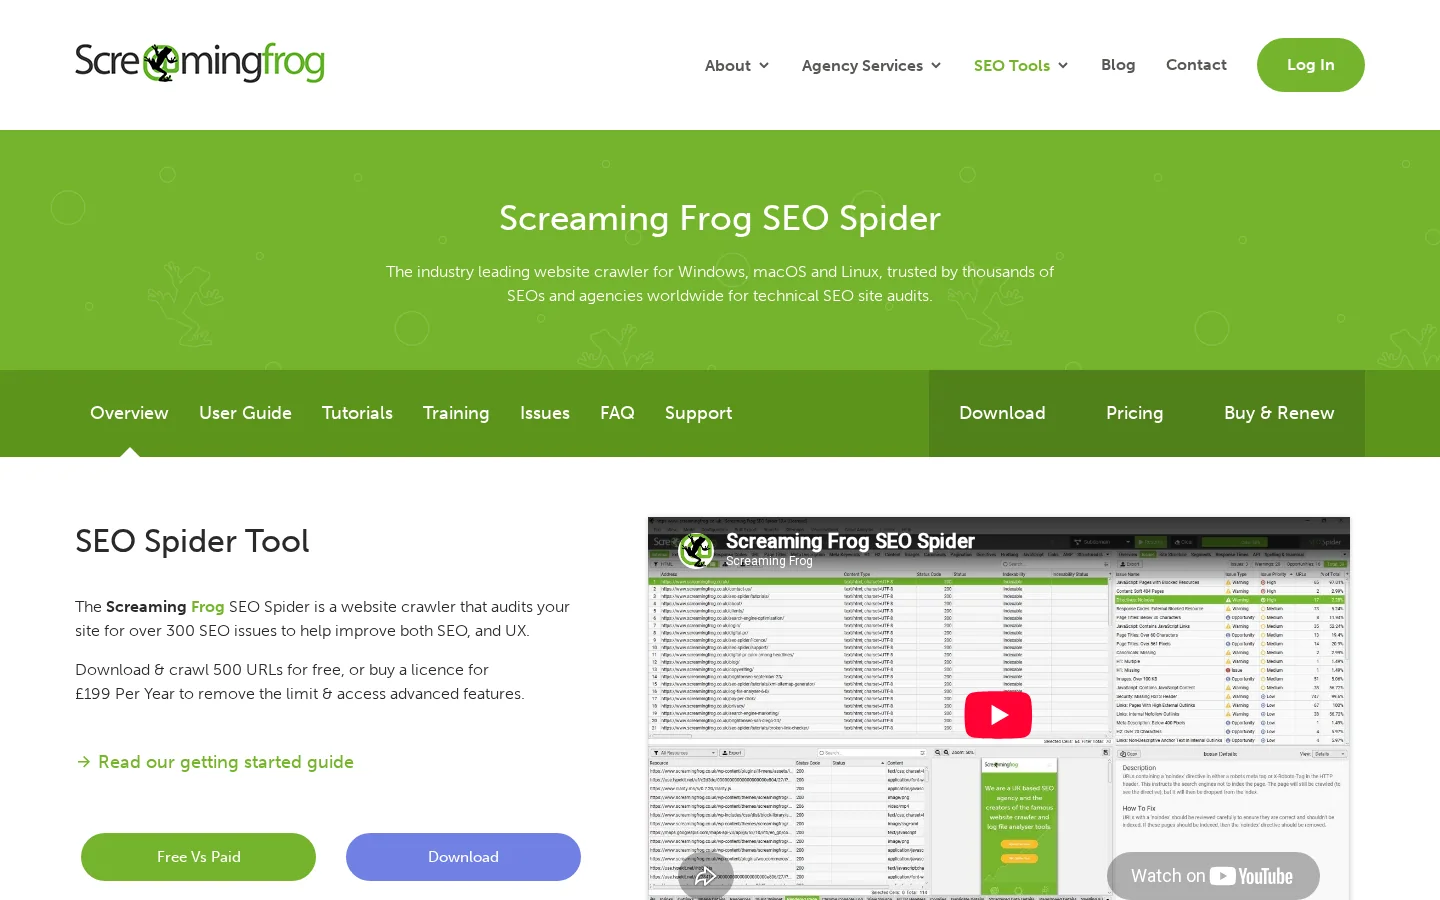
Un crawler fa, su scala ridotta, ciò che fa Googlebot: parte da una pagina, segue i link che trova e registra ciò che vede per ogni URL. Lo strumento che usiamo nella maggior parte degli audit è Screaming Frog SEO Spider. La sua versione gratuita scansiona fino a 500 URL, abbastanza per un sito piccolo o per una sezione di uno grande. Una licenza a pagamento elimina il limite. La nostra guida a Screaming Frog illustra la configurazione passo passo.
Screaming Frog SEO Spider, il crawler desktop che elenca ogni URL di un sito con il suo codice di stato e le sue direttive.
Avvii la scansione dalla home page e dalla sitemap, poi confronti le due liste. Ogni URL che compare in una sola delle due è una domanda aperta. Configuri il crawler perché rispetti robots.txt come fa Googlebot, e perché esegua il rendering del JavaScript se il sito ne dipende. Una scansione che non renderizza le pagine perde i contenuti che vedono gli utenti.
Codici di stato e catene di redirect
Filtri prima le risposte 4xx e 5xx. Un 404 non è un problema di per sé. Diventa un problema quando i link interni puntano ancora a lui, perché questi link portano utenti e crawler in un vicolo cieco. Individui i link interni che conducono a pagine di errore e li indirizzi verso un URL attivo. Poi controlli le catene di redirect: un URL vecchio reindirizza a un secondo, che reindirizza a un terzo. Ogni passaggio aggiunge latenza e diluisce il segnale. Appiattisca ogni catena, così che l'URL vecchio punti direttamente a quello finale.
Controlli anche il tipo di redirect. Un 302 temporaneo usato per uno spostamento permanente dovrebbe essere un 301. La nostra guida 301 vs 302 spiega la regola da applicare.
Direttive robots, noindex e canonical
Tre impostazioni possono nascondere una pagina senza che nessuno se ne accorga. Una regola disallow in robots.txt blocca la scansione. Un meta tag noindex, o un header HTTP X-Robots-Tag, blocca l'indicizzazione. Un tag canonical che punta a un altro URL indica ai motori quale versione mantenere. Verifichi ciascuna per ogni tipo di pagina, perché una regola aggiunta per sistemare una sezione spesso ne blocca un'altra. Un caso frequente: una regola di staging mai rimossa dal robots.txt online.
Attenzione
Bloccare una pagina in robots.txt non equivale a rimuoverla dalla ricerca. Se Google non può scansionare la pagina, non può leggere un tag noindex al suo interno. Per eliminare una pagina dall'indice, consenta la scansione, aggiunga noindex e attenda che Google la riscansioni.
Pagine orfane e profondità di clic
Una pagina orfana non ha alcun link interno che punti a lei. I crawler la trovano solo tramite la sitemap o un link esterno, e gli utenti quasi mai la raggiungono. Per individuare le orfane, confronti tre liste: gli URL raggiunti dalla scansione tramite i link, gli URL della sitemap e gli URL che ricevono visite nei suoi analytics. Una pagina presente nella sitemap o che riceve visite, ma senza link interni in entrata, è una candidata orfana.
Misuri anche la profondità di clic, cioè il numero di clic dalla home page. Una pagina importante sepolta a cinque o sei clic riceve poca attenzione dai crawler e pochi link interni. La colleghi da una pagina hub pertinente, e faccia in modo che anche l'hub sia poco profondo.
Title, descrizioni e duplicati
Filtri i title mancanti, i title duplicati, le meta description duplicate e i title troppo lunghi per essere mostrati per intero nei risultati. I duplicati derivano quasi sempre da un modello, non da un redattore. Un modello di scheda prodotto che restituisce lo stesso title per ogni variante crea centinaia di duplicati, e correggere il modello li risolve tutti insieme. Consideri il tag title un forte suggerimento per Google, non una garanzia. A volte Google lo riscrive, e questo è un motivo in più per mantenerlo accurato e specifico.
I log del server chiudono il cerchio della scansione. Mostrano quali URL ha richiesto Googlebot, con quale frequenza e quali codici di stato ha ricevuto. Se vi ha accesso, confronti quelle richieste con la sitemap. Le pagine che Googlebot visita di continuo senza portare valore sono un segnale di spreco di crawl budget, spiegato nella nostra voce di glossario sul crawl budget.
Fase 2: indicizzazione, che cosa Google conserva e perché
Il rapporto Indicizzazione delle pagine di Search Console elenca gli URL che Google conosce e lo stato che attribuisce a ciascuno. Lo apra e ordini per motivo, non per numero. Ogni motivo richiede una correzione diversa. La guida di Search Console sugli stati di indicizzazione di Google è il riferimento per le etichette della tabella seguente.
Stato nel rapporto
Che cosa significa
Che cosa fare
Rilevata, attualmente non indicizzata
Google ha trovato l'URL ma non l'ha ancora scansionato, e ha rinviato la scansione perché riteneva il sito sovraccarico
Controllare i tempi di risposta del server e la profondità dell'URL. Assicurarsi che ci siano link interni che puntano a esso
Sottoposta a scansione, attualmente non indicizzata
Google ha scansionato la pagina e ha scelto di non indicizzarla. Google non indicizza tutte le pagine del web
Controllare prima la qualità: contenuto sottile, quasi duplicati, link interni deboli. Usare l'ispezione URL sulle pagine importanti
Bloccata da robots.txt
A Googlebot non è consentito scansionare l'URL
Confermare che il blocco sia intenzionale. Rimuoverlo se la pagina deve posizionarsi
Esclusa dal tag noindex
La pagina contiene una direttiva noindex
Rimuovere la direttiva se la pagina deve comparire. Mantenerla sulle pagine che devono restare fuori, come i risultati di ricerca interna
Una regola pratica: quando un intero tipo di pagina mostra una quota alta di «sottoposta a scansione, attualmente non indicizzata», guardi prima il modello e solo dopo gli articoli. I modelli sottili producono pagine sottili, e correggere un singolo articolo non cambia lo schema. La nostra guida allo stato «sottoposta a scansione, attualmente non indicizzata» illustra le cause nel dettaglio.
Per le pagine che contano, usi l'ispezione URL una alla volta. Mostra la data dell'ultima scansione, se la pagina è indicizzata e il canonical scelto da Google. Quando il canonical scelto non è quello che ha dichiarato, la causa è quasi sempre una duplicazione o segnali contrastanti, come un canonical che punta a un URL reindirizzato, o link interni che privilegiano una versione con parametri.
Fase 3: dati di ricerca, dove si trovano le opportunità
Il rapporto Rendimento di Search Console è il set di dati gratuito più utile per un audit. Di default mostra gli ultimi tre mesi, un periodo troppo breve per vedere un trend. Esporti almeno 90 giorni di dati su query e pagine, e conservi il file con la data, così da poterlo confrontare con il prossimo audit. Raggruppi la tabella per pagina e per query, e usi i filtri per paese e dispositivo quando il sito serve più mercati.
Google Search Console, la fonte dei dati su query, pagine e indicizzazione usati nell'audit.
Quattro analisi fanno emergere la maggior parte delle opportunità in questi dati.
Distanza dalla prima pagina. Query per cui la sua pagina si posiziona tra la posizione 8 e la 20 con impressioni reali. Queste pagine hanno già pertinenza. Spesso bastano un title migliore, più approfondimento sulla query o alcuni link interni da pagine correlate, non una riscrittura.
Calo. Pagine i cui clic sono scesi tra due periodi di pari durata. Confronti gli ultimi 90 giorni con i 90 precedenti. Guardi prima la pagina e poi le query che ha perso, perché una pagina può mantenere la posizione mentre una nuova funzione della ricerca le sottrae clic.
Cannibalizzazione. Query per cui due o più dei suoi URL compaiono e si alternano le posizioni di settimana in settimana. Scelga una pagina bersaglio per la query, poi consolidi in essa la pagina più debole, oppure renda le due pagine chiaramente diverse per intento.
Scarti di CTR. Pagine che mantengono una posizione normale ma ottengono meno clic di pagine simili. Confronti il tasso di clic con la media per quella posizione, poi riscriva title e description delle pagine sotto la media.
Per isolare un tipo di pagina, aggiunga un filtro di pagina con un'espressione regolare. Ad esempio, per vedere solo le pagine del blog che puntano a query di tipo «come fare», inserisca questi due valori:
Filtro pagina (regex):   /blog-geo-seo/.*
Filtro query (regex):    come|guida|checklist
Il tasso di clic dipende molto dalla parte alta della pagina dei risultati. Alcuni dati pubblicati aiutano a capire se uno scarto è reale. In uno studio sui tassi di clic di Google, il primo risultato organico riceveva il 27,6% dei clic, i primi tre insieme il 54,4%, e i risultati della seconda pagina lo 0,63%.
Perché la prima posizione conta così tanto
27,6%dei clic va al primo risultato organico
54,4%dei clic va ai primi tre risultati insieme
0,63%dei clic va ai risultati della seconda pagina
Fonte: Backlinko, studio sui tassi di clic di Google (backlinko.com/google-ctr-stats)
Usi queste medie come verifica di coerenza, non come obiettivo. Mescolano ogni tipo di query, e i suoi numeri dipendono dall'intento di ricerca, dalle query di brand e dagli elementi che compaiono sopra il suo risultato, come video, immagini o risposte IA. Confronti ogni pagina con pagine del suo sito che si posizionano per query simili.
Le soglie seguenti sono punti di partenza che usiamo per smistare i dati. Non sono regole di Google. Le adatti alle dimensioni del sito e al volume delle query.
Controllo
Soglia di partenza (la nostra regola empirica)
Perché conta
Distanza dalla prima pagina
Posizione media da 8 a 20, almeno 50 impressioni in 90 giorni
La domanda c'è, e la pagina è abbastanza vicina per salire
Calo
Clic in calo del 30% o più tra due periodi uguali
Traffico perso sufficiente a giustificare una revisione
Contenuto sottile
Meno di 300 parole di testo utile, esclusi navigazione e blocchi ricorrenti
Spesso insufficiente a rispondere alla query. Una pagina strumento breve può essere giusta, quindi verifichi l'intento
Link interni
Meno di 3 link interni in entrata da pagine indicizzabili
Un segnale debole di importanza e un sintomo frequente di pagina orfana
I dati di Search Console offrono anche una seconda verifica: le query per cui si posiziona senza averle mai prese di mira. Sono spesso le aggiunte più semplici a una pagina esistente, perché la pertinenza è già dimostrata dalle impressioni.
Fase 4: Core Web Vitals e mobile
La documentazione di Google sui Core Web Vitals definisce tre misure dell'esperienza utente e le loro soglie. Una pagina rientra nella fascia «buona» quando il suo Largest Contentful Paint è di 2,5 secondi o meno, il suo Interaction to Next Paint di 200 millisecondi o meno e il suo Cumulative Layout Shift di 0,1 o meno. L'INP è diventato un Core Web Vital stabile nel 2024, sostituendo il First Input Delay.
Metrica
Buona quando
Che cosa misura
Correzione tipica
LCP
2,5 secondi o meno
Quanto velocemente carica l'elemento visibile più grande
Ottimizzare l'immagine principale, ridurre il tempo di risposta del server, precaricare il font di cui la pagina ha bisogno per primo
INP
200 millisecondi o meno
Quanto rapidamente la pagina risponde a clic, tocchi e pressioni di tasti durante la visita
Spezzare le lunghe attività JavaScript, rimuovere gli script di terze parti pesanti, evitare di bloccare il thread principale al caricamento
CLS
0,1 o meno
Quanto si spostano i contenuti mentre la pagina carica
Definire larghezza e altezza di immagini e embed, riservare spazio a banner e pubblicità, evitare elementi che compaiono tardi sopra la piega
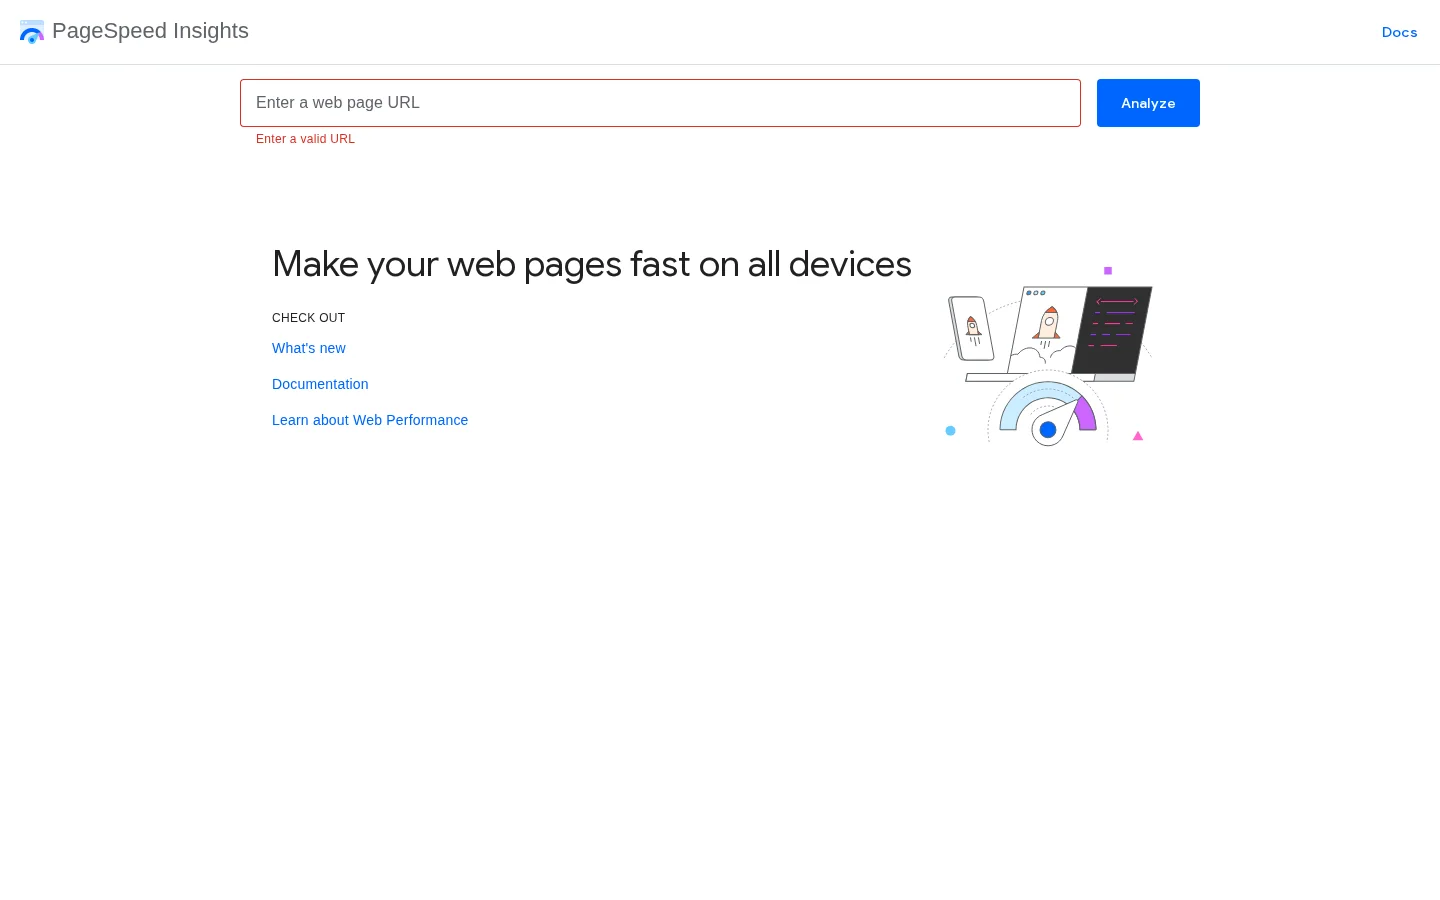
Legga prima i dati di campo e poi quelli di laboratorio. I dati di campo arrivano da utenti reali di Chrome e dicono se i visitatori soffrono davvero. I dati di laboratorio vengono da un test simulato e spiegano perché una pagina è lenta. PageSpeed Insights mostra entrambi: i dati di campo quando Google ha abbastanza traffico per l'URL, e i dati di laboratorio per ogni URL testato.
PageSpeed Insights, che mostra dati di campo e di laboratorio per qualsiasi URL.
Testi tre o cinque URL per modello, non solo la home page. Un modello di scheda prodotto, uno di categoria e uno di blog possono avere punteggi molto diversi sullo stesso sito, perché caricano script diversi. Un buon punteggio di laboratorio con un INP di campo scadente è un risultato comune nei siti con tag manager pesanti e widget di chat. In quel caso il test di laboratorio non è sbagliato, ma non rappresenta l'interazione che gli utenti vivono dopo il caricamento della pagina.
Su mobile verifichi tre cose. Il contenuto principale della versione mobile deve corrispondere a quello desktop, perché Google usa principalmente la versione mobile di una pagina per l'indicizzazione. I dati strutturati e i link interni devono essere uguali nelle due versioni. E nessun interstitial invadente deve coprire il contenuto all'arrivo. La velocità conta per il ranking, ma il motivo più utile per correggerla è che i modelli lenti fanno perdere visitatori prima che leggano qualsiasi cosa.
Fase 5: contenuti on-page e link interni
Per ogni pagina importante controlli il title, i titoli, la profondità della risposta, i link in entrata e in uscita, e l'eventuale esistenza di un quasi duplicato. Lo faccia su un campione di pagine di ogni modello, e poi sulle pagine che nei dati di ricerca appaiono come distanza dalla prima pagina o come calo.
Controllo
Superato quando
Fallito quando
Tag title
Nomina l'argomento e la query principale della pagina, ed è unico nel sito
Duplica un'altra pagina, o è un valore predefinito del modello, come il solo nome del sito
H1
Uno per pagina, che enuncia l'argomento con parole semplici
Mancante, ripetuto, o sostituito da un logo o da un banner
Prima schermata
La domanda della query riceve risposta vicino all'inizio
La prima schermata contiene solo contesto e testi di brand, e la risposta arriva dopo diversi scroll
Profondità
Copre le sottodomande che le persone si pongono sull'argomento, con dettagli concreti
Sottile, o riempito di paragrafi ripetuti
Link interni
Linkata da pagine correlate, e porta al passo logico successivo
Orfana, o linkata solo dal footer o dalla sitemap
Dati strutturati
Corrispondono al contenuto che il visitatore vede nella pagina
Marcano contenuti non presenti nella pagina, o usano il tipo sbagliato
I link interni sono la leva più economica di tutto l'audit. Un link da una pagina che già si posiziona, inserito nel corpo del testo e con le parole della query bersaglio nell'ancora, trasmette sia contesto sia autorevolezza. Le ancore generiche come «clicca qui» o «leggi di più» trasmettono pochissimo significato. Parta dalle pagine che portano più traffico, perché ogni nuovo link da lì raggiunge una pagina con un pubblico reale.
I contenuti duplicati e quasi duplicati meritano un passaggio a parte. Filtri di categoria, parametri di ordinamento e parametri di tracciamento creano spesso molti URL che mostrano la stessa lista. Decida quale versione deve esistere, poi usi il tag canonical, le regole robots o la gestione dei parametri più adatta. Non lasci la decisione a Google, perché il risultato probabilmente non le piacerà.
Suggerimento
Per una prima verifica rapida di una singola pagina, lo strumento gratuito di audit SEO on-page esegue i controlli più comuni su title, titoli, link e meta tag, così può dedicare il tempo ai risultati che richiedono giudizio.
Fase 6: autorevolezza e link
Il controllo del profilo di link risponde a tre domande: sta acquisendo domini che linkano a un ritmo costante, ha perso link importanti, e ci sono schemi che sembrano manipolati? Esporti nel tempo i domini che linkano da uno strumento di backlink, poi cerchi i picchi improvvisi, spesso dovuti a una campagna a pagamento o allo spam, e i cali, spesso dovuti a pagine scadute o a una migrazione. La nostra guida all'audit dei backlink illustra la revisione completa.
Faccia attenzione allo strumento di disavow. Secondo le indicazioni dello stesso Google, la maggior parte dei siti non ne ha bisogno. Lo usi quando vede uno schema chiaro di link che non ha meritato e un'azione manuale o un problema serio legato a essi, non perché uno strumento di backlink ha assegnato un punteggio basso ad alcuni domini. Disconoscere per errore dei buoni link costa più che lasciarne qualcuno cattivo.
Fase 7: visibilità nelle IA e crawler delle IA
Due controlli fanno ormai parte di ogni audit. Il primo riguarda l'accesso: i crawler delle IA possono raggiungere le sue pagine? Verifichi le regole di robots.txt per ogni crawler che le interessa. OpenAI usa GPTBot e OAI-SearchBot, Anthropic usa ClaudeBot e Perplexity usa PerplexityBot, e non servono tutti lo stesso scopo. Una regola unica per tutti raramente è la decisione giusta. La nostra guida ai crawler delle IA li elenca con i rispettivi ruoli.
L'esempio qui sopra è una decisione possibile, non una raccomandazione per ogni sito. Consente a un crawler di leggere le pagine per le risposte di ricerca e ne blocca un altro usato per l'addestramento. Decida crawler per crawler, metta la decisione per iscritto e controlli il file dopo ogni rilascio, perché un robots.txt che blocca tutto compare spesso dopo una release di staging.
Il secondo controllo riguarda la visibilità: i motori di risposta la citano quando un acquirente pone la domanda su cui lei punta? Costruisca un elenco di dieci o venti prompt a partire dalle domande reali nei suoi dati di ricerca e nelle telefonate commerciali. Li esegua in ChatGPT, Perplexity e Gemini, annoti quali marchi e quali URL vengono citati, e ripeta ogni prompt più volte nell'arco di alcuni giorni, perché le risposte cambiano da una esecuzione all'altra. Il metodo di audit della visibilità IA spiega come valutare i risultati.
Metodi di audit: quale si adatta alla sua situazione
Gli audit differiscono per perimetro e per il punto da cui si parte. Cinque metodi sono comuni nella pratica. Ciascuno è adatto a una situazione diversa, e la maggior parte dei team ne combina due.
1. L'audit tecnico completo
Principio: coprire l'intero sito, ogni tipo di pagina e ogni fonte di dati, poi classificare i risultati. Usarlo quando prepara una migrazione, dopo un calo netto di traffico o per il primo audit di un sito grande. Vantaggio: trova problemi strutturali che nessuna revisione pagina per pagina può vedere, come una navigazione a faccette che moltiplica gli URL. Limite: è lento e produce molti risultati che richiedono un secondo passaggio per essere ordinati. Esempio: un retailer con 40000 URL di prodotto scopre che un solo parametro di filtro genera la maggior parte dei suoi duplicati, cosa che nessuna revisione di singoli prodotti avrebbe rivelato.
2. L'audit basato sui dati
Principio: partire da ciò che è cambiato nei dati di ricerca, poi diagnosticare solo le pagine e le query coinvolte. Usarlo quando fa una revisione mensile, subito dopo il rilascio di un aggiornamento importante o quando il team è piccolo. Vantaggio: il lavoro è dato in ordine di traffico fin dal primo minuto. Limite: è cieco davanti alle pagine che non hanno ancora dati, come nuove sezioni o pagine bloccate fin dall'inizio. Esempio: un blog che ha perso clic su cinque pagine controlla quelle cinque, scopre che due si cannibalizzano e le unisce.
3. L'audit a livello di pagina
Principio: eseguire ogni controllo su un solo URL, poi decidere se serve una riscrittura. Usarlo quando una singola pagina importante rende meno del previsto, o prima di una riscrittura pianificata. Vantaggio: rapido e concreto, con un prima e un dopo chiari. Limite: non può mostrare schemi, quindi un bug di modello può sembrare un problema isolato. Esempio: una scheda prodotto con un buon title e un buon contenuto ha un canonical che punta a una variante esaurita.
4. L'audit dei divari con i concorrenti
Principio: confrontare le sue pagine e i suoi argomenti con quelli che si posizionano sopra di lei per le stesse query. Usarlo quando pianifica nuovi contenuti o nuovi link. Vantaggio: mostra ciò che il mercato premia nella pratica, inclusi profondità, formato e sottodomande coperte. Limite: copiare il leader può portarla in un argomento saturo o con un intento sbagliato. Verifichi che cosa hanno davvero in comune i primi risultati prima di decidere. Esempio: i primi cinque risultati di una query rispondono a una domanda sul prezzo già nella prima schermata, la sua no.
5. L'audit della visibilità IA
Principio: verificare se i crawler delle IA possono leggere le sue pagine e se i motori di risposta la citano per le domande che contano. Usarlo quando deve sapere se gli strumenti di IA consigliano il suo brand. Vantaggio: copre un canale che i classici strumenti di monitoraggio delle posizioni non mostrano. Limite: le risposte variano da una esecuzione all'altra, quindi il campione va ripetuto prima di trarre conclusioni. Esempio: un'azienda di software viene citata per una funzione che non vende più, il che dimostra che le sue pagine di confronto sono obsolete.
Metodo
Punto di partenza
Ideale per
Limite principale
Audit tecnico completo
La scansione e tutte le fonti di dati
Migrazioni, siti grandi, cali netti
Lento, e difficile da ordinare senza un piano
Audit basato sui dati
Variazioni nei dati di ricerca
Revisioni mensili, team piccoli
Non vede le pagine senza dati
Audit a livello di pagina
Un URL
Una pagina che rende meno del previsto
Non vede gli schemi di modello
Audit dei divari con i concorrenti
I risultati sopra di lei
Nuovi contenuti e nuovi link
Rischio di copiare un intento sbagliato
Audit della visibilità IA
Accesso dei crawler e motori di risposta
Capire se l'IA la consiglia
Le risposte variano, i campioni vanno ripetuti
Audit rapido o audit completo
Audit rapido
Solo dati di ricerca e modelli principali
Termina con una lista breve e ordinata
Non vede i problemi strutturali e di scansione
Audit completo
Copre ogni tipo di pagina e modello
Trova problemi strutturali e di scansione
Lento, e facile da chiudere senza un piano
Il nostro consiglio: cominci con l'audit rapido, e passi all'audit completo solo quando quello rapido indica una causa strutturale o quando sta per cambiare l'architettura del sito.
Dare priorità: dai risultati a un piano
Un audit con 400 risultati e nessun ordine vale meno di uno con dieci. Valuti ogni risultato su due aspetti: quanto traffico o fatturato mette a rischio e quanto è difficile la correzione. Parta dagli interventi ad alto impatto e basso sforzo. Poi passi agli interventi ad alto impatto che richiedono più lavoro ma sbloccano un intero modello, perché una sola correzione lì cambia migliaia di pagine.
Risultato
Traffico a rischio
Sforzo
Priorità
Un modello linka a pagine 404 da ogni pagina
Alto
Basso
Da fare subito
Pagine importanti con title duplicati
Alto
Basso
Da fare subito
LCP lento sul modello di categoria
Alto
Medio
Pianificare nello sprint successivo
Articoli di blog in calo
Medio
Medio
Aggiornare in ordine di clic persi
Pagine di glossario orfane
Basso
Basso
Raggruppare con il lavoro di link interni
Pagine di archivio dei tag con contenuto sottile
Basso
Medio
Verificare l'intento, poi noindex o consolidare
Assegni a ogni voce un responsabile, una data e la metrica che si aspetta di far muovere. Un risultato senza responsabile resta un appunto, e gli appunti non cambiano i ranking. Misuri di nuovo dopo che Google ha riscansionato le pagine interessate, cosa che può richiedere settimane, e confronti con la base di partenza salvata all'inizio. Quando presenta i risultati, il modello di report di audit SEO offre una struttura che dirigenti e clienti possono leggere in dieci minuti.
Se vuole avere il traffico di Google e quello delle IA in un unico posto mentre segue queste correzioni, la dashboard GEO / SEO di Sorank li mostra affiancati.
Un audit SEO di 90 minuti: che cosa si può completare in una sessione
Un audit SEO di 90 minuti controlla le pagine che portano più traffico di ricerca, in un ordine che fa emergere subito le perdite reali. Lo usi quando ha una sola sessione e le serve un elenco prioritario di correzioni, non una revisione di ogni URL. Limiti il lavoro alle pagine principali e a un URL di esempio per modello, e il risultato sarà utilizzabile lo stesso giorno.
Divida la sessione in blocchi fissi, e chiuda ciascun blocco quando il suo tempo è scaduto. Il limite di tempo fa parte del metodo, perché la obbliga a scegliere.
Minuti
Attività
Risultato
Da 0 a 10
Esportare 90 giorni di dati su query e pagine da Search Console ed elencare le prime 20 pagine per clic
Una base di partenza salvata e un elenco di pagine
Da 10 a 25
Applicare a quell'elenco i controlli di distanza dalla prima pagina e di calo descritti nella fase 3
Pagine che hanno perso clic o si trovano tra le posizioni 8 e 20
Da 25 a 40
Scansionare un URL di esempio per modello e verificare codice di stato, canonical e direttive robots
Errori, canonical errate e blocchi, per modello
Da 40 a 55
Aprire il rapporto Pagine di Search Console e ordinare i motivi per numero
Lo stato che riguarda il maggior numero di pagine
Da 55 a 70
Eseguire PageSpeed Insights su un URL per modello, leggendo prima i dati di campo
Il modello con LCP o INP di campo più debole
Da 70 a 90
Scrivere i primi dieci risultati con traffico a rischio, sforzo e un responsabile
Un piano prioritario da inviare lo stesso giorno
Ogni riga risponde a una domanda, quindi può saltarne una senza perdere le altre. Se il rapporto di indicizzazione non mostra nulla di insolito, dedichi quel tempo ai dati di ricerca, che di solito portano più in fretta a una correzione.
Che cosa un audit di 90 minuti non può vedere
Un limite di tempo nasconde tre cose. Sfuggono i problemi strutturali, come un filtro che moltiplica gli URL, perché si leggono solo campioni. Non si usano i log del server, quindi non si vede con quale frequenza i crawler richiedono una pagina. E si salta il profilo dei link, che richiede un export completo da uno strumento di backlink. Li annoti come domande aperte per un successivo audit dei backlink o per una revisione completa, così che l'audit breve non sembri più completo di quanto sia.
Errori che sprecano una sessione breve
L'errore più comune è partire dal crawler. La scansione di un sito grande può richiedere più dell'intera sessione e restituire più avvisi di quanti qualcuno riesca a leggere. Parta invece dai dati di ricerca, e apra il crawler solo per le pagine che hanno clic o impressioni. Sistemi prima gli avvisi di quelle pagine, perché gli avvisi su pagine che nessuno visita non cambiano il suo traffico.
Suggerimento
Inserisca la sessione nel calendario con un timer e un solo file di output. Usi fin dall'inizio le colonne del modello di report di audit SEO, così l'elenco è pronto da condividere al minuto 90.
Errori comuni, e come riconoscerli e correggerli
La maggior parte degli audit contiene gli stessi errori. Sono facili da evitare una volta che se ne conoscono i segnali.
Fare un audit senza perimetro
Che cosa è: l'audit copre tutto, quindi nulla viene completato. Come riconoscerlo: il report ha centinaia di problemi, nessuno con una cifra di traffico o un responsabile. Come correggerlo: ricominci con la richiesta mirata della prima sezione, limiti la scansione ai tipi di pagina che contano e ordini i risultati per traffico prima di scrivere qualsiasi altra cosa.
Trattare gli avvisi come se fossero posizionamenti
Che cosa è: il team corregge gli avvisi che lo strumento mostra in rosso, anche quando riguardano pagine che nessuno visita. Come riconoscerlo: il numero di avvisi scende mentre i clic sulle pagine importanti continuano a calare. Come correggerlo: incroci la scansione con i dati di ricerca, e risolva prima i problemi sulle pagine che hanno traffico, impressioni o link.
Considerare una sola scansione come la verità
Che cosa è: il crawler non segnala errori, quindi il team conclude che il sito è sano. Come riconoscerlo: Search Console segnala molti URL «sottoposta a scansione, attualmente non indicizzata» o «rilevata» che il crawler non ha mai segnalato. Come correggerlo: confronti la scansione con la sitemap, il rapporto di indicizzazione e i log del server. Un crawler vede solo ciò che può raggiungere tramite link e rendering, quindi i contenuti dietro un login, gli script o i filtri a faccette possono mancare nel suo elenco.
Correggere le pagine invece dei modelli
Che cosa è: il team modifica lo stesso title, la stessa immagine o lo stesso canonical su centinaia di pagine, una alla volta. Come riconoscerlo: lo stesso risultato compare sulla maggior parte degli URL di un tipo di pagina. Come correggerlo: corregga il modello una volta, poi controlli un campione di pagine per confermare che la modifica ha funzionato ovunque. Una sola modifica al modello risolve l'intero gruppo.
Bloccare una pagina per rimuoverla dalla ricerca
Che cosa è: il team aggiunge un disallow in robots.txt a una pagina che vuole far uscire da Google. Come riconoscerlo: la pagina resta nell'indice con un URL nudo e senza snippet, e il report la segnala come bloccata. Come correggerlo: consenta la scansione, aggiunga una direttiva noindex e attenda che Google riscansioni la pagina. Una volta uscita dall'indice, può bloccarla se serve, ma non è necessario.
Esempio (a titolo illustrativo)
Immagini un sito che ha ritirato una serie di pagine di campagna e le ha bloccate in robots.txt. Le pagine continuano a comparire nella ricerca con un URL nudo e senza descrizione, perché altri siti puntano ancora a esse. Rimuovere il blocco e aggiungere noindex permette a Google di scansionare le pagine, leggere la direttiva e farle uscire dall'indice.
Inseguire un punteggio di laboratorio perfetto
Che cosa è: il team ottimizza per un punteggio di 100 in un test di laboratorio e ignora i dati di campo. Come riconoscerlo: il punteggio di laboratorio è alto, ma l'INP di campo dello stesso modello è scadente nel rapporto Core Web Vitals di Search Console. Come correggerlo: profili le interazioni che fanno davvero gli utenti, di solito dopo il caricamento della pagina. Cerchi le attività lunghe innescate dagli script, e non il tempo di caricamento del primo rendering.
Con quale frequenza fare un audit
Faccia un audit rapido ogni mese sui dati di ricerca e sui suoi modelli più importanti. Faccia un audit completo dopo una migrazione, un restyling, un cambio di CMS o un calo improvviso del traffico, e una revisione completa all'anno per cogliere le derive strutturali. I dati di ricerca vanno monitorati in continuo, perché un calo di clic è più utile come allarme che come promemoria sul calendario.
Audit del sito: un controllo dello stato di salute ripetibile per l'intero dominio
Un audit del sito è una scansione di ogni URL raggiungibile di un unico dominio, riportata per tipo di problema e gravità. Mostra che cosa non funziona in tutto il sito, inclusi i pattern che una revisione pagina per pagina non vede. Non dice quale correzione farà salire i ranking, quindi lo abbini ai dati di ricerca.
Definisca il perimetro della scansione prima di iniziare
Filtri, opzioni di ordinamento e tag di tracciamento possono generare molti più URL delle pagine che ha, e la maggior parte mostra la stessa lista. Escluda questi parametri e i file multimediali, e scansioni ogni sottodominio come progetto separato. Mantenga basso il ritmo delle richieste, così il server resta veloce per i visitatori reali. Mantenga nel perimetro la paginazione (page=), perché le liste paginate possono contenere pagine che vuole indicizzate.
La maggior parte dei crawler accetta regole di esclusione scritte come espressioni regolari come queste. Le provi su una scansione breve e verifichi che il numero di URL cali solo per i parametri che voleva escludere.
Legga la gravità prima del punteggio
Ogni strumento raggruppa i problemi per livelli e calcola un proprio punteggio di salute. Le etichette cambiano da uno strumento all'altro, ma la logica di priorità è la stessa. Un punteggio è una linea di tendenza per uno strumento con impostazioni fisse, non un voto che applica Google. Scorra i livelli in quest'ordine:
Livello
Problemi tipici
Prima azione
Errori su pagine indicizzabili
Risposte 4xx o 5xx su URL che vuole posizionare, link interni rotti
Correggerli per primi, partendo dalle pagine che già portano clic
Errori su pagine che non vuole indicizzare
Ricerca interna rotta, URL di filtri o campagne dismesse
Rimuovere i link interni che puntano ancora a esse
Avvisi
Tag title troppo lunghi, meta description mancanti, titoli duplicati
Correggerli a gruppi, idealmente con un'unica modifica al modello
Segnalazioni
Piccoli suggerimenti di ottimizzazione
Verificarli una volta e agire solo se si ripetono sulle pagine che vendono
Confronti due scansioni, non due punteggi
Il risultato più utile di un audit del sito è la differenza tra due esecuzioni. Esporti l'elenco dei problemi dell'ultima esecuzione, scansioni di nuovo con le stesse impostazioni e confronti i conteggi per tipo di problema e per URL. I problemi nuovi vengono prima, perché un errore nuovo su una pagina online di solito segue una release recente. Confronti ogni nuovo gruppo con il registro delle modifiche prima di assegnare un responsabile.
Per esempio, la prima esecuzione segnala 42 errori. La seconda, quattro settimane dopo, ne segnala 57, e 15 dei nuovi si trovano su un modello di pagina dei prezzi andato online quella settimana. Corregga il modello una volta sola. Se il conteggio torna verso 42, la correzione ha funzionato, e quell'esecuzione diventa il riferimento per la successiva.
Mantenga la routine abbastanza breve da poterla ripetere
Un audit del sito che richiede una giornata intera non verrà ripetuto. Salvi perimetro, regole di esclusione e tabella di gravità in un'unica configurazione, così la volta successiva bastano pochi minuti. Pianifichi la scansione ed esporti ogni volta gli stessi tre file: l'elenco dei problemi, gli URL indicizzabili e gli URL che ricevono clic. La nostra guida ai report SEO automatizzati spiega che cosa automatizzare e come configurarlo.
Se sta ancora scegliendo un crawler, il nostro confronto degli strumenti di SEO tecnico ordina le opzioni in base al lavoro che svolgono. Un audit del sito merita di essere pianificato solo se qualcuno legge la differenza tra un'esecuzione e l'altra. Altrimenti è solo un'esportazione in più in una cartella.
Da dove iniziare questa settimana
Se non ha mai fatto un audit, faccia quattro cose in ordine. Esporti 90 giorni di dati di Search Console e li salvi con la data. Scansioni i suoi modelli principali con un crawler, partendo dalla versione gratuita da 500 URL se il sito è piccolo. Legga il rapporto di indicizzazione e ordini i motivi. Poi corregga i tre problemi di modello più grandi che ha trovato, e misuri di nuovo dopo il ciclo di scansione successivo.
Esportare i dati su query e pagine, e salvare la base di partenza.
Scansionare un URL di esempio per modello, annotando codici di stato, title, canonical e direttive robots.
Leggere il rapporto di indicizzazione, e trasformare ogni stato in una domanda con un responsabile.
Correggere i tre problemi di modello più grandi, poi confrontare i dati di ricerca dopo il ciclo di scansione successivo.
Un buon audit non finisce con un documento. Finisce con una breve lista di correzioni che qualcuno sta realizzando questo mese, e con una base di partenza che dimostra se hanno funzionato.
Domande frequenti
Quanto dura un audit SEO?
Dipende dalle dimensioni del sito e da quanto in profondità serve andare. Un audit mirato sui modelli principali e sui dati di ricerca si può completare in pochi giorni. Un audit completo di un sito grande con molti modelli richiede più tempo, e la maggior parte di questo tempo va alla diagnosi e alla definizione delle priorità più che alla scansione in sé.
Di quali strumenti ho bisogno per un audit SEO?
Almeno Google Search Console e un crawler come Screaming Frog SEO Spider, più PageSpeed Insights per la velocità. Analytics e i log del server aggiungono contesto utile. Le suite SEO a pagamento aiutano per backlink e dati sui concorrenti, ma non sono indispensabili per un primo audit.
Qual è la differenza tra un audit SEO e una checklist SEO?
Una checklist elenca i controlli da fare. Un audit esegue quei controlli sul suo sito, decide quali risultati contano e ordina le correzioni in base al traffico che mettono a rischio. Usi una checklist per costruire l'audit, e l'audit per scegliere il lavoro da fare.
y!
Ricevi gratis il tuo piano di contenuti per 30 giorni
Analizziamo i tuoi concorrenti, il tuo sito web e la tua visibilità nelle IA per creare gratuitamente un piano di contenuti su misura.
“Ho testato Sorank sul sito reale di un cliente ed è pazzesco. Fa tutto quello che un'agenzia fa pagare 1.500 € al mese. Ora va in produzione su quel cliente.”Guillaume Guersanguersanguillaume.com
“Siamo un'agenzia pubblicitaria e volevamo rimettere in carreggiata il nostro SEO una volta per tutte. Sorank ci ha dato una visione chiara del nostro sito, ci ha aiutato a dare priorità alle ottimizzazioni e a strutturare correttamente i nostri contenuti. Lo strumento è facile da usare, ben progettato per un team e molto pratico per centralizzare il monitoraggio senza dover destreggiarsi tra più piattaforme. Una base molto solida per ripartire da zero con il nostro SEO.”Gaspard MadouiAgenzia Pubblicitaria
“Mi sono specializzata in GEO grazie a Sorank. Il GEO Leaderboard mi permette di mostrare ai miei clienti il loro posizionamento rispetto ai concorrenti su ChatGPT. È un vero differenziatore commerciale.”MélanieFreelancer SEO
“Ottimo servizio, funziona bene per il nostro sito web e ci aiuta a capire come migliorarlo per posizionarci meglio su Google e altrove. Complimenti, continuate così, ve lo consiglio.”Hugo T.Commerciante e-commerce


 Search Console