La confidentialité est importante pour nous. Vous avez donc la possibilité de désactiver certains types de stockage qui peuvent ne pas être nécessaires au fonctionnement de base du site Web. Le blocage des catégories peut avoir un impact sur votre expérience sur le site Web. Plus d'informations (Politique de cookies)
Merci ! Vos choix ont bien été enregistrés.
Oups ! Une erreur s'est produite lors de l'envoi du formulaire.
Un carnet avec une checklist d'audit SEO et des graphiques imprimés sur un bureau.
Outils
Sur cette page
En bref
Un audit SEO est un contrôle structuré de tout ce qui empêche vos pages d'être explorées, indexées, comprises, cliquées et citées. Faites-le dans un ordre fixe : exploration, indexation, données de recherche, vitesse, contenu on-page, liens, puis visibilité dans les IA. Notez chaque constat selon le trafic qu'il bloque, et transformez les dix premiers en tâches datées avec un responsable. Un audit ciblé peut se faire en quelques jours. Un audit complet d'un grand site prend plus de temps, et son résultat doit être un plan, pas une liste.
3 jours offerts, puis vous arrêtez quand vous voulez. Garantie résultats 90 jours, sous conditions.
Ce qu'est un audit SEO, et ce qu'il n'est pas
Un audit SEO répond à une seule question : quels problèmes techniques, de contenu et d'autorité vous coûtent des visites aujourd'hui, et dans quel ordre faut-il les corriger ? Ce n'est pas une liste de toutes les bonnes pratiques qui existent. Une checklist de 40 points vous dit quoi regarder. Un audit vous dit ce qui ne va pas sur votre site, son importance, et ce qu'il faut faire en premier.
Trois notions se confondent : l'audit (le diagnostic), la checklist (la liste des contrôles) et le rapport (ce que vous remettez à un client ou à un responsable). Notre modèle de rapport d'audit SEO traite du rapport, et la checklist SEO technique couvre les contrôles. Cet article porte sur la méthode qui relie les deux, et sur les données nécessaires pour décider de ce qui compte.
Deux façons de cadrer le même audit
Brief vague
Vérifier le site pour trouver des problèmes SEO
Résultat : une longue liste d'avertissements que personne ne lit
Brief ciblé
Trouver les pages qui ont perdu des clics sur les 90 derniers jours
Résultat : dix corrections classées par trafic en jeu
La différence ne tient pas à l'effort. Elle tient à la question. Un brief ciblé nomme les pages, la période et la décision, si bien que chaque contrôle a une raison d'exister.
Avant de commencer : accès, périmètre et point de départ
La plupart des audits échouent avant le premier crawl, parce que personne ne s'est mis d'accord sur le périmètre ni n'a sauvegardé un point de départ. Réglez trois points avant d'ouvrir un outil.
Périmètre. Quels domaines et sous-domaines, quels pays et quelles langues, quels types de pages comptent. Pour un site e-commerce, cela signifie accueil, catégories, fiches produits, blog et pages d'atterrissage éventuelles. Notez-les.
Accès. Accès propriétaire à Search Console pour chaque propriété (versions http, https, www et sans www, si elles existent), accès en lecture à votre outil d'analyse, et accès au CMS ou aux journaux serveur si vous les avez. Les journaux serveur montrent ce que les robots demandent réellement, ce qu'aucune simulation d'exploration ne peut révéler.
Point de départ. Un instantané des clics, des impressions, de la position moyenne et des pages qui apportent le plus de clics, enregistré dans une feuille datée. Sans lui, vous ne pouvez pas prouver qu'une correction a fonctionné.
Avant toute exploration
Confirmer l'accès propriétaire à Search Console pour chaque propriété
Exporter 90 jours de données de requêtes et de pages, et les enregistrer avec la date du jour
Lister vos principaux types de pages et une URL d'exemple pour chacun
Formuler l'objectif en une phrase : plus de clics sur les pages stratégiques, moins d'erreurs, des modèles de pages plus rapides
Choisir votre robot d'exploration et ses limites (voir la section sur l'exploration ci-dessous)
Un audit examine toute la structure d'un site avant de corriger la moindre page.
La méthode, dans l'ordre : sept étapes
L'ordre compte. L'exploration vous dit ce qui existe sur votre site. L'indexation vous dit ce que Google conserve. Les données de recherche vous disent ce que les gens trouvent et cliquent. La vitesse, le contenu et les liens expliquent ensuite pourquoi une page sous-performe. Si vous faites l'inverse, vous passerez des heures à réécrire une page que Google ne peut même pas indexer.
Les sept étapes d'un audit SEO
Explorer le siteLister chaque URL avec son code de statut, son titre, sa canonical, ses directives robots et ses liens internes.
Vérifier l'indexationComparer ce que vous publiez avec ce que Google indexe, et lire la raison de chaque exclusion.
Lire les données de rechercheTrouver les pages et requêtes qui gagnent ou perdent des clics, et celles qui sont proches du haut de la première page.
Tester la vitesse et le mobileMesurer les Core Web Vitals sur chaque modèle, en commençant par les données terrain issues d'utilisateurs réels.
Examiner le contenu on-pageVérifier titres, intertitres, profondeur, duplication et liens internes, page par page et modèle par modèle.
Évaluer l'autorité et les liensExaminer les domaines référents dans le temps, les liens perdus, les textes d'ancre et les signaux de spam.
Vérifier la visibilité dans les IAConfirmer que les robots d'IA peuvent atteindre vos pages, et tester si les moteurs de réponse vous citent.
Contrôles SEO avant audit : ce qu'il faut confirmer avant de faire confiance aux données
Les contrôles SEO avant audit vérifient que le site que vous allez auditer est bien celui que Google et vos visiteurs voient, et que vos données sont assez fiables pour agir. Consacrez environ une heure à ces contrôles avant tout crawl. Une mauvaise propriété, une règle de préproduction restée en ligne ou un suivi cassé peuvent fausser chaque constat qui suit, et une exploration ne révélera rien de tout cela.
Confirmer quelle version du site est en ligne
Demandez chaque variante de votre domaine : http, https, avec et sans www, avec et sans barre oblique finale. Chaque variante doit aboutir à la même adresse finale, idéalement après une seule redirection. Deux versions en ligne répartissent liens et signaux entre elles, et un robot les signalera toutes deux comme saines.
Lisez l'en-tête Location de chaque réponse. Il doit pointer directement vers votre adresse préférée, pas vers une deuxième redirection. Répétez le contrôle sur la page d'accueil et sur une page profonde, car les règles de redirection diffèrent souvent d'un modèle à l'autre.
Vérifier qu'aucun réglage de test n'est arrivé en ligne
Les réglages de préproduction sont l'une des causes les plus fréquentes d'une chute soudaine. Regardez le robots.txt en ligne, la balise meta robots et l'en-tête X-Robots-Tag sur la page d'accueil et sur un article. Une règle Disallow pour tout le site, ou un noindex resté d'une version de test, peut masquer des sections de la recherche alors que les pages s'affichent normalement pour les visiteurs. Si vous en trouvez une, corrigez-la avant d'auditer ces sections, car chaque constat ultérieur décrirait un site que Google ne peut pas voir.
Tenir un journal des modifications avant de diagnostiquer une chute
Écrivez une liste datée de chaque mise en production, refonte, mise à jour du CMS, migration et modification de robots.txt ou de noindex des six derniers mois. Comparez ensuite ces dates avec le début de toute variation de trafic. Une chute qui commence le jour de la mise en production d'un modèle désigne ce modèle. Une chute sans changement à proximité peut venir d'une mise à jour de la recherche, et demande un autre contrôle. Sans journal, vous accuserez ce que vous avez regardé en dernier. Pour les changements qui touchent aux URL, la checklist de migration SEO indique ce qu'il faut consigner.
Vérifier les données sur lesquelles reposera l'audit
Comparez les clics de Search Console avec les sessions organiques de votre outil d'analyse sur les mêmes 90 jours. Les deux courbes n'ont pas besoin de coïncider, mais elles doivent évoluer dans le même sens. Si elles divergent, contrôlez les balises sur les pages clés, la bannière de consentement et le filtrage des robots avant de diagnostiquer le site. Le comparatif des deux outils explique ce que mesure chacun.
Étape 1 : explorer le site et corriger ce que le robot trouve
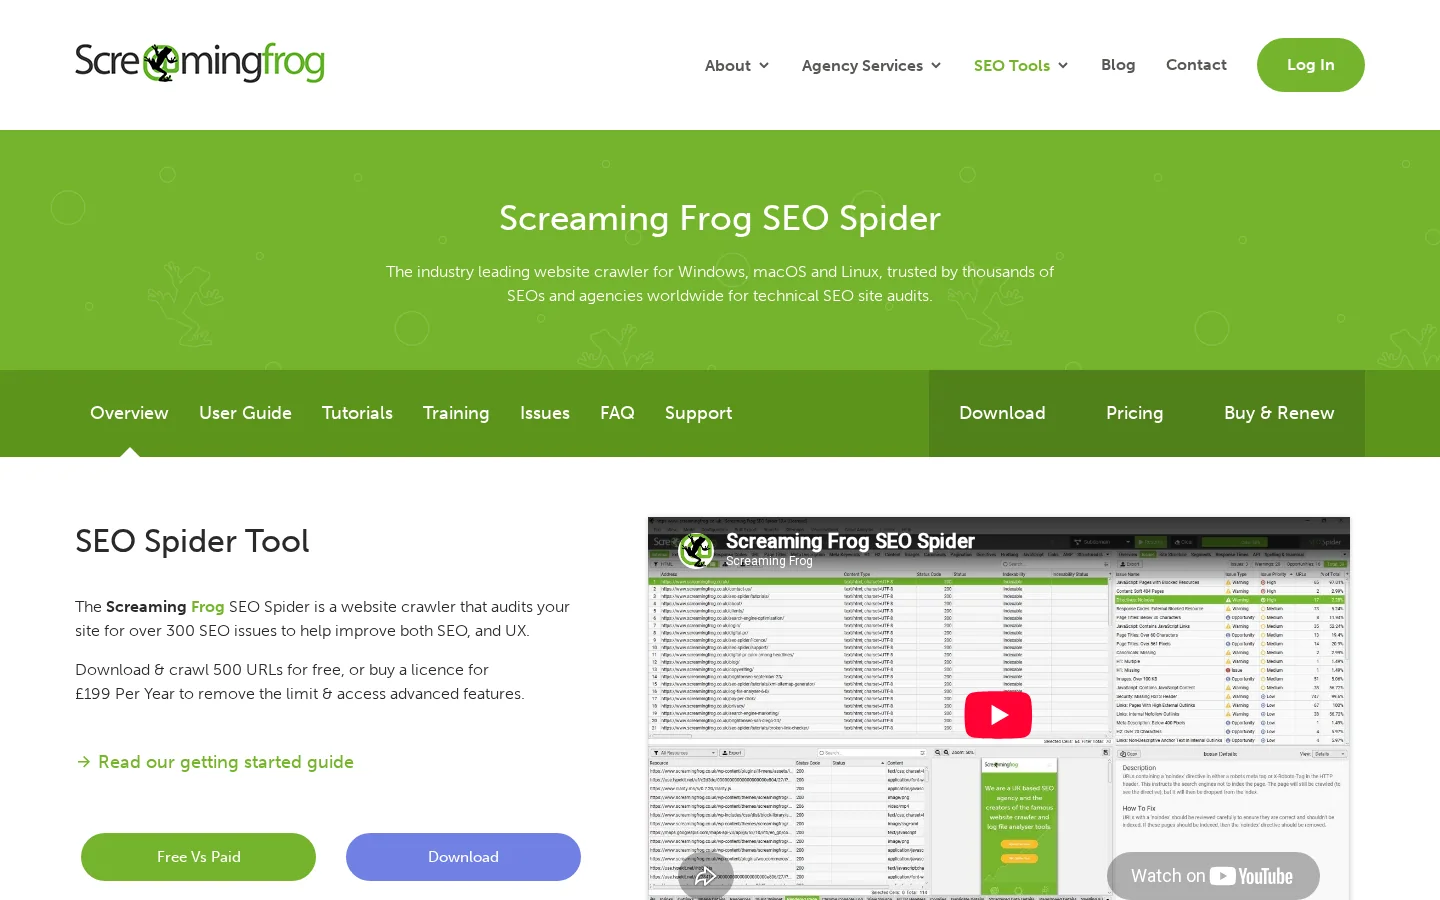
Un robot d'exploration fait, à plus petite échelle, ce que fait Googlebot : il part d'une page, suit les liens qu'il trouve et note ce qu'il voit pour chaque URL. L'outil que nous utilisons dans la plupart des audits est Screaming Frog SEO Spider. Sa version gratuite explore jusqu'à 500 URL, ce qui suffit pour un petit site ou pour une section d'un grand. Une licence payante lève la limite. Notre guide Screaming Frog détaille la configuration.
Screaming Frog SEO Spider, le robot d'exploration de bureau qui liste chaque URL d'un site avec son code de statut et ses directives.
Lancez l'exploration depuis votre page d'accueil et depuis votre plan du site, puis comparez les deux listes. Chaque URL qui n'apparaît que dans l'une des deux est une question. Configurez le robot pour respecter robots.txt comme le fait Googlebot, et pour exécuter le JavaScript si votre site en dépend. Une exploration qui n'affiche pas vos pages manquera le contenu que voient les utilisateurs.
Codes de statut et chaînes de redirection
Filtrez d'abord les réponses 4xx et 5xx. Une erreur 404 n'est pas un problème en soi. Elle le devient lorsque des liens internes pointent encore vers elle, car ces liens envoient utilisateurs et robots vers une impasse. Repérez les liens internes qui mènent à des pages d'erreur et faites-les pointer vers une URL active. Examinez ensuite les chaînes de redirection : une ancienne URL redirige vers une deuxième, qui redirige vers une troisième. Chaque saut ajoute de la latence et dilue le signal. Aplatissez chaque chaîne pour que l'ancienne URL pointe directement vers la finale.
Vérifiez aussi le type de redirection. Une 302 temporaire utilisée pour un changement définitif doit devenir une 301. Notre guide 301 vs 302 donne la règle de décision.
Directives robots, noindex et canonicals
Trois réglages peuvent masquer une page sans que personne ne le remarque. Une règle disallow dans robots.txt bloque l'exploration. Une balise meta noindex, ou un en-tête HTTP X-Robots-Tag, bloque l'indexation. Une balise canonical pointant vers une autre URL indique aux moteurs quelle version conserver. Contrôlez chacun pour chaque type de page, car une règle ajoutée pour corriger une section bloque souvent une autre. Cas fréquent : une règle de préproduction jamais retirée du robots.txt en ligne.
Attention
Bloquer une page dans robots.txt n'est pas la même chose que la retirer des résultats. Si Google ne peut pas explorer la page, il ne peut pas lire une balise noindex qu'elle contient. Pour sortir une page de l'index, autorisez l'exploration et ajoutez noindex, puis attendez que Google la réexplore.
Pages orphelines et profondeur de clic
Une page orpheline n'a aucun lien interne qui pointe vers elle. Les robots ne la trouvent que par le plan du site ou par un lien externe, et les utilisateurs ne la trouvent presque jamais. Pour repérer les orphelines, comparez trois listes : les URL atteintes par l'exploration via les liens, les URL de votre plan du site, et les URL qui reçoivent des visites dans votre outil d'analyse. Une page présente dans le plan du site ou qui reçoit des visites, mais sans lien interne entrant, est une candidate orpheline.
Mesurez aussi la profondeur de clic, c'est-à-dire le nombre de clics depuis la page d'accueil. Une page importante enfouie à cinq ou six clics reçoit peu d'attention des robots et peu de liens internes. Reliez-la depuis une page pivot pertinente, et veillez à ce que le pivot lui-même soit peu profond.
Titres, descriptions et doublons
Filtrez les titres manquants, les titres en double, les méta-descriptions en double et les titres trop longs pour s'afficher en entier dans les résultats. Les doublons viennent presque toujours d'un modèle, pas d'un rédacteur. Un modèle de fiche produit qui affiche le même titre pour chaque variante crée des centaines de doublons, et corriger le modèle les corrige tous d'un coup. Considérez la balise titre comme une suggestion forte pour Google, pas comme une garantie. Google la réécrit parfois, ce qui est une raison de plus de la garder exacte et précise.
Les journaux serveur bouclent l'exploration. Ils montrent quelles URL Googlebot a demandées, à quelle fréquence, et quels codes de statut il a reçus. Si vous y avez accès, comparez ces requêtes avec votre plan du site. Les pages que Googlebot sollicite sans cesse sans apporter de valeur sont le signe d'un gaspillage d'exploration, expliqué dans notre fiche budget d'exploration.
Étape 2 : indexation, ce que Google conserve et pourquoi
Le rapport Pages de Search Console liste les URL que Google connaît et le statut attribué à chacune. Ouvrez-le, puis triez par motif, pas par nombre. Chaque motif appelle une correction différente. La documentation Search Console sur les statuts d'indexation de Google fait référence pour les libellés ci-dessous.
Statut dans le rapport
Ce que cela signifie
Que faire
Détectée, actuellement non indexée
Google a trouvé l'URL mais ne l'a pas encore explorée, et a reporté l'exploration car il estimait le site surchargé
Vérifier les temps de réponse du serveur et la profondeur de l'URL. S'assurer que des liens internes pointent vers elle
Explorée, actuellement non indexée
Google a exploré la page et a choisi de ne pas l'indexer. Google n'indexe pas toutes les pages du web
Vérifier d'abord la qualité : contenu mince, quasi-doublons, liens internes faibles. Utiliser l'inspection d'URL sur les pages importantes
Bloquée par robots.txt
Googlebot n'est pas autorisé à explorer l'URL
Confirmer que le blocage est voulu. Le retirer si la page doit être positionnée
Exclue par une balise noindex
La page porte une directive noindex
Retirer la directive si la page doit ressortir. La garder sur les pages qui doivent rester hors des résultats, comme les résultats de recherche interne
Règle pratique : lorsqu'un type de page entier présente une forte part de « explorée, actuellement non indexée », regardez d'abord le modèle avant les articles. Les modèles minces produisent des pages minces, et corriger un seul article ne changera pas le schéma. Notre guide du statut explorée, actuellement non indexée détaille les causes.
Pour les pages importantes, utilisez l'inspection d'URL une URL à la fois. Elle montre la date du dernier crawl, si la page est indexée, et la canonical retenue par Google. Lorsque la canonical choisie n'est pas celle que vous avez déclarée, la cause est presque toujours une duplication ou des signaux contradictoires, comme une canonical pointant vers une URL redirigée, ou des liens internes qui favorisent une version avec paramètres.
Étape 3 : données de recherche, là où se trouvent les opportunités
Le rapport Performances de Search Console est le jeu de données gratuit le plus utile pour un audit. Par défaut, il affiche les trois derniers mois, trop court pour dégager une tendance. Exportez au moins 90 jours de données de requêtes et de pages, et conservez le fichier avec sa date, pour pouvoir le comparer au prochain audit. Regroupez le tableau par page et par requête, et utilisez les filtres pays et appareil lorsque le site sert plusieurs marchés.
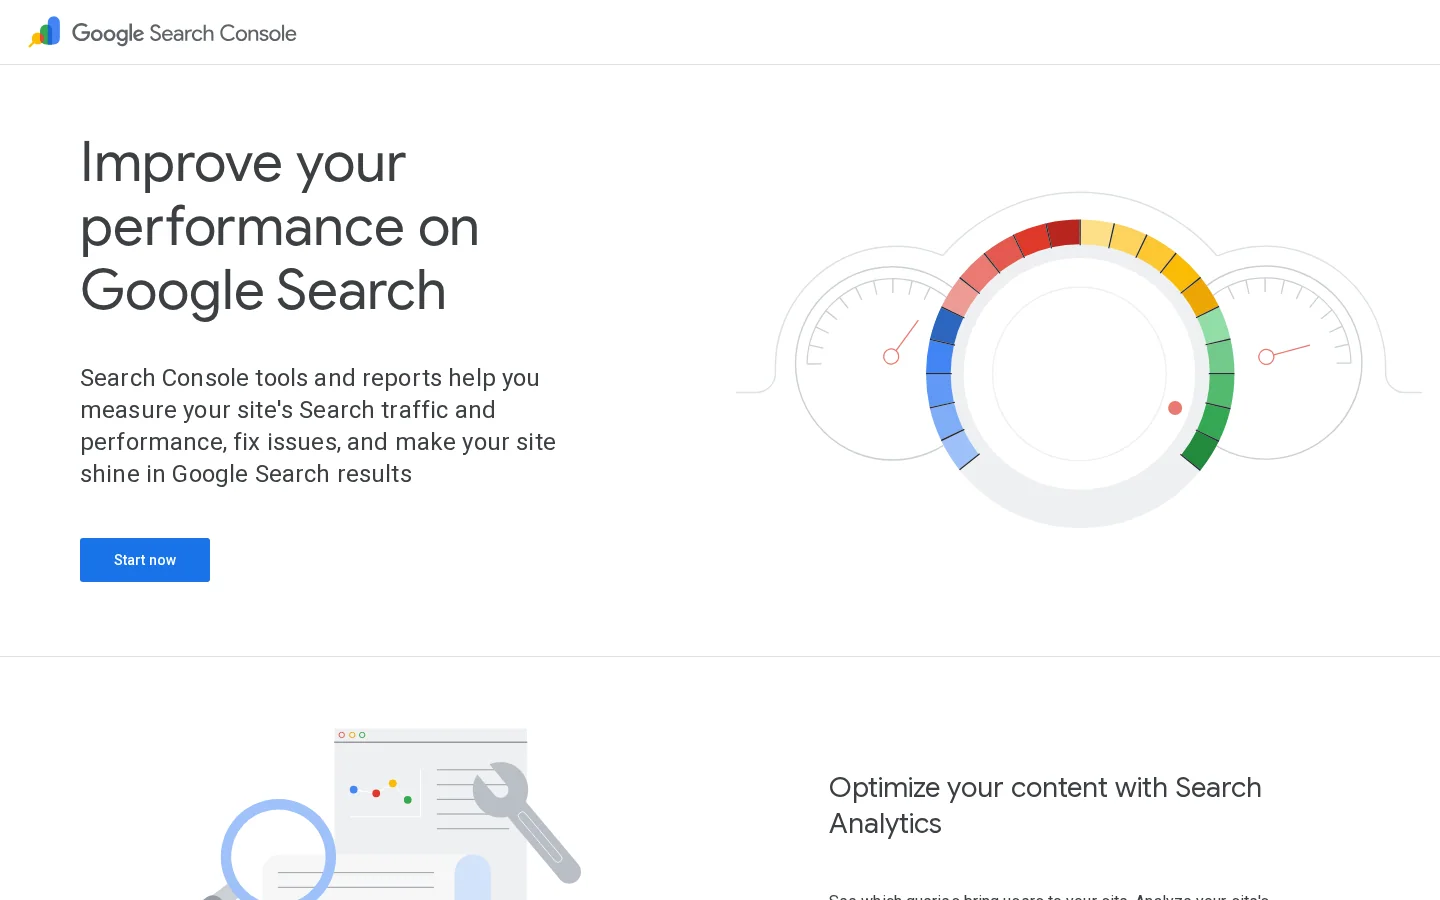
Google Search Console, la source des données de requêtes, de pages et d'indexation utilisées dans l'audit.
Quatre analyses font ressortir l'essentiel des opportunités dans ces données.
Distance de déclassement. Requêtes pour lesquelles votre page se classe entre les positions 8 et 20 avec de vraies impressions. Ces pages ont déjà de la pertinence. Elles ont souvent besoin d'un meilleur titre, d'un traitement plus approfondi de la requête, ou de quelques liens internes depuis des pages liées, plutôt que d'une réécriture.
Érosion. Pages dont les clics ont baissé entre deux périodes de même durée. Comparez les 90 derniers jours avec les 90 jours précédents. Regardez d'abord la page, puis les requêtes qu'elle a perdues, car une page peut garder sa position pendant qu'une nouvelle fonctionnalité capte ses clics.
Cannibalisation. Requêtes pour lesquelles deux URL ou plus de votre site apparaissent et se disputent les positions d'une semaine à l'autre. Choisissez une page cible pour la requête, puis fusionnez la page la plus faible dans celle-ci, ou rendez les deux pages clairement différentes par l'intention.
Écarts de CTR. Pages qui occupent une position normale mais obtiennent moins de clics que des pages comparables. Comparez le taux de clic à la moyenne de cette position, puis réécrivez le titre et la description des pages sous-performantes.
Pour isoler un type de page, ajoutez un filtre de page avec une expression régulière. Par exemple, pour ne voir que les pages du blog qui ciblent des requêtes de type tutoriel, saisissez ces deux valeurs :
Filtre de page (regex) :     /blog-geo-seo/.*
Filtre de requête (regex) :  comment|guide|checklist
Le taux de clic dépend fortement du haut de la page de résultats. Quelques chiffres publiés vous aident à juger si un écart est réel. Dans une étude sur les taux de clic de Google, le premier résultat organique recevait 27,6 % des clics, les trois premiers ensemble 54,4 %, et les résultats de la deuxième page 0,63 %.
Pourquoi la première position compte autant
27,6 %des clics vont au premier résultat organique
54,4 %des clics vont aux trois premiers résultats réunis
0,63 %des clics vont aux résultats de la deuxième page
Source : Backlinko, étude sur les taux de clic de Google (backlinko.com/google-ctr-stats)
Utilisez ces moyennes comme contrôle de cohérence, pas comme objectif. Elles mélangent toutes sortes de requêtes, et vos propres chiffres dépendent de l'intention de recherche, des requêtes de marque et des éléments affichés au-dessus de votre résultat, comme des vidéos, des images ou des réponses IA. Comparez chaque page aux pages de votre site qui se classent pour des requêtes proches.
Les seuils ci-dessous sont des points de départ que nous utilisons pour trier les données. Ce ne sont pas des règles de Google. Adaptez-les à la taille de votre site et au volume de vos requêtes.
Contrôle
Seuil de départ (notre règle empirique)
Pourquoi c'est important
Distance de déclassement
Position moyenne de 8 à 20, au moins 50 impressions sur 90 jours
La demande existe, et la page est assez proche pour progresser
Érosion
Clics en baisse de 30 % ou plus entre deux périodes égales
Assez de trafic perdu pour justifier un examen
Contenu mince
Moins de 300 mots de texte utile, hors navigation et éléments récurrents
Souvent insuffisant pour répondre à la requête. Une courte page d'outil peut rester pertinente, vérifiez donc l'intention
Liens internes
Moins de 3 liens internes entrants depuis des pages indexables
Signal faible d'importance, et signe fréquent d'une page orpheline
Les données Search Console offrent aussi un second contrôle : les requêtes pour lesquelles vous vous classez sans les avoir ciblées. Ce sont souvent les ajouts les plus faciles à une page existante, car leur pertinence est déjà prouvée par les impressions.
Étape 4 : Core Web Vitals et mobile
La documentation Google sur les Core Web Vitals définit trois mesures d'expérience utilisateur et leurs seuils. Une page est dans la plage « bonne » lorsque son Largest Contentful Paint est de 2,5 secondes ou moins, son Interaction to Next Paint de 200 millisecondes ou moins, et son Cumulative Layout Shift de 0,1 ou moins. L'INP est devenu un Core Web Vital stable en 2024, en remplacement du First Input Delay.
Métrique
Bonne lorsque
Ce qu'elle mesure
Correction habituelle
LCP
2,5 secondes ou moins
Vitesse de chargement du plus grand élément visible
Optimiser l'image principale, réduire le temps de réponse du serveur, précharger en priorité la police dont la page a besoin
INP
200 millisecondes ou moins
Rapidité de réaction de la page aux clics, aux appuis et aux touches pendant la visite
Découper les longues tâches JavaScript, retirer les scripts tiers lourds, éviter de bloquer le thread principal au chargement
CLS
0,1 ou moins
Quantité de contenu qui bouge pendant le chargement
Définir largeur et hauteur des images et intégrations, réserver l'espace des bannières et des publicités, éviter les éléments tardifs au-dessus de la ligne de flottaison
Lisez les données terrain avant les données de laboratoire. Les données terrain viennent d'utilisateurs réels de Chrome et disent si les visiteurs souffrent réellement. Les données de laboratoire viennent d'un test simulé et expliquent pourquoi une page est lente. PageSpeed Insights affiche les deux : les données terrain lorsque Google dispose d'assez de trafic pour l'URL, et les données de laboratoire pour chaque URL testée.
PageSpeed Insights, qui affiche les données terrain et les données de laboratoire de n'importe quelle URL.
Testez trois à cinq URL par modèle, pas seulement la page d'accueil. Un modèle de fiche produit, un modèle de catégorie et un modèle de blog peuvent avoir des scores très différents sur un même site, car ils chargent des scripts différents. Un bon score de laboratoire associé à un INP terrain médiocre est un résultat courant sur les sites chargés de gestionnaires de balises et de widgets de chat. Dans ce cas, le test de laboratoire n'est pas faux, mais il ne représente pas l'interaction que vivent les utilisateurs une fois la page chargée.
Sur mobile, vérifiez trois points. Le contenu principal de la version mobile doit correspondre à la version bureau, car Google utilise principalement la version mobile d'une page pour l'indexation. Les données structurées et les liens internes doivent être identiques sur les deux. Et aucun interstitiel intrusif ne doit masquer le contenu à l'arrivée. La vitesse compte pour le classement, mais la raison la plus utile de la corriger est que des modèles lents font fuir les visiteurs avant qu'ils ne lisent quoi que ce soit.
Étape 5 : contenu on-page et liens internes
Pour chaque page importante, vérifiez le titre, les intertitres, la profondeur de la réponse, les liens entrants et sortants, et l'existence d'un quasi-doublon. Faites-le sur un échantillon de pages de chaque modèle, puis sur les pages qui apparaissent dans les données de recherche en distance de déclassement ou en érosion.
Contrôle
Réussi quand
Échoué quand
Balise title
Nomme le sujet et la requête principale de la page, et reste unique sur le site
Duplique une autre page, ou se limite à une valeur par défaut du modèle comme le seul nom du site
H1
Un seul par page, qui énonce le sujet en termes simples
Absent, répété, ou remplacé par un logo ou une bannière
Premier écran
La question posée par la requête reçoit une réponse près du haut de la page
Le premier écran n'est que contexte et discours de marque, et la réponse arrive après plusieurs défilements
Profondeur
Couvre les sous-questions que les gens posent sur le sujet, avec des précisions
Mince, ou remplie de paragraphes répétés
Liens internes
Relié depuis les pages connexes, et mène à l'étape logique suivante
Orpheline, ou reliée uniquement depuis le pied de page ou le plan du site
Données structurées
Correspond au contenu que le visiteur voit sur la page
Balise un contenu absent de la page, ou utilise le mauvais type
Les liens internes sont le levier le moins coûteux de tout l'audit. Un lien depuis une page déjà bien classée, placé dans le corps du texte et utilisant les mots de la requête cible dans l'ancre, transmet à la fois le contexte et l'autorité. Les ancres génériques comme « cliquez ici » ou « lire la suite » transmettent très peu de sens. Commencez par les pages qui apportent le plus de trafic, car chaque nouveau lien depuis elles atteint une page qui a un vrai public.
Les contenus dupliqués et quasi-dupliqués méritent leur propre passage. Les filtres de catégorie, les paramètres de tri et les paramètres de suivi créent souvent de nombreuses URL qui affichent la même liste. Décidez quelle version doit exister, puis utilisez la balise canonical, les règles robots ou la gestion des paramètres adaptée. Ne laissez pas ce choix à Google, car le résultat ne vous plaira probablement pas.
Astuce
Pour une première passe rapide sur une seule page, l'outil gratuit d'audit SEO on-page lance les contrôles courants sur le titre, les intertitres, les liens et les balises meta, pour que vous consacriez votre temps aux constats qui demandent du jugement.
Étape 6 : autorité et liens
Le contrôle du profil de liens répond à trois questions : gagnez-vous des domaines référents à un rythme régulier, avez-vous perdu des liens importants, et existe-t-il des schémas qui semblent manipulés ? Exportez les domaines référents dans le temps depuis un outil de backlinks, puis cherchez les pics soudains, souvent issus d'une campagne payante ou de spam, et les baisses, souvent dues à des pages expirées ou à une migration. Notre guide de l'audit de backlinks détaille l'examen complet.
Soyez prudent avec l'outil de désaveu. La recommandation de Google est que la plupart des sites n'en ont pas besoin. Utilisez-le lorsque vous constatez un schéma clair de liens que vous n'avez pas mérités, associé à une action manuelle ou à un problème sérieux, et non parce qu'un outil de backlinks a donné une mauvaise note à certains domaines. Désavouer de bons liens par erreur coûte plus cher que de laisser quelques mauvais en place.
Étape 7 : visibilité dans les IA et robots d'IA
Deux contrôles font désormais partie de tout audit. Le premier concerne l'accès : les robots d'IA peuvent-ils atteindre vos pages ? Vérifiez les règles de robots.txt pour chaque robot qui vous importe. OpenAI utilise GPTBot et OAI-SearchBot, Anthropic utilise ClaudeBot et Perplexity utilise PerplexityBot, et ils ne servent pas tous le même objectif. Une règle unique pour tous est rarement la bonne décision. Notre guide des robots d'IA les liste avec leurs rôles.
L'exemple ci-dessus est une décision possible, pas une recommandation pour chaque site. Il laisse un robot lire vos pages pour les réponses de recherche, et en bloque un autre utilisé pour l'entraînement. Décidez robot par robot, consignez la décision par écrit, et vérifiez le fichier après chaque déploiement, car un robots.txt qui bloque tout apparaît souvent après une mise en production depuis la préproduction.
Le second contrôle concerne la visibilité : les moteurs de réponse vous citent-ils lorsqu'un acheteur pose la question que vous ciblez ? Établissez une liste de dix à vingt requêtes à partir des vraies questions de vos données de recherche et de vos échanges commerciaux. Lancez-les dans ChatGPT, Perplexity et Gemini, notez les marques et les URL citées, et répétez chaque requête plusieurs fois sur quelques jours, car les réponses changent d'une exécution à l'autre. La méthode d'audit de visibilité IA explique comment noter les résultats.
Méthodes d'audit : laquelle convient à votre situation
Les audits diffèrent par leur périmètre et par leur point de départ. Cinq méthodes sont courantes en pratique. Chacune convient à une situation différente, et la plupart des équipes en combinent deux.
1. L'audit technique complet
Principe : couvrir tout le site, chaque type de page et chaque source de données, puis classer les constats. À utiliser quand vous préparez une migration, après une forte chute de trafic, ou pour le premier audit d'un grand site. Avantage : il repère des problèmes structurels qu'aucune revue page par page ne voit, comme une navigation à facettes qui multiplie les URL. Limite : il est lent et produit beaucoup de constats qui demandent une seconde passe pour être ordonnés. Exemple : un distributeur avec 40000 URL de produits découvre qu'un seul paramètre de filtre crée l'essentiel de ses doublons, ce qu'aucune revue d'une fiche produit n'aurait révélé.
2. L'audit par les données
Principe : partir de ce qui a changé dans les données de recherche, puis diagnostiquer uniquement les pages et requêtes concernées. À utiliser quand vous faites une revue mensuelle, quand une mise à jour majeure vient d'être déployée, ou quand l'équipe est réduite. Avantage : le travail est priorisé par trafic dès la première minute. Limite : il est aveugle aux pages qui n'ont pas encore de données, comme les nouvelles sections ou les pages bloquées dès le départ. Exemple : un blog qui a perdu des clics sur cinq pages examine ces cinq pages, découvre que deux se cannibalisent, et les fusionne.
3. L'audit au niveau de la page
Principe : exécuter chaque contrôle sur une seule URL, puis décider si elle nécessite une réécriture. À utiliser quand une page stratégique sous-performe, ou avant une réécriture prévue. Avantage : rapide et concret, avec un avant et un après clairs. Limite : il ne peut pas montrer de schémas, donc un bug de modèle peut ressembler à un problème isolé. Exemple : une fiche produit au titre correct et au contenu solide a une canonical qui pointe vers une variante en rupture de stock.
4. L'audit d'écart avec les concurrents
Principe : comparer vos pages et sujets à ceux qui se classent au-dessus de vous pour les mêmes requêtes. À utiliser quand vous planifiez de nouveaux contenus ou de nouveaux liens. Avantage : il montre ce que le marché récompense en pratique, y compris la profondeur, le format et les sous-questions traitées. Limite : copier le leader peut vous mener vers un sujet saturé ou une mauvaise intention. Vérifiez ce que les premiers résultats ont réellement en commun avant de décider. Exemple : les cinq premiers résultats d'une requête répondent tous à une question de prix dès le premier écran, et le vôtre non.
5. L'audit de visibilité IA
Principe : vérifier si les robots d'IA peuvent lire vos pages, et si les moteurs de réponse vous citent pour les questions qui comptent. À utiliser quand vous voulez savoir si les outils d'IA recommandent votre marque. Avantage : il couvre un canal que les outils classiques de suivi de positions ne montrent pas. Limite : les réponses varient d'une exécution à l'autre, donc l'échantillon doit être répété avant de tirer des conclusions. Exemple : une société de logiciels est citée pour une fonctionnalité qu'elle ne vend plus, ce qui montre que ses pages de comparaison sont obsolètes.
Méthode
Point de départ
Idéale pour
Limite principale
Audit technique complet
L'exploration et toutes les sources de données
Migrations, grands sites, fortes chutes
Lent, et difficile à ordonner sans plan
Audit par les données
Évolutions des données de recherche
Revues mensuelles, petites équipes
Passe à côté des pages sans données
Audit au niveau de la page
Une URL
Une page qui sous-performe
Ne voit pas les schémas à l'échelle d'un modèle
Audit d'écart avec les concurrents
Les résultats au-dessus de vous
Nouveaux contenus et nouveaux liens
Risque de copier une mauvaise intention
Audit de visibilité IA
Accès des robots et moteurs de réponse
Savoir si l'IA vous recommande
Les réponses varient, les échantillons doivent être répétés
Audit rapide ou audit complet
Audit rapide
Données de recherche et principaux modèles uniquement
Se termine par une liste courte et classée
Passe à côté des problèmes structurels et d'exploration
Audit complet
Couvre chaque type de page et chaque modèle
Trouve les problèmes structurels et d'exploration
Lent, et facile à finir sans plan
Notre conseil : commencez par l'audit rapide, et ne passez à l'audit complet que lorsque le premier pointe vers une cause structurelle, ou lorsque vous êtes sur le point de modifier l'architecture du site.
Prioriser : des constats à un plan
Un audit de 400 constats sans ordre vaut moins qu'un audit de dix. Notez chaque constat selon deux critères : le trafic ou le chiffre d'affaires qu'il met en jeu, et la difficulté de la correction. Commencez par les éléments à fort impact et faible effort. Passez ensuite aux éléments à fort impact qui demandent plus de travail mais débloquent un modèle entier, car une seule correction à cet endroit change des milliers de pages.
Constat
Trafic en jeu
Effort
Priorité
Un modèle de page renvoie vers des pages 404 depuis chaque page
Élevé
Faible
À faire en premier
Pages stratégiques avec des titres en double
Élevé
Faible
À faire en premier
LCP lent sur le modèle de catégorie
Élevé
Moyen
À planifier dans le prochain sprint
Articles de blog en érosion
Moyen
Moyen
À rafraîchir par ordre de clics perdus
Pages de glossaire orphelines
Faible
Faible
À regrouper avec le travail de maillage interne
Pages d'archives de balises au contenu mince
Faible
Moyen
Vérifier l'intention, puis noindex ou regrouper
Attribuez à chaque élément un responsable, une date et la métrique que vous espérez faire bouger. Un constat sans responsable reste une note, et les notes ne changent pas les classements. Mesurez à nouveau après que Google a réexploré les pages concernées, ce qui peut prendre plusieurs semaines, et comparez avec le point de départ sauvegardé au début. Lorsque vous présentez les résultats, le modèle de rapport d'audit SEO offre une structure que managers et clients peuvent lire en dix minutes.
Si vous voulez réunir le trafic Google et le trafic IA au même endroit pendant le suivi de ces corrections, le tableau de bord GEO / SEO de Sorank les affiche côte à côte.
Un audit SEO en 90 minutes : ce que vous pouvez finir en une session
Un audit SEO de 90 minutes contrôle les pages qui apportent le plus de trafic de recherche, dans un ordre qui fait remonter en premier les pertes réelles. Utilisez-le lorsque vous disposez d'une seule session et avez besoin d'une liste classée de corrections, et non d'une revue de chaque URL. Limitez le travail à vos pages principales et à une URL d'exemple par modèle : le résultat est exploitable le jour même.
Découpez la session en blocs fixes, et arrêtez chaque bloc lorsque son temps est écoulé. La limite de temps fait partie de la méthode, car elle vous oblige à choisir.
Minutes
Tâche
Résultat
0 à 10
Exporter 90 jours de données de requêtes et de pages depuis Search Console, et lister les 20 pages principales par clics
Une base de référence enregistrée et une liste de pages
10 à 25
Appliquer à cette liste les contrôles de distance de déclassement et d'érosion de l'étape 3
Pages qui ont perdu des clics ou se situent entre les positions 8 et 20
25 à 40
Explorer une URL d'exemple par modèle et vérifier le code de statut, la canonical et les directives robots
Erreurs, mauvaises canonicals et blocages, par modèle
40 à 55
Ouvrir le rapport Pages de Search Console et trier les motifs par nombre
Le statut qui touche le plus de pages
55 à 70
Lancer PageSpeed Insights sur une URL par modèle, en lisant d'abord les données terrain
Le modèle dont le LCP ou l'INP terrain est le plus faible
70 à 90
Rédiger les dix principaux constats avec le trafic en jeu, l'effort et un responsable
Un plan classé à envoyer le jour même
Chaque ligne répond à une question, vous pouvez donc en sauter une sans perdre les autres. Si le rapport d'indexation ne montre rien d'inhabituel, consacrez ce temps aux données de recherche, qui mènent généralement plus vite à une correction.
Ce qu'un audit de 90 minutes ne peut pas voir
Une limite de temps masque trois choses. Elle manque les problèmes structurels, comme un filtre qui multiplie les URL, parce que vous ne lisez que des échantillons. Elle n'utilise pas les journaux serveur, donc vous ne pouvez pas voir à quelle fréquence les robots demandent une page. Et elle laisse de côté le profil de liens, qui exige un export complet depuis un outil de backlinks. Notez-les comme questions ouvertes pour un audit de backlinks ultérieur ou une revue complète, afin que l'audit court ne paraisse pas plus complet qu'il ne l'est.
Les erreurs qui gâchent une session courte
L'erreur la plus fréquente consiste à commencer par le robot d'exploration. L'exploration d'un grand site peut prendre plus de temps que toute la session et renvoyer plus d'avertissements que personne ne peut lire. Partez plutôt des données de recherche, et ouvrez le robot seulement pour les pages qui ont des clics ou des impressions. Corrigez d'abord les avertissements de ces pages, car les avertissements sur des pages que personne ne visite ne changent pas votre trafic.
Astuce
Planifiez la session dans votre agenda avec un minuteur et un seul fichier de sortie. Utilisez dès le départ les colonnes du modèle de rapport d'audit SEO, pour que la liste soit prête à être partagée à la minute 90.
Erreurs courantes, et comment les repérer et les corriger
La plupart des audits contiennent les mêmes erreurs. Elles sont faciles à éviter une fois que vous en connaissez les signes.
Auditer sans périmètre
Ce que c'est : l'audit couvre tout, donc rien n'est terminé. Comment la repérer : le rapport compte des centaines de problèmes, aucun avec un chiffre de trafic ni un responsable. Comment la corriger : recommencez avec le brief ciblé de la première section, limitez l'exploration aux types de pages qui comptent, et triez les constats par trafic avant d'écrire quoi que ce soit d'autre.
Traiter les avertissements comme des classements
Ce que c'est : l'équipe corrige les avertissements affichés en rouge par l'outil, même lorsqu'ils touchent des pages que personne ne visite. Comment la repérer : le nombre d'avertissements baisse pendant que les clics sur les pages stratégiques continuent de chuter. Comment la corriger : croisez l'exploration avec les données de recherche, et corrigez d'abord les problèmes sur les pages qui ont du trafic, des impressions ou des liens.
Croire qu'une seule exploration dit toute la vérité
Ce que c'est : le robot ne signale aucune erreur, donc l'équipe conclut que le site est sain. Comment la repérer : Search Console signale de nombreuses URL « explorée, actuellement non indexée » ou « détectée » que le robot n'a jamais remontées. Comment la corriger : comparez l'exploration avec le plan du site, le rapport d'indexation et les journaux serveur. Un robot ne voit que ce qu'il peut atteindre par les liens et le rendu, donc le contenu derrière une connexion, des scripts ou des filtres à facettes peut manquer dans sa liste.
Corriger des pages au lieu des modèles
Ce que c'est : l'équipe modifie le même titre, la même image ou la même canonical sur des centaines de pages, une à une. Comment la repérer : le même constat apparaît sur la plupart des URL d'un type de page. Comment la corriger : corrigez le modèle une fois, puis vérifiez un échantillon de pages pour confirmer que le changement a fonctionné partout. Une seule modification de modèle corrige tout le groupe.
Bloquer une page pour la retirer des résultats
Ce que c'est : l'équipe ajoute une règle disallow dans robots.txt à une page qu'elle veut voir sortir de Google. Comment la repérer : la page reste dans l'index avec une URL nue et sans extrait, et le rapport la signale comme bloquée. Comment la corriger : autorisez l'exploration, ajoutez une directive noindex, et attendez que Google réexplore la page. Une fois sortie de l'index, vous pouvez la bloquer si nécessaire, mais vous n'en avez pas besoin.
Exemple (illustratif)
Imaginez un site qui a retiré un ensemble de pages de campagne et les a bloquées dans robots.txt. Les pages continuent d'apparaître dans les résultats avec une URL nue et sans description, parce que d'autres sites pointent encore vers elles. Retirer le blocage et ajouter noindex permet à Google d'explorer les pages, de lire la directive et de les sortir de l'index.
Viser un score de laboratoire parfait
Ce que c'est : l'équipe optimise pour un score de 100 en test de laboratoire et ignore les données terrain. Comment la repérer : le score de laboratoire est élevé, mais l'INP terrain du même modèle est médiocre dans le rapport Core Web Vitals de Search Console. Comment la corriger : profilez les interactions que font réellement les utilisateurs, généralement après le chargement de la page. Recherchez les longues tâches déclenchées par des scripts, plutôt que le temps de chargement du premier affichage.
À quelle fréquence auditer
Lancez un audit rapide chaque mois sur les données de recherche et sur vos modèles les plus importants. Lancez un audit complet après une migration, une refonte, un changement de CMS ou une chute soudaine du trafic, et faites une revue complète par an pour détecter la dérive structurelle. Les données de recherche doivent être suivies en continu, car une baisse de clics est plus utile comme alerte que comme rappel calendaire.
Audit de site : un contrôle de santé reproductible pour tout le domaine
Un audit de site est une exploration de chaque URL accessible d'un même domaine, présentée par type de problème et par gravité. Il montre ce qui ne fonctionne pas sur l'ensemble du site, y compris les schémas qu'une revue page par page laisse passer. Il ne dit pas quelle correction fera bouger les positions : associez-le donc aux données de recherche.
Définir le périmètre de l'exploration avant de commencer
Les filtres, les options de tri et les paramètres de suivi peuvent créer bien plus d'URL que vous n'avez de pages, et la plupart affichent la même liste. Excluez ces paramètres ainsi que les fichiers médias, et explorez chaque sous-domaine comme un projet distinct. Limitez le rythme des requêtes pour que le serveur reste rapide pour les vrais visiteurs. Gardez la pagination (page=) dans le périmètre, car les listes paginées peuvent contenir des pages que vous voulez voir indexées.
La plupart des robots d'exploration acceptent des règles d'exclusion écrites sous forme d'expressions régulières comme celles-ci. Testez-les sur une petite exploration, et vérifiez que le nombre d'URL ne baisse que pour les paramètres que vous vouliez exclure.
Lire la gravité avant le score
Chaque outil regroupe les problèmes par niveaux et calcule son propre score de santé. Les libellés changent d'un outil à l'autre, mais la logique de tri reste la même. Un score est une courbe de tendance pour un outil aux réglages fixes, pas une note que Google applique. Parcourez les niveaux dans cet ordre :
Niveau
Problèmes typiques
Première action
Erreurs sur les pages indexables
Réponses 4xx ou 5xx sur les URL que vous voulez positionner, liens internes cassés
Corriger en premier, en commençant par les pages qui gagnent déjà des clics
Erreurs sur les pages que vous ne voulez pas indexer
Recherche interne défaillante, URL de filtres ou de campagnes retirées
Supprimer les liens internes qui pointent encore vers elles
Avertissements
Balises title trop longues, descriptions manquantes, intertitres en double
Corriger par lots, idéalement avec une seule modification de template
Notices
Pistes d'optimisation mineures
Examiner une fois, n'agir que si elles se répètent sur des pages stratégiques
Comparer deux explorations, pas deux scores
Le résultat le plus utile d'un audit de site est la différence entre deux passages. Exportez la liste des problèmes du dernier passage, relancez l'exploration avec les mêmes réglages, puis comparez les volumes par type de problème et par URL. Les nouveaux problèmes passent en premier, car une nouvelle erreur sur une page en ligne suit généralement une mise en production récente. Rapprochez chaque nouveau groupe de votre journal des modifications avant d'attribuer un responsable.
Prenons un exemple : le premier passage signale 42 erreurs. Le second, quatre semaines plus tard, en signale 57, dont 15 se trouvent sur un modèle de page tarifaire mis en ligne cette semaine-là. Vous corrigez le modèle une seule fois. Si le compte redescend vers 42, la correction a fonctionné, et ce passage devient la référence du suivant.
Garder la routine assez courte pour la répéter
Un audit de site qui prend une journée entière ne sera jamais refait. Enregistrez le périmètre, les règles d'exclusion et le tableau de gravité dans une seule configuration, pour que le passage suivant ne prenne que quelques minutes. Planifiez l'exploration et exportez à chaque fois les mêmes trois fichiers : la liste des problèmes, les URL indexables et les URL qui reçoivent des clics. Notre guide des rapports SEO automatisés explique quoi automatiser et comment le mettre en place.
Si vous hésitez encore sur le robot d'exploration à choisir, notre comparatif des outils de SEO technique classe les options selon la tâche qu'elles remplissent. Un audit de site ne mérite d'être planifié que si quelqu'un lit la différence entre deux passages. Sinon, ce n'est qu'un export de plus dans un dossier.
Par où commencer cette semaine
Si vous n'avez jamais fait d'audit, faites quatre choses dans l'ordre. Exportez 90 jours de données Search Console et enregistrez-les avec la date. Explorez vos principaux modèles avec un robot, en commençant par la version gratuite de 500 URL si votre site est petit. Lisez le rapport d'indexation et triez les motifs. Corrigez ensuite les trois plus gros problèmes de modèle que vous avez trouvés, et mesurez à nouveau après le prochain cycle de réexploration.
Exporter les données de requêtes et de pages, et enregistrer le point de départ.
Explorer une URL d'exemple par modèle, et noter les codes de statut, les titres, les canonicals et les directives robots.
Lire le rapport d'indexation, et transformer chaque statut en question avec un responsable.
Corriger les trois plus gros problèmes de modèle, puis comparer les données de recherche après le prochain cycle de réexploration.
Un bon audit ne se termine pas par un document. Il se termine par une courte liste de corrections que quelqu'un réalise ce mois-ci, et par un point de départ qui prouve si elles ont fonctionné.
Questions fréquentes
Combien de temps dure un audit SEO ?
Cela dépend de la taille du site et de la profondeur voulue. Un audit ciblé de vos principaux modèles et de vos données de recherche se fait en quelques jours. Un audit complet d'un grand site avec de nombreux modèles prend plus de temps, et l'essentiel de ce temps va au diagnostic et à la priorisation plutôt qu'à l'exploration elle-même.
De quels outils ai-je besoin pour un audit SEO ?
Au minimum, Google Search Console et un robot d'exploration comme Screaming Frog SEO Spider, plus PageSpeed Insights pour la vitesse. Les outils d'analyse et les journaux serveur apportent un contexte utile. Les suites SEO payantes aident pour les backlinks et les données concurrentielles, mais elles ne sont pas nécessaires pour un premier audit.
Quelle différence entre un audit SEO et une checklist SEO ?
Une checklist liste les contrôles à effectuer. Un audit exécute ces contrôles sur votre site, décide quels constats comptent, et classe les corrections selon le trafic qu'elles mettent en jeu. Utilisez une checklist pour construire l'audit, et l'audit pour choisir le travail à faire.
y!
Recevez gratuitement votre plan de contenu pour 30 jours
Nous analysons vos concurrents, votre site et votre visibilité dans les IA pour créer gratuitement un plan de contenu sur mesure.
“J'ai testé Sorank sur un vrai site client et c'est dingue. Il fait tout ce qu'une agence facture 1'500€ par mois. Là, ça part en production sur ce client.”Guillaume Guersanguersanguillaume.com
“Nous sommes une agence Ads et nous voulions remettre notre SEO sur les rails une bonne fois pour toutes. Sorank nous a donné une vue claire de notre site, nous a aidés à prioriser les optimisations et à structurer correctement notre contenu. L'outil est facile à utiliser, bien pensé pour une équipe et très pratique pour centraliser le suivi sans avoir à jongler entre plusieurs plateformes. Une base très solide pour repartir à zéro avec notre SEO.”Gaspard MadouiAgence Publicitaire
Dominiqueflight-sensations-idf.comLoisirs et aviation
“J'ai simplement laissé le logiciel Sorank faire son travail, et aujourd'hui mon DR est de 25 et ma page se positionne mieux.”Lucas Flandrefoundertrace.fr
“Je me suis spécialisée en GEO grâce à Sorank. Le GEO Leaderboard me permet de montrer à mes clients leur positionnement vs leurs concurrents sur ChatGPT. C'est un vrai différenciateur commercial.”MélanieSEO indépendant
“Excellent service, fonctionne bien pour notre site web et nous aide à comprendre comment l'améliorer pour mieux nous positionner sur Google et ailleurs. Félicitations, continuez, je vous le recommande.”Hugo T.Marchand en ligne


 Search Console