A privacidade é importante para nós, então você tem a opção de desativar certos tipos de armazenamento que podem não ser necessários para o funcionamento básico do site. O bloqueio de categorias pode afetar sua experiência no site. Mais informações (Política de cookies)
Como fazer uma auditoria de SEO: um método passo a passo que encontra o que custa tráfego
Uma auditoria de SEO completa, em ordem: rastreamento, indexação, dados do Search Console, Core Web Vitals e IA, com as correções que fazem o tráfego se mover.
Um caderno com uma checklist de auditoria de SEO e gráficos impressos sobre uma mesa.
Ferramentas
Nesta página
Em resumo
Uma auditoria de SEO é uma verificação estruturada de tudo o que impede suas páginas de serem rastreadas, indexadas, compreendidas, clicadas e citadas. Faça-a em uma ordem fixa: rastreamento, indexação, dados de busca, velocidade, conteúdo on-page, links e, por último, visibilidade nas IAs. Avalie cada achado pelo tráfego que ele bloqueia e transforme os dez mais importantes em tarefas com data e responsável. Uma auditoria focada pode ser feita em poucos dias. Uma auditoria completa de um site grande leva mais tempo, e o resultado dela deve ser um plano, não uma lista.
3 dias grátis, depois você para quando quiser. Garantia de resultados de 90 dias, sujeita a condições.
O que é uma auditoria de SEO, e o que ela não é
Uma auditoria de SEO responde a uma pergunta: quais problemas técnicos, de conteúdo e de autoridade estão custando visitas agora, e em que ordem você deve corrigi-los? Ela não é uma lista de todas as boas práticas que existem. Uma checklist de 40 pontos mostra o que observar. Uma auditoria mostra o que está errado no seu site, quanto isso importa e o que fazer primeiro.
Três coisas se confundem com frequência: a auditoria (o diagnóstico), a checklist (a lista de verificações) e o relatório (o que você entrega a um cliente ou a um gestor). Nosso modelo de relatório de auditoria de SEO trata do relatório, e a checklist de SEO técnico cobre as verificações. Este artigo trata do método que conecta as duas coisas e dos dados necessários para decidir o que importa.
Duas formas de pedir a mesma auditoria
Pedido vago
Verificar o site em busca de problemas de SEO
Resultado: uma lista longa de alertas que ninguém lê
Pedido objetivo
Encontrar as páginas que perderam cliques nos últimos 90 dias
Resultado: dez correções ordenadas pelo tráfego em risco
A diferença não está no esforço. Está na pergunta. Um pedido objetivo nomeia as páginas, o período e a decisão, para que cada verificação tenha um motivo para existir.
Antes de começar: acessos, escopo e uma linha de base
A maioria das auditorias dá errado antes do primeiro rastreamento, porque ninguém combinou o escopo nem salvou um ponto de partida. Resolva três coisas antes de abrir qualquer ferramenta.
Escopo. Quais domínios e subdomínios, quais países e idiomas, e quais tipos de página importam. Em um e-commerce, isso significa home, categorias, páginas de produto, blog e eventuais landing pages. Anote tudo.
Acessos. Acesso de proprietário ao Search Console para cada propriedade (versões http, https, www e sem www, se existirem), acesso de leitura à sua ferramenta de analytics e acesso ao CMS ou aos logs do servidor, se você tiver. Os logs do servidor mostram o que os rastreadores realmente pedem, algo que nenhuma simulação de rastreamento consegue mostrar.
Linha de base. Um retrato dos cliques, impressões, posição média e das páginas que trazem mais cliques, salvo em uma planilha com a data. Sem ele, você não consegue provar que uma correção funcionou.
Antes de rastrear qualquer coisa
Confirmar o acesso de proprietário ao Search Console para cada propriedade
Exportar 90 dias de dados de consultas e páginas e salvá-los com a data de hoje
Listar os principais tipos de página e uma URL de exemplo para cada um
Escrever o objetivo em uma frase: mais cliques nas páginas que geram receita, menos erros, modelos mais rápidos
Escolher o rastreador e seus limites (veja a seção sobre rastreamento abaixo)
Uma auditoria examina toda a estrutura de um site antes de corrigir qualquer página isolada.
O método, em ordem: sete etapas
A ordem importa. O rastreamento diz o que existe no seu site. A indexação diz o que o Google mantém. Os dados de busca dizem o que as pessoas encontram e clicam. Velocidade, conteúdo e links explicam, então, por que uma página tem desempenho fraco. Se você fizer o contrário, vai passar horas reescrevendo uma página que o Google nem consegue indexar.
As sete etapas de uma auditoria de SEO
Rastrear o siteListar cada URL com seu código de status, title, canonical, diretivas de robots e links internos.
Verificar a indexaçãoComparar o que você publica com o que o Google indexa, e ler o motivo de cada exclusão.
Ler os dados de buscaEncontrar as páginas e consultas que ganham ou perdem cliques, e as que estão perto do topo da primeira página.
Testar velocidade e mobileMedir os Core Web Vitals em cada modelo de página, começando pelos dados de campo de usuários reais.
Revisar o conteúdo on-pageVerificar titles, títulos, profundidade, duplicação e links internos, página a página e modelo a modelo.
Avaliar autoridade e linksAnalisar os domínios que linkam ao longo do tempo, os links perdidos, os textos de âncora e os sinais de spam.
Verificar a visibilidade nas IAsConfirmar que os rastreadores de IA alcançam suas páginas, e testar se os mecanismos de resposta citam você.
Verificações de SEO antes da auditoria: o que confirmar antes de confiar nos dados
As verificações de SEO antes da auditoria confirmam que o site que você vai auditar é o que o Google e os seus visitantes veem, e que os dados são confiáveis o bastante para agir. Dedique cerca de uma hora a essas verificações antes de qualquer rastreamento. Uma propriedade errada, uma regra de homologação ainda ativa ou um rastreamento quebrado podem tornar incorretos todos os achados seguintes, e um rastreamento não revelará nada disso.
Confirmar qual versão do site está no ar
Solicite cada variação do seu domínio: http, https, com e sem www, com e sem barra final. Cada variação deve chegar ao mesmo endereço final, idealmente após um único redirecionamento. Duas versões no ar dividem links e sinais entre elas, e um rastreador vai reportar as duas como saudáveis.
Leia o cabeçalho Location de cada resposta. Ele deve apontar direto para o seu endereço preferido, não para um segundo redirecionamento. Repita a verificação na home e em uma página profunda, porque as regras de redirecionamento costumam variar entre modelos.
Verificar se nenhuma configuração de teste chegou ao site publicado
As configurações de homologação são uma das causas mais comuns de queda repentina. Verifique o robots.txt publicado, a meta tag robots e o cabeçalho X-Robots-Tag na home e em um artigo. Uma regra disallow para o site inteiro, ou um noindex deixado por uma versão de teste, pode ocultar seções da busca enquanto as páginas continuam carregando para os visitantes. Se encontrar algum deles, corrija antes de auditar essas seções, porque todos os achados seguintes descreveriam um site que o Google não consegue ver.
Manter um registro de mudanças antes de diagnosticar uma queda
Escreva uma lista datada de cada publicação, redesenho, atualização do CMS, migração e alteração de robots.txt ou de noindex dos últimos seis meses. Depois compare essas datas com o início de qualquer mudança de tráfego. Uma queda que começa no dia da publicação de um modelo aponta para esse modelo. Uma queda sem nenhuma mudança por perto pode vir de uma atualização da busca e precisa de outra verificação. Sem o registro, você acusa o que olhou por último. Para as mudanças que envolvem URLs, a checklist de migração de SEO lista o que registrar.
Verificar os dados em que a auditoria vai se basear
Compare os cliques do Search Console com as sessões orgânicas da sua ferramenta de analytics nos mesmos 90 dias. As duas linhas não precisam coincidir, mas devem se mover na mesma direção. Se divergirem, verifique as tags nas páginas-chave, o banner de consentimento e o filtro de bots antes de diagnosticar o site. A comparação das duas ferramentas explica o que cada uma mede.
Etapa 1: rastrear o site e corrigir o que o rastreador encontra
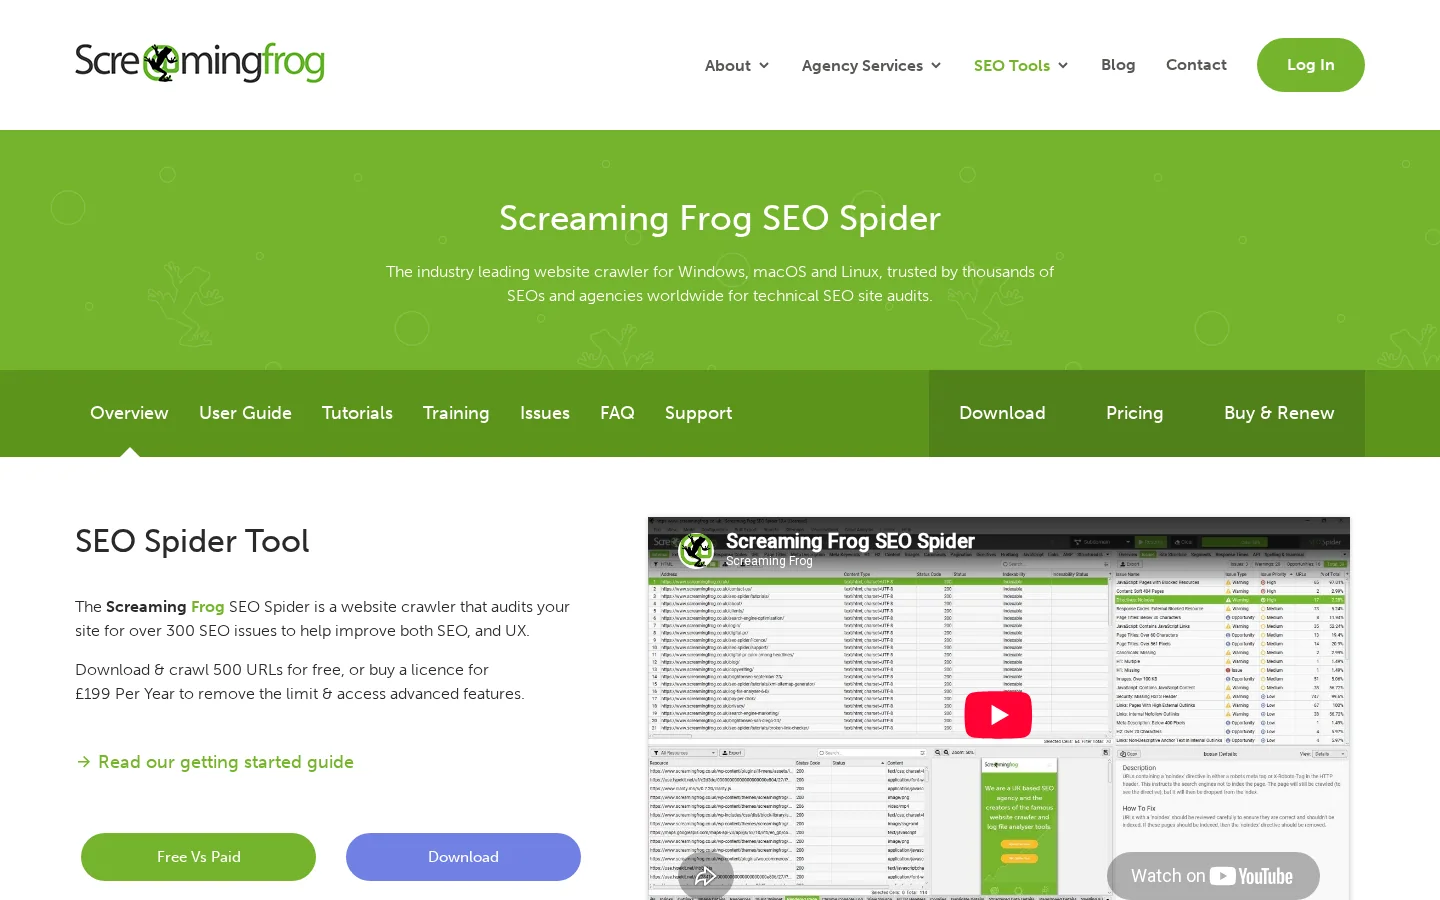
Um rastreador faz, em menor escala, o que o Googlebot faz: parte de uma página, segue os links que encontra e registra o que vê de cada URL. A ferramenta que usamos na maioria das auditorias é o Screaming Frog SEO Spider. A versão gratuita rastreia até 500 URLs, o suficiente para um site pequeno ou para uma seção de um site grande. Uma licença paga remove o limite. Nosso guia do Screaming Frog mostra a configuração passo a passo.
Screaming Frog SEO Spider, o rastreador para desktop que lista cada URL de um site com seu código de status e suas diretivas.
Comece o rastreamento pela home e pelo seu sitemap, depois compare as duas listas. Toda URL que aparece em uma e não na outra é uma pergunta. Configure o rastreador para respeitar o robots.txt do jeito que o Googlebot faz, e para renderizar JavaScript se o seu site depender dele. Um rastreamento que não renderiza suas páginas vai perder conteúdo que os usuários veem.
Códigos de status e cadeias de redirecionamento
Filtre primeiro as respostas 4xx e 5xx. Um 404 não é um problema por si só. Ele se torna um problema quando links internos ainda apontam para ele, porque esses links levam usuários e rastreadores a um beco sem saída. Encontre os links internos que levam a páginas de erro e aponte-os para uma URL ativa. Depois, veja as cadeias de redirecionamento: uma URL antiga redireciona para uma segunda, que redireciona para uma terceira. Cada salto soma latência e dilui o sinal. Achate cada cadeia para que a URL antiga aponte diretamente para a final.
Verifique também o tipo de redirecionamento. Um 302 temporário usado para uma mudança definitiva deveria ser um 301. Nosso guia 301 vs 302 explica a regra de decisão.
Diretivas de robots, noindex e canonicals
Três configurações podem ocultar uma página sem que ninguém perceba. Uma regra disallow no robots.txt interrompe o rastreamento. Uma meta tag noindex, ou um cabeçalho HTTP X-Robots-Tag, interrompe a indexação. Uma tag canonical apontando para outra URL indica aos buscadores qual versão manter. Verifique cada uma para cada tipo de página, porque uma regra criada para corrigir uma seção costuma bloquear outra. Um caso comum: uma regra de homologação que nunca foi removida do robots.txt do ambiente publicado.
Atenção
Bloquear uma página no robots.txt não é o mesmo que removê-la da busca. Se o Google não consegue rastrear a página, ele não consegue ler uma tag noindex que ela contenha. Para tirar uma página do índice, libere o rastreamento, adicione noindex e espere o Google rastreá-la novamente.
Páginas órfãs e profundidade de clique
Uma página órfã não tem nenhum link interno apontando para ela. Os rastreadores só a encontram pelo sitemap ou por um link externo, e os usuários quase nunca chegam até ela. Para identificar órfãs, compare três listas: as URLs que o rastreador alcançou por links, as URLs do sitemap e as URLs que recebem visitas no seu analytics. Uma página que está no sitemap ou recebe visitas, mas não tem links internos de entrada, é uma candidata a órfã.
Meça também a profundidade de clique, isto é, o número de cliques a partir da home. Uma página importante enterrada a cinco ou seis cliques recebe pouca atenção dos rastreadores e poucos links internos. Linke-a a partir de uma página de hub relevante, e garanta que o próprio hub seja raso.
Titles, descrições e duplicatas
Filtre titles ausentes, titles duplicados, meta descrições duplicadas e titles longos demais para aparecer por completo nos resultados. As duplicatas quase sempre vêm de um modelo, não de um redator. Um modelo de página de produto que gera o mesmo title para cada variação cria centenas de duplicatas, e corrigir o modelo resolve todas de uma vez. Trate a tag title como uma sugestão forte para o Google, não como uma garantia. Às vezes o Google a reescreve, o que é mais um motivo para mantê-la precisa e específica.
Os logs do servidor fecham o ciclo do rastreamento. Eles mostram quais URLs o Googlebot pediu, com que frequência e quais códigos de status recebeu. Se você tiver acesso, compare essas requisições com o sitemap. Páginas que o Googlebot visita o tempo todo sem trazer valor são sinal de desperdício de orçamento de rastreamento, explicado no nosso verbete sobre orçamento de rastreamento.
Etapa 2: indexação, o que o Google mantém e por quê
O relatório de Indexação de páginas do Search Console lista as URLs que o Google conhece e o status que atribui a cada uma. Abra-o e ordene pelo motivo, não pela quantidade. Cada motivo aponta para uma correção diferente. A ajuda do Search Console sobre os status de indexação do Google é a referência para os rótulos da tabela abaixo.
Status no relatório
O que significa
O que fazer
Descoberta, atualmente não indexada
O Google encontrou a URL, mas ainda não a rastreou, e adiou o rastreamento porque achou que o site estava sobrecarregado
Verificar os tempos de resposta do servidor e a profundidade da URL. Garantir que existam links internos apontando para ela
Rastreada, atualmente não indexada
O Google rastreou a página e decidiu não indexá-la. O Google não indexa todas as páginas da web
Verificar primeiro a qualidade: conteúdo fino, quase duplicados, links internos fracos. Usar a inspeção de URL nas páginas importantes
Bloqueada pelo robots.txt
O Googlebot não tem permissão para rastrear a URL
Confirmar que o bloqueio é intencional. Removê-lo se a página deve ranquear
Excluída pela tag noindex
A página tem uma diretiva noindex
Remover a diretiva se a página deve ranquear. Mantê-la em páginas que devem ficar fora, como resultados de busca interna
Uma regra prática: quando um tipo de página inteiro apresenta uma proporção alta de «rastreada, atualmente não indexada», olhe primeiro o modelo antes dos artigos. Modelos finos produzem páginas finas, e corrigir um único artigo não muda o padrão. Nosso guia sobre o status rastreada, atualmente não indexada detalha as causas.
Nas páginas que importam, use a inspeção de URL uma por vez. Ela mostra a data do último rastreamento, se a página está indexada e a canonical escolhida pelo Google. Quando a canonical escolhida não é a que você declarou, a causa quase sempre é duplicação ou sinais conflitantes, como uma canonical apontando para uma URL redirecionada, ou links internos que favorecem uma versão com parâmetros.
Etapa 3: dados de busca, onde estão as oportunidades
O relatório de Desempenho do Search Console é o conjunto de dados gratuito mais útil para uma auditoria. Por padrão, ele mostra os últimos três meses, um período curto demais para ver uma tendência. Exporte pelo menos 90 dias de dados de consultas e páginas, e guarde o arquivo com a data para comparar na próxima auditoria. Agrupe a tabela por página e por consulta, e use os filtros de país e dispositivo quando o site atender mais de um mercado.
Google Search Console, a fonte dos dados de consultas, páginas e indexação usados na auditoria.
Quatro análises encontram a maior parte das oportunidades nesses dados.
Distância da primeira página. Consultas em que sua página se posiciona entre a 8ª e a 20ª posição com impressões reais. Essas páginas já têm relevância. Muitas vezes precisam de um title melhor, de mais profundidade na consulta ou de alguns links internos de páginas relacionadas, não de uma reescrita.
Queda. Páginas cujos cliques caíram entre dois períodos de mesma duração. Compare os últimos 90 dias com os 90 anteriores. Olhe primeiro a página e depois as consultas que ela perdeu, porque uma página pode manter a posição enquanto um novo recurso da busca tira seus cliques.
Canibalização. Consultas em que duas ou mais das suas URLs aparecem e trocam de posição de uma semana para outra. Escolha uma página-alvo para a consulta e consolide nela a página mais fraca, ou deixe as duas páginas claramente diferentes na intenção.
Lacunas de CTR. Páginas que mantêm uma posição normal, mas recebem menos cliques do que páginas semelhantes. Compare a taxa de cliques com a média daquela posição e reescreva o title e a descrição das que estão abaixo.
Para isolar um tipo de página, adicione um filtro de página com uma expressão regular. Por exemplo, para ver apenas as páginas do blog que visam consultas do tipo «como fazer», insira estes dois valores:
Filtro de página (regex):    /blog-geo-seo/.*
Filtro de consulta (regex):  como|guia|checklist
A taxa de cliques depende muito do topo da página de resultados. Alguns números publicados ajudam a julgar se uma diferença é real. Em um estudo sobre as taxas de clique do Google, o primeiro resultado orgânico recebia 27,6% dos cliques, os três primeiros juntos 54,4%, e os resultados da segunda página 0,63%.
Por que a primeira posição importa tanto
27,6%dos cliques vão para o primeiro resultado orgânico
54,4%dos cliques vão para os três primeiros resultados juntos
0,63%dos cliques vão para os resultados da segunda página
Fonte: Backlinko, estudo sobre taxas de clique do Google (backlinko.com/google-ctr-stats)
Use essas médias como verificação de sanidade, não como meta. Elas misturam todo tipo de consulta, e os seus números dependem da intenção de busca, das consultas de marca e dos elementos exibidos acima do seu resultado, como vídeos, imagens ou respostas de IA. Compare cada página com páginas do seu próprio site que ranqueiam para consultas parecidas.
Os limiares abaixo são pontos de partida que usamos para triar os dados. Não são regras do Google. Ajuste-os ao tamanho do seu site e ao volume das suas consultas.
Verificação
Limiar inicial (nossa regra prática)
Por que importa
Distância da primeira página
Posição média de 8 a 20, pelo menos 50 impressões em 90 dias
A demanda existe, e a página está perto o bastante para subir
Queda
Cliques caindo 30% ou mais entre dois períodos iguais
Tráfego perdido suficiente para justificar uma revisão
Conteúdo fino
Menos de 300 palavras de texto útil, sem navegação nem blocos repetidos
Muitas vezes insuficiente para responder à consulta. Uma página curta de ferramenta pode estar correta, então verifique a intenção
Links internos
Menos de 3 links internos de entrada vindos de páginas indexáveis
Um sinal fraco de importância e um sintoma comum de página órfã
Os dados do Search Console também oferecem uma segunda verificação: as consultas para as quais você ranqueia, mas que nunca mirou. Muitas vezes são as adições mais fáceis a uma página existente, porque a relevância já está comprovada pelas impressões.
Etapa 4: Core Web Vitals e mobile
A documentação do Google sobre Core Web Vitals define três medidas de experiência do usuário e seus limites. Uma página fica na faixa «boa» quando seu Largest Contentful Paint é de 2,5 segundos ou menos, seu Interaction to Next Paint é de 200 milissegundos ou menos, e seu Cumulative Layout Shift é de 0,1 ou menos. O INP tornou-se um Core Web Vital estável em 2024, substituindo o First Input Delay.
Métrica
Boa quando
O que mede
Correção comum
LCP
2,5 segundos ou menos
Com que rapidez carrega o maior elemento visível
Otimizar a imagem principal, reduzir o tempo de resposta do servidor, pré-carregar a fonte que a página precisa primeiro
INP
200 milissegundos ou menos
Com que rapidez a página responde a cliques, toques e teclas durante a visita
Dividir as tarefas longas de JavaScript, remover scripts de terceiros pesados, evitar bloquear a thread principal no carregamento
CLS
0,1 ou menos
Quanto o conteúdo se move enquanto a página carrega
Definir largura e altura de imagens e embeds, reservar espaço para banners e anúncios, evitar elementos que surgem tarde acima da dobra
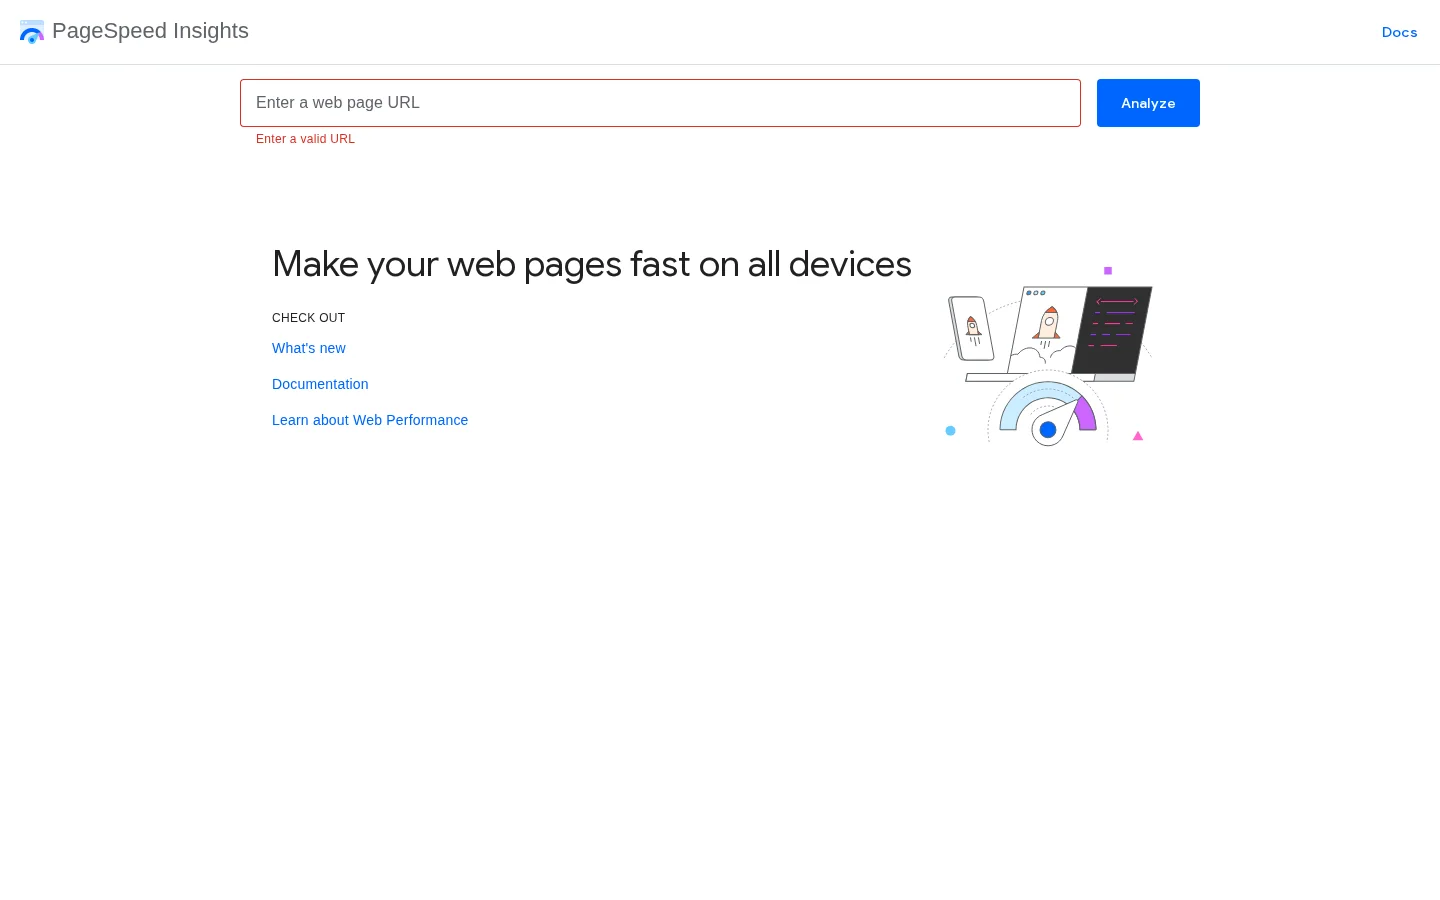
Leia primeiro os dados de campo e depois os de laboratório. Os dados de campo vêm de usuários reais do Chrome e mostram se os visitantes realmente sofrem. Os dados de laboratório vêm de um teste simulado e explicam por que uma página é lenta. O PageSpeed Insights mostra os dois: dados de campo quando o Google tem tráfego suficiente para a URL, e dados de laboratório para cada URL testada.
PageSpeed Insights, que mostra dados de campo e de laboratório de qualquer URL.
Teste de três a cinco URLs por modelo, não apenas a home. Um modelo de produto, um de categoria e um de blog podem ter pontuações muito diferentes no mesmo site, porque carregam scripts diferentes. Uma boa pontuação de laboratório com um INP de campo ruim é um resultado comum em sites com gerenciadores de tags pesados e widgets de chat. Nesse caso, o teste de laboratório não está errado, mas não representa a interação que os usuários têm depois que a página carrega.
No mobile, verifique três coisas. O conteúdo principal da versão mobile deve corresponder ao da versão desktop, porque o Google usa principalmente a versão mobile de uma página para indexar. Os dados estruturados e os links internos devem ser iguais nas duas versões. E nenhum intersticial intrusivo deve cobrir o conteúdo na chegada. A velocidade importa para o ranqueamento, mas o motivo mais útil para corrigi-la é que modelos lentos fazem os visitantes desistir antes de lerem qualquer coisa.
Etapa 5: conteúdo on-page e links internos
Para cada página importante, revise o title, os títulos, a profundidade da resposta, os links de entrada e de saída, e se existe um quase duplicado. Faça isso com uma amostra de páginas de cada modelo, e depois com as páginas que aparecem nos dados de busca como distância da primeira página ou queda.
Verificação
Passa quando
Falha quando
Tag title
Nomeia o tema e a consulta principal da página, e é único no site
Duplica outra página, ou é um padrão do modelo, como apenas o nome do site
H1
Um por página, que declara o tema em palavras simples
Ausente, repetido, ou substituído por um logo ou banner
Primeira tela
A pergunta da consulta é respondida perto do topo
A primeira tela é contexto e texto de marca, e a resposta aparece depois de vários scrolls
Profundidade
Cobre as subperguntas que as pessoas fazem sobre o tema, com detalhes
Fina, ou preenchida com parágrafos repetidos
Links internos
Linkada a partir de páginas relacionadas, e leva ao próximo passo lógico
Órfã, ou linkada apenas pelo rodapé ou pelo sitemap
Dados estruturados
Correspondem ao conteúdo que o visitante vê na página
Marcam conteúdo que não está na página, ou usam o tipo errado
Os links internos são a alavanca mais barata de toda a auditoria. Um link de uma página que já ranqueia, colocado no corpo do texto e usando as palavras da consulta-alvo na âncora, transmite contexto e autoridade. Âncoras genéricas como «clique aqui» ou «leia mais» transmitem muito pouco significado. Comece pelas páginas que trazem mais tráfego, porque cada novo link delas chega a uma página com público real.
Conteúdo duplicado e quase duplicado merece uma etapa própria. Filtros de categoria, parâmetros de ordenação e parâmetros de rastreamento costumam criar muitas URLs que mostram a mesma lista. Decida qual versão deve existir e então use a tag canonical, as regras de robots ou o tratamento de parâmetros adequado. Não deixe a decisão com o Google, porque provavelmente você não vai gostar do resultado.
Dica
Para uma primeira verificação rápida de uma única página, a ferramenta gratuita de auditoria de SEO on-page executa as verificações comuns de title, títulos, links e meta tags, para que você dedique seu tempo aos achados que exigem julgamento.
Etapa 6: autoridade e links
A verificação do perfil de links responde a três perguntas: você está ganhando domínios de referência em um ritmo constante, perdeu links que importavam, e há padrões que parecem manipulados? Exporte os domínios de referência ao longo do tempo a partir de uma ferramenta de backlinks e procure picos repentinos, que costumam vir de uma campanha paga ou de spam, e quedas, que costumam vir de páginas expiradas ou de uma migração. Nosso guia de auditoria de backlinks apresenta a revisão completa.
Tenha cuidado com a ferramenta de desautorização. A própria orientação do Google é que a maioria dos sites não precisa dela. Use-a quando houver um padrão claro de links que você não conquistou, associado a uma ação manual ou a um problema sério, e não porque uma ferramenta de backlinks deu nota baixa a alguns domínios. Desautorizar bons links por engano custa mais do que deixar alguns ruins no lugar.
Etapa 7: visibilidade nas IAs e rastreadores de IA
Duas verificações fazem parte de qualquer auditoria hoje. A primeira é o acesso: os rastreadores de IA conseguem chegar às suas páginas? Verifique as regras do robots.txt para cada rastreador que importa para você. A OpenAI usa GPTBot e OAI-SearchBot, a Anthropic usa ClaudeBot e a Perplexity usa PerplexityBot, e eles não servem todos ao mesmo propósito. Uma única regra para todos raramente é a decisão certa. Nosso guia de rastreadores de IA lista todos com seus papéis.
O exemplo acima é uma decisão possível, não uma recomendação para todos os sites. Ele permite que um rastreador leia suas páginas para respostas de busca e bloqueia outro usado para treinamento. Decida rastreador por rastreador, registre a decisão por escrito e confira o arquivo após cada publicação, porque um robots.txt que bloqueia tudo costuma aparecer depois de uma liberação feita a partir da homologação.
A segunda verificação é a visibilidade: os mecanismos de resposta citam você quando um comprador faz a pergunta que você mira? Monte uma lista de dez a vinte prompts a partir das perguntas reais nos seus dados de busca e nas conversas com vendas. Execute-os no ChatGPT, no Perplexity e no Gemini, anote quais marcas e quais URLs são citadas, e repita cada prompt várias vezes ao longo de alguns dias, porque as respostas mudam de uma execução para outra. O método de auditoria de visibilidade em IA explica como pontuar os resultados.
Métodos de auditoria: qual se encaixa na sua situação
As auditorias diferem pelo escopo e pelo ponto em que começam. Cinco métodos são comuns na prática. Cada um é adequado a uma situação diferente, e a maioria das equipes combina dois.
1. A auditoria técnica completa
Princípio: cobrir o site inteiro, cada tipo de página e cada fonte de dados, e depois ranquear os achados. Use quando estiver preparando uma migração, depois de uma queda acentuada de tráfego ou na primeira auditoria de um site grande. Vantagem: encontra problemas estruturais que nenhuma revisão página a página consegue ver, como uma navegação por facetas que multiplica URLs. Limite: é lenta e produz muitos achados que precisam de uma segunda passada para serem ordenados. Exemplo: um varejista com 40000 URLs de produto descobre que um único parâmetro de filtro gera a maior parte das suas duplicatas, algo que nenhuma revisão de produto individual teria revelado.
2. A auditoria orientada por dados
Princípio: começar pelo que mudou nos dados de busca e diagnosticar apenas as páginas e consultas envolvidas. Use quando fizer uma revisão mensal, logo após uma atualização importante do Google ou quando a equipe for pequena. Vantagem: o trabalho já sai priorizado por tráfego desde o primeiro minuto. Limite: é cega para páginas que ainda não têm dados, como novas seções ou páginas bloqueadas desde o início. Exemplo: um blog que perdeu cliques em cinco páginas verifica essas cinco, descobre que duas canibalizam uma à outra e as une.
3. A auditoria em nível de página
Princípio: executar todas as verificações em uma única URL e decidir se ela precisa de reescrita. Use quando uma página de negócio importante tem desempenho abaixo do esperado, ou antes de uma reescrita planejada. Vantagem: rápida e concreta, com um antes e um depois claros. Limite: não consegue mostrar padrões, então um erro de modelo pode parecer um problema isolado. Exemplo: uma página de produto com title e conteúdo bons tem uma canonical apontando para uma variação esgotada.
4. A auditoria de lacunas com a concorrência
Princípio: comparar suas páginas e temas com os que ranqueiam acima de você para as mesmas consultas. Use quando planejar novos conteúdos ou novos links. Vantagem: mostra o que o mercado recompensa na prática, incluindo profundidade, formato e subperguntas cobertas. Limite: copiar o líder pode levar você a um tema saturado ou com intenção errada. Verifique o que os primeiros resultados têm em comum antes de decidir. Exemplo: os cinco primeiros resultados de uma consulta respondem a uma pergunta sobre preço já na primeira tela, e o seu não.
5. A auditoria de visibilidade em IA
Princípio: verificar se os rastreadores de IA conseguem ler suas páginas e se os mecanismos de resposta citam você nas perguntas que importam. Use quando precisar saber se as ferramentas de IA recomendam sua marca. Vantagem: cobre um canal que os rastreadores de posição tradicionais não mostram. Limite: as respostas variam de uma execução para outra, então a amostra precisa ser repetida antes de tirar conclusões. Exemplo: uma empresa de software é citada por um recurso que não vende mais, o que mostra que suas páginas de comparação estão desatualizadas.
Método
Ponto de partida
Ideal para
Principal limite
Auditoria técnica completa
O rastreamento e todas as fontes de dados
Migrações, sites grandes, quedas acentuadas
Lenta, e difícil de ordenar sem um plano
Auditoria orientada por dados
Mudanças nos dados de busca
Revisões mensais, equipes pequenas
Deixa de fora páginas sem dados
Auditoria em nível de página
Uma URL
Uma página com desempenho abaixo do esperado
Não enxerga padrões de modelo
Auditoria de lacunas com a concorrência
Os resultados acima de você
Novos conteúdos e novos links
Risco de copiar uma intenção errada
Auditoria de visibilidade em IA
Acesso dos rastreadores e mecanismos de resposta
Saber se a IA recomenda você
As respostas variam, as amostras precisam ser repetidas
Auditoria rápida ou auditoria completa
Auditoria rápida
Apenas dados de busca e os modelos principais
Termina com uma lista curta e ranqueada
Deixa de fora problemas estruturais e de rastreamento
Auditoria completa
Cobre cada tipo de página e modelo
Encontra problemas estruturais e de rastreamento
Lenta, e fácil de terminar sem um plano
Nosso conselho: comece pela auditoria rápida e passe para a completa apenas quando a rápida apontar uma causa estrutural ou quando você estiver prestes a mudar a arquitetura do site.
Priorizar: dos achados a um plano
Uma auditoria com 400 achados e sem ordem vale menos do que uma com dez. Pontue cada achado em dois critérios: quanto tráfego ou receita ele coloca em risco, e quão difícil é a correção. Comece pelos itens de alto impacto e baixo esforço. Depois, passe aos itens de alto impacto que exigem mais trabalho, mas desbloqueiam um modelo inteiro, porque uma única correção ali muda milhares de páginas.
Achado
Tráfego em risco
Esforço
Prioridade
Um modelo linka para páginas 404 a partir de todas as páginas
Alto
Baixo
Fazer primeiro
Páginas importantes com titles duplicados
Alto
Baixo
Fazer primeiro
LCP lento no modelo de categoria
Alto
Médio
Planejar para a próxima sprint
Artigos de blog em queda
Médio
Médio
Atualizar pela ordem de cliques perdidos
Páginas de glossário órfãs
Baixo
Baixo
Agrupar com o trabalho de links internos
Páginas de arquivo de tags com conteúdo fino
Baixo
Médio
Verificar a intenção, depois noindex ou consolidar
Atribua a cada item um responsável, uma data e a métrica que você espera mover. Um achado sem responsável continua sendo uma anotação, e anotações não mudam rankings. Meça de novo depois que o Google tiver rastreado novamente as páginas afetadas, o que pode levar semanas, e compare com a linha de base que você salvou no início. Ao apresentar os resultados, o modelo de relatório de auditoria de SEO oferece uma estrutura que gestores e clientes conseguem ler em dez minutos.
Se você quiser ter o tráfego do Google e o das IAs no mesmo lugar enquanto acompanha essas correções, o painel GEO / SEO da Sorank mostra os dois lado a lado.
Uma auditoria de SEO de 90 minutos: o que dá para concluir em uma sessão
Uma auditoria de SEO de 90 minutos verifica as páginas que trazem mais tráfego de busca, em uma ordem que revela primeiro as perdas reais. Use-a quando tiver uma única sessão e precisar de uma lista ranqueada de correções, e não de uma revisão de todas as URLs. Limite o trabalho às suas páginas principais e a uma URL de exemplo por modelo, e o resultado fica pronto para uso no mesmo dia.
Divida a sessão em blocos fixos e pare cada bloco quando o tempo acabar. O limite de tempo faz parte do método, porque obriga você a escolher.
Minutos
Tarefa
Resultado
0 a 10
Exportar 90 dias de dados de consultas e páginas do Search Console e listar as 20 principais páginas por cliques
Uma linha de base salva e uma lista de páginas
10 a 25
Aplicar a essa lista as verificações de distância da primeira página e de queda da etapa 3
Páginas que perderam cliques ou estão entre a 8ª e a 20ª posição
25 a 40
Rastrear uma URL de exemplo por modelo e verificar código de status, canonical e diretivas de robots
Erros, canonicals erradas e bloqueios, por modelo
40 a 55
Abrir o relatório de Páginas do Search Console e ordenar os motivos pela quantidade
O status que afeta mais páginas
55 a 70
Rodar o PageSpeed Insights em uma URL por modelo, lendo primeiro os dados de campo
O modelo com o LCP ou INP de campo mais fraco
70 a 90
Redigir os dez principais achados com tráfego em risco, esforço e responsável
Um plano ranqueado que você pode enviar no mesmo dia
Cada linha responde a uma pergunta, então você pode pular uma sem perder as outras. Se o relatório de indexação não mostrar nada incomum, dedique esse tempo aos dados de busca, que costumam ser o caminho mais rápido até uma correção.
O que uma auditoria de 90 minutos não consegue ver
Um limite de tempo esconde três coisas. Ele deixa de fora problemas estruturais, como um filtro que multiplica URLs, porque você lê apenas amostras. Não usa os logs do servidor, então você não consegue ver com que frequência os rastreadores pedem uma página. E pula o perfil de links, que exige uma exportação completa de uma ferramenta de backlinks. Anote essas questões como pendências para uma auditoria de backlinks posterior ou uma revisão completa, para que a auditoria curta não pareça mais completa do que é.
Erros que desperdiçam uma sessão curta
O erro mais comum é começar pelo rastreador. Um rastreamento de um site grande pode levar mais tempo que a sessão inteira e devolver mais alertas do que alguém consegue ler. Comece pelos dados de busca e abra o rastreador apenas para as páginas que têm cliques ou impressões. Corrija primeiro os alertas dessas páginas, porque alertas em páginas que ninguém visita não mudam o seu tráfego.
Dica
Coloque a sessão na sua agenda com um cronômetro e um único arquivo de saída. Use as colunas do modelo de relatório de auditoria de SEO desde o início, para que a lista esteja pronta para compartilhar no minuto 90.
Erros comuns, e como identificá-los e corrigi-los
A maioria das auditorias contém os mesmos erros. Eles são fáceis de evitar quando você conhece os sinais.
Auditar sem escopo
O que é: a auditoria cobre tudo, então nada termina. Como identificar: o relatório tem centenas de problemas, nenhum com uma cifra de tráfego ou um responsável. Como corrigir: recomece com o pedido objetivo da primeira seção, limite o rastreamento aos tipos de página que importam e ordene os achados por tráfego antes de escrever qualquer outra coisa.
Tratar alertas como se fossem rankings
O que é: a equipe corrige os alertas que a ferramenta mostra em vermelho, mesmo quando afetam páginas que ninguém visita. Como identificar: o número de alertas cai enquanto os cliques nas páginas de negócio continuam caindo. Como corrigir: cruze o rastreamento com os dados de busca e corrija primeiro os problemas nas páginas que têm tráfego, impressões ou links.
Confiar em um único rastreamento como verdade
O que é: o rastreador não reporta erros, então a equipe conclui que o site está saudável. Como identificar: o Search Console mostra muitas URLs «rastreada, atualmente não indexada» ou «descoberta» que o rastreador nunca sinalizou. Como corrigir: compare o rastreamento com o sitemap, o relatório de indexação e os logs do servidor. Um rastreador só vê o que consegue alcançar por links e renderização, então conteúdo atrás de login, scripts ou filtros por facetas pode faltar na lista dele.
Corrigir páginas em vez de modelos
O que é: a equipe edita o mesmo title, a mesma imagem ou a mesma canonical em centenas de páginas, uma por uma. Como identificar: o mesmo achado aparece na maioria das URLs de um tipo de página. Como corrigir: corrija o modelo uma vez e depois verifique uma amostra de páginas para confirmar que a mudança funcionou em todas. Uma única mudança no modelo corrige o grupo inteiro.
Bloquear uma página para removê-la da busca
O que é: a equipe adiciona um disallow no robots.txt a uma página que quer que saia do Google. Como identificar: a página continua no índice com uma URL nua e sem snippet, e o relatório a mostra como bloqueada. Como corrigir: libere o rastreamento, adicione uma diretiva noindex e espere o Google rastrear a página de novo. Depois que ela sair do índice, você pode bloqueá-la se precisar, mas não é necessário.
Exemplo (ilustrativo)
Imagine um site que desativou um conjunto de páginas de campanha e as bloqueou no robots.txt. As páginas continuam aparecendo na busca com uma URL nua e sem descrição, porque outros sites ainda linkam para elas. Remover o bloqueio e adicionar noindex permite que o Google rastreie as páginas, leia a diretiva e as tire do índice.
Buscar uma pontuação de laboratório perfeita
O que é: a equipe otimiza para uma nota 100 em um teste de laboratório e ignora os dados de campo. Como identificar: a pontuação de laboratório é alta, mas o INP de campo do mesmo modelo é ruim no relatório de Core Web Vitals do Search Console. Como corrigir: analise as interações que os usuários reais fazem, normalmente depois que a página carrega. Procure tarefas longas disparadas por scripts, e não o tempo de carregamento da primeira renderização.
Com que frequência fazer uma auditoria
Faça uma auditoria rápida todo mês, com base nos dados de busca e nos seus modelos mais importantes. Faça uma auditoria completa depois de uma migração, de um redesenho, de uma troca de CMS ou de uma queda repentina de tráfego, e uma revisão completa por ano para detectar desvios estruturais. Os dados de busca devem ser acompanhados continuamente, porque uma queda de cliques é mais útil como alerta do que como lembrete de calendário.
Auditoria do site: uma verificação de saúde repetível para o domínio inteiro
Uma auditoria do site é um rastreamento de cada URL acessível de um mesmo domínio, relatado por tipo de problema e gravidade. Ela mostra o que está quebrado em todo o site, incluindo padrões que uma revisão página a página deixa passar. Ela não informa qual correção vai mover as posições, então combine-a com os dados de busca.
Defina o escopo do rastreamento antes de começar
Filtros, opções de ordenação e tags de rastreamento podem criar muito mais URLs do que páginas, e a maioria mostra a mesma lista. Exclua esses parâmetros e os arquivos de mídia, e rastreie cada subdomínio como um projeto separado. Mantenha a taxa de requisições baixa para que o servidor continue rápido para os visitantes reais. Mantenha a paginação (page=) no escopo, porque listas paginadas podem conter páginas que você quer indexadas.
A maioria dos rastreadores aceita regras de exclusão escritas como expressões regulares como estas. Teste-as em um rastreamento curto e confira se a contagem de URLs cai apenas para os parâmetros que você queria excluir.
Leia a gravidade antes da pontuação
Cada ferramenta agrupa os problemas em níveis e calcula a própria pontuação de saúde. Os rótulos variam de uma ferramenta para outra, mas a lógica de triagem é a mesma. Uma pontuação é uma linha de tendência para uma ferramenta com configurações fixas, não uma nota que o Google aplica. Percorra os níveis nesta ordem:
Nível
Problemas típicos
Primeira ação
Erros em páginas indexáveis
Respostas 4xx ou 5xx em URLs que você quer ranqueadas, links internos quebrados
Corrigir primeiro, começando pelas páginas que já geram cliques
Erros em páginas que você não quer indexar
Busca interna quebrada, URLs de filtros ou de campanhas desativadas
Remover os links internos que ainda apontam para elas
Alertas
Tags title longas demais, meta descriptions ausentes, subtítulos duplicados
Corrigir em lotes, de preferência com uma única mudança no template
Observações
Pequenas sugestões de otimização
Revisar uma vez e agir só se repetirem em páginas que vendem
Compare dois rastreamentos, não duas pontuações
O resultado mais útil de uma auditoria do site é a diferença entre duas execuções. Exporte a lista de problemas da última execução, rastreie de novo com as mesmas configurações e compare as contagens por tipo de problema e por URL. Os problemas novos vêm primeiro, porque um erro novo em uma página no ar geralmente segue uma publicação recente. Cruze cada grupo novo com seu registro de mudanças antes de atribuir um responsável.
Por exemplo, a primeira execução aponta 42 erros. A segunda, quatro semanas depois, aponta 57, e 15 dos novos estão em um modelo de página de preços publicado naquela semana. Corrija o modelo uma vez. Se a contagem voltar em direção a 42, a correção funcionou, e essa execução vira a referência para a próxima.
Mantenha a rotina curta o bastante para repetir
Uma auditoria do site que leva um dia inteiro não será repetida. Salve o escopo, as regras de exclusão e a tabela de gravidade em uma única configuração, para que a próxima execução leve minutos. Agende o rastreamento e exporte sempre os mesmos três arquivos: a lista de problemas, as URLs indexáveis e as URLs que recebem cliques. Nosso guia de relatórios de SEO automatizados explica o que automatizar e como configurar.
Se você ainda está escolhendo um rastreador, nossa comparação de ferramentas de SEO técnico classifica as opções pela tarefa que cumprem. Uma auditoria do site só vale a pena agendar se alguém lê a diferença entre as execuções. Caso contrário, é mais uma exportação em uma pasta.
Por onde começar esta semana
Se você nunca fez uma auditoria, faça quatro coisas em ordem. Exporte 90 dias de dados do Search Console e salve-os com a data. Rastreie seus modelos principais com um rastreador, começando pela versão gratuita de 500 URLs se o site for pequeno. Leia o relatório de indexação e ordene os motivos. Depois corrija os três maiores problemas de modelo que encontrou, e meça de novo depois do próximo ciclo de rastreamento.
Exportar os dados de consultas e páginas, e salvar a linha de base.
Rastrear uma URL de exemplo por modelo, anotando códigos de status, titles, canonicals e diretivas de robots.
Ler o relatório de indexação, e transformar cada status em uma pergunta com responsável.
Corrigir os três maiores problemas de modelo, depois comparar os dados de busca após o próximo ciclo de rastreamento.
Uma boa auditoria não termina com um documento. Termina com uma lista curta de correções que alguém está fazendo neste mês, e com uma linha de base que prova se elas funcionaram.
Perguntas frequentes
Quanto tempo leva uma auditoria de SEO?
Depende do tamanho do site e de quão fundo você precisa ir. Uma auditoria focada nos seus principais modelos de página e nos dados de busca pode ser feita em poucos dias. Uma auditoria completa de um site grande, com muitos modelos, leva mais tempo, e a maior parte desse tempo vai para o diagnóstico e a priorização, e não para o rastreamento em si.
Quais ferramentas preciso para fazer uma auditoria de SEO?
No mínimo, o Google Search Console e um rastreador como o Screaming Frog SEO Spider, além do PageSpeed Insights para velocidade. Analytics e logs do servidor acrescentam contexto útil. Suítes de SEO pagas ajudam com backlinks e dados de concorrentes, mas não são obrigatórias para uma primeira auditoria.
Qual a diferença entre uma auditoria de SEO e uma checklist de SEO?
Uma checklist lista as verificações a fazer. Uma auditoria executa essas verificações no seu site, decide quais achados importam e ordena as correções pelo tráfego que colocam em risco. Use a checklist para montar a auditoria, e a auditoria para escolher o trabalho.
y!
Receba gratuitamente o seu plano de conteúdo para 30 dias
Analisamos seus concorrentes, seu site e sua visibilidade nas IA para criar, gratuitamente, um plano de conteúdo sob medida.
“Testei o Sorank no site real de um cliente e é uma loucura. Faz tudo aquilo que uma agência cobra 1.500 € por mês. Agora vai para produção nesse cliente.”Guillaume Guersanguersanguillaume.com
“Somos uma agência de publicidade e queríamos colocar nosso SEO nos trilhos de uma vez por todas. A Sorank nos deu uma visão clara do nosso site, ajudou-nos a priorizar as otimizações e estruturar corretamente nosso conteúdo. A ferramenta é fácil de usar, bem projetada para uma equipe e muito prática para centralizar o acompanhamento sem ter que fazer malabarismos entre várias plataformas. Uma base muito sólida para recomeçar do zero com nosso SEO.”Gaspard MadouiAgência de Publicidade
“Me especializei em GEO graças à Sorank. O GEO Leaderboard me permite mostrar aos meus clientes o seu posicionamento em relação aos concorrentes no ChatGPT. É um verdadeiro diferencial comercial.”MélanieFreelancer SEO
“Excelente serviço, funciona bem para o nosso site e nos ajuda a entender como melhorá-lo para nos posicionarmos melhor no Google e em outros lugares. Parabéns, continuem assim, eu recomendo.”Hugo T.Comerciante de e-commerce


 Search Console