Integritet är viktigt för oss, så du kan välja att inaktivera vissa typer av lagring som kanske inte är nödvändig för webbplatsens grundläggande funktioner. Om du blockerar kategorier kan det påverka din upplevelse av webbplatsen. Mer information (Cookiepolicy)
Hur man gör en SEO-audit: en steg-för-steg-metod som hittar det som kostar trafik
Gör en fullständig SEO-audit i rätt ordning: crawl, indexering, Search Console, Core Web Vitals och AI-synlighet, med kontroller och åtgärder som flyttar trafik.
En anteckningsbok med en SEO-auditchecklista och utskrivna diagram på ett skrivbord.
Verktyg
På den här sidan
Kort sagt
En SEO-audit är en strukturerad kontroll av allt som hindrar dina sidor från att crawlas, indexeras, förstås, klickas på och citeras. Kör den i en fast ordning: crawl, indexering, sökdata, hastighet, sidinnehåll, länkar och sedan AI-synlighet. Poängsätt varje fynd efter den trafik det blockerar, och gör de tio viktigaste till datumsatta uppgifter med en ansvarig. En fokuserad audit kan göras på några dagar. En fullständig audit av en stor webbplats tar längre tid, och resultatet ska vara en plan, inte en lista.
3 dagar gratis, sedan kan du avsluta när du vill. 90 dagars resultatgaranti, villkor gäller.
Vad en SEO-audit är, och vad den inte är
En SEO-audit besvarar en fråga: vilka tekniska, innehållsmässiga och auktoritetsrelaterade problem kostar dig besök just nu, och i vilken ordning ska de åtgärdas? Den är inte en lista över alla best practices som finns. En checklista med 40 punkter visar vad du ska titta på. En audit visar vad som är fel på din webbplats, hur allvarligt det är och vad du ska göra först.
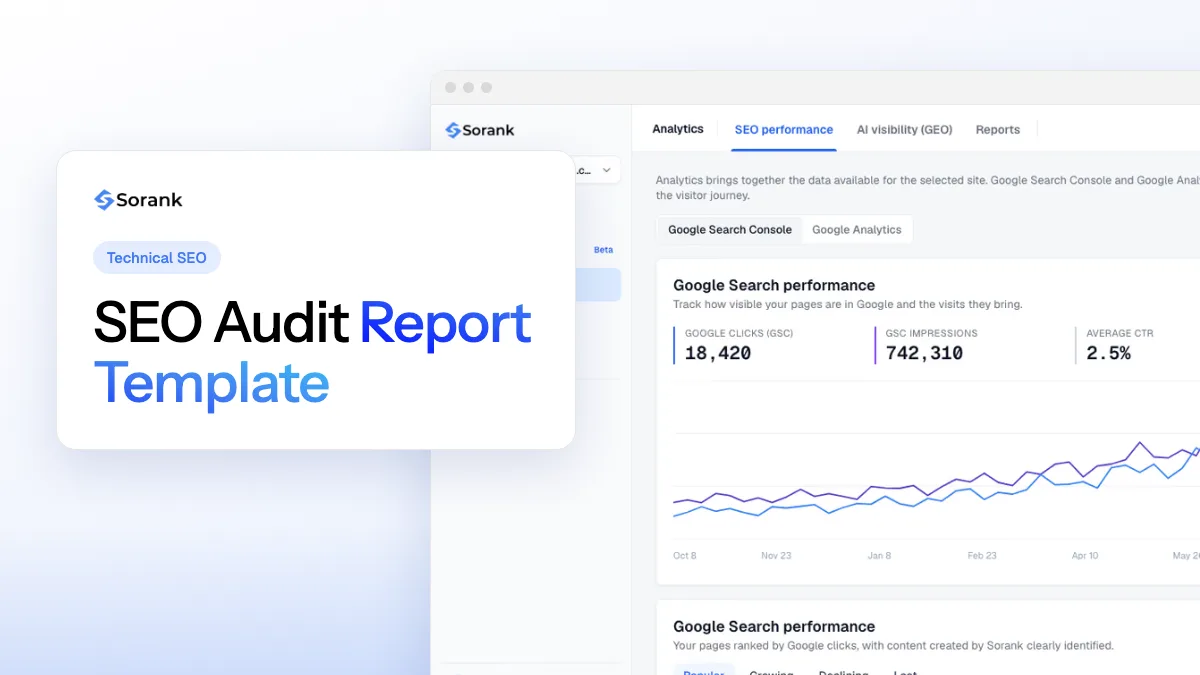
Tre saker blandas ofta ihop: auditen (diagnosen), checklistan (listan över kontroller) och rapporten (det du lämnar över till en kund eller chef). Vår mall för SEO-auditrapporten täcker rapporten, och checklistan för teknisk SEO täcker kontrollerna. Den här artikeln handlar om metoden som kopplar ihop dem, och om den data du behöver för att avgöra vad som spelar roll.
Två sätt att beskriva samma audit
Vag beskrivning
Kontrollera webbplatsen efter SEO-problem
Resultat: en lång lista med varningar som ingen läser
Avgränsad beskrivning
Hitta sidorna som tappat klick under de senaste 90 dagarna
Resultat: tio åtgärder rangordnade efter den trafik som står på spel
Skillnaden ligger inte i insatsen. Den ligger i frågan. En avgränsad beskrivning anger sidorna, perioden och beslutet, så att varje kontroll du gör har en anledning att finnas.
Innan du börjar: åtkomst, omfattning och en utgångspunkt
De flesta audits går fel redan före den första crawlen, eftersom ingen har kommit överens om omfattningen eller sparat en startpunkt. Klargör tre saker innan du öppnar något verktyg.
Omfattning. Vilken domän och vilka subdomäner, vilka länder och språk, och vilka sidtyper som är viktiga. För en e-handelssajt innebär det startsida, kategorier, produkter, blogg och eventuella målsidor. Skriv ner dem.
Åtkomst. Ägaråtkomst till Search Console för varje egendom (http, https, www och icke-www, om de finns), läsåtkomst till din analys och åtkomst till CMS:et eller serverloggarna om du har dem. Serverloggar visar vad sökrobotar faktiskt begär, något som ingen crawlersimulering kan visa.
Utgångspunkt. En ögonblicksbild av klick, visningar, genomsnittlig position och de sidor som ger flest klick, sparad i ett kalkylblad med datum. Utan den kan du inte bevisa att en åtgärd fungerade.
Innan du crawlar något
Bekräfta ägaråtkomst till Search Console för varje egendom
Exportera 90 dagars data per sökfråga och sida och spara den med dagens datum
Lista dina huvudsakliga sidtyper och en exempeladress för varje
Skriv målet i en mening: fler klick på affärssidor, färre fel, snabbare mallar
Välj din crawler och dess gränser (se avsnittet om crawl nedan)
En audit läser hela strukturen på en webbplats innan den åtgärdar en enskild sida.
Metoden i ordning: sju steg
Ordningen spelar roll. Crawlen visar vad som finns på din webbplats. Indexeringen visar vad Google behåller. Sökdatan visar vad folk hittar och klickar på. Hastighet, innehåll och länkar förklarar sedan varför en sida presterar sämre. Gör du det i omvänd ordning lägger du timmar på att skriva om en sida som Google inte kan indexera över huvud taget.
De sju stegen i en SEO-audit
Crawla webbplatsenLista varje URL med dess statuskod, title, canonical, robots-direktiv och interna länkar.
Kontrollera indexeringenJämför det du publicerar med det Google indexerar, och läs orsaken till varje uteslutning.
Läs sökdatanHitta sidorna och sökfrågorna som ökar eller minskar i klick, och de som ligger nära toppen på första sidan.
Testa hastighet och mobilMät Core Web Vitals för varje mall, med början i fältdata från riktiga användare.
Granska sidinnehålletKontrollera titlar, rubriker, djup, dubbletter och interna länkar, sida för sida och mall för mall.
Bedöm auktoritet och länkarTitta på hänvisande domäner över tid, förlorade länkar, ankartext och spamsignaler.
Kontrollera AI-synlighetBekräfta att AI-crawlers kan nå dina sidor, och testa om svarsmotorer nämner dig.
Kontroller före audit: vad du ska bekräfta innan du litar på datan
Kontroller före audit bekräftar att webbplatsen du ska granska är den som Google och dina besökare faktiskt ser, och att din data är tillförlitlig nog att agera på. Ägna ungefär en timme åt dem innan någon crawl. En felaktig Search Console-egendom, en aktiv stagingregel eller trasig spårning kan göra alla senare fynd felaktiga, och en crawl avslöjar ingen av dem.
Bekräfta vilken version av webbplatsen som är live
Begär varje variant av din domän: http, https, med www och utan www, med och utan avslutande snedstreck. Varje variant bör sluta på samma slutliga adress, helst efter en enda omdirigering. Två live-versioner delar upp länkar och signaler mellan sig, och en crawler rapporterar båda som friska.
Läs Location-huvudet i varje svar. Det bör peka direkt till din föredragna adress, inte till en andra omdirigering. Upprepa kontrollen på startsidan och på en djup sida, eftersom omdirigeringsregler ofta skiljer sig mellan mallar.
Kontrollera att ingen testinställning nådde den publika webbplatsen
Stagingsinställningar är en av de vanligaste orsakerna till ett plötsligt fall. Titta på den publika robots.txt, metataggen robots och HTTP-huvudet X-Robots-Tag på startsidan och på en artikel. En Disallow-regel för hela webbplatsen, eller ett noindex kvar från en testversion, kan dölja avsnitt för sökningen medan sidorna fortfarande laddas för besökare. Om du hittar en sådan, åtgärda den innan du granskar de avsnitten, eftersom alla senare fynd då skulle beskriva en webbplats som Google inte kan se.
Skapa en ändringslogg innan du diagnostiserar ett fall
Skriv en daterad lista över varje release, omdesign, CMS-uppdatering, migrering och redigering av robots eller noindex från de senaste sex månaderna. Jämför sedan dessa datum med början på varje trafikförändring. Ett fall som börjar samma dag som en malluppdatering pekar på just den mallen. Ett fall utan någon närliggande ändring kan peka på en uppdatering av sökalgoritmen och kräver en annan kontroll. Utan loggen skyller du på det du tittade på sist. För ändringar som berör URL:er listar checklistan för SEO-migrering vad som ska registreras.
Kontrollera datan som auditen ska bygga på
Jämför klick i Search Console med organiska sessioner i din analys under samma 90 dagar. De två linjerna behöver inte matcha, men de bör röra sig åt samma håll. Om de skiljer sig åt, kontrollera taggarna på nyckelsidor, samtyckesbannern och eventuell botfiltrering innan du diagnostiserar webbplatsen. Jämförelsen av de två verktygen förklarar vad vart och ett räknar.
Steg 1: crawla webbplatsen och åtgärda det crawlern hittar
En crawler gör i mindre skala det Googlebot gör: den startar från en sida, följer de länkar den hittar och registrerar vad den ser för varje URL. Verktyget vi använder i de flesta audits är Screaming Frog SEO Spider. Den kostnadsfria versionen crawlar upp till 500 URL:er, vilket räcker för en liten webbplats eller för ett avsnitt av en stor. En betald licens tar bort gränsen. Vår guide till Screaming Frog går igenom installationen.
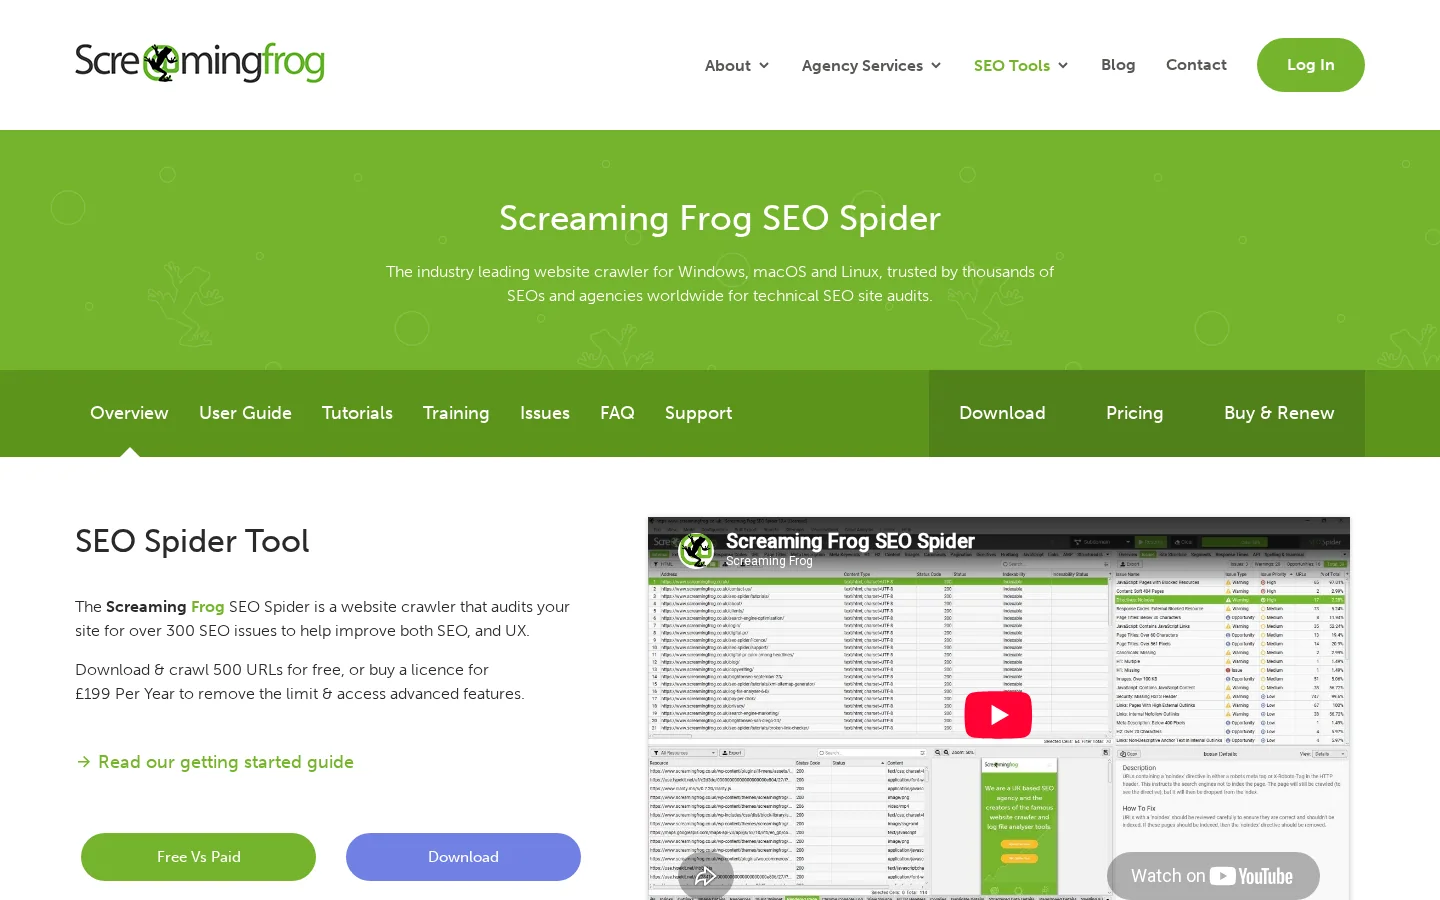
Screaming Frog SEO Spider, den stationära crawler som listar varje URL på en webbplats med dess statuskod och direktiv.
Starta crawlen från startsidan och från din sitemap, och jämför sedan de två listorna. Varje URL som finns i den ena men inte i den andra är en fråga. Ställ in crawlern så att den respekterar robots.txt på samma sätt som Googlebot, och så att den renderar JavaScript om din sajt är beroende av det. En crawl som inte renderar dina sidor missar innehåll som användarna ser.
Statuskoder och omdirigeringskedjor
Filtrera först på svar med 4xx och 5xx. Ett 404 är inget problem i sig. Det blir ett problem när interna länkar fortfarande pekar på det, eftersom de länkarna skickar användare och crawlers in i en återvändsgränd. Hitta de interna länkar som leder till felsidor och peka om dem till en fungerande URL. Titta sedan på omdirigeringskedjor: en gammal URL omdirigerar till en andra URL, som omdirigerar till en tredje. Varje hopp lägger till latens och späder ut signalen. Platta till varje kedja så att den gamla URL:en pekar direkt på den slutliga.
Kontrollera också typen av omdirigering. En tillfällig 302 som används för en permanent flytt bör vara en 301. Vår guide om 301 kontra 302 ger beslutsregeln.
Robots-direktiv, noindex och canonical
Tre inställningar kan gömma en sida utan att någon märker det. En disallow-regel i robots.txt stoppar crawlningen. En noindex-metatagg eller HTTP-huvudet X-Robots-Tag stoppar indexeringen. En canonical-tagg som pekar på en annan URL talar om för sökmotorer vilken version som ska behållas. Kontrollera var och en för varje sidtyp, eftersom en regel som lagts till för att åtgärda en sektion ofta blockerar en annan. Ett vanligt fall: en regel från en stagingmiljö som aldrig togs bort från den publika robots.txt.
Varning
Att blockera en sida i robots.txt är inte samma sak som att ta bort den från sökresultaten. Om Google inte kan crawla sidan kan den inte läsa en noindex-tagg på den. För att ta bort en sida från indexet ska du tillåta crawlning och lägga till noindex, och sedan vänta tills Google crawlar om den.
Föräldralösa sidor och klickdjup
En föräldralös sida har ingen intern länk som pekar på den. Crawlers hittar den bara via sitemapen eller via en extern länk, och användare hittar den nästan aldrig. För att upptäcka föräldralösa sidor jämför du tre listor: de URL:er crawlern nådde via länkar, de URL:er som finns i din sitemap och de URL:er som får besök i din analys. En sida som finns i sitemapen eller får besök men saknar en inkommande intern länk är en kandidat för föräldralös.
Mät också klickdjup, alltså antalet klick från startsidan. En viktig sida som ligger fem eller sex klick ner får lite crawl-uppmärksamhet och få interna länkar. Länka den från en relevant navsida, och se till att navsidan i sig ligger grunt.
Titlar, beskrivningar och dubbletter
Filtrera på saknade titlar, dubblerade titlar, dubblerade metabeskrivningar och titlar som är för långa för att visas fullt ut i sökresultaten. Dubbletter kommer nästan alltid från en mall, inte från en skribent. En produktmall som skriver ut samma titel för varje variant ger hundratals dubbletter, och att rätta mallen åtgärdar alla samtidigt. Behandla title-taggen som ett starkt förslag till Google, inte som en garanti. Google skriver ibland om den, vilket är ytterligare ett skäl att hålla den korrekt och specifik.
Serverloggar stänger kretsen kring crawlen. De visar vilka URL:er Googlebot begärde, hur ofta och vilka statuskoder den fick. Om du har tillgång till dem, jämför förfrågningarna med din sitemap. Sidor som Googlebot träffar ständigt men som inte ger något värde är ett tecken på slösad crawl, vilket förklaras i vårt uppslag om crawlbudget.
Steg 2: indexering, vad Google behåller och varför
Rapporten Sidindexering i Search Console visar de URL:er Google känner till och den status den ger var och en. Öppna den och sortera efter orsak, inte efter antal. Varje orsak pekar mot en annan åtgärd. Googles egna definitioner, från Search Console-hjälpen om indexeringsstatus, är referensen för etiketterna nedan.
Status i rapporten
Vad det betyder
Vad du ska göra
Upptäckt, för närvarande inte indexerad
Google hittade URL:en men har inte crawlat den ännu, och schemalade om crawlen eftersom den bedömde att webbplatsen skulle bli överbelastad
Kontrollera serverns svarstider och hur djupt URL:en ligger. Se till att interna länkar pekar på den
Crawlad, för närvarande inte indexerad
Google crawlade sidan och valde att inte indexera den. Google indexerar inte varje sida på webben
Kontrollera kvaliteten först: tunt innehåll, nära dubbletter, svaga interna länkar. Använd URL-inspektion på de sidor som är viktiga
Blockerad av robots.txt
Googlebot får inte crawla URL:en
Bekräfta att blockeringen är avsiktlig. Ta bort den om sidan ska kunna rankas
Exkluderad av noindex-tagg
Sidan har ett noindex-direktiv
Ta bort direktivet om sidan ska rankas. Behåll det på sidor som ska vara utanför, till exempel interna sökresultat
En praktisk tumregel: när en hel sidtyp har en hög andel "crawlad, för närvarande inte indexerad" ska du titta på mallen innan du tittar på artiklarna. Tunna mallar ger tunna sidor, och att rätta en enskild artikel ändrar inte mönstret. Vår guide till statusen crawlad, för närvarande inte indexerad går igenom orsakerna i detalj.
För de sidor som spelar roll använder du URL-inspektion en URL i taget. Den visar datum för senaste crawl, om sidan är indexerad och den canonical som Google valde. När den valda canonicalen inte är den du deklarerade beror det nästan alltid på dubblering eller motstridiga signaler, till exempel en canonical som pekar på en omdirigerad URL, eller interna länkar som gynnar en parameterversion.
Steg 3: sökdata, där möjligheterna finns
Rapporten Prestanda i Search Console är den mest användbara kostnadsfria datamängden för en audit. Som standard visar den de senaste tre månaderna, vilket är för kort för en trend. Exportera minst 90 dagars data per sökfråga och sida, och spara filen med datum så att du kan jämföra den med nästa audit. Gruppera tabellen per sida och per sökfråga, och använd filtren för land och enhet när sajten betjänar fler än en marknad.
Google Search Console, källan till sökfråge-, sid- och indexeringsdata som används i auditen.
Fyra analyser hittar det mesta av möjligheterna i datan.
Striking distance. Sökfrågor där din sida ligger mellan position 8 och 20 med verkliga visningar. Dessa sidor har redan relevans. De behöver ofta en bättre titel, mer djup kring sökfrågan eller några interna länkar från relaterade sidor, inte en omskrivning.
Decay. Sidor vars klick sjönk mellan två lika långa perioder. Jämför de senaste 90 dagarna med de 90 dagarna innan. Titta först på sidan och sedan på de sökfrågor den förlorade, eftersom en sida kan behålla sin position medan en ny funktion tar dess klick.
Kannibalisering. Sökfrågor där två eller fler av dina URL:er båda syns och byter position från vecka till vecka. Välj en målsida för sökfrågan och slå sedan ihop den svagare sidan med den, eller gör de två sidorna tydligt olika i sökavsikt.
CTR-gap. Sidor som har en normal position men får färre klick än liknande sidor. Jämför klickfrekvensen med genomsnittet för den positionen och skriv sedan om titeln och beskrivningen för de sidor som presterar sämre.
För att isolera en sidtyp lägger du till ett sidfilter med ett reguljärt uttryck. För att till exempel bara se de bloggsidor som riktar sig mot hur-gör-sökfrågor anger du dessa två värden:
Page filter (regex):   /blog-geo-seo/.*
Query filter (regex):  how to|guide|checklist
Klickfrekvensen beror starkt på toppen av sökresultatsidan. Några publicerade siffror hjälper dig att bedöma om ett gap är verkligt. I en studie av klickfrekvenser i Google fick det första organiska resultatet 27,6 % av klicken, de tre första tillsammans fick 54,4 %, och resultaten på andra sidan fick 0,63 %.
Varför position ett betyder så mycket
27,6 %av klicken går till det första organiska resultatet
54,4 %av klicken går till de tre första resultaten tillsammans
0,63 %av klicken går till resultaten på andra sidan
Källa: Backlinko, studie om Googles klickfrekvens (backlinko.com/google-ctr-stats)
Använd dessa genomsnitt som en kontroll, inte som ett mål. De blandar alla typer av sökfrågor, och dina egna siffror beror på sökavsikt, varumärkestermer och de funktioner som visas ovanför din träff, till exempel videor, bilder eller AI-svar. Jämför varje sida med sidor som rankar för liknande sökfrågor på din egen webbplats.
Tröskelvärdena nedan är utgångspunkter som vi använder för att sortera datan. De är inga Google-regler, så justera dem efter storleken på din webbplats och volymen på dina sökfrågor.
Kontroll
Utgångströskel (vår tumregel)
Varför det spelar roll
Striking distance
Genomsnittlig position 8 till 20, minst 50 visningar under 90 dagar
Efterfrågan finns, och sidan är tillräckligt nära för att kunna flytta sig
Decay
Klick ner 30 % eller mer mellan två lika långa perioder
Tillräckligt med trafik har gått förlorad för att motivera en översyn
Tunt innehåll
Under 300 ord brödtext, exklusive navigation och standardtext
Ofta för lite för att besvara sökfrågan. En kort verktygssida kan ändå vara rätt, så kontrollera avsikten
Interna länkar
Färre än 3 inkommande interna länkar från indexerbara sidor
En svag signal om betydelse, och ett vanligt tecken på en föräldralös sida
Search Console-datan ger dig också en andra kontroll: de sökfrågor du rankar för men aldrig riktar dig mot. Det är ofta de enklaste tilläggen till en befintlig sida, eftersom relevansen redan är bevisad av visningarna.
Steg 4: Core Web Vitals och mobil
Googles dokumentation om Core Web Vitals definierar tre mått på användarupplevelsen och deras tröskelvärden. En sida är i det "bra" intervallet när dess Largest Contentful Paint är 2,5 sekunder eller mindre, dess Interaction to Next Paint är 200 millisekunder eller mindre och dess Cumulative Layout Shift är 0,1 eller mindre. INP blev ett stabilt Core Web Vital 2024 och ersatte First Input Delay.
Mått
Bra när
Vad det mäter
Vanlig åtgärd
LCP
2,5 sekunder eller mindre
Hur snabbt det största synliga elementet laddas
Optimera hjältebilden, minska serverns svarstid, förladda det typsnitt sidan behöver först
INP
200 millisekunder eller mindre
Hur snabbt sidan svarar på klick, tryck och tangenttryckningar under besöket
Dela upp långa JavaScript-uppgifter, ta bort tunga tredjepartsskript, undvik att blockera huvudtråden vid laddning
CLS
0,1 eller mindre
Hur mycket innehåll som förflyttas medan sidan laddas
Ange bredd och höjd på bilder och inbäddningar, reservera utrymme för banners och annonser, undvik sent laddade element ovanför den synliga delen
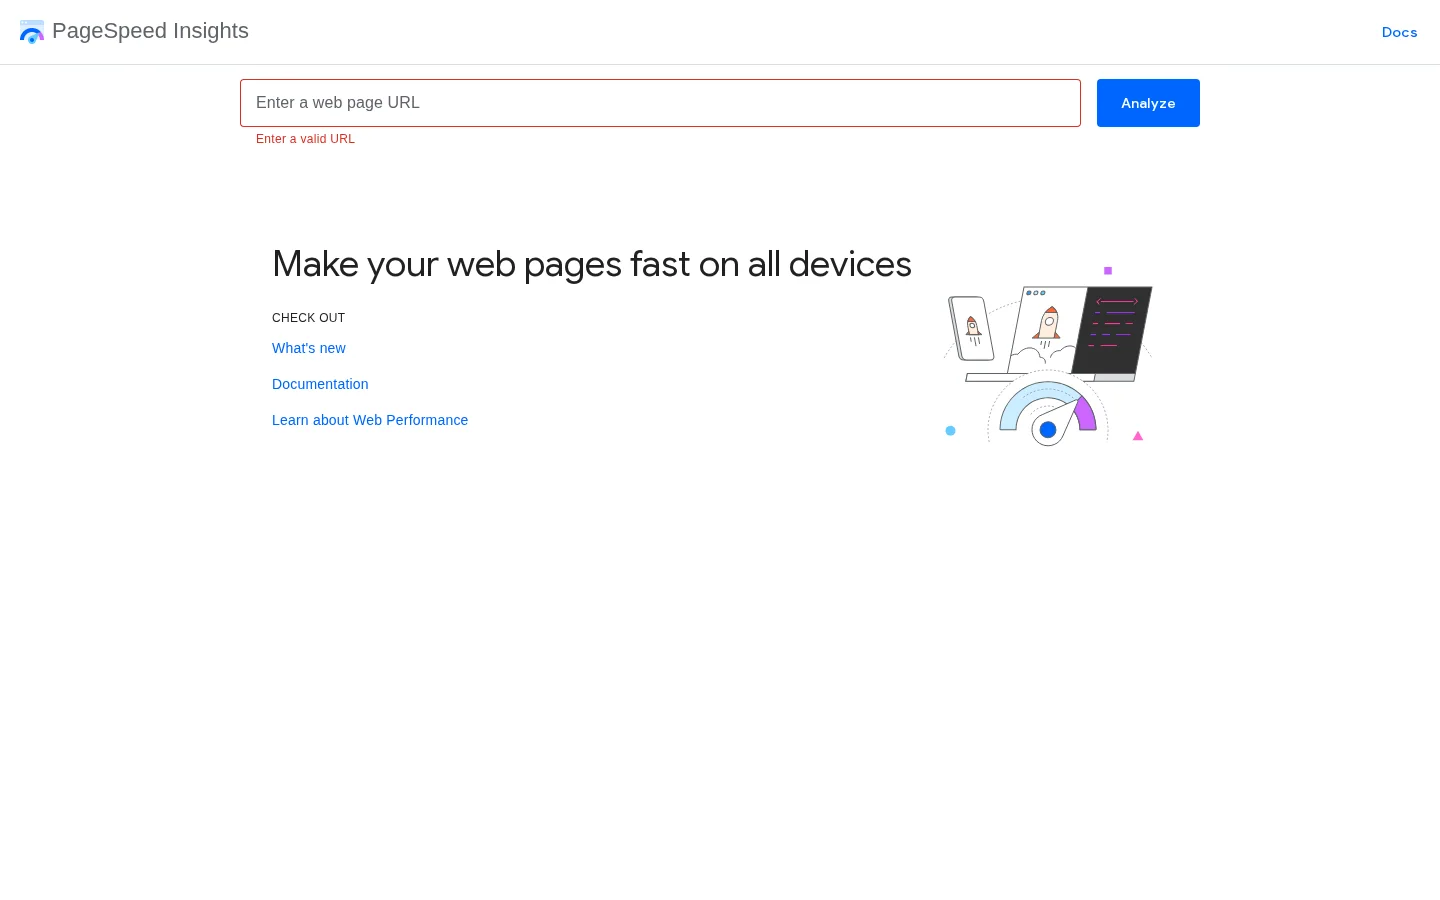
Läs fältdata före labbdata. Fältdata kommer från riktiga Chrome-användare och visar om besökarna faktiskt upplever problem. Labbdata kommer från en simulerad testkörning och visar varför en sida är långsam. PageSpeed Insights visar båda: fältdata när Google har tillräckligt med trafik för URL:en, och labbdata för varje URL du testar.
PageSpeed Insights, som visar både fältdata och labbdata för valfri URL.
Testa tre till fem URL:er per mall, inte bara startsidan. En produktmall, en kategorimall och en bloggmall kan ha mycket olika poäng på samma webbplats, eftersom de laddar olika skript. En hög labbpoäng med dålig fält-INP är ett vanligt resultat på webbplatser med tunga taggshanterare och chattwidgetar. I så fall är labbtestet inte fel, men det representerar inte den interaktion användarna har med sidan efter att den laddats.
På mobil kontrollerar du tre saker. Huvudinnehållet i mobilversionen bör vara detsamma som i desktopversionen, eftersom Google främst använder mobilversionen av en sida för indexering. Strukturerad data och interna länkar bör vara samma på båda. Och ingen påträngande interstitial bör täcka innehållet när sidan öppnas. Hastighet påverkar rankingen, men den mer användbara anledningen att åtgärda den är att långsamma mallar gör att besökare lämnar innan de hunnit läsa något.
Steg 5: sidinnehåll och interna länkar
För varje viktig sida kontrollerar du titeln, rubrikerna, hur djupt svaret går, länkarna in och ut, och om en nära dubblett finns. Gör det för ett urval av sidor från varje mall, och sedan för de sidor som i sökdatan visar striking distance eller minskande klick.
Kontroll
Godkänd när
Underkänd när
Title-tagg
Nämner ämnet och sidans huvudsökfråga, och är unik på hela webbplatsen
Duplicerar en annan sida, eller är en mallstandard som enbart webbplatsens namn
H1
En per sida, anger ämnet med enkla ord
Saknas, upprepas, eller ersatt av en logotyp eller en banner
Första skärmen
Frågan som sökningen ställer besvaras nära toppen
Första skärmen är kontext och varumärkestext, och svaret kommer efter flera scrollningar
Djup
Täcker de följdfrågor människor ställer om ämnet, med detaljer
Tunt, eller fyllt med upprepade stycken
Interna länkar
Länkad från relaterade sidor, och länkar vidare till nästa logiska steg
Föräldralös, eller bara länkad från sidfoten eller sitemapen
Strukturerad data
Stämmer med det innehåll besökaren kan se på sidan
Märker upp innehåll som inte finns på sidan, eller använder fel typ
Interna länkar är den billigaste hävstången i hela auditen. En länk från en sida som redan rankar, placerad i brödtexten och med orden från målsökfrågan i ankartexten, för både sammanhang och auktoritet. Generiska ankare som "klicka här" eller "läs mer" förmedlar mycket lite betydelse. Arbeta utifrån de sidor som ger mest trafik, eftersom varje ny länk från dem når en sida med en verklig publik.
Duplicerat och nästan duplicerat innehåll förtjänar ett eget pass. Kategorifilter, sorteringsparametrar och spårningsparametrar skapar ofta många URL:er som visar samma lista. Bestäm vilken version som ska finnas, och använd sedan canonical-taggen, robots-reglerna eller parameterhanteringen som passar. Lämna inte beslutet till Google, för du kommer inte att gilla resultatet.
Tips
För en snabb första genomgång av en enskild sida kör det kostnadsfria verktyget för SEO-audit på sidan de vanliga kontrollerna av titel, rubriker, länkar och metataggar, så att du kan lägga din tid på de fynd som kräver bedömning.
Steg 6: auktoritet och länkar
Kontrollen av länkprofilen besvarar tre frågor: får du nya hänvisande domäner i ett jämnt tempo, har du förlorat länkar som betydde något, och finns det mönster som ser manipulerade ut? Exportera de hänvisande domänerna över tid från ett verktyg för bakåtlänkar, och titta sedan efter plötsliga toppar, som ofta kommer från en betald kampanj eller från spam, och efter fall, som ofta beror på utgångna sidor eller en webbplatsflytt. Vår guide till granskning av bakåtlänkar beskriver hela genomgången.
Var försiktig med verktyget för att ogiltigförklara länkar (disavow). Googles egen vägledning är att de flesta webbplatser inte behöver det. Använd det när du har ett tydligt mönster av länkar du inte förtjänat och en manuell åtgärd eller ett allvarligt problem kopplat till dem, inte för att ett verktyg för bakåtlänkar gav några domäner ett lågt betyg. Att ogiltigförklara bra länkar av misstag kostar mer än att lämna några dåliga kvar.
Steg 7: AI-synlighet och AI-crawlers
Två kontroller hör nu hemma i varje audit. Den första är åtkomst: kan AI-crawlers nå dina sidor? Kontrollera robots.txt-reglerna för varje crawler som är viktig för dig. OpenAI använder GPTBot och OAI-SearchBot, Anthropic använder ClaudeBot och Perplexity använder PerplexityBot, och de tjänar inte alla samma syfte. En enda regel för alla är sällan rätt beslut. Vår guide till AI-crawlers listar dem och deras roller.
Exemplet ovan är ett möjligt beslut, inte en rekommendation för alla webbplatser. Det låter en crawler läsa dina sidor för sökresultat och blockerar en annan som används för träning. Besluta per crawler, skriv ner beslutet och kontrollera filen efter varje driftsättning, eftersom en robots.txt som blockerar allt ofta dyker upp efter en stagingsläpp.
Den andra kontrollen är synlighet: nämner svarsmotorer dig när en köpare ställer frågan du riktar dig mot? Gör en lista med tio till tjugo prompter utifrån de verkliga frågorna i din sökdata och i dina säljsamtal. Kör dem i ChatGPT, Perplexity och Gemini, logga vilka varumärken och vilka URL:er som citeras, och upprepa varje prompt flera gånger under några dagar, eftersom svaren ändras mellan körningarna. Vår metod för AI-synlighetsaudit förklarar hur resultaten poängsätts.
Auditmetoder: vilken som passar din situation
Audits skiljer sig åt efter omfattning och efter var du börjar. Fem metoder är vanliga i praktiken. Var och en passar i en annan situation, och de flesta team kombinerar två av dem.
1. Den fullständiga tekniska auditen
Princip: täck hela webbplatsen, varje sidtyp och varje datakälla, och rangordna sedan fynden. Använd den när du förbereder en migrering, efter ett kraftigt trafikfall eller gör den första auditen av en stor webbplats. Fördel: den hittar strukturella problem som ingen granskning på sidnivå kan se, till exempel en facetterad navigering som multiplicerar URL:er. Begränsning: den är långsam och ger många fynd som kräver en andra genomgång för att ordnas. Exempel: en återförsäljare med 40000 produkt-URL:er upptäcker att en enda filterparameter skapar de flesta av dubbletterna, något som ingen enskild produktgranskning hade avslöjat.
2. Den datadrivna auditen
Princip: börja från det som förändrats i sökdatan och diagnostisera sedan bara de sidor och sökfrågor som berörs. Använd den när du kör en månatlig översyn, när en kärnuppdatering precis har rullats ut eller när teamet är litet. Fördel: arbetet prioriteras efter trafik från första minuten. Begränsning: den är blind för sidor som ännu inte har någon data, till exempel nya sektioner eller sidor som blockerats från början. Exempel: en blogg som tappat klick på fem sidor kontrollerar just de fem sidorna, upptäcker att två kannibaliserar varandra och slår ihop dem.
3. Auditen på sidnivå
Princip: kör varje kontroll på en URL och avgör sedan om den behöver skrivas om. Använd den när en enskild affärssida underpresterar, eller före en planerad omskrivning. Fördel: snabb och konkret, med en tydlig före- och efterbild. Begränsning: den kan inte visa mönster, så ett mallfel kan se ut som ett enstaka problem. Exempel: en produktsida med en bra titel och bra innehåll visar sig ha en canonical som pekar på en slutsåld variant.
4. Konkurrentgapauditen
Princip: jämför dina sidor och ämnen med de som rankar över dig för samma sökfrågor. Använd den när du planerar nytt innehåll eller nya länkar. Fördel: den visar vad marknaden belönar i praktiken, inklusive djup, format och vilka följdfrågor som täcks. Begränsning: att kopiera ledaren kan leda dig in i ett överfullt eller fel sökavsikt-ämne. Kontrollera vad de bästa resultaten faktiskt har gemensamt innan du bestämmer dig. Exempel: de fem bästa resultaten för en sökfråga besvarar alla en prisfråga på första skärmen, och ditt gör inte det.
5. AI-synlighetsauditen
Princip: kontrollera om AI-crawlers kan läsa dina sidor, och om svarsmotorer citerar dig för de frågor som spelar roll. Använd den när du behöver veta om AI-verktyg rekommenderar ditt varumärke. Fördel: den täcker en kanal som traditionella rank trackers inte visar. Begränsning: svaren varierar från körning till körning, så urvalet måste upprepas innan du drar slutsatser. Exempel: ett mjukvaruföretag citeras för en funktion det slutat sälja, vilket visar att dess jämförelsesidor är föråldrade.
Metod
Utgår från
Bäst för
Huvudsaklig begränsning
Fullständig teknisk audit
Crawlen och alla datakällor
Migreringar, stora webbplatser, kraftiga fall
Långsam, och svår att ordna utan en plan
Datadriven audit
Förändringar i sökdatan
Månatliga översyner, små team
Missar sidor utan data ännu
Audit på sidnivå
En URL
En enskild sida som underpresterar
Kan inte se mönster över hela mallar
Konkurrentgapaudit
Resultaten över dig
Nytt innehåll och nya länkar
Risk att kopiera in fel sökavsikt
AI-synlighetsaudit
Crawler-åtkomst och svarsmotorer
Att veta om AI rekommenderar dig
Svaren varierar, så urvalen måste upprepas
Snabb audit mot fullständig audit
Snabb audit
Endast sökdata och de viktigaste mallarna
Slutar med en kort, rangordnad lista
Missar strukturella problem och crawlproblem
Fullständig audit
Täcker varje sidtyp och mall
Hittar strukturella problem och crawlproblem
Långsam, och lätt att avsluta utan plan
Vårt råd är att börja med den snabba auditen och bara gå över till den fullständiga när den snabba pekar på en strukturell orsak, eller när du är på väg att ändra webbplatsens arkitektur.
Prioritera: från fynd till en plan
En audit med 400 fynd och ingen ordning är mindre värd än en med tio. Poängsätt varje fynd efter två saker: hur mycket trafik eller intäkt det riskerar, och hur svår åtgärden är. Börja med de punkter som har stor effekt och liten insats. Ta sedan de åtgärder med stor effekt som kräver mer arbete men som låser upp en hel mall, eftersom en åtgärd där ändrar tusentals sidor.
Fynd
Trafik som riskeras
Insats
Prioritet
Mallen länkar till 404-sidor från varje sida
Hög
Låg
Gör först
Affärssidor med dubblerade titlar
Hög
Låg
Gör först
Långsam LCP på kategorimallen
Hög
Medel
Planera i nästa sprint
Blogginlägg med minskande trafik
Medel
Medel
Uppdatera i ordning efter förlorade klick
Föräldralösa ordlisteidor
Låg
Låg
Samla med arbetet med interna länkar
Taggarkivsidor med tunt innehåll
Låg
Medel
Kontrollera avsikten, sedan noindex eller slå ihop
Ge varje punkt en ansvarig, ett datum och det mått du förväntar dig ska röra sig. Ett fynd utan ansvarig är en anteckning, och anteckningar ändrar inte rankingen. Mät om efter att Google har crawlat de berörda sidorna igen, vilket kan ta flera veckor, och jämför med utgångspunkten du sparade i början. När du presenterar resultaten ger mallen för SEO-auditrapporten en struktur som chefer och kunder kan läsa på tio minuter.
Om du vill ha Google- och AI-trafiken på ett ställe medan du följer upp dessa åtgärder visar GEO/SEO-dashboarden från Sorank båda sida vid sida.
En SEO-audit på 90 minuter: vad du hinner göra på ett pass
En SEO-audit på 90 minuter kontrollerar de sidor som ger mest trafik från sökningar, i en ordning som hittar de verkliga förlusterna först. Använd den när du har ett pass och behöver en rangordnad lista över åtgärder, inte en genomgång av varje URL. Begränsa arbetet till dina viktigaste sidor och en exempel-URL per mall, så är resultatet användbart samma dag.
Dela upp passet i fasta block och avbryt varje block när tiden är slut. Tidsgränsen är en del av metoden, eftersom den tvingar dig att välja.
Minuter
Uppgift
Resultat
0 till 10
Exportera 90 dagars data per sökfråga och sida från Search Console och lista de 20 sidor som har flest klick
En sparad utgångspunkt och en kortlista över sidor
10 till 25
Använd kontrollerna för striking distance och decay från steg 3 på kortlistan
Sidor som tappat klick eller ligger mellan position 8 och 20
25 till 40
Crawla en exempel-URL per mall och kontrollera statuskod, canonical och robots-direktiv
Fel, felaktiga canonicals och blockeringar, per mall
40 till 55
Öppna rapporten Sidindexering och sortera orsakerna efter antal
Statusen som påverkar flest sidor
55 till 70
Kör PageSpeed Insights på en URL per mall och läs fältdata först
Mallen med sämst fält-LCP eller INP
70 till 90
Skriv de tio viktigaste fynden med trafik som står på spel, insats och en ansvarig
En rangordnad plan du kan skicka samma dag
Varje rad besvarar en fråga, så du kan hoppa över en rad utan att förlora de andra. Om rapporten för indexering inte visar något ovanligt, lägg tiden på sökdatan i stället, vilket oftast är den snabbare vägen till en lösning.
Vad en audit på 90 minuter inte kan se
En tidsgräns döljer tre saker. Den missar strukturella problem, till exempel ett filter som multiplicerar URL:er, eftersom du bara läser stickprov. Den använder inte serverloggar, så du ser inte hur ofta sökrobotar begär en sida. Och den hoppar över länkprofilen, som kräver en fullständig export från ett verktyg för bakåtlänkar. Skriv ner dessa som öppna frågor till en senare granskning av bakåtlänkar eller en fullständig genomgång, så att den korta auditen inte ser mer komplett ut än den är.
Misstag som slösar bort ett kort pass
Det vanligaste misstaget är att börja med crawlern. En crawl av en stor webbplats kan ta längre tid än hela passet och ge fler varningar än någon hinner läsa. Börja i stället med sökdatan, och öppna crawlern bara för sidor som har klick eller visningar. Åtgärda varningarna på de sidorna först, eftersom varningar på sidor som ingen besöker inte påverkar din trafik.
Tips
Lägg passet i kalendern med en timer och en enda resultatfil. Använd kolumnerna i mallen för SEO-auditrapporten från början, så att listan är redo att delas vid minut 90.
Vanliga misstag, och hur du upptäcker och åtgärdar dem
De flesta audits innehåller samma misstag. De är lätta att undvika när du känner igen tecknen.
Att granska utan omfattning
Vad det är: auditen täcker allt, så ingenting blir klart. Så upptäcker du det: rapporten har hundratals problem, ingen med en trafiksiffra eller en ansvarig. Så åtgärdar du det: börja om med den avgränsade beskrivningen från första avsnittet, begränsa crawlen till de sidtyper som spelar roll och sortera fynden efter trafik innan du skriver något annat.
Att behandla varningar som rankingar
Vad det är: teamet åtgärdar de varningar verktyget visar i rött, även när de påverkar sidor som ingen besöker. Så upptäcker du det: antalet varningar minskar medan klicken på affärssidorna fortsätter att falla. Så åtgärdar du det: koppla samman crawlen med sökdatan och åtgärda först problemen på sidor som har trafik, visningar eller länkar.
Att lita på en enda crawl som sanningen
Vad det är: crawlern rapporterar inga fel, så teamet drar slutsatsen att webbplatsen är frisk. Så upptäcker du det: Search Console visar många "crawlad, för närvarande inte indexerad" eller "upptäckt" URL:er som crawlern aldrig flaggade. Så åtgärdar du det: jämför crawlen med sitemapen, indexeringsrapporten och serverloggarna. En crawler ser bara det den kan nå via länkar och rendering, så innehåll bakom inloggningar, skript eller facetterade filter kan saknas i dess lista.
Att åtgärda sidor i stället för mallar
Vad det är: teamet redigerar samma titel, samma bild eller samma canonical på hundratals sidor, en i taget. Så upptäcker du det: samma fynd förekommer på de flesta URL:er av en sidtyp. Så åtgärdar du det: rätta mallen en gång och kontrollera sedan ett urval av sidor för att bekräfta att ändringen fungerade överallt. En enda malländring åtgärdar hela gruppen.
Att blockera en sida för att ta bort den från sökningen
Vad det är: teamet lägger till en disallow i robots.txt för en sida de vill ha bort från Google. Så upptäcker du det: sidan finns kvar i indexet med en naken URL och inget utdrag, och rapporten visar den som blockerad. Så åtgärdar du det: tillåt crawlning, lägg till ett noindex-direktiv och vänta tills Google crawlar sidan igen. När den har fallit ur indexet kan du blockera den om du behöver, men du behöver inte göra det.
Exempel (illustrativt)
Föreställ dig en webbplats som lagt ner en serie kampanjlandningssidor och blockerat dem i robots.txt. Sidorna fortsätter att dyka upp i sökresultaten med en naken URL och ingen beskrivning, eftersom andra sajter fortfarande länkar till dem. Om du tar bort blockeringen och lägger till noindex kan Google crawla sidorna, läsa direktivet och ta bort dem från indexet.
Att jaga en perfekt labbpoäng
Vad det är: teamet optimerar för en poäng på 100 i ett labbtest och ignorerar fältdata. Så upptäcker du det: labbpoängen är hög, men fält-INP för samma mall är dålig i Search Console-rapporten för Core Web Vitals. Så åtgärdar du det: profilera de interaktioner riktiga användare gör, oftast efter att sidan laddats. Leta efter långa uppgifter som utlöses av skript, inte efter laddningstiden för den första renderingen.
Hur ofta du ska köra en audit
Kör en snabb audit varje månad på sökdatan och på dina viktigaste mallar. Kör en fullständig audit efter en migrering, en redesign, ett byte av CMS eller ett plötsligt trafikfall, och gör en fullständig genomgång en gång om året för att fånga strukturell drift. Sökdatan bör bevakas löpande, eftersom ett klickfall är mer användbart som larm än som en kalenderpåminnelse.
Webbplatsaudit: en upprepbar hälsokontroll för hela domänen
En webbplatsaudit är en crawl av varje nåbar URL på en domän, redovisad efter typ av problem och allvarlighetsgrad. Den visar vad som är trasigt på hela webbplatsen, inklusive mönster som en granskning sida för sida missar. Den säger inte vilken åtgärd som flyttar rankingen, så kombinera den med sökdatan.
Ange crawlens omfattning innan du börjar
Filter, sorteringsalternativ och spårningstaggar kan skapa betydligt fler URL:er än du har sidor, och de flesta visar samma lista. Exkludera dessa parametrar och mediefiler, och crawla varje subdomän som ett eget projekt. Håll förfrågningsfrekvensen låg så att servern förblir snabb för riktiga besökare. Behåll pagineringen (page=) i omfattningen, eftersom paginerade listor kan innehålla sidor du vill ha indexerade.
De flesta crawlers accepterar exkluderingsregler skrivna som reguljära uttryck som dessa. Testa dem på en kort crawl och kontrollera att antalet URL:er bara minskar för de parametrar du tänkt exkludera.
Läs allvarlighetsgraden före poängen
Varje verktyg grupperar problem i nivåer och räknar ut sin egen hälsopoäng. Namnen skiljer sig mellan verktygen, men logiken för prioriteringen är densamma. En poäng är en trendlinje för ett verktyg med fasta inställningar, inte ett betyg som Google delar ut. Gå igenom nivåerna i den här ordningen:
Nivå
Typiska problem
Första åtgärd
Fel på indexerbara sidor
4xx- eller 5xx-svar på URL:er du vill ha rankade, trasiga interna länkar
Åtgärda först, börja med sidorna som redan ger klick
Fel på sidor du inte vill ha indexerade
Trasiga interna sökningar, filter eller avslutade kampanj-URL:er
Ta bort de interna länkar som fortfarande pekar dit
Varningar
För långa titlar, saknade beskrivningar, dubbla rubriker
Åtgärda i omgångar, helst med en enda malländring
Notiser
Mindre optimeringstips
Granska en gång, och agera bara om de återkommer på sidor som säljer
Jämför två crawlar, inte två poäng
Det mest användbara resultatet från en webbplatsaudit är skillnaden mellan två körningar. Exportera problemlistan från den senaste körningen, crawla igen med samma inställningar och jämför antalet per problemtyp och per URL. Nya problem kommer först, eftersom ett nytt fel på en live-sida oftast följer en nylig release. Matcha varje ny grupp mot din ändringslogg innan du tilldelar en ansvarig.
Till exempel: första körningen visar 42 fel. Den andra, fyra veckor senare, visar 57, och 15 av de nya ligger på en prismall som gick live den veckan. Du åtgärdar mallen en gång. Om antalet sjunker tillbaka mot 42 fungerade åtgärden, och körningen blir utgångspunkt för nästa.
Håll rutinen tillräckligt kort för att upprepas
En webbplatsaudit som tar en hel dag kommer inte att upprepas. Spara omfattningen, exkluderingsreglerna och allvarlighetstabellen som en konfiguration, så tar nästa körning några minuter. Schemalägg crawlen och exportera samma tre filer varje gång: problemlistan, de indexerbara URL:erna och de URL:er som får klick. Vår guide till automatiserad SEO-rapportering förklarar vad du kan automatisera och hur du ställer in det.
Om du fortfarande väljer crawler rangordnar vår jämförelse av verktyg för teknisk SEO alternativen efter vilket jobb de gör. En webbplatsaudit är bara värd att schemalägga om någon läser skillnaden mellan körningarna. Annars är den bara ytterligare en export i en mapp.
Var du ska börja den här veckan
Om du aldrig har gjort en audit, gör fyra saker i ordning. Exportera 90 dagars Search Console-data och spara den med datum. Crawla dina viktigaste mallar med en crawler, med början i den kostnadsfria versionen för 500 URL:er om din webbplats är liten. Läs indexeringsrapporten och sortera orsakerna. Åtgärda sedan de tre största mallproblemen du hittade och mät igen efter att Google har crawlat dem på nytt.
Exportera data per sökfråga och sida, och spara utgångspunkten.
Crawla en exempeladress per mall och registrera statuskoder, titlar, canonicals och robots-direktiv.
Läs indexeringsrapporten och gör om varje status till en fråga med en ansvarig.
Åtgärda de tre största mallproblemen, och jämför sedan sökdatan efter nästa crawlcykel.
En bra audit slutar inte med ett dokument. Den slutar med en kort lista över åtgärder som någon gör den här månaden, och en utgångspunkt som visar om de fungerade.
Vanliga frågor
Hur lång tid tar en SEO-audit?
Det beror på webbplatsens storlek och hur djupt du behöver gå. En fokuserad audit av dina huvudmallar och din sökdata kan göras på några dagar. En fullständig audit av en stor webbplats med många mallar tar längre tid, och större delen av tiden går till diagnos och prioritering snarare än till själva crawlen.
Vilka verktyg behöver jag för att göra en SEO-audit?
Som minimum Google Search Console och en crawler som Screaming Frog SEO Spider, plus PageSpeed Insights för hastighet. Analys och serverloggar ger användbar kontext. Betalda SEO-sviter hjälper med bakåtlänkar och konkurrentdata, men de krävs inte för en första audit.
Vad är skillnaden mellan en SEO-audit och en SEO-checklista?
En checklista listar kontrollerna som ska göras. En audit kör dessa kontroller på din webbplats, avgör vilka fynd som spelar roll och rangordnar åtgärderna efter den trafik de riskerar. Använd checklistan för att bygga auditen, och använd auditen för att välja arbetet.
y!
Få din innehållsplan för 30 dagar gratis
Vi analyserar dina konkurrenter, din webbplats och din synlighet i AI för att skapa en skräddarsydd innehållsplan, gratis.
“Jag testade Sorank på en riktig kundsajt och det är helt otroligt. Det gör allt som en byrå skulle ta 1500 dollar i månaden för. Den används nu i produktion för den kunden.”Guillaume Guersanguersanguillaume.com
“Vi är en annonsbyrå och ville få igång vår SEO på rätt spår en gång för alla. Sorank gav oss en tydlig bild av vår webbplats, hjälpte oss att prioritera optimeringarna och att strukturera vårt innehåll på rätt sätt. Verktyget är lätt att använda, väl genomtänkt för ett team och mycket praktiskt för att samla uppföljningen på ett ställe utan att jonglera med flera plattformar. En mycket stabil grund för att börja om från början med vår SEO.”Gaspard MadouiAnnonsbyrå
“Jag specialiserade mig på GEO tack vare Sorank. GEO-rankningen gör det möjligt för mig att visa mina kunder deras position jämfört med konkurrenterna i ChatGPT. Det är en verklig konkurrensfördel.”MélanieFrilans SEO-konsult
“Bra service, den fungerar bra för vår webbplats och hjälper oss att förstå hur vi kan förbättra den för att rankas bättre på Google och på andra ställen. Grattis, fortsätt så, jag rekommenderar det.”Hugo T.Handlare inom e-handel


 Search Console