Prywatność jest dla nas ważna, dlatego możesz wyłączyć niektóre rodzaje przechowywania danych, które nie są niezbędne do podstawowego działania strony. Zablokowanie kategorii może wpłynąć na Twoje doświadczenie podczas korzystania z witryny. Więcej informacji (Polityka cookies)
Dziękujemy! Twoje zgłoszenie zostało odebrane!
Ups! Podczas wysyłania formularza coś poszło nie tak.
Notatnik z checklistą audytu SEO i wydrukowanymi wykresami na biurku.
Narzędzia
Na tej stronie
W skrócie
Audyt SEO to uporządkowane sprawdzenie wszystkiego, co uniemożliwia indeksowanie, zrozumienie, kliknięcie i cytowanie Twoich stron. Wykonuj go w stałej kolejności: crawl, indeksowanie, dane z wyszukiwarki, szybkość, treść na stronie, linki, a na końcu widoczność w AI. Oceniaj każde znalezisko według ruchu, który blokuje, i zamień dziesięć najważniejszych w datowane zadania z przypisaną osobą. Skupiony audyt można zrobić w kilka dni. Pełny audyt dużej witryny trwa dłużej, a jego wynikiem powinien być plan, a nie lista.
3 dni za darmo, potem rezygnujesz, kiedy chcesz. 90-dniowa gwarancja wyników, obowiązują warunki.
Czym jest audyt SEO, a czym nie
Audyt SEO odpowiada na jedno pytanie: które problemy techniczne, treściowe i autorytetu kosztują Cię teraz wizyty i w jakiej kolejności je naprawić? To nie jest lista wszystkich znanych dobrych praktyk. Lista na 40 punktów mówi, na co patrzeć. Audyt mówi, co jest źle w Twojej witrynie, jak bardzo to ma znaczenie i co zrobić najpierw.
Trzy rzeczy bywają mylone: audyt (diagnoza), checklista (lista sprawdzeń) i raport (to, co przekazujesz klientowi lub przełożonemu). Nasz szablon raportu z audytu SEO dotyczy raportu, a lista kontrolna technicznego SEO dotyczy sprawdzeń. Ten artykuł opisuje metodę, która je łączy, oraz dane potrzebne, by rozstrzygnąć, co ma znaczenie.
Dwa sposoby na zlecenie tego samego audytu
Mglisty brief
Sprawdź witrynę pod kątem problemów SEO
Wynik: długa lista ostrzeżeń, której nikt nie czyta
Precyzyjny brief
Znajdź strony, które straciły kliknięcia w ciągu ostatnich 90 dni
Wynik: dziesięć poprawek uszeregowanych według zagrożonego ruchu
Różnica nie tkwi w nakładzie pracy, lecz w pytaniu. Precyzyjny brief nazywa strony, okres i decyzję, więc każde sprawdzenie ma uzasadnienie.
Przed startem: dostęp, zakres i punkt odniesienia
Większość audytów zawodzi jeszcze przed pierwszym crawlem, bo nikt nie uzgodnił zakresu ani nie zapisał punktu startowego. Ustal trzy rzeczy, zanim otworzysz jakiekolwiek narzędzie.
Zakres. Która domena i subdomeny, które kraje i języki, które typy stron mają znaczenie. W sklepie internetowym to strona główna, kategorie, produkty, blog i ewentualne strony docelowe. Zapisz je.
Dostęp. Uprawnienia właściciela w Search Console dla każdej usługi (wersje http, https, www i bez www, jeśli istnieją), dostęp do odczytu analityki oraz dostęp do CMS lub logów serwera, jeśli je masz. Logi serwera pokazują, o co naprawdę proszą boty, czego żadna symulacja crawlera nie pokaże.
Punkt odniesienia. Zrzut kliknięć, wyświetleń, średniej pozycji i stron, które dają większość kliknięć, zapisany w arkuszu z datą. Bez niego nie udowodnisz, że poprawka zadziałała.
Zanim zaczniesz crawlować
Potwierdź uprawnienia właściciela w Search Console dla każdej usługi
Wyeksportuj 90 dni danych o zapytaniach i stronach i zapisz je z dzisiejszą datą
Wypisz główne typy stron i po jednym przykładowym adresie URL dla każdego
Zapisz cel w jednym zdaniu: więcej kliknięć na strony sprzedażowe, mniej błędów, szybsze szablony
Wybierz crawler i jego limity (patrz sekcja o crawlu poniżej)
Audyt czyta całą strukturę witryny, zanim naprawi jakąkolwiek pojedynczą stronę.
Metoda w kolejności: siedem etapów
Kolejność ma znaczenie. Crawl mówi, co istnieje w witrynie. Indeksowanie mówi, co Google zachowuje. Dane z wyszukiwarki mówią, co ludzie znajdują i klikają. Szybkość, treść i linki wyjaśniają, dlaczego strona słabo wypada. Jeśli zrobisz to odwrotnie, spędzisz godziny na przepisywaniu strony, której Google w ogóle nie może zaindeksować.
Siedem etapów audytu SEO
Przeskanuj witrynęZapisz każdy adres URL z kodem statusu, tytułem, canonical, dyrektywami robots i linkami wewnętrznymi.
Sprawdź indeksowaniePorównaj to, co publikujesz, z tym, co Google indeksuje, i przeczytaj powód każdego wykluczenia.
Przeczytaj dane z wyszukiwarkiZnajdź strony i zapytania, które zyskują lub tracą kliknięcia, oraz te tuż pod szczytem pierwszej strony.
Testuj szybkość i mobileMierz Core Web Vitals na każdym szablonie, zaczynając od danych terenowych od prawdziwych użytkowników.
Przejrzyj treść na stronieSprawdź tytuły, nagłówki, głębokość, duplikaty i linki wewnętrzne, strona po stronie i szablon po szablonie.
Oceń autorytet i linkiPrzyjrzyj się domenom odsyłającym w czasie, utraconym linkom, tekstom kotwic i sygnałom spamu.
Sprawdź widoczność w AIPotwierdź, że crawlery AI mogą dotrzeć do Twoich stron, i sprawdź, czy silniki odpowiedzi Cię wymieniają.
Kontrole przed audytem SEO: co potwierdzić, zanim zaufasz danym
Kontrole przed audytem SEO potwierdzają, że witryna, którą zamierzasz badać, to ta sama, którą widzą Google i użytkownicy, oraz że twoje dane są na tyle wiarygodne, by na nich działać. Poświęć na nie około godziny przed jakimkolwiek przeskanowaniem. Zła właściwość w narzędziach, aktywna reguła z witryny testowej albo uszkodzone śledzenie mogą sprawić, że każde późniejsze ustalenie będzie błędne, a crawl nie pokaże żadnego z tych problemów.
Potwierdź, która wersja witryny jest aktywna
Sprawdź każdy wariant domeny: http, https, z www i bez www, z końcowym ukośnikiem i bez niego. Każdy powinien kończyć się pod tym samym adresem końcowym, najlepiej po jednym przekierowaniu. Dwie aktywne wersje rozdzielają linki i sygnały, a crawler zgłosi obie jako prawidłowe.
Odczytaj nagłówek Location każdej odpowiedzi. Powinien wskazywać bezpośrednio na preferowany adres, a nie na kolejne przekierowanie. Powtórz sprawdzenie na stronie głównej i na jednej głębszej stronie, bo reguły przekierowań często różnią się między szablonami.
Sprawdź, czy na witrynę produkcyjną nie trafiło żadne ustawienie testowe
Ustawienia z witryny testowej to jedna z najczęstszych przyczyn nagłego spadku. Zajrzyj do działającego pliku robots.txt, znacznika meta robots i nagłówka X-Robots-Tag na stronie głównej oraz w jednym artykule. Reguła Disallow dla całej witryny albo pozostawiony po testach noindex mogą ukryć sekcje przed wyszukiwarką, mimo że strony nadal się wyświetlają użytkownikom. Jeśli taki problem znajdziesz, napraw go przed audytem tych sekcji, bo każde późniejsze ustalenie opisywałoby witrynę, której Google nie widzi.
Zbuduj dziennik zmian, zanim zdiagnozujesz spadek
Zapisz z datami każde wydanie, przeprojektowanie, aktualizację CMS, migrację oraz zmianę w robots lub noindex z ostatnich sześciu miesięcy. Potem porównaj te daty z początkiem każdej zmiany ruchu. Spadek, który zaczyna się w dniu wydania szablonu, wskazuje na ten szablon. Spadek bez zmian w pobliżu może wskazywać na aktualizację wyszukiwarki i wymaga innego sprawdzenia. Bez dziennika będziesz winić to, na co patrzyłeś ostatnio. Przy zmianach dotyczących adresów URL lista kontrolna migracji SEO wskazuje, co zapisać.
Sprawdź dane, na których oprzesz audyt
Porównaj kliknięcia z Search Console z sesjami organicznymi w analityce z tych samych 90 dni. Linie nie muszą być identyczne, ale powinny iść w tym samym kierunku. Jeśli się rozjeżdżają, zanim zdiagnozujesz witrynę, sprawdź tagi na kluczowych stronach, baner zgody na cookies i filtrowanie botów. Porównanie obu narzędzi wyjaśnia, co liczy każde z nich.
Etap 1: przeskanuj witrynę i napraw to, co znajdzie crawler
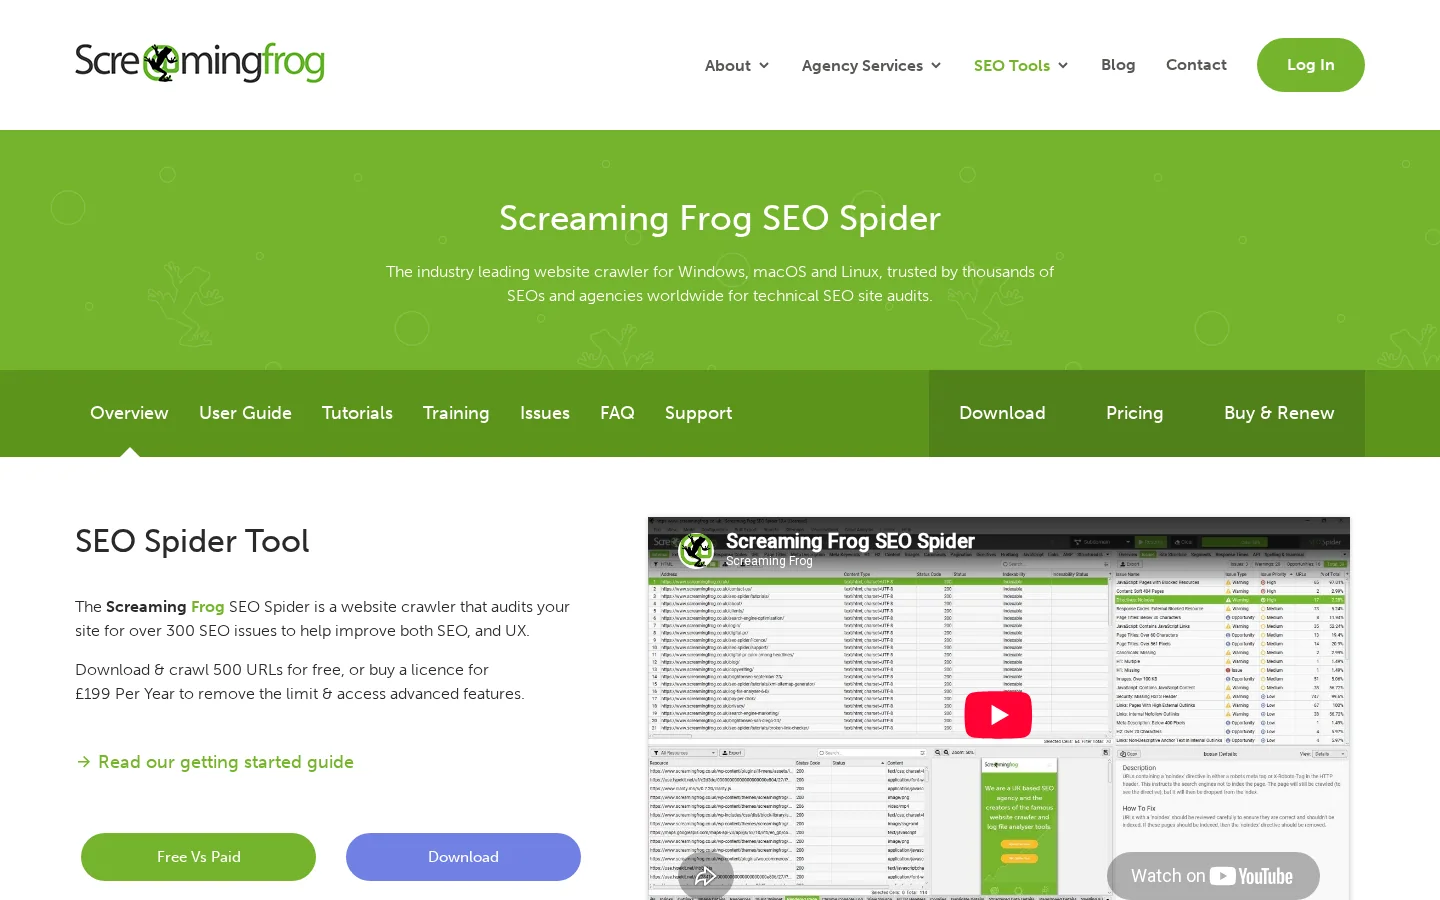
Crawler robi w mniejszej skali to, co Googlebot: zaczyna od strony, podąża za znalezionymi linkami i zapisuje, co widzi przy każdym URL. Narzędzie, którego używamy w większości audytów, to Screaming Frog SEO Spider. Jego darmowa wersja przeszukuje do 500 URL, co wystarcza dla małej witryny lub jednej sekcji dużej. Płatna licencja usuwa limit. Nasz przewodnik po Screaming Frog przeprowadza przez konfigurację.
Screaming Frog SEO Spider, desktopowy crawler, który wylicza każdy URL witryny wraz z kodem statusu i dyrektywami.
Zacznij crawl od strony głównej i od mapy witryny, a potem porównaj obie listy. Każdy URL, który pojawia się tylko w jednej, to pytanie. Ustaw crawler tak, by respektował robots.txt tak jak Googlebot, i renderował JavaScript, jeśli Twoja strona na nim polega. Crawl bez renderowania pominie treści, które widzą użytkownicy.
Kody statusu i łańcuchy przekierowań
Najpierw filtruj odpowiedzi 4xx i 5xx. Błąd 404 sam w sobie nie jest problemem. Staje się nim, gdy linki wewnętrzne wciąż na niego wskazują, bo kierują użytkowników i crawlery w ślepą uliczkę. Znajdź linki wewnętrzne prowadzące do stron błędów i wskaż je na działający URL. Potem sprawdź łańcuchy przekierowań: stary URL przekierowuje na drugi, który przekierowuje na trzeci. Każdy przeskok dokłada opóźnienie i rozmywa sygnał. Spłaszcz każdy łańcuch, tak by stary URL wskazywał bezpośrednio na ostateczny.
Sprawdź też typ przekierowania. Tymczasowe 302 użyte dla trwałej zmiany powinno być 301. Nasz przewodnik 301 kontra 302 podaje regułę decyzji.
Dyrektywy robots, noindex i canonicals
Trzy ustawienia mogą ukryć stronę bez niczyjej wiedzy. Reguła disallow w robots.txt zatrzymuje crawlowanie. Meta tag noindex albo nagłówek HTTP X-Robots-Tag zatrzymuje indeksowanie. Tag canonical wskazujący inny URL mówi wyszukiwarkom, którą wersję zachować. Sprawdź każde z nich dla każdego typu strony, bo reguła dodana, by naprawić jedną sekcję, często blokuje inną. Typowy przypadek: reguła ze środowiska testowego, której nigdy nie usunięto z robots.txt na żywej stronie.
Uwaga
Zablokowanie strony w robots.txt nie jest tym samym co usunięcie jej z wyszukiwarki. Jeśli Google nie może przeskanować strony, nie może odczytać znacznika noindex na niej. Aby usunąć stronę z indeksu, zezwól na crawlowanie i dodaj noindex, a potem poczekaj, aż Google ponownie ją przeskanuje.
Strony osierocone i głębokość kliknięcia
Strona osierocona nie ma linku wewnętrznego, który by na nią wskazywał. Crawlery znajdują ją tylko przez mapę witryny lub zewnętrzny link, a użytkownicy niemal nigdy na nią nie trafiają. Aby wykryć osierocone strony, porównaj trzy listy: URL-e, do których crawler dotarł przez linki, URL-e z mapy witryny i URL-e, które mają wizyty w analityce. Strona, która jest w mapie lub ma wizyty, ale nie ma wewnętrznego linku przychodzącego, jest kandydatem na osieroconą.
Zmierz też głębokość kliknięcia, czyli liczbę kliknięć od strony głównej. Ważna strona zakopana na piątym lub szóstym kliknięciu dostaje mało uwagi crawlerów i mało linków wewnętrznych. Podlinkuj ją z odpowiedniej strony hub i upewnij się, że sam hub jest płytko.
Tytuły, opisy i duplikaty
Filtruj brakujące tytuły, zduplikowane tytuły, zduplikowane meta opisy i tytuły zbyt długie, by wyświetlić je w całości w wynikach. Duplikaty niemal zawsze pochodzą z szablonu, a nie od autora. Szablon produktu, który wypisuje ten sam tytuł dla każdego wariantu, generuje setki duplikatów, a naprawa szablonu naprawia je wszystkie naraz. Traktuj tag title jako silną sugestię dla Google, a nie gwarancję. Google czasem go przepisuje, co jest kolejnym powodem, by utrzymywać go dokładnym i konkretnym.
Logi serwera zamykają pętlę crawla. Pokazują, które URL-e prosił Googlebot, jak często i jakie kody statusu dostał. Jeśli masz do nich dostęp, porównaj żądania z mapą witryny. Strony, w które Googlebot uderza stale, a które nie przynoszą wartości, to znak marnowania crawla, wyjaśniony w naszym haśle budżet crawla.
Etap 2: indeksowanie, co Google zachowuje i dlaczego
Raport Strony w indeksie w Search Console wylicza adresy URL, o których Google wie, i status, jaki im nadaje. Otwórz go i sortuj według przyczyny, nie według liczby. Każda przyczyna wskazuje inną naprawę. Oficjalne definicje Google, z pomocy Search Console o statusach indeksowania, są punktem odniesienia dla poniższych etykiet.
Status w raporcie
Co oznacza
Co zrobić
Odkryto, obecnie nie zindeksowano
Google znalazł URL, ale jeszcze go nie przeskanował i przełożył crawl, bo uznał, że witryna może być przeciążona
Sprawdź czasy odpowiedzi serwera i głębokość URL. Upewnij się, że linki wewnętrzne do niego prowadzą
Przeskanowano, obecnie nie zindeksowano
Google przeskanował stronę i zdecydował, że jej nie zindeksuje. Google nie indeksuje każdej strony w sieci
Najpierw sprawdź jakość: cienka treść, niemal duplikaty, słabe linki wewnętrzne. Użyj Inspekcji adresu URL na ważnych stronach
Zablokowano w robots.txt
Googlebot nie może przeskanować URL
Potwierdź, że blokada jest zamierzona. Usuń ją, jeśli strona ma się pozycjonować
Wykluczono tagiem noindex
Strona ma dyrektywę noindex
Usuń dyrektywę, jeśli strona ma się pozycjonować. Zostaw ją na stronach, które mają pozostać poza indeksem, np. wewnętrznych wynikach wyszukiwania
Praktyczna zasada: gdy cały typ strony ma wysoki udział „przeskanowano, obecnie nie zindeksowano”, najpierw spójrz na szablon, a dopiero potem na artykuły. Cienkie szablony produkują cienkie strony, a poprawa jednego artykułu nie zmieni wzorca. Nasz przewodnik po statusie przeskanowano, obecnie nie zindeksowano omawia przyczyny szczegółowo.
Dla stron, które mają znaczenie, użyj Inspekcji adresu URL po jednym URL naraz. Pokazuje datę ostatniego crawla, czy strona jest zindeksowana i canonical, który wybrał Google. Gdy wybrany canonical nie jest tym, który zadeklarowałeś, przyczyną jest niemal zawsze duplikacja lub sprzeczne sygnały, np. canonical wskazujący na przekierowany URL albo linki wewnętrzne faworyzujące wersję z parametrem.
Etap 3: dane z wyszukiwarki, gdzie są szanse
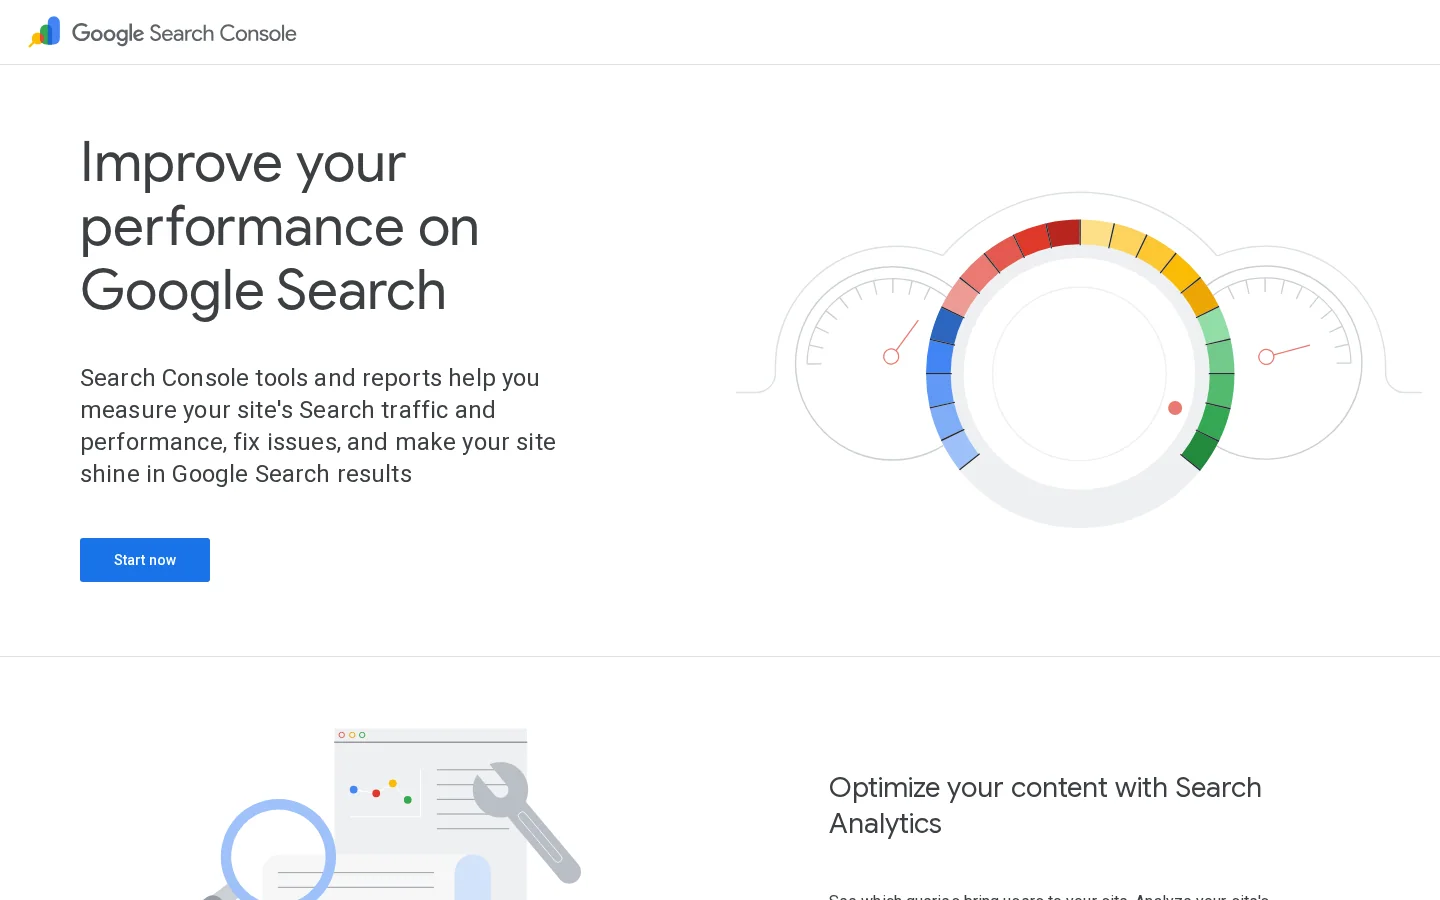
Raport Skuteczność w Search Console to najbardziej przydatny darmowy zbiór danych do audytu. Domyślnie pokazuje ostatnie trzy miesiące, co jest zbyt krótkie na trend. Wyeksportuj co najmniej 90 dni danych o zapytaniach i stronach i zachowaj plik z datą, by móc porównać go z następnym audytem. Grupuj tabelę według strony i według zapytania, a przy witrynie obsługującej więcej niż jeden rynek użyj filtrów kraju i urządzenia.
Google Search Console, źródło danych o zapytaniach, stronach i indeksowaniu użytych w audycie.
Cztery analizy znajdują w tych danych większość szans.
Zasięg (striking distance). Zapytania, dla których Twoja strona jest na pozycjach 8 do 20 z realnymi wyświetleniami. Te strony mają już trafność. Zwykle potrzebują lepszego tytułu, większej głębi odpowiedzi na zapytanie albo kilku linków wewnętrznych z powiązanych stron, a nie przepisania.
Spadek (decay). Strony, których kliknięcia spadły między dwoma równymi okresami. Porównaj ostatnie 90 dni z 90 dniami przed nimi. Najpierw patrz na stronę, potem na zapytania, które straciła, bo strona może zachować pozycję, a nową funkcję zabierze jej kliknięcia.
Kanibalizacja. Zapytania, dla których dwa lub więcej Twoich URL-i się pojawiają i z tygodnia na tydzień wymieniają się pozycjami. Wybierz jedną stronę docelową dla zapytania, potem scal słabszą stronę z nią albo uczyń obie wyraźnie różnymi pod względem intencji.
Luki w CTR. Strony na normalnej pozycji, które zdobywają mniej kliknięć niż podobne strony. Porównaj współczynnik klikalności ze średnią dla tej pozycji, potem przepisz tytuł i opis słabszych stron.
Aby wyizolować typ strony, dodaj filtr strony z wyrażeniem regularnym. Na przykład, by zobaczyć tylko strony bloga dotyczące zapytań typu „jak”, wpisz te dwie wartości:
Filtr strony (regex):      /blog-geo-seo/.*
Filtr zapytania (regex):   jak|poradnik|checklista
Współczynnik klikalności mocno zależy od góry wyników. Kilka opublikowanych liczb pomaga ocenić, czy luka jest prawdziwa. W badaniu współczynników klikalności Google pierwszy wynik organiczny dostał 27,6% kliknięć, pierwsza trójka razem 54,4%, a wyniki na drugiej stronie 0,63%.
Dlaczego pozycja pierwsza ma takie znaczenie
27,6%kliknięć trafia na pierwszy wynik organiczny
54,4%kliknięć trafia na pierwszą trójkę wyników razem
0,63%kliknięć trafia na wyniki na drugiej stronie
Źródło: Backlinko, badanie współczynników klikalności Google (backlinko.com/google-ctr-stats)
Traktuj te średnie jako kontrolę poprawności, a nie cel. Mieszają wszystkie rodzaje zapytań, a Twoje liczby zależą od intencji wyszukiwania, fraz markowych i elementów nad Twoim wpisem, takich jak filmy, obrazy czy odpowiedzi AI. Porównuj każdą stronę z podobnymi stronami w Twojej witrynie, które rankują na podobne zapytania.
Poniższe progi to punkty startowe, których używamy do wstępnej selekcji danych. Nie są regułami Google, więc dostosuj je do wielkości witryny i wolumenu zapytań.
Sprawdzenie
Startowy próg (nasza reguła kciuka)
Dlaczego to ma znaczenie
Zasięg
Średnia pozycja 8 do 20, co najmniej 50 wyświetleń w 90 dni
Popyt istnieje, a strona jest dostatecznie blisko, by się przesunąć
Spadek
Kliknięcia w dół o 30% lub więcej między dwoma równymi okresami
Utracono dość ruchu, by uzasadnić przegląd
Cienka treść
Poniżej 300 słów treści, bez nawigacji i powtarzalnych elementów
Często za mało, by odpowiedzieć na zapytanie. Krótka strona narzędziowa może być poprawna, więc sprawdź intencję
Linki wewnętrzne
Mniej niż 3 linki wewnętrzne przychodzące z indeksowalnych stron
Słaby sygnał ważności i częsty znak strony osieroconej
Dane z Search Console dają też drugą kontrolę: zapytania, na które rankujesz, ale których nigdy nie celowałeś. Są często najłatwiejszym dodatkiem do istniejącej strony, bo trafność jest już potwierdzona wyświetleniami.
Etap 4: Core Web Vitals i mobile
Dokumentacja Google o Core Web Vitals definiuje trzy miary doświadczenia użytkownika i ich progi. Strona jest w zakresie „dobrym”, gdy jej Largest Contentful Paint wynosi 2,5 sekundy lub mniej, Interaction to Next Paint 200 milisekund lub mniej, a Cumulative Layout Shift 0,1 lub mniej. INP stał się stabilnym Core Web Vital w 2024 roku, zastępując First Input Delay.
Metryka
Dobra, gdy
Co mierzy
Typowa naprawa
LCP
2,5 sekundy lub mniej
Jak szybko ładuje się największy widoczny element
Zoptymalizuj obraz główny, skróć czas odpowiedzi serwera, wstępnie załaduj czcionkę, której strona potrzebuje najpierw
INP
200 milisekund lub mniej
Jak szybko strona reaguje na kliknięcia, dotknięcia i klawisze podczas wizyty
Podziel długie zadania JavaScript, usuń ciężkie skrypty zewnętrzne, nie blokuj głównego wątku przy ładowaniu
CLS
0,1 lub mniej
Ile treści się przesuwa podczas ładowania strony
Ustaw szerokość i wysokość obrazów i osadzeń, zarezerwuj miejsce na banery i reklamy, unikaj późno ładowanych elementów nad linią zgięcia
Czytaj najpierw dane terenowe, potem laboratoryjne. Dane terenowe pochodzą od prawdziwych użytkowników Chrome i mówią, czy odwiedzający faktycznie cierpią. Dane laboratoryjne pochodzą z symulowanego testu i mówią, dlaczego strona jest wolna. PageSpeed Insights pokazuje oba: dane terenowe, gdy Google ma dość ruchu dla URL, oraz dane laboratoryjne dla każdego testowanego URL.
PageSpeed Insights, który pokazuje dane terenowe i laboratoryjne dla dowolnego URL.
Testuj trzy do pięciu URL-i na szablon, nie tylko stronę główną. Szablon produktu, kategorii i bloga mogą mieć bardzo różne wyniki w tej samej witrynie, bo ładują różne skrypty. Wysoki wynik laboratoryjny przy słabym terenowym INP to częsty wynik na witrynach z ciężkimi menedżerami tagów i czatami. Wtedy test laboratoryjny nie jest błędny, ale nie odzwierciedla interakcji, jakie użytkownik ma ze stroną po załadowaniu.
Na mobile sprawdź trzy rzeczy. Główna treść wersji mobilnej powinna być zgodna z wersją desktopową, bo Google do indeksowania używa przede wszystkim wersji mobilnej strony. Dane strukturalne i linki wewnętrzne powinny być takie same w obu. Żaden intruzywny interstitial nie powinien przysłaniać treści po wejściu. Szybkość ma znaczenie dla pozycji, ale bardziej przydatny powód do naprawy jest taki, że wolne szablony tracą odwiedzających, zanim cokolwiek przeczytają.
Etap 5: treść na stronie i linki wewnętrzne
Dla każdej ważnej strony sprawdź tytuł, nagłówki, głębokość odpowiedzi, linki przychodzące i wychodzące oraz to, czy nie istnieje bliski duplikat. Zrób to dla próbki stron z każdego szablonu, potem dla stron, które w danych z wyszukiwarki widnieją jako zasięg lub spadek.
Sprawdzenie
Zaliczone, gdy
Niezaliczone, gdy
Tag title
Nazywa temat i główne zapytanie strony i jest unikalny w całej witrynie
Duplikuje inną stronę albo jest domyślnym szablonem, np. samą nazwą witryny
H1
Jeden na stronę, podaje temat prostymi słowami
Brakuje, się powtarza albo zastępuje go logo lub baner
Pierwszy ekran
Pytanie zapytania ma odpowiedź blisko góry
Pierwszy ekran to kontekst i tekst marki, a odpowiedź pojawia się po kilku przewinięciach
Głębia
Obejmuje podpytania, które ludzie zadają o temacie, z konkretami
Cienka lub wypełniona powtarzającymi się akapitami
Linki wewnętrzne
Linkowana z powiązanych stron i prowadzi dalej do kolejnego logicznego kroku
Osierocona albo linkowana tylko ze stopki lub mapy witryny
Dane strukturalne
Zgodne z treścią widoczną dla odwiedzającego na stronie
Oznaczają treść, której nie ma na stronie, albo używają złego typu
Linki wewnętrzne to najtańsza dźwignia w całym audycie. Link ze strony, która już rankuje, umieszczony w treści i używający słów zapytania docelowego w kotwicy, przekazuje zarówno kontekst, jak i autorytet. Ogólne kotwice, takie jak „kliknij tutaj” lub „czytaj więcej”, przekazują bardzo mało znaczenia. Zacznij od stron, które przynoszą najwięcej ruchu, bo każdy nowy link z nich trafia na stronę z realnymi odbiorcami.
Duplikaty i niemal duplikaty treści zasługują na osobne przejście. Filtry kategorii, parametry sortowania i parametry śledzenia często tworzą wiele URL-i pokazujących tę samą listę. Zdecyduj, która wersja ma istnieć, potem użyj tagu canonical, reguł robots lub obsługi parametrów, które pasują. Nie zostawiaj decyzji Google, bo wynik może Ci się nie spodobać.
Wskazówka
W szybkim pierwszym przejściu po pojedynczej stronie darmowe narzędzie audytu SEO na stronie uruchamia typowe sprawdzenia tytułu, nagłówków, linków i meta tagów, dzięki czemu czas poświęcasz na ustalenia wymagające oceny.
Etap 6: autorytet i linki
Kontrola profilu linków odpowiada na trzy pytania: czy zyskujesz domeny odsyłające w stałym tempie, czy straciłeś ważne linki i czy są wzorce wyglądające na sztuczne? Wyeksportuj domeny odsyłające w czasie z narzędzia do linków zwrotnych, potem szukaj nagłych skoków, które często pochodzą z płatnej kampanii lub spamu, oraz spadków, które często wynikają z wygasłych stron lub migracji. Nasz przewodnik po audycie linków zwrotnych przedstawia pełny przegląd.
Uważaj na narzędzie do odrzucania linków (disavow). Wytyczne samego Google mówią, że większość witryn go nie potrzebuje. Używaj go, gdy masz wyraźny wzorzec linków, których nie zdobyłeś, i ręczną karę lub poważny problem z nimi związany, a nie dlatego, że narzędzie do linków dało niską ocenę niektórym domenom. Błędne odrzucenie dobrych linków kosztuje więcej niż pozostawienie kilku złych.
Etap 7: widoczność w AI i crawlery AI
Dwie kontrole należą dziś do każdego audytu. Pierwsza to dostęp: czy crawlery AI mogą dotrzeć do Twoich stron? Sprawdź reguły robots.txt dla każdego crawlera, który ma dla Ciebie znaczenie. OpenAI używa GPTBot i OAI-SearchBot, Anthropic używa ClaudeBot, a Perplexity PerplexityBot, i nie wszystkie służą temu samemu celowi. Jedna reguła dla wszystkich rzadko jest właściwą decyzją. Nasz przewodnik po crawlerach AI wymienia je i ich role.
Powyższy przykład to jedna z możliwych decyzji, a nie zalecenie dla każdej witryny. Pozwala jednemu crawlerowi czytać strony na potrzeby odpowiedzi wyszukiwania i blokuje inny, używany do trenowania. Podejmuj decyzję dla każdego crawlera osobno, zapisz ją i sprawdzaj plik po każdym wdrożeniu, bo robots.txt blokujący wszystko często pojawia się po wydaniu na środowisko testowe.
Druga kontrola to widoczność: czy silniki odpowiedzi wymieniają Cię, gdy kupujący zadaje pytanie, na które celujesz? Zbuduj listę dziesięciu do dwudziestu promptów z prawdziwych pytań z danych wyszukiwania i rozmów sprzedażowych. Uruchom je w ChatGPT, Perplexity i Gemini, zapisz, które marki i które URL-e są cytowane, i powtarzaj każdy prompt kilka razy przez kilka dni, bo odpowiedzi zmieniają się między uruchomieniami. Metoda audytu widoczności AI wyjaśnia, jak oceniać wyniki.
Metody audytu: która pasuje do Twojej sytuacji
Audyty różnią się zakresem i miejscem, w którym zaczynasz. W praktyce używa się pięciu metod. Każda pasuje do innej sytuacji, a większość zespołów łączy dwie z nich.
1. Pełny audyt techniczny
Zasada: objąć całą witrynę, każdy typ strony i każde źródło danych, potem uszeregować ustalenia. Użyj, gdy przygotowujesz migrację, po gwałtownym spadku ruchu albo robisz pierwszy audyt dużej witryny. Zaleta: znajduje problemy strukturalne, których żaden przegląd pojedynczych stron nie zobaczy, na przykład nawigację fasetową mnożącą URL-e. Ograniczenie: jest powolny i produkuje wiele ustaleń wymagających drugiego przejścia, by je uporządkować. Przykład: sprzedawca z 40000 URL-i produktów odkrywa, że jeden parametr filtra tworzy większość duplikatów, czego żaden przegląd pojedynczego produktu by nie ujawnił.
2. Audyt oparty na danych
Zasada: zacznij od tego, co zmieniło się w danych z wyszukiwarki, i diagnozuj tylko zaangażowane strony i zapytania. Użyj, gdy robisz comiesięczny przegląd, tuż po wdrożeniu aktualizacji algorytmu albo gdy zespół jest mały. Zaleta: praca jest od pierwszej minuty uszeregowana według ruchu. Ograniczenie: jest ślepy na strony, które nie mają jeszcze danych, np. nowe sekcje lub strony zablokowane od początku. Przykład: blog, który stracił kliknięcia na pięciu stronach, sprawdza te pięć, znajduje dwie kanibalizujące się i je scala.
3. Audyt na poziomie strony
Zasada: wykonaj wszystkie sprawdzenia na jednym URL, potem zdecyduj, czy potrzebuje przepisania. Użyj, gdy pojedyncza strona sprzedażowa słabo wypada albo przed planowanym przepisaniem. Zaleta: szybki i konkretny, z wyraźnym stanem przed i po. Ograniczenie: nie widzi wzorców, więc błąd szablonu może wyglądać jak jednorazowy problem. Przykład: strona produktu z dobrym tytułem i treścią okazuje się mieć canonical wskazujący na wariant niedostępny w magazynie.
4. Audyt luki konkurencyjnej
Zasada: porównaj swoje strony i tematy z tymi, które rankują nad Tobą na te same zapytania. Użyj, gdy planujesz nowe treści lub nowe linki. Zaleta: pokazuje, co rynek w praktyce nagradza, w tym głębię, format i podpytania. Ograniczenie: kopiowanie lidera może wprowadzić Cię w zatłoczony temat albo temat o złej intencji. Sprawdź, co mają wspólnego najlepsze wyniki, zanim zdecydujesz. Przykład: pierwszych pięć wyników dla zapytania odpowiada w pierwszym ekranie na pytanie o cenę, a Twój nie.
5. Audyt widoczności w AI
Zasada: sprawdź, czy crawlery AI mogą czytać Twoje strony i czy silniki odpowiedzi cytują Cię w pytaniach, które mają znaczenie. Użyj, gdy musisz wiedzieć, czy narzędzia AI polecają Twoją markę. Zaleta: obejmuje kanał, którego tradycyjne narzędzia do pozycji nie pokazują. Ograniczenie: odpowiedzi różnią się między uruchomieniami, więc próbkę trzeba powtarzać, zanim wyciągniesz wnioski. Przykład: firma programistyczna jest cytowana za funkcję, którą przestała sprzedawać, co pokazuje, że jej strony porównawcze są przestarzałe.
Metoda
Punkt wyjścia
Najlepsza dla
Główne ograniczenie
Pełny audyt techniczny
Crawl i wszystkie źródła danych
Migracji, dużych witryn, gwałtownych spadków
Powolny i trudny do uporządkowania bez planu
Audyt oparty na danych
Zmiany w danych z wyszukiwarki
Comiesięcznych przeglądów, małych zespołów
Pomija strony bez jeszcze danych
Audyt na poziomie strony
Pojedynczy URL
Jednej słabo działającej strony
Nie widzi wzorców szablonowych
Audyt luki konkurencyjnej
Wyniki powyżej Ciebie
Nowych treści i nowych linków
Ryzyko kopiowania złej intencji
Audyt widoczności w AI
Dostęp crawlerów i silniki odpowiedzi
Sprawdzenia, czy AI Cię poleca
Odpowiedzi się różnią, więc próbki muszą się powtarzać
Szybki audyt kontra pełny audyt
Szybki audyt
Tylko dane z wyszukiwarki i główne szablony
Kończy się krótką, uszeregowaną listą
Pomija problemy strukturalne i crawlowe
Pełny audyt
Obejmuje każdy typ strony i szablon
Znajduje problemy strukturalne i crawlowe
Powolny i łatwo skończyć bez planu
Nasza rada: zacznij od szybkiego audytu, a przejdź do pełnego dopiero wtedy, gdy szybki wskaże przyczynę strukturalną albo gdy zamierzasz zmienić architekturę witryny.
Priorytetyzacja: od ustaleń do planu
Audyt z 400 ustaleniami bez kolejności jest wart mniej niż ten z dziesięcioma. Oceń każde ustalenie w dwóch wymiarach: ile ruchu lub przychodu zagraża i jak trudna jest naprawa. Zacznij od pozycji o dużym wpływie i małym nakładzie. Potem weź pozycje o dużym wpływie, które wymagają więcej pracy, ale odblokowują cały szablon, bo jedna poprawka tam zmienia tysiące stron.
Ustalenie
Zagrożony ruch
Nakład
Priorytet
Szablon linkuje do stron 404 z każdej strony
Wysoki
Niski
Zrób najpierw
Strony sprzedażowe z zduplikowanymi tytułami
Wysoki
Niski
Zrób najpierw
Powolny LCP w szablonie kategorii
Wysoki
Średni
Zaplanuj w następnym sprincie
Wpisy na blogu ze spadkiem
Średni
Średni
Odśwież w kolejności utraconych kliknięć
Osierocone strony glosariusza
Niski
Niski
Połącz z pracą nad linkowaniem wewnętrznym
Strony archiwum tagów z cienką treścią
Niski
Średni
Sprawdź intencję, potem noindex lub konsolidacja
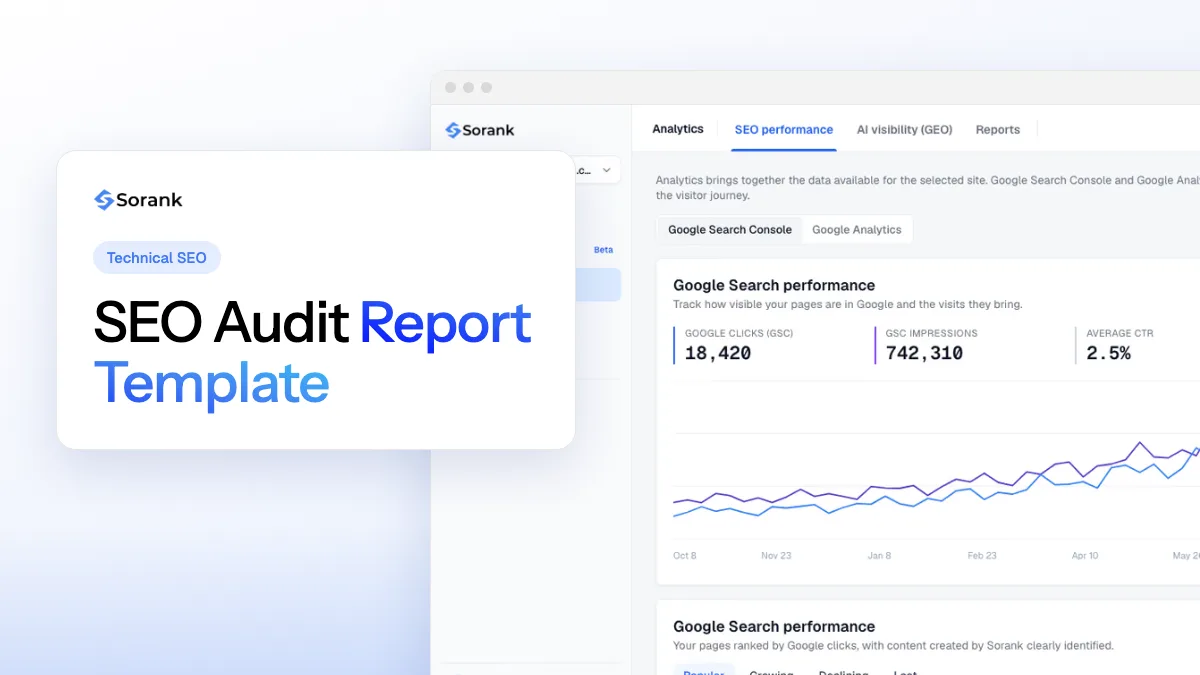
Każdej pozycji przypisz właściciela, termin i wskaźnik, który ma się poruszyć. Ustalenie bez właściciela to notatka, a notatki nie zmieniają pozycji. Mierz ponownie po tym, jak Google ponownie przeskanuje dotknięte strony, co może zająć tygodnie, i porównaj z punktem odniesienia zapisanym na początku. Prezentując wyniki, szablon raportu z audytu SEO daje strukturę, którą menedżerowie i klienci przeczytają w dziesięć minut.
Jeśli chcesz mieć ruch z Google i z AI w jednym miejscu podczas śledzenia tych napraw, panel GEO / SEO Sorank pokazuje oba obok siebie.
Audyt SEO w 90 minut: co można zrobić w jednej sesji
Audyt SEO w 90 minut sprawdza strony, które przynoszą najwięcej ruchu z wyszukiwarki, w kolejności, która najszybciej wykrywa realne straty. Używaj go, gdy masz jedną sesję i potrzebujesz uporządkowanej listy poprawek, a nie przeglądu każdego adresu. Ogranicz pracę do najważniejszych stron i jednego przykładowego URL z każdego szablonu, a wynik będzie użyteczny tego samego dnia.
Podziel sesję na stałe bloki i zatrzymuj każdy z nich, gdy skończy się jego czas. Limit czasu jest częścią metody, bo zmusza do wyborów.
Minuty
Zadanie
Wynik
0 do 10
Wyeksportuj 90 dni danych o zapytaniach i stronach z Search Console i zestaw 20 stron z największą liczbą kliknięć
Zapisany punkt odniesienia i krótka lista stron
10 do 25
Zastosuj do tej listy kontrole pozycji tuż za pierwszą stroną i spadku z etapu 3
Strony, które straciły kliknięcia lub są na pozycjach od 8 do 20
25 do 40
Przeskanuj jeden przykładowy URL z każdego szablonu i sprawdź kod statusu, canonical oraz dyrektywy robots
Błędy, złe canonicale i blokady, w podziale na szablony
40 do 55
Otwórz raport Indeksowanie stron i posortuj przyczyny według liczby
Status, który dotyczy największej liczby stron
55 do 70
Uruchom PageSpeed Insights dla jednego URL z każdego szablonu, czytając najpierw dane terenowe
Szablon z najsłabszym terenowym LCP lub INP
70 do 90
Zapisz dziesięć najważniejszych ustaleń z ruchem zagrożonym, nakładem pracy i osobą odpowiedzialną
Uporządkowany plan, który możesz wysłać tego samego dnia
Każdy wiersz odpowiada na jedno pytanie, więc możesz pominąć jeden wiersz bez utraty pozostałych. Jeśli raport indeksowania nie pokazuje nic niezwykłego, poświęć ten czas danym z wyszukiwarki, które zwykle prowadzą do poprawki szybciej.
Czego nie widzi audyt w 90 minut
Limit czasu ukrywa trzy rzeczy. Pomija problemy strukturalne, takie jak filtr mnożący adresy URL, bo czytasz tylko próbki. Nie korzysta z logów serwera, więc nie widzisz, jak często crawlery pobierają daną stronę. Pomija też profil linków, który wymaga pełnego eksportu z narzędzia do analizy backlinków. Zapisz te kwestie jako otwarte pytania na późniejszy audyt backlinków lub pełny przegląd, aby krótki audyt nie wyglądał na bardziej kompletny, niż jest.
Błędy, które marnują krótką sesję
Najczęstszy błąd to zaczynanie od crawlera. Przeskanowanie dużej witryny może zająć więcej czasu niż cała sesja i zwrócić więcej ostrzeżeń, niż ktokolwiek zdoła przeczytać. Zacznij od danych z wyszukiwarki i otwieraj crawler tylko dla stron z kliknięciami lub wyświetleniami. Najpierw napraw ostrzeżenia na tych stronach, bo ostrzeżenia na stronach, których nikt nie odwiedza, nie zmieniają twojego ruchu.
Wskazówka
Zaplanuj sesję w kalendarzu z minutnikiem i jednym plikiem wynikowym. Używaj kolumn z szablonu raportu z audytu SEO od początku, żeby lista była gotowa do udostępnienia w 90. minucie.
Typowe błędy, jak je rozpoznać i naprawić
Większość audytów zawiera te same błędy. Łatwo ich uniknąć, gdy znasz sygnały ostrzegawcze.
Audyt bez zakresu
Czym jest: audyt obejmuje wszystko, więc nic nie zostaje skończone. Jak go rozpoznać: raport ma setki problemów, żaden z szacunkiem ruchu lub właścicielem. Jak naprawić: zacznij od nowa z precyzyjnym briefem z pierwszej sekcji, ogranicz crawl do typów stron, które mają znaczenie, i uszereguj ustalenia według ruchu, zanim cokolwiek innego napiszesz.
Traktowanie ostrzeżeń jak rankingów
Czym jest: zespół naprawia ostrzeżenia, które narzędzie pokazuje na czerwono, nawet gdy dotyczą stron, których nikt nie odwiedza. Jak go rozpoznać: liczba ostrzeżeń spada, a kliknięcia na strony sprzedażowe wciąż maleją. Jak naprawić: połącz crawl z danymi z wyszukiwarki i najpierw napraw problemy na stronach, które mają ruch, wyświetlenia lub linki.
Ufanie jednemu crawlowi jako prawdzie
Czym jest: crawler nie zgłasza błędów, więc zespół uznaje witrynę za zdrową. Jak go rozpoznać: Search Console raportuje wiele URL-i „przeskanowano, obecnie nie zindeksowano” lub „odkryto”, których crawler nigdy nie oznaczył. Jak naprawić: porównaj crawl z mapą witryny, raportem indeksowania i logami serwera. Crawler widzi tylko to, do czego może dotrzeć przez linki i renderowanie, więc treść za logowaniem, skryptami lub filtrami fasetowymi może być na jego liście nieobecna.
Naprawianie stron zamiast szablonów
Czym jest: zespół edytuje ten sam tytuł, ten sam obraz lub ten sam canonical na setkach stron, jedna po drugiej. Jak go rozpoznać: to samo ustalenie pojawia się na większości URL-i jednego typu strony. Jak naprawić: napraw szablon raz, potem sprawdź próbkę stron, by potwierdzić, że zmiana zadziałała wszędzie. Jedna zmiana szablonu naprawia całą grupę.
Blokowanie strony, by usunąć ją z wyszukiwarki
Czym jest: zespół dodaje disallow w robots.txt do strony, którą chce wyrzucić z Google. Jak go rozpoznać: strona zostaje w indeksie jako goły URL bez fragmentu, a raport pokazuje ją jako zablokowaną. Jak naprawić: zezwól na crawlowanie, dodaj dyrektywę noindex i poczekaj, aż Google ponownie przeskanuje stronę. Gdy wypadnie z indeksu, możesz ją zablokować, jeśli musisz, ale nie musisz.
Przykład (poglądowy)
Wyobraź sobie witrynę, która wycofała zestaw stron kampanii i zablokowała je w robots.txt. Strony nadal pojawiają się w wyszukiwarce jako goły URL bez opisu, bo inne witryny wciąż do nich linkują. Usunięcie blokady i dodanie noindex pozwala Google przeskanować strony, odczytać dyrektywę i usunąć je z indeksu.
Pogoń za idealnym wynikiem laboratoryjnym
Czym jest: zespół optymalizuje pod wynik 100 w teście laboratoryjnym i ignoruje dane terenowe. Jak go rozpoznać: wynik laboratoryjny jest wysoki, ale terenowy INP dla tego samego szablonu jest słaby w raporcie Core Web Vitals Search Console. Jak naprawić: profiluj interakcje, które wykonują prawdziwi użytkownicy, zwykle po załadowaniu strony. Szukaj długich zadań wywołanych przez skrypty, a nie czasu ładowania pierwszego renderu.
Jak często robić audyt
Uruchamiaj szybki audyt co miesiąc na danych z wyszukiwarki i na najważniejszych szablonach. Pełny audyt rób po migracji, redesignie, zmianie CMS lub nagłym spadku ruchu, a raz w roku pełny przegląd, by wychwycić dryf strukturalny. Dane z wyszukiwarki warto obserwować stale, bo spadek kliknięć jest bardziej przydatny jako alert niż jako przypomnienie w kalendarzu.
Audyt witryny: powtarzalna kontrola kondycji całej domeny
Audyt witryny to crawl każdego dostępnego adresu URL w jednej domenie, z raportem według typu problemu i wagi. Pokazuje, co jest zepsute w całej witrynie, w tym wzorce, których przegląd strona po stronie nie wychwytuje. Nie mówi jednak, która poprawka podniesie pozycje, dlatego zestaw go z danymi z wyszukiwarki.
Ustaw zakres crawla przed startem
Filtry, opcje sortowania i tagi śledzące potrafią wygenerować wielokrotnie więcej adresów URL niż stron, a większość z nich pokazuje tę samą listę. Wyklucz te parametry i pliki multimedialne, a każdą subdomenę crawluj jako osobny projekt. Utrzymuj niską liczbę zapytań, żeby serwer dalej działał szybko dla prawdziwych odwiedzających. Zostaw stronicowanie (page=) w zakresie, bo listy stronicowane mogą zawierać strony, które chcesz zaindeksować.
Większość crawlerów przyjmuje reguły wykluczeń zapisane jako wyrażenia regularne, jak powyższe. Przetestuj je na krótkim crawlu i sprawdź, czy liczba adresów spada tylko dla parametrów, które miałeś na myśli.
Najpierw poziom ważności, potem wynik
Każde narzędzie grupuje problemy w poziomy i liczy własny wynik kondycji. Nazwy różnią się między narzędziami, ale logika segregowania jest ta sama. Wynik to linia trendu jednego narzędzia przy stałych ustawieniach, a nie ocena, którą wystawia Google. Przechodź przez poziomy w tej kolejności:
Poziom
Typowe problemy
Pierwsze działanie
Błędy na stronach indeksowalnych
Odpowiedzi 4xx lub 5xx na adresach, które chcesz mieć w wynikach, zepsute linki wewnętrzne
Napraw najpierw, zaczynając od stron, które już przyciągają kliknięcia
Błędy na stronach, których nie chcesz indeksować
Zepsute wewnętrzne wyszukiwanie, filtry lub wycofane adresy kampanii
Usuń linki wewnętrzne, które wciąż na nie wskazują
Ostrzeżenia
Za długie tytuły, brakujące opisy, zduplikowane nagłówki
Naprawiaj partiami, najlepiej jedną zmianą szablonu
Uwagi
Drobne wskazówki optymalizacyjne
Przejrzyj raz i działaj tylko wtedy, gdy powtarzają się na stronach sprzedażowych
Porównaj dwa crawle, a nie dwa wyniki
Najbardziej użyteczny wynik audytu witryny to różnica między dwoma przebiegami. Wyeksportuj listę problemów z ostatniego przebiegu, uruchom crawl ponownie z tymi samymi ustawieniami i porównaj liczby według typu problemu i według adresu URL. Nowe problemy idą na pierwszy plan, bo nowy błąd na działającej stronie zwykle pojawia się po niedawnym wdrożeniu. Zanim przypiszesz właściciela, dopasuj każdy nowy klaster do dziennika zmian.
Na przykład pierwszy przebieg pokazuje 42 błędy. Drugi, cztery tygodnie później, pokazuje 57, a 15 nowych dotyczy szablonu cennika, który wszedł na żywo w tym tygodniu. Naprawiasz szablon raz. Jeśli liczba spada z powrotem w okolice 42, poprawka zadziałała, a ten przebieg staje się punktem odniesienia dla następnego.
Utrzymaj rutynę na tyle krótką, by dało się ją powtarzać
Audyt, który zajmuje cały dzień, nie będzie powtarzany. Zapisz zakres, reguły wykluczeń i tabelę poziomów jako jedną konfigurację, żeby kolejny przebieg zajął minuty. Zaplanuj crawl i eksportuj za każdym razem te same trzy pliki: listę problemów, adresy indeksowalne i adresy, które dostają kliknięcia. Nasz przewodnik po automatycznym raportowaniu SEO wyjaśnia, co zautomatyzować i jak to ustawić.
Jeśli dopiero wybierasz crawler, nasze porównanie narzędzi do technicznego SEO ustawia opcje według zadania, do którego służą. Audyt witryny warto planować tylko wtedy, gdy ktoś czyta różnicę między przebiegami. W przeciwnym razie to kolejny eksport w folderze.
Od czego zacząć w tym tygodniu
Jeśli nigdy nie robiłeś audytu, zrób cztery rzeczy w tej kolejności. Wyeksportuj 90 dni danych z Search Console i zapisz je z datą. Przeskanuj swoje główne szablony crawlerem, zaczynając od darmowej wersji 500 URL, jeśli Twoja witryna jest mała. Przeczytaj raport indeksowania i uporządkuj przyczyny. Potem napraw trzy największe problemy szablonowe, które znalazłeś, i zmierz ponownie po tym, jak Google ponownie przeskanuje strony.
Wyeksportuj dane o zapytaniach i stronach i zapisz punkt odniesienia.
Przeskanuj jeden przykładowy URL na szablon, zapisując kody statusu, tytuły, canonicals i dyrektywy robots.
Przeczytaj raport indeksowania i zamień każdy status w pytanie z właścicielem.
Napraw trzy największe problemy szablonowe, potem porównaj dane z wyszukiwarki po następnym cyklu ponownego crawla.
Dobry audyt nie kończy się dokumentem. Kończy się krótką listą napraw, którymi ktoś zajmuje się w tym miesiącu, i punktem odniesienia, który udowadnia, czy zadziałały.
Najczęściej zadawane pytania
Ile trwa audyt SEO?
Zależy od wielkości witryny i tego, jak głęboko chcesz sięgnąć. Skupiony audyt głównych szablonów i danych z wyszukiwarki można zrobić w kilka dni. Pełny audyt dużej witryny z wieloma szablonami trwa dłużej, a większość tego czasu idzie na diagnozę i priorytetyzację, a nie na sam crawl.
Jakich narzędzi potrzebuję do audytu SEO?
Co najmniej Google Search Console i crawler, taki jak Screaming Frog SEO Spider, a do szybkości PageSpeed Insights. Analityka i logi serwera dodają przydatnego kontekstu. Płatne pakiety SEO pomagają w danych o linkach i konkurencji, ale do pierwszego audytu nie są wymagane.
Czym różni się audyt SEO od checklisty SEO?
Checklista wylicza sprawdzenia do wykonania. Audyt wykonuje te sprawdzenia na Twojej witrynie, decyduje, które ustalenia mają znaczenie, i porządkuje naprawy według zagrożonego ruchu. Użyj checklisty, by zbudować audyt, a audytu, by wybrać pracę.
y!
Odbierz za darmo plan treści na 30 dni
Analizujemy Twoich konkurentów, Twoją stronę i Twoją widoczność w AI, aby bezpłatnie przygotować dla Ciebie dopasowany plan treści.
“Przetestowałem Sorank na prawdziwej stronie klienta i to jest szalone. Robi wszystko, za co agencja policzyłaby Ci $1500 miesięcznie. Teraz trafia na produkcję u tego klienta.”Guillaume Guersanguersanguillaume.com
“Jesteśmy agencją reklamową i chcieliśmy raz na zawsze uporządkować nasze SEO. Sorank dał nam przejrzysty obraz naszej strony, pomógł ustalić priorytety optymalizacji i właściwie uporządkować nasze treści. Narzędzie jest proste w obsłudze, dobrze zaprojektowane do pracy zespołowej i bardzo praktyczne do centralizacji monitoringu bez żonglowania wieloma platformami. Bardzo solidna podstawa, by zacząć SEO od nowa.”Gaspard MadouiAgencja reklamowa
“Dzięki Sorank wyspecjalizowałem się w GEO. Ranking GEO pozwala mi pokazywać klientom ich pozycję na tle konkurencji w ChatGPT. To realna przewaga handlowa.”MélanieFreelancer SEO
“Świetna usługa, dobrze działa dla naszej strony i pomaga zrozumieć, jak ją ulepszyć, aby lepiej pozycjonować się w Google i nie tylko. Gratulacje, tak trzymać, polecam.”Hugo T.Sprzedawca e-commerce


 Search Console