Налаштування
Ми цінуємо вашу приватність, тому ви можете вимкнути певні типи зберігання даних, які не потрібні для базової роботи вебсайту. Блокування категорій може вплинути на ваш досвід користування сайтом. Докладніше
Ми цінуємо вашу приватність, тому ви можете вимкнути певні типи зберігання даних, які не потрібні для базової роботи вебсайту. Блокування категорій може вплинути на ваш досвід користування сайтом. Докладніше

Проведіть SEO-аудит за порядком: сканування, індексація, дані  Search Console, Core Web Vitals та видимість в ШІ, з перевірками й виправленнями, що впливають на трафік.

Інструменти

Коротко
SEO-аудит це структурована перевірка всього, що заважає сторінкам скануватися, індексуватися, розумітися, отримувати кліки і цитуватися. Проводьте його у фіксованому порядку: сканування, індексація, пошукові дані, швидкість, зміст сторінок, посилання, потім видимість в ШІ. Оцінюйте кожну знахідку за обсягом трафіку, який вона блокує, а десять головних перетворюйте на датовані завдання з відповідальним. Точковий аудит можна провести за кілька днів. Повний аудит великого сайту займає більше часу, і його результатом має бути план, а не список.
Хочете дізнатися більше? Запитайте
Швидкий тест
Чи підходить вам SEO і з чого почати?
Sorank відповідає вашим відповідям


Спробуйте його 3 дні на власному сайті й дізнайтеся, де ви зараз у Google, ChatGPT та інших ШІ.
Спробувати 3 дні безкоштовно3 дні безкоштовно, потім зупиніть, коли захочете. Гарантія повернення коштів протягом 90 днів, на певних умовах.
SEO-аудит відповідає на одне питання: які технічні, контентні та авторитетні проблеми зараз коштують вам відвідувачів і в якому порядку їх виправляти? Це не перелік усіх існуючих практик. Чек-лист на 40 пунктів показує, на що дивитися. Аудит показує, що не так на вашому сайті, наскільки це важливо і що робити насамперед.
Три поняття часто плутають: сам аудит (діагноз), чек-лист (перелік перевірок) і звіт (те, що ви передаєте клієнту або керівнику). Наш шаблон звіту SEO-аудиту присвячений звіту, а чек-лист технічного SEO присвячений перевіркам. Ця стаття про метод, який їх поєднує, і про дані, потрібні, щоб вирішити, що важливо.
Два способи поставити одне й те саме завдання аудиту
Різниця не в обсязі зусиль, а в запитанні. Чітке завдання називає сторінки, період і рішення, тож кожна перевірка має причину існувати.
Більшість аудитів ідуть не так ще до першого сканування, бо ніхто не узгодив обсяг і не зберіг відправну точку. Визначте три речі, перш ніж відкрити будь-який інструмент.
Перед будь-яким скануванням
Порядок має значення. Сканування показує, що існує на сайті. Індексація показує, що зберігає Google. Пошукові дані показують, що люди знаходять і на що клацають. Швидкість, контент і посилання потім пояснюють, чому сторінка працює гірше. Якщо піти в зворотному порядку, ви витратите години на переписування сторінки, яку Google взагалі не може проіндексувати.
Сім етапів SEO-аудиту
Перевірки перед аудитом підтверджують, що сайт, який ви збираєтеся аудитувати, саме той, який бачать Google і ваші відвідувачі, і що дані достатньо надійні, щоб на них спиратися. Витратьте на них близько години до будь-якого сканування. Хибна властивість у Search Console, активне правило тестового середовища або зламана аналітика можуть зробити всі подальші знахідки хибними, а сканування жодної з цих проблем не покаже.
Запитайте кожен варіант домену: http, https, з www і без www, із завершальним слешем і без нього. Кожен варіант має закінчуватися на тій самій кінцевій адресі, бажано після одного редиректу. Дві живі версії ділять посилання і сигнали між собою, і краулер визнає обидві здоровими.
curl -I http://example.com/
curl -I https://www.example.com/
Прочитайте заголовок Location у кожній відповіді. Він має вказувати безпосередньо на бажану адресу, а не на другий редирект. Повторіть перевірку на головній сторінці та на одній глибокій сторінці, бо правила редиректів часто відрізняються між шаблонами.
Налаштування тестового середовища є однією з найпоширеніших причин раптового падіння. Перегляньте живий robots.txt, мета-тег robots і заголовок X-Robots-Tag на головній сторінці та на одній статті. Правило Disallow для всього сайту або noindex, що залишилося від тестової збірки, можуть сховати розділи від пошуку, тоді як сторінки все ще відкриваються для відвідувачів. Якщо знайшли таке, виправте його до аудиту цих розділів, бо всі подальші знахідки описували б сайт, який Google не бачить.
Запишіть із датами список кожного релізу, редизайну, оновлення CMS, міграції та правки robots або noindex за останні шість місяців. Потім порівняйте ці дати з початком будь-якої зміни трафіку. Падіння, що почалося в день релізу шаблону, вказує на цей шаблон. Падіння без змін поруч може вказувати на оновлення пошукового алгоритму і потребує іншої перевірки. Без журналу ви звинуватите те, на що дивилися останнім. Для змін, що стосуються URL, чек-лист SEO-міграції перелічує, що фіксувати.
Порівняйте кліки в Search Console з органічними сесіями у вашій аналітиці за ті самі 90 днів. Лінії не мають збігатися, але мають рухатися в одному напрямку. Якщо вони розходяться, перевірте теги на ключових сторінках, банер згоди і фільтрацію ботів, перш ніж діагностувати сайт. Порівняння двох інструментів пояснює, що рахує кожен з них.
Сканер робить у меншому масштабі те, що робить Googlebot: починає з однієї сторінки, переходить за знайденими посиланнями й фіксує, що бачить для кожного URL. Інструмент, яким ми користуємося в більшості аудитів, це Screaming Frog SEO Spider. Його безкоштовна версія сканує до 500 URL, чого вистачає для невеликого сайту або одного розділу великого. Платна ліцензія знімає обмеження. Наш посібник зі Screaming Frog показує налаштування.
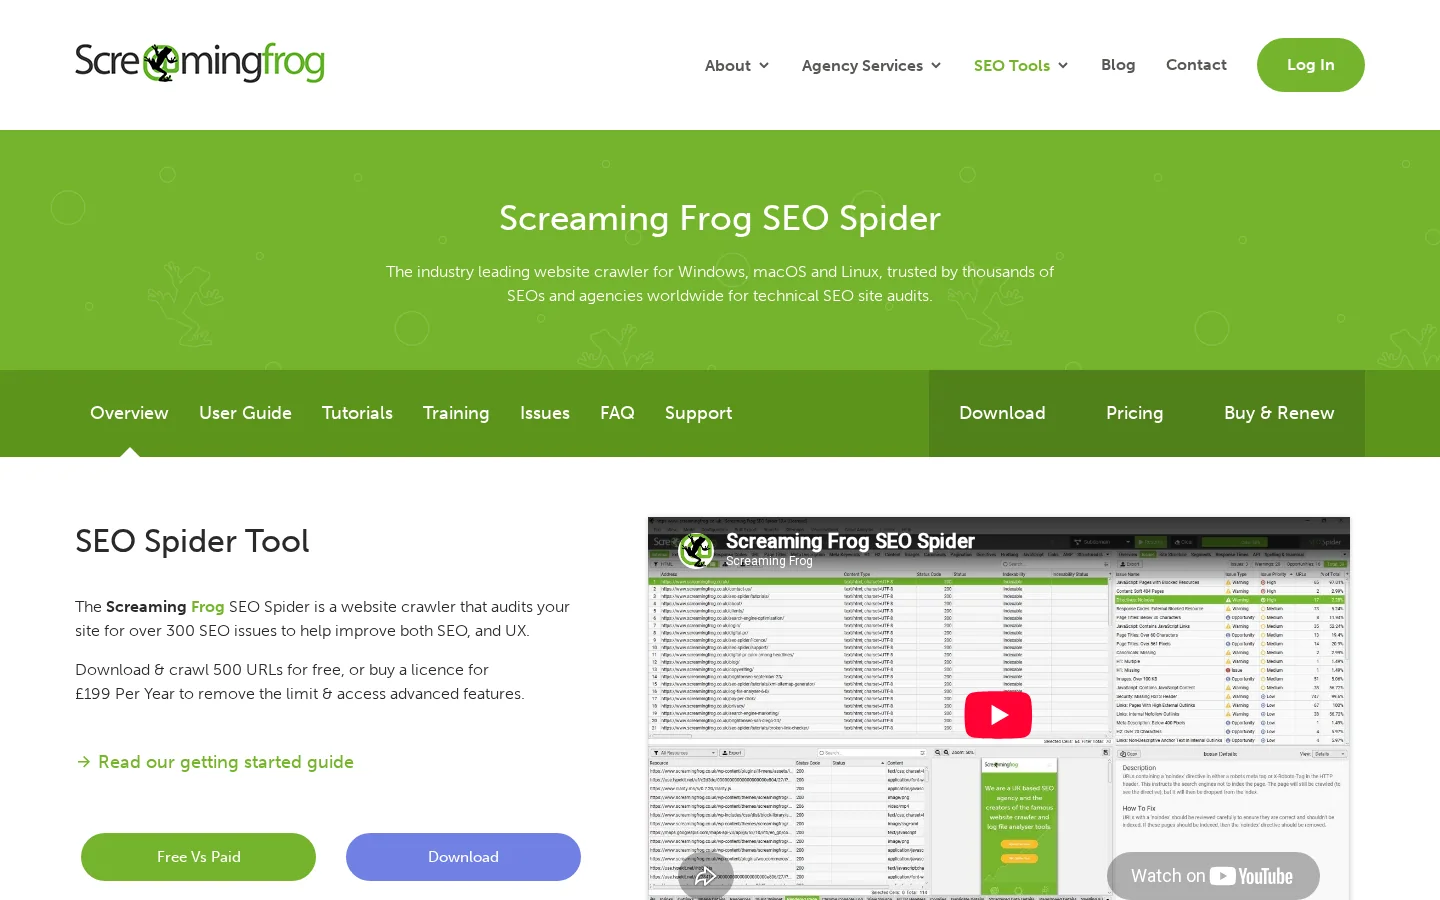
Почніть сканування з головної сторінки та з карти сайту, а потім порівняйте два списки. Кожен URL, який є лише в одному з них, це запитання. Налаштуйте сканер так, щоб він враховував robots.txt так само, як Googlebot, і рендерив JavaScript, якщо сайт від нього залежить. Сканування, яке не рендерить сторінки, пропустить вміст, який бачать користувачі.
Спершу відфільтруйте відповіді 4xx і 5xx. Сама по собі 404 не є проблемою. Вона стає проблемою, коли на неї все ще ведуть внутрішні посилання, бо вони відправляють користувачів і краулерів у глухий кут. Знайдіть внутрішні посилання, що ведуть на сторінки з помилками, і спрямуйте їх на робочий URL. Потім подивіться на ланцюжки редиректів: старий URL перенаправляє на другий, той на третій. Кожен перехід додає затримку і розмиває сигнал. Вирівняйте кожен ланцюжок так, щоб старий URL вказував одразу на кінцевий.
Перевірте також тип редиректу. Тимчасовий 302, використаний для постійного переїзду, має бути 301. У нашому посібнику щодо 301 і 302 наведено правило вибору.
Три налаштування можуть непомітно приховати сторінку. Правило disallow у robots.txt зупиняє сканування. Мета-тег noindex або HTTP-заголовок X-Robots-Tag зупиняють індексацію. Тег canonical, що вказує на інший URL, повідомляє пошуковикам, яку версію зберегти. Перевіряйте кожне налаштування для кожного типу сторінок, бо правило, додане для виправлення одного розділу, часто блокує інший. Типовий випадок: правило з тестового середовища, яке так і не прибрали з робочого robots.txt.
Попередження
Блокування сторінки в robots.txt не те саме, що її видалення з пошуку. Якщо Google не може просканувати сторінку, він не може прочитати на ній тег noindex. Щоб вилучити сторінку з індексу, дозвольте сканування, додайте noindex і зачекайте, поки Google перескануватиме її.
Сторінка-сирота не має внутрішнього посилання, яке на неї вказує. Краулери знаходять її лише через карту сайту або зовнішнє посилання, а користувачі майже ніколи її не знаходять. Щоб знайти сиріт, порівняйте три списки: URL, до яких сканер дістався за посиланнями, URL з карти сайту та URL, які отримують відвідування в аналітиці. Сторінка, яка є в карті сайту або отримує відвідування, але не має вхідного внутрішнього посилання, є кандидатом у сироти.
Виміряйте також глибину кліку, тобто кількість кліків від головної сторінки. Важлива сторінка, захована на п'ятому чи шостому кліку, отримує мало уваги краулерів і мало внутрішніх посилань. Додайте на неї посилання з релевантної сторінки-хабу і переконайтеся, що сам хаб розташований неглибоко.
Відфільтруйте відсутні title, повторювані title, повторювані мета-описи та заголовки, які занадто довгі, щоб повністю відображатися в результатах пошуку. Дублі майже завжди створює шаблон, а не автор. Шаблон картки товару, який виводить той самий title для кожної модифікації, породжує сотні дублів, і виправлення шаблону усуває їх усі одразу. Розглядайте тег title як сильну пропозицію для Google, а не гарантію. Google інколи переписує його, і це ще одна причина тримати його точним і конкретним.
Серверні логи замикають цикл сканування. Вони показують, які URL запитував Googlebot, як часто і які статус-коди отримував. Якщо у вас є доступ до них, порівняйте запити з картою сайту. Сторінки, які Googlebot постійно відвідує, але які не приносять користі, свідчать про втрати краулінгового бюджету, що пояснюється в нашій статті про краулінговий бюджет.
Звіт «Індексування сторінок» у Search Console перелічує URL, про які знає Google, і статус, який він присвоює кожному. Відкрийте його і сортуйте за причиною, а не за кількістю. Кожна причина вказує на своє виправлення. Офіційні визначення Google зі довідки Search Console про статуси індексації є еталоном для міток нижче.
| Статус у звіті | Що це означає | Що робити |
|---|---|---|
| Виявлено, наразі не проіндексовано | Google знайшов URL, але ще не сканував його і відклав сканування, бо очікував перевантаження сайту | Перевірте час відповіді сервера і глибину URL. Переконайтеся, що на нього ведуть внутрішні посилання |
| Просканована, наразі не проіндексована | Google просканував сторінку і вирішив її не індексувати. Google не індексує кожну сторінку в мережі | Спершу перевірте якість: тонкий вміст, майже однакові сторінки, слабкі внутрішні посилання. Використовуйте перевірку URL для важливих сторінок |
| Заблоковано robots.txt | Googlebot не має дозволу сканувати URL | Переконайтеся, що блокування навмисне. Приберіть його, якщо сторінка має ранжуватися |
| Виключено тегом noindex | На сторінці є директива noindex | Приберіть директиву, якщо сторінка має ранжуватися. Залиште її на сторінках, які мають лишатися поза пошуком, наприклад на результатах внутрішнього пошуку |
Практичне правило: коли весь тип сторінок показує високу частку «просканована, наразі не проіндексована», дивіться спершу на шаблон, а потім на статті. Тонкі шаблони створюють тонкі сторінки, і виправлення однієї статті не змінить картину. Наш посібник зі статусу «просканована, наразі не проіндексована» детально розглядає причини.
Для важливих сторінок використовуйте перевірку URL по одній сторінці. Вона показує дату останнього сканування, чи проіндексована сторінка, і канонічний URL, який обрав Google. Коли обраний канонічний URL не збігається з оголошеним вами, причина майже завжди в дублюванні або суперечливих сигналах, наприклад у canonical, що вказує на перенаправлений URL, або в внутрішніх посиланнях, які віддають перевагу параметричній версії.
Звіт «Ефективність» у Search Console є найкориснішим безкоштовним набором даних для аудиту. За замовчуванням він показує останні три місяці, що замало для тренду. Експортуйте щонайменше 90 днів даних за запитами та сторінками і збережіть файл із датою, щоб порівняти його з наступним аудитом. Групуйте таблицю за сторінками і запитами, а фільтри за країною та пристроєм використовуйте, коли сайт працює на кількох ринках.
Чотири аналізи знаходять більшість можливостей у цих даних.
Щоб виділити тип сторінок, додайте фільтр сторінок із регулярним виразом. Наприклад, щоб побачити лише сторінки блогу, орієнтовані на запити «як зробити», введіть два значення:
Page filter (regex):   /blog-geo-seo/.*
Query filter (regex):  how to|guide|checklist
Клікабельність сильно залежить від верхньої частини видачі. Кілька опублікованих цифр допомагають оцінити, чи реальний розрив. У дослідженні CTR Google перший органічний результат отримував 27,6% кліків, перша трійка разом 54,4%, а результати другої сторінки 0,63%.
Чому перша позиція має таке значення
Джерело: Backlinko, дослідження CTR Google (backlinko.com/google-ctr-stats)
Використовуйте ці середні як перевірку здорового глузду, а не як ціль. Вони змішують усі види запитів, а ваші цифри залежать від пошукового наміру, брендових запитів і функцій над вашим результатом, таких як відео, зображення чи відповіді ШІ. Порівнюйте кожну сторінку зі сторінками, які ранжуються за схожими запитами на вашому сайті.
Пороги нижче є відправними точками, які ми використовуємо для сортування даних. Це не правила Google, тому коригуйте їх залежно від розміру сайту та обсягу запитів.
| Перевірка | Стартовий поріг (наше практичне правило) | Чому це важливо |
|---|---|---|
| Зона близької позиції | Середня позиція з 8 по 20, щонайменше 50 показів за 90 днів | Попит є, а сторінка достатньо близько, щоб піднятися |
| Спад | Кліки впали на 30% і більше між двома однаковими періодами | Втрачено достатньо трафіку, щоб виправдати перегляд |
| Тонкий вміст | Менше 300 слів основного тексту без навігації та шаблонних блоків | Часто цього замало, щоб відповісти на запит. Коротка сторінка-інструмент може бути правильною, тож перевірте намір |
| Внутрішні посилання | Менше 3 вхідних внутрішніх посилань з індексованих сторінок | Слабкий сигнал важливості і типова ознака сторінки-сироти |
Дані Search Console дають також другу перевірку: запити, за якими ви ранжуєтесь, але які ніколи не були цільовими. Це часто найлегші доповнення до наявної сторінки, бо релевантність уже підтверджена показами.
Документація Google щодо Core Web Vitals визначає три показники користувацького досвіду та їхні порогові значення. Сторінка перебуває в «доброму» діапазоні, коли її Largest Contentful Paint не перевищує 2,5 секунди, Interaction to Next Paint не перевищує 200 мілісекунд, а Cumulative Layout Shift не перевищує 0,1. INP став стабільним Core Web Vital у 2024 році і замінив First Input Delay.
| Метрика | Добре, коли | Що вимірює | Типове виправлення |
|---|---|---|---|
| LCP | 2,5 секунди або менше | Як швидко завантажується найбільший видимий елемент | Оптимізуйте головне зображення, скоротіть час відповіді сервера, попередньо завантажте шрифт, який сторінка потребує першим |
| INP | 200 мілісекунд або менше | Як швидко сторінка реагує на кліки, дотики та натискання клавіш під час відвідування | Розбивайте довгі завдання JavaScript, видаляйте важкі сторонні скрипти, не блокуйте головний потік під час завантаження |
| CLS | 0,1 або менше | Наскільки сильно зсувається вміст під час завантаження сторінки | Задавайте ширину і висоту зображень і вбудовувань, резервуйте місце для банерів і реклами, уникайте пізно завантажуваних елементів над згином |
Спершу читайте польові дані, потім лабораторні. Польові дані надходять від реальних користувачів Chrome і показують, чи справді страждають відвідувачі. Лабораторні дані отримують у ході симульованого запуску і показують, чому сторінка повільна. PageSpeed Insights показує обидва: польові дані, коли в Google достатньо трафіку для URL, і лабораторні дані для кожного URL, який ви тестуєте.
Тестуйте три-п'ять URL на кожен шаблон, а не лише головну. Шаблон товару, шаблон категорії і шаблон блогу можуть мати дуже різні оцінки на одному сайті, бо завантажують різні скрипти. Висока лабораторна оцінка за поганого польового INP є типовою для сайтів із важкими менеджерами тегів і чат-віджетами. У такому разі лабораторний тест не помилковий, але він не відображає взаємодію користувача зі сторінкою після завантаження.
На мобільних пристроях перевірте три речі. Основний вміст мобільної версії має збігатися з десктопною, бо Google передусім індексує мобільну версію сторінки. Структуровані дані та внутрішні посилання мають бути однаковими в обох. І жодний нав'язливий інтерстиціал не повинен перекривати вміст одразу після відкриття. Швидкість впливає на ранжування, але корисніше виправляти її тому, що повільні шаблони втрачають відвідувачів ще до того, як ті щось прочитають.
Для кожної важливої сторінки перевірте title, заголовки, глибину відповіді, посилання вхідні та вихідні, і чи існує близький дубль. Робіть це для вибірки сторінок із кожного шаблону, а потім для сторінок, які в пошукових даних показують зону близької позиції або спад.
| Перевірка | Проходить, коли | Не проходить, коли |
|---|---|---|
| Title | Називає тему та основний запит сторінки і є унікальним на всьому сайті | Дублює іншу сторінку або є шаблонним значенням, наприклад лише назвою сайту |
| H1 | Один на сторінку, називає тему простими словами | Відсутній, повторюється або замінений логотипом чи банером |
| Перший екран | Запитання, яке ставить запит, отримує відповідь близько до верху | На першому екрані контекст і брендовий текст, а відповідь з'являється після кількох прокручувань |
| Глибина | Охоплює підпитання, які люди ставлять з цієї теми, з конкретикою | Тонка або заповнена повторюваними абзацами |
| Внутрішні посилання | Посилаються на неї суміжні сторінки, а вона веде до наступного логічного кроку | Сирота, або посилання лише з футера чи карти сайту |
| Структуровані дані | Відповідають вмісту, який відвідувач бачить на сторінці | Позначають вміст, якого немає на сторінці, або використовують неправильний тип |
Внутрішні посилання є найдешевшим важелем у всьому аудиті. Посилання зі сторінки, яка вже ранжується, розміщене в основному тексті і з використанням слів цільового запиту в анкорі, передає і контекст, і авторитет. Загальні анкори на кшталт «натисніть тут» чи «читати далі» передають дуже мало змісту. Працюйте зі сторінок, які приносять найбільше трафіку, бо кожне нове посилання з них веде на сторінку з реальною аудиторією.
Дубльований і майже дубльований вміст заслуговує на окремий прохід. Фільтри категорій, параметри сортування та параметри відстеження часто створюють багато URL, що показують один і той самий список. Вирішіть, яка версія має існувати, а потім використайте відповідний canonical, правила robots або обробку параметрів. Не залишайте це рішення Google, бо результат вам не сподобається.
Порада
Для швидкого першого огляду однієї сторінки безкоштовний інструмент on-page SEO-аудиту виконує типові перевірки title, заголовків, посилань і мета-тегів, щоб ви могли витрачати час на знахідки, які потребують судження.
Перевірка профілю посилань відповідає на три питання: чи набираєте ви посилальні домени у сталому темпі, чи втратили важливі посилання і чи є патерни, що виглядають маніпульованими? Експортуйте посилальні домени за період з інструмента для беклінків, потім шукайте різкі сплески, які часто йдуть від платної кампанії або спаму, і провали, які часто спричинені застарілими сторінками або міграцією сайту. Наш посібник з аудиту беклінків описує повний огляд.
Будьте обережні з інструментом відхилення посилань (disavow). Власні рекомендації Google полягають у тому, що більшості сайтів він не потрібен. Використовуйте його, коли маєте чіткий патерн посилань, які ви не заробили, і ручну санкцію або серйозну проблему, пов'язану з ними, а не тому, що інструмент для беклінків присвоїв деяким доменам низьку оцінку. Помилково відхилити добрі посилання обходиться дорожче, ніж залишити кілька поганих.
Дві перевірки тепер обов'язкові в кожному аудиті. Перша це доступ: чи можуть ШІ-краулери дістатися до ваших сторінок? Перевірте правила robots.txt для кожного краулера, який важливий для вас. OpenAI використовує GPTBot і OAI-SearchBot, Anthropic використовує ClaudeBot, а Perplexity використовує PerplexityBot, і служать вони не для однієї мети. Одне правило для всіх рідко є правильним рішенням. Наш посібник зі ШІ-краулерів перелічує їх і їхні ролі.
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /
Приклад вище це одне можливе рішення, а не рекомендація для кожного сайту. Він дозволяє одному краулеру читати ваші сторінки для відповідей у пошуку і блокує інший, який використовується для навчання. Вирішуйте окремо для кожного краулера, фіксуйте рішення і перевіряйте файл після кожного розгортання, бо robots.txt, який блокує все, часто з'являється після випуску з тестового середовища.
Друга перевірка це видимість: чи називають вас системи відповідей, коли покупець ставить запитання, на яке ви орієнтуєтеся? Складіть список із десяти-двадцяти промптів з реальних питань у ваших пошукових даних і в розмовах із продажу. Запустіть їх у ChatGPT, Perplexity і Gemini, фіксуйте, які бренди й URL цитуються, і повторюйте кожен промпт кілька разів протягом кількох днів, бо відповіді змінюються від запуску до запуску. Метод аудиту AI-видимості пояснює, як оцінювати результати.
Аудити відрізняються обсягом і місцем, з якого ви починаєте. На практиці поширені п'ять методів. Кожен підходить для своєї ситуації, і більшість команд поєднують два з них.
Принцип: охопити весь сайт, кожен тип сторінок і кожне джерело даних, а потім ранжувати знахідки. Використовуйте, коли готуєте міграцію, після різкого падіння трафіку або проводите перший аудит великого сайту. Перевага: він знаходить структурні проблеми, які не видно під час перегляду окремих сторінок, наприклад фасетну навігацію, що множить URL. Обмеження: він повільний і видає багато знахідок, які потребують другого проходу, щоб їх упорядкувати. Приклад: ритейлер із 40000 URL товарів з'ясовує, що один параметр фільтра створює більшість дублів, які не виявив би жоден окремий огляд товару.
Принцип: почніть із того, що змінилося в пошукових даних, і діагностуйте лише залучені сторінки та запити. Використовуйте, коли проводите місячний огляд, коли щойно вийшло оновлення ядра або коли команда мала. Перевага: роботу пріоритизовано за трафіком із першої хвилини. Обмеження: він сліпий до сторінок, за якими ще немає даних, наприклад нових розділів або сторінок, заблокованих від початку. Приклад: блог, який втратив кліки на п'яти сторінках, перевіряє саме ці п'ять, знаходить дві, що канібалізують одна одну, і об'єднує їх.
Принцип: виконати кожну перевірку на одному URL, а потім вирішити, чи потрібне переписування. Використовуйте, коли одна комерційна сторінка underperforms або перед запланованим переписуванням. Перевага: швидкий і конкретний, із чітким «до» і «після». Обмеження: він не показує патернів, тож помилка шаблону може здаватися разовою проблемою. Приклад: сторінка товару з гарним title і змістом виявляється з canonical, що вказує на варіант, якого немає в наявності.
Принцип: порівняти ваші сторінки й теми з тими, що ранжуються вище за ті самі запити. Використовуйте, коли плануєте новий контент або нові посилання. Перевага: він показує, що ринок винагороджує на практиці, зокрема глибину, формат і охоплені підпитання. Обмеження: копіювання лідера може завести в переповнену тему або тему з хибним наміром. Перш ніж вирішувати, перевірте, що справді спільного в топових результатів. Приклад: топ-5 результатів за запитом усі відповідають на питання про ціну на першому екрані, а ваш ні.
Принцип: перевірити, чи можуть ШІ-краулери читати ваші сторінки і чи цитують вас системи відповідей за важливими питаннями. Використовуйте, коли потрібно знати, чи рекомендують ваш бренд ШІ-інструменти. Перевага: він охоплює канал, який традиційні трекери позицій не показують. Обмеження: відповіді варіюються від запуску до запуску, тож вибірку треба повторювати, перш ніж робити висновки. Приклад: софтверну компанію цитують за функцію, яку вона перестала продавати, що показує застарілість її порівняльних сторінок.
| Метод | Відправна точка | Найкраще для | Головне обмеження |
|---|---|---|---|
| Повний технічний аудит | Сканування та всі джерела даних | Міграції, великі сайти, різкі падіння | Повільний, і важко впорядкувати без плану |
| Аудит, що починається з даних | Зміни в пошукових даних | Місячні огляди, малі команди | Пропускає сторінки, за якими ще немає даних |
| Аудит на рівні сторінки | Один URL | Одна сторінка, що недопрацьовує | Не бачить патернів на рівні шаблонів |
| Аудит розриву з конкурентами | Результати над вами | Новий контент і нові посилання | Ризик скопіювати хибний намір |
| Аудит видимості в ШІ | Доступ краулерів і системи відповідей | Знати, чи рекомендує вас ШІ | Відповіді варіюються, тож вибірки треба повторювати |
Швидкий аудит проти повного
Наша порада: починайте зі швидкого аудиту і переходьте до повного лише тоді, коли швидкий вказує на структурну причину або коли ви збираєтеся змінювати архітектуру сайту.
Аудит із 400 знахідками без порядку вартий менше, ніж той, що має десять. Оцінюйте кожну знахідку за двома критеріями: скільки трафіку або доходу вона ставить під загрозу і наскільки складно її виправити. Почніть із пунктів з високим ефектом і низькими зусиллями. Потім візьміть пункти з високим ефектом, які потребують більше роботи, але відкривають цілий шаблон, бо одне виправлення там змінює тисячі сторінок.
| Знахідка | Трафік під загрозою | Зусилля | Пріоритет |
|---|---|---|---|
| Шаблон посилається на 404-сторінки з кожної сторінки | Високий | Низькі | Зробити першим |
| Комерційні сторінки з дубльованими title | Високий | Низькі | Зробити першим |
| Повільний LCP на шаблоні категорій | Високий | Середні | Запланувати в наступному спринті |
| Статті блогу зі спадом | Середній | Середні | Оновлювати за порядком втрачених кліків |
| Сторінки-сироти глосарію | Низький | Низькі | Об'єднати з роботою над внутрішньою перелінковкою |
| Сторінки архівів тегів із тонким вмістом | Низький | Середні | Перевірити намір, потім noindex або об'єднання |
Призначте кожному пункту власника, дату і метрику, яку очікуєте змінити. Знахідка без власника є нотаткою, а нотатки не змінюють ранжування. Перевимірюйте після того, як Google перескануює зачеплені сторінки, а це може тривати тижні, і порівнюйте з відправною точкою, яку зберегли на початку. Під час презентації результатів шаблон звіту SEO-аудиту дає структуру, яку менеджери та клієнти можуть прочитати за десять хвилин.
Якщо хочете мати трафік Google і ШІ в одному місці, поки відстежуєте ці виправлення, дашборд GEO/SEO від Sorank показує обидва поруч.
SEO-аудит за 90 хвилин перевіряє сторінки, які приносять найбільше пошукового трафіку, у такому порядку, щоб спершу знаходити реальні втрати. Використовуйте його, коли у вас одна сесія і потрібен ранжований список виправлень, а не огляд кожного URL. Обмежте роботу головними сторінками та одним прикладом URL на кожен шаблон, і результат можна використати того ж дня.
Поділіть сесію на фіксовані блоки і зупиняйте кожен блок, коли вичерпався його час. Ліміт часу є частиною методу, бо змушує робити вибір.
| Хвилини | Завдання | Результат |
|---|---|---|
| 0 до 10 | Експортуйте 90 днів даних за запитами та сторінками з Search Console і складіть список 20 найкращих сторінок за кліками | Збережена відправна точка і короткий список сторінок |
| 10 до 25 | Застосуйте до цього списку перевірки striking distance і decay з етапу 3 | Сторінки, що втратили кліки, або ті, що розташовані між позиціями 8 і 20 |
| 25 до 40 | Проскануйте по одному прикладу URL на кожен шаблон і перевірте статус-код, canonical та директиви robots | Помилки, хибні canonical і блокування за шаблонами |
| 40 до 55 | Відкрийте звіт «Індексування сторінок» і відсортуйте причини за кількістю | Статус, що стосується найбільшої кількості сторінок |
| 55 до 70 | Запустіть PageSpeed Insights на одному URL кожного шаблону, спершу читаючи польові дані | Шаблон із найслабкішим польовим LCP або INP |
| 70 до 90 | Запишіть десять головних знахідок з трафіком під загрозою, зусиллями і відповідальним | Ранжований план, який можна надіслати того ж дня |
Кожен рядок відповідає на одне питання, тож можна пропустити рядок і не втратити інші. Якщо звіт про індексацію не показує нічого незвичайного, віддайте цей час пошуковим даним: це зазвичай швидший шлях до виправлення.
Ліміт часу приховує три речі. Він пропускає структурні проблеми, наприклад фільтр, що множить URL, бо ви читаєте лише вибірки. Він не використовує серверні логи, тож ви не бачите, як часто краулери запитують сторінку. І він оминає профіль посилань, для якого потрібен повний експорт з інструмента для беклінків. Запишіть це як відкриті питання для пізнішого аудиту беклінків або повного огляду, щоб короткий аудит не здавався повнішим, ніж є.
Найпоширеніша помилка: почати з краулера. Сканування великого сайту може тривати довше за всю сесію і видати більше попереджень, ніж хтось здатен прочитати. Почніть натомість з пошукових даних і відкривайте краулер лише для сторінок, які мають кліки або покази. Спершу виправляйте попередження на цих сторінках, бо попередження на сторінках, які ніхто не відвідує, не змінюють ваш трафік.
Порада
Поставте сесію в календар із таймером і одним файлом результатів. Використовуйте колонки шаблону звіту SEO-аудиту від початку, щоб список був готовий до передачі на 90-й хвилині.
Більшість аудитів містять одні й ті самі помилки. Їх легко уникнути, коли знаєш ознаки.
Що це: аудит охоплює все, тож нічого не завершується. Як помітити: у звіті сотні проблем, жодна з позначкою трафіку чи власника. Як виправити: почніть наново з чіткого завдання з першого розділу, обмежте сканування типами сторінок, які важливі, і відсортуйте знахідки за трафіком, перш ніж писати щось інше.
Що це: команда виправляє попередження, які інструмент показує червоним, навіть коли вони стосуються сторінок, які ніхто не відвідує. Як помітити: кількість попереджень зменшується, а кліки на комерційні сторінки продовжують падати. Як виправити: поєднайте сканування з пошуковими даними і спершу виправляйте проблеми на сторінках, які мають трафік, покази або посилання.
Що це: сканер не повідомляє про помилки, тож команда робить висновок, що сайт здоровий. Як помітити: Search Console показує багато URL зі статусами «просканована, наразі не проіндексована» або «виявлено», які сканер ніколи не позначав. Як виправити: порівняйте сканування з картою сайту, звітом про індексацію та серверними логами. Сканер бачить лише те, до чого може дістатися за посиланнями та рендерингом, тож вміст за логінами, скриптами чи фасетними фільтрами може бракувати в його списку.
Що це: команда редагує той самий title, те саме зображення або той самий canonical на сотнях сторінок, по одній. Як помітити: та сама знахідка трапляється на більшості URL одного типу сторінок. Як виправити: виправте шаблон один раз, а потім перевірте вибірку сторінок, щоб підтвердити, що зміна спрацювала скрізь. Одна зміна шаблону виправляє всю групу.
Що це: команда додає disallow у robots.txt для сторінки, яку хоче прибрати з Google. Як помітити: сторінка залишається в індексі з голим URL і без фрагмента, а звіт показує її як заблоковану. Як виправити: дозвольте сканування, додайте директиву noindex і зачекайте, поки Google перескануює сторінку. Коли вона випаде з індексу, можна її заблокувати, якщо потрібно, але це не обов'язково.
Приклад (ілюстративний)
Уявіть сайт, який прибрав серію рекламних посадкових сторінок і заблокував їх у robots.txt. Сторінки продовжують з'являтися в пошуку з голим URL і без опису, бо інші сайти досі на них посилаються. Зняття блокування і додавання noindex дозволяють Google просканувати сторінки, прочитати директиву і вилучити їх з індексу.
Що це: команда оптимізує оцінку 100 у лабораторному тесті й ігнорує польові дані. Як помітити: лабораторна оцінка висока, але польовий INP для того самого шаблону поганий у звіті Core Web Vitals у Search Console. Як виправити: профілюйте взаємодії, які роблять реальні користувачі, зазвичай після завантаження сторінки. Шукайте довгі завдання, які спричиняють скрипти, а не час завантаження першого відображення.
Щомісяця проводьте швидкий аудит за пошуковими даними і за вашими найважливішими шаблонами. Повний аудит запускайте після міграції, редизайну, зміни CMS або раптового падіння трафіку, а один повний огляд на рік робіть, щоб виявляти структурний дрейф. Пошукові дані варто відстежувати безперервно, бо падіння кліків корисніше як сигнал тривоги, ніж як нагадування в календарі.
Аудит сайту це сканування кожного доступного URL на одному домені зі звітом за типом проблеми та рівнем важливості. Він показує, що зламано на всьому сайті, включно з закономірностями, які пропускає перевірка сторінка за сторінкою. Він не каже, яке виправлення підніме позиції, тож поєднуйте його з пошуковими даними.
Фільтри, параметри сортування і мітки відстеження можуть створити значно більше URL, ніж у вас є сторінок, і більшість із них показують той самий список. Виключіть ці параметри та медіафайли і скануйте кожен піддомен як окремий проєкт. Тримайте частоту запитів низькою, щоб сервер залишався швидким для реальних відвідувачів. Залиште в обсязі пагінацію (page=), бо посторінкові списки можуть містити сторінки, які мають бути в індексі.
.*\?(sort|filter|utm_[a-z]+)=.*
.*\.(jpg|jpeg|png|webp|gif|svg|pdf|mp4)$
Більшість краулерів приймають правила виключення, записані як регулярні вирази на кшталт цих. Перевірте їх на короткому скануванні і переконайтеся, що кількість URL зменшується лише через параметри, які ви хотіли виключити.
Кожен інструмент групує проблеми за рівнями і рахує власну оцінку стану. Назви відрізняються, але логіка пріоритизації однакова. Оцінка це лінія тренду для одного інструмента з фіксованими налаштуваннями, а не оцінка, яку ставить Google. Проходьте рівні в такому порядку:
| Рівень | Типові проблеми | Перша дія |
|---|---|---|
| Помилки на індексованих сторінках | Відповіді 4xx або 5xx на URL, які мають ранжуватися, зламані внутрішні посилання | Виправляйте першими, починаючи зі сторінок, які вже приносять кліки |
| Помилки на сторінках, які не треба індексувати | Зламаний внутрішній пошук, фільтри або закриті рекламні URL | Приберіть внутрішні посилання, які ще на них ведуть |
| Попередження | Задовгі title, відсутні описи, повторювані заголовки | Виправляйте пакетами, бажано однією зміною шаблону |
| Повідомлення | Дрібні поради з оптимізації | Перегляньте один раз і діяйте лише тоді, коли вони повторюються на комерційних сторінках |
Найкорисніший результат аудиту сайту: різниця між двома запусками. Експортуйте список проблем з останнього запуску, проскануйте знову з тими самими налаштуваннями і порівняйте кількість за типом проблеми та за URL. Нові проблеми йдуть першими, бо нова помилка на живій сторінці зазвичай слідує за нещодавнім релізом. Зіставте кожну нову групу з журналом змін, перш ніж призначати відповідального.
Наприклад, перший запуск показує 42 помилки, а другий, через чотири тижні, 57, і 15 з нових розташовані на шаблоні цін, що вийшов того ж тижня. Ви виправляєте шаблон один раз. Якщо кількість знову наближається до 42, виправлення спрацювало, і цей запуск стає базою для наступного.
Аудит сайту, на який іде цілий день, не буде повторюватися. Збережіть обсяг, правила виключення і таблицю рівнів важливості як одну конфігурацію, щоб наступний запуск займав хвилини. Налаштуйте розклад сканування і щоразу експортуйте ті самі три файли: список проблем, індексовані URL і URL, які отримують кліки. Наш посібник з автоматизованої SEO-звітності пояснює, що автоматизувати і як це налаштувати.
Якщо ви ще обираєте краулер, наше порівняння інструментів технічного SEO ранжує варіанти за завданнями, які вони виконують. Аудит сайту варто планувати лише тоді, коли хтось читає різницю між запусками. Інакше це ще один експорт у папці.
Якщо ви ніколи не проводили аудит, зробіть чотири речі по черзі. Експортуйте 90 днів даних Search Console і збережіть їх із датою. Просканируйте основні шаблони краулером, почавши з безкоштовної версії на 500 URL, якщо сайт невеликий. Прочитайте звіт про індексацію і відсортуйте причини. Потім виправте три найбільші проблеми шаблонів, які знайшли, і перевимірюйте після того, як Google їх перескануює.
Добрий аудит не закінчується документом. Він закінчується коротким списком виправлень, які хтось робить цього місяця, і відправною точкою, яка показує, чи вони спрацювали.
Це залежить від розміру сайту та глибини перевірки. Точковий аудит основних шаблонів і пошукових даних можна провести за кілька днів. Повний аудит великого сайту з багатьма шаблонами займає довше, і більшість часу йде на діагностику та розстановку пріоритетів, а не на саме сканування.
Щонайменше Google Search Console і сканер на кшталт Screaming Frog SEO Spider, а також PageSpeed Insights для швидкості. Аналітика та серверні логи дають корисний контекст. Платні SEO-пакети допомагають із зворотними посиланнями та даними про конкурентів, але для першого аудиту вони не обов'язкові.
Чек-лист перелічує перевірки, які потрібно виконати. Аудит виконує ці перевірки на вашому сайті, визначає, які знахідки важливі, і упорядковує виправлення за трафіком, який вони ставлять під загрозу. Використовуйте чек-лист, щоб побудувати аудит, а аудит, щоб обрати роботу.
Ми аналізуємо ваших конкурентів, ваш сайт і вашу видимість у ШІ, щоб безкоштовно скласти персоналізований контент-план.
 ШІ-генератор брифів для контенту
 Генератор FAQ-розмітки
 ШІ-генератор ідей для статей у блозі
 Валідатор структурованих даних (валідатор Schema)
 Перевірка alt-тексту
 Аналізатор внутрішніх посилань
 Челендж із зворотних посилань
 ШІ-генератор мета-описів
 ШІ-генератор заголовків для блогу
 Перевірка індексованості в Google
 ШІ-генератор плану статті для блогу
 Конструктор UTM-посилань
 Інструмент кластеризації ключових слів
 Перевірка тегу canonical
 Генератор XML-карти сайту
 Перевірка битих посилань
 ШІ-генератор SEO-заголовків
 Аналізатор заголовків
 Попередній перегляд пошукової видачі
 Перевірка перенаправлень
 Генератор тегів hreflang
 Аналізатор структури заголовків
 Перевірка HTTP-заголовків
 Екстрактор фавіконок
 Калькулятор CTR у видачі
 Калькулятор економії SEO порівняно з платним пошуком
 Калькулятор частки голосу в SEO
 Калькулятор ROI від SEO
 Калькулятор прогнозу трафіку та доходу від SEO
 Калькулятор бюджету SEO
 Калькулятор беззбитковості SEO
 Калькулятор ROI від SEO для SaaS
 Калькулятор ROAS
 Калькулятор часу читання
 Симулятор приросту позицій
 Калькулятор вартості органічного трафіку
 Оцінювач органічного трафіку та перевірка відвідуваності сайту
 Калькулятор співвідношення LTV до CAC
 Калькулятор ROI локального SEO
 Калькулятор вартості лінкбілдингу
 Калькулятор вартості ключового слова
 Калькулятор оцінки можливостей ключових слів
 Калькулятор щільності ключових слів
 Калькулятор ROI GEO
 Калькулятор інвестицій у GEO-контент
 Калькулятор ROI SEO для інтернет-магазину
 Калькулятор пожиттєвої цінності клієнта
 Калькулятор вартості залучення клієнта
 Калькулятор CTR
 Калькулятор вартості статті
 Калькулятор коефіцієнта конверсії
 Калькулятор ROI контент-маркетингу
 Оцінювач реферального трафіку з ChatGPT
 Калькулятор показника відмов
 Калькулятор ROI зворотних посилань
 Калькулятор оцінки видимості у ШІ
 Калькулятор вартості AI-трафіку
 Калькулятор частки голосу в ШІ
 Калькулятор вартості невидимості в ШІ
 Калькулятор частоти цитування в ШІ
 Валідатор llms.txt
 Перевірка AI Overview і позицій в AI Overviews
 Перевірка robots.txt
 SEO-аудит для ШІ
 Перевірка читабельності для LLM
 Перевірка готовності до SearchGPT
 Аудит структурованих даних для LLM
 ШІ-аудит доступності сайту для краулерів
 Чому ChatGPT не рекомендує мій сайт
 Інструмент позицій у Gemini
 Перевірка позицій у Perplexity
 Перевірка цитування в LLM
 Аудит оптимізації для відповідних систем (AEO)
 GEO-аудит
 Тест видимості в ШІ-пошуку
 Перевірка видимості в ChatGPT
 Генератор llms.txt
 Екстрактор URL
 Веб-сторінка в Markdown
 Перевірка карти сайту
 Сенсор волатильності видачі
 Перевірка розміру сторінки
 Лічильник слів
 Генератор слагів
 Генератор Schema
 Генератор Robots
 Попередній перегляд Open Graph
 Генератор мета-тегів
 Компресор зображень
 Генератор фавіконок
 SEO-аудит сторінки: SEO-перевірка та SEO-аналіз
 Інструмент аналізу зворотних посилань
 Інструмент підбору ключових слів
 Перевірка авторитету домену
 “Я протестував Sorank на реальному сайті клієнта, і це неймовірно. Він робить усе, за що агенція виставила б вам рахунок на 1500 доларів на місяць. Тепер його запускають у роботу на цьому клієнті.”

 Guillaume Guersanguersanguillaume.com“Ми рекламна агенція і хотіли раз і назавжди повернути своє SEO в нормальне русло. Sorank дав нам чітке уявлення про наш сайт, допоміг розставити пріоритети оптимізацій і належним чином структурувати наш контент. Інструмент простий у використанні, добре продуманий для команди й дуже зручний для централізованого відстеження без жонглювання кількома платформами. Дуже міцна основа, щоб почати наше SEO з нуля.”
 Gaspard MadouiРекламна агенція
 “Я просто дозволив програмі Sorank повністю робити свою справу, і тепер мій показник DR дорівнює 25, а моя сторінка піднялася вище в пошуку.”
 Lucas Flandrefoundertrace.fr“Я спеціалізувалася на GEO завдяки Sorank. Рейтинг GEO дає змогу показувати клієнтам їхню позицію щодо конкурентів у ChatGPT. Це справжня комерційна перевага.”
 MélanieSEO-фрілансерка“Чудовий сервіс, добре працює для нашого сайту й допомагає зрозуміти, як його покращити, щоб вище ранжуватися в Google та поза ним. Вітаю, так тримати, рекомендую.”
 Hugo T.Власник інтернет-магазину