Confidențialitatea contează pentru noi, așa că ai opțiunea de a dezactiva anumite tipuri de stocare care nu sunt necesare pentru funcționarea de bază a site-ului. Blocarea categoriilor poate afecta experiența ta pe site. Mai multe informații (Politica privind cookie-urile)
Mulțumim! Trimiterea ta a fost primită!
Ups! A apărut o eroare la trimiterea formularului.
Cum să faci un audit SEO: o metodă pas cu pas care găsește ce îți costă trafic
Fă un audit SEO complet, în ordine: crawl, indexare, date Search Console, Core Web Vitals și vizibilitate în AI, cu verificările și corecturile care cresc traficul.
Un caiet cu o listă de verificare pentru auditul SEO și grafice tipărite pe un birou.
Instrumente
Pe această pagină
Pe scurt
Un audit SEO este o verificare structurată a tot ce împiedică paginile tale să fie parcurse, indexate, înțelese, accesate și citate. Rulează-l într-o ordine fixă: crawl, indexare, date de căutare, viteză, conținutul paginilor, linkuri, apoi vizibilitatea în AI. Evaluează fiecare constatare după traficul pe care îl blochează și transformă primele zece în sarcini datate, cu un responsabil. Un audit concentrat poate fi făcut în câteva zile. Un audit complet al unui site mare durează mai mult, iar rezultatul trebuie să fie un plan, nu o listă.
3 zile gratuit, apoi renunți oricând vrei. Garanție de rezultate de 90 de zile, se aplică condiții.
Ce este un audit SEO și ce nu este
Un audit SEO răspunde la o singură întrebare: ce probleme tehnice, de conținut și de autoritate îți costă vizite chiar acum și în ce ordine ar trebui rezolvate? Nu este o listă cu toate bunele practici existente. O listă de verificare cu 40 de puncte îți spune ce să privești. Un audit îți spune ce nu funcționează pe site-ul tău, cât de important este și ce să faci mai întâi.
Trei lucruri se confundă des: auditul (diagnosticul), lista de verificare (lista controalelor) și raportul (ceea ce predai unui client sau unui manager). Șablonul nostru pentru raportul de audit SEO acoperă raportul, iar lista de verificare SEO tehnic acoperă controalele. Acest articol descrie metoda care le leagă și datele de care ai nevoie pentru a decide ce contează cu adevărat.
Două moduri de a da brief pentru același audit
Brief vag
Verifică site-ul pentru probleme SEO
Rezultat: o listă lungă de avertismente pe care nu le citește nimeni
Brief clar delimitat
Găsește paginile care au pierdut clicuri în ultimele 90 de zile
Rezultat: zece corecturi ordonate după traficul aflat în pericol
Diferența nu ține de efort, ci de întrebare. Un brief clar delimitat numește paginile, perioada și decizia, astfel încât fiecare verificare are un motiv să existe.
Înainte de start: acces, domeniu și un punct de referință
Majoritatea auditurilor greșesc înainte de primul crawl, pentru că nimeni nu a stabilit domeniul sau nu a salvat un punct de plecare. Hotărăște trei lucruri înainte de a deschide orice instrument.
Domeniul. Ce domeniu și ce subdomenii, ce țări și limbi și ce tipuri de pagini contează. Pentru un site de comerț electronic, asta înseamnă pagina de start, categoriile, produsele, blogul și orice pagini de destinație. Notează-le.
Acces. Acces de proprietar în Search Console pentru fiecare proprietate (versiunile http, https, www și non-www, dacă există), acces de citire la analytics și acces la CMS sau la jurnalele serverului, dacă le ai. Jurnalele serverului arată ce cer, de fapt, crawlerele, lucru pe care nicio simulare de crawler nu ți-l poate spune.
Punctul de referință. Un instantaneu al clicurilor, impresiilor, poziției medii și al paginilor care aduc cea mai mare parte a clicurilor, salvat într-o foaie de calcul cu data. Fără el, nu poți dovedi că o corectură a funcționat.
Înainte să faci orice crawl
Confirmă accesul de proprietar în Search Console pentru fiecare proprietate
Exportă 90 de zile de date despre interogări și pagini și salvează-le cu data de azi
Listează principalele tipuri de pagini și un URL exemplu pentru fiecare
Scrie obiectivul într-o singură propoziție: mai multe clicuri pe paginile care aduc bani, mai puține erori, șabloane mai rapide
Alege crawlerul și limitele lui (vezi secțiunea despre crawl de mai jos)
Un audit citește întreaga structură a unui site înainte de a repara vreo pagină individuală.
Metoda, în ordine: șapte etape
Ordinea contează. Crawlul îți arată ce există pe site. Indexarea îți arată ce păstrează Google. Datele de căutare îți arată ce găsesc și pe ce dau clic oamenii. Viteza, conținutul și linkurile explică apoi de ce o pagină performează slab. Dacă faci invers, vei petrece ore rescriind o pagină pe care Google nu o poate indexa oricum.
Cele șapte etape ale unui audit SEO
Parcurge site-ulListează fiecare URL cu codul de stare, titlul, canonicalul, directivele robots și linkurile interne.
Verifică indexareaCompară ce publici cu ce indexează Google și citește motivul fiecărei excluderi.
Citește datele de căutareGăsește paginile și interogările care câștigă sau pierd clicuri și pe cele aflate aproape de prima pagină.
Testează viteza și mobilulMăsoară Core Web Vitals pe fiecare șablon, începând cu datele de teren de la utilizatori reali.
Analizează conținutul paginilorVerifică titlurile, anteturile, profunzimea, duplicările și linkurile interne, pagină cu pagină și șablon cu șablon.
Evaluează autoritatea și linkurileUrmărește domeniile care trimit linkuri în timp, linkurile pierdute, textele ancoră și semnalele de spam.
Verifică vizibilitatea în AIConfirmă că crawlerele AI pot ajunge la paginile tale și testează dacă motoarele de răspuns te menționează.
Verificări înainte de auditul SEO: ce să confirmi înainte să ai încredere în date
Verificările dinaintea auditului SEO confirmă că site-ul pe care urmează să-l auditezi este cel pe care îl văd Google și vizitatorii și că datele tale sunt suficient de fiabile ca să acționezi pe baza lor. Alocă aproximativ o oră pentru ele înainte de orice crawlare. O proprietate greșită, o regulă de staging încă activă sau o măsurare defectă pot face ca fiecare constatare ulterioară să fie greșită, iar o crawlare nu va arăta niciuna dintre acestea.
Confirmă ce versiune a site-ului este activă
Cere fiecare variantă a domeniului: http, https, cu www și fără www, cu și fără slash final. Fiecare ar trebui să ajungă la aceeași adresă finală, idealmente după o singură redirecționare. Două versiuni active împart linkurile și semnalele între ele, iar un crawler le va raporta pe amândouă ca sănătoase.
Citește antetul Location al fiecărui răspuns. Ar trebui să indice direct adresa preferată, nu o a doua redirecționare. Repetă verificarea pe pagina de start și pe o pagină adâncă, pentru că regulile de redirecționare diferă adesea între șabloane.
Verifică să nu fi ajuns pe site-ul live nicio setare de test
Setările de staging sunt una dintre cele mai frecvente cauze ale unei scăderi bruște. Verifică robots.txt-ul live, eticheta meta robots și antetul X-Robots-Tag pe pagina de start și pe un articol. O regulă Disallow pentru întregul site sau un noindex rămas dintr-o versiune de test pot ascunde secțiuni din căutare, deși paginile se încarcă în continuare pentru vizitatori. Dacă găsești una, repar-o înainte de a audita acele secțiuni, pentru că orice constatare ulterioară ar descrie un site pe care Google nu îl poate vedea.
Construiește un jurnal al modificărilor înainte să diagnostichezi o scădere
Scrie o listă datată cu fiecare lansare, reproiectare, actualizare de CMS, migrare și modificare de robots sau noindex din ultimele șase luni. Apoi compară aceste date cu începutul oricărei schimbări de trafic. O scădere care începe în ziua lansării unui șablon indică acel șablon. O scădere fără nicio schimbare în apropiere poate indica o actualizare a căutării și are nevoie de o verificare diferită. Fără jurnal, vei da vina pe ce ai privit ultima dată. Pentru modificările care afectează URL-uri, lista de verificare pentru migrarea SEO arată ce trebuie notat.
Verifică datele pe care se va baza auditul
Compară clicurile din Search Console cu sesiunile organice din analitice pentru aceleași 90 de zile. Cele două linii nu trebuie să coincidă, dar ar trebui să se miște în aceeași direcție. Dacă se despart, verifică etichetele de pe paginile importante, fereastra de consimțământ pentru cookie-uri și filtrarea botilor înainte să diagnostichezi site-ul. Comparația celor două instrumente explică ce numără fiecare.
Etapa 1: parcurge site-ul și repară ce găsește crawlerul
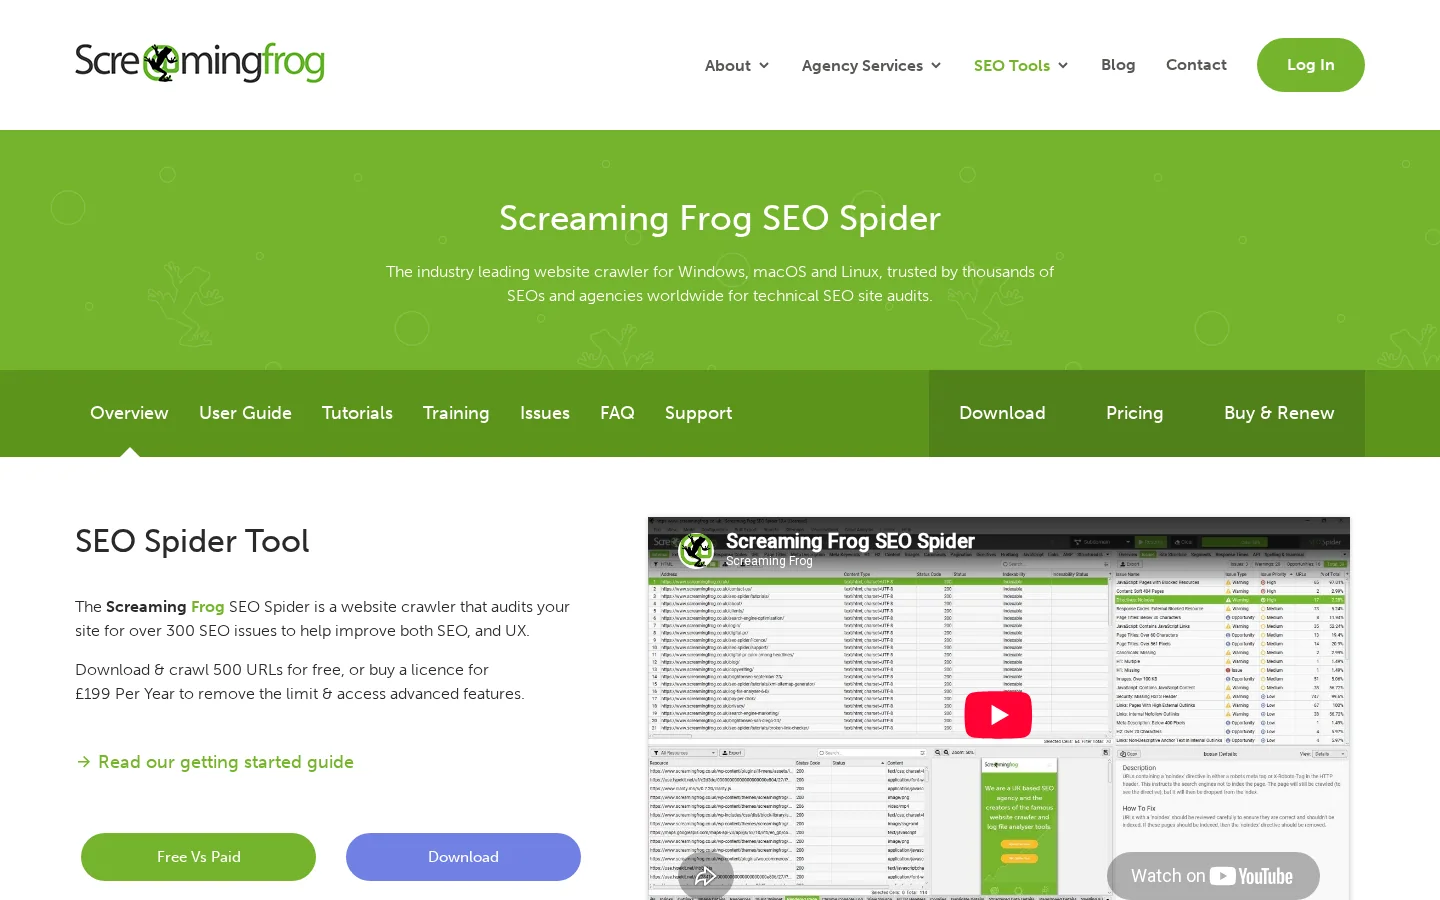
Un crawler face, la scară mai mică, ceea ce face Googlebot: pornește de la o pagină, urmează linkurile pe care le găsește și notează ce vede pentru fiecare URL. Instrumentul pe care îl folosim în majoritatea auditurilor este Screaming Frog SEO Spider. Versiunea sa gratuită parcurge până la 500 de URL-uri, suficient pentru un site mic sau pentru o secțiune a unui site mare. O licență plătită elimină limita. Ghidul nostru pentru Screaming Frog explică configurarea.
Screaming Frog SEO Spider, crawlerul desktop care listează fiecare URL al site-ului cu codul de stare și directivele.
Începe crawlul de pe pagina de start și din sitemap, apoi compară cele două liste. Fiecare URL care apare doar într-una dintre ele este o întrebare. Configurează crawlerul să respecte robots.txt la fel ca Googlebot și să randeze JavaScript dacă site-ul tău depinde de el. Un crawl care nu randează paginile va rata conținutul pe care îl văd utilizatorii.
Coduri de stare și lanțuri de redirecționare
Mai întâi filtrează răspunsurile 4xx și 5xx. Un 404 nu este, de unul singur, o problemă. Devine problemă când linkurile interne încă duc spre el, pentru că trimit utilizatorii și crawlerele într-un drum fără ieșire. Găsește linkurile interne care duc la pagini de eroare și indică-le spre un URL funcțional. Apoi verifică lanțurile de redirecționare: un URL vechi redirecționează către un al doilea, care redirecționează către un al treilea. Fiecare salt adaugă latență și diluează semnalul. Aplatizează fiecare lanț, astfel încât URL-ul vechi să indice direct spre URL-ul final.
Verifică și tipul redirecționării. O redirecționare temporară 302 folosită pentru o mutare permanentă ar trebui să fie 301. Ghidul nostru 301 vs 302 oferă regula de decizie.
Directive robots, noindex și canonicale
Trei setări pot ascunde o pagină fără ca cineva să observe. O regulă disallow în robots.txt oprește crawlingul. O meta etichetă noindex sau un antet HTTP X-Robots-Tag oprește indexarea. O etichetă canonical care indică spre un alt URL spune motoarelor de căutare ce versiune să păstreze. Verific-le pe fiecare tip de pagină, pentru că o regulă adăugată pentru a repara o secțiune blochează adesea alta. Un caz frecvent: o regulă de staging care n-a fost niciodată scoasă din robots.txt-ul live.
Atenție
Blocarea unei pagini în robots.txt nu înseamnă eliminarea ei din căutare. Dacă Google nu poate parcurge pagina, nu poate citi eticheta noindex de pe ea. Pentru a scoate o pagină din index, permite crawlingul și adaugă noindex, apoi așteaptă ca Google să recrawleze pagina.
Pagini orfane și adâncimea de clic
O pagină orfană nu are niciun link intern care să indice spre ea. Crawlerele o găsesc doar prin sitemap sau printr-un link extern, iar utilizatorii aproape niciodată nu ajung la ea. Pentru a identifica paginile orfane, compară trei liste: URL-urile la care crawlerul ajunge prin linkuri, URL-urile din sitemap și URL-urile care primesc vizite în analytics. O pagină care apare în sitemap sau primește vizite, dar nu are niciun link intern de intrare, este candidată la statutul de orfană.
Măsoară și adâncimea de clic, adică numărul de clicuri de la pagina de start. O pagină importantă îngropată la al cincilea sau al șaselea clic primește puțină atenție din partea crawlerelor și puține linkuri interne. Leag-o dintr-o pagină hub relevantă și asigură-te că și hub-ul este puțin adânc.
Titluri, descrieri și duplicate
Filtrează titlurile lipsă, titlurile duplicate, meta descrierile duplicate și titlurile prea lungi pentru a fi afișate integral în rezultatele de căutare. Duplicatele provin aproape întotdeauna dintr-un șablon, nu de la un autor. Un șablon de produs care afișează același titlu pentru fiecare variantă produce sute de duplicate, iar repararea șablonului le rezolvă pe toate deodată. Tratează eticheta title ca pe o sugestie puternică pentru Google, nu ca pe o garanție. Google o rescrie uneori, ceea ce este un motiv în plus să o păstrezi exactă și specifică.
Jurnalele serverului închid bucla crawlului. Ele arată ce URL-uri a cerut Googlebot, cât de des și ce coduri de stare a primit. Dacă ai acces la ele, compară cererile cu sitemap-ul. Paginile pe care Googlebot le lovește constant, dar care nu aduc valoare, sunt un semn de risipă de crawl, explicată în intrarea noastră din glosar despre bugetul de crawl.
Etapa 2: indexarea, ce păstrează Google și de ce
Raportul Indexarea paginilor din Search Console listează URL-urile pe care Google le cunoaște și statusul pe care i-l atribuie fiecăruia. Deschide-l și sortează după motiv, nu după număr. Fiecare motiv indică o corectură diferită. Definițiile oficiale ale Google, din ajutorul Search Console despre statusurile de indexare, sunt referința pentru etichetele de mai jos.
Status în raport
Ce înseamnă
Ce trebuie făcut
Descoperită, în prezent neindexată
Google a găsit URL-ul, dar nu l-a parcurs încă și a reprogramat crawlul, deoarece a presupus că site-ul ar fi supraîncărcat
Verifică timpii de răspuns ai serverului și adâncimea URL-ului. Asigură-te că linkurile interne duc spre el
Parcursă, în prezent neindexată
Google a parcurs pagina și a ales să nu o indexeze. Google nu indexează fiecare pagină de pe web
Verifică mai întâi calitatea: conținut subțire, aproape duplicate, linkuri interne slabe. Folosește Inspecția URL-ului pe paginile importante
Blocată de robots.txt
Googlebot nu are voie să parcurgă acest URL
Confirmă că blocarea este intenționată. Elimin-o dacă pagina ar trebui să apară în clasament
Exclusă de eticheta noindex
Pagina are o directivă noindex
Elimină directiva dacă pagina ar trebui să apară în clasament. Păstreaz-o pe paginile care trebuie să rămână în afara indexului, cum ar fi rezultatele căutării interne
O regulă practică: atunci când un întreg tip de pagină arată o proporție mare de „parcursă, în prezent neindexată”, uită-te mai întâi la șablon și abia apoi la articole. Șabloanele subțiri produc pagini subțiri, iar corectarea unui singur articol nu schimbă tiparul. Ghidul nostru despre statusul parcursă, în prezent neindexată acoperă cauzele în detaliu.
Pentru paginile care contează, folosește Inspecția URL-ului, câte un URL pe rând. Ea arată data ultimului crawl, dacă pagina este indexată și canonicalul ales de Google. Când canonicalul ales nu este cel pe care l-ai declarat, cauza este aproape întotdeauna duplicarea sau semnale contradictorii, de exemplu un canonical care indică spre un URL redirecționat sau linkuri interne care favorizează versiunea cu parametri.
Etapa 3: datele de căutare, unde se află oportunitățile
Raportul Performanță din Search Console este cel mai util set de date gratuit pentru un audit. Implicit, arată ultimele trei luni, ceea ce este prea scurt pentru o tendință. Exportă cel puțin 90 de zile de date despre interogări și pagini și păstrează fișierul cu data, astfel încât să îl poți compara cu următorul audit. Grupează tabelul pe pagină și pe interogare și folosește filtrele de țară și de dispozitiv atunci când site-ul servește mai multe piețe.
Google Search Console, sursa datelor despre interogări, pagini și indexare folosite în audit.
Patru analize găsesc cea mai mare parte a oportunității din aceste date.
Distanța de atac (striking distance). Interogările pentru care pagina ta se află pe pozițiile 8 până la 20, cu impresii reale. Aceste pagini au deja relevanță. De obicei au nevoie de un titlu mai bun, de mai multă profunzime pentru interogare sau de câteva linkuri interne din pagini conexe, nu de o rescriere.
Declin (decay). Pagini ale căror clicuri au scăzut între două perioade egale. Compară ultimele 90 de zile cu cele 90 de zile dinaintea lor. Uită-te întâi la pagină, apoi la interogările pe care le-a pierdut, pentru că o pagină își poate menține poziția în timp ce o funcție nouă îi ia clicurile.
Canibalizare. Interogări pentru care două sau mai multe dintre URL-urile tale apar și își schimbă pozițiile de la o săptămână la alta. Alege o pagină țintă pentru interogare, apoi unește pagina mai slabă în ea sau fă cele două pagini clar diferite prin intenție.
Diferențe de CTR. Pagini care mențin o poziție normală, dar câștigă mai puține clicuri decât pagini similare. Compară rata de clic cu media pentru acea poziție, apoi rescrie titlul și descrierea paginilor cu performanță slabă.
Pentru a izola un tip de pagină, adaugă un filtru de pagină cu o expresie regulată. De exemplu, pentru a vedea doar paginile de blog care vizează interogări de tip ghid, introdu aceste două valori:
Rata de clic depinde foarte mult de partea de sus a rezultatelor. Câteva cifre publicate te ajută să judeci dacă o diferență este reală. Într-un studiu despre ratele de clic Google, primul rezultat organic a primit 27,6% dintre clicuri, primele trei împreună au primit 54,4%, iar rezultatele de pe a doua pagină au primit 0,63%.
De ce poziția întâi contează atât de mult
27,6%dintre clicuri merg la primul rezultat organic
54,4%dintre clicuri merg la primele trei rezultate împreună
0,63%dintre clicuri merg la rezultatele de pe a doua pagină
Sursa: Backlinko, studiul despre ratele de clic Google (backlinko.com/google-ctr-stats)
Folosește aceste medii ca verificare de bun-simț, nu ca țintă. Ele amestecă toate tipurile de interogări, în timp ce cifrele tale depind de intenția de căutare, de interogările de brand și de elementele care apar deasupra rezultatului tău, precum videoclipuri, imagini sau răspunsuri AI. Compară fiecare pagină cu paginile de pe propriul tău site care se clasează pentru interogări similare.
Pragurile de mai jos sunt puncte de plecare pe care le folosim pentru a sorta datele. Nu sunt reguli Google, așa că ajustează-le la dimensiunea site-ului și la volumul interogărilor tale.
Verificare
Prag de start (regula noastră empirică)
De ce contează
Distanța de atac
Poziție medie între 8 și 20, cel puțin 50 de impresii în 90 de zile
Cererea există, iar pagina este suficient de aproape ca să urce
Declin
Clicuri în scădere cu 30% sau mai mult între două perioade egale
Trafic pierdut suficient cât să justifice o analiză
Conținut subțire
Sub 300 de cuvinte de text principal, fără navigare și elemente repetitive
Adesea prea puțin pentru a răspunde interogării. O pagină scurtă de instrument poate fi corectă, deci verifică intenția
Linkuri interne
Mai puțin de 3 linkuri interne de intrare din pagini indexabile
Un semnal slab de importanță și un semn comun al unei pagini orfane
Datele Search Console îți oferă și o a doua verificare: interogările pentru care te clasezi, dar pe care nu le-ai vizat niciodată. Ele sunt adesea cele mai simple adăugiri la o pagină existentă, pentru că relevanța este deja dovedită de impresii.
Etapa 4: Core Web Vitals și mobilul
Documentația Google despre Core Web Vitals definește trei măsuri ale experienței utilizatorului și pragurile lor. O pagină se află în intervalul „bun” când Largest Contentful Paint este de 2,5 secunde sau mai puțin, Interaction to Next Paint este de 200 de milisecunde sau mai puțin, iar Cumulative Layout Shift este de 0,1 sau mai puțin. INP a devenit un Core Web Vital stabil în 2024, înlocuind First Input Delay.
Metrică
Bună când
Ce măsoară
Remediere obișnuită
LCP
2,5 secunde sau mai puțin
Cât de repede se încarcă cel mai mare element vizibil
Optimizează imaginea principală, redu timpul de răspuns al serverului, precarcă fontul de care pagina are nevoie primul
INP
200 de milisecunde sau mai puțin
Cât de repede răspunde pagina la clicuri, atingeri și apăsări de taste în timpul vizitei
Împarte sarcinile JavaScript lungi, elimină scripturile terțe grele, evită blocarea firului principal la încărcare
CLS
0,1 sau mai puțin
Cât conținut se mișcă în timp ce pagina se încarcă
Setează lățimea și înălțimea pentru imagini și embed-uri, rezervă spațiu pentru bannere și reclame, evită elementele care se încarcă târziu deasupra pliului
Citește mai întâi datele de teren, apoi pe cele de laborator. Datele de teren vin de la utilizatori reali de Chrome și îți spun dacă vizitatorii chiar suferă. Datele de laborator vin dintr-un test simulat și îți spun de ce o pagină este lentă. PageSpeed Insights arată ambele: datele de teren atunci când Google are suficient trafic pentru URL, iar datele de laborator pentru fiecare URL testat.
PageSpeed Insights, care arată date de teren și de laborator pentru orice URL.
Testează trei până la cinci URL-uri pe șablon, nu doar pagina de start. Un șablon de produs, unul de categorie și unul de blog pot avea scoruri foarte diferite pe același site, pentru că încarcă scripturi diferite. Un scor de laborator ridicat împreună cu un INP de teren slab este un rezultat frecvent pe site-urile cu manageri de etichete și widgeturi de chat grele. În acest caz, testul de laborator nu este greșit, dar nu reprezintă interacțiunea pe care o are utilizatorul cu pagina după ce se încarcă.
Pe mobil, verifică trei lucruri. Conținutul principal al versiunii mobile ar trebui să corespundă versiunii desktop, pentru că Google folosește în principal versiunea mobilă a unei pagini pentru indexare. Datele structurate și linkurile interne ar trebui să fie aceleași pe ambele. Și niciun interstițial intruziv nu ar trebui să acopere conținutul la sosirea vizitatorului. Viteza contează pentru clasare, dar motivul mai util pentru a o repara este că șabloanele lente pierd vizitatori înainte ca aceștia să citească ceva.
Etapa 5: conținutul paginilor și linkurile interne
Pentru fiecare pagină importantă, verifică titlul, anteturile, profunzimea răspunsului, linkurile de intrare și de ieșire și dacă există un duplicat apropiat. Fă asta pe un eșantion de pagini din fiecare șablon, apoi pe paginile care apar în datele de căutare ca distanță de atac sau în declin.
Verificare
Trece când
Eșuează când
Eticheta title
Numește subiectul și interogarea principală a paginii și este unică în tot site-ul
Duplică o altă pagină sau este doar valoarea implicită a șablonului, cum ar fi numele site-ului
H1
Unul pe pagină, care exprimă subiectul în cuvinte simple
Lipsește, se repetă sau este înlocuit cu un logo sau un banner
Primul ecran
Întrebarea din interogare primește răspuns aproape de început
Primul ecran conține context și text de brand, iar răspunsul apare după câteva derulări
Profunzime
Acoperă sub-întrebările pe care oamenii le pun despre subiect, cu detalii concrete
Subțire sau umplut cu paragrafe repetate
Linkuri interne
Este legată din pagini conexe și duce mai departe, la următorul pas logic
Orfană sau legată doar din subsol sau din sitemap
Date structurate
Corespund conținutului pe care vizitatorul îl vede pe pagină
Marchează conținut care nu există pe pagină sau folosesc tipul greșit
Linkurile interne sunt cea mai ieftină pârghie din întregul audit. Un link dintr-o pagină care deja se clasează, plasat în textul principal și folosind cuvintele interogării țintă în ancoră, transmite atât context, cât și autoritate. Ancorele generice precum „click aici” sau „citește mai mult” transmit foarte puțin sens. Începe cu paginile care aduc cel mai mult trafic, pentru că fiecare link nou din ele ajunge la o pagină cu un public real.
Conținutul duplicat și aproape duplicat merită o trecere separată. Filtrele de categorie, parametrii de sortare și parametrii de urmărire creează adesea multe URL-uri care afișează aceeași listă. Decide ce versiune ar trebui să existe, apoi folosește eticheta canonical, regulile robots sau gestionarea parametrilor care se potrivește. Nu lăsa decizia pe seama Google, pentru că s-ar putea să nu-ți placă rezultatul.
Sfat
Pentru o primă trecere rapidă pe o singură pagină, instrumentul gratuit de audit SEO on-page rulează verificările obișnuite pentru titlu, anteturi, linkuri și meta etichete, ca să poți să-ți petreci timpul pe constatările care cer judecată.
Etapa 6: autoritate și linkuri
Verificarea profilului de linkuri răspunde la trei întrebări: câștigi domenii care trimit linkuri într-un ritm constant, ai pierdut linkuri care contau și există tipare care par manipulate? Exportă domeniile care trimit linkuri în timp dintr-un instrument de backlinkuri, apoi caută creșteri bruște, care vin adesea dintr-o campanie plătită sau din spam, și scăderi, care vin adesea din pagini expirate sau dintr-o migrare de site. Ghidul nostru pentru auditul backlinkurilor prezintă analiza completă.
Fii atent cu instrumentul de respingere a linkurilor (disavow). Ghidul propriu al Google spune că majoritatea site-urilor nu au nevoie de el. Folosește-l când ai un tipar clar de linkuri pe care nu le-ai câștigat și o acțiune manuală sau o problemă serioasă legată de ele, nu pentru că un instrument de backlinkuri a dat un scor mic unor domenii. Respingerea din greșeală a unor linkuri bune costă mai mult decât lăsarea în loc a câtorva rele.
Etapa 7: vizibilitatea în AI și crawlerele AI
Două verificări aparțin acum fiecărui audit. Prima este accesul: pot crawlerele AI să ajungă la paginile tale? Verifică regulile robots.txt pentru fiecare crawler care te interesează. OpenAI folosește GPTBot și OAI-SearchBot, Anthropic folosește ClaudeBot, iar Perplexity folosește PerplexityBot, iar ele nu servesc toate același scop. O singură regulă pentru toate este rareori decizia corectă. Ghidul nostru despre crawlerele AI le listează și explică rolurile lor.
Exemplul de mai sus este o decizie posibilă, nu o recomandare pentru fiecare site. Permite unui crawler să-ți citească paginile pentru răspunsuri de căutare și blochează un altul folosit pentru antrenare. Decide pentru fiecare crawler, notează decizia și verifică fișierul după fiecare lansare, pentru că un robots.txt care blochează totul apare adesea după o publicare din staging.
A doua verificare este vizibilitatea: te menționează motoarele de răspuns atunci când un cumpărător pune întrebarea pe care o vizezi? Construiește o listă de zece până la douăzeci de prompturi din întrebări reale din datele tale de căutare și din apelurile de vânzare. Rulează-le în ChatGPT, Perplexity și Gemini, notează ce mărci și ce URL-uri sunt citate și repetă fiecare prompt de mai multe ori pe parcursul câtorva zile, pentru că răspunsurile se schimbă între rulări. Metoda de audit a vizibilității AI explică cum se notează rezultatele.
Metode de audit: care se potrivește situației tale
Auditurile diferă după domeniu și după punctul de plecare. În practică sunt comune cinci metode. Fiecare este potrivită într-o situație diferită, iar majoritatea echipelor combină două dintre ele.
1. Auditul tehnic complet
Principiu: acoperă întregul site, fiecare tip de pagină și fiecare sursă de date, apoi clasează constatările. Folosește-l când pregătești o migrare, după o scădere bruscă de trafic sau faci primul audit al unui site mare. Avantaj: găsește probleme structurale pe care nicio analiză a unei pagini individuale nu le poate vedea, cum ar fi o navigare pe facete care înmulțește URL-urile. Limită: este lent și produce multe constatări care necesită o a doua trecere pentru ordonare. Exemplu: un retailer cu 40000 de URL-uri de produs descoperă că un singur parametru de filtrare generează majoritatea duplicatelor sale, ceva ce nicio analiză a unui singur produs nu ar fi arătat.
2. Auditul bazat întâi pe date
Principiu: pornește de la ce s-a schimbat în datele de căutare și diagnostichează doar paginile și interogările implicate. Folosește-l când faci o analiză lunară, când tocmai a fost lansată o actualizare de bază sau când echipa este mică. Avantaj: munca este prioritizată după trafic de la primul minut. Limită: este orb în fața paginilor care nu au încă date, cum ar fi secțiunile noi sau paginile blocate de la început. Exemplu: un blog care a pierdut clicuri pe cinci pagini verifică acele cinci pagini, găsește două care se canibalizează și le unește.
3. Auditul la nivel de pagină
Principiu: rulează fiecare verificare pe un singur URL, apoi decide dacă are nevoie de rescriere. Folosește-l când o singură pagină care aduce bani performează slab sau înainte de o rescriere planificată. Avantaj: rapid și concret, cu un înainte și un după clar. Limită: nu poate arăta tipare, astfel că un bug de șablon poate părea o problemă izolată. Exemplu: o pagină de produs cu un titlu și un conținut bune are un canonical care indică spre o variantă epuizată.
4. Auditul diferenței față de concurenți
Principiu: compară-ți paginile și subiectele cu cele care se clasează deasupra ta pentru aceleași interogări. Folosește-l când planifici conținut nou sau linkuri noi. Avantaj: arată ce recompensează piața în practică, inclusiv profunzimea, formatul și sub-întrebările acoperite. Limită: copierea liderului te poate duce într-un subiect aglomerat sau cu o intenție greșită. Verifică ce au în comun rezultatele de top înainte să decizi. Exemplu: primele cinci rezultate pentru o interogare răspund toate la o întrebare despre preț pe primul ecran, iar al tău nu.
5. Auditul vizibilității în AI
Principiu: verifică dacă crawlerele AI îți pot citi paginile și dacă motoarele de răspuns te citează pentru întrebările care contează. Folosește-l când trebuie să știi dacă instrumentele AI recomandă brandul tău. Avantaj: acoperă un canal pe care instrumentele tradiționale de urmărire a pozițiilor nu îl arată. Limită: răspunsurile variază între rulări, deci eșantionul trebuie repetat înainte să tragi concluzii. Exemplu: o companie de software este citată pentru o funcție pe care nu o mai vinde, ceea ce arată că paginile ei de comparație sunt depășite.
Metodă
Pornește de la
Cel mai potrivit pentru
Limita principală
Audit tehnic complet
Crawlul și toate sursele de date
Migrări, site-uri mari, scăderi bruște
Lent și greu de ordonat fără plan
Audit bazat pe date
Schimbările din datele de căutare
Analize lunare, echipe mici
Ratează paginile fără date încă
Audit la nivel de pagină
Un singur URL
O pagină care performează slab
Nu poate vedea tipare pe șabloane
Audit al diferenței față de concurenți
Rezultatele de deasupra ta
Conținut nou și linkuri noi
Risc de copiere a unei intenții greșite
Audit al vizibilității AI
Accesul crawlerelor și motoarele de răspuns
Să afli dacă AI te recomandă
Răspunsurile variază, deci eșantioanele se repetă
Audit rapid vs audit complet
Audit rapid
Doar datele de căutare și șabloanele principale
Se încheie cu o listă scurtă, ordonată
Ratează problemele structurale și de crawl
Audit complet
Acoperă fiecare tip de pagină și șablon
Găsește probleme structurale și de crawl
Lent și ușor de încheiat fără un plan
Sfatul nostru: începe cu auditul rapid și treci la cel complet doar când auditul rapid indică o cauză structurală sau când urmează să modifici arhitectura site-ului.
Prioritizare: de la constatări la un plan
Un audit cu 400 de constatări fără ordine valorează mai puțin decât unul cu zece. Evaluează fiecare constatare după două lucruri: cât trafic sau venit este pus în pericol și cât de greu este de reparat. Începe cu elementele cu impact mare și efort mic. Apoi ia elementele cu impact mare care cer mai multă muncă, dar deblochează un întreg șablon, pentru că o singură corectură acolo schimbă mii de pagini.
Constatare
Trafic în pericol
Efort
Prioritate
Șablonul leagă de pagini 404 din fiecare pagină
Ridicat
Scăzut
Fă primul
Pagini care aduc bani cu titluri duplicate
Ridicat
Scăzut
Fă primul
LCP lent pe șablonul de categorie
Ridicat
Mediu
Planifică în sprintul următor
Articole de blog cu declin
Mediu
Mediu
Actualizează în ordinea clicurilor pierdute
Pagini orfane din glosar
Scăzut
Scăzut
Grupează cu lucrul la linkurile interne
Pagini de arhivă de etichete cu conținut subțire
Scăzut
Mediu
Verifică intenția, apoi noindex sau consolidare
Atribuie fiecărui element un responsabil, o dată și indicatorul pe care te aștepți să îl miște. O constatare fără responsabil este doar o notă, iar notele nu schimbă clasamentele. Măsoară din nou după ce Google a recrawlat paginile afectate, ceea ce poate dura săptămâni, și compară cu punctul de referință salvat la început. Când prezinți rezultatele, șablonul de raport de audit SEO îți oferă o structură pe care managerii și clienții o pot citi în zece minute.
Dacă vrei traficul Google și cel AI într-un singur loc în timp ce urmărești aceste corecturi, panoul GEO / SEO de la Sorank le afișează alăturat.
Audit SEO în 90 de minute: ce poți termina într-o singură sesiune
Auditul SEO în 90 de minute verifică paginile care aduc cel mai mult trafic din căutare, într-o ordine care găsește mai întâi pierderile reale. Folosește-l când ai o singură sesiune și ai nevoie de o listă ordonată de remedieri, nu de o revizuire a fiecărui URL. Limitează lucrul la paginile principale și la un URL exemplu pentru fiecare șablon, iar rezultatul este utilizabil în aceeași zi.
Împarte sesiunea în blocuri fixe și oprește fiecare bloc când i se termină timpul. Limita de timp face parte din metodă, pentru că te obligă să alegi.
Minute
Sarcină
Rezultat
0 până la 10
Exportă 90 de zile de date despre interogări și pagini din Search Console și listează primele 20 de pagini după clicuri
O referință salvată și o listă scurtă de pagini
10 până la 25
Aplică pe lista scurtă verificările pentru distanța de poziționare și pentru scădere din Etapa 3
Paginile care au pierdut clicuri sau stau între pozițiile 8 și 20
25 până la 40
Crawlează un URL exemplu pentru fiecare șablon și verifică codul de stare, canonicalul și directivele robots
Erori, canonicale greșite și blocaje, pe șablon
40 până la 55
Deschide raportul Indexarea paginilor și sortează motivele după număr
Starea care afectează cele mai multe pagini
55 până la 70
Rulează PageSpeed Insights pe un URL pentru fiecare șablon, citind mai întâi datele de teren
Șablonul cu cel mai slab LCP sau INP din teren
70 până la 90
Scrie primele zece constatări, cu trafic în pericol, efort și responsabil
Un plan ordonat pe care îl poți trimite în aceeași zi
Fiecare rând răspunde la o întrebare, deci poți sări peste un rând fără să pierzi celelalte. Dacă raportul de indexare nu arată nimic neobișnuit, dă acest timp datelor din căutare, care sunt de obicei drumul mai rapid spre o remediere.
Ce nu vede un audit de 90 de minute
Limita de timp ascunde trei lucruri. Ratează problemele structurale, precum un filtru care înmulțește URL-urile, pentru că citești doar eșantioane. Nu folosește jurnalele serverului, deci nu vezi cât de des cere un crawler o pagină. Și sare peste profilul de linkuri, care necesită un export complet dintr-un instrument de backlinkuri. Notează-le ca întrebări deschise pentru un audit de backlinkuri ulterior sau pentru o revizuire completă, ca auditul scurt să nu pară mai complet decât este.
Greșeli care irosesc o sesiune scurtă
Cea mai frecventă greșeală este să începi cu crawlerul. Crawlarea unui site mare poate dura mai mult decât întreaga sesiune și poate returna mai multe avertismente decât poate citi cineva. Începe cu datele din căutare și deschide crawlerul doar pentru paginile care au clicuri sau impresii. Repară întâi avertismentele de pe acele pagini, pentru că avertismentele de pe paginile pe care nu le vizitează nimeni nu schimbă traficul tău.
Sfat
Pune sesiunea în calendar cu un cronometru și un singur fișier de rezultat. Folosește coloanele din șablonul de raport pentru auditul SEO de la început, ca lista să fie gata de partajat la minutul 90.
Greșeli frecvente, cum le recunoști și cum le repari
Majoritatea auditurilor conțin aceleași greșeli. Sunt ușor de evitat odată ce știi semnele.
Auditul fără domeniu
Ce este: auditul acoperă totul, așa că nimic nu se termină. Cum o recunoști: raportul are sute de probleme, niciuna cu o cifră de trafic sau un responsabil. Cum o repari: reia cu brieful clar delimitat din prima secțiune, limitează crawlul la tipurile de pagini care contează și sortează constatările după trafic înainte de a scrie altceva.
Tratarea avertismentelor drept clasamente
Ce este: echipa repară avertismentele pe care instrumentul le afișează cu roșu, chiar dacă afectează pagini pe care nimeni nu le vizitează. Cum o recunoști: numărul de avertismente scade, în timp ce clicurile pe paginile care aduc bani continuă să scadă. Cum o repari: unește crawlul cu datele de căutare și repară mai întâi problemele de pe paginile care au trafic, impresii sau linkuri.
A avea încredere într-un singur crawl ca fiind adevărul
Ce este: crawlerul nu raportează erori, așa că echipa concluzionează că site-ul este sănătos. Cum o recunoști: Search Console raportează multe URL-uri „parcursă, în prezent neindexată” sau „descoperită” pe care crawlerul nu le-a semnalat niciodată. Cum o repari: compară crawlul cu sitemap-ul, raportul de indexare și jurnalele serverului. Un crawler vede doar ceea ce poate ajunge prin linkuri și randare, deci conținutul din spatele autentificărilor, al scripturilor sau al filtrelor pe facete poate lipsi din lista lui.
Repararea paginilor în loc de șabloane
Ce este: echipa editează același titlu, aceeași imagine sau același canonical pe sute de pagini, una câte una. Cum o recunoști: aceeași constatare apare pe majoritatea URL-urilor unui tip de pagină. Cum o repari: repară șablonul o singură dată, apoi verifică un eșantion de pagini ca să confirmi că schimbarea a funcționat peste tot. O singură modificare de șablon repară tot grupul.
Blocarea unei pagini ca să dispară din căutare
Ce este: echipa adaugă un disallow în robots.txt pentru o pagină pe care vrea să o scoată din Google. Cum o recunoști: pagina rămâne în index ca un URL gol, fără fragment, iar raportul o arată ca blocată. Cum o repari: permite crawlingul, adaugă directiva noindex și așteaptă ca Google să recrawleze pagina. Odată ce a ieșit din index, o poți bloca dacă ai nevoie, dar nu este obligatoriu.
Exemplu (ilustrativ)
Imaginează-ți un site care a retras un set de pagini de campanie vechi și le-a blocat în robots.txt. Paginile continuă să apară în căutare ca URL-uri goale, fără descriere, pentru că alte site-uri încă leagă către ele. Eliminarea blocării și adăugarea noindex permit Google să parcurgă paginile, să citească directiva și să le scoată din index.
Urmărirea unui scor de laborator perfect
Ce este: echipa optimizează pentru un scor de 100 într-un test de laborator și ignoră datele de teren. Cum o recunoști: scorul de laborator este ridicat, dar INP-ul de teren pentru același șablon este slab în raportul Core Web Vitals din Search Console. Cum o repari: profilează interacțiunile pe care le fac utilizatorii reali, de obicei după ce pagina s-a încărcat. Caută sarcinile lungi declanșate de scripturi, nu timpul de încărcare până la prima randare.
Cât de des să rulezi un audit
Rulează un audit rapid în fiecare lună, pe datele de căutare și pe cele mai importante șabloane. Rulează un audit complet după o migrare, un redesign, o schimbare de CMS sau o scădere bruscă a traficului, și fă o analiză completă pe an, pentru a prinde deriva structurală. Datele de căutare ar trebui urmărite continuu, pentru că o scădere a clicurilor este mai utilă ca alertă decât ca reamintire din calendar.
Audit al site-ului: o verificare de sănătate repetabilă pentru întregul domeniu
Auditul site-ului este un crawl al fiecărui URL accesibil de pe un domeniu, raportat pe tip de problemă și pe severitate. Arată ce este defect în tot site-ul, inclusiv tipare pe care o verificare pagină cu pagină le ratează. Nu spune însă ce remediere va muta clasamentele, de aceea combinați-l cu datele de căutare.
Stabiliți sfera crawlului înainte de a începe
Filtrele, opțiunile de sortare și etichetele de urmărire pot genera mult mai multe URL-uri decât aveți pagini, iar majoritatea afișează aceeași listă. Excludeți acei parametri și fișierele media și parcurgeți fiecare subdomeniu ca proiect separat. Păstrați rata cererilor scăzută, ca serverul să rămână rapid pentru vizitatorii reali. Păstrați paginarea (page=) în sfera crawlului, pentru că listele paginate pot conține pagini pe care vreți să le indexați.
Majoritatea crawlerelor acceptă reguli de excludere scrise ca expresii regulate, ca cele de mai sus. Testați-le pe un crawl scurt și verificați că numărul de URL-uri scade doar pentru parametrii pe care i-ați vrut excluși.
Citiți severitatea înainte de scor
Fiecare instrument grupează problemele pe niveluri și calculează propriul scor de sănătate. Etichetele diferă de la un instrument la altul, dar logica de prioritizare este aceeași. Scorul este o linie de trend pentru un singur instrument, cu setări fixe, nu o notă pe care o aplică Google. Parcurgeți nivelurile în această ordine:
Nivel
Probleme tipice
Prima acțiune
Erori pe paginile indexabile
Răspunsuri 4xx sau 5xx la URL-urile pe care le vreți în clasament, linkuri interne rupte
Remediați primele, începând cu paginile care deja aduc clicuri
Erori pe paginile pe care nu le vreți indexate
Căutare internă ruptă, URL-uri de filtre sau de campanii retrase
Eliminați linkurile interne care mai duc spre ele
Avertismente
Titluri prea lungi, descrieri lipsă, anteturi duplicate
Remediați în loturi, de preferat printr-o singură modificare de șablon
Notificări
Sugestii minore de optimizare
Verificați o dată și acționați doar dacă se repetă pe paginile de vânzare
Comparați două crawl-uri, nu două scoruri
Cel mai util rezultat al unui audit al site-ului este diferența dintre două rulări. Exportați lista de probleme din ultima rulare, faceți crawl din nou cu aceleași setări și comparați numerele pe tip de problemă și pe URL. Problemele noi vin primele, pentru că o eroare nouă pe o pagină live urmează de obicei unei lansări recente. Asociați fiecare grup nou cu jurnalul de modificări înainte să atribuiți un responsabil.
De exemplu, prima rulare arată 42 de erori. A doua, patru săptămâni mai târziu, arată 57, iar 15 dintre cele noi sunt pe un șablon de prețuri lansat în săptămâna aceea. Remediați șablonul o singură dată. Dacă numărul revine spre 42, remedierea a funcționat, iar rularea devine punctul de referință pentru următoarea.
Păstrați rutina suficient de scurtă ca să fie repetată
Un audit al site-ului care durează o zi întreagă nu va fi repetat. Salvați sfera, regulile de excludere și tabelul de severități ca o singură configurație, ca următoarea rulare să dureze câteva minute. Programați crawl-ul și exportați de fiecare dată aceleași trei fișiere: lista de probleme, URL-urile indexabile și URL-urile care primesc clicuri. Ghidul nostru despre raportarea SEO automatizată explică ce să automatizați și cum să configurați.
Dacă mai alegeți un crawler, comparația noastră a instrumentelor de SEO tehnic ordonează opțiunile după sarcina pe care o îndeplinesc. Un audit al site-ului merită programat doar dacă cineva citește diferența dintre rulări. Altfel, devine încă un export într-un folder.
De unde să începi săptămâna aceasta
Dacă nu ai făcut niciodată un audit, fă patru lucruri în această ordine. Exportă 90 de zile de date din Search Console și salvează-le cu data. Parcurge șabloanele principale cu un crawler, începând cu versiunea gratuită de 500 de URL-uri dacă site-ul tău este mic. Citește raportul de indexare și sortează motivele. Apoi repară cele trei probleme majore la nivel de șablon pe care le-ai găsit și măsoară din nou după ce Google le recrawlează.
Exportă datele despre interogări și pagini și salvează punctul de referință.
Parcurge un URL exemplu pe șablon și notează codurile de stare, titlurile, canonicalurile și directivele robots.
Citește raportul de indexare și transformă fiecare status într-o întrebare cu un responsabil.
Repară cele trei cele mai mari probleme de șablon, apoi compară datele de căutare după următorul ciclu de recrawl.
Un audit bun nu se termină cu un document. Se termină cu o listă scurtă de corecturi pe care cineva le face luna aceasta și cu un punct de referință care dovedește dacă au funcționat.
Întrebări frecvente
Cât durează un audit SEO?
Depinde de dimensiunea site-ului și de cât de adânc vrei să mergi. Un audit concentrat pe șabloanele principale și pe datele de căutare poate fi făcut în câteva zile. Un audit complet al unui site mare cu multe șabloane durează mai mult, iar cea mai mare parte a timpului merge pe diagnostic și prioritizare, nu pe crawl în sine.
Ce instrumente am nevoie pentru un audit SEO?
Cel puțin Google Search Console și un crawler precum Screaming Frog SEO Spider, plus PageSpeed Insights pentru viteză. Analytics și jurnalele serverului adaugă context util. Suitele SEO plătite ajută cu date despre backlinkuri și concurenți, dar nu sunt obligatorii pentru un prim audit.
Care este diferența dintre un audit SEO și o listă de verificare SEO?
O listă de verificare enumeră controalele de făcut. Un audit rulează aceste controale pe site-ul tău, decide ce constatări contează și ordonează corecturile după traficul pe care îl pun în pericol. Folosește lista pentru a construi auditul și auditul pentru a alege munca.
y!
Primește gratuit planul tău de conținut pe 30 de zile
Analizăm concurenții, site-ul tău și vizibilitatea ta în AI pentru a crea gratuit un plan de conținut personalizat.
“Am testat Sorank pe un site real de client și este incredibil. Face tot ce o agenție ți-ar factura 1500$ pe lună. Acum este deja în producție la acel client.”Guillaume Guersanguersanguillaume.com
“Suntem o agenție de publicitate și am vrut să punem în sfârșit SEO-ul pe picioare. Sorank ne-a oferit o viziune clară asupra site-ului nostru, ne-a ajutat să prioritizăm optimizările și să ne structurăm conținutul corect. Instrumentul este ușor de utilizat, bine gândit pentru o echipă și foarte practic pentru a centraliza urmărirea fără să jonglăm între mai multe platforme. O bază foarte solidă pentru a începe din nou cu SEO-ul nostru.”Gaspard MadouiAgenție de publicitate
Dominiqueflight-sensations-idf.comAgrement și aviație
“Am lăsat pur și simplu software-ul Sorank să își facă treaba, iar acum DR-ul meu este 25 și pagina mea se clasează mai sus.”Lucas Flandrefoundertrace.fr
“M-am specializat în GEO datorită Sorank. Clasamentul GEO îmi permite să îmi arăt clienții poziția față de concurenți în ChatGPT. Este un avantaj comercial real.”MélanieFreelancer SEO
“Serviciu excelent, funcționează bine pentru site-ul nostru și ne ajută să înțelegem cum să îl îmbunătățim pentru a ne clasa mai bine pe Google și în alte părți. Felicitări, continuați așa, vă recomand.”Hugo T.Comerciant e-commerce


 Search Console