設定
当社はプライバシーを重視しており、ウェブサイトの基本機能に必要のない特定のストレージを無効にするオプションを提供しています。カテゴリーをブロックすると、ウェブサイトでの体験に影響が出る可能性があります。詳細はこちら
当社はプライバシーを重視しており、ウェブサイトの基本機能に必要のない特定のストレージを無効にするオプションを提供しています。カテゴリーをブロックすると、ウェブサイトでの体験に影響が出る可能性があります。詳細はこちら

クロール、インデックス、Search Consoleのデータ、Core Web Vitals、AIでの可視性を順番に確認する完全なSEO監査。トラフィックを押し上げるチェック項目と修正方法を解説します。
ツール

要点
SEO監査とは、ページがクロールされ、インデックスされ、理解され、クリックされ、引用されるのを妨げるすべてのものを体系的にチェックすることです。クロール、インデックス、検索データ、速度、ページ内容、リンク、AIでの可視性という固定の順序で実行してください。各問題は、それが阻害しているトラフィックで評価し、上位10件を担当者と期日のあるタスクに変えます。焦点を絞った監査は数日で完了できます。大規模サイトの完全な監査にはさらに時間がかかり、その成果はリストではなく計画であるべきです。
さらに詳しく知るには、こちらに質問
クイック診断
SEOはあなたに向いている?どう始めるべき?
Sorankはあなたの回答にぴったりです


ご自身のサイトで3日間お試しいただき、Google、ChatGPT、その他のAIでの現状をご確認ください。
3日間の無料トライアルを開始3日間無料、いつでも解約できます。90日間成果保証(条件あり)。
SEO監査は一つの問いに答えます。どの技術面、コンテンツ面、権威性の問題が今まさにあなたの訪問を失わせているのか、そしてどの順番で直すべきか。存在するすべてのベストプラクティスを並べたものではありません。40項目のチェックリストは何を見るべきかを教えてくれますが、監査はあなたのサイトの何が間違っているのか、それがどれほど重要か、そして最初に何をすべきかを教えてくれます。
混同されがちなものが三つあります。監査(診断)、チェックリスト(確認項目の一覧)、そしてレポート(クライアントや上司に渡すもの)です。当社のSEO監査レポートテンプレートはレポートを扱い、テクニカルSEOチェックリストは確認項目を扱います。この記事は、それらをつなぐ方法と、何が重要かを判断するために必要なデータについて説明します。
同じ監査を依頼する二つの方法
違いは労力ではなく、問いにあります。範囲を絞った依頼はページ、期間、判断を明示するため、行うすべてのチェックに存在する理由が生まれます。
多くの監査は、最初のクロールの前に失敗します。範囲について合意しておらず、出発点を保存していないからです。ツールを開く前に三つのことを決めておきましょう。
クロールを始める前に
順序は重要です。クロールはサイトに何が存在するかを教えます。インデックスはGoogleが何を保持しているかを教えます。検索データは、人々が何を見つけてクリックしたかを教えます。その後、速度、コンテンツ、リンクが、あるページのパフォーマンスが低い理由を説明します。逆の順序で進めると、Googleがそもそもインデックスできないページを書き直すのに何時間も費やすことになります。
SEO監査の七つの段階
監査前のSEOチェックは、これから監査するサイトが、Googleとサイトの訪問者が実際に見ているサイトと同じであることを確認し、データが行動の根拠にできるほど信頼できるかを確かめるものです。どのクロールより前に、約一時間をこれに充ててください。誤ったプロパティ、残ったままのステージング用ルール、壊れた計測があると、後の発見事項がすべて誤りになりかねません。しかもクロールでは、それらは分かりません。
ドメインの各バリエーションをリクエストしてください。httpとhttps、wwwあり・なし、末尾のスラッシュあり・なし、を確認します。どのバリエーションも同じ最終アドレスに到達すべきで、理想的には一回のリダイレクトだけで済むのが望ましいです。二つのバージョンが同時に公開されていると、リンクとシグナルが分散し、クローラーは両方とも正常だと報告してしまいます。
curl -I http://example.com/
curl -I https://www.example.com/
各レスポンスのLocationヘッダーを読んでください。直接、優先アドレスを指しているべきで、二つ目のリダイレクトを経由してはいけません。ホームページと深い階層のページ一つで同じ確認を繰り返してください。リダイレクトのルールはテンプレートごとに異なることが多いためです。
ステージング環境の設定は、急な順位下落の最も一般的な原因の一つです。公開中のrobots.txt、meta robotsタグ、そしてホームページと記事一つのX-Robots-Tagヘッダーを確認してください。サイト全体を対象にしたDisallowルールや、テストビルドから残ったnoindexがあると、ページ自体は訪問者に表示されていても、検索からセクションが隠れてしまうことがあります。そうした設定を見つけたら、そのセクションを監査する前に修正してください。修正しないと、後のすべての発見事項がGoogleから見えないサイトについてのものになってしまいます。
過去六か月のすべてのリリース、リデザイン、CMSの更新、移行、robotsやnoindexの編集について、日付つきの一覧を作ってください。そのうえで、その日付とトラフィック変化の開始時点を比べます。テンプレートのリリース当日に始まった下落は、そのテンプレートを示しています。近くに変更がない下落は、検索アルゴリズムの更新が原因かもしれず、別の確認が必要です。履歴がなければ、最後に見たものを犯人にしてしまいます。URLに関わる変更については、SEO移行チェックリストに記録すべき項目が書かれています。
同じ90日間について、Search Consoleのクリック数と分析ツールのオーガニックセッション数を比べてください。二つの線が一致する必要はありませんが、同じ方向に動くべきです。ずれている場合は、サイトを診断する前に、主要ページのタグ、同意バナー、ボットのフィルタリングを確認してください。二つのツールの比較で、それぞれが何を数えるのかを説明しています。
クローラーは、Googlebotが行うことを小規模に行います。ページから始めて、見つけたリンクをたどり、URLごとに見たものを記録します。ほとんどの監査で使うツールはScreaming Frog SEO Spiderです。無料版は最大500 URLまでクロールでき、小規模サイトや大規模サイトの一部には十分です。有料ライセンスではこの上限がなくなります。当社のScreaming Frogガイドで設定手順を確認できます。
クロールは、ホームページとサイトマップの両方から開始し、二つのリストを比較してください。どちらか一方にだけ現れるURLはすべて疑問点です。クローラーがGooglebotと同じようにrobots.txtを尊重するよう設定し、サイトがJavaScriptに依存しているならJavaScriptをレンダリングさせてください。ページをレンダリングしないクロールでは、ユーザーに見えているコンテンツを見落とします。
まず4xxと5xxの応答を絞り込みます。404そのものは問題ではありません。内部リンクがまだそれを指している場合に問題になります。そのリンクがユーザーとクローラーを行き止まりに導くからです。エラーページに向かう内部リンクを見つけ、有効なURLに向けてください。次にリダイレクトチェーンを確認します。古いURLが二つ目のURLにリダイレクトし、それがさらに三つ目へリダイレクトしている状態です。ホップが増えるたびに遅延が加わり、シグナルが薄まります。すべてのチェーンを平坦化し、古いURLが最終URLを直接指すようにしてください。
リダイレクトの種類も確認します。恒久的な移転に使われた一時的な302は、301であるべきです。当社の301と302のガイドに判断基準があります。
誰にも気づかれずにページを隠してしまう設定が三つあります。robots.txtのdisallowルールはクロールを止めます。noindexのmetaタグやX-Robots-TagのHTTPヘッダーはインデックスを止めます。別のURLを指すcanonicalタグは、どのバージョンを残すべきかを検索エンジンに伝えます。それぞれのページタイプについて確認してください。あるセクションを直すために加えたルールが、別のセクションを塞いでしまうことがよくあるからです。よくあるケース:ステージング環境のルールが、本番のrobots.txtから削除されないまま残っている。
警告
robots.txtでページをブロックすることは、検索からそのページを削除することとは違います。Googleがそのページをクロールできなければ、ページ上のnoindexを読むこともできません。ページをインデックスから外すには、クロールを許可してnoindexを追加し、Googleが再クロールするまで待ってください。
孤立ページとは、それを指す内部リンクがないページです。クローラーはサイトマップか外部リンクを通じてしか見つけられず、ユーザーはほとんど見つけることができません。孤立ページを見つけるには、三つのリストを比べます。リンク経由でクローラーが到達したURL、サイトマップにあるURL、アナリティクスで訪問を得ているURLです。サイトマップに載っているか訪問を得ているのに、内部リンクがないページは、孤立の候補です。
クリック深度、つまりホームページからのクリック数も測定してください。重要なページが5回や6回のクリックの奥に埋もれていると、クロールの注目をほとんど集めず、内部リンクも少なくなります。関連するハブページからリンクし、そのハブページ自体も浅い位置にあることを確認してください。
タイトルが欠けているページ、タイトルの重複、メタディスクリプションの重複、検索結果で全体が表示されないほど長いタイトルを絞り込みます。重複はほぼ常に執筆者ではなくテンプレートから生まれます。バリエーションごとに同じタイトルを出力する商品テンプレートは何百もの重複を生み、テンプレートを直せばそれらすべてを一度に解決できます。タイトルタグは、Googleへの強い提案であって保証ではないと考えてください。Googleが書き換えることもあり、だからこそ正確で具体的に保つ理由がもう一つあります。
サーバーログはクロールのループを閉じます。GooglebotがリクエストしたURL、その頻度、受け取ったステータスコードが分かります。ログにアクセスできるなら、リクエストをサイトマップと比較してください。Googlebotが絶えず訪れているのに価値をもたらさないページは、クロールの無駄の兆候です。これについては、当社のクロールバジェットの項目で説明しています。
Search Consoleの「ページのインデックス登録」レポートには、Googleが把握しているURLと、それぞれに与えたステータスが並びます。開いたら、件数ではなく理由で並べ替えてください。理由ごとに異なる修正が対応します。以下のラベルは、インデックスステータスに関するSearch ConsoleのヘルプにあるGoogleの定義を基準としています。
| レポートのステータス | 意味 | すべきこと |
|---|---|---|
| Discovered, currently not indexed | GoogleはこのURLを見つけたがまだクロールしておらず、サイトに負荷がかかると予想してクロールを後回しにした | サーバーの応答時間とURLの深さを確認する。内部リンクがそこを指していることを確認する |
| Crawled, currently not indexed | Googleはページをクロールしたが、インデックスしないことを選んだ。Googleはウェブ上のすべてのページをインデックスするわけではない | まず品質を確認する:薄いコンテンツ、ほぼ重複したコンテンツ、弱い内部リンク。重要なページにはURL検査を使う |
| Blocked by robots.txt | GooglebotがそのURLをクロールすることは許可されていない | そのブロックが意図的かを確認する。ページが掲載されるべきならブロックを外す |
| Excluded by noindex tag | ページにnoindexの指定がある | ページが掲載されるべきなら指定を外す。内部検索の結果など、外に出しておくべきページには残す |
実用的なルール:あるページタイプ全体で「Crawled, currently not indexed」の割合が高い場合は、記事を見る前にテンプレートを見てください。薄いテンプレートは薄いページを生み、一つの記事を直しても傾向は変わりません。Crawled, currently not indexedステータスのガイドで原因を詳しく扱っています。
重要なページについては、URL検査を一度に一つのURLに対して使ってください。最後にクロールされた日付、インデックスされているか、Googleが選んだcanonicalが分かります。Googleが選んだcanonicalが、あなたが宣言したものと違う場合、原因はほぼ常に重複か矛盾するシグナルです。例えば、リダイレクトされたURLを指すcanonical、またはパラメータ付きのバージョンを優遇する内部リンクなどです。
Search Consoleのパフォーマンスレポートは、監査にとって最も有用な無料のデータセットです。既定では直近三か月が表示されますが、傾向を見るには短すぎます。クエリとページのデータを少なくとも90日分エクスポートし、日付つきで保存して、次の監査と比較できるようにしてください。表をページごとおよびクエリごとにグループ化し、サイトが複数の市場にサービスを提供している場合は国とデバイスのフィルターを使います。
このデータの機会の大半は、四つの分析で見つかります。
特定のページタイプだけを切り出すには、正規表現のページフィルターを追加します。例えば、ハウツー系のクエリを狙っているブログページだけを見るには、次の二つの値を入力します。
Page filter (regex):   /blog-geo-seo/.*
Query filter (regex): how to|guide|checklistクリック率は検索結果ページの上部に大きく左右されます。公開されているいくつかの数字は、ギャップが本物かどうかを判断する助けになります。Googleのクリック率に関する調査では、最初の自然検索結果が27.6%のクリックを得て、上位三件を合わせると54.4%、2ページ目の結果は0.63%でした。
なぜ1位がこれほど重要なのか
出典:Backlinko、Googleのクリック率調査(backlinko.com/google-ctr-stats)
これらの平均値は目標ではなく、妥当性の確認に使ってください。あらゆる種類のクエリが混ざっており、あなたの数値は検索意図、ブランド名のクエリ、そしてあなたの掲載結果の上に表示される動画、画像、AI回答といった機能に左右されます。各ページは、あなたのサイトで似たクエリに順位づけされているページと比較してください。
以下の閾値は、データを振り分けるための出発点として私たちが使っているものです。Googleの規則ではないので、サイトの規模とクエリの量に合わせて調整してください。
| チェック項目 | 出発点の閾値(当社の経験則) | 重要な理由 |
|---|---|---|
| ストライキング・ディスタンス | 平均掲載順位8位から20位、90日で少なくとも50回の表示回数 | 需要があり、ページが動かせるほど近い位置にある |
| 減衰 | 同じ長さの二つの期間の間でクリックが30%以上減少 | 見直しを正当化するほどのトラフィックを失っている |
| 薄いコンテンツ | ナビゲーションや定型文を除く本文が300語未満 | クエリに答えるには不十分なことが多い。短いツールページは正しい場合もあるので、検索意図を確認する |
| 内部リンク | インデックス可能なページからの内部リンクの受信が3件未満 | 重要度の弱いシグナルであり、孤立ページのよくある兆候 |
Search Consoleのデータは、二つ目のチェックももたらします。あなたが順位を持っているのに、意図して狙ってこなかったクエリです。表示回数によって関連性がすでに証明されているため、これらは既存ページに加えるのが最も容易なことが多いのです。
GoogleのCore Web Vitalsのドキュメントは、三つのユーザー体験指標とそのしきい値を定義しています。ページが「良好」の範囲にあるのは、最大視覚コンテンツの描画(LCP)が2.5秒以下、次の描画までのインタラクション時間(INP)が200ミリ秒以下、累積レイアウトシフト(CLS)が0.1以下のときです。INPは2024年に安定版のCore Web Vitalsになり、First Input Delayに取って代わりました。
| 指標 | 良好となる条件 | 測定内容 | 一般的な修正 |
|---|---|---|---|
| LCP | 2.5秒以下 | 最も大きな可視要素が読み込まれる速さ | ヒーロー画像を最適化し、サーバー応答時間を短縮し、ページに必要なフォントを優先的にプリロードする |
| INP | 200ミリ秒以下 | 訪問中にクリック、タップ、キー入力へページが応答する速さ | 長いJavaScriptタスクを分割し、重いサードパーティのスクリプトを取り除き、読み込み時にメインスレッドをブロックしないようにする |
| CLS | 0.1以下 | ページの読み込み中にコンテンツがどれだけ動くか | 画像と埋め込みに幅と高さを設定し、バナーや広告の領域を確保し、ファーストビューより上で遅れて読み込まれる要素を避ける |
ラボデータより先にフィールドデータを読んでください。フィールドデータは実際のChromeユーザーから得られ、訪問者が本当に困っているかどうかを教えてくれます。ラボデータはシミュレーションされたテストから得られ、ページがなぜ遅いのかを教えてくれます。PageSpeed Insightsは両方を示します。そのURLにGoogleが十分なトラフィックデータを持っている場合はフィールドデータを、テストしたすべてのURLについてはラボデータを表示します。
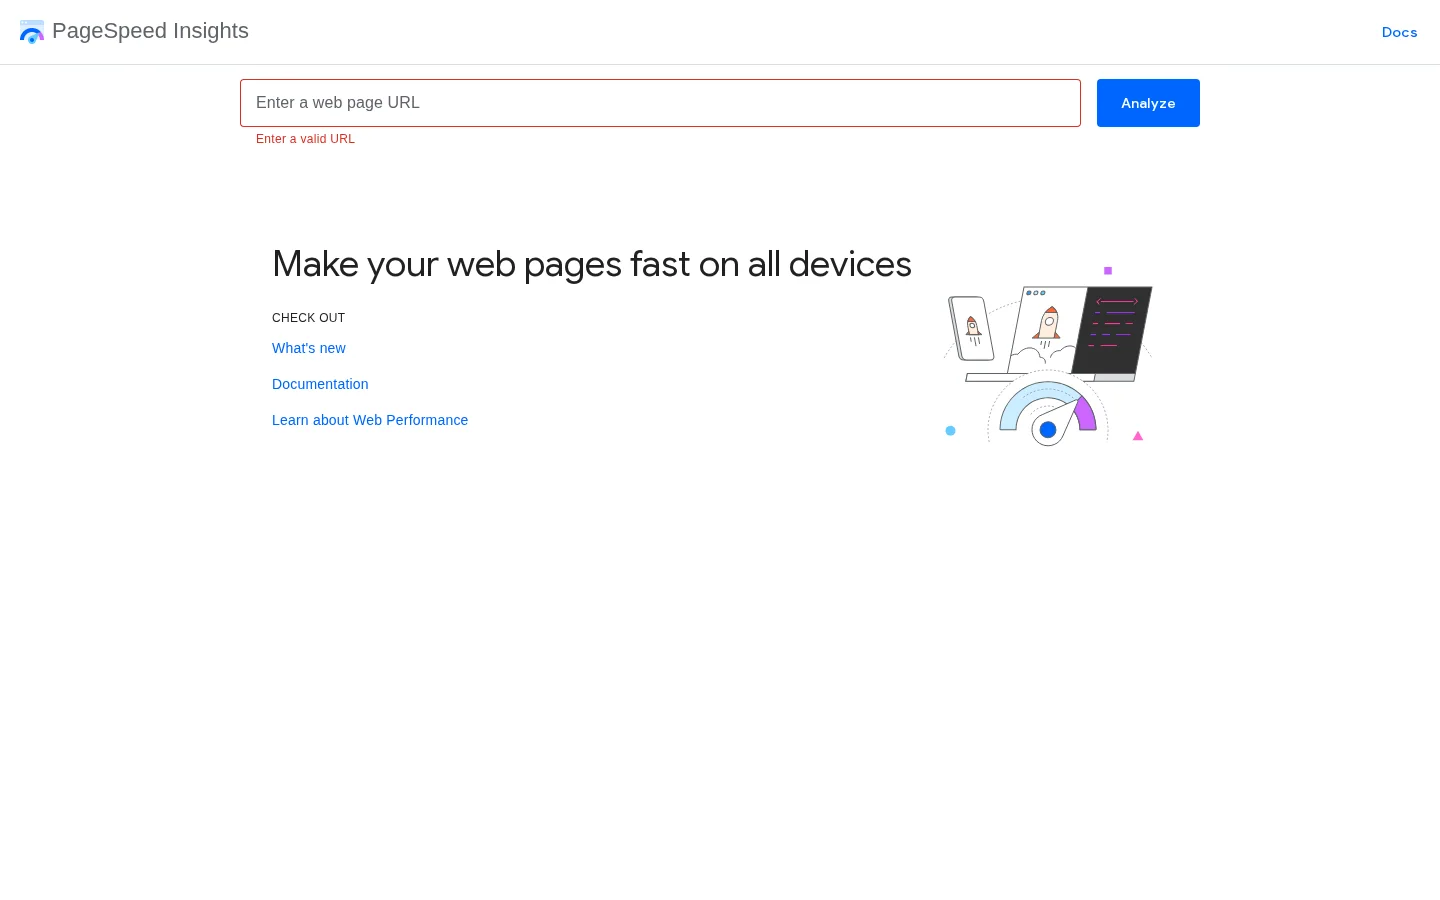
ホームページだけでなく、テンプレートごとに三から五つのURLをテストしてください。商品テンプレート、カテゴリテンプレート、ブログテンプレートは、読み込むスクリプトが異なるため、同じサイトでもスコアが大きく異なることがあります。タグマネージャーやチャットウィジェットが多いサイトでは、ラボのスコアは高いのにフィールドのINPが悪いというのがよくある結果です。その場合、ラボテストが間違っているわけではありませんが、ページ読み込み後にユーザーが行うやり取りを表しているわけでもありません。
モバイルでは三つのことを確認してください。Googleは主にページのモバイル版でインデックスを行うため、モバイル版の主要コンテンツはデスクトップ版と一致している必要があります。構造化データと内部リンクは両方のバージョンで同じであるべきです。そして、到着時に煩わしいインタースティシャルがコンテンツを覆っていないことです。速度はランキングにとって重要ですが、それを修正するより有益な理由は、遅いテンプレートは訪問者が何かを読む前に離脱させてしまうことです。
重要な各ページについて、タイトル、見出し、回答の深さ、流入と流出のリンク、そして極めて似た重複ページがあるかを確認します。これを各テンプレートからのサンプルページに対して行い、その後、検索データで臨界距離または減衰として現れたページに対して行います。
| チェック項目 | 合格となる条件 | 不合格となる条件 |
|---|---|---|
| タイトルタグ | テーマとページの主要クエリを示し、サイト全体で一意である | 別のページと重複している、またはサイト名だけといったテンプレートの既定値である |
| H1 | ページごとに一つあり、テーマを平易な言葉で示している | 欠けている、繰り返されている、またはロゴやバナーに置き換わっている |
| ファーストビュー | クエリが問うている質問への答えが上部近くにある | ファーストビューが背景説明とブランドのコピーだけで、答えが何度もスクロールした後に現れる |
| 深さ | テーマについて人々が尋ねる下位の質問を、具体的な詳細とともに扱っている | 薄い、または同じ段落の繰り返しで水増しされている |
| 内部リンク | 関連ページからリンクされ、次の論理的なステップへとつながっている | 孤立している、またはフッターかサイトマップからしかリンクされていない |
| 構造化データ | 訪問者がページで見られるコンテンツと一致している | ページにないコンテンツをマークアップしている、または誤った種類を使っている |
内部リンクは、監査全体の中で最も安上がりなレバーです。既に順位を持っているページからのリンクで、本文中に置かれ、対象クエリの語をアンカーに使っているものは、文脈と権威の両方を伝えます。「こちらをクリック」や「続きを読む」といった汎用的なアンカーはほとんど意味を伝えません。最も多くのトラフィックをもたらすページから作業を始めてください。そこからの新しいリンクはそれぞれ、本当の読者を持つページに届くからです。
重複や近似重複のコンテンツには、専用の確認が必要です。カテゴリフィルター、並べ替えパラメータ、トラッキングパラメータは、同じリストを表示する多くのURLを生み出すことがよくあります。どのバージョンが存在すべきかを決め、それに合ったcanonicalタグ、robotsのルール、またはパラメータの扱いを使ってください。その判断をGoogleに任せてはいけません。結果を気に入らないことになるからです。
ヒント
単一ページの最初の簡単なチェックには、無料のオンページSEO監査ツールが、タイトル、見出し、リンク、metaタグに関する一般的なチェックを実行してくれるので、判断が必要な発見に時間を使えます。
リンクプロファイルのチェックは三つの問いに答えます。参照ドメインを安定したペースで獲得しているか。重要なリンクを失っていないか。そして、人為的に見えるパターンがないか。バックリンクツールから時間の経過に伴う参照ドメインをエクスポートし、突然の急増(有料キャンペーンやスパムから来ることが多い)と、減少(期限切れのページやサイト移行から来ることが多い)を探してください。当社のバックリンク監査ガイドが、完全な確認方法を示しています。
disavowツールは慎重に扱ってください。Google自身のガイダンスによれば、ほとんどのサイトには必要ありません。獲得していないリンクの明確なパターンがあり、それに関連する手動対策や深刻な問題があるときにだけ使ってください。バックリンクツールがいくつかのドメインに低いスコアを付けたからという理由で使うべきではありません。良いリンクを誤って否認すると、いくつかの悪いリンクをそのまま残すことより高くつきます。
現在、すべての監査に含めるべき確認は二つあります。一つ目はアクセス性です。AIクローラーはあなたのページに到達できますか?関心のある各クローラーについて、robots.txtのルールを確認してください。OpenAIはGPTBotとOAI-SearchBotを使い、AnthropicはClaudeBotを使い、PerplexityはPerplexityBotを使いますが、それぞれの目的は同じではありません。すべてに一つのルールを適用するのは、正しい判断であることがほとんどありません。当社のAIクローラーのガイドが、それらとその役割を一覧にしています。
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /
上の例は、あり得る判断の一つであって、すべてのサイトへの推奨ではありません。検索回答のためにページを読むことは一つのクローラーに許可し、学習に使われる別のクローラーはブロックしています。クローラーごとに判断し、その判断を書き留めて、デプロイのたびにファイルを確認してください。ステージング版を公開した後には、すべてをブロックするrobots.txtがよく現れるからです。
二つ目の確認は可視性です。購入者があなたが狙っている質問をしたとき、回答エンジンはあなたの名前を挙げますか?検索データや営業の会話からの実際の質問をもとに、十から二十個のプロンプトのリストを作ってください。ChatGPT、Perplexity、Geminiでそれらを実行し、どのブランドとどのURLが引用されたかを記録します。また、回答は実行ごとに変わるため、数日にわたって各プロンプトを何度か繰り返してください。AI可視性監査の方法が、結果の採点方法を説明しています。
監査は、範囲と開始地点によって異なります。実務でよく使われる方法は五つあります。それぞれ異なる状況に適しており、多くのチームは二つを組み合わせます。
原則:サイト全体、すべてのページタイプ、すべてのデータソースを対象にし、その後で発見事項を順位づけします。使いどころ:移行の準備をしているとき、急激なトラフィック低下の後、または大規模サイトの最初の監査のとき。利点:URLを倍増させるファセットナビゲーションのような、ページ単位のレビューでは見えない構造的な問題を見つけられます。限界:時間がかかり、順序づけのために二度目の確認が必要な発見が多く生まれます。例:40000の商品URLを持つ小売業者が、一つのフィルターパラメータがほとんどの重複を生んでいることを発見します。個々の商品のレビューでは決して分からなかったことです。
原則:検索データで何が変わったかから始め、関係するページとクエリだけを診断します。使いどころ:月次のレビューを行うとき、コアアップデートが公開された直後、またはチームが小規模なとき。利点:作業は最初の一分から、トラフィックによって優先順位づけされます。限界:新しいセクションや、最初からブロックされたページなど、まだデータがないページは見えません。例:五つのページでクリックが減ったブログが、その五つを確認し、二つが互いに競合していることを見つけて統合します。
原則:一つのURLに対してすべてのチェックを実行し、書き直しが必要かどうかを判断します。使いどころ:一つのマネーページのパフォーマンスが低いとき、または計画された書き直しの前。利点:速く、具体的で、前後の比較が明確です。限界:パターンを示せないため、テンプレート全体のバグが一度きりの問題に見えることがあります。例:タイトルもコンテンツも良好な商品ページが、在庫切れのバリエーションを指すcanonicalを持っていることが判明します。
原則:あなたのページとトピックを、同じクエリであなたより上に表示されているものと比較します。使いどころ:新しいコンテンツや新しいリンクを計画するとき。利点:市場が実際に何に報いているかを示します。深さ、形式、扱われている下位の質問などです。限界:リーダーを真似ると、混雑した、あるいは検索意図の合わないトピックに入り込むおそれがあります。決める前に、上位の結果が実際に何を共有しているかを確認してください。例:あるクエリの上位五件がすべて、ファーストビューで価格に関する質問に答えているのに、あなたのページはそうしていません。
原則:AIクローラーがあなたのページを読めるか、そして回答エンジンが重要な質問であなたを引用するかを確認します。使いどころ:AIツールがあなたのブランドを推奨しているかを知る必要があるとき。利点:従来の順位トラッカーには表示されないチャネルをカバーします。限界:回答は実行ごとに変わるため、結論を出す前にサンプルを繰り返す必要があります。例:あるソフトウェア企業が、すでに販売を停止している機能について引用されていて、比較ページが古くなっていることが分かります。
| 方法 | 出発点 | 最適な用途 | 主な限界 |
|---|---|---|---|
| 完全な技術監査 | クロールとすべてのデータソース | 移行、大規模サイト、急激な低下 | 遅く、計画なしでは順序づけが難しい |
| データ優先の監査 | 検索データの変化 | 月次レビュー、小規模チーム | まだデータがないページを見逃す |
| ページレベルの監査 | 一つのURL | パフォーマンスの低い単一ページ | テンプレート全体のパターンは見えない |
| 競合ギャップ監査 | あなたより上の結果 | 新しいコンテンツと新しいリンク | 間違った検索意図を模倣するリスク |
| AI可視性監査 | クローラーのアクセスと回答エンジン | AIがあなたを推奨しているかの把握 | 回答は変動するため、サンプルを繰り返す必要がある |
クイック監査と完全監査
私たちの助言は、まずクイック監査から始め、クイック監査が構造的な原因を指し示すとき、またはサイトのアーキテクチャを変えようとしているときにのみ、完全監査に進むことです。
順序のない400件の発見事項を持つ監査は、順序づけされた10件の監査より価値が低いものです。各発見事項を二つの点で採点してください。どれだけのトラフィックや収益を危険にさらしているか、そして修正がどれだけ難しいか。影響が大きく、手間の少ないものから始めます。その後、より多くの作業を要するものの、テンプレート全体を解放する高影響の項目に進みます。そこでの一つの修正が、何千ページも変えるからです。
| 発見事項 | 危険にさらされるトラフィック | 工数 | 優先度 |
|---|---|---|---|
| テンプレートがすべてのページから404ページにリンクしている | 高 | 低 | 最初に実施 |
| マネーページにタイトルの重複がある | 高 | 低 | 最初に実施 |
| カテゴリテンプレートでLCPが遅い | 高 | 中 | 次のスプリントに計画 |
| 減衰を示しているブログ記事 | 中 | 中 | 失ったクリック数の多い順に更新 |
| 孤立した用語集ページ | 低 | 低 | 内部リンクの作業とまとめる |
| 内容の薄いタグアーカイブページ | 低 | 中 | 検索意図を確認してから、noindexまたは統合 |
各項目に担当者、期日、そして動くと期待する指標を割り当ててください。担当者のない発見事項はメモにすぎず、メモでは順位は変わりません。影響を受けたページをGoogleが再クロールした後に再測定してください。これには数週間かかることがあり、開始時に保存したベースラインと比較します。結果を提示するときは、SEO監査レポートテンプレートが、マネージャーやクライアントが十分程度で読める構成を提供します。
修正を追跡しながらGoogleとAIのトラフィックを一か所で見たい場合は、SorankのGEO / SEOダッシュボードが両者を並べて表示します。
90分のSEO監査は、検索流入を最も多くもたらすページを、本当の損失が最初に見つかる順序で確認します。セッションが一回しかなく、すべてのURLを見直すのではなく優先順位つきの修正リストが必要なときに使ってください。作業は主要ページと、テンプレートごとに一つの代表URLに絞ります。そうすれば、その日のうちに成果を使えます。
セッションを決まったブロックに分け、時間が来たらそのブロックを終えます。時間制限は手法の一部です。選択を迫られるからです。
| 時間(分) | 作業 | 成果物 |
|---|---|---|
| 0〜10 | Search Consoleから90日分のクエリとページのデータを書き出し、クリック数の多い上位20ページを一覧にする | 保存した基準値と対象ページの候補リスト |
| 10〜25 | 候補リストに段階3のStriking distanceと下落の確認を適用する | クリックが減ったページ、または掲載順位が8位から20位の間にあるページ |
| 25〜40 | テンプレートごとに代表URLを一つクロールし、ステータスコード、canonical、robotsの指示を確認する | テンプレートごとのエラー、誤ったcanonicalやブロック |
| 40〜55 | ページのインデックス登録レポートを開き、理由を件数順に並べる | 最も多くのページに影響している状態 |
| 55〜70 | テンプレートごとに一つのURLでPageSpeed Insightsを実行し、フィールドデータを先に読む | フィールドのLCPまたはINPが最も弱いテンプレート |
| 70〜90 | 上位10件の発見事項について、リスクのあるトラフィック、工数、担当者を書く | 同じ日に共有できる優先順位つきの計画 |
各行は一つの問いに答えるため、行を飛ばしても他の行の結果は失われません。インデックス登録レポートに特に異常がなければ、その時間は検索データに充ててください。修正への近道になることが多いからです。
時間制限があると、三つのことが見えなくなります。構造的な問題、たとえばURLを倍増させるフィルターは、サンプルしか読まないため見落とされます。サーバーログを使わないため、クローラーがあるページをどれくらいの頻度で取得しているかは分かりません。そして、リンクプロファイルは検証できません。バックリンクツールからの完全なエクスポートが必要だからです。これらは未解決の課題として書き留め、後日のバックリンク監査や完全なレビューに回してください。そうすれば、短い監査が実際以上に完全に見えてしまうことを防げます。
最もよくある失敗は、クローラーから始めることです。大規模サイトのクロールは、セッション全体より長くかかることがあり、誰も読み切れないほどの警告を返します。代わりに検索データから始め、クリックや表示回数のあるページに限ってクローラーを開いてください。そうしたページの警告を先に修正しましょう。誰も訪れていないページの警告は、トラフィックを変えないからです。
ヒント
タイマーと出力ファイルを一つ用意して、セッションをカレンダーに登録してください。SEO監査レポートテンプレートの列を最初から使えば、90分経過時点でリストを共有できる状態になります。
ほとんどの監査には同じ間違いが含まれています。その兆候を知っていれば、簡単に避けられます。
それは何か:監査がすべてを対象にするため、何も完了しない。見分け方:レポートに数百の問題があり、どれにもトラフィックの数値や担当者がない。直し方:最初のセクションの、範囲を絞った依頼からやり直し、クロールを重要なページタイプに限定し、何かを書く前にトラフィックで発見事項を並べ替える。
それは何か:誰も訪れないページに影響していても、チームはツールが赤で示す警告を直してしまう。見分け方:警告の数は減っているのに、マネーページのクリックは減り続けている。直し方:クロールを検索データと結びつけ、トラフィック、表示回数、またはリンクのあるページの問題から先に直す。
それは何か:クローラーがエラーを報告しないため、チームはサイトが健全だと結論づける。見分け方:Search Consoleが、クローラーが一度も指摘しなかった「Crawled, currently not indexed」や「Discovered」のURLを多数報告している。直し方:クロールをサイトマップ、インデックスレポート、サーバーログと比較する。クローラーはリンクとレンダリングを通じて到達できるものしか見ないため、ログイン、スクリプト、ファセットフィルターの背後にあるコンテンツは、そのリストから欠けている可能性があります。
それは何か:チームが、同じタイトル、同じ画像、同じcanonicalを何百ページにもわたって、一つずつ編集する。見分け方:同じ発見事項が、一つのページタイプのURLの大半に現れる。直し方:テンプレートを一度直し、変更がどこでもうまくいったかを確認するためにサンプルのページをチェックする。一つのテンプレートの変更で、そのグループ全体が直ります。
それは何か:Googleから外したいページに、チームがrobots.txtのdisallowを追加する。見分け方:ページは要約なしの裸のURLとしてインデックスに残り、レポートではブロックされたものとして表示される。直し方:クロールを許可し、noindexの指定を追加して、Googleがそのページを再クロールするのを待つ。いったん外れたら、必要ならブロックしてもかまいませんが、その必要はありません。
例(説明用)
あるサイトが、古いキャンペーンのランディングページの一群を廃止し、robots.txtでそれらをブロックしたとします。他のサイトがまだそれらにリンクしているため、ページは要約も説明もなく、裸のURLとして検索に表示され続けます。ブロックを解除してnoindexを追加すれば、Googleはページをクロールして指定を読み、インデックスから外すことができます。
それは何か:チームがラボテストで100点を目指して最適化し、フィールドデータを無視する。見分け方:ラボのスコアは高いのに、同じテンプレートのフィールドINPが、Search ConsoleのCore Web Vitalsレポートで悪い。直し方:実際のユーザーが行う操作、多くはページの読み込み後の操作を分析する。最初の描画の読み込み時間ではなく、スクリプトによって引き起こされる長いタスクを探してください。
毎月、検索データと最も重要なテンプレートに対して、クイック監査を実行してください。移行、リデザイン、CMSの変更、または突然のトラフィック低下の後には、完全監査を実行し、構造のずれを捉えるために年に一度は完全なレビューを行ってください。検索データは継続的に監視すべきです。クリック数の減少は、カレンダーのリマインダーとしてよりも、アラートとしての方が有用だからです。
サイト監査は、1つのドメインで到達可能なすべてのURLをクロールし、問題の種類と重要度ごとにまとめたものです。ページごとのレビューでは見落とされるパターンも含め、サイト全体で何が壊れているかを示します。どの修正が順位を動かすかは教えてくれないため、検索データと組み合わせて使ってください。
フィルター、並べ替えオプション、トラッキングタグによって、ページ数よりはるかに多くのURLが生成されることがあり、その大半は同じリストを表示します。これらのパラメータとメディアファイルを除外し、各サブドメインを個別のプロジェクトとしてクロールしてください。リクエスト頻度は低く保ち、実際の訪問者にとってサーバーが速いままであるようにします。ページネーション(page=)は範囲に含めておきましょう。ページ分割されたリストには、インデックスさせたいページが含まれている場合があるためです。
.*\?(sort|filter|utm_[a-z]+)=.*
.*\.(jpg|jpeg|png|webp|gif|svg|pdf|mp4)$
ほとんどのクロールツールは、このような正規表現として書かれた除外ルールを受け付けます。短いクロールで試し、除外したいパラメータに対してだけURL数が減ることを確認してください。
各ツールは問題をレベルにまとめ、独自の健全性スコアを算出します。ラベルはツールによって異なりますが、トリアージの考え方は同じです。スコアは、固定された設定の下での1つのツールにおける推移線にすぎず、Googleが適用する評価ではありません。次の順序でレベルを確認してください。
| レベル | よくある問題 | 最初の対応 |
|---|---|---|
| インデックス可能なページのエラー | 順位を狙うURLで4xxや5xxの応答が出る、内部リンクが切れている | すでにクリックを獲得しているページから優先して修正する |
| インデックスさせたくないページのエラー | 壊れた内部検索、フィルターURL、終了したキャンペーンのURL | まだそこを指している内部リンクを削除する |
| 警告 | タイトルが長すぎる、説明文がない、見出しが重複している | まとめて修正する。理想的には1つのテンプレート変更で対応する |
| 通知 | 軽微な最適化のヒント | 一度確認し、収益ページで繰り返し出る場合のみ対応する |
サイト監査で最も役立つ出力は、2回の実行間の差分です。前回の問題リストをエクスポートし、同じ設定で再度クロールして、問題の種類とURLごとに件数を比較します。新しい問題を優先してください。公開中のページで新たに発生したエラーは、通常は直近のリリースに続いて現れるからです。担当者を割り当てる前に、新しいまとまりごとに変更履歴と照らし合わせましょう。
例えば、1回目の実行ではエラーが42件、4週間後の2回目では57件と報告されたとします。そのうち15件は、その週に公開された料金テンプレート上にあります。テンプレートを一度修正します。件数が42付近まで戻れば修正は効果があったことになり、その実行が次回の基準になります。
丸一日かかるサイト監査は繰り返されません。範囲、除外ルール、重要度表を1つの設定としてまとめて保存すれば、次の実行は数分で済みます。クロールをスケジュールし、毎回同じ3つのファイルをエクスポートしてください。問題リスト、インデックス可能なURL、クリックを獲得しているURLです。自動SEOレポートのガイドでは、何を自動化すべきか、そしてその設定方法を説明しています。
クローラーを選定中であれば、テクニカルSEOツールの比較で、各ツールの役割に基づいて選択肢を比べています。サイト監査は、誰かが実行間の差分を読むのであれば、スケジュールする価値があります。読まれないなら、フォルダに増えるもう1つのエクスポートにすぎません。
これまで監査をしたことがないなら、次の四つを順番に行ってください。Search Consoleのデータを90日分エクスポートし、日付つきで保存します。主要なテンプレートをクローラーでクロールします。サイトが小さい場合は、無料の500 URL版から始めてください。インデックスレポートを読み、理由を分類します。そして、見つけた上位三つのテンプレートレベルの問題を修正し、次のクロールサイクルの後に再測定します。
良い監査は文書で終わるのではありません。今月誰かが実行している短い修正リストと、それらが効果を上げたかを証明するベースラインで終わります。
サイトの規模と、どこまで深く調べたいかによって異なります。主要なテンプレートと検索データに絞った監査なら、数日で終えられることもあります。多くのテンプレートを持つ大規模サイトの完全な監査には、より時間がかかります。その時間の大半はクロールそのものではなく、診断と優先順位づけに費やされます。
最低限、Google Search Consoleと、Screaming Frog SEO Spiderのようなクローラーが必要です。速度の確認にはPageSpeed Insightsも使います。アナリティクスとサーバーログがあると、より多くの文脈が得られます。有料のSEOスイートはバックリンクや競合のデータに役立ちますが、最初の監査には必須ではありません。
チェックリストは実行すべき確認項目を並べたものです。監査はそれらの確認をあなたのサイトで実行し、どの発見事項が重要かを判断して、修正を失われるトラフィックの大きさで順序づけします。チェックリストで監査を組み立て、監査で取り組むべき作業を選んでください。
競合、あなたのサイト、AIでの可視性を分析し、あなた専用のコンテンツプランを無料で作成します。
 AI コンテンツブリーフ生成ツール
 FAQ スキーマ生成ツール
 AI ブログ記事アイデア生成ツール
 構造化データ検証ツール(スキーマバリデーター)
 代替テキストチェッカー
 内部リンク分析ツール
 被リンクチャレンジ
 AI メタディスクリプション生成ツール
 AI ブログタイトル生成ツール
 Google インデックス可否チェッカー
 AI 記事構成案生成ツール
 UTM リンク作成ツール
 キーワードのグループ化ツール
 canonical タグチェッカー
 XML サイトマップ生成ツール
 リンク切れチェッカー
 AI SEO タイトル生成ツール
 見出しアナライザー
 検索結果プレビューツール
 リダイレクトチェッカー
 hreflang タグ生成ツール
 見出し構造チェッカー
 HTTP ヘッダーチェッカー
 Favicon 抽出ツール
 SEO トラフィック・売上予測計算ツール
 SEO 予算計算ツール
 順位上昇シミュレーター
 キーワード機会スコア計算ツール
 GEO コンテンツ投資計算ツール
 顧客生涯価値計算ツール
 CTR 計算ツール
 AI トラフィック価値計算ツール
 AI シェア・オブ・ボイス計算ツール
 Gemini ランキングツール
 ROAS 計算ツール
 自然検索トラフィック価値計算ツール
 ローカル SEO ROI 計算ツール
 被リンク獲得コスト計算ツール
 キーワード密度計算ツール
 顧客獲得コスト計算ツール
 記事単価計算ツール
 直帰率計算ツール
 AI 引用率計算ツール
 LLM 向け構造化データ監査
 llms.txt ジェネレーター
 Sitemap チェッカー
 SERP 変動センサー
 文字数カウンター
 Schema マークアップ生成ツール
 キーワード調査ツール
 SEO 損益分岐点計算ツール
 読了時間計算ツール
 自然検索トラフィック予測ツール・サイトのアクセス数チェック
 ChatGPT 参照トラフィック予測ツール
 AI 可視性スコア計算ツール
 AI 可読性チェッカー
 SearchGPT 対応チェッカー
 ChatGPT が自社サイトを推薦しない理由
 URL 抽出ツール
 ウェブページ Markdown 変換ツール
 robots.txt 生成ツール
 Open Graph プレビュー
 オンページ SEO 監査:SEO チェッカーと SEO 分析ツール
 LTV:CAC 比率計算ツール
 GEO ROI 計算ツール
 コンバージョン率計算ツール
 AI クローラー巡回監査
 AI 検索可視性テスト
 ページサイズチェッカー
 URL スラッグ生成ツール
 メタタグ生成ツール
 画像圧縮ツール
 ファビコン生成ツール
 ドメインオーソリティチェッカー
 検索結果 CTR 計算ツール
 EC SEO ROI 計算ツール
 コンテンツマーケティング ROI 計算ツール
 AI での不可視コスト計算ツール
 AI Overviews チェッカーと AI Overviews 順位チェック
 robots.txt チェッカー
 SEO・AI 監査
 Perplexity ランキングチェッカー
 アンサーエンジン最適化の監査
 ChatGPT 可視性チェッカー
 被リンク分析ツール
 SEO とリスティング広告の節約額計算ツール
 SEO シェア・オブ・ボイス計算ツール
 SaaS SEO ROI 計算ツール
 被リンク ROI 計算ツール
 llms.txt バリデーター
 LLM 引用チェッカー
 GEO 監査
 SEO ROI 計算ツール
 キーワード価値計算ツール
 “2年間、クライアントの100%がLinkedIn経由でした。毎日の投稿、コメント、DMでのフォローアップ…完全にアルゴリズム頼みでした。SEOに取り組むべきだとわかっていても、時間がかかる、技術的すぎる、自分の仕事ではないと、いつも後回しにしていました。Sorankでようやく一歩を踏み出しました。4か月で、何も投稿しなくても毎月15件のオーガニックリードを獲得しています。まだLinkedInと半々ではありませんが、自動で育つ2つ目のリード源ができたことで安心して眠れるようになりました。”

 Valentin Thomyoffbound.fr“Sorankは、クライアントに提供する成果を大きく変えてくれました。AIが実際に使っているキーワードを特定し、特定の競合が引用される理由を理解し、以前は完全に見落としていたチャンスを見つけられるようになりました。クライアントは、より早い順位上昇、AIの回答での可視性向上、そしてすべての施策のROIがより明確になったことを実感しています。”
 Benjamin Rouxovirank.com
 “私はマーケターではなく開発者です。私のShopifyテーマは口コミと広告だけで売れていました。Sorankのおかげで、SEOの組み立て方と上位表示される記事の書き方がようやくわかりました。監査で商品ページが遅すぎることも判明しました。2か月でオーガニックトラフィックは2倍になり、ShopifyテーマについてChatGPTで検索されたときの回答にも表示され始めています。しかも、週に約2時間の作業だけです。”
 Thème FullStackgo.themefullstack.com“Sorankのおかげで、私たちのSEOエージェンシーの働き方は大きく変わりました。すべてが一元化・自動化されたため、クライアント1社あたりにかける時間が大幅に減りました。以前は何時間もかかっていた作業が今では数分で終わり、ようやくビジネスの中で働くのではなく、ビジネスそのものに取り組めるようになりました。”
 Océane Bondismaison-leverage.com