Настройки
Конфиденциальность важна для нас, поэтому вы можете отключить отдельные виды хранения данных, которые не нужны для базовой работы сайта. Блокировка некоторых категорий может повлиять на ваше впечатление от сайта. Подробнее
Конфиденциальность важна для нас, поэтому вы можете отключить отдельные виды хранения данных, которые не нужны для базовой работы сайта. Блокировка некоторых категорий может повлиять на ваше впечатление от сайта. Подробнее

Проведите SEO-аудит по порядку: сканирование, индексация, данные  Search Console, Core Web Vitals и видимость в ИИ, с проверками и исправлениями, которые влияют на трафик.

Инструменты

Коротко
SEO-аудит это структурированная проверка всего, что мешает страницам сканироваться, индексироваться, пониматься, получать клики и цитироваться. Проводите его в фиксированном порядке: сканирование, индексация, поисковые данные, скорость, содержание страниц, ссылки, затем видимость в ИИ. Оценивайте каждое найденное проблемное место по объему трафика, который оно блокирует, а десять главных превращайте в датированные задачи с ответственным. Точечный аудит можно провести за несколько дней. Полный аудит большого сайта занимает больше времени, и его результатом должен быть план, а не список.
Хотите узнать больше? Спросите
Короткий тест
Подходит ли вам SEO и с чего начать?
Sorank подходит под ваши ответы


Попробуйте его 3 дня на своём сайте и узнайте, где вы находитесь в Google, ChatGPT и других ИИ.
Попробовать 3 дня бесплатно3 дня бесплатно, потом вы можете остановиться в любой момент. Гарантия возврата денег 90 дней, на определённых условиях.
SEO-аудит отвечает на один вопрос: какие технические, контентные и авторитетные проблемы прямо сейчас стоят вам посетителей и в каком порядке их исправлять? Это не перечень всех существующих практик. Чек-лист на 40 пунктов показывает, на что смотреть. Аудит показывает, что неправильно на вашем сайте, насколько это важно и что делать в первую очередь.
Три понятия часто путают: сам аудит (диагноз), чек-лист (перечень проверок) и отчет (то, что вы передаете клиенту или руководителю). Наш шаблон отчета SEO-аудита посвящен отчету, а чек-лист технического SEO посвящен проверкам. Эта статья о методе, который связывает их между собой, и о данных, необходимых, чтобы решить, что важно.
Два способа поставить одну и ту же задачу аудита
Разница не в объеме усилий, а в вопросе. Четкая постановка задачи называет страницы, период и решение, поэтому у каждой проверки есть причина.
Большинство аудитов идут не так еще до первого сканирования, потому что никто не согласовал объем и не сохранил исходную точку. Определите три вещи до того, как откроете любой инструмент.
Перед любым сканированием
Порядок важен. Сканирование показывает, что существует на сайте. Индексация показывает, что хранит Google. Поисковые данные показывают, что люди находят и на что кликают. Скорость, контент и ссылки затем объясняют, почему страница работает хуже. Если идти в обратном порядке, вы потратите часы на переписывание страницы, которую Google вообще не может проиндексировать.
Семь этапов SEO-аудита
Проверки перед аудитом подтверждают, что сайт, который вы собираетесь аудировать, именно тот, который видят Google и ваши посетители, и что данные достаточно надежны, чтобы на них опираться. Потратьте на них около часа до любого сканирования. Неверный ресурс в Search Console, активное правило тестовой среды или сломанная аналитика могут сделать все последующие находки ошибочными, и сканирование ни одну из этих проблем не покажет.
Запросите каждый вариант домена: http, https, с www и без www, с завершающим слэшем и без него. Каждый вариант должен заканчиваться на одном и том же конечном адресе, лучше после одного перенаправления. Две живые версии делят ссылки и сигналы между собой, и краулер сочтет обе здоровыми.
curl -I http://example.com/
curl -I https://www.example.com/
Прочитайте заголовок Location в каждом ответе. Он должен вести напрямую на предпочтительный адрес, а не на второе перенаправление. Повторите проверку на главной странице и на одной глубокой странице, потому что правила перенаправлений часто различаются между шаблонами.
Настройки тестовой среды являются одной из самых частых причин внезапного падения. Посмотрите живой robots.txt, мета-тег robots и заголовок X-Robots-Tag на главной странице и на одной статье. Правило Disallow для всего сайта или noindex, оставшийся от тестовой сборки, может скрыть разделы от поиска, в то время как страницы по-прежнему открываются для посетителей. Если нашли такое, исправьте его до аудита этих разделов, потому что все последующие находки описывали бы сайт, который Google не видит.
Запишите с датами список каждого релиза, редизайна, обновления CMS, миграции и правки robots или noindex за последние шесть месяцев. Затем сравните эти даты с началом любого изменения трафика. Падение, начавшееся в день релиза шаблона, указывает на этот шаблон. Падение без изменений рядом может указывать на обновление поисковых алгоритмов и требует другой проверки. Без журнала вы обвините то, что смотрели последним. Для изменений, связанных с URL, в чек-листе SEO-миграции перечислено, что нужно фиксировать.
Сравните клики в Search Console с органическими сессиями в вашей аналитике за те же 90 дней. Линии не обязаны совпадать, но должны двигаться в одном направлении. Если они расходятся, проверьте теги на ключевых страницах, баннер согласия и фильтрацию ботов, прежде чем диагностировать сайт. Сравнение двух инструментов объясняет, что считает каждый из них.
Сканер делает в меньшем масштабе то же, что Googlebot: начинает со страницы, переходит по найденным ссылкам и фиксирует, что видит для каждого URL. Инструмент, который мы используем в большинстве аудитов, это Screaming Frog SEO Spider. Его бесплатная версия сканирует до 500 URL, чего достаточно для небольшого сайта или одного раздела большого. Платная лицензия снимает ограничение. Наше руководство по Screaming Frog показывает настройку.
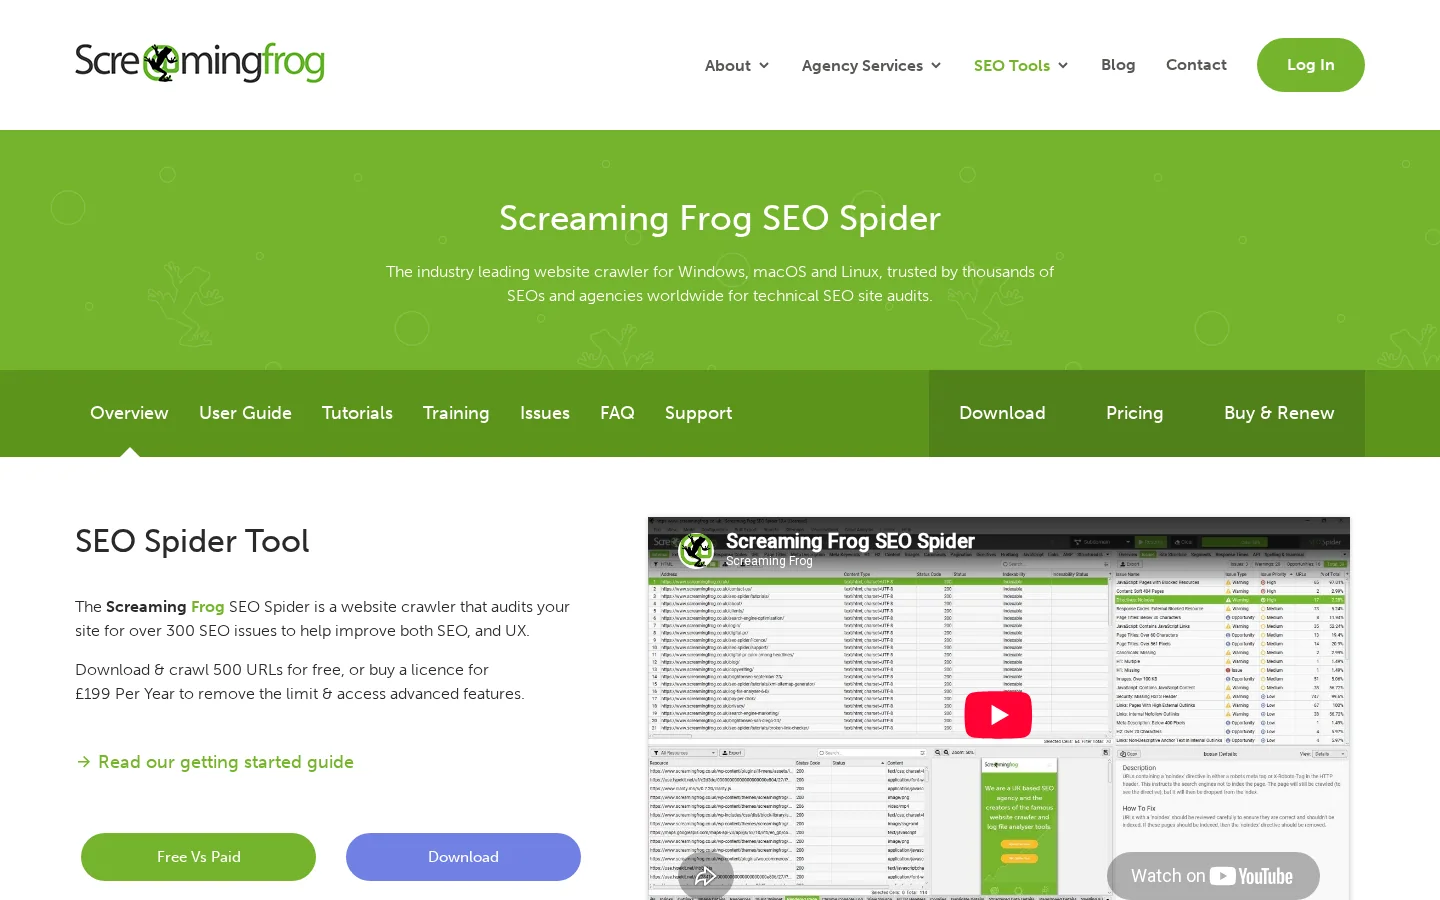
Начните сканирование с главной страницы и с карты сайта, затем сравните два списка. Каждый URL, который есть только в одном из них, это вопрос. Настройте сканер так, чтобы он учитывал robots.txt так же, как Googlebot, и рендерил JavaScript, если сайт от него зависит. Сканирование, которое не рендерит страницы, пропустит контент, который видят пользователи.
Сначала отфильтруйте ответы 4xx и 5xx. Сама по себе 404 не проблема. Она становится проблемой, когда на нее все еще ведут внутренние ссылки, потому что они отправляют пользователей и краулеров в тупик. Найдите внутренние ссылки, которые ведут на страницы с ошибками, и направьте их на работающий URL. Затем посмотрите на цепочки редиректов: старый URL перенаправляет на второй, тот на третий. Каждый переход добавляет задержку и размывает сигнал. Выпрямите каждую цепочку, чтобы старый URL указывал сразу на конечный.
Проверьте также тип редиректа. Временный 302, использованный для постоянного переезда, должен быть 301. В нашем руководстве по 301 и 302 дано правило выбора.
Три настройки могут незаметно скрыть страницу. Правило disallow в robots.txt останавливает сканирование. Мета-тег noindex или HTTP-заголовок X-Robots-Tag останавливают индексацию. Тег canonical, указывающий на другой URL, сообщает поисковикам, какую версию сохранить. Проверяйте каждую настройку для каждого типа страниц, потому что правило, добавленное для исправления одного раздела, часто блокирует другой. Типичный случай: правило с тестовой среды, которое так и не убрали из боевого robots.txt.
Предупреждение
Блокировка страницы в robots.txt не равна удалению ее из поиска. Если Google не может сканировать страницу, он не может прочитать на ней тег noindex. Чтобы убрать страницу из индекса, разрешите сканирование, добавьте noindex и дождитесь, пока Google снова просканирует страницу.
Страница-сирота не имеет внутренней ссылки, которая на нее указывает. Краулеры находят ее только через карту сайта или внешнюю ссылку, а пользователи почти никогда до нее не доходят. Чтобы найти сирот, сравните три списка: URL, до которых сканер добрался по ссылкам, URL из карты сайта и URL, которые получают визиты в аналитике. Страница, которая есть в карте сайта или получает визиты, но не имеет входящей внутренней ссылки, является кандидатом в сироты.
Измерьте также глубину клика, то есть число кликов от главной страницы. Важная страница, спрятанная на пятом или шестом клике, получает мало внимания краулеров и мало внутренних ссылок. Добавьте на нее ссылку с релевантной страницы-хаба и проверьте, что сам хаб находится неглубоко.
Отфильтруйте отсутствующие title, повторяющиеся title, повторяющиеся мета-описания и заголовки, которые слишком длинны, чтобы полностью показываться в результатах поиска. Дубли почти всегда создает шаблон, а не автор. Шаблон карточки товара, который выводит один и тот же title для каждой модификации, порождает сотни дублей, и исправление шаблона устраняет их все сразу. Считайте тег title сильной подсказкой для Google, а не гарантией. Google иногда переписывает его, и это еще одна причина держать его точным и конкретным.
Серверные логи замыкают цикл сканирования. Они показывают, какие URL запрашивал Googlebot, как часто и какие статус-коды получал. Если у вас есть к ним доступ, сравните запросы с картой сайта. Страницы, которые Googlebot постоянно посещает, но которые не приносят пользы, свидетельствуют о потере краулингового бюджета, что объясняется в нашей статье о краулинговом бюджете.
Отчет «Индексирование страниц» в Search Console перечисляет URL, о которых знает Google, и статус, который он присваивает каждому. Откройте его и сортируйте по причине, а не по количеству. Каждая причина указывает на свое исправление. Официальные определения Google из справки Search Console о статусах индексации служат эталоном для меток ниже.
| Статус в отчете | Что это значит | Что делать |
|---|---|---|
| Обнаружена, сейчас не проиндексирована | Google нашел URL, но еще не сканировал его и отложил сканирование, потому что ожидал перегрузки сайта | Проверьте время ответа сервера и глубину URL. Убедитесь, что на него ведут внутренние ссылки |
| Просканирована, сейчас не проиндексирована | Google просканировал страницу и решил не индексировать ее. Google не индексирует каждую страницу в сети | Сначала проверьте качество: тонкий контент, почти одинаковые страницы, слабые внутренние ссылки. Используйте проверку URL для важных страниц |
| Заблокирована в robots.txt | Googlebot не может сканировать URL | Убедитесь, что блокировка намеренная. Снимите ее, если страница должна ранжироваться |
| Исключена тегом noindex | На странице стоит директива noindex | Уберите директиву, если страница должна ранжироваться. Оставьте ее на страницах, которые должны оставаться вне поиска, например на результатах внутреннего поиска |
Практическое правило: когда целый тип страниц показывает высокую долю «просканирована, сейчас не проиндексирована», смотрите сначала на шаблон, а потом на статьи. Тонкие шаблоны производят тонкие страницы, и исправление одной статьи не изменит картину. Наше руководство по статусу «просканирована, сейчас не проиндексирована» подробно разбирает причины.
Для важных страниц используйте проверку URL по одной странице за раз. Она показывает дату последнего сканирования, проиндексирована ли страница и канонический адрес, который выбрал Google. Когда выбранный канонический адрес не совпадает с объявленным вами, причина почти всегда в дублировании или противоречивых сигналах: например, canonical указывает на перенаправленный URL, или внутренние ссылки предпочитают параметрическую версию.
Отчет «Эффективность» в Search Console самый полезный бесплатный набор данных для аудита. По умолчанию он показывает последние три месяца, чего слишком мало для тренда. Экспортируйте не менее 90 дней данных по запросам и страницам и сохраните файл с датой, чтобы сравнить его со следующим аудитом. Группируйте таблицу по страницам и по запросам, а фильтры по стране и устройству используйте, если сайт работает на нескольких рынках.
Четыре анализа находят большую часть возможностей в этих данных.
Чтобы выделить тип страниц, добавьте фильтр страниц с регулярным выражением. Например, чтобы увидеть только страницы блога, которые нацелены на запросы «как сделать», введите два значения:
Page filter (regex):   /blog-geo-seo/.*
Query filter (regex):  how to|guide|checklist
Кликабельность сильно зависит от верхней части выдачи. Несколько опубликованных цифр помогают оценить, реален ли разрыв. В исследовании кликабельности Google первый органический результат получал 27,6% кликов, первая тройка вместе 54,4%, а результаты второй страницы 0,63%.
Почему первая позиция так важна
Источник: Backlinko, исследование CTR Google (backlinko.com/google-ctr-stats)
Используйте эти средние как проверку здравого смысла, а не как цель. Они смешивают все виды запросов, а ваши цифры зависят от поискового намерения, брендовых запросов и функций над вашим результатом, таких как видео, изображения или ответы ИИ. Сравнивайте каждую страницу со страницами, которые ранжируются по похожим запросам на вашем же сайте.
Пороги ниже это отправные точки, которые мы используем для сортировки данных. Это не правила Google, поэтому корректируйте их под размер сайта и объем запросов.
| Проверка | Стартовый порог (наше практическое правило) | Почему это важно |
|---|---|---|
| Зона близкой позиции | Средняя позиция с 8 по 20, минимум 50 показов за 90 дней | Спрос есть, а страница достаточно близко, чтобы подняться |
| Спад | Клики упали на 30% и более между двумя равными периодами | Потеряно достаточно трафика, чтобы оправдать пересмотр |
| Тонкий контент | Менее 300 слов основного текста без навигации и шаблонных блоков | Часто этого мало, чтобы ответить на запрос. Короткая страница-инструмент может быть правильной, поэтому проверьте намерение |
| Внутренние ссылки | Меньше 3 входящих внутренних ссылок с индексируемых страниц | Слабый сигнал важности и частый признак страницы-сироты |
Данные Search Console дают и вторую проверку: запросы, по которым вы ранжируетесь, но которые никогда не были целевыми. Это часто самые легкие дополнения к существующей странице, потому что релевантность уже подтверждена показами.
Документация Google по Core Web Vitals определяет три показателя пользовательского опыта и их пороговые значения. Страница находится в «хорошей» зоне, когда ее Largest Contentful Paint не превышает 2,5 секунды, Interaction to Next Paint не превышает 200 миллисекунд, а Cumulative Layout Shift не превышает 0,1. INP стал стабильным Core Web Vital в 2024 году и заменил First Input Delay.
| Метрика | Хорошо, когда | Что измеряет | Обычное решение |
|---|---|---|---|
| LCP | 2,5 секунды или меньше | Как быстро загружается самый большой видимый элемент | Оптимизируйте главное изображение, сократите время ответа сервера, предзагрузите шрифт, который нужен странице первым |
| INP | 200 миллисекунд или меньше | Как быстро страница реагирует на клики, касания и нажатия клавиш во время визита | Разбивайте длинные задачи JavaScript, удаляйте тяжелые сторонние скрипты, не блокируйте главный поток при загрузке |
| CLS | 0,1 или меньше | Насколько сильно сдвигается контент во время загрузки страницы | Задавайте ширину и высоту изображений и встроенных элементов, резервируйте место под баннеры и рекламу, избегайте поздно загружаемых элементов над сгибом |
Сначала читайте полевые данные, потом лабораторные. Полевые данные поступают от реальных пользователей Chrome и показывают, страдают ли посетители на самом деле. Лабораторные данные получены в ходе симулированного запуска и показывают, почему страница медленная. PageSpeed Insights показывает оба: полевые данные, когда у Google достаточно трафика по URL, и лабораторные данные для каждого URL, который вы тестируете.
Тестируйте три-пять URL на каждый шаблон, а не только главную. Шаблон товара, шаблон категории и шаблон блога могут иметь очень разные оценки на одном сайте, потому что загружают разные скрипты. Высокая лабораторная оценка при плохом полевом INP типична для сайтов с тяжелыми менеджерами тегов и виджетами чата. В таком случае лабораторный тест не ошибочен, но он не отражает взаимодействие пользователя со страницей после загрузки.
На мобильных устройствах проверьте три вещи. Основной контент мобильной версии должен совпадать с десктопной, потому что Google в первую очередь индексирует мобильную версию страницы. Структурированные данные и внутренние ссылки должны быть одинаковыми в обеих версиях. И никакой навязчивый интерстициал не должен закрывать контент при входе. Скорость влияет на ранжирование, но полезнее исправлять ее потому, что медленные шаблоны теряют посетителей, пока те ничего не успели прочитать.
Для каждой важной страницы проверьте title, заголовки, глубину ответа, ссылки входящие и исходящие, и есть ли близкий дубликат. Делайте это для выборки страниц каждого шаблона, а затем для страниц, которые в поисковых данных показывают зону близкой позиции или спад.
| Проверка | Проходит, когда | Не проходит, когда |
|---|---|---|
| Title | Называет тему и основной запрос страницы и уникален для всего сайта | Дублирует другую страницу или является шаблонным значением, например только названием сайта |
| H1 | Один на страницу, называет тему простыми словами | Отсутствует, повторяется или заменен логотипом или баннером |
| Первый экран | Вопрос запроса получает ответ близко к верху | На первом экране контекст и брендовый текст, а ответ появляется после нескольких прокруток |
| Глубина | Покрывает подвопросы, которые люди задают по теме, с конкретикой | Тонкая или заполненная повторяющимися абзацами |
| Внутренние ссылки | Ведут на нее родственные страницы, а сама она ведет на следующий логичный шаг | Сирота или ссылки только из подвала или карты сайта |
| Структурированные данные | Соответствуют содержимому, которое посетитель видит на странице | Размечают контент, которого нет на странице, или используют не тот тип |
Внутренние ссылки самый дешевый рычаг во всем аудите. Ссылка со страницы, которая уже ранжируется, стоящая в основном тексте и использующая слова целевого запроса в анкоре, передает и контекст, и авторитет. Общие анкоры вроде «нажмите здесь» или «читать далее» передают очень мало смысла. Работайте со страниц, которые приносят больше всего трафика, потому что каждая новая ссылка с них ведет на страницу с реальной аудиторией.
Дублированный и почти дублированный контент заслуживает отдельного прохода. Фильтры категорий, параметры сортировки и параметры отслеживания часто создают много URL, которые показывают один и тот же список. Решите, какая версия должна существовать, и используйте подходящий canonical, правила robots или обработку параметров. Не оставляйте это решение Google, потому что результат вам не понравится.
Совет
Для быстрой первой проверки одной страницы бесплатный инструмент on-page SEO-аудита выполняет типовые проверки title, заголовков, ссылок и мета-тегов, чтобы вы могли тратить время на находки, которые требуют суждения.
Проверка ссылочного профиля отвечает на три вопроса: растете ли вы по числу ссылающихся доменов в ровном темпе, потеряли ли важные ссылки и есть ли паттерны, которые выглядят искусственными? Экспортируйте ссылающиеся домены за период из инструмента для бэклинков, затем ищите резкие всплески, которые часто идут от платной кампании или спама, и провалы, которые часто связаны с устаревшими страницами или миграцией сайта. Наше руководство по аудиту бэклинков описывает полный обзор.
Будьте осторожны с инструментом отклонения ссылок (disavow). Собственные рекомендации Google таковы, что большинству сайтов он не нужен. Используйте его, когда есть явный паттерн ссылок, которые вы не заработали, и ручная санкция или серьезная проблема, связанная с ними, а не потому что инструмент для бэклинков присвоил некоторым доменам низкий балл. Ошибочно отклонить хорошие ссылки обходится дороже, чем оставить несколько плохих.
Две проверки теперь обязательны в любом аудите. Первая это доступ: могут ли ИИ-краулеры попасть на ваши страницы? Проверьте правила robots.txt для каждого краулера, который важен для вас. OpenAI использует GPTBot и OAI-SearchBot, Anthropic использует ClaudeBot, а Perplexity использует PerplexityBot, и служат они не одной и той же цели. Одно правило для всех редко бывает правильным решением. Наше руководство по ИИ-краулерам перечисляет их и их роли.
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /
Пример выше это одно возможное решение, а не рекомендация для каждого сайта. Он позволяет одному краулеру читать ваши страницы для ответов в поиске и блокирует другой, который используется для обучения. Решайте отдельно для каждого краулера, фиксируйте решение и проверяйте файл после каждого деплоя, потому что robots.txt, который блокирует все, часто появляется после выкладки с тестовой среды.
Вторая проверка это видимость: называют ли вас ответные системы, когда покупатель задает вопрос, на который вы нацелены? Составьте список из десяти-двадцати промптов из реальных вопросов в ваших поисковых данных и в разговорах с продажами. Запустите их в ChatGPT, Perplexity и Gemini, фиксируйте, какие бренды и какие URL цитируются, и повторяйте каждый промпт несколько раз в течение нескольких дней, потому что ответы меняются от запуска к запуску. Метод аудита AI-видимости объясняет, как оценивать результаты.
Аудиты отличаются по объему и по месту, с которого вы начинаете. На практике распространены пять методов. Каждый подходит в своей ситуации, и большинство команд комбинируют два из них.
Принцип: охватить весь сайт, каждый тип страниц и каждый источник данных, затем ранжировать находки. Используйте, когда готовите миграцию, после резкого падения трафика или проводите первый аудит большого сайта. Преимущество: находит структурные проблемы, которые не видны при проверке отдельных страниц, например фасетную навигацию, которая множит URL. Ограничение: он медленный и выдает много находок, которые требуют второго прохода для упорядочивания. Пример: ритейлер с 40000 URL товаров выясняет, что один параметр фильтра создает большую часть дублей, которую не выявила бы ни одна проверка отдельного товара.
Принцип: начинать с того, что изменилось в поисковых данных, и диагностировать только затронутые страницы и запросы. Используйте, когда проводите ежемесячный обзор, когда только что выкатилось обновление ядра или когда команда небольшая. Преимущество: работа приоритизирована по трафику с первой минуты. Ограничение: он слеп к страницам, по которым еще нет данных, например к новым разделам или страницам, заблокированным с самого начала. Пример: блог, потерявший клики на пяти страницах, проверяет именно эти пять, находит две, которые конкурируют друг с другом, и объединяет их.
Принцип: провести все проверки на одном URL, затем решить, нужна ли переработка. Используйте, когда одна коммерческая страница underperforms или перед запланированной переработкой. Преимущество: быстрый и конкретный, с понятными «до» и «после». Ограничение: он не показывает паттерны, поэтому ошибка шаблона может выглядеть как разовая проблема. Пример: страница товара с хорошим title и содержанием оказывается с canonical, который указывает на отсутствующую в наличии модификацию.
Принцип: сравнить ваши страницы и темы с теми, что ранжируются выше вас по тем же запросам. Используйте, когда планируете новый контент или новые ссылки. Преимущество: показывает, что рынок вознаграждает на практике, включая глубину, формат и охваченные подвопросы. Ограничение: копирование лидера может завести в переполненную тему или тему с неверным намерением. Проверьте, что действительно общего у лучших результатов, прежде чем решать. Пример: пять лучших результатов по запросу все отвечают на вопрос о цене на первом экране, а ваш результат нет.
Принцип: проверить, могут ли ИИ-краулеры читать ваши страницы и цитируют ли ответные системы вас по важным вопросам. Используйте, когда нужно знать, рекомендуют ли ваш бренд ИИ-инструменты. Преимущество: он охватывает канал, который традиционные трекеры позиций не показывают. Ограничение: ответы варьируются от запуска к запуску, поэтому выборку нужно повторять, прежде чем делать выводы. Пример: софтверная компания упоминается за функцию, которую она перестала продавать, что показывает устаревание ее сравнительных страниц.
| Метод | Отправная точка | Лучше всего подходит | Главное ограничение |
|---|---|---|---|
| Полный технический аудит | Сканирование и все источники данных | Миграции, большие сайты, резкие падения | Медленный, и трудно упорядочить без плана |
| Аудит, начинающийся с данных | Изменения в поисковых данных | Ежемесячные обзоры, небольшие команды | Пропускает страницы, по которым еще нет данных |
| Аудит на уровне страницы | Один URL | Одна недооцененная страница | Не видит паттернов на уровне шаблонов |
| Аудит разрыва с конкурентами | Результаты выше вас | Новый контент и новые ссылки | Риск скопировать неверное намерение |
| Аудит видимости в ИИ | Доступ краулеров и ответные системы | Понимание, рекомендует ли вас ИИ | Ответы варьируются, поэтому выборки нужно повторять |
Быстрый аудит против полного
Наш совет: начинайте с быстрого аудита и переходите к полному, только когда быстрый указывает на структурную причину или когда вы собираетесь менять архитектуру сайта.
Аудит с 400 находками и без порядка стоит меньше, чем аудит с десятью. Оценивайте каждую находку по двум критериям: сколько трафика или выручки она ставит под угрозу и насколько сложно ее исправить. Начните с пунктов с высоким эффектом и низкими усилиями. Затем берите пункты с высоким эффектом, которые требуют больше работы, но открывают целый шаблон, потому что одно исправление там меняет тысячи страниц.
| Находка | Трафик под угрозой | Усилия | Приоритет |
|---|---|---|---|
| Шаблон ссылается на 404-страницы с каждой страницы | Высокий | Низкие | Сделать первым |
| Коммерческие страницы с дублирующимися title | Высокий | Низкие | Сделать первым |
| Медленный LCP на шаблоне категорий | Высокий | Средние | Запланировать в следующем спринте |
| Статьи блога с падением трафика | Средний | Средние | Обновлять по порядку потерянных кликов |
| Страницы-сироты глоссария | Низкий | Низкие | Объединить с работой над внутренней перелинковкой |
| Страницы архивов тегов с тонким контентом | Низкий | Средние | Проверить намерение, затем noindex или объединение |
Назначьте каждому пункту ответственного, дату и метрику, которую ожидаете сдвинуть. Находка без ответственного это заметка, а заметки не меняют ранжирование. Перемеряйте после того, как Google пересканирует затронутые страницы, что может занять недели, и сравните с исходной точкой, которую вы сохранили в начале. При презентации результатов шаблон отчета SEO-аудита дает структуру, которую руководители и клиенты могут прочитать за десять минут.
Если вы хотите видеть трафик Google и ИИ в одном месте, пока отслеживаете эти исправления, дашборд GEO/SEO от Sorank показывает оба рядом.
SEO-аудит за 90 минут проверяет страницы, которые приносят больше всего поискового трафика, в таком порядке, чтобы сначала находить реальные потери. Используйте его, когда у вас есть одна сессия и нужен ранжированный список исправлений, а не обзор каждого URL. Ограничьте работу главными страницами и одним примером URL на каждый шаблон, и результат можно будет использовать в тот же день.
Разделите сессию на фиксированные блоки и останавливайте каждый блок, когда его время истекло. Ограничение по времени является частью метода, потому что заставляет выбирать.
| Минуты | Задача | Результат |
|---|---|---|
| 0 до 10 | Экспортируйте данные по запросам и страницам за 90 дней из Search Console и составьте список 20 страниц с наибольшим количеством кликов | Сохраненная исходная точка и короткий список страниц |
| 10 до 25 | Примените к этому списку проверки striking distance и decay из этапа 3 | Страницы, которые потеряли клики, или находятся между позициями 8 и 20 |
| 25 до 40 | Просканируйте по одному примеру URL на каждый шаблон и проверьте код ответа, canonical и директивы robots | Ошибки, неверные canonical и блокировки по шаблонам |
| 40 до 55 | Откройте отчет «Индексирование страниц» и отсортируйте причины по количеству | Статус, который затрагивает больше всего страниц |
| 55 до 70 | Запустите PageSpeed Insights на одном URL каждого шаблона, сначала читая полевые данные | Шаблон с самым слабым полевым LCP или INP |
| 70 до 90 | Запишите десять главных находок с трафиком под угрозой, усилиями и ответственным | Ранжированный план, который можно отправить в тот же день |
Каждая строка отвечает на один вопрос, поэтому можно пропустить строку, не потеряв остальные. Если отчет об индексации ничего необычного не показывает, отдайте это время поисковым данным: обычно это быстрее ведет к исправлению.
Ограничение по времени скрывает три вещи. Пропускаются структурные проблемы, например фильтр, который множит URL, потому что вы читаете только выборки. Не используются серверные логи, поэтому не видно, как часто краулеры запрашивают страницу. И пропускается ссылочный профиль, для которого нужна полная выгрузка из инструмента для бэклинков. Запишите это как открытые вопросы для последующего аудита бэклинков или полного обзора, чтобы короткий аудит не выглядел полнее, чем он есть.
Самая частая ошибка: начинать с краулера. Сканирование большого сайта может занять больше времени, чем вся сессия, и выдать больше предупреждений, чем кто-либо способен прочитать. Начинайте с поисковых данных и открывайте краулер только для страниц, у которых есть клики или показы. Сначала исправляйте предупреждения на этих страницах, потому что предупреждения на страницах, которые никто не посещает, не меняют ваш трафик.
Совет
Поставьте сессию в календарь с таймером и одним файлом результатов. Используйте колонки шаблона отчета SEO-аудита с самого начала, чтобы к 90-й минуте список был готов для передачи.
В большинстве аудитов встречаются одни и те же ошибки. Их легко избежать, когда знаешь признаки.
Что это: аудит охватывает все, поэтому ничего не доводится до конца. Как заметить: в отчете сотни проблем, ни у одной нет цифры трафика или ответственного. Как исправить: начните заново с четкой постановки задачи из первого раздела, ограничьте сканирование типами страниц, которые важны, и отсортируйте находки по трафику, прежде чем писать что-либо еще.
Что это: команда исправляет предупреждения, которые инструмент показывает красным, даже когда они касаются страниц, которые никто не посещает. Как заметить: количество предупреждений снижается, а клики на коммерческие страницы продолжают падать. Как исправить: соедините сканирование с поисковыми данными и сначала исправляйте проблемы на страницах, которые имеют трафик, показы или ссылки.
Что это: сканер не сообщает об ошибках, поэтому команда делает вывод, что сайт здоров. Как заметить: Search Console показывает много URL со статусами «просканирована, сейчас не проиндексирована» или «обнаружена», которые сканер никогда не отмечал. Как исправить: сравните сканирование с картой сайта, отчетом об индексации и серверными логами. Сканер видит только то, что может достичь по ссылкам и рендерингу, поэтому контент за логинами, скриптами или фасетными фильтрами может отсутствовать в его списке.
Что это: команда редактирует один и тот же title, одно и то же изображение или один и тот же canonical на сотнях страниц по одной. Как заметить: одна и та же находка встречается на большинстве URL одного типа страниц. Как исправить: исправьте шаблон один раз, затем проверьте выборку страниц, чтобы убедиться, что изменение сработало везде. Одно изменение шаблона исправляет всю группу.
Что это: команда добавляет disallow в robots.txt для страницы, которую хочет убрать из Google. Как заметить: страница остается в индексе с голым URL и без сниппета, а отчет показывает ее как заблокированную. Как исправить: разрешите сканирование, добавьте директиву noindex и дождитесь, пока Google снова просканирует страницу. Когда она выпадет из индекса, вы можете заблокировать ее, если нужно, но необходимости в этом нет.
Пример (иллюстративный)
Представьте сайт, который убрал серию рекламных посадочных страниц и заблокировал их в robots.txt. Страницы продолжают появляться в поиске с голым URL и без описания, потому что другие сайты по-прежнему на них ссылаются. Снятие блокировки и добавление noindex позволяют Google просканировать страницы, прочитать директиву и удалить их из индекса.
Что это: команда оптимизирует оценку 100 в лабораторном тесте и игнорирует полевые данные. Как заметить: лабораторная оценка высокая, но полевой INP для того же шаблона плохой в отчете Search Console по Core Web Vitals. Как исправить: профилируйте взаимодействия, которые совершают реальные пользователи, обычно уже после загрузки страницы. Ищите длинные задачи, вызванные скриптами, а не время загрузки первой отрисовки.
Каждый месяц проводите быстрый аудит по поисковым данным и по самым важным шаблонам. Полный аудит запускайте после миграции, редизайна, смены CMS или внезапного падения трафика, а один полный обзор в год проводите, чтобы поймать структурный дрейф. Поисковые данные нужно отслеживать постоянно, потому что падение кликов полезнее работает как сигнал тревоги, чем как напоминание в календаре.
Аудит сайта представляет собой сканирование каждого доступного URL на одном домене с отчетом по типу проблемы и уровню важности. Он показывает, что сломано на всем сайте, включая закономерности, которые пропускает проверка страница за страницей. Он не говорит, какое исправление поднимет позиции, поэтому сопоставляйте его с данными поиска.
Фильтры, параметры сортировки и метки отслеживания могут создать гораздо больше URL, чем у вас страниц, и большинство из них показывают один и тот же список. Исключите эти параметры и медиафайлы и сканируйте каждый поддомен как отдельный проект. Держите частоту запросов низкой, чтобы сервер оставался быстрым для реальных посетителей. Оставьте в объеме пагинацию (page=), потому что постраничные списки могут содержать страницы, которые должны быть в индексе.
.*\?(sort|filter|utm_[a-z]+)=.*
.*\.(jpg|jpeg|png|webp|gif|svg|pdf|mp4)$
Большинство краулеров принимают правила исключения, записанные как регулярные выражения вроде этих. Проверьте их на коротком сканировании и убедитесь, что число URL снижается только за счет параметров, которые вы хотели исключить.
Каждый инструмент группирует проблемы по уровням и считает собственную оценку состояния. Названия различаются, но логика приоритизации одна и та же. Оценка это линия тренда для одного инструмента с фиксированными настройками, а не оценка, которую ставит Google. Проходите уровни в таком порядке:
| Уровень | Типичные проблемы | Первое действие |
|---|---|---|
| Ошибки на индексируемых страницах | Ответы 4xx или 5xx на URL, которые должны ранжироваться, битые внутренние ссылки | Исправляйте первыми, начиная со страниц, которые уже приносят клики |
| Ошибки на страницах, которые не нужно индексировать | Битый внутренний поиск, фильтры или закрытые рекламные URL | Уберите внутренние ссылки, которые все еще на них ведут |
| Предупреждения | Слишком длинные title, отсутствующие описания, повторяющиеся заголовки | Исправляйте пакетами, желательно одним изменением шаблона |
| Уведомления | Мелкие советы по оптимизации | Просмотрите один раз и действуйте, только если они повторяются на коммерческих страницах |
Самый полезный результат аудита сайта: разница между двумя запусками. Экспортируйте список проблем из последнего запуска, снова просканируйте с теми же настройками и сравните количество по типу проблемы и по URL. Новые проблемы идут первыми, потому что новая ошибка на живой странице обычно следует за недавним релизом. Сопоставьте каждую новую группу с журналом изменений, прежде чем назначать ответственного.
Например, первый запуск показывает 42 ошибки, а второй, через четыре недели, 57, и 15 из новых находятся на шаблоне цен, который вышел в ту же неделю. Вы исправляете шаблон один раз. Если число снова приближается к 42, исправление сработало, и этот запуск становится базой для следующего.
Аудит сайта, на который уходит целый день, не будет повторяться. Сохраните объем, правила исключения и таблицу уровней важности как одну конфигурацию, чтобы следующий запуск занимал минуты. Настройте расписание сканирования и каждый раз экспортируйте одни и те же три файла: список проблем, индексируемые URL и URL, которые получают клики. Наше руководство по автоматизированной отчетности по SEO объясняет, что автоматизировать и как это настроить.
Если вы еще выбираете краулер, наше сравнение инструментов технического SEO ранжирует варианты по выполняемым задачам. Аудит сайта стоит планировать только тогда, когда кто-то читает разницу между запусками. Иначе это просто еще один экспорт в папке.
Если вы никогда не проводили аудит, сделайте четыре шага по порядку. Экспортируйте 90 дней данных Search Console и сохраните их с датой. Просканируйте ваши основные шаблоны краулером, начав с бесплатной версии на 500 URL, если сайт небольшой. Прочитайте отчет об индексации и сгруппируйте причины. Затем исправьте три крупнейшие проблемы шаблонов, которые нашли, и измерьте снова после того, как Google пересканирует страницы.
Хороший аудит не заканчивается документом. Он заканчивается коротким списком исправлений, которые кто-то делает в этом месяце, и исходной точкой, которая показывает, сработали ли они.
Это зависит от размера сайта и глубины проверки. Точечный аудит основных шаблонов и поисковых данных можно провести за несколько дней. Полный аудит большого сайта со множеством шаблонов занимает дольше, и большая часть времени уходит на диагностику и расстановку приоритетов, а не на само сканирование.
Как минимум Google Search Console и сканер вроде Screaming Frog SEO Spider, а также PageSpeed Insights для скорости. Аналитика и серверные логи дают полезный контекст. Платные SEO-пакеты помогают с обратными ссылками и данными о конкурентах, но для первого аудита они не обязательны.
Чек-лист перечисляет проверки, которые нужно выполнить. Аудит выполняет эти проверки на вашем сайте, определяет, какие находки важны, и упорядочивает исправления по трафику, который они ставят под угрозу. Используйте чек-лист, чтобы построить аудит, а аудит, чтобы выбрать работу.
Мы бесплатно анализируем ваших конкурентов, ваш сайт и вашу видимость в ИИ и составляем персональный контент-план.
 ИИ-генератор брифа для контента
 Генератор схемы FAQ
 ИИ-генератор идей для постов в блоге
 Валидатор структурированных данных (валидатор Schema)
 Проверка альтернативного текста
 Анализатор внутренних ссылок
 Челлендж по обратным ссылкам
 ИИ-генератор метаописаний
 ИИ-генератор заголовков для блога
 Проверка индексируемости в Google
 ИИ-генератор плана статьи для блога
 Конструктор UTM-ссылок
 Инструмент кластеризации ключевых слов
 Проверка тега canonical
 Генератор XML-карты сайта
 Проверка битых ссылок
 ИИ-генератор SEO-заголовков
 Анализатор заголовков
 Предпросмотр поисковой выдачи
 Проверка редиректов
 Генератор тегов hreflang
 Анализатор структуры заголовков
 Проверка HTTP-заголовков
 Экстрактор фавиконок
 Калькулятор CTR в выдаче
 Калькулятор экономии SEO в сравнении с платным поиском
 Калькулятор доли голоса в SEO
 Калькулятор ROI от SEO
 Калькулятор прогноза трафика и выручки от SEO
 Калькулятор бюджета на SEO
 Калькулятор точки безубыточности SEO
 Калькулятор ROI от SEO для SaaS
 Калькулятор ROAS
 Калькулятор времени чтения
 Симулятор прироста позиций
 Калькулятор стоимости органического трафика
 Оценка органического трафика и проверка посещаемости сайта
 Калькулятор соотношения LTV к CAC
 Калькулятор ROI от локального SEO
 Калькулятор стоимости линкбилдинга
 Калькулятор ценности ключевого слова
 Калькулятор оценки возможностей ключевого слова
 Калькулятор плотности ключевых слов
 Калькулятор ROI от GEO
 Калькулятор инвестиций в GEO-контент
 Калькулятор ROI от SEO для интернет-магазина
 Калькулятор пожизненной ценности клиента
 Калькулятор стоимости привлечения клиента
 Калькулятор CTR
 Калькулятор стоимости статьи
 Калькулятор коэффициента конверсии
 Калькулятор ROI контент-маркетинга
 Оценка реферального трафика из ChatGPT
 Калькулятор показателя отказов
 Калькулятор ROI обратных ссылок
 Калькулятор AI Visibility Score
 Калькулятор стоимости AI-трафика
 Калькулятор доли голоса в ИИ
 Калькулятор стоимости невидимости в ИИ
 Калькулятор частоты цитирования в ИИ
 Валидатор llms.txt
 Проверка AI Overview и позиций в AI Overviews
 Проверка robots.txt
 ИИ SEO-аудит
 Проверка читаемости для LLM
 Проверка готовности к SearchGPT
 Аудит структурированных данных для LLM
 Аудит доступности сайта для ИИ-роботов
 Почему ChatGPT не рекомендует мой сайт
 Инструмент позиций в Gemini
 Проверка позиций в Perplexity
 Проверка цитирования в LLM
 Аудит Answer Engine Optimization
 GEO-аудит
 Тест видимости в ИИ-поиске
 Проверка видимости в ChatGPT
 Генератор llms.txt
 Извлечение URL
 Веб-страница в Markdown
 Проверка карты сайта
 Датчик волатильности выдачи
 Проверка размера страницы
 Счётчик слов
 Генератор slug
 Генератор Schema
 Генератор robots
 Предпросмотр OG
 Генератор метатегов
 Компрессор изображений
 Генератор фавиконок
 Аудит внутренней SEO-оптимизации: SEO-проверка и SEO-анализ
 Инструмент анализа обратных ссылок
 Инструмент подбора ключевых слов
 Проверка авторитета домена
 “Я протестировал Sorank на реальном клиентском сайте, и это потрясающе. Он делает всё то, за что агентство выставило бы вам счёт на $1500 в месяц. Теперь он запускается в работу на этом клиенте.”

 Guillaume Guersanguersanguillaume.com“Мы рекламное агентство и хотели раз и навсегда вернуть своё SEO в нужное русло. Sorank дал нам чёткое представление о нашем сайте, помог расставить приоритеты в оптимизации и правильно структурировать наш контент. Инструмент прост в использовании, хорошо продуман для работы в команде и очень удобен для централизованного отслеживания без необходимости жонглировать несколькими платформами. Очень прочная основа, чтобы начать наше SEO с чистого листа.”
 Gaspard MadouiРекламное агентство
 “Я просто позволил программе Sorank делать своё дело, и теперь мой показатель DR равен 25, а моя страница ранжируется выше.”
 Lucas Flandrefoundertrace.fr“Я специализировался на GEO благодаря Sorank. Рейтинг GEO позволяет мне показывать клиентам их позицию относительно конкурентов в ChatGPT. Это реальное коммерческое преимущество.”
 MélanieФрилансер по SEO“Отличный сервис, хорошо подходит для нашего сайта и помогает понять, как его улучшить, чтобы лучше ранжироваться в Google и не только. Поздравляю, так держать, рекомендую.”
 Hugo T.Владелец интернет-магазина