Datenschutz ist uns wichtig. Deshalb können Sie bestimmte Speicherarten deaktivieren, die für die grundlegende Funktion der Website nicht erforderlich sind. Das Blockieren einzelner Kategorien kann Ihr Erlebnis auf der Website beeinträchtigen. Weitere Informationen (Cookie-Richtlinie)
Vielen Dank! Ihre Auswahl wurde gespeichert.
Hoppla! Beim Absenden des Formulars ist ein Fehler aufgetreten.
SEO-Audit durchführen: eine Schritt-für-Schritt-Methode, die findet, was Traffic kostet
Ein vollständiger SEO-Audit in der richtigen Reihenfolge: Crawling, Indexierung, Search-Console-Daten, Core Web Vitals und KI-Sichtbarkeit mit den Korrekturen, die Traffic bewegen.
Ein Notizbuch mit einer SEO-Audit-Checkliste und ausgedruckten Diagrammen auf einem Schreibtisch.
Werkzeuge
Auf dieser Seite
Kurz gesagt
Ein SEO-Audit ist eine strukturierte Prüfung aller Faktoren, die verhindern, dass Ihre Seiten gecrawlt, indexiert, verstanden, angeklickt und zitiert werden. Arbeiten Sie in fester Reihenfolge: Crawling, Indexierung, Suchdaten, Ladezeit, Inhalte auf der Seite, Links, dann KI-Sichtbarkeit. Bewerten Sie jeden Befund nach dem Traffic, den er blockiert, und machen Sie aus den zehn wichtigsten Befunden datierte Aufgaben mit einem Verantwortlichen. Ein fokussierter Audit lässt sich in wenigen Tagen erledigen. Ein vollständiger Audit einer großen Website dauert länger, und sein Ergebnis sollte ein Plan sein, keine Liste.
3 Tage kostenlos, danach beenden Sie jederzeit. 90-Tage-Ergebnisgarantie, es gelten Bedingungen.
Was ein SEO-Audit ist und was nicht
Ein SEO-Audit beantwortet eine Frage: Welche technischen, inhaltlichen und autoritätsbezogenen Probleme kosten Sie gerade Besuche, und in welcher Reihenfolge sollten Sie sie beheben? Es ist keine Liste aller existierenden Best Practices. Eine Checkliste mit 40 Punkten sagt Ihnen, worauf Sie schauen sollten. Ein Audit sagt Ihnen, was auf Ihrer Website falsch läuft, wie wichtig das ist und was Sie zuerst tun sollten.
Drei Dinge werden oft verwechselt: der Audit (die Diagnose), die Checkliste (die Liste der Prüfungen) und der Bericht (das, was Sie einem Kunden oder einer Geschäftsleitung übergeben). Unsere Vorlage für SEO-Auditberichte behandelt den Bericht, und die technische SEO-Checkliste behandelt die Prüfungen. Dieser Artikel beschreibt die Methode, die beides verbindet, und die Daten, die Sie brauchen, um zu entscheiden, was wichtig ist.
Zwei Arten, denselben Audit zu beauftragen
Vage Vorgabe
Die Website auf SEO-Probleme prüfen
Ergebnis: eine lange Liste von Warnungen, die niemand liest
Präzise Vorgabe
Seiten finden, die in den letzten 90 Tagen Klicks verloren haben
Ergebnis: zehn Korrekturen, sortiert nach gefährdetem Traffic
Der Unterschied liegt nicht im Aufwand. Er liegt in der Fragestellung. Eine präzise Vorgabe nennt die Seiten, den Zeitraum und die Entscheidung, sodass jede Prüfung einen Grund hat.
Vor dem Start: Zugang, Umfang und Ausgangswerte
Die meisten Audits scheitern schon vor dem ersten Crawl, weil sich niemand auf den Umfang geeinigt und kein Ausgangswert gespeichert wurde. Klären Sie drei Dinge, bevor Sie ein Tool öffnen.
Umfang. Welche Domains und Subdomains, welche Länder und Sprachen und welche Seitentypen zählen. Bei einem Onlineshop sind das Startseite, Kategorien, Produktseiten, Blog und eventuelle Landingpages. Halten Sie sie schriftlich fest.
Zugang. Eigentümerzugang zur Search Console für jede Property (http, https, www und ohne www, falls vorhanden), Lesezugriff auf Ihre Analysesoftware sowie Zugang zum CMS oder zu den Server-Logs, falls vorhanden. Server-Logs zeigen, was Crawler tatsächlich anfragen, was keine Crawling-Simulation zeigen kann.
Ausgangswert. Ein Snapshot von Klicks, Impressionen, durchschnittlicher Position und den Seiten, die die meisten Klicks bringen, gespeichert in einer datierten Tabelle. Ohne ihn können Sie nicht belegen, dass eine Korrektur gewirkt hat.
Vor jedem Crawl
Eigentümerzugang zur Search Console für jede Property bestätigen
90 Tage Abfrage- und Seitendaten exportieren und mit dem heutigen Datum speichern
Ihre wichtigsten Seitentypen und je eine Beispiel-URL dafür auflisten
Das Ziel in einem Satz formulieren: mehr Klicks auf die wichtigen Seiten, weniger Fehler, schnellere Vorlagen
Crawler und dessen Grenzen wählen (siehe Abschnitt zum Crawling weiter unten)
Ein Audit erfasst die gesamte Struktur einer Website, bevor er eine einzelne Seite korrigiert.
Die Methode in der richtigen Reihenfolge: sieben Schritte
Die Reihenfolge ist entscheidend. Das Crawling zeigt, was auf Ihrer Website existiert. Die Indexierung zeigt, was Google behält. Die Suchdaten zeigen, was Menschen finden und anklicken. Ladezeit, Inhalte und Links erklären dann, warum eine Seite schwach performt. Wenn Sie es umgekehrt machen, verbringen Sie Stunden damit, eine Seite umzuschreiben, die Google gar nicht indexieren kann.
Die sieben Schritte eines SEO-Audits
Website crawlenJede URL mit Statuscode, Title, Canonical, Robots-Anweisungen und internen Links erfassen.
Indexierung prüfenVergleichen, was Sie veröffentlichen, mit dem, was Google indexiert, und für jeden Ausschluss den Grund lesen.
Suchdaten auswertenSeiten und Suchanfragen finden, die Klicks gewinnen oder verlieren, und jene, die knapp vor Platz eins liegen.
Ladezeit und Mobile testenCore Web Vitals pro Vorlage messen, beginnend mit den Felddaten echter Nutzer.
Inhalte auf der Seite prüfenTitles, Überschriften, Tiefe, Duplikate und interne Links Seite für Seite und Vorlage für Vorlage kontrollieren.
Autorität und Links bewertenVerweisende Domains im Zeitverlauf, verlorene Links, Ankertexte und Spam-Signale untersuchen.
KI-Sichtbarkeit prüfenBestätigen, dass KI-Crawler Ihre Seiten erreichen, und testen, ob Antwortmaschinen Sie nennen.
SEO-Prüfungen vor dem Audit: was Sie bestätigen sollten, bevor Sie den Daten vertrauen
SEO-Prüfungen vor dem Audit stellen sicher, dass die Website, die Sie auditieren, die ist, die Google und Ihre Besucher sehen, und dass Ihre Daten verlässlich genug sind, um darauf zu handeln. Investieren Sie etwa eine Stunde, bevor Sie crawlen. Eine falsche Property, eine Staging-Regel, die live ist, oder ein kaputtes Tracking können jeden späteren Befund verfälschen, und ein Crawl zeigt davon nichts.
Bestätigen, welche Version der Website live ist
Rufen Sie jede Variante Ihrer Domain auf: http, https, mit und ohne www, mit und ohne abschließenden Schrägstrich. Jede Variante sollte an derselben finalen Adresse landen, idealerweise nach einer einzigen Weiterleitung. Zwei live erreichbare Versionen teilen Links und Signale auf, und ein Crawler meldet beide als gesund.
Lesen Sie den Location-Header jeder Antwort. Er sollte direkt auf Ihre bevorzugte Adresse zeigen, nicht auf eine zweite Weiterleitung. Wiederholen Sie die Prüfung auf der Startseite und auf einer tiefen Seite, denn Weiterleitungsregeln unterscheiden sich oft zwischen Vorlagen.
Prüfen, dass keine Testeinstellung auf die Live-Seite gelangt ist
Staging-Einstellungen gehören zu den häufigsten Ursachen für einen plötzlichen Einbruch. Prüfen Sie die Live-robots.txt, das Meta-Tag robots und den X-Robots-Tag-Header auf der Startseite und auf einem Artikel. Eine Disallow-Regel für die gesamte Website oder ein noindex aus einem Testbuild kann Bereiche aus der Suche verbergen, während die Seiten für Besucher weiterhin laden. Wenn Sie einen solchen Fehler finden, beheben Sie ihn, bevor Sie diese Bereiche prüfen, denn jeder spätere Befund würde eine Website beschreiben, die Google nicht sehen kann.
Ein Änderungsprotokoll anlegen, bevor Sie einen Einbruch diagnostizieren
Erstellen Sie eine datierte Liste jedes Releases, Redesigns, CMS-Updates, jeder Migration und jeder Änderung an robots.txt oder noindex aus den letzten sechs Monaten. Vergleichen Sie diese Daten dann mit dem Beginn jeder Traffic-Veränderung. Ein Einbruch, der am Tag eines Template-Releases beginnt, weist auf dieses Template hin. Ein Einbruch ohne Änderung in der Nähe kann auf ein Update der Suche zurückgehen und braucht einen anderen Test. Ohne Protokoll beschuldigen Sie das, was Sie zuletzt angesehen haben. Bei Änderungen an URLs listet die SEO-Migrations-Checkliste auf, was Sie festhalten sollten.
Die Daten prüfen, auf denen der Audit beruht
Vergleichen Sie die Klicks aus der Search Console mit den organischen Sitzungen in Ihrem Analyse-Tool für denselben Zeitraum von 90 Tagen. Die beiden Linien müssen nicht übereinstimmen, sollten sich aber in dieselbe Richtung bewegen. Wenn sie auseinanderlaufen, prüfen Sie die Tags auf wichtigen Seiten, das Einwilligungsbanner und die Bot-Filterung, bevor Sie die Website diagnostizieren. Der Vergleich der beiden Tools erklärt, was jedes der beiden misst.
Schritt 1: Website crawlen und finden, was der Crawler entdeckt
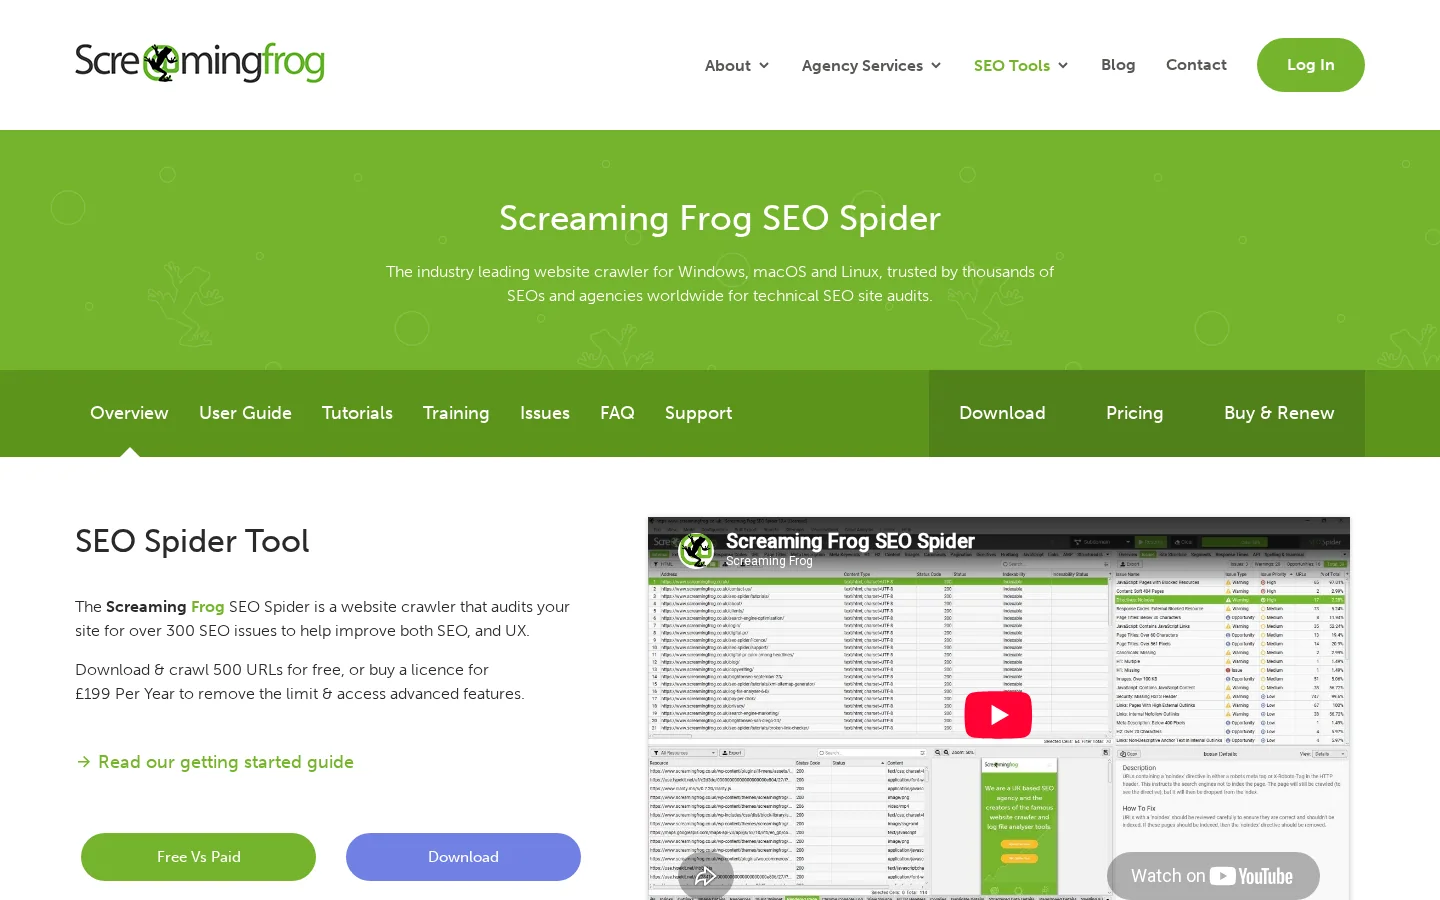
Ein Crawler macht im Kleinen, was der Googlebot macht: Er startet bei einer Seite, folgt den gefundenen Links und notiert für jede URL, was er sieht. Das Tool, das wir in den meisten Audits einsetzen, ist Screaming Frog SEO Spider. Die kostenlose Version crawlt bis zu 500 URLs, was für eine kleine Website oder einen Bereich einer großen ausreicht. Eine kostenpflichtige Lizenz hebt das Limit auf. Unser Leitfaden zu Screaming Frog erklärt die Einrichtung Schritt für Schritt.
Screaming Frog SEO Spider, der Desktop-Crawler, der jede URL einer Website mit Statuscode und Anweisungen auflistet.
Starten Sie den Crawl von Ihrer Startseite und von Ihrer Sitemap aus und vergleichen Sie danach beide Listen. Jede URL, die nur in einer der beiden Listen steht, wirft eine Frage auf. Stellen Sie den Crawler so ein, dass er die robots.txt wie der Googlebot respektiert, und lassen Sie JavaScript rendern, wenn Ihre Website davon abhängt. Ein Crawl, der Ihre Seiten nicht rendert, übersieht Inhalte, die Nutzer sehen.
Statuscodes und Weiterleitungsketten
Filtern Sie zuerst nach 4xx- und 5xx-Antworten. Ein 404-Fehler ist an sich kein Problem. Er wird zu einem, wenn interne Links noch auf ihn zeigen, weil diese Links Nutzer und Crawler in eine Sackgasse schicken. Finden Sie die internen Links, die zu Fehlerseiten führen, und richten Sie sie auf eine funktionierende URL. Prüfen Sie dann die Weiterleitungsketten: Eine alte URL leitet auf eine zweite weiter, die auf eine dritte weiterleitet. Jeder Sprung kostet Ladezeit und verwässert das Signal. Glätten Sie jede Kette, sodass die alte URL direkt auf das Ziel zeigt.
Prüfen Sie auch den Typ der Weiterleitung. Eine temporäre 302 für einen dauerhaften Umzug sollte eine 301 sein. Unser Leitfaden 301 vs. 302 nennt die Entscheidungsregel.
Robots-Anweisungen, noindex und Canonicals
Drei Einstellungen können eine Seite unbemerkt verbergen. Eine Disallow-Regel in der robots.txt stoppt das Crawling. Ein noindex-Meta-Tag oder ein X-Robots-Tag im HTTP-Header stoppt die Indexierung. Ein Canonical-Tag, das auf eine andere URL zeigt, sagt Suchmaschinen, welche Version behalten werden soll. Prüfen Sie jede dieser Einstellungen für jeden Seitentyp, denn eine Regel, die einen Bereich repariert, blockiert oft einen anderen. Ein häufiger Fall: eine Staging-Regel, die nie aus der Live-robots.txt entfernt wurde.
Warnung
Eine Seite in der robots.txt zu blockieren ist nicht dasselbe wie sie aus der Suche zu entfernen. Kann Google die Seite nicht crawlen, kann es auch kein noindex-Tag auf ihr lesen. Um eine Seite aus dem Index zu nehmen, erlauben Sie das Crawling, setzen noindex und warten, bis Google sie erneut crawlt.
Verwaiste Seiten und Klicktiefe
Eine verwaiste Seite hat keinen internen Link, der auf sie zeigt. Crawler finden sie nur über die Sitemap oder über einen externen Link, und Nutzer finden sie fast nie. Um verwaiste Seiten zu erkennen, vergleichen Sie drei Listen: die URLs, die der Crawler über Links erreicht hat, die URLs in Ihrer Sitemap und die URLs, die in Ihrer Analysesoftware Besuche bekommen. Eine Seite, die in der Sitemap steht oder Besuche erhält, aber keinen internen Link eingehend hat, ist ein Kandidat für eine verwaiste Seite.
Messen Sie außerdem die Klicktiefe, also die Zahl der Klicks von der Startseite aus. Eine wichtige Seite, die fünf oder sechs Klicks tief vergraben ist, erhält wenig Crawl-Aufmerksamkeit und wenige interne Links. Verlinken Sie sie von einer passenden Übersichtsseite, und sorgen Sie dafür, dass diese Übersichtsseite selbst flach liegt.
Titles, Beschreibungen und Duplikate
Filtern Sie nach fehlenden Titles, doppelten Titles, doppelten Meta-Beschreibungen und Titles, die in den Suchergebnissen nicht vollständig angezeigt werden. Duplikate entstehen fast immer durch eine Vorlage, nicht durch einen Redakteur. Eine Produktvorlage, die für jede Variante denselben Title ausgibt, erzeugt Hunderte Duplikate, und eine Korrektur der Vorlage behebt alle auf einmal. Betrachten Sie das Title-Tag als starken Hinweis an Google, nicht als Garantie. Google schreibt es manchmal um, was ein weiterer Grund ist, es präzise und exakt zu halten.
Server-Logs schließen den Kreis des Crawls. Sie zeigen, welche URLs der Googlebot angefragt hat, wie oft und mit welchen Statuscodes. Wenn Sie Zugang haben, vergleichen Sie diese Anfragen mit Ihrer Sitemap. Seiten, die der Googlebot ständig aufruft, aber die keinen Wert bringen, sind ein Zeichen für verschwendetes Crawl-Budget, das in unserem Glossareintrag zum Crawl-Budget erklärt wird.
Schritt 2: Indexierung, was Google behält und warum
Der Bericht „Seitenindexierung“ in der Search Console listet die URLs, die Google kennt, und den Status, den Google jeder vergibt. Öffnen Sie ihn und sortieren Sie nach Grund, nicht nach Anzahl. Jeder Grund verlangt eine andere Lösung. Die eigenen Definitionen Googles aus der Search-Console-Hilfe zu Indexierungsstatus sind die Referenz für die folgenden Bezeichnungen.
Status im Bericht
Was er bedeutet
Was zu tun ist
Gefunden, derzeit nicht indexiert
Google hat die URL gefunden, sie aber noch nicht gecrawlt und den Crawl verschoben, weil es die Website für überlastet hielt
Serverantwortzeiten und Klicktiefe der URL prüfen. Sicherstellen, dass interne Links auf sie zeigen
Gecrawlt, derzeit nicht indexiert
Google hat die Seite gecrawlt und entschieden, sie nicht zu indexieren. Google indexiert nicht jede Seite im Web
Zuerst die Qualität prüfen: dünner Inhalt, fast gleiche Seiten, schwache interne Links. Für die wichtigen Seiten die URL-Prüfung nutzen
Durch robots.txt blockiert
Der Googlebot darf die URL nicht crawlen
Prüfen, ob die Sperre beabsichtigt ist. Entfernen, wenn die Seite ranken soll
Durch Tag „noindex“ ausgeschlossen
Die Seite trägt eine noindex-Anweisung
Anweisung entfernen, wenn die Seite ranken soll. Sie auf Seiten belassen, die draußen bleiben sollen, etwa interne Suchergebnisse
Eine praktische Regel: Wenn ein ganzer Seitentyp einen hohen Anteil an „Gecrawlt, derzeit nicht indexiert“ hat, schauen Sie sich zuerst die Vorlage an, bevor Sie die Artikel prüfen. Dünne Vorlagen erzeugen dünne Seiten, und die Korrektur eines einzelnen Artikels ändert das Muster nicht. Unser Leitfaden zum Status „Gecrawlt, derzeit nicht indexiert“ behandelt die Ursachen im Detail.
Verwenden Sie bei den wichtigen Seiten die URL-Prüfung, jeweils eine URL nach der anderen. Sie zeigt das letzte Crawl-Datum, ob die Seite indexiert ist und welche Canonical-URL Google gewählt hat. Wenn die gewählte Canonical nicht die ist, die Sie angegeben haben, liegt die Ursache fast immer in Duplikaten oder widersprüchlichen Signalen, etwa einem Canonical, das auf eine weitergeleitete URL zeigt, oder internen Links, die eine Version mit Parametern bevorzugen.
Schritt 3: Suchdaten, wo die Chancen liegen
Der Bericht „Leistung“ in der Search Console ist der nützlichste kostenlose Datensatz für einen Audit. Standardmäßig zeigt er die letzten drei Monate, was für einen Trend zu kurz ist. Exportieren Sie mindestens 90 Tage Abfrage- und Seitendaten und speichern Sie die Datei mit Datum, damit Sie sie beim nächsten Audit vergleichen können. Gruppieren Sie die Tabelle nach Seite und nach Abfrage, und nutzen Sie die Filter für Land und Gerät, wenn die Website mehrere Märkte bedient.
Google Search Console, die Quelle der Abfrage-, Seiten- und Indexierungsdaten, die im Audit genutzt werden.
Vier Analysen decken den größten Teil der Chancen in diesen Daten auf.
Reichweite zum Aufstieg. Suchanfragen, für die Ihre Seite zwischen Position 8 und 20 mit echten Impressionen rankt. Diese Seiten haben bereits Relevanz. Oft brauchen sie einen besseren Title, mehr Tiefe zur Anfrage oder ein paar interne Links von verwandten Seiten, keine Neuschreibung.
Verlust. Seiten, deren Klicks zwischen zwei gleich langen Zeiträumen gesunken sind. Vergleichen Sie die letzten 90 Tage mit den 90 Tagen davor. Schauen Sie zuerst auf die Seite und dann auf die Anfragen, die sie verloren hat, denn eine Seite kann ihre Position halten, während ein neues Suchmerkmal ihre Klicks abzieht.
Kannibalisierung. Suchanfragen, bei denen zwei oder mehr Ihrer URLs erscheinen und sich von Woche zu Woche die Positionen teilen. Wählen Sie eine Zielseite für die Anfrage und führen Sie die schwächere Seite darin zusammen, oder machen Sie die beiden Seiten nach Suchintention klar unterscheidbar.
CTR-Lücken. Seiten, die eine normale Position halten, aber weniger Klicks erhalten als vergleichbare Seiten. Vergleichen Sie die Klickrate mit dem Durchschnitt für diese Position und schreiben Sie dann Title und Beschreibung der schwachen Seiten um.
Um einen Seitentyp zu isolieren, fügen Sie einen Seitenfilter mit einem regulären Ausdruck hinzu. Um zum Beispiel nur die Blogseiten zu sehen, die auf Anleitungsanfragen zielen, geben Sie diese zwei Werte ein:
Die Klickrate hängt stark vom oberen Bereich der Ergebnisseite ab. Einige veröffentlichte Zahlen helfen Ihnen zu beurteilen, ob eine Lücke echt ist. In einer Studie zu Klickraten bei Google erhielt das erste organische Ergebnis 27,6 % der Klicks, die ersten drei zusammen 54,4 %, und Ergebnisse auf der zweiten Seite 0,63 %.
Warum Platz eins so viel zählt
27,6 %der Klicks gehen an das erste organische Ergebnis
54,4 %der Klicks gehen an die ersten drei Ergebnisse zusammen
0,63 %der Klicks gehen an Ergebnisse auf der zweiten Seite
Quelle: Backlinko, Studie zu Klickraten bei Google (backlinko.com/google-ctr-stats)
Nutzen Sie diese Durchschnittswerte als Plausibilitätscheck, nicht als Ziel. Sie mischen alle Arten von Anfragen, und Ihre eigenen Zahlen hängen von der Suchintention, von Markenbegriffen und von Elementen über Ihrem Ergebnis ab, etwa Videos, Bilder oder KI-Antworten. Vergleichen Sie jede Seite mit Seiten Ihrer Website, die für ähnliche Anfragen ranken.
Die folgenden Schwellenwerte sind Ausgangspunkte, mit denen wir die Daten sortieren. Es sind keine Google-Regeln. Passen Sie sie an die Größe Ihrer Website und das Volumen Ihrer Anfragen an.
Prüfung
Ausgangsschwelle (unsere Faustregel)
Warum sie wichtig ist
Reichweite zum Aufstieg
Durchschnittliche Position 8 bis 20, mindestens 50 Impressionen in 90 Tagen
Die Nachfrage ist da, und die Seite ist nah genug, um aufzusteigen
Verlust
Klicks um 30 % oder mehr gesunken zwischen zwei gleich langen Zeiträumen
Genug Traffic verloren, um eine Überprüfung zu rechtfertigen
Dünner Inhalt
Unter 300 Wörter Fließtext, ohne Navigation und wiederkehrende Bausteine
Oft zu wenig, um die Anfrage zu beantworten. Eine kurze Tool-Seite kann trotzdem richtig sein, prüfen Sie also die Intention
Interne Links
Weniger als 3 eingehende interne Links von indexierbaren Seiten
Ein schwaches Zeichen für Wichtigkeit und ein häufiges Anzeichen für eine verwaiste Seite
Die Search-Console-Daten liefern außerdem eine zweite Prüfung: die Anfragen, für die Sie ranken, aber die Sie nie gezielt angesprochen haben. Das sind oft die einfachsten Ergänzungen für eine bestehende Seite, denn die Relevanz ist durch die Impressionen bereits belegt.
Schritt 4: Core Web Vitals und Mobile
Die Dokumentation zu den Core Web Vitals von Google definiert drei Messgrößen für die Nutzererfahrung und ihre Schwellenwerte. Eine Seite ist im Bereich „gut“, wenn ihr Largest Contentful Paint bei 2,5 Sekunden oder weniger liegt, ihr Interaction to Next Paint bei 200 Millisekunden oder weniger und ihr Cumulative Layout Shift bei 0,1 oder weniger. Der INP ist seit 2024 ein stabiler Core Web Vital und hat die First Input Delay abgelöst.
Metrik
Gut, wenn
Was sie misst
Übliche Lösung
LCP
2,5 Sekunden oder weniger
Wie schnell das größte sichtbare Element lädt
Das Hauptbild optimieren, die Serverantwortzeit verkürzen, die Schrift vorladen, die die Seite zuerst braucht
INP
200 Millisekunden oder weniger
Wie schnell die Seite auf Klicks, Tipps und Tastendrücke während des Besuchs reagiert
Lange JavaScript-Aufgaben aufteilen, schwere Drittanbieter-Skripte entfernen, beim Laden keinen Hauptthread blockieren
CLS
0,1 oder weniger
Wie stark sich Inhalte während des Ladens verschieben
Breite und Höhe von Bildern und Einbettungen festlegen, Platz für Banner und Werbung reservieren, spät ladende Elemente über dem sichtbaren Bereich vermeiden
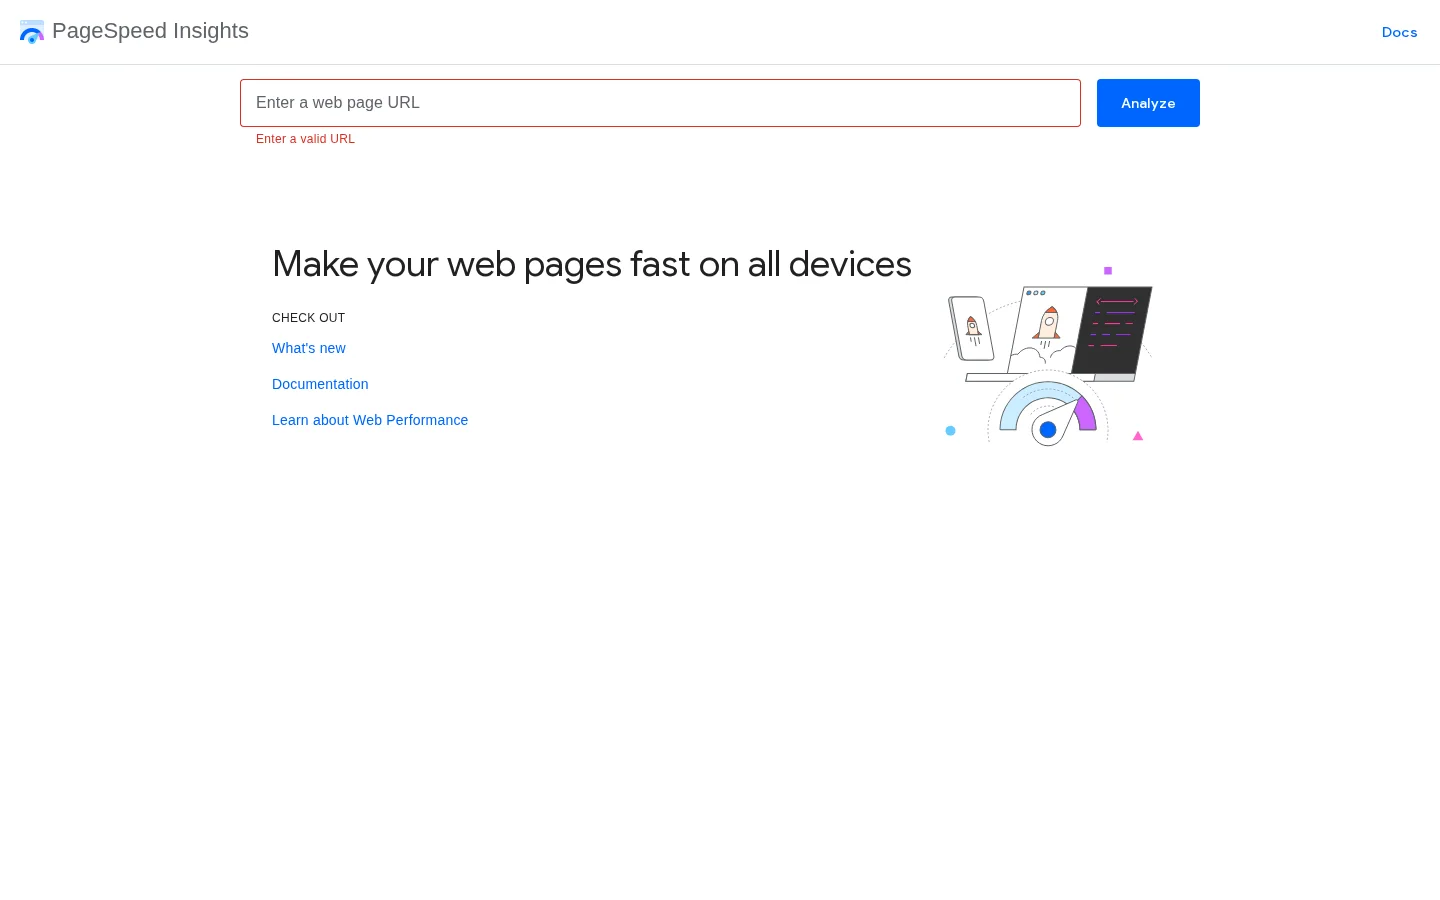
Lesen Sie die Felddaten vor den Labordaten. Felddaten stammen von echten Chrome-Nutzern und zeigen, ob Besucher tatsächlich leiden. Labordaten stammen aus einem simulierten Testlauf und erklären, warum eine Seite langsam ist. PageSpeed Insights zeigt beides: Felddaten, wenn Google für die URL genug Traffic hat, und Labordaten für jede getestete URL.
PageSpeed Insights, das Felddaten und Labordaten für jede beliebige URL anzeigt.
Testen Sie drei bis fünf URLs pro Vorlage, nicht nur die Startseite. Eine Produktvorlage, eine Kategorievorlage und eine Blogvorlage können auf derselben Website sehr unterschiedliche Werte haben, weil sie verschiedene Skripte laden. Ein guter Laborwert bei einem schlechten INP im Feld ist ein häufiges Ergebnis auf Websites mit schweren Tag-Managern und Chat-Widgets. In diesem Fall ist der Labortest nicht falsch, bildet aber die Interaktion nicht ab, die Nutzer nach dem Laden der Seite erleben.
Auf Mobilgeräten prüfen Sie drei Dinge. Der Hauptinhalt der mobilen Version sollte mit der Desktop-Version übereinstimmen, denn Google nutzt für die Indexierung hauptsächlich die mobile Version einer Seite. Strukturierte Daten und interne Links sollten auf beiden gleich sein. Und kein aufdringlicher Interstitial sollte beim Aufruf den Inhalt verdecken. Die Geschwindigkeit ist für das Ranking wichtig, der nützlichere Grund, sie zu verbessern, ist aber, dass langsame Vorlagen Besucher verlieren, bevor sie irgendetwas lesen.
Schritt 5: Inhalte auf der Seite und interne Links
Prüfen Sie für jede wichtige Seite den Title, die Überschriften, die Tiefe der Antwort, die ein- und ausgehenden Links und ob ein nahezu identisches Duplikat existiert. Tun Sie das für eine Stichprobe von Seiten jeder Vorlage und danach für die Seiten, die in den Suchdaten als Reichweite zum Aufstieg oder als Verlust auftauchen.
Prüfung
Bestanden, wenn
Nicht bestanden, wenn
Title-Tag
Nennt das Thema und die Hauptanfrage der Seite und ist auf der ganzen Website einzigartig
Dupliziert eine andere Seite oder ist ein Vorlagenstandard wie nur der Name der Website
H1
Eine pro Seite, nennt das Thema in klaren Worten
Fehlt, ist wiederholt oder wurde durch ein Logo oder einen Banner ersetzt
Erster Bildschirm
Die Frage der Suchanfrage wird nahe am Anfang beantwortet
Der erste Bildschirm besteht aus Kontext und Markentexten, und die Antwort kommt erst nach mehreren Scrolls
Tiefe
Behandelt die Teilfragen, die Menschen zum Thema stellen, mit konkreten Details
Dünn oder mit wiederholten Absätzen aufgebläht
Interne Links
Von verwandten Seiten verlinkt und führt zum nächsten logischen Schritt
Verwaist oder nur aus dem Footer oder der Sitemap verlinkt
Strukturierte Daten
Entsprechen dem Inhalt, den der Besucher auf der Seite sieht
Markieren Inhalte, die nicht auf der Seite stehen, oder verwenden den falschen Typ
Interne Links sind der günstigste Hebel im gesamten Audit. Ein Link von einer Seite, die bereits rankt, im Fließtext platziert und mit den Wörtern der Zielanfrage im Anker, überträgt sowohl Kontext als auch Autorität. Generische Anker wie „hier klicken“ oder „weiterlesen“ vermitteln sehr wenig Bedeutung. Arbeiten Sie sich bei den Seiten mit dem meisten Traffic vor, denn jeder neue Link von dort erreicht eine Seite mit echtem Publikum.
Doppelte und nahezu doppelte Inhalte verdienen einen eigenen Durchgang. Kategoriefilter, Sortierparameter und Tracking-Parameter erzeugen oft viele URLs, die dieselbe Liste zeigen. Entscheiden Sie, welche Version existieren soll, und setzen Sie dann das passende Canonical-Tag, die Robots-Regeln oder die Parameterbehandlung ein. Überlassen Sie diese Entscheidung nicht Google, denn das Ergebnis wird Ihnen wahrscheinlich nicht gefallen.
Tipp
Für einen ersten, schnellen Durchgang auf einer einzelnen Seite führt das kostenlose On-Page-SEO-Audit-Tool die gängigen Prüfungen zu Title, Überschriften, Links und Meta-Tags aus, damit Sie Ihre Zeit für die Befunde aufwenden, die ein Urteil erfordern.
Schritt 6: Autorität und Links
Die Prüfung des Linkprofils beantwortet drei Fragen: Gewinnen Sie verweisende Domains in einem gleichmäßigen Tempo, haben Sie wichtige Links verloren, und gibt es Muster, die manipuliert wirken? Exportieren Sie die verweisenden Domains im Zeitverlauf aus einem Backlink-Tool und suchen Sie nach plötzlichen Spitzen, die oft von einer bezahlten Kampagne oder von Spam stammen, und nach Einbrüchen, die oft von abgelaufenen Seiten oder einer Migration herrühren. Unser Leitfaden zum Backlink-Audit beschreibt die vollständige Prüfung.
Gehen Sie vorsichtig mit dem Disavow-Tool um. Googles eigene Empfehlung lautet, dass die meisten Websites es nicht brauchen. Nutzen Sie es, wenn Sie ein klares Muster von Links sehen, die Sie nicht verdient haben, und eine manuelle Maßnahme oder ein ernstes Problem damit zusammenhängt, nicht weil ein Backlink-Tool einigen Domains eine niedrige Bewertung gegeben hat. Gute Links versehentlich zu entwerten kostet mehr, als einige schlechte Links stehen zu lassen.
Schritt 7: KI-Sichtbarkeit und KI-Crawler
Zwei Prüfungen gehören inzwischen in jeden Audit. Die erste betrifft den Zugang: Können KI-Crawler Ihre Seiten erreichen? Prüfen Sie die robots.txt-Regeln für jeden Crawler, der für Sie wichtig ist. OpenAI nutzt GPTBot und OAI-SearchBot, Anthropic nutzt ClaudeBot und Perplexity nutzt PerplexityBot, und sie dienen nicht alle demselben Zweck. Eine einzige Regel für alle ist selten die richtige Entscheidung. Unser Leitfaden zu KI-Crawlern listet sie mit ihren Rollen auf.
Das obige Beispiel ist eine mögliche Entscheidung, keine Empfehlung für jede Website. Es lässt einen Crawler Ihre Seiten für Suchantworten lesen und blockiert einen anderen, der für das Training genutzt wird. Entscheiden Sie pro Crawler, halten Sie die Entscheidung schriftlich fest und prüfen Sie die Datei nach jedem Deployment, denn eine robots.txt, die alles blockiert, taucht nach einem Staging-Release oft auf.
Die zweite Prüfung betrifft die Sichtbarkeit: Nennen Antwortmaschinen Sie, wenn ein Käufer die Frage stellt, auf die Sie zielen? Erstellen Sie eine Liste von zehn bis zwanzig Prompts aus den echten Fragen in Ihren Suchdaten und aus Verkaufsgesprächen. Lassen Sie sie in ChatGPT, Perplexity und Gemini laufen, notieren Sie, welche Marken und welche URLs zitiert werden, und wiederholen Sie jeden Prompt mehrfach über einige Tage, denn Antworten ändern sich von Lauf zu Lauf. Die Methode des KI-Sichtbarkeits-Audits erklärt, wie Sie die Ergebnisse bewerten.
Audit-Methoden: welche zu Ihrer Situation passt
Audits unterscheiden sich nach Umfang und nach dem Punkt, an dem man beginnt. Fünf Methoden sind in der Praxis verbreitet. Jede passt zu einer anderen Situation, und die meisten Teams kombinieren zwei davon.
1. Der vollständige technische Audit
Prinzip: die gesamte Website abdecken, jeden Seitentyp und jede Datenquelle, dann die Befunde priorisieren. Einsetzen, wenn Sie eine Migration vorbereiten, nach einem starken Traffic-Einbruch oder beim ersten Audit einer großen Website. Vorteil: er findet strukturelle Probleme, die keine Prüfung einzelner Seiten sieht, etwa eine Facettennavigation, die URLs vervielfacht. Grenze: er ist langsam und erzeugt viele Befunde, die einen zweiten Durchgang zur Ordnung brauchen. Beispiel: Ein Händler mit 40000 Produkt-URLs stellt fest, dass ein einziger Filterparameter den größten Teil seiner Duplikate erzeugt, was keine Prüfung einzelner Produktseiten je aufgedeckt hätte.
2. Der datengetriebene Audit
Prinzip: Ausgangspunkt sind Veränderungen in den Suchdaten, dann werden nur die betroffenen Seiten und Anfragen diagnostiziert. Einsetzen, wenn Sie eine monatliche Überprüfung machen, wenn gerade ein Core-Update ausgerollt wurde oder wenn das Team klein ist. Vorteil: die Arbeit ist von der ersten Minute an nach Traffic priorisiert. Grenze: er ist blind für Seiten ohne Daten, etwa neue Bereiche oder Seiten, die von Anfang an blockiert waren. Beispiel: Ein Blog, der auf fünf Seiten Klicks verloren hat, prüft genau diese fünf Seiten, stellt fest, dass sich zwei gegenseitig kannibalisieren, und führt sie zusammen.
3. Der Audit auf Seitenebene
Prinzip: jede Prüfung für eine einzelne URL durchführen und dann entscheiden, ob sie umgeschrieben werden muss. Einsetzen, wenn eine einzelne wichtige Seite schwach performt oder vor einer geplanten Neufassung. Vorteil: schnell und konkret, mit klarem Vorher und Nachher. Grenze: er kann keine Muster zeigen, daher kann ein Fehler in einer Vorlage wie ein Einzelfall aussehen. Beispiel: Eine Produktseite mit gutem Title und gutem Inhalt hat ein Canonical, das auf eine nicht vorrätige Variante zeigt.
4. Die Analyse der Lücken zu Wettbewerbern
Prinzip: Ihre Seiten und Themen mit denen vergleichen, die für dieselben Anfragen vor Ihnen ranken. Einsetzen, wenn Sie neue Inhalte oder neue Links planen. Vorteil: sie zeigt, was der Markt in der Praxis belohnt, einschließlich Tiefe, Format und behandelter Teilfragen. Grenze: den Marktführer zu kopieren kann Sie in ein überfülltes Thema oder in die falsche Intention führen. Prüfen Sie, was die Top-Ergebnisse tatsächlich gemeinsam haben, bevor Sie entscheiden. Beispiel: Die fünf Top-Ergebnisse einer Anfrage beantworten alle eine Preisfrage schon im ersten Bildschirm, Ihre Seite nicht.
5. Der Audit der KI-Sichtbarkeit
Prinzip: prüfen, ob KI-Crawler Ihre Seiten lesen können und ob Antwortmaschinen Sie für die wichtigen Fragen zitieren. Einsetzen, wenn Sie wissen müssen, ob KI-Tools Ihre Marke empfehlen. Vorteil: er deckt einen Kanal ab, den klassische Rank-Tracker nicht zeigen. Grenze: Antworten schwanken von Lauf zu Lauf, daher muss die Stichprobe wiederholt werden, bevor man Schlüsse zieht. Beispiel: Ein Softwareunternehmen wird für eine Funktion zitiert, die es nicht mehr verkauft, was zeigt, dass seine Vergleichsseiten veraltet sind.
Methode
Ausgangspunkt
Ideal für
Hauptgrenze
Vollständiger technischer Audit
Das Crawling und alle Datenquellen
Migrationen, große Websites, starke Einbrüche
Langsam und ohne Plan schwer zu ordnen
Datengetriebener Audit
Veränderungen in den Suchdaten
Monatliche Überprüfungen, kleine Teams
Übersieht Seiten ohne Daten
Audit auf Seitenebene
Eine URL
Eine schwach performende Seite
Kann keine vorlagenweiten Muster erkennen
Analyse der Lücken zu Wettbewerbern
Die Ergebnisse über Ihnen
Neue Inhalte und neue Links
Gefahr, die falsche Intention zu kopieren
Audit der KI-Sichtbarkeit
Crawler-Zugang und Antwortmaschinen
Wissen, ob KI Sie empfiehlt
Antworten schwanken, Stichproben müssen wiederholt werden
Schnellaudit oder vollständiger Audit
Schnellaudit
Nur Suchdaten und die wichtigsten Vorlagen
Endet mit einer kurzen, priorisierten Liste
Übersieht strukturelle Probleme und Crawl-Probleme
Vollständiger Audit
Deckt jeden Seitentyp und jede Vorlage ab
Findet strukturelle Probleme und Crawl-Probleme
Langsam und leicht ohne Plan zu beenden
Unser Rat: Beginnen Sie mit dem Schnellaudit und wechseln Sie nur dann zum vollständigen Audit, wenn der Schnellaudit auf eine strukturelle Ursache hinweist oder wenn Sie die Architektur der Website ändern wollen.
Priorisieren: von den Befunden zu einem Plan
Ein Audit mit 400 Befunden und ohne Reihenfolge ist weniger wert als einer mit zehn. Bewerten Sie jeden Befund nach zwei Kriterien: wie viel Traffic oder Umsatz er gefährdet und wie aufwendig die Korrektur ist. Beginnen Sie mit den Punkten mit hoher Wirkung und geringem Aufwand. Danach kommen die Punkte mit hoher Wirkung, die mehr Arbeit machen, aber eine ganze Vorlage freischalten, denn eine einzige Korrektur dort ändert Tausende Seiten.
Befund
Gefährdeter Traffic
Aufwand
Priorität
Eine Vorlage verlinkt auf allen Seiten auf 404-Seiten
Hoch
Gering
Zuerst erledigen
Wichtige Seiten mit doppelten Titles
Hoch
Gering
Zuerst erledigen
Langsames LCP auf der Kategorievorlage
Hoch
Mittel
Im nächsten Sprint einplanen
Blogartikel mit Verlusten
Mittel
Mittel
Auffrischen nach Höhe der verlorenen Klicks
Verwaiste Glossarseiten
Gering
Gering
Mit der Arbeit am internen Linking bündeln
Tag-Archivseiten mit dünnem Inhalt
Gering
Mittel
Intention prüfen, dann noindex setzen oder zusammenlegen
Geben Sie jedem Punkt einen Verantwortlichen, ein Datum und die Kennzahl, die Sie bewegen wollen. Ein Befund ohne Verantwortlichen bleibt eine Notiz, und Notizen verändern keine Rankings. Messen Sie erneut, nachdem Google die betroffenen Seiten neu gecrawlt hat, was Wochen dauern kann, und vergleichen Sie mit dem Ausgangswert, den Sie am Anfang gespeichert haben. Wenn Sie die Ergebnisse präsentieren, bietet die Vorlage für SEO-Auditberichte eine Struktur, die Führungskräfte und Kunden in zehn Minuten lesen können.
Wenn Sie den Google- und den KI-Traffic während der Umsetzung dieser Maßnahmen an einem Ort verfolgen wollen, zeigt das GEO-/SEO-Dashboard von Sorank beides nebeneinander.
Ein SEO-Audit in 90 Minuten: was Sie in einer Sitzung abschließen können
Ein 90-minütiger SEO-Audit prüft die Seiten mit dem meisten Suchtraffic, in einer Reihenfolge, die echte Verluste zuerst sichtbar macht. Nutzen Sie ihn, wenn Sie eine Sitzung zur Verfügung haben und eine priorisierte Liste von Korrekturen brauchen, keine Durchsicht jeder URL. Beschränken Sie die Arbeit auf Ihre wichtigsten Seiten und eine Beispiel-URL pro Vorlage, dann ist das Ergebnis noch am selben Tag verwertbar.
Teilen Sie die Sitzung in feste Blöcke auf und beenden Sie jeden Block, sobald seine Zeit abgelaufen ist. Die Zeitbegrenzung gehört zur Methode, weil sie Sie zu Entscheidungen zwingt.
Minuten
Aufgabe
Ergebnis
0 bis 10
90 Tage Abfrage- und Seitendaten aus der Search Console exportieren und die 20 Seiten mit den meisten Klicks auflisten
Eine gespeicherte Ausgangsbasis und eine Seitenauswahl
10 bis 25
Die Prüfungen auf Reichweite zum Aufstieg und Verlust aus Schritt 3 auf diese Auswahl anwenden
Seiten, die Klicks verloren haben oder zwischen Position 8 und 20 liegen
25 bis 40
Eine Beispiel-URL pro Vorlage crawlen und Statuscode, Canonical sowie Robots-Anweisungen prüfen
Fehler, falsche Canonicals und Blockaden, je Vorlage
40 bis 55
Den Bericht „Seiten“ in der Search Console öffnen und die Gründe nach Anzahl sortieren
Der Status, der die meisten Seiten betrifft
55 bis 70
PageSpeed Insights für eine URL pro Vorlage ausführen und zuerst die Felddaten lesen
Die Vorlage mit dem schwächsten LCP oder INP im Felddaten-Bereich
70 bis 90
Die zehn wichtigsten Befunde mit gefährdetem Traffic, Aufwand und Verantwortlichem notieren
Ein priorisierter Plan, den Sie noch am selben Tag verschicken können
Jede Zeile beantwortet eine Frage, daher können Sie eine Zeile überspringen, ohne die anderen zu verlieren. Zeigt der Indexierungsbericht nichts Ungewöhnliches, nutzen Sie die Zeit lieber für die Suchdaten, die meist der schnellere Weg zu einer Korrektur sind.
Was ein 90-Minuten-Audit nicht sehen kann
Eine Zeitbegrenzung blendet drei Dinge aus. Sie übersieht strukturelle Probleme, etwa einen Filter, der URLs vervielfacht, weil Sie nur Stichproben lesen. Sie nutzt keine Server-Logs, daher sehen Sie nicht, wie oft Crawler eine Seite abrufen. Und sie lässt das Linkprofil aus, das einen vollständigen Export aus einem Backlink-Tool erfordert. Notieren Sie diese Punkte als offene Fragen für ein späteres Backlink-Audit oder eine vollständige Prüfung, damit der kurze Audit nicht vollständiger wirkt, als er ist.
Fehler, die eine kurze Sitzung verschwenden
Der häufigste Fehler ist, mit dem Crawler zu beginnen. Ein Crawl eines großen Sites kann länger dauern als die ganze Sitzung und mehr Warnungen liefern, als jemand lesen kann. Beginnen Sie stattdessen mit den Suchdaten und öffnen Sie den Crawler nur für Seiten mit Klicks oder Impressionen. Beheben Sie zuerst die Warnungen auf diesen Seiten, denn Warnungen auf Seiten, die niemand besucht, ändern Ihren Traffic nicht.
Tipp
Tragen Sie die Sitzung mit einem Timer und einer einzigen Ausgabedatei in Ihren Kalender ein. Verwenden Sie von Anfang an die Spalten der Vorlage für SEO-Auditberichte, damit die Liste zur 90. Minute versandfertig ist.
Häufige Fehler, und wie Sie sie erkennen und beheben
Die meisten Audits enthalten dieselben Fehler. Sie lassen sich leicht vermeiden, sobald Sie die Anzeichen kennen.
Ohne Umfang prüfen
Was es ist: Der Audit deckt alles ab, daher wird nichts fertig. Woran Sie es erkennen: Der Bericht enthält Hunderte Probleme, keines mit einer Traffic-Zahl oder einem Verantwortlichen. Wie Sie es beheben: Beginnen Sie neu mit der präzisen Vorgabe aus dem ersten Abschnitt, begrenzen Sie das Crawling auf die wichtigen Seitentypen und sortieren Sie die Befunde nach Traffic, bevor Sie irgendetwas anderes schreiben.
Warnungen für Rankings halten
Was es ist: Das Team behebt die Warnungen, die das Tool rot markiert, auch wenn sie Seiten betreffen, die niemand besucht. Woran Sie es erkennen: Die Zahl der Warnungen sinkt, während die Klicks auf die wichtigen Seiten weiter fallen. Wie Sie es beheben: Verbinden Sie das Crawl mit den Suchdaten und beheben Sie zuerst die Probleme auf Seiten mit Traffic, Impressionen oder Links.
Einen einzelnen Crawl als Wahrheit nehmen
Was es ist: Der Crawler meldet keine Fehler, also schließt das Team, dass die Website gesund ist. Woran Sie es erkennen: Die Search Console meldet viele URLs als „Gecrawlt, derzeit nicht indexiert“ oder „Gefunden“, die der Crawler nie markiert hat. Wie Sie es beheben: Vergleichen Sie den Crawl mit der Sitemap, dem Indexierungsbericht und den Server-Logs. Ein Crawler sieht nur, was er über Links und Rendering erreichen kann, daher können Inhalte hinter Logins, Skripten oder Facettenfiltern in seiner Liste fehlen.
Seiten statt Vorlagen korrigieren
Was es ist: Das Team bearbeitet denselben Title, dasselbe Bild oder dasselbe Canonical auf Hunderten Seiten, eine nach der anderen. Woran Sie es erkennen: Derselbe Befund taucht auf den meisten URLs eines Seitentyps auf. Wie Sie es beheben: Korrigieren Sie die Vorlage einmal und prüfen Sie dann eine Stichprobe von Seiten, um zu bestätigen, dass die Änderung überall gewirkt hat. Eine einzige Vorlagenänderung behebt die ganze Gruppe.
Eine Seite blockieren, um sie aus der Suche zu entfernen
Was es ist: Das Team setzt ein Disallow in der robots.txt für eine Seite, die aus Google verschwinden soll. Woran Sie es erkennen: Die Seite bleibt im Index, mit einer nackten URL und ohne Snippet, und der Bericht zeigt sie als blockiert. Wie Sie es beheben: Erlauben Sie das Crawling, setzen Sie eine noindex-Anweisung und warten Sie, bis Google die Seite erneut crawlt. Sobald sie aus dem Index gefallen ist, können Sie sie bei Bedarf blockieren, aber Sie müssen es nicht.
Beispiel (veranschaulicht)
Stellen Sie sich eine Website vor, die eine Reihe von Kampagnenseiten abgeschaltet und in der robots.txt blockiert hat. Die Seiten erscheinen weiterhin in der Suche, mit einer nackten URL und ohne Beschreibung, weil andere Websites noch auf sie verlinken. Wenn Sie die Sperre entfernen und noindex setzen, kann Google die Seiten crawlen, die Anweisung lesen und sie aus dem Index nehmen.
Einem perfekten Laborwert nachjagen
Was es ist: Das Team optimiert auf einen Wert von 100 im Labortest und ignoriert die Felddaten. Woran Sie es erkennen: Der Laborwert ist hoch, aber der Felddaten-INP derselben Vorlage ist im Core-Web-Vitals-Bericht der Search Console schlecht. Wie Sie es beheben: Analysieren Sie die Interaktionen, die echte Nutzer tatsächlich ausführen, meist nachdem die Seite geladen ist. Suchen Sie nach langen Aufgaben, die durch Skripte ausgelöst werden, und nicht nach der Ladezeit des ersten Bildaufbaus.
Wie oft Sie einen Audit durchführen sollten
Führen Sie jeden Monat einen Schnellaudit anhand der Suchdaten und Ihrer wichtigsten Vorlagen durch. Einen vollständigen Audit sollten Sie nach einer Migration, einem Relaunch, einem CMS-Wechsel oder einem plötzlichen Traffic-Einbruch durchführen, und einmal im Jahr eine vollständige Überprüfung, um strukturelle Abweichungen zu erkennen. Die Suchdaten sollten dauerhaft beobachtet werden, denn ein Klickrückgang ist als Alarm nützlicher als als Kalendererinnerung.
Website-Audit: ein wiederholbarer Gesundheitscheck für die gesamte Domain
Ein Website-Audit ist ein Crawl jeder erreichbaren URL einer Domain, aufgeschlüsselt nach Problemtyp und Schweregrad. Er zeigt, was auf der gesamten Website kaputt ist, einschließlich Mustern, die eine Prüfung Seite für Seite übersieht. Er sagt nicht, welche Korrektur die Rankings verbessert, also kombinieren Sie ihn mit den Suchdaten.
Den Crawl-Umfang vor dem Start festlegen
Filter, Sortieroptionen und Tracking-Parameter können weit mehr URLs erzeugen, als Seiten existieren, und die meisten zeigen dieselbe Liste. Schließen Sie diese Parameter und Mediendateien aus und crawlen Sie jede Subdomain als eigenes Projekt. Halten Sie die Anfragerate niedrig, damit der Server für echte Besucher schnell bleibt. Lassen Sie die Paginierung (page=) im Umfang, denn paginierte Listen können Seiten enthalten, die indexiert werden sollen.
Die meisten Crawler akzeptieren Ausschlussregeln, die als reguläre Ausdrücke geschrieben sind, wie diese. Testen Sie sie an einem kurzen Crawl und prüfen Sie, ob die Anzahl der URLs nur bei den Parametern sinkt, die Sie ausschließen wollten.
Erst den Schweregrad lesen, dann den Score
Jedes Tool ordnet Probleme in Stufen ein und berechnet seinen eigenen Gesundheitsscore. Die Bezeichnungen unterscheiden sich, die Logik der Priorisierung aber nicht. Ein Score ist eine Trendlinie für ein Tool mit festen Einstellungen, keine Note, die Google vergibt. Arbeiten Sie die Stufen in dieser Reihenfolge ab:
Stufe
Typische Probleme
Erste Maßnahme
Fehler auf indexierbaren Seiten
4xx- oder 5xx-Antworten auf URLs, die ranken sollen, defekte interne Links
Zuerst beheben, beginnend mit den Seiten, die bereits Klicks bringen
Fehler auf Seiten, die nicht indexiert werden sollen
Defekte interne Suche, Filter- oder abgelaufene Kampagnen-URLs
Interne Links entfernen, die noch auf sie zeigen
Warnungen
Zu lange Title-Tags, fehlende Meta-Descriptions, doppelte Zwischenüberschriften
Stapelweise beheben, idealerweise mit einer einzigen Template-Änderung
Hinweise
Kleine Optimierungsvorschläge
Einmal prüfen und nur handeln, wenn sie auf umsatzrelevanten Seiten wiederkehren
Zwei Crawls vergleichen, nicht zwei Scores
Das nützlichste Ergebnis eines Website-Audits ist der Unterschied zwischen zwei Läufen. Exportieren Sie die Problemliste des letzten Laufs, crawlen Sie mit denselben Einstellungen erneut und vergleichen Sie die Anzahl nach Problemtyp und nach URL. Neue Probleme kommen zuerst, denn ein neuer Fehler auf einer Live-Seite folgt meist auf ein kürzliches Release. Gleichen Sie jeden neuen Cluster mit Ihrem Änderungsprotokoll ab, bevor Sie einen Verantwortlichen zuweisen.
Zum Beispiel meldet der erste Lauf 42 Fehler. Der zweite, vier Wochen später, meldet 57, und 15 der neuen liegen auf einer Preisseiten-Vorlage, die in dieser Woche live ging. Sie korrigieren die Vorlage einmal. Sinkt die Zahl wieder Richtung 42, hat die Korrektur gewirkt, und dieser Lauf wird zur Ausgangsbasis für den nächsten.
Die Routine kurz genug halten, um sie zu wiederholen
Ein Website-Audit, der einen ganzen Tag dauert, wird nicht wiederholt. Speichern Sie Umfang, Ausschlussregeln und Schweregrad-Tabelle als eine Konfiguration, damit der nächste Lauf nur Minuten braucht. Planen Sie den Crawl und exportieren Sie jedes Mal dieselben drei Dateien: die Problemliste, die indexierbaren URLs und die URLs, die Klicks erhalten. Unser Leitfaden zu automatisierten SEO-Berichten erklärt, was Sie automatisieren können und wie Sie es einrichten.
Wenn Sie noch einen Crawler auswählen, vergleicht unser Vergleich technischer SEO-Tools die Optionen nach ihrer Aufgabe. Ein Website-Audit lohnt sich als regelmäßiger Termin nur, wenn jemand den Unterschied zwischen den Läufen liest. Sonst ist er nur ein weiterer Export in einem Ordner.
Wo Sie diese Woche anfangen sollten
Wenn Sie noch nie einen Audit gemacht haben, erledigen Sie vier Dinge in dieser Reihenfolge. Exportieren Sie 90 Tage Search-Console-Daten und speichern Sie sie mit Datum. Crawlen Sie Ihre wichtigsten Vorlagen mit einem Crawler, bei einer kleinen Website mit der kostenlosen 500-URL-Version. Lesen Sie den Indexierungsbericht und sortieren Sie die Gründe. Beheben Sie dann die drei größten Probleme auf Vorlagenebene, die Sie gefunden haben, und messen Sie nach dem nächsten Crawl-Zyklus erneut.
Exportieren Sie die Abfrage- und Seitendaten und speichern Sie den Ausgangswert.
Crawlen Sie je eine Beispiel-URL pro Vorlage und notieren Sie Statuscodes, Titles, Canonicals und Robots-Anweisungen.
Lesen Sie den Indexierungsbericht und machen Sie aus jedem Status eine Frage mit einem Verantwortlichen.
Beheben Sie die drei größten Probleme auf Vorlagenebene und vergleichen Sie die Suchdaten nach dem nächsten Crawl-Zyklus.
Ein guter Audit endet nicht mit einem Dokument. Er endet mit einer kurzen Liste von Korrekturen, die jemand diesen Monat umsetzt, und einem Ausgangswert, der beweist, ob sie gewirkt haben.
Häufig gestellte Fragen
Wie lange dauert ein SEO-Audit?
Das hängt von der Größe der Website und davon ab, wie tief Sie gehen müssen. Ein fokussierter Audit Ihrer wichtigsten Vorlagen und Ihrer Suchdaten ist in wenigen Tagen erledigt. Ein vollständiger Audit einer großen Website mit vielen Vorlagen dauert länger, und der größte Teil der Zeit fließt in Diagnose und Priorisierung statt in das Crawling selbst.
Welche Tools brauche ich für einen SEO-Audit?
Mindestens die Google Search Console und einen Crawler wie Screaming Frog SEO Spider, dazu PageSpeed Insights für die Geschwindigkeit. Analysesoftware und Server-Logs liefern nützlichen Kontext. Kostenpflichtige SEO-Suiten helfen bei Backlinks und Wettbewerbsdaten, sind für einen ersten Audit aber nicht nötig.
Was ist der Unterschied zwischen einem SEO-Audit und einer SEO-Checkliste?
Eine Checkliste nennt die Prüfungen, die durchzuführen sind. Ein Audit führt diese Prüfungen auf Ihrer Website aus, entscheidet, welche Befunde wichtig sind, und ordnet die Korrekturen nach dem Traffic, der auf dem Spiel steht. Nutzen Sie eine Checkliste, um den Audit aufzubauen, und den Audit, um die Arbeit auszuwählen.
y!
Erhalten Sie kostenlos Ihren Content-Plan für 30 Tage
Wir analysieren Ihre Wettbewerber, Ihre Website und Ihre KI-Sichtbarkeit, um kostenlos einen maßgeschneiderten Content-Plan für Sie zu erstellen.
“Ich habe Sorank auf einer echten Kundenwebsite getestet, und es ist der Wahnsinn. Es macht alles, wofür eine Agentur 1.500 € im Monat berechnet. Jetzt geht es bei diesem Kunden in den Produktivbetrieb.”Guillaume Guersanguersanguillaume.com
“Wir sind eine Ads-Agentur und wollten unser SEO endgültig wieder auf Kurs bringen. Sorank hat uns eine klare Übersicht über unsere Website verschafft, uns geholfen, Optimierungen zu priorisieren und unsere Inhalte richtig zu strukturieren. Das Tool ist einfach zu bedienen, gut für ein Team konzipiert und sehr praktisch, um das Tracking zu zentralisieren, ohne zwischen mehreren Plattformen jonglieren zu müssen. Eine sehr solide Grundlage, um mit unserem SEO neu zu starten.”Gaspard MadouiWerbeagentur
“Ich habe mich dank Sorank auf GEO spezialisiert. Das GEO Leaderboard ermöglicht es mir, meinen Kunden ihre Position im Vergleich zu ihren Wettbewerbern auf ChatGPT zu zeigen. Das ist ein echter kommerzieller Differenzierungsfaktor.”MélanieFreelancer im Bereich SEO
“Hervorragender Service, funktioniert gut für unsere Website und hilft uns zu verstehen, wie wir sie verbessern können, um auf Google und anderswo besser zu ranken. Herzlichen Glückwunsch, machen Sie weiter, ich empfehle es.”Hugo T.E-Commerce-Händler