Jouw privacy is belangrijk voor ons, daarom kun je bepaalde soorten opslag uitschakelen die niet nodig zijn voor de basiswerking van de website. Het blokkeren van categorieën kan invloed hebben op je ervaring op de website. Meer informatie (Cookiebeleid)
Bedankt! Je aanmelding is ontvangen!
Oeps! Er ging iets mis bij het versturen van het formulier.
Een SEO-audit uitvoeren: een stapsgewijze methode die vindt wat verkeer kost
Een volledige SEO-audit in volgorde: crawlen, indexering, Search Console-data, Core Web Vitals en AI-zichtbaarheid, met de oplossingen die het verkeer doen bewegen.
Een notitieboek met een SEO-auditchecklist en uitgeprinte grafieken op een bureau.
Tools
Op deze pagina
Kort samengevat
Een SEO-audit is een gestructureerde controle van alles wat voorkomt dat je pagina's worden gecrawld, geïndexeerd, begrepen, aangeklikt en geciteerd. Doe hem in een vaste volgorde: crawlen, indexering, zoekdata, snelheid, on-pagecontent, links en daarna zichtbaarheid in AI. Beoordeel elke bevinding op het verkeer dat ze blokkeert, en zet de tien belangrijkste om in taken met een datum en een eigenaar. Een gerichte audit kun je in een paar dagen afronden. Een volledige audit van een grote site kost meer tijd, en het resultaat moet een plan zijn, geen lijst.
3 dagen gratis, daarna stop je wanneer je wilt. 90 dagen geld-terug-garantie, onder voorwaarden.
Wat een SEO-audit is, en wat niet
Een SEO-audit beantwoordt één vraag: welke technische, inhoudelijke en autoriteitsproblemen kosten je nu bezoekers, en in welke volgorde moet je ze oplossen? Het is geen opsomming van alle bestaande best practices. Een checklist van 40 punten vertelt je waar je naar moet kijken. Een audit vertelt je wat er op jouw site misgaat, hoe zwaar dat weegt en wat je als eerste moet doen.
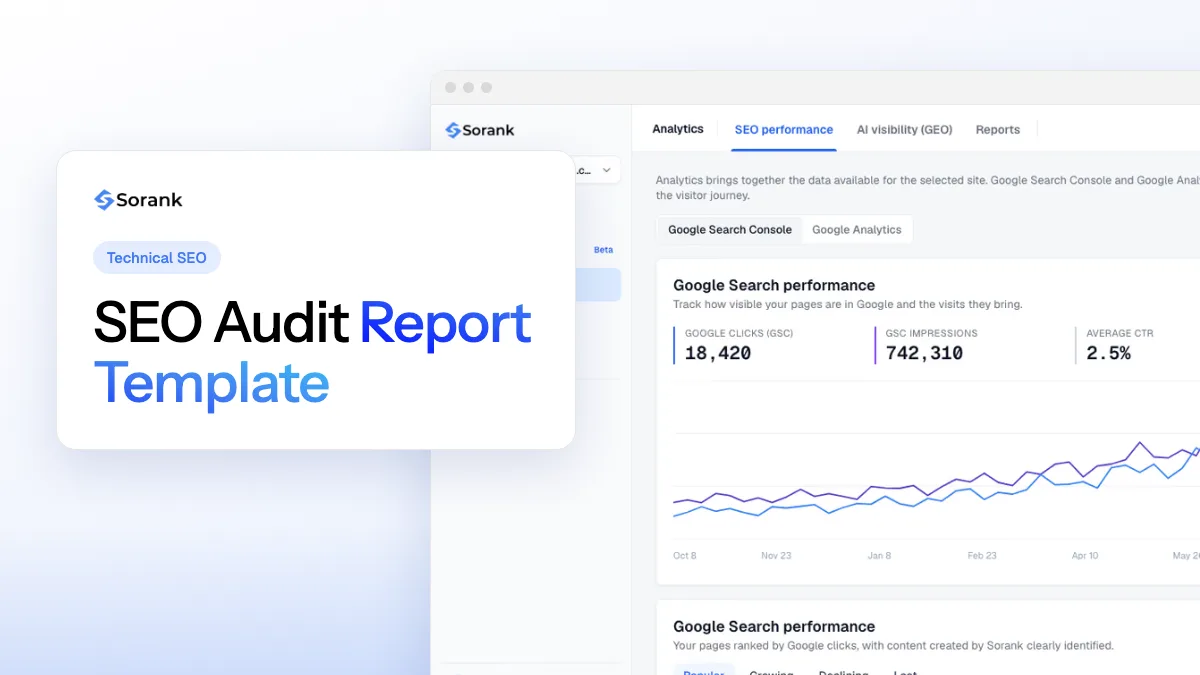
Drie dingen worden vaak door elkaar gehaald: de audit (de diagnose), de checklist (de lijst met controles) en het rapport (wat je aan een klant of manager overhandigt). Onze sjabloon voor een SEO-auditrapport gaat over het rapport, en de technische SEO-checklist over de controles. Dit artikel gaat over de methode die beide verbindt, en over de data die je nodig hebt om te bepalen wat ertoe doet.
Twee manieren om dezelfde audit op te dragen
Vage opdracht
Controleer de site op SEO-problemen
Resultaat: een lange lijst met waarschuwingen die niemand leest
Gerichte opdracht
Zoek de pagina's die de afgelopen 90 dagen klikken hebben verloren
Resultaat: tien oplossingen gerangschikt op het verkeer dat op het spel staat
Het verschil zit niet in de inspanning. Het zit in de vraag. Een gerichte opdracht noemt de pagina's, de periode en de beslissing, zodat elke controle een reden heeft.
Voordat je begint: toegang, scope en een nulmeting
De meeste audits lopen mis voordat de eerste crawl is gestart, omdat niemand de scope heeft afgesproken of een startpunt heeft opgeslagen. Regel drie dingen voordat je een tool opent.
Scope. Welke domeinen en subdomeinen, welke landen en talen, en welke paginatypen ertoe doen. Bij een webwinkel zijn dat de homepage, categorieën, productpagina's, de blog en eventuele landingspagina's. Schrijf ze op.
Toegang. Eigenaarstoegang tot Search Console voor elke property (http, https, www en zonder www, als die bestaan), leestoegang tot je analysetool, en toegang tot het CMS of de serverlogs als je die hebt. Serverlogs laten zien wat crawlers daadwerkelijk opvragen, iets wat geen crawlsimulatie kan tonen.
Nulmeting. Een momentopname van klikken, vertoningen, gemiddelde positie en de pagina's die de meeste klikken opleveren, opgeslagen in een spreadsheet met de datum erbij. Zonder die meting kun je niet aantonen dat een oplossing heeft gewerkt.
Voordat je iets crawlt
Eigenaarstoegang tot Search Console voor elke property bevestigen
90 dagen aan query- en paginadata exporteren en opslaan met de datum van vandaag
Je belangrijkste paginatypen opsommen, met één voorbeeld-URL per type
Het doel in één zin opschrijven: meer klikken op je geldpagina's, minder fouten, snellere templates
Je crawler en de limieten ervan kiezen (zie de crawlsectie hieronder)
Een audit bekijkt de hele structuur van een site voordat hij één pagina repareert.
De methode in volgorde: zeven fasen
De volgorde is belangrijk. Crawlen vertelt je wat er op je site bestaat. Indexering vertelt je wat Google bewaart. Zoekdata vertelt je wat mensen vinden en aanklikken. Snelheid, inhoud en links verklaren daarna waarom een pagina slecht presteert. Als je het omgekeerd doet, besteed je uren aan het herschrijven van een pagina die Google niet eens kan indexeren.
De zeven fasen van een SEO-audit
De site crawlenElke URL noteren met statuscode, title, canonical, robots-richtlijnen en interne links.
Indexering controlerenVergelijken wat je publiceert met wat Google indexeert, en de reden van elke uitsluiting lezen.
De zoekdata lezenDe pagina's en zoekopdrachten vinden die klikken winnen of verliezen, en die net onder de top van pagina één staan.
Snelheid en mobiel testenCore Web Vitals meten per template, te beginnen met veldgegevens van echte gebruikers.
On-pagecontent beoordelenTitles, koppen, diepgang, duplicatie en interne links controleren, pagina voor pagina en template voor template.
Autoriteit en links beoordelenVerwijzende domeinen in de tijd bekijken, verloren links, ankerteksten en spamsignalen.
AI-zichtbaarheid controlerenBevestigen dat AI-crawlers je pagina's kunnen bereiken, en testen of antwoordmachines je noemen.
SEO-controles vóór de audit: wat je moet bevestigen voordat je de data vertrouwt
SEO-controles vóór de audit bevestigen dat de site die je gaat auditen de site is die Google en je bezoekers zien, en dat je data betrouwbaar genoeg is om op te handelen. Besteed ongeveer een uur aan deze controles voordat je iets crawlt. Een verkeerde property, een stagingregel die live staat of kapotte tracking kan elke latere bevinding onjuist maken, en een crawl laat niets van dat zien.
Bevestigen welke versie van de site live staat
Vraag elke variant van je domein op: http, https, met en zonder www, met en zonder slash aan het eind. Elke variant hoort op hetzelfde eindadres uit te komen, idealiter na één redirect. Twee live versies verdelen links en signalen over elkaar, en een crawler meldt beide als gezond.
Lees de Location-header van elk antwoord. Die moet direct naar je voorkeursadres wijzen, niet naar een tweede redirect. Herhaal de controle op de homepage en op één diepe pagina, want redirectregels verschillen vaak per template.
Controleren dat geen testinstelling op de live site terecht is gekomen
Stagingsinstellingen zijn een van de meest voorkomende oorzaken van een plotselinge daling. Bekijk de live robots.txt, de meta robots-tag en de X-Robots-Tag-header op de homepage en op één artikel. Een disallow-regel voor de hele site, of een noindex die is blijven staan van een testbuild, kan secties voor zoekmachines verbergen, terwijl de pagina's voor bezoekers gewoon laden. Als je er een vindt, los hem dan op voordat je die secties auditeert, want elke latere bevinding zou een site beschrijven die Google niet kan zien.
Een wijzigingslogboek bijhouden voordat je een daling diagnosticeert
Schrijf een gedateerde lijst van elke release, redesign, CMS-update, migratie en wijziging aan robots.txt of noindex van de afgelopen zes maanden. Vergelijk die data daarna met het begin van elke verkeersverandering. Een daling die begint op de dag dat een template is uitgerold, wijst naar dat template. Een daling zonder wijziging in de buurt kan wijzen op een zoekupdate en vraagt om een andere controle. Zonder logboek geef je de schuld aan wat je als laatste hebt bekeken. Voor wijzigingen die URL's raken, somt de SEO-migratiechecklist op wat je moet vastleggen.
De data controleren waarop de audit steunt
Vergelijk de klikken in Search Console met de organische sessies in je analysetool over dezelfde 90 dagen. De twee lijnen hoeven niet samen te vallen, maar ze moeten wel in dezelfde richting bewegen. Als ze uiteenlopen, controleer dan de tags op belangrijke pagina's, de cookiebanner en de botfilter voordat je de site diagnosticeert. De vergelijking van de twee tools legt uit wat elk meet.
Fase 1: de site crawlen en repareren wat de crawler vindt
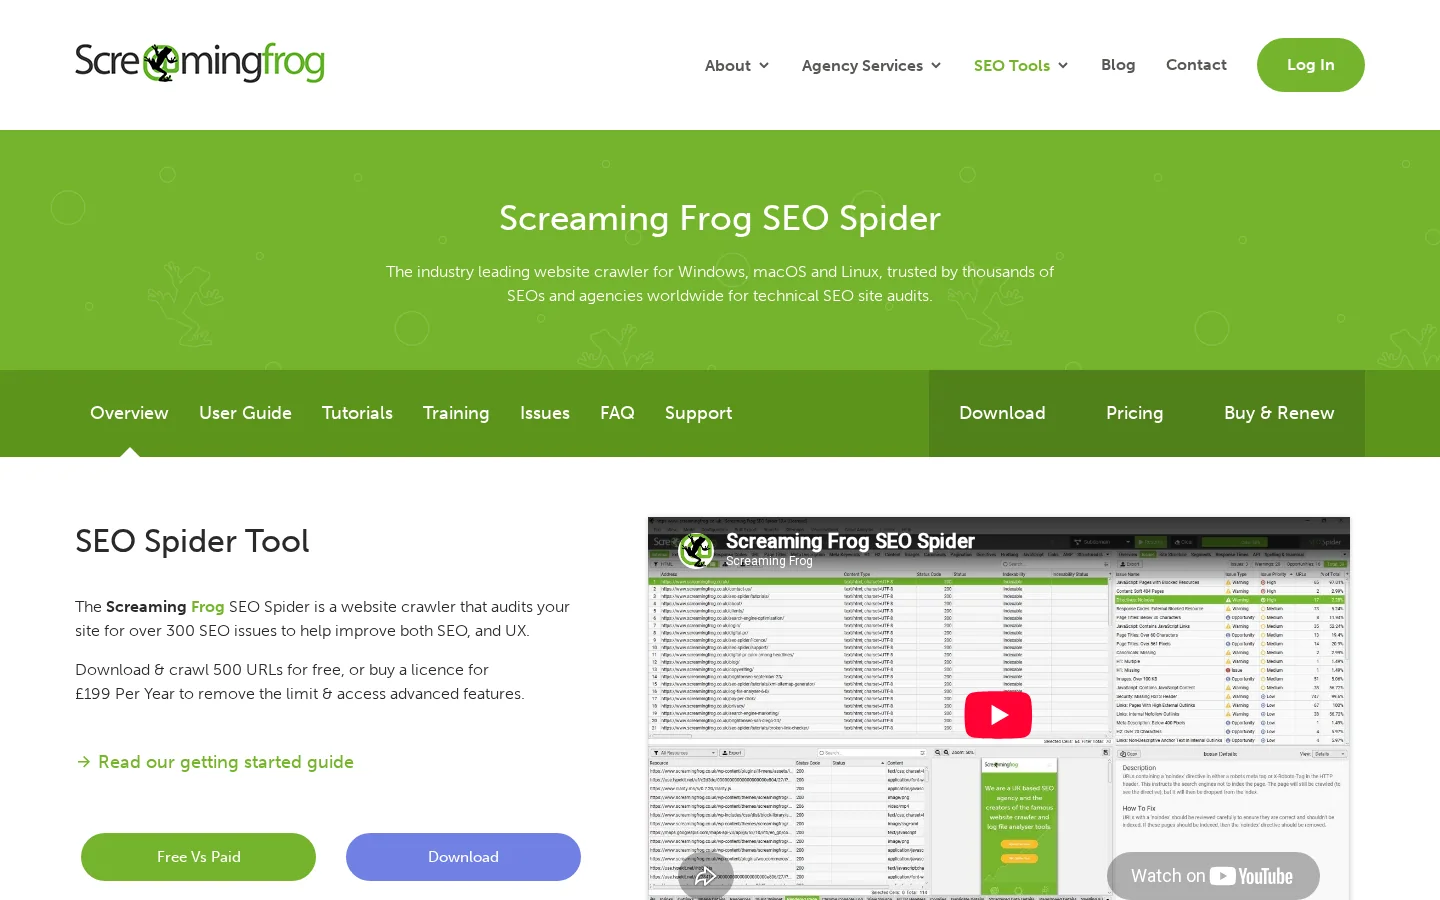
Een crawler doet op kleinere schaal wat Googlebot doet: hij start bij een pagina, volgt de links die hij vindt en registreert wat hij ziet bij elke URL. De tool die we in de meeste audits gebruiken is Screaming Frog SEO Spider. De gratis versie crawlt tot 500 URL's, wat genoeg is voor een kleine site of één sectie van een grote. Een betaalde licentie haalt de limiet weg. Onze Screaming Frog-gids loopt de installatie stap voor stap door.
Screaming Frog SEO Spider, de desktopcrawler die elke URL van een site toont met de statuscode en richtlijnen.
Start de crawl vanaf je homepage en vanaf je sitemap, en vergelijk daarna de twee lijsten. Elke URL die in de ene lijst staat en in de andere niet, is een vraag. Stel de crawler in zodat hij robots.txt respecteert zoals Googlebot dat doet, en laat hem JavaScript renderen als je site ervan afhankelijk is. Een crawl die je pagina's niet rendert, mist inhoud die gebruikers wel zien.
Statuscodes en redirectketens
Filter eerst op 4xx- en 5xx-antwoorden. Een 404 is op zichzelf geen probleem. Het wordt er een wanneer interne links er nog naar verwijzen, want die links sturen gebruikers en crawlers in een doodlopend pad. Zoek de interne links die naar foutpagina's leiden en wijs ze naar een werkende URL. Bekijk daarna de redirectketens: een oude URL stuurt door naar een tweede, die doorstuurt naar een derde. Elke sprong voegt latentie toe en verzwakt het signaal. Vlak elke keten af, zodat de oude URL rechtstreeks naar de eindbestemming wijst.
Controleer ook het type redirect. Een tijdelijke 302 voor een permanente verhuizing hoort een 301 te zijn. Onze gids 301 vs 302 geeft de beslisregel.
Robots-richtlijnen, noindex en canonicals
Drie instellingen kunnen een pagina verbergen zonder dat iemand het merkt. Een disallow-regel in robots.txt stopt het crawlen. Een noindex-metatag, of een X-Robots-Tag in de HTTP-header, stopt het indexeren. Een canonical-tag die naar een andere URL verwijst, vertelt zoekmachines welke versie ze moeten houden. Controleer elk van die instellingen voor elk paginatype, want een regel die één sectie repareert, blokkeert vaak een andere. Een veelvoorkomend geval: een stagingregel die nooit uit de live robots.txt is verwijderd.
Waarschuwing
Een pagina blokkeren in robots.txt is niet hetzelfde als haar uit de zoekresultaten halen. Als Google de pagina niet kan crawlen, kan het ook geen noindex-tag lezen die erop staat. Om een pagina uit de index te krijgen, laat je het crawlen toe, voeg je noindex toe en wacht je tot Google haar opnieuw crawlt.
Wezenloze pagina's en kliekdiepte
Een wezenloze pagina heeft geen interne link die ernaar verwijst. Crawlers vinden haar alleen via de sitemap of via een externe link, en gebruikers vinden haar bijna nooit. Om wezen te herkennen, vergelijk je drie lijsten: de URL's die de crawler via links heeft bereikt, de URL's in je sitemap, en de URL's die bezoekers krijgen in je analysetool. Een pagina die in de sitemap staat of bezoekers krijgt, maar geen interne inkomende links heeft, is een kandidaat-wees.
Meet ook de kliekdiepte, dat wil zeggen het aantal klikken vanaf de homepage. Een belangrijke pagina die vijf of zes klikken diep ligt, krijgt weinig crawlaandacht en weinig interne links. Link haar vanaf een relevante hubpagina, en zorg dat die hub zelf ondiep ligt.
Titles, beschrijvingen en duplicaten
Filter op ontbrekende titles, dubbele titles, dubbele meta-beschrijvingen en titles die te lang zijn om volledig in de zoekresultaten te tonen. Duplicaten komen bijna altijd uit een template, niet van een schrijver. Een producttemplate dat voor elke variant dezelfde title uitvoert, maakt honderden duplicaten, en het repareren van het template lost ze allemaal tegelijk op. Beschouw de titletag als een sterke suggestie voor Google, niet als garantie. Google herschrijft hem soms, wat een extra reden is om hem nauwkeurig en specifiek te houden.
Serverlogs sluiten de crawl af. Ze laten zien welke URL's Googlebot heeft opgevraagd, hoe vaak, en welke statuscodes hij kreeg. Als je er toegang toe hebt, vergelijk die verzoeken dan met je sitemap. Pagina's die Googlebot steeds opvraagt maar die geen waarde opleveren, wijzen op verspilling van crawlbudget, wat wordt uitgelegd in ons woordenlijstitem over crawlbudget.
Fase 2: indexering, wat Google bewaart en waarom
Het rapport Paginaindexering in Search Console toont de URL's die Google kent en de status die Google aan elke URL geeft. Open het en sorteer op reden, niet op aantal. Elke reden vraagt om een andere oplossing. De Search Console-help over indexeringsstatussen van Google is de referentie voor de labels hieronder.
Status in het rapport
Wat het betekent
Wat te doen
Gevonden, momenteel niet geïndexeerd
Google heeft de URL gevonden maar nog niet gecrawld, en het crawlen uitgesteld omdat het dacht dat de site overbelast was
Controleer de serverresponstijden en de diepte van de URL. Zorg dat er interne links naar verwijzen
Gecrawld, momenteel niet geïndexeerd
Google heeft de pagina gecrawld en besloten haar niet te indexeren. Google indexeert niet elke pagina op het web
Controleer eerst de kwaliteit: dunne inhoud, bijna-duplicaten, zwakke interne links. Gebruik URL-inspectie op de pagina's die ertoe doen
Geblokkeerd door robots.txt
Googlebot mag de URL niet crawlen
Bevestig dat de blokkade bedoeld is. Verwijder die als de pagina moet ranken
Uitgesloten door noindex-tag
De pagina bevat een noindex-richtlijn
Verwijder de richtlijn als de pagina moet ranken. Laat hem staan op pagina's die buiten de index moeten blijven, zoals interne zoekresultaten
Een praktische regel: als een heel paginatype een hoog aandeel «gecrawld, momenteel niet geïndexeerd» laat zien, kijk dan eerst naar het template voordat je naar de artikelen kijkt. Dunne templates produceren dunne pagina's, en het aanpassen van één artikel verandert het patroon niet. Onze gids over de status gecrawld, momenteel niet geïndexeerd behandelt de oorzaken in detail.
Gebruik voor de pagina's die ertoe doen URL-inspectie, één URL per keer. Die toont de datum van de laatste crawl, of de pagina is geïndexeerd, en de canonical die Google heeft gekozen. Wanneer de gekozen canonical niet de canonical is die jij hebt opgegeven, is de oorzaak bijna altijd duplicatie of tegenstrijdige signalen, zoals een canonical die naar een geredirecteerde URL wijst, of interne links die een versie met parameters bevoordelen.
Fase 3: zoekdata, waar de kansen zitten
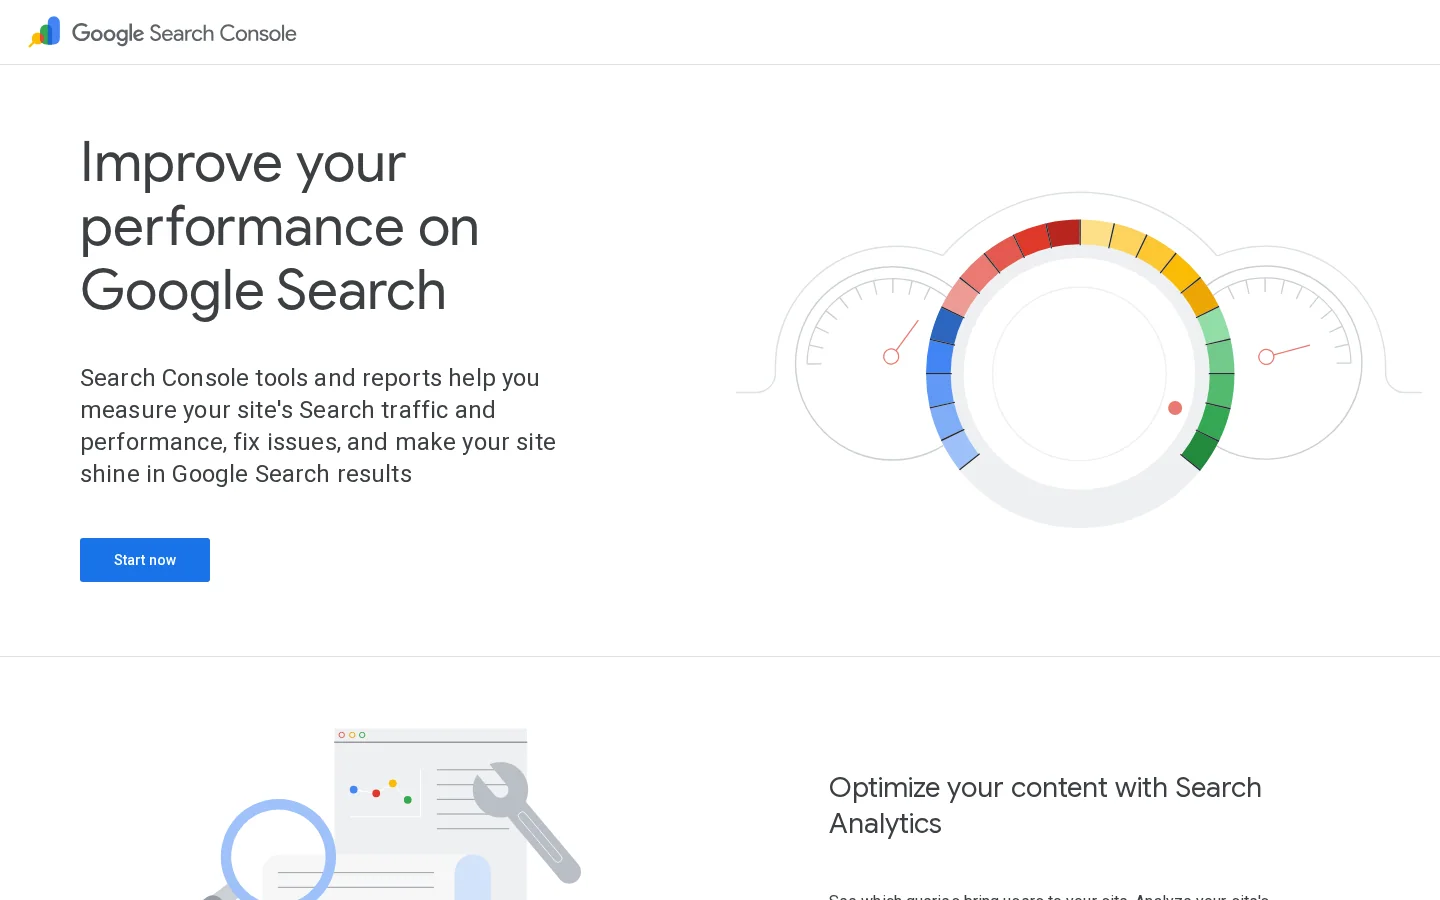
Het rapport Prestaties in Search Console is de meest bruikbare gratis dataset voor een audit. Standaard toont het de laatste drie maanden, wat te kort is voor een trend. Exporteer minstens 90 dagen aan query- en paginadata en bewaar het bestand met de datum, zodat je het bij de volgende audit kunt vergelijken. Groepeer de tabel op pagina en op query, en gebruik de filters voor land en apparaat wanneer de site meerdere markten bedient.
Google Search Console, de bron van de query-, pagina- en indexeringsdata die in de audit wordt gebruikt.
Vier analyses vinden het grootste deel van de kansen in deze data.
Afstand tot de top. Zoekopdrachten waarvoor je pagina tussen positie 8 en 20 rankt met echte vertoningen. Deze pagina's hebben al relevantie. Ze hebben vaak een betere title nodig, meer diepgang op de zoekopdracht of een paar interne links van verwante pagina's, geen herschrijving.
Verval. Pagina's waarvan de klikken tussen twee even lange periodes zijn gedaald. Vergelijk de laatste 90 dagen met de 90 dagen ervoor. Kijk eerst naar de pagina en daarna naar de zoekopdrachten die ze verloor, want een pagina kan haar positie behouden terwijl een nieuwe zoekfunctie de klikken wegneemt.
Kannibalisatie. Zoekopdrachten waarbij twee of meer van je URL's verschijnen en van week tot week om de posities strijden. Kies één doelpagina voor de zoekopdracht, en voeg de zwakkere pagina daarin samen, of maak de twee pagina's duidelijk verschillend in intentie.
CTR-gaten. Pagina's die een normale positie houden maar minder klikken krijgen dan vergelijkbare pagina's. Vergelijk de doorklikratio met het gemiddelde voor die positie, en herschrijf daarna de title en beschrijving van de achterblijvers.
Om één paginatype te isoleren, voeg je een paginafilter toe met een reguliere expressie. Om bijvoorbeeld alleen de blogpagina's te zien die op hoe-vragen mikken, vul je deze twee waarden in:
De doorklikratio hangt sterk af van het bovenste deel van de resultatenpagina. Een paar gepubliceerde cijfers helpen je beoordelen of een verschil echt is. In een onderzoek naar doorklikratio's bij Google ontving het eerste organische resultaat 27,6% van de klikken, de top drie samen 54,4%, en de resultaten op de tweede pagina 0,63%.
Waarom positie één zoveel uitmaakt
27,6%van de klikken gaat naar het eerste organische resultaat
54,4%van de klikken gaat naar de top drie samen
0,63%van de klikken gaat naar de resultaten op pagina twee
Bron: Backlinko, onderzoek naar doorklikratio's bij Google (backlinko.com/google-ctr-stats)
Gebruik deze gemiddelden als controle op de redelijkheid, niet als doel. Ze mengen alle soorten zoekopdrachten, en jouw eigen cijfers hangen af van de zoekintentie, merkzoekopdrachten en de elementen boven je resultaat, zoals video's, afbeeldingen of AI-antwoorden. Vergelijk elke pagina met pagina's op je eigen site die voor vergelijkbare zoekopdrachten ranken.
De onderstaande drempels zijn startpunten die we gebruiken om de data te sorteren. Het zijn geen Google-regels. Pas ze aan op de omvang van je site en het volume van je zoekopdrachten.
Controle
Startdrempel (onze vuistregel)
Waarom het ertoe doet
Afstand tot de top
Gemiddelde positie 8 tot 20, minimaal 50 vertoningen in 90 dagen
De vraag is er, en de pagina staat dichtbij genoeg om te stijgen
Verval
Klikken met 30% of meer gedaald tussen twee gelijke periodes
Genoeg verkeer verloren om een beoordeling te rechtvaardigen
Dunne inhoud
Minder dan 300 woorden bruikbare tekst, zonder navigatie en standaardtekst
Vaak te weinig om de zoekopdracht te beantwoorden. Een korte toolpagina kan toch goed zijn, dus controleer de intentie
Interne links
Minder dan 3 interne inkomende links van indexeerbare pagina's
Een zwak signaal van belang en een veelvoorkomend teken van een wezenloze pagina
De Search Console-data geeft je ook een tweede controle: de zoekopdrachten waarop je rankt maar waarop je nooit hebt gemikt. Dat zijn vaak de makkelijkste toevoegingen aan een bestaande pagina, omdat de relevantie al is bewezen door de vertoningen.
Fase 4: Core Web Vitals en mobiel
De documentatie van Google over Core Web Vitals definieert drie gebruikerservaringsmetingen en hun drempels. Een pagina valt in het «goede» bereik wanneer haar Largest Contentful Paint 2,5 seconden of minder is, haar Interaction to Next Paint 200 milliseconden of minder, en haar Cumulative Layout Shift 0,1 of minder. INP werd in 2024 een stabiele Core Web Vital en verving First Input Delay.
Meting
Goed wanneer
Wat het meet
Gebruikelijke oplossing
LCP
2,5 seconden of minder
Hoe snel het grootste zichtbare element laadt
De hoofdafbeelding optimaliseren, de serverresponstijd verkorten, het lettertype preloaden dat de pagina als eerste nodig heeft
INP
200 milliseconden of minder
Hoe snel de pagina reageert op klikken, tikken en toetsaanslagen tijdens het bezoek
Lange JavaScript-taken opsplitsen, zware scripts van derden verwijderen, voorkomen dat de hoofdthread bij het laden wordt geblokkeerd
CLS
0,1 of minder
Hoeveel de inhoud verschuift terwijl de pagina laadt
Breedte en hoogte instellen op afbeeldingen en embeds, ruimte reserveren voor banners en advertenties, laat ladende elementen boven de vouw vermijden
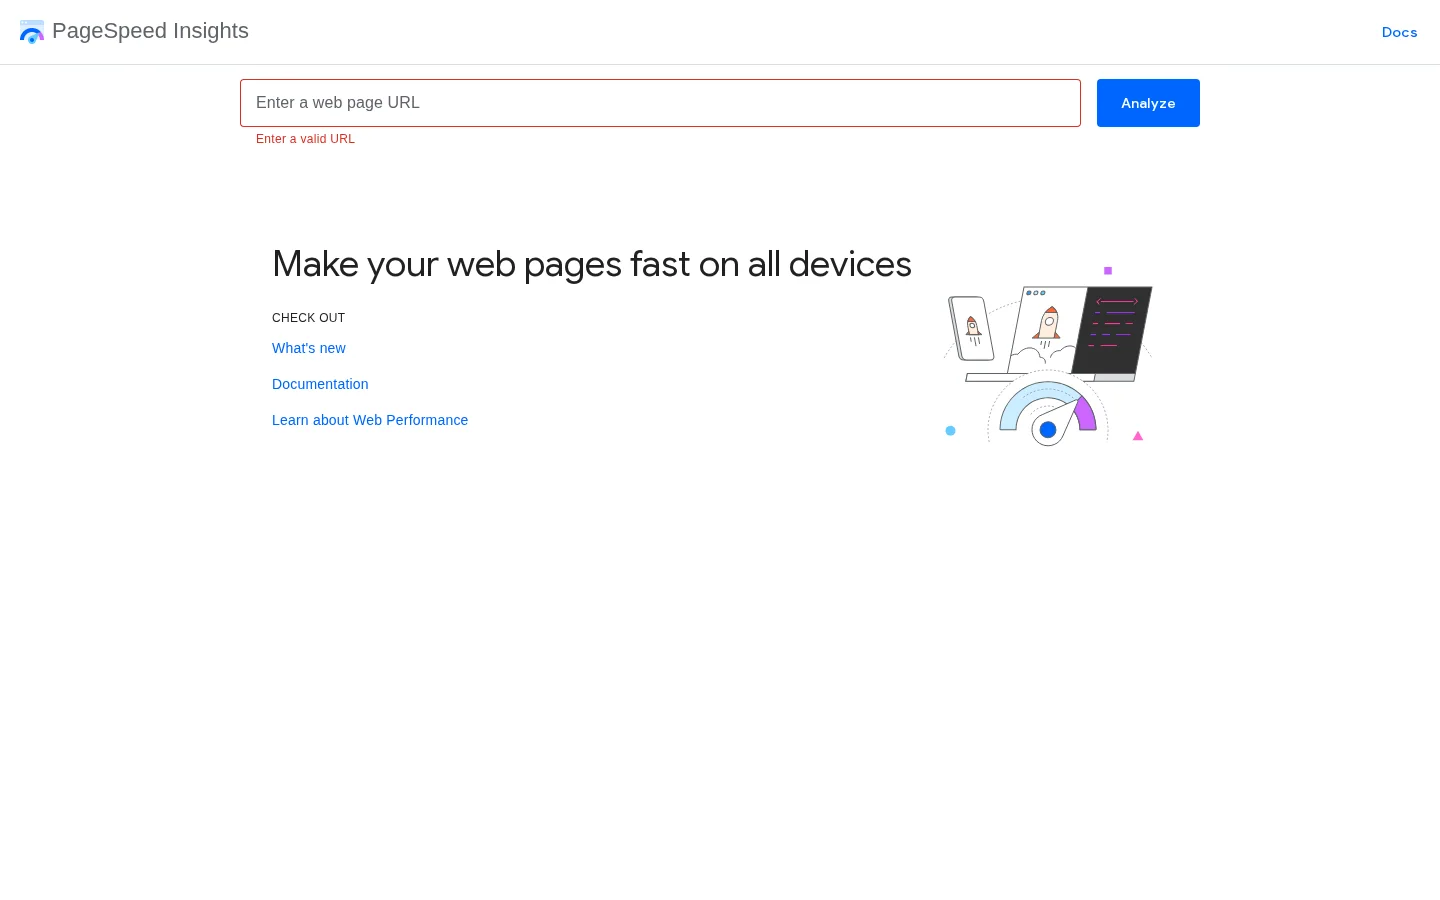
Lees eerst de veldgegevens en daarna de labgegevens. Veldgegevens komen van echte Chrome-gebruikers en laten zien of bezoekers er daadwerkelijk last van hebben. Labgegevens komen uit een gesimuleerde testrun en verklaren waarom een pagina traag is. PageSpeed Insights toont beide: veldgegevens wanneer Google voldoende verkeer heeft voor de URL, en labgegevens voor elke URL die je test.
PageSpeed Insights, die veld- en labgegevens toont voor elke URL.
Test drie tot vijf URL's per template, niet alleen de homepage. Een producttemplate, een categorietemplate en een blogtemplate kunnen op dezelfde site heel verschillende scores hebben, omdat ze verschillende scripts laden. Een hoge labscore met een slechte veld-INP is een veelvoorkomend resultaat op sites met zware tagmanagers en chatwidgets. In dat geval is de labtest niet fout, maar hij geeft niet weer welke interactie gebruikers na het laden van de pagina ervaren.
Controleer op mobiel drie dingen. De hoofdinhoud van de mobiele versie moet overeenkomen met de desktopversie, want Google gebruikt voor indexering vooral de mobiele versie van een pagina. Gestructureerde data en interne links moeten op beide hetzelfde zijn. En geen opdringerig interstitial mag de inhoud bij aankomst bedekken. Snelheid telt mee voor de ranking, maar de nuttigste reden om het te verbeteren is dat trage templates bezoekers verliezen voordat ze iets hebben gelezen.
Fase 5: on-pagecontent en interne links
Controleer voor elke belangrijke pagina de title, de koppen, de diepgang van het antwoord, de links naar binnen en naar buiten, en of er een bijna-duplicaat bestaat. Doe dat voor een steekproef van pagina's uit elk template, en daarna voor de pagina's die in de zoekdata opduiken als afstand tot de top of als verval.
Controle
Geslaagd wanneer
Mislukt wanneer
Titletag
Noemt het onderwerp en de hoofdzoekopdracht van de pagina, en is uniek binnen de site
Dupliceert een andere pagina, of is een standaardwaarde van het template, zoals alleen de sitenaam
H1
Één per pagina, die het onderwerp in gewone woorden benoemt
Ontbreekt, is herhaald, of is vervangen door een logo of banner
Eerste scherm
De vraag van de zoekopdracht wordt bovenaan beantwoord
Het eerste scherm bestaat uit context en merktekst, en het antwoord komt pas na meerdere keren scrollen
Diepgang
Behandelt de subvragen die mensen over het onderwerp stellen, met concrete details
Dun, of opgevuld met herhaalde alinea's
Interne links
Wordt gelinkt vanaf verwante pagina's, en verwijst door naar de logische volgende stap
Wezenloos, of alleen gelinkt vanuit de footer of de sitemap
Gestructureerde data
Komt overeen met de inhoud die de bezoeker op de pagina ziet
Markeert inhoud die niet op de pagina staat, of gebruikt het verkeerde type
Interne links zijn de goedkoopste hefboom van de hele audit. Een link vanaf een pagina die al rankt, in de lopende tekst geplaatst en met de woorden van de doelzoekopdracht in het anker, geeft zowel context als autoriteit door. Generieke ankers als «klik hier» of «lees verder» geven heel weinig betekenis door. Begin bij de pagina's met het meeste verkeer, want elke nieuwe link vanaf die pagina's bereikt een pagina met een echt publiek.
Dubbele en bijna-dubbele inhoud verdient een eigen ronde. Categoriefilters, sorteerparameters en trackingparameters maken vaak veel URL's die dezelfde lijst tonen. Bepaal welke versie moet bestaan, en gebruik dan de canonical-tag, de robots-regels of de parameterafhandeling die past. Laat die beslissing niet aan Google over, want je zult het resultaat waarschijnlijk niet waarderen.
Tip
Voor een snelle eerste ronde op één pagina voert de gratis on-page SEO-audittool de gebruikelijke controles uit op title, koppen, links en metatags, zodat je je tijd kunt besteden aan de bevindingen die oordeelsvermogen vragen.
Fase 6: autoriteit en links
De controle van het linkprofiel beantwoordt drie vragen: win je verwijzende domeinen in een gelijkmatig tempo, heb je links verloren die ertoe deden, en zijn er patronen die gemanipuleerd lijken? Exporteer de verwijzende domeinen in de tijd uit een backlinktool en zoek naar plotselinge pieken, die vaak afkomstig zijn van een betaalde campagne of van spam, en naar dalingen, die vaak het gevolg zijn van verlopen pagina's of een migratie. Onze gids voor de backlinkaudit beschrijft de volledige beoordeling.
Wees voorzichtig met de disavow-tool. Googles eigen advies is dat de meeste sites hem niet nodig hebben. Gebruik hem wanneer je een duidelijk patroon ziet van links die je niet hebt verdiend, en er een handmatige actie of een ernstig probleem aan gekoppeld is, niet omdat een backlinktool sommige domeinen een lage score gaf. Goede links per ongeluk afwijzen kost meer dan een paar slechte links laten staan.
Fase 7: AI-zichtbaarheid en AI-crawlers
Twee controles horen tegenwoordig in elke audit. De eerste gaat over toegang: kunnen AI-crawlers je pagina's bereiken? Controleer de robots.txt-regels voor elke crawler die voor jou belangrijk is. OpenAI gebruikt GPTBot en OAI-SearchBot, Anthropic gebruikt ClaudeBot en Perplexity gebruikt PerplexityBot, en ze dienen niet allemaal hetzelfde doel. Eén regel voor allemaal is zelden de juiste keuze. Onze gids over AI-crawlers somt ze op met hun rollen.
Het voorbeeld hierboven is één mogelijke keuze, geen aanbeveling voor elke site. Het laat één crawler je pagina's lezen voor zoekantwoorden en blokkeert een andere die voor training wordt gebruikt. Beslis per crawler, leg de beslissing vast en controleer het bestand na elke release, want een robots.txt die alles blokkeert, duikt vaak op na een stagingrelease.
De tweede controle gaat over zichtbaarheid: noemen antwoordmachines je wanneer een koper de vraag stelt waarop je mikt? Maak een lijst van tien tot twintig prompts op basis van de echte vragen in je zoekdata en in verkoopgesprekken. Voer ze uit in ChatGPT, Perplexity en Gemini, noteer welke merken en welke URL's worden geciteerd, en herhaal elke prompt meerdere keren over een paar dagen, want antwoorden verschillen van run tot run. De methode voor de AI-zichtbaarheidsaudit legt uit hoe je de resultaten scoort.
Auditmethoden: welke bij jouw situatie past
Audits verschillen in scope en in het punt waar je begint. Vijf methoden komen in de praktijk veel voor. Elk past bij een andere situatie, en de meeste teams combineren er twee.
1. De volledige technische audit
Principe: de hele site dekken, elk paginatype en elke databron, en daarna de bevindingen rangschikken. Gebruik hem wanneer je een migratie voorbereidt, na een scherpe verkeersdaling, of voor de eerste audit van een grote site. Voordeel: hij vindt structurele problemen die geen paginagewijze beoordeling ziet, zoals een facetnavigatie die URL's vermenigvuldigt. Beperking: hij is traag en levert veel bevindingen op die een tweede ronde nodig hebben om geordend te worden. Voorbeeld: een retailer met 40000 product-URL's ontdekt dat één filterparameter het grootste deel van zijn duplicaten veroorzaakt, iets wat geen beoordeling van één product had onthuld.
2. De datagedreven audit
Principe: begin bij wat er in de zoekdata is veranderd, en diagnosticeer daarna alleen de betrokken pagina's en zoekopdrachten. Gebruik hem wanneer je een maandelijkse review doet, wanneer net een core update is uitgerold, of wanneer het team klein is. Voordeel: het werk is vanaf de eerste minuut op verkeer geprioriteerd. Beperking: hij is blind voor pagina's die nog geen data hebben, zoals nieuwe secties of pagina's die vanaf het begin geblokkeerd waren. Voorbeeld: een blog dat op vijf pagina's klikken verloor, controleert die vijf, ontdekt dat er twee elkaar kannibaliseren, en voegt ze samen.
3. De audit op paginaniveau
Principe: voer elke controle uit op één URL, en beslis daarna of er herschreven moet worden. Gebruik hem wanneer één belangrijke geldpagina achterblijft, of vóór een geplande herschrijving. Voordeel: snel en concreet, met een duidelijk voor en na. Beperking: hij kan geen patronen tonen, dus een templatefout kan eruitzien als een op zichzelf staand probleem. Voorbeeld: een productpagina met een goede title en goede inhoud heeft een canonical die naar een uitverkochte variant wijst.
4. De concurrentiegapaudit
Principe: vergelijk je pagina's en onderwerpen met die welke voor dezelfde zoekopdrachten boven je ranken. Gebruik hem wanneer je nieuwe content of nieuwe links plant. Voordeel: hij laat zien wat de markt in de praktijk beloont, inclusief diepgang, formaat en de behandelde subvragen. Beperking: de koploper kopiëren kan je naar een overvol of verkeerd intentieonderwerp leiden. Kijk wat de topresultaten werkelijk gemeen hebben voordat je beslist. Voorbeeld: de vijf topresultaten van een zoekopdracht beantwoorden allemaal een prijsvraag in het eerste scherm, de jouwe niet.
5. De AI-zichtbaarheidsaudit
Principe: controleer of AI-crawlers je pagina's kunnen lezen, en of antwoordmachines je citeren voor de vragen die ertoe doen. Gebruik hem wanneer je wilt weten of AI-tools je merk aanbevelen. Voordeel: hij dekt een kanaal dat traditionele positietrackers niet laten zien. Beperking: antwoorden verschillen van run tot run, dus de steekproef moet worden herhaald voordat je conclusies trekt. Voorbeeld: een softwarebedrijf wordt geciteerd voor een functie die het niet meer verkoopt, wat laat zien dat zijn vergelijkingspagina's verouderd zijn.
Methode
Startpunt
Het best voor
Belangrijkste beperking
Volledige technische audit
De crawl en elke databron
Migraties, grote sites, scherpe dalingen
Traag, en lastig te ordenen zonder plan
Datagedreven audit
Veranderingen in de zoekdata
Maandelijkse reviews, kleine teams
Mist pagina's zonder data
Audit op paginaniveau
Eén URL
Één pagina die achterblijft
Ziet geen templatebrede patronen
Concurrentiegapaudit
De resultaten boven jou
Nieuwe content en nieuwe links
Risico om de verkeerde intentie te kopiëren
AI-zichtbaarheidsaudit
Crawlertoegang en antwoordmachines
Weten of AI je aanbeveelt
Antwoorden variëren, steekproeven moeten worden herhaald
Snelle audit of volledige audit
Snelle audit
Alleen zoekdata en de belangrijkste templates
Eindigt met een korte, gerangschikte lijst
Mist structurele en crawlproblemen
Volledige audit
Dekt elk paginatype en template
Vindt structurele en crawlproblemen
Traag, en makkelijk af te ronden zonder plan
Ons advies: begin met de snelle audit, en ga pas naar de volledige audit wanneer de snelle wijst op een structurele oorzaak, of wanneer je op het punt staat de architectuur van de site te veranderen.
Prioriteren: van bevindingen naar een plan
Een audit met 400 bevindingen en geen volgorde is minder waard dan een met tien. Score elke bevinding op twee punten: hoeveel verkeer of omzet ze in gevaar brengt, en hoe moeilijk de oplossing is. Begin met de items met veel impact en weinig inspanning. Ga daarna naar de items met veel impact die meer werk vragen maar een heel template ontgrendelen, want één oplossing daar verandert duizenden pagina's.
Bevinding
Verkeer in gevaar
Inspanning
Prioriteit
Een template linkt vanaf elke pagina naar 404-pagina's
Hoog
Laag
Eerst doen
Geldpagina's met dubbele titles
Hoog
Laag
Eerst doen
Trage LCP op het categorietemplate
Hoog
Middel
Plannen in de volgende sprint
Blogartikelen met verval
Middel
Middel
Vernieuwen op volgorde van verloren klikken
Wezenloze glossariumpagina's
Laag
Laag
Bundelen met het werk aan interne links
Tagarchiefpagina's met dunne inhoud
Laag
Middel
Intentie controleren, daarna noindex of samenvoegen
Geef elk item een eigenaar, een datum en de meting waarvan je verwacht dat die beweegt. Een bevinding zonder eigenaar is een notitie, en notities veranderen geen rankings. Meet opnieuw nadat Google de betrokken pagina's opnieuw heeft gecrawld, wat weken kan duren, en vergelijk met de nulmeting die je aan het begin hebt opgeslagen. Wanneer je de resultaten presenteert, geeft de sjabloon voor een SEO-auditrapport een structuur die managers en klanten in tien minuten kunnen lezen.
Als je het Google- en het AI-verkeer op één plek wilt hebben terwijl je deze oplossingen volgt, toont het GEO / SEO-dashboard van Sorank beide naast elkaar.
Een SEO-audit van 90 minuten: wat je in één sessie kunt afronden
Een SEO-audit van 90 minuten controleert de pagina's met het meeste zoekverkeer, in een volgorde die echte verliezen als eerste boven water haalt. Gebruik hem wanneer je één sessie hebt en een gerangschikte lijst met oplossingen nodig hebt, geen doorloop van elke URL. Beperk het werk tot je belangrijkste pagina's en één voorbeeld-URL per template, dan is het resultaat dezelfde dag al bruikbaar.
Verdeel de sessie in vaste blokken en stop elk blok zodra de tijd erop zit. De tijdslimiet hoort bij de methode, want hij dwingt je tot keuzes.
Minuten
Taak
Resultaat
0 tot 10
90 dagen query- en paginadata uit Search Console exporteren en de top 20 pagina's op klikken noteren
Een opgeslagen nulmeting en een lijst met pagina's
10 tot 25
De controles op afstand tot de top en verval uit fase 3 toepassen op die lijst
Pagina's die klikken hebben verloren of tussen positie 8 en 20 staan
25 tot 40
Eén voorbeeld-URL per template crawlen en de statuscode, canonical en robots-richtlijnen controleren
Fouten, verkeerde canonicals en blokkades, per template
40 tot 55
Het rapport Paginaindexering openen en de redenen op aantal sorteren
De status die de meeste pagina's raakt
55 tot 70
PageSpeed Insights draaien op één URL per template, eerst de veldgegevens lezen
Het template met de zwakste veld-LCP of veld-INP
70 tot 90
De tien belangrijkste bevindingen opschrijven met verkeer op het spel, inspanning en een eigenaar
Een gerangschikt plan dat je dezelfde dag kunt versturen
Elke rij beantwoordt één vraag, dus je kunt een rij overslaan zonder de andere te verliezen. Laat het indexeringsrapport niets ongewoons zien, besteed die tijd dan aan de zoekdata, die meestal de snellere weg naar een oplossing is.
Wat een audit van 90 minuten niet kan zien
Een tijdslimiet verbergt drie dingen. Structurele problemen blijven onzichtbaar, zoals een filter dat URL's vermenigvuldigt, omdat je alleen steekproeven leest. Serverlogs worden niet gebruikt, dus je ziet niet hoe vaak crawlers een pagina opvragen. En het linkprofiel wordt overgeslagen, dat een volledige export uit een backlinktool nodig heeft. Schrijf die op als open vragen voor een latere backlinkaudit of een volledige review, zodat de korte audit niet completer lijkt dan hij is.
Fouten die een korte sessie verspillen
De meest voorkomende fout is beginnen met de crawler. Een crawl van een grote site kan langer duren dan de hele sessie en meer waarschuwingen opleveren dan iemand kan lezen. Begin in plaats daarvan met de zoekdata en open de crawler alleen voor pagina's met klikken of vertoningen. Los eerst de waarschuwingen op die pagina's op, want waarschuwingen op pagina's die niemand bezoekt veranderen je verkeer niet.
Tip
Zet de sessie in je agenda met een timer en één uitvoerbestand. Gebruik vanaf het begin de kolommen van de sjabloon voor een SEO-auditrapport, zodat de lijst op minuut 90 klaar is om te delen.
Veelgemaakte fouten, en hoe je ze herkent en oplost
De meeste audits bevatten dezelfde fouten. Ze zijn makkelijk te vermijden zodra je de signalen kent.
Auditen zonder scope
Wat het is: de audit dekt alles, dus niets wordt afgerond. Hoe je het herkent: het rapport heeft honderden problemen, geen enkele met een verkeerscijfer of een eigenaar. Hoe je het oplost: begin opnieuw met de gerichte opdracht uit de eerste sectie, beperk de crawl tot de paginatypen die ertoe doen, en sorteer de bevindingen op verkeer voordat je iets anders schrijft.
Waarschuwingen behandelen als rankings
Wat het is: het team lost de waarschuwingen op die de tool in rood toont, ook wanneer ze pagina's raken die niemand bezoekt. Hoe je het herkent: het aantal waarschuwingen daalt terwijl de klikken op je geldpagina's blijven dalen. Hoe je het oplost: koppel de crawl aan de zoekdata, en los eerst de problemen op pagina's met verkeer, vertoningen of links op.
Eén crawl als de waarheid beschouwen
Wat het is: de crawler meldt geen fouten, dus het team concludeert dat de site gezond is. Hoe je het herkent: Search Console meldt veel URL's als «gecrawld, momenteel niet geïndexeerd» of «gevonden» die de crawler nooit heeft gesignaleerd. Hoe je het oplost: vergelijk de crawl met de sitemap, het indexeringsrapport en de serverlogs. Een crawler ziet alleen wat hij via links en rendering kan bereiken, dus inhoud achter een login, scripts of facetfilters kan in zijn lijst ontbreken.
Pagina's repareren in plaats van templates
Wat het is: het team past dezelfde title, dezelfde afbeelding of dezelfde canonical op honderden pagina's aan, één voor één. Hoe je het herkent: dezelfde bevinding komt voor op de meeste URL's van één paginatype. Hoe je het oplost: repareer het template één keer, en controleer daarna een steekproef van pagina's om te bevestigen dat de wijziging overal werkt. Eén templatewijziging herstelt de hele groep.
Een pagina blokkeren om haar uit de zoekresultaten te halen
Wat het is: het team voegt een disallow in robots.txt toe aan een pagina die uit Google moet verdwijnen. Hoe je het herkent: de pagina blijft in de index met een kale URL en zonder snippet, en het rapport toont haar als geblokkeerd. Hoe je het oplost: laat het crawlen toe, voeg een noindex-richtlijn toe en wacht tot Google de pagina opnieuw crawlt. Zodra ze uit de index is, kun je haar blokkeren als dat nodig is, maar dat hoeft niet.
Voorbeeld (ter illustratie)
Stel je een site voor die een reeks campagnepagina's heeft opgeheven en die in robots.txt heeft geblokkeerd. De pagina's blijven in de zoekresultaten verschijnen, met een kale URL en zonder beschrijving, omdat andere sites nog naar ze linken. Het blokkeren ongedaan maken en noindex toevoegen geeft Google de kans de pagina's te crawlen, de richtlijn te lezen en ze uit de index te halen.
Najagen van een perfecte labscore
Wat het is: het team optimaliseert voor een score van 100 in een labtest en negeert de veldgegevens. Hoe je het herkent: de labscore is hoog, maar de veld-INP van hetzelfde template is slecht in het Core Web Vitals-rapport van Search Console. Hoe je het oplost: breng de interacties in kaart die echte gebruikers maken, meestal nadat de pagina is geladen. Zoek naar lange taken die door scripts worden veroorzaakt, niet naar de laadtijd van de eerste weergave.
Hoe vaak je een audit moet doen
Doe elke maand een snelle audit op de zoekdata en op je belangrijkste templates. Doe een volledige audit na een migratie, een redesign, een CMS-wissel of een plotselinge verkeersdaling, en doe één keer per jaar een volledige review om structurele afwijkingen op te sporen. De zoekdata moet continu worden gevolgd, want een daling in klikken is als signaal nuttiger dan als agendaherinnering.
Site-audit: een herhaalbare gezondheidscheck voor het hele domein
Een site-audit is een crawl van elke bereikbare URL op één domein, gerapporteerd per type probleem en ernst. Hij laat zien wat er op de hele site kapot is, inclusief patronen die een beoordeling pagina voor pagina mist. Hij zegt niet welke oplossing de rankings verbetert, dus combineer hem met de zoekdata.
Bepaal de crawlscope voordat je begint
Filters, sorteeropties en trackingtags kunnen veel meer URL's maken dan je pagina's hebt, en de meeste tonen dezelfde lijst. Sluit die parameters en mediabestanden uit, en crawl elk subdomein als apart project. Houd het aantal verzoeken laag, zodat de server snel blijft voor echte bezoekers. Houd paginering (page=) in scope, want gepagineerde lijsten kunnen pagina's bevatten die je geïndexeerd wilt hebben.
De meeste crawlers accepteren uitsluitingsregels die als reguliere expressies zijn geschreven, zoals deze. Test ze op een korte crawl en controleer of het aantal URL's alleen daalt voor de parameters die je wilde uitsluiten.
Lees de ernst voordat je naar de score kijkt
Elke tool groepeert problemen in niveaus en berekent een eigen gezondheidsscore. De labels verschillen per tool, maar de logica van de prioritering is gelijk. Een score is een trendlijn voor één tool met vaste instellingen, geen cijfer dat Google toekent. Werk de niveaus in deze volgorde af:
Niveau
Typische problemen
Eerste actie
Fouten op indexeerbare pagina's
4xx- of 5xx-antwoorden op URL's die je wilt laten ranken, kapotte interne links
Eerst oplossen, beginnend bij de pagina's die al klikken opleveren
Fouten op pagina's die je niet wilt indexeren
Kapotte interne zoekfunctie, URL's van filters of stopgezette campagnes
Verwijder de interne links die er nog naar verwijzen
Waarschuwingen
Te lange title-tags, ontbrekende meta-descriptions, dubbele koppen
In batches oplossen, idealiter met één sjabloonwijziging
Meldingen
Kleine optimalisatietips
Eén keer bekijken en alleen handelen als ze op geldpagina's terugkomen
Vergelijk twee crawls, niet twee scores
Het nuttigste resultaat van een site-audit is het verschil tussen twee runs. Exporteer de probleemlijst van de vorige run, crawl opnieuw met dezelfde instellingen en vergelijk de aantallen per type probleem en per URL. Nieuwe problemen komen eerst, want een nieuwe fout op een live pagina volgt meestal op een recente release. Koppel elk nieuw cluster aan je wijzigingslogboek voordat je een eigenaar toewijst.
Neem bijvoorbeeld een run die 42 fouten meldt. Run twee, vier weken later, meldt er 57, en 15 van de nieuwe zitten op een prijzentemplate dat die week live ging. Je lost het template één keer op. Als het aantal terugzakt richting 42, heeft de oplossing gewerkt, en wordt die run de nulmeting voor de volgende.
Houd de routine kort genoeg om te herhalen
Een site-audit die een hele dag kost, wordt niet herhaald. Sla de scope, de uitsluitingsregels en de ernsttabel op als één configuratie, zodat de volgende run minuten kost. Plan de crawl in en exporteer elke keer dezelfde drie bestanden: de probleemlijst, de indexeerbare URL's en de URL's die klikken krijgen. Onze gids voor geautomatiseerde SEO-rapportage legt uit wat je kunt automatiseren en hoe je dat instelt.
Als je nog een crawler kiest, rangschikt onze vergelijking van technische SEO-tools de opties op de taak die ze vervullen. Een site-audit is alleen de moeite waard om in te plannen als iemand het verschil tussen de runs leest. Anders is het nog één export in een map.
Waar je deze week mee begint
Als je nog nooit een audit hebt gedaan, doe dan vier dingen in volgorde. Exporteer 90 dagen Search Console-data en bewaar die met de datum. Crawl je belangrijkste templates met een crawler, te beginnen met de gratis versie van 500 URL's als je site klein is. Lees het indexeringsrapport en sorteer de redenen. Repareer daarna de drie grootste templateproblemen die je hebt gevonden, en meet opnieuw na de volgende crawlcyclus.
Exporteer de query- en paginadata, en sla de nulmeting op.
Crawl één voorbeeld-URL per template, en noteer de statuscodes, titles, canonicals en robots-richtlijnen.
Lees het indexeringsrapport, en maak van elke status een vraag met een eigenaar.
Repareer de drie grootste templateproblemen, en vergelijk daarna de zoekdata na de volgende crawlcyclus.
Een goede audit eindigt niet met een document. Hij eindigt met een korte lijst oplossingen die iemand deze maand uitvoert, en met een nulmeting die bewijst of ze hebben gewerkt.
Veelgestelde vragen
Hoe lang duurt een SEO-audit?
Dat hangt af van de omvang van de site en hoe diep je wilt gaan. Een gerichte audit van je belangrijkste templates en je zoekdata kun je in een paar dagen doen. Een volledige audit van een grote site met veel templates kost meer tijd, en het grootste deel daarvan gaat naar diagnose en prioritering in plaats van naar de crawl zelf.
Welke tools heb ik nodig voor een SEO-audit?
Minimaal Google Search Console en een crawler zoals Screaming Frog SEO Spider, plus PageSpeed Insights voor snelheid. Analytics en serverlogs voegen nuttige context toe. Betaalde SEO-suites helpen met backlinks en concurrentiedata, maar ze zijn niet nodig voor een eerste audit.
Wat is het verschil tussen een SEO-audit en een SEO-checklist?
Een checklist somt de controles op die je moet uitvoeren. Een audit voert die controles uit op jouw site, bepaalt welke bevindingen ertoe doen, en rangschikt de oplossingen op het verkeer dat ze in gevaar brengen. Gebruik een checklist om de audit op te bouwen, en de audit om het werk te kiezen.
y!
Ontvang gratis je contentplan voor 30 dagen
We analyseren je concurrenten, je website en je AI-zichtbaarheid om gratis een contentplan op maat voor je te maken.
“Ik heb Sorank getest op de site van een echte klant en het is waanzinnig. Het doet alles waar een bureau je $1500 per maand voor rekent. Het gaat nu bij die klant in productie.”Guillaume Guersanguersanguillaume.com
“Wij zijn een advertentiebureau en wilden onze SEO eens en voor altijd weer op de rails krijgen. Sorank gaf ons een helder beeld van onze site, hielp ons optimalisaties te prioriteren en onze content goed te structureren. De tool is makkelijk in gebruik, goed ontworpen voor een team en erg handig om het volgen te centraliseren zonder met meerdere platforms te hoeven jongleren. Een heel solide basis om met onze SEO opnieuw te beginnen.”Gaspard MadouiAdvertentiebureau
“Dankzij Sorank heb ik me gespecialiseerd in GEO. Met de GEO-ranglijst kan ik mijn klanten hun positie ten opzichte van concurrenten in ChatGPT laten zien. Het is een echt commercieel onderscheidend vermogen.”MélanieFreelance SEO-specialist
“Geweldige service, werkt goed voor onze website en helpt ons begrijpen hoe we die kunnen verbeteren om beter te scoren in Google en elders. Gefeliciteerd, ga zo door, ik raad het aan.”Hugo T.E-commerce-ondernemer