आपकी गोपनीयता हमारे लिए महत्वपूर्ण है, इसलिए आपके पास कुछ प्रकार के स्टोरेज को बंद करने का विकल्प है जो वेबसाइट के बुनियादी कामकाज के लिए ज़रूरी नहीं हो सकते। कुछ श्रेणियों को बंद करने से वेबसाइट पर आपके अनुभव पर असर पड़ सकता है। अधिक जानकारी (कुकी नीति)
धन्यवाद! आपका फ़ॉर्म सफलतापूर्वक प्राप्त हो गया है!
3 दिन मुफ़्त, फिर जब चाहें बंद करें। 90 दिन की परिणाम गारंटी, शर्तें लागू।
संक्षेप में: SEO ऑडिट एक संरचित जाँच है कि वे सब चीज़ें कौन-सी हैं जो आपके पेजों को क्रॉल, इंडेक्स, समझे, क्लिक और उद्धृत होने से रोकती हैं। इसे एक तय क्रम में चलाएँ: क्रॉलिंग, इंडेक्सिंग, सर्च डेटा, स्पीड, पेज कंटेंट, लिंक, और फिर AI विज़िबिलिटी। हर समस्या को उस ट्रैफ़िक से आँकें जिसे वह रोक रही है, और शीर्ष दस को तारीख़ और ज़िम्मेदार व्यक्ति वाले कामों में बदलें। एक केंद्रित ऑडिट कुछ दिनों में हो सकता है। किसी बड़ी साइट का पूरा ऑडिट ज़्यादा समय लेता है, और उसका नतीजा एक योजना होनी चाहिए, सिर्फ़ सूची नहीं।
SEO ऑडिट क्या है, और क्या नहीं है
SEO ऑडिट एक सवाल का जवाब देता है: कौन-सी तकनीकी, कंटेंट और अधिकार (authority) से जुड़ी समस्याएँ इस समय आपके विज़िट गिरा रही हैं, और उन्हें किस क्रम में ठीक करना चाहिए? यह मौजूद हर सर्वोत्तम प्रथा की सूची नहीं है। चालीस बिंदुओं का चेकलिस्ट बताता है कि क्या देखना है, जबकि ऑडिट बताता है कि आपकी साइट में क्या गलत है, वह कितना मायने रखता है, और पहले क्या करना है।
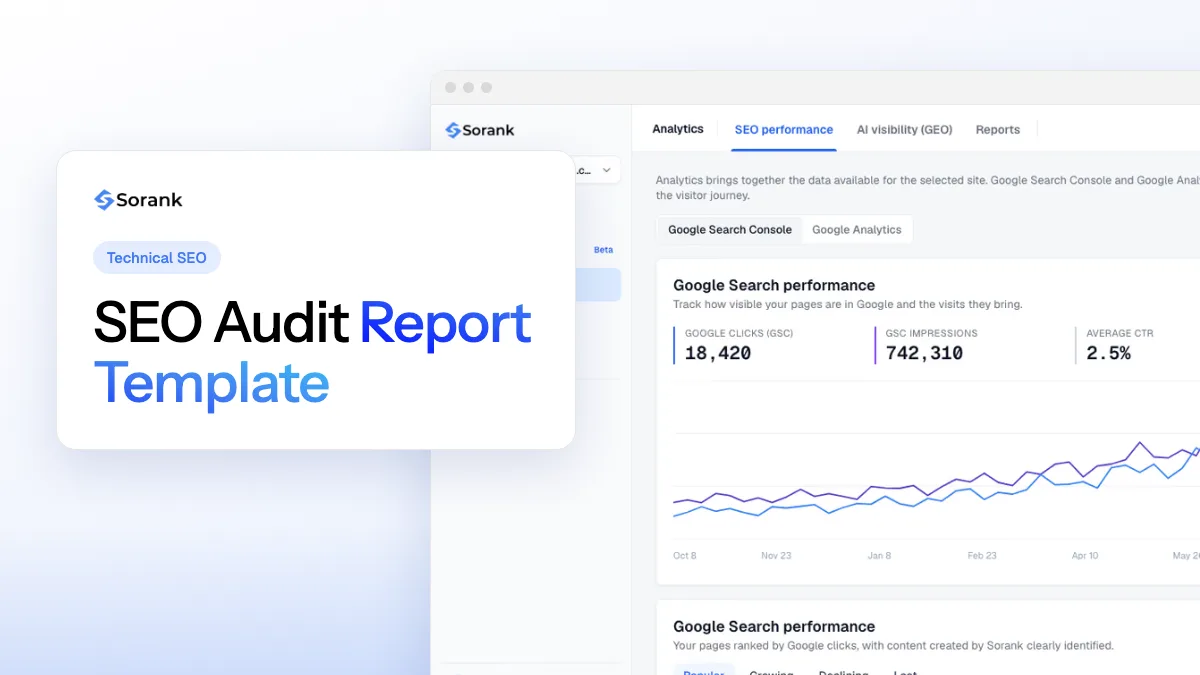
तीन चीज़ें अक्सर आपस में उलझ जाती हैं: ऑडिट (निदान), चेकलिस्ट (जाँच की सूची), और रिपोर्ट (जो आप किसी क्लाइंट या मैनेजर को सौंपते हैं)। हमारा SEO ऑडिट रिपोर्ट टेम्प्लेट रिपोर्ट के बारे में है, और तकनीकी SEO चेकलिस्ट जाँचों के बारे में। यह लेख उस तरीक़े के बारे में है जो इन दोनों को जोड़ता है, और उस डेटा के बारे में जिससे तय होता है कि क्या मायने रखता है।
एक ही ऑडिट को समझाने के दो तरीके
अस्पष्ट ब्रीफ़
साइट पर SEO की समस्याएँ जाँचो
नतीजा: चेतावनियों की एक लंबी सूची जिसे कोई नहीं पढ़ता
सीमित ब्रीफ़
वे पेज खोजो जिनके क्लिक पिछले 90 दिनों में गिरे हैं
नतीजा: दस सुधार, जो दाँव पर लगे ट्रैफ़िक के हिसाब से क्रमबद्ध हों
फ़र्क मेहनत में नहीं, सवाल में है। सीमित ब्रीफ़ पेज, अवधि और फ़ैसले का नाम लेती है, इसलिए हर जाँच का एक कारण होता है।
शुरू करने से पहले: पहुँच, दायरा और बेसलाइन
ज़्यादातर ऑडिट पहले क्रॉल से पहले ही बिगड़ जाते हैं, क्योंकि किसी ने दायरे पर सहमति नहीं ली और शुरुआती बिंदु सहेजा नहीं। किसी भी टूल को खोलने से पहले तीन बातें तय करें।
दायरा। कौन-सा डोमेन और कौन-से सबडोमेन, कौन-से देश और भाषाएँ, और कौन-से पेज प्रकार मायने रखते हैं। ई-कॉमर्स साइट के लिए इसका मतलब है होम, कैटेगरी, प्रोडक्ट, ब्लॉग और कोई भी लैंडिंग पेज। इन्हें लिखकर रखें।
पहुँच। हर प्रॉपर्टी (http, https, www और non-www के संस्करण, अगर मौजूद हों) के लिए Search Console में ओनर एक्सेस, एनालिटिक्स का रीड एक्सेस, और अगर हों तो CMS या सर्वर लॉग का एक्सेस। सर्वर लॉग दिखाते हैं कि क्रॉलर असल में क्या माँगते हैं, जो कोई क्रॉल सिमुलेशन नहीं बता सकता।
बेसलाइन। क्लिक, इम्प्रेशन, औसत पोज़ीशन और उन पेजों का स्नैपशॉट जो ज़्यादातर क्लिक लाते हैं, तारीख़ के साथ एक शीट में सहेजा हुआ। इसके बिना आप यह साबित नहीं कर सकते कि कोई सुधार काम कर गया।
कुछ भी क्रॉल करने से पहले
हर प्रॉपर्टी के लिए Search Console में ओनर एक्सेस की पुष्टि करें
90 दिनों का क्वेरी और पेज डेटा एक्सपोर्ट करें और आज की तारीख़ के साथ सहेजें
अपने मुख्य पेज प्रकारों की सूची बनाएँ और हर एक के लिए एक उदाहरण URL लिखें
लक्ष्य एक वाक्य में लिखें: मनी पेजों पर ज़्यादा क्लिक, कम एरर, तेज़ टेम्प्लेट
अपना क्रॉलर और उसकी सीमाएँ चुनें (नीचे क्रॉल वाला हिस्सा देखें)
ऑडिट किसी एक पेज को ठीक करने से पहले पूरी साइट की संरचना पढ़ता है।
क्रम से चलने वाला तरीका: सात चरण
क्रम मायने रखता है। क्रॉलिंग बताती है कि आपकी साइट पर क्या मौजूद है। इंडेक्सिंग बताती है कि Google क्या रखता है। सर्च डेटा बताता है कि लोग क्या ढूँढते और क्लिक करते हैं। फिर स्पीड, कंटेंट और लिंक समझाते हैं कि कोई पेज कम प्रदर्शन क्यों कर रहा है। अगर आप उल्टे क्रम में चलेंगे, तो घंटों ऐसे पेज को दोबारा लिखने में लगाएँगे जिसे Google इंडेक्स ही नहीं कर सकता।
SEO ऑडिट के सात चरण
साइट को क्रॉल करेंहर URL को उसके स्टेटस कोड, टाइटल, canonical, robots निर्देशों और आंतरिक लिंक के साथ सूचीबद्ध करें।
इंडेक्सिंग जाँचेंजो आप प्रकाशित करते हैं और जो Google इंडेक्स करता है, उसकी तुलना करें, और हर बहिष्करण का कारण पढ़ें।
सर्च डेटा पढ़ेंवे पेज और क्वेरी खोजें जिनके क्लिक बढ़ या घट रहे हैं, और वे जो पहले पेज के शीर्ष के करीब हैं।
स्पीड और मोबाइल टेस्ट करेंहर टेम्प्लेट पर Core Web Vitals मापें, असली उपयोगकर्ताओं के फ़ील्ड डेटा से शुरू करते हुए।
पेज कंटेंट की समीक्षा करेंटाइटल, हेडिंग, गहराई, दोहराव और आंतरिक लिंक पेज-दर-पेज और टेम्प्लेट-दर-टेम्प्लेट जाँचें।
अधिकार (authority) और लिंक का आकलन करेंसमय के साथ रेफ़रिंग डोमेन, खोए हुए लिंक, एंकर टेक्स्ट और स्पैम के संकेत देखें।
AI विज़िबिलिटी जाँचेंपक्का करें कि AI क्रॉलर आपके पेजों तक पहुँच सकते हैं, और परखें कि क्या उत्तर देने वाले इंजन आपका नाम लेते हैं।
ऑडिट से पहले SEO जाँच: डेटा पर भरोसा करने से पहले क्या पक्का करें
ऑडिट से पहले की SEO जाँच यह पक्का करती है कि जिस साइट का आप ऑडिट करने वाले हैं, वही साइट Google और आपके विज़िटर देखते हैं, और आपका डेटा इतना भरोसेमंद है कि उस पर काम किया जा सके। किसी भी क्रॉल से पहले इसमें लगभग एक घंटा दें। गलत प्रॉपर्टी, लाइव स्टेजिंग नियम या टूटी ट्रैकिंग बाद के हर निष्कर्ष को गलत बना सकती है, और क्रॉल इनमें से कुछ भी नहीं बताएगा।
पक्का करें कि कौन-सा वर्ज़न लाइव है
अपने डोमेन का हर वेरिएंट जाँचें: http और https, www के साथ और उसके बिना, और आख़िर में स्लैश के साथ और उसके बिना। हर वेरिएंट एक ही अंतिम पते पर पहुँचना चाहिए, आदर्श रूप से एक ही रीडायरेक्ट के बाद। दो लाइव वर्ज़न लिंक और सिग्नल बाँट देते हैं, और क्रॉलर दोनों को स्वस्थ बताएगा।
हर जवाब का Location हेडर पढ़ें। वह सीधे आपके पसंदीदा पते की ओर इशारा करना चाहिए, किसी दूसरे रीडायरेक्ट की ओर नहीं। होम पेज और एक गहरे पेज पर यही जाँच दोहराएँ, क्योंकि रीडायरेक्ट के नियम अक्सर टेम्प्लेट के हिसाब से अलग होते हैं।
जाँचें कि कोई टेस्ट सेटिंग लाइव साइट तक नहीं पहुँची
स्टेजिंग सेटिंग अचानक गिरावट की सबसे आम वजहों में से एक है। लाइव robots.txt, meta robots टैग, और होम पेज व एक लेख पर X-Robots-Tag हेडर देखें। पूरी साइट के लिए Disallow नियम, या टेस्ट बिल्ड से बचा रह गया noindex, पेजों को विज़िटर के लिए खुला रखते हुए भी खोज से पूरे सेक्शन छुपा सकता है। अगर ऐसा कुछ मिले, तो उन सेक्शन का ऑडिट करने से पहले उसे ठीक करें, वरना आगे का हर निष्कर्ष ऐसी साइट के बारे में होगा जिसे Google देख ही नहीं सकता।
गिरावट का निदान करने से पहले बदलावों का लॉग बनाएँ
पिछले छह महीनों के हर रिलीज़, रीडिज़ाइन, CMS अपडेट, माइग्रेशन और robots या noindex के बदलाव की तारीख़ों वाली सूची बनाएँ। फिर इन तारीख़ों को उस दिन से मिलाएँ जब ट्रैफ़िक बदलना शुरू हुआ। जो गिरावट किसी टेम्प्लेट रिलीज़ के दिन शुरू हुई, वह उसी टेम्प्लेट की ओर इशारा करती है। जिस गिरावट के आसपास कोई बदलाव न हो, वह सर्च अपडेट का नतीजा हो सकती है और उसे अलग जाँच चाहिए। लॉग के बिना आप वही चीज़ दोषी ठहराएँगे जो आपने आख़िरी बार देखी थी। URL से जुड़े बदलावों के लिए, SEO माइग्रेशन चेकलिस्ट बताती है कि क्या दर्ज करना है।
जिस डेटा पर ऑडिट टिका है, उसकी जाँच करें
उन्हीं 90 दिनों के लिए Search Console के क्लिक और आपके एनालिटिक्स के ऑर्गेनिक सेशन की तुलना करें। दोनों रेखाएँ एक-सी होना ज़रूरी नहीं, पर उन्हें एक ही दिशा में चलना चाहिए। अगर वे अलग हों, तो साइट का निदान करने से पहले मुख्य पेजों के टैग, कुकी सहमति बैनर और बॉट फ़िल्टरिंग जाँचें। दोनों टूल की तुलना बताती है कि हर टूल क्या गिनता है।
चरण 1: साइट क्रॉल करें और क्रॉलर जो मिले उसे ठीक करें
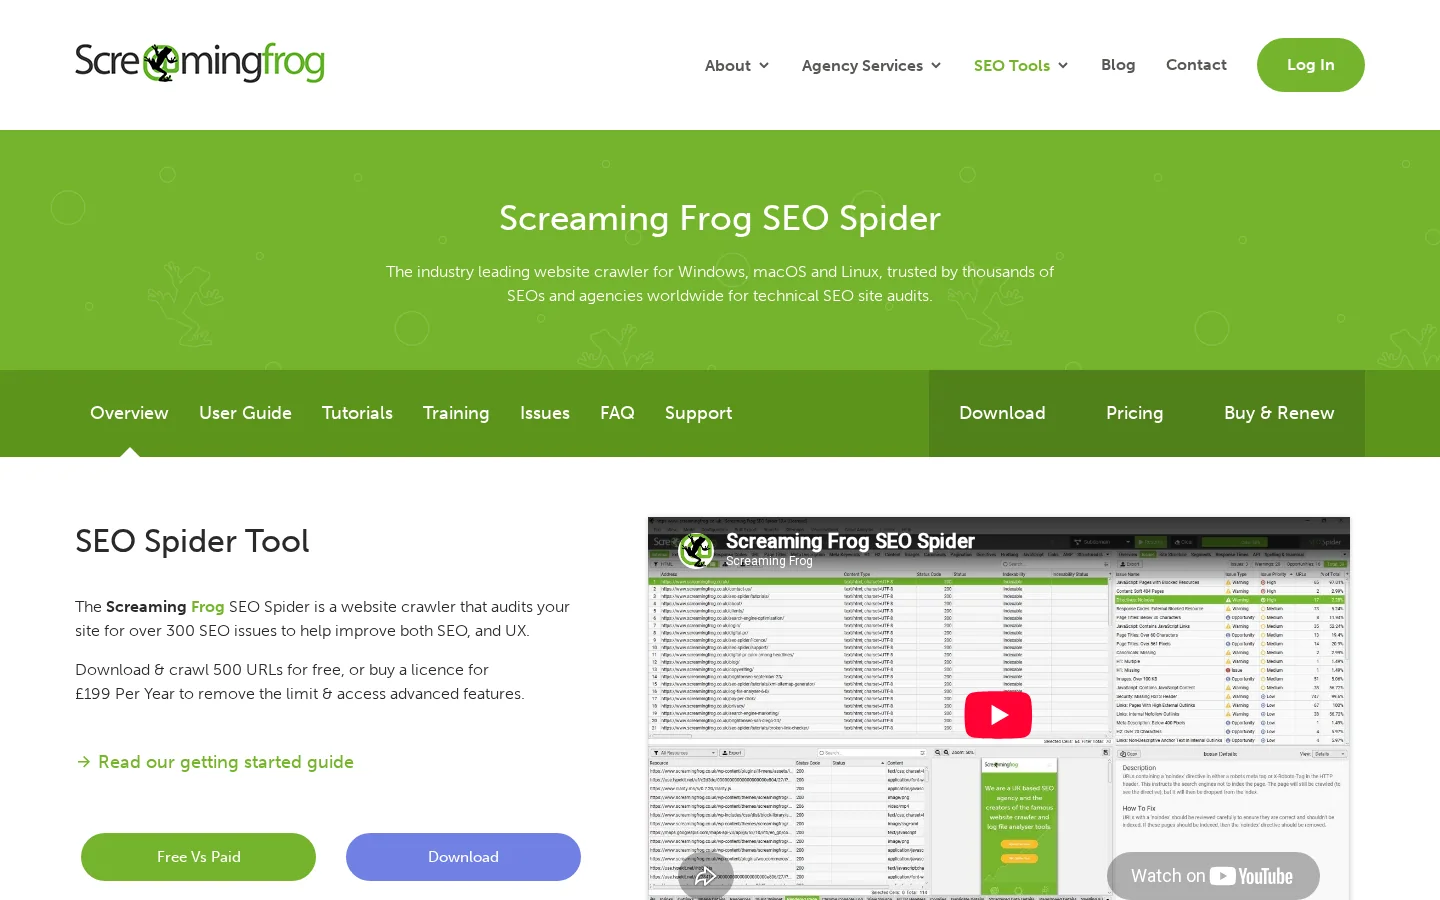
क्रॉलर वही करता है जो Googlebot करता है, बस छोटे पैमाने पर: वह एक पेज से शुरू करता है, मिले लिंक का पीछा करता है, और हर URL के लिए जो देखता है उसे दर्ज करता है। ज़्यादातर ऑडिट में हम जो टूल इस्तेमाल करते हैं वह Screaming Frog SEO Spider है। इसका मुफ़्त संस्करण 500 URL तक क्रॉल करता है, जो एक छोटी साइट या किसी बड़ी साइट के एक हिस्से के लिए काफ़ी है। पेड लाइसेंस यह सीमा हटा देता है। हमारी Screaming Frog गाइड में सेटअप चरण दर चरण दिए गए हैं।
Screaming Frog SEO Spider, एक डेस्कटॉप क्रॉलर जो साइट के हर URL को उसके स्टेटस कोड और निर्देशों के साथ सूचीबद्ध करता है।
क्रॉल अपने होम पेज और साइटमैप से शुरू करें, फिर दोनों सूचियों की तुलना करें। जो URL एक सूची में हो और दूसरी में नहीं, वह एक सवाल है। क्रॉलर को robots.txt का उसी तरह पालन करने के लिए सेट करें जैसे Googlebot करता है, और अगर आपकी साइट JavaScript पर निर्भर है तो उसे JavaScript रेंडर करने दें। जो क्रॉल पेजों को रेंडर नहीं करता, वह वह कंटेंट छोड़ देगा जो उपयोगकर्ता देखते हैं।
स्टेटस कोड और रीडायरेक्ट चेन
पहले 4xx और 5xx प्रतिक्रियाएँ छाँटें। 404 अपने आप में कोई समस्या नहीं है। वह तब समस्या बनता है जब आंतरिक लिंक अब भी उसकी ओर इशारा करते हैं, क्योंकि वे लिंक उपयोगकर्ताओं और क्रॉलरों को एक बंद गली में भेजते हैं। ऐसे आंतरिक लिंक खोजें जो एरर पेजों की ओर जाते हैं और उन्हें किसी जीवित URL की ओर मोड़ें। फिर रीडायरेक्ट चेन देखें: एक पुराना URL दूसरे URL पर जाता है, और वह तीसरे पर। हर हॉप देरी जोड़ता है और सिग्नल को कमज़ोर करता है। हर चेन को सीधा करें, ताकि पुराना URL सीधे अंतिम URL की ओर इशारा करे।
रीडायरेक्ट के प्रकार की भी जाँच करें। स्थायी स्थानांतरण के लिए इस्तेमाल हुआ अस्थायी 302 असल में 301 होना चाहिए। हमारी 301 बनाम 302 गाइड में फ़ैसले का नियम दिया गया है।
robots निर्देश, noindex और canonical
तीन सेटिंग्स बिना किसी के ध्यान दिए एक पेज को छिपा सकती हैं। robots.txt में disallow नियम क्रॉलिंग रोकता है। noindex मेटा टैग या X-Robots-Tag HTTP हेडर इंडेक्सिंग रोकता है। किसी दूसरे URL की ओर इशारा करने वाला canonical टैग बताता है कि खोज इंजन किस संस्करण को रखे। हर पेज प्रकार के लिए हर सेटिंग जाँचें, क्योंकि एक हिस्से को ठीक करने के लिए जोड़ा गया नियम अक्सर किसी दूसरे हिस्से को बंद कर देता है। एक आम मामला: स्टेजिंग का नियम जो कभी लाइव robots.txt से हटाया ही नहीं गया।
चेतावनी
robots.txt में किसी पेज को ब्लॉक करना उसे खोज से हटाने के बराबर नहीं है। अगर Google पेज को क्रॉल नहीं कर सकता, तो वह उस पर लगा noindex भी नहीं पढ़ सकता। किसी पेज को इंडेक्स से बाहर करने के लिए, क्रॉलिंग की अनुमति दें और noindex जोड़ें, फिर Google के दोबारा क्रॉल करने का इंतज़ार करें।
ऑर्फ़न पेज और क्लिक डेप्थ
ऑर्फ़न पेज वह है जिस तक कोई आंतरिक लिंक नहीं जाता। क्रॉलर उसे केवल साइटमैप या किसी बाहरी लिंक से ढूँढ पाते हैं, और उपयोगकर्ता उसे लगभग कभी नहीं ढूँढते। ऑर्फ़न पहचानने के लिए तीन सूचियों की तुलना करें: वे URL जिन तक क्रॉलर लिंक के ज़रिए पहुँचा, वे URL जो आपके साइटमैप में हैं, और वे URL जो एनालिटिक्स में विज़िट पाते हैं। जो पेज साइटमैप में है या विज़िट पाता है, पर जिसका कोई आंतरिक इनबाउंड लिंक नहीं है, वह ऑर्फ़न का उम्मीदवार है।
क्लिक डेप्थ भी मापें, यानी होम पेज से कितने क्लिक दूर है। कोई महत्वपूर्ण पेज अगर पाँच या छह क्लिक की गहराई में दबा है, तो उसे क्रॉलर का कम ध्यान मिलता है और आंतरिक लिंक भी कम। उसे किसी प्रासंगिक हब पेज से लिंक करें, और यह भी सुनिश्चित करें कि हब पेज खुद उथला हो।
टाइटल, विवरण और दोहराव
गायब टाइटल, दोहराए गए टाइटल, दोहराए गए मेटा विवरण, और इतने लंबे टाइटल जो खोज परिणामों में पूरे नहीं दिखते, इन सबको छाँटें। दोहराव लगभग हमेशा टेम्प्लेट से आता है, लेखक से नहीं। एक प्रोडक्ट टेम्प्लेट जो हर वैरिएंट के लिए एक ही टाइटल देता है, सैकड़ों दोहराव बनाता है, और टेम्प्लेट ठीक करने से वे सब एक साथ ठीक हो जाते हैं। टाइटल टैग को Google के लिए एक मज़बूत सुझाव मानें, गारंटी नहीं। कभी-कभी Google उसे दोबारा लिख देता है, और इसलिए उसे सटीक और विशिष्ट रखने का एक और कारण है।
सर्वर लॉग क्रॉल का चक्र पूरा करते हैं। वे दिखाते हैं कि Googlebot ने कौन-से URL माँगे, कितनी बार, और कौन-से स्टेटस कोड पाए। अगर आपकी उन तक पहुँच है, तो अनुरोधों की तुलना अपने साइटमैप से करें। वे पेज जिन्हें Googlebot लगातार देखता है, पर जो कोई मूल्य नहीं लाते, वे क्रॉल की बर्बादी का संकेत हैं, जिसे हमारी क्रॉल बजट प्रविष्टि में समझाया गया है।
चरण 2: इंडेक्सिंग, Google क्या रखता है और क्यों
Search Console की Page indexing रिपोर्ट उन URL की सूची देती है जिन्हें Google जानता है, और हर एक को दी गई स्थिति। इसे खोलें, फिर गिनती से नहीं, कारण से छाँटें। हर कारण एक अलग सुधार की ओर इशारा करता है। नीचे के लेबल के लिए संदर्भ Google की अपनी परिभाषाएँ हैं, जो इंडेक्सिंग स्टेटस पर Search Console की सहायता में हैं।
रिपोर्ट में स्थिति
इसका मतलब
क्या करें
Discovered, currently not indexed
Google ने URL खोजा है पर उसे अभी तक क्रॉल नहीं किया, और उसने यह उम्मीद करते हुए क्रॉल टाल दिया कि साइट पर ज़्यादा बोझ पड़ेगा
सर्वर का रिस्पॉन्स टाइम और URL की गहराई जाँचें। सुनिश्चित करें कि आंतरिक लिंक उसकी ओर इशारा करते हैं
Crawled, currently not indexed
Google ने पेज क्रॉल किया, पर उसे इंडेक्स न करने का फ़ैसला किया। Google वेब पर हर पेज इंडेक्स नहीं करता
पहले गुणवत्ता जाँचें: पतला कंटेंट, लगभग-डुप्लिकेट पेज, कमज़ोर आंतरिक लिंक। ज़रूरी पेजों पर URL Inspection का इस्तेमाल करें
Blocked by robots.txt
Googlebot को उस URL को क्रॉल करने की अनुमति नहीं है
पुष्टि करें कि ब्लॉक जानबूझकर है। अगर पेज को रैंक करना चाहिए, तो उसे हटाएँ
Excluded by noindex tag
पेज पर noindex निर्देश है
अगर पेज को रैंक करना चाहिए तो निर्देश हटाएँ। जिन पेजों को बाहर रहना चाहिए, जैसे आंतरिक सर्च के परिणाम, उन पर इसे रहने दें
एक व्यावहारिक नियम: जब पूरे पेज प्रकार में "Crawled, currently not indexed" का हिस्सा ज़्यादा हो, तो लेखों से पहले टेम्प्लेट देखें। पतले टेम्प्लेट पतले पेज बनाते हैं, और एक लेख ठीक करने से यह पैटर्न नहीं बदलेगा। हमारी Crawled, currently not indexed स्टेटस गाइड इसके कारणों को विस्तार से बताती है।
जो पेज मायने रखते हैं, उनके लिए URL Inspection का इस्तेमाल एक समय में एक URL पर करें। यह आखिरी क्रॉल की तारीख़, पेज इंडेक्स है या नहीं, और Google ने कौन-सा canonical चुना, यह दिखाता है। जब Google का चुना canonical आपकी घोषित canonical से अलग हो, तो कारण लगभग हमेशा दोहराव या आपस में टकराते संकेत होते हैं, जैसे किसी रीडायरेक्ट किए गए URL की ओर इशारा करता canonical, या ऐसे आंतरिक लिंक जो किसी पैरामीटर वाले संस्करण को तरजीह देते हैं।
चरण 3: सर्च डेटा, अवसर कहाँ हैं
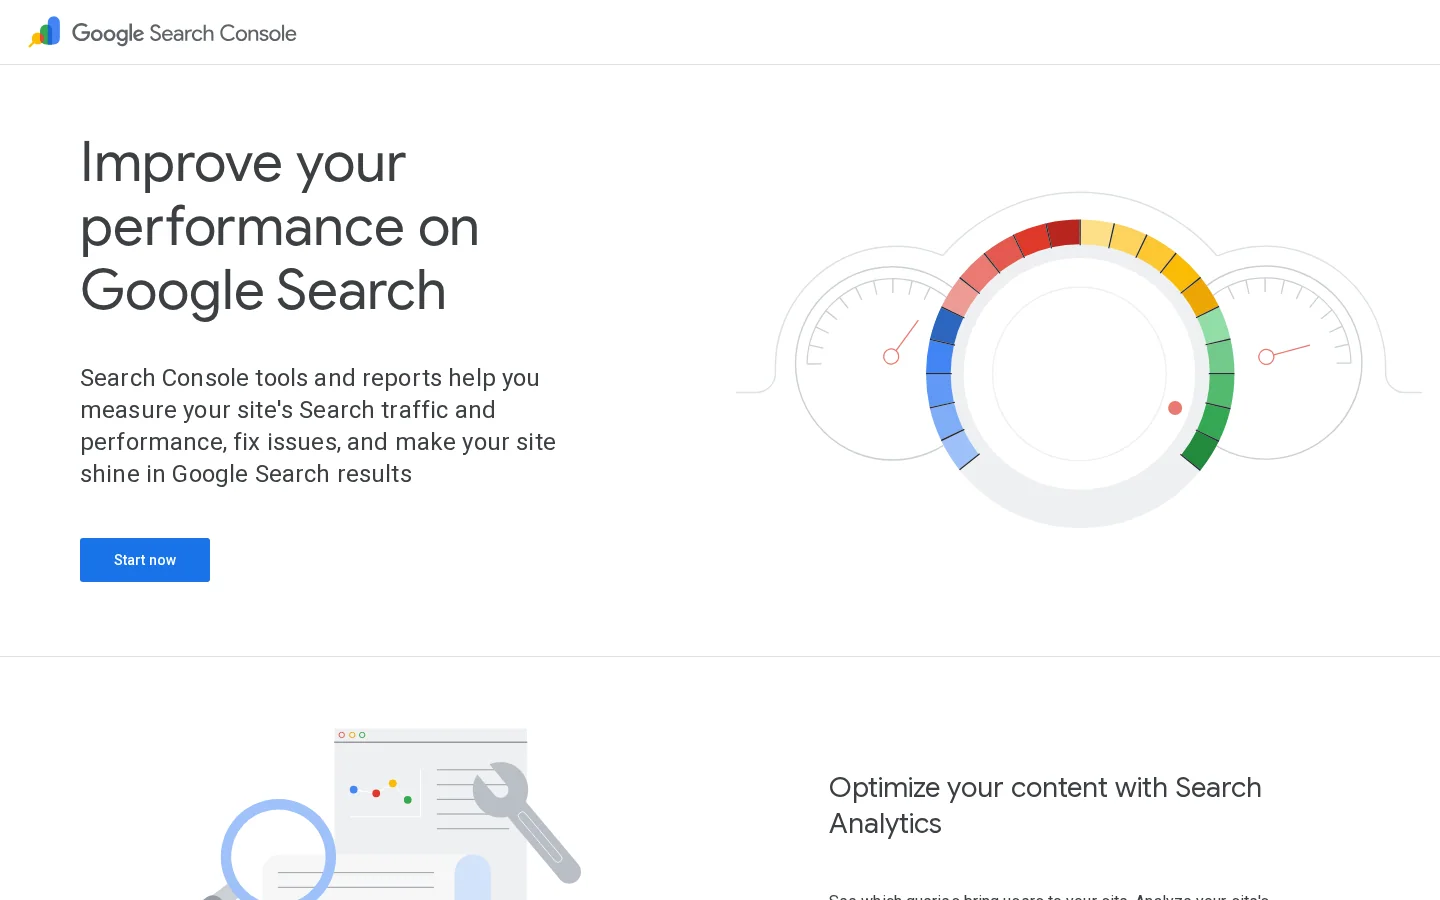
Search Console की Performance रिपोर्ट किसी ऑडिट के लिए सबसे उपयोगी मुफ़्त डेटा सेट है। डिफ़ॉल्ट रूप से यह पिछले तीन महीने दिखाती है, जो किसी ट्रेंड के लिए बहुत छोटा है। कम से कम 90 दिनों का क्वेरी और पेज डेटा एक्सपोर्ट करें और फ़ाइल को तारीख़ के साथ रखें, ताकि अगले ऑडिट से तुलना कर सकें। तालिका को पेज और क्वेरी के हिसाब से समूहित करें, और जब साइट एक से ज़्यादा बाज़ारों की सेवा करती हो तो देश और डिवाइस के फ़िल्टर इस्तेमाल करें।
Google Search Console, वह स्रोत जहाँ से ऑडिट में इस्तेमाल होने वाला क्वेरी, पेज और इंडेक्सिंग डेटा आता है।
चार विश्लेषण इस डेटा में ज़्यादातर अवसर खोज निकालते हैं।
स्ट्राइकिंग डिस्टेंस (Striking distance). वे क्वेरी जिनमें आपका पेज 8 से 20 के बीच की पोज़ीशन पर है और असली इम्प्रेशन हैं। इन पेजों में पहले से प्रासंगिकता है। अक्सर इन्हें बेहतर टाइटल, उस क्वेरी पर ज़्यादा गहराई, या संबंधित पेजों से कुछ आंतरिक लिंक चाहिए, दोबारा लिखा जाना नहीं।
गिरावट (Decay). वे पेज जिनके क्लिक दो बराबर अवधियों के बीच गिरे हैं। आख़िरी 90 दिनों की तुलना उससे पहले के 90 दिनों से करें। पहले पेज देखें, फिर वे क्वेरी जो उसने खोईं, क्योंकि कोई पेज अपनी पोज़ीशन बनाए रख सकता है और फिर भी कोई नया फ़ीचर उसके क्लिक ले सकता है।
कैननिबलाइज़ेशन (Cannibalisation). वे क्वेरी जिनमें आपके दो या ज़्यादा URL दिखते हैं और हफ़्ते-दर-हफ़्ते पोज़ीशन की अदला-बदली करते हैं। उस क्वेरी के लिए एक लक्ष्य पेज चुनें, फिर कमज़ोर पेज को उसमें मिलाएँ, या दोनों पेजों का इरादा साफ़ तौर पर अलग बनाएँ।
CTR अंतर। वे पेज जो सामान्य पोज़ीशन पर हैं, पर मिलते-जुलते पेजों से कम क्लिक पाते हैं। क्लिक-थ्रू रेट की तुलना उस पोज़ीशन के औसत से करें, फिर कमज़ोर प्रदर्शन करने वाले पेजों के टाइटल और विवरण दोबारा लिखें।
किसी पेज प्रकार को अलग करने के लिए, रेगुलर एक्सप्रेशन वाला पेज फ़िल्टर जोड़ें। उदाहरण के लिए, केवल उन ब्लॉग पेजों को देखने के लिए जो "कैसे" वाली क्वेरी को लक्षित करते हैं, ये दो मान दर्ज करें:
Page filter (regex):   /blog-geo-seo/.*
Query filter (regex):  how to|guide|checklist
क्लिक-थ्रू रेट सर्च परिणाम पेज के शीर्ष पर बहुत निर्भर करता है। प्रकाशित कुछ आँकड़े आपको यह आँकने में मदद करते हैं कि कोई अंतर असली है या नहीं। Google के क्लिक-थ्रू रेट के एक अध्ययन में, पहले ऑर्गेनिक परिणाम को 27.6% क्लिक मिले, शीर्ष तीन को मिलाकर 54.4%, और दूसरे पेज के परिणामों को 0.63%।
पहली पोज़ीशन इतनी अहम क्यों है
27.6%क्लिक पहले ऑर्गेनिक परिणाम पर जाते हैं
54.4%क्लिक शीर्ष तीन परिणामों को मिलाकर जाते हैं
0.63%क्लिक दूसरे पेज के परिणामों पर जाते हैं
स्रोत: Backlinko, Google क्लिक-थ्रू रेट अध्ययन (backlinko.com/google-ctr-stats)
इन औसतों को लक्ष्य नहीं, बल्कि एक सामान्य जाँच की तरह इस्तेमाल करें। इनमें हर तरह की क्वेरी मिली हुई हैं, और आपके अपने आँकड़े सर्च इरादे, ब्रांड शब्दों, और आपके लिस्टिंग के ऊपर दिखने वाली सुविधाओं जैसे वीडियो, छवियों या AI उत्तरों पर निर्भर करते हैं। हर पेज की तुलना अपनी ही साइट के उन पेजों से करें जो मिलती-जुलती क्वेरी पर रैंक करते हैं।
नीचे की सीमाएँ डेटा को छाँटने के लिए हमारे शुरुआती बिंदु हैं। ये Google के नियम नहीं हैं, इसलिए इन्हें अपनी साइट के आकार और क्वेरी की मात्रा के हिसाब से समायोजित करें।
जाँच
शुरुआती सीमा (हमारा अनुमानित नियम)
यह क्यों मायने रखता है
Striking distance
औसत पोज़ीशन 8 से 20, और 90 दिनों में कम से कम 50 इम्प्रेशन
माँग मौजूद है, और पेज इतना करीब है कि आगे बढ़ सके
Decay
दो बराबर अवधियों के बीच क्लिक 30% या ज़्यादा गिरे
इतना ट्रैफ़िक खो गया है कि समीक्षा ज़रूरी है
Thin content
नेविगेशन और बॉयलरप्लेट छोड़कर मुख्य टेक्स्ट 300 शब्दों से कम
अक्सर क्वेरी का उत्तर देने के लिए पर्याप्त नहीं। एक छोटा टूल पेज फिर भी सही हो सकता है, इसलिए इरादा जाँचें
Internal links
इंडेक्स योग्य पेजों से 3 से कम आंतरिक इनबाउंड लिंक
महत्व का कमज़ोर संकेत, और ऑर्फ़न पेज की आम पहचान
Search Console का डेटा आपको एक दूसरी जाँच भी देता है: वे क्वेरी जिन पर आप रैंक करते हैं पर जिन्हें आपने कभी लक्षित नहीं किया। ये अक्सर किसी मौजूदा पेज में जोड़ने के सबसे आसान अवसर होते हैं, क्योंकि इम्प्रेशन से प्रासंगिकता पहले ही साबित हो चुकी है।
चरण 4: Core Web Vitals और मोबाइल
Google का Core Web Vitals दस्तावेज़ तीन उपयोगकर्ता अनुभव मापदंड और उनकी सीमाएँ परिभाषित करता है। कोई पेज "अच्छा" श्रेणी में तब होता है जब उसका Largest Contentful Paint 2.5 सेकंड या कम हो, उसका Interaction to Next Paint 200 मिलीसेकंड या कम हो, और उसका Cumulative Layout Shift 0.1 या कम हो। INP 2024 में एक स्थायी Core Web Vital बना, और उसने First Input Delay की जगह ली।
मापदंड
अच्छा कब है
क्या मापता है
आम सुधार
LCP
2.5 सेकंड या कम
सबसे बड़ा दिखने वाला तत्व कितनी जल्दी लोड होता है
हीरो इमेज को ऑप्टिमाइज़ करें, सर्वर रिस्पॉन्स टाइम घटाएँ, और पेज को जिस फ़ॉन्ट की सबसे पहले ज़रूरत है उसे प्रीलोड करें
INP
200 मिलीसेकंड या कम
विज़िट के दौरान पेज क्लिक, टैप और कीप्रेस पर कितनी जल्दी प्रतिक्रिया देता है
लंबे JavaScript कार्यों को तोड़ें, भारी थर्ड-पार्टी स्क्रिप्ट हटाएँ, और लोड पर मेन थ्रेड को ब्लॉक करने से बचें
CLS
0.1 या कम
पेज लोड होते समय कंटेंट कितना खिसकता है
इमेज और एम्बेड पर चौड़ाई और ऊँचाई सेट करें, बैनर और विज्ञापनों के लिए जगह आरक्षित करें, और फ़ोल्ड के ऊपर देर से लोड होने वाले तत्वों से बचें
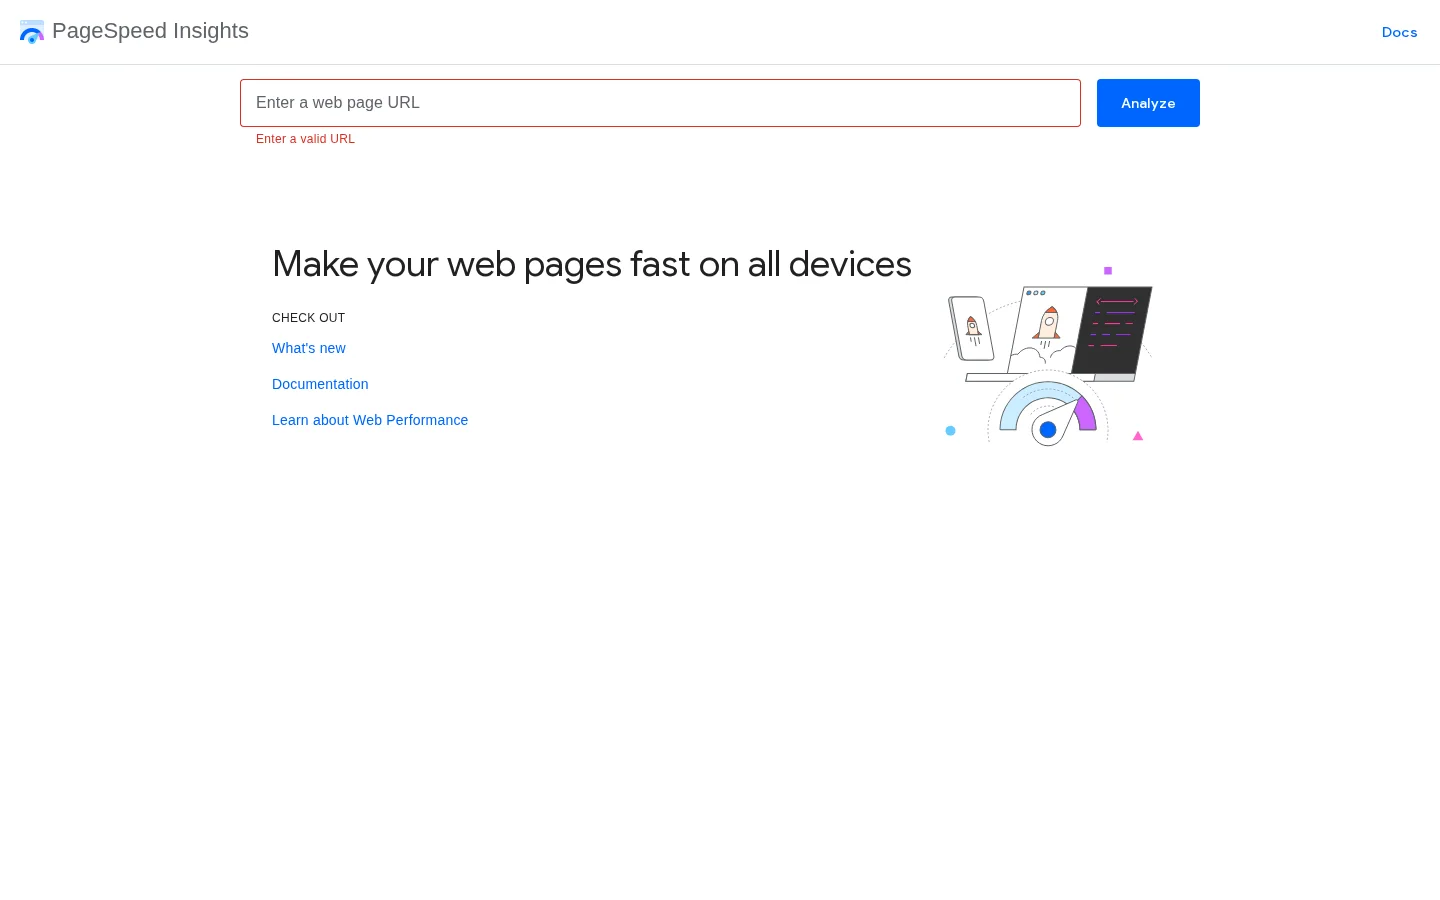
लैब डेटा से पहले फ़ील्ड डेटा पढ़ें। फ़ील्ड डेटा असली Chrome उपयोगकर्ताओं से आता है और बताता है कि विज़िटर सचमुच परेशान हो रहे हैं या नहीं। लैब डेटा एक सिमुलेटेड टेस्ट रन से आता है और बताता है कि पेज धीमा क्यों है। PageSpeed Insights दोनों दिखाता है: जब Google के पास URL के लिए पर्याप्त ट्रैफ़िक डेटा हो तो फ़ील्ड डेटा, और हर उस URL के लिए लैब डेटा जिसे आप टेस्ट करते हैं।
PageSpeed Insights, जो किसी भी URL के लिए फ़ील्ड डेटा और लैब डेटा दोनों दिखाता है।
सिर्फ़ होम पेज नहीं, बल्कि हर टेम्प्लेट के लिए तीन से पाँच URL टेस्ट करें। प्रोडक्ट टेम्प्लेट, कैटेगरी टेम्प्लेट और ब्लॉग टेम्प्लेट अलग-अलग स्क्रिप्ट लोड करते हैं, इसलिए एक ही साइट पर उनके स्कोर बहुत अलग हो सकते हैं। भारी टैग मैनेजर और चैट विजेट वाली साइटों पर लैब स्कोर ऊँचा और फ़ील्ड INP खराब होना आम नतीजा है। ऐसे में लैब टेस्ट गलत नहीं है, लेकिन वह उस इंटरैक्शन का प्रतिनिधित्व नहीं करता जो उपयोगकर्ता पेज लोड होने के बाद करते हैं।
मोबाइल पर तीन बातें जाँचें। मोबाइल संस्करण की मुख्य सामग्री डेस्कटॉप संस्करण से मेल खानी चाहिए, क्योंकि Google मुख्य रूप से पेज के मोबाइल संस्करण से इंडेक्स करता है। स्ट्रक्चर्ड डेटा और आंतरिक लिंक दोनों संस्करणों पर एक जैसे होने चाहिए। और पेज खुलते ही कोई परेशान करने वाला इंटरस्टीशियल सामग्री को ढकना नहीं चाहिए। स्पीड रैंकिंग के लिए मायने रखती है, लेकिन उसे ठीक करने का ज़्यादा उपयोगी कारण यह है कि धीमे टेम्प्लेट विज़िटरों को कुछ भी पढ़ने से पहले खो देते हैं।
चरण 5: पेज कंटेंट और आंतरिक लिंक
हर महत्वपूर्ण पेज के लिए टाइटल, हेडिंग, उत्तर की गहराई, अंदर और बाहर जाने वाले लिंक, और यह जाँचें कि कोई लगभग-समान डुप्लिकेट मौजूद है या नहीं। यह हर टेम्प्लेट के नमूना पेजों के लिए करें, फिर उन पेजों के लिए जो सर्च डेटा में Striking distance या Decay के रूप में दिखते हैं।
जाँच
कब पास होती है
कब फ़ेल होती है
टाइटल टैग
विषय और पेज की मुख्य क्वेरी बताता है, और पूरी साइट पर अनोखा है
किसी दूसरे पेज का दोहराव है, या सिर्फ़ साइट का नाम जैसा टेम्प्लेट डिफ़ॉल्ट है
H1
हर पेज पर एक, और सरल शब्दों में विषय बताता है
गायब है, दोहराया गया है, या लोगो या बैनर से बदल दिया गया है
पहली स्क्रीन
क्वेरी जो सवाल पूछती है उसका जवाब ऊपर के करीब मिलता है
पहली स्क्रीन संदर्भ और ब्रांड का परिचय है, और जवाब कई स्क्रॉल के बाद आता है
गहराई
विषय पर लोगों के उप-सवालों को विशिष्ट ब्योरे के साथ कवर करता है
पतला है, या एक जैसे दोहराए गए पैराग्राफ़ से भरा है
आंतरिक लिंक
संबंधित पेजों से लिंक किया गया है, और अगले तार्किक कदम तक ले जाता है
ऑर्फ़न है, या केवल फ़ुटर या साइटमैप से लिंक है
स्ट्रक्चर्ड डेटा
वही कंटेंट दिखाता है जो विज़िटर पेज पर देखता है
ऐसे कंटेंट को मार्क अप करता है जो पेज पर नहीं है, या गलत प्रकार इस्तेमाल करता है
आंतरिक लिंक पूरे ऑडिट का सबसे सस्ता लीवर है। ऐसे पेज से लिंक जो पहले से रैंक कर रहा है, मुख्य टेक्स्ट में रखा गया हो, और एंकर में लक्ष्य क्वेरी के शब्द इस्तेमाल करता हो, वह संदर्भ और अधिकार दोनों पहुँचाता है। "यहाँ क्लिक करें" या "और पढ़ें" जैसे सामान्य एंकर बहुत कम अर्थ पहुँचाते हैं। सबसे ज़्यादा ट्रैफ़िक लाने वाले पेजों से शुरू करें, क्योंकि उनसे हर नया लिंक ऐसे पेज तक जाता है जिसके पास असली दर्शक हैं।
डुप्लिकेट और लगभग-डुप्लिकेट कंटेंट को अपनी अलग समीक्षा चाहिए। कैटेगरी फ़िल्टर, सॉर्ट पैरामीटर और ट्रैकिंग पैरामीटर अक्सर ऐसे कई URL बनाते हैं जो एक ही सूची दिखाते हैं। तय करें कि कौन-सा संस्करण मौजूद रहना चाहिए, फिर वह canonical टैग, robots नियम, या पैरामीटर हैंडलिंग इस्तेमाल करें जो फ़िट बैठे। यह फ़ैसला Google पर न छोड़ें, क्योंकि नतीजा आपको पसंद नहीं आएगा।
सुझाव
किसी एक पेज की त्वरित पहली जाँच के लिए, मुफ़्त ऑनपेज SEO ऑडिट टूल टाइटल, हेडिंग, लिंक और मेटा टैग पर आम जाँचें चलाता है, ताकि आप अपना समय उन निष्कर्षों पर लगा सकें जिनमें विवेक चाहिए।
चरण 6: अधिकार (authority) और लिंक
लिंक प्रोफ़ाइल की जाँच तीन सवालों का जवाब देती है: क्या आपको रेफ़रिंग डोमेन स्थिर गति से मिल रहे हैं, क्या आपने ज़रूरी लिंक खोए हैं, और क्या कोई ऐसे पैटर्न हैं जो हेरफेर किए हुए लगते हैं? किसी बैकलिंक टूल से समय के साथ रेफ़रिंग डोमेन निर्यात करें, फिर अचानक उछाल देखें, जो अक्सर भुगतान वाले अभियान या स्पैम से आता है, और गिरावट, जो अक्सर खत्म हो चुके पेजों या साइट माइग्रेशन से आती है। हमारी बैकलिंक ऑडिट गाइड पूरी समीक्षा बताती है।
Disavow टूल के साथ सावधान रहें। Google का अपना मार्गदर्शन है कि ज़्यादातर साइटों को इसकी ज़रूरत नहीं होती। इसका इस्तेमाल तब करें जब आपके पास उन लिंक का स्पष्ट पैटर्न हो जो आपने कमाए नहीं, और उनसे जुड़ी कोई मैनुअल कार्रवाई या गंभीर समस्या हो, न कि इसलिए कि किसी बैकलिंक टूल ने कुछ डोमेन को कम स्कोर दिया। अच्छे लिंक गलती से खारिज करना कुछ खराब लिंक छोड़ देने से ज़्यादा महँगा पड़ता है।
चरण 7: AI विज़िबिलिटी और AI क्रॉलर
अब हर ऑडिट में दो जाँचें होनी चाहिए। पहली है पहुँच: क्या AI क्रॉलर आपके पेजों तक पहुँच सकते हैं? हर उस क्रॉलर के लिए robots.txt नियम जाँचें जो आपके लिए मायने रखता है। OpenAI GPTBot और OAI-SearchBot इस्तेमाल करता है, Anthropic ClaudeBot, और Perplexity PerplexityBot, और ये सब एक ही काम के लिए नहीं हैं। सब पर एक ही नियम लगाना शायद ही कभी सही फ़ैसला होता है। हमारी AI क्रॉलर गाइड इन्हें और उनकी भूमिकाओं को सूचीबद्ध करती है।
ऊपर का उदाहरण एक संभावित फ़ैसला है, हर साइट के लिए सिफ़ारिश नहीं। यह एक क्रॉलर को खोज उत्तरों के लिए आपके पेज पढ़ने देता है, और दूसरे क्रॉलर को, जो प्रशिक्षण के लिए इस्तेमाल होता है, रोकता है। हर क्रॉलर के लिए अलग से फ़ैसला करें, उसे लिखकर रखें, और हर डिप्लॉयमेंट के बाद फ़ाइल जाँचें, क्योंकि स्टेजिंग रिलीज़ के बाद अक्सर ऐसी robots.txt आ जाती है जो सब कुछ ब्लॉक कर देती है।
दूसरी जाँच है विज़िबिलिटी: जब कोई खरीदार वह सवाल पूछता है जिसे आप लक्षित कर रहे हैं, तो क्या उत्तर देने वाले इंजन आपका नाम लेते हैं? असली सर्च डेटा और बिक्री की बातचीत के सवालों से दस से बीस प्रॉम्प्ट की सूची बनाएँ। उन्हें ChatGPT, Perplexity और Gemini में चलाएँ, दर्ज करें कि कौन-से ब्रांड और कौन-से URL उद्धृत हुए, और हर प्रॉम्प्ट को कुछ दिनों में कई बार दोहराएँ, क्योंकि हर रन में जवाब बदलते हैं। AI विज़िबिलिटी ऑडिट की विधि बताती है कि नतीजों को कैसे आँकें।
ऑडिट के तरीके: आपकी स्थिति के लिए कौन-सा सही है
ऑडिट दायरे और शुरुआत की जगह के हिसाब से अलग होते हैं। व्यवहार में पाँच तरीके आम हैं। हर एक किसी अलग स्थिति में सही है, और ज़्यादातर टीमें उनमें से दो को मिलाती हैं।
1. पूरा तकनीकी ऑडिट
सिद्धांत: पूरी साइट, हर पेज प्रकार और हर डेटा स्रोत को कवर करें, फिर निष्कर्षों को क्रमबद्ध करें। कब उपयोग करें: माइग्रेशन की तैयारी करते समय, तेज़ ट्रैफ़िक गिरावट के बाद, या किसी बड़ी साइट के पहले ऑडिट में। फ़ायदा: यह ऐसी संरचनात्मक समस्याएँ खोजता है जो किसी पेज-स्तरीय समीक्षा को नहीं दिखतीं, जैसे फ़ैसेटेड नेविगेशन जो URL को गुणा करता है। सीमा: यह धीमा है, और इसमें बहुत से निष्कर्ष आते हैं जिन्हें क्रम में लगाने के लिए दूसरी समीक्षा चाहिए। उदाहरण: 40000 प्रोडक्ट URL वाला एक रिटेलर पाता है कि एक फ़िल्टर पैरामीटर उसके ज़्यादातर डुप्लिकेट बनाता है, जो किसी एक प्रोडक्ट की समीक्षा से कभी नहीं दिखता।
2. डेटा-प्रथम ऑडिट
सिद्धांत: सर्च डेटा में क्या बदला, वहीं से शुरू करें, और सिर्फ़ शामिल पेजों और क्वेरी का निदान करें। कब उपयोग करें: जब आप मासिक समीक्षा करते हों, कोई कोर अपडेट अभी-अभी आया हो, या टीम छोटी हो। फ़ायदा: काम पहले मिनट से ट्रैफ़िक के हिसाब से प्राथमिकता पाता है। सीमा: यह उन पेजों के प्रति अंधा है जिनका अभी कोई डेटा नहीं है, जैसे नए सेक्शन या शुरू से ब्लॉक किए गए पेज। उदाहरण: पाँच पेजों पर क्लिक खो देने वाला एक ब्लॉग उन पाँचों की जाँच करता है, पाता है कि दो एक-दूसरे से टकरा रहे हैं, और उन्हें मिला देता है।
3. पेज-स्तरीय ऑडिट
सिद्धांत: एक URL पर हर जाँच चलाएँ, फिर तय करें कि उसे दोबारा लिखने की ज़रूरत है या नहीं। कब उपयोग करें: जब कोई एक मनी पेज कम प्रदर्शन कर रहा हो, या किसी योजनाबद्ध पुनर्लेखन से पहले। फ़ायदा: तेज़ और ठोस है, साफ़ पहले और बाद के साथ। सीमा: यह पैटर्न नहीं दिखा सकता, इसलिए टेम्प्लेट का बग एक अकेली समस्या जैसा लग सकता है। उदाहरण: एक अच्छे टाइटल और कंटेंट वाला प्रोडक्ट पेज निकलता है जिसका canonical एक स्टॉक से बाहर वैरिएंट की ओर इशारा करता है।
4. प्रतियोगी अंतर ऑडिट
सिद्धांत: अपने पेजों और विषयों की तुलना उन पेजों से करें जो उन्हीं क्वेरी पर आपसे ऊपर रैंक करते हैं। कब उपयोग करें: नया कंटेंट या नए लिंक की योजना बनाते समय। फ़ायदा: यह दिखाता है कि बाज़ार व्यवहार में किस चीज़ को इनाम देता है, जिसमें गहराई, प्रारूप और कवर किए गए उप-सवाल शामिल हैं। सीमा: लीडर की नकल आपको भीड़भाड़ वाले या गलत इरादे वाले विषय में ले जा सकती है। फ़ैसला करने से पहले जाँचें कि शीर्ष परिणामों में असल में क्या समान है। उदाहरण: किसी क्वेरी के शीर्ष पाँचों परिणाम सभी पहली स्क्रीन पर कीमत के सवाल का जवाब देते हैं, और आपका नहीं देता।
5. AI विज़िबिलिटी ऑडिट
सिद्धांत: जाँचें कि क्या AI क्रॉलर आपके पेज पढ़ सकते हैं, और क्या उत्तर देने वाले इंजन महत्वपूर्ण सवालों पर आपको उद्धृत करते हैं। कब उपयोग करें: जब आपको जानना हो कि क्या AI टूल आपके ब्रांड की सिफ़ारिश करते हैं। फ़ायदा: यह ऐसा चैनल कवर करता है जो पारंपरिक रैंक ट्रैकर नहीं दिखाते। सीमा: जवाब हर रन में बदलते हैं, इसलिए निष्कर्ष निकालने से पहले नमूने दोहराने होंगे। उदाहरण: एक सॉफ़्टवेयर कंपनी उस फ़ीचर के लिए उद्धृत हो रही है जिसे उसने बेचना बंद कर दिया, जो दिखाता है कि उसके तुलना पेज पुराने हैं।
तरीका
कहाँ से शुरू होता है
किसके लिए सबसे अच्छा
मुख्य सीमा
पूरा तकनीकी ऑडिट
क्रॉल और हर डेटा स्रोत
माइग्रेशन, बड़ी साइटें, तेज़ गिरावट
धीमा, और योजना के बिना क्रम में लगाना कठिन
डेटा-प्रथम ऑडिट
सर्च डेटा में बदलाव
मासिक समीक्षा, छोटी टीमें
अभी डेटा न वाले पेज छूट जाते हैं
पेज-स्तरीय ऑडिट
एक URL
एक कम प्रदर्शन करने वाला पेज
टेम्प्लेट-स्तरीय पैटर्न नहीं दिखते
प्रतियोगी अंतर ऑडिट
आपसे ऊपर के परिणाम
नया कंटेंट और नए लिंक
गलत इरादे की नकल का जोखिम
AI विज़िबिलिटी ऑडिट
क्रॉलर पहुँच और उत्तर इंजन
यह जानना कि AI आपकी सिफ़ारिश करता है या नहीं
जवाब बदलते हैं, इसलिए नमूने दोहराने होंगे
त्वरित ऑडिट बनाम पूरा ऑडिट
त्वरित ऑडिट
केवल सर्च डेटा और मुख्य टेम्प्लेट
एक छोटी, क्रमबद्ध सूची पर खत्म होता है
संरचनात्मक और क्रॉल की समस्याएँ छूट जाती हैं
पूरा ऑडिट
हर पेज प्रकार और टेम्प्लेट कवर करता है
संरचनात्मक और क्रॉल की समस्याएँ खोजता है
धीमा, और बिना योजना के खत्म होना आसान
हमारी सलाह है कि त्वरित ऑडिट से शुरू करें, और पूरे ऑडिट पर तभी जाएँ जब त्वरित ऑडिट किसी संरचनात्मक कारण की ओर इशारा करे, या जब आप साइट का आर्किटेक्चर बदलने वाले हों।
प्राथमिकता तय करें: निष्कर्षों से योजना तक
बिना क्रम के 400 निष्कर्षों वाला ऑडिट, क्रम से लगे दस निष्कर्षों वाले ऑडिट से कम मूल्यवान है। हर निष्कर्ष को दो बातों पर आँकें: कितना ट्रैफ़िक या राजस्व दाँव पर है, और सुधार कितना कठिन है। उच्च प्रभाव और कम प्रयास वाली चीज़ों से शुरू करें। फिर वे उच्च प्रभाव वाली चीज़ें लें जिनमें ज़्यादा काम लगता है, पर जो पूरा टेम्प्लेट खोल देती हैं, क्योंकि वहाँ एक सुधार हज़ारों पेज बदल देता है।
निष्कर्ष
दाँव पर ट्रैफ़िक
प्रयास
प्राथमिकता
टेम्प्लेट हर पेज से 404 पेजों की ओर लिंक करता है
उच्च
कम
पहले करें
मनी पेजों पर डुप्लिकेट टाइटल
उच्च
कम
पहले करें
कैटेगरी टेम्प्लेट पर धीमा LCP
उच्च
मध्यम
अगले स्प्रिंट में योजना बनाएँ
गिरावट दिखाते ब्लॉग पोस्ट
मध्यम
मध्यम
खोए क्लिक के क्रम में ताज़ा करें
ऑर्फ़न ग्लॉसरी पेज
कम
कम
आंतरिक लिंकिंग के काम के साथ बैच करें
पतले कंटेंट वाले टैग आर्काइव पेज
कम
मध्यम
पहले इरादा जाँचें, फिर noindex या विलय करें
हर आइटम को एक ज़िम्मेदार व्यक्ति, एक तारीख़ और वह मेट्रिक दें जिसके हिलने की उम्मीद है। बिना ज़िम्मेदार व्यक्ति का निष्कर्ष एक नोट है, और नोट रैंकिंग नहीं बदलते। प्रभावित पेजों को Google द्वारा दोबारा क्रॉल करने के बाद फिर से मापें, जिसमें हफ़्ते लग सकते हैं, और शुरू में सहेजी गई बेसलाइन से तुलना करें। नतीजे पेश करते समय, SEO ऑडिट रिपोर्ट टेम्प्लेट एक ऐसा ढाँचा देता है जिसे मैनेजर और क्लाइंट दस मिनट में पढ़ सकें।
अगर आप इन सुधारों को ट्रैक करते हुए Google और AI ट्रैफ़िक एक ही जगह देखना चाहते हैं, तो Sorank का GEO / SEO डैशबोर्ड दोनों को साथ-साथ दिखाता है।
90 मिनट का SEO ऑडिट: एक सेशन में क्या पूरा किया जा सकता है
90 मिनट का SEO ऑडिट उन पेजों की जाँच करता है जो सबसे ज़्यादा सर्च ट्रैफ़िक लाते हैं, और ऐसे क्रम में जो असली नुकसान को पहले पकड़े। इसका इस्तेमाल तब करें जब आपके पास एक ही सेशन हो और हर URL की समीक्षा के बजाय सुधारों की प्राथमिकता वाली सूची चाहिए। काम को अपने मुख्य पेजों और हर टेम्प्लेट के एक उदाहरण URL तक सीमित रखें, तो नतीजा उसी दिन काम आ जाएगा।
सेशन को तय ब्लॉकों में बाँटें, और हर ब्लॉक का समय खत्म होते ही उसे रोक दें। समय की सीमा इस तरीके का हिस्सा है, क्योंकि यह आपको चुनने के लिए मजबूर करती है।
मिनट
काम
नतीजा
0 से 10
Search Console से 90 दिनों का क्वेरी और पेज डेटा एक्सपोर्ट करें और क्लिक के हिसाब से शीर्ष 20 पेजों की सूची बनाएँ
सहेजा गया बेसलाइन और पेजों की छोटी सूची
10 से 25
उस सूची पर चरण 3 वाली Striking distance और गिरावट की जाँच लगाएँ
वे पेज जिनके क्लिक घटे हैं या जो 8 से 20 के बीच की पोज़ीशन पर हैं
25 से 40
हर टेम्प्लेट का एक URL क्रॉल करें और स्टेटस कोड, canonical और robots निर्देश जाँचें
हर टेम्प्लेट के लिए एरर, गलत canonical और ब्लॉक
40 से 55
पेज इंडेक्सिंग रिपोर्ट खोलें और कारणों को संख्या के हिसाब से क्रम में लगाएँ
वह स्थिति जो सबसे ज़्यादा पेजों को प्रभावित करती है
55 से 70
हर टेम्प्लेट के एक URL पर PageSpeed Insights चलाएँ और पहले फ़ील्ड डेटा पढ़ें
वह टेम्प्लेट जिसका फ़ील्ड LCP या INP सबसे कमज़ोर है
70 से 90
शीर्ष दस निष्कर्ष लिखें, जिनमें दाँव पर लगा ट्रैफ़िक, मेहनत और ज़िम्मेदार व्यक्ति हो
एक क्रमबद्ध योजना जिसे उसी दिन भेजा जा सके
हर पंक्ति एक सवाल का जवाब देती है, इसलिए आप कोई पंक्ति छोड़ सकते हैं और बाकी का नुकसान नहीं होता। अगर इंडेक्सिंग रिपोर्ट में कुछ असामान्य नहीं दिखता, तो वह समय सर्च डेटा को दें, क्योंकि सुधार तक पहुँचने का आम तौर पर वही तेज़ रास्ता होता है।
90 मिनट के ऑडिट को क्या नहीं दिखता
समय की सीमा तीन चीज़ें छुपा देती है। यह संरचनात्मक समस्याएँ छोड़ देती है, जैसे कोई फ़िल्टर जो URL की संख्या बढ़ा देता है, क्योंकि आप सिर्फ़ नमूने पढ़ते हैं। यह सर्वर लॉग का इस्तेमाल नहीं करती, इसलिए आप नहीं जान सकते कि क्रॉलर किसी पेज को कितनी बार माँगते हैं। और यह लिंक प्रोफ़ाइल को छोड़ देती है, जिसके लिए बैकलिंक टूल से पूरा एक्सपोर्ट चाहिए। इन्हें बाद के बैकलिंक ऑडिट या पूरी समीक्षा के लिए खुले सवालों के रूप में लिख लें, ताकि छोटा ऑडिट वास्तव में जितना पूरा है उससे ज़्यादा पूरा न दिखे।
छोटे सेशन को बर्बाद करने वाली गलतियाँ
सबसे आम गलती क्रॉलर से शुरू करना है। किसी बड़ी साइट का क्रॉल पूरे सेशन से लंबा चल सकता है और इतनी चेतावनियाँ लौटा सकता है जितनी कोई पढ़ नहीं सकता। इसके बजाय सर्च डेटा से शुरू करें, और क्रॉलर को सिर्फ़ उन पेजों के लिए खोलें जिनके पास क्लिक या इम्प्रेशन हैं। पहले उन पेजों की चेतावनियाँ ठीक करें, क्योंकि जिन पेजों को कोई नहीं देखता उनकी चेतावनियाँ आपका ट्रैफ़िक नहीं बदलतीं।
सुझाव
सेशन को टाइमर और एक आउटपुट फ़ाइल के साथ अपने कैलेंडर में डालें। SEO ऑडिट रिपोर्ट टेम्प्लेट के कॉलम शुरू से इस्तेमाल करें, ताकि 90वें मिनट तक सूची साझा करने के लिए तैयार हो।
आम गलतियाँ, और उन्हें कैसे पहचानें व ठीक करें
ज़्यादातर ऑडिट में वही गलतियाँ होती हैं। उनके संकेत जान लेने पर उनसे बचना आसान हो जाता है।
बिना दायरे के ऑडिट करना
यह क्या है: ऑडिट हर चीज़ को कवर करता है, इसलिए कुछ भी पूरा नहीं होता। कैसे पहचानें: रिपोर्ट में सैकड़ों समस्याएँ हैं, और किसी के पास ट्रैफ़िक का आँकड़ा या ज़िम्मेदार व्यक्ति नहीं है। कैसे ठीक करें: पहले सेक्शन की सीमित ब्रीफ़ से दोबारा शुरू करें, क्रॉल को उन पेज प्रकारों तक सीमित करें जो मायने रखते हैं, और कुछ और लिखने से पहले निष्कर्षों को ट्रैफ़िक के हिसाब से छाँटें।
चेतावनियों को रैंकिंग समझ लेना
यह क्या है: टीम वे लाल चेतावनियाँ ठीक करती है जो टूल दिखाता है, भले ही वे ऐसे पेजों को प्रभावित करती हों जिन्हें कोई नहीं देखता। कैसे पहचानें: चेतावनियों की संख्या घटती है, पर मनी पेजों पर क्लिक गिरते रहते हैं। कैसे ठीक करें: क्रॉल को सर्च डेटा से जोड़ें, और पहले उन पेजों की समस्याएँ ठीक करें जिनमें ट्रैफ़िक, इम्प्रेशन या लिंक हैं।
एक क्रॉल को सच मान लेना
यह क्या है: क्रॉलर कोई एरर नहीं बताता, इसलिए टीम मान लेती है कि साइट स्वस्थ है। कैसे पहचानें: Search Console में बहुत सारे "Crawled, currently not indexed" या "Discovered" URL दिखते हैं, जिन्हें क्रॉलर ने कभी चिह्नित नहीं किया। कैसे ठीक करें: क्रॉल की तुलना साइटमैप, इंडेक्सिंग रिपोर्ट और सर्वर लॉग से करें। क्रॉलर वही देखता है जो वह लिंक और रेंडरिंग के ज़रिए पहुँच सकता है, इसलिए लॉगिन, स्क्रिप्ट या फ़ैसेटेड फ़िल्टर के पीछे का कंटेंट उसकी सूची से छूट सकता है।
टेम्प्लेट की जगह पेजों को ठीक करना
यह क्या है: टीम एक ही टाइटल, एक ही इमेज या एक ही canonical को सैकड़ों पेजों पर एक-एक करके बदलती है। कैसे पहचानें: वही निष्कर्ष एक पेज प्रकार के ज़्यादातर URL पर दिखता है। कैसे ठीक करें: टेम्प्लेट को एक बार ठीक करें, फिर नमूना पेजों की जाँच करें कि बदलाव हर जगह काम कर गया। एक टेम्प्लेट बदलाव पूरे समूह को ठीक कर देता है।
खोज से हटाने के लिए पेज ब्लॉक करना
यह क्या है: टीम उस पेज के लिए robots.txt में disallow जोड़ती है जिसे वे Google से बाहर करना चाहते हैं। कैसे पहचानें: पेज इंडेक्स में बिना सारांश के, केवल URL के रूप में बना रहता है, और रिपोर्ट उसे ब्लॉक्ड दिखाती है। कैसे ठीक करें: क्रॉलिंग की अनुमति दें, noindex निर्देश जोड़ें, और Google के पेज को दोबारा क्रॉल करने का इंतज़ार करें। एक बार पेज इंडेक्स से निकल जाए, तो ज़रूरत हो तो आप उसे ब्लॉक कर सकते हैं, पर ऐसा करना ज़रूरी नहीं है।
उदाहरण (स्पष्टीकरण के लिए)
कल्पना कीजिए एक साइट ने पुराने कैंपेन लैंडिंग पेजों का एक समूह हटाया और उन्हें robots.txt में ब्लॉक कर दिया। ये पेज खोज में बिना विवरण के, केवल URL के रूप में दिखते रहते हैं, क्योंकि दूसरी साइटें अब भी इन्हें लिंक कर रही हैं। ब्लॉक हटाने और noindex जोड़ने से Google पेजों को क्रॉल कर सकता है, निर्देश पढ़ सकता है, और उन्हें इंडेक्स से निकाल सकता है।
परफ़ेक्ट लैब स्कोर का पीछा करना
यह क्या है: टीम लैब टेस्ट में 100 स्कोर के लिए ऑप्टिमाइज़ करती है और फ़ील्ड डेटा को नज़रअंदाज़ करती है। कैसे पहचानें: लैब स्कोर ऊँचा है, पर वही टेम्प्लेट का फ़ील्ड INP Search Console की Core Web Vitals रिपोर्ट में खराब है। कैसे ठीक करें: उन इंटरैक्शन का विश्लेषण करें जो असली उपयोगकर्ता करते हैं, आम तौर पर पेज लोड होने के बाद। स्क्रिप्ट से शुरू होने वाले लंबे कार्य खोजें, पहले पेंट के लोड समय को नहीं।
ऑडिट कितनी बार करें
हर महीने सर्च डेटा और अपने सबसे महत्वपूर्ण टेम्प्लेट पर एक त्वरित ऑडिट चलाएँ। माइग्रेशन, रीडिज़ाइन, CMS बदलने, या ट्रैफ़िक में अचानक गिरावट के बाद एक पूरा ऑडिट चलाएँ, और संरचनात्मक बदलाव पकड़ने के लिए साल में एक बार पूरी समीक्षा करें। सर्च डेटा पर लगातार नज़र रखनी चाहिए, क्योंकि क्लिक में गिरावट कैलेंडर के रिमाइंडर से ज़्यादा एक चेतावनी के रूप में उपयोगी है।
साइट ऑडिट: पूरे डोमेन की दोहराई जा सकने वाली स्वास्थ्य जाँच
साइट ऑडिट एक डोमेन पर हर पहुँच योग्य URL का क्रॉल है, जिसे समस्या के प्रकार और गंभीरता के अनुसार रिपोर्ट किया जाता है। यह दिखाता है कि पूरी साइट पर क्या टूटा है, जिसमें वे पैटर्न भी शामिल हैं जो पेज-दर-पेज समीक्षा से छूट जाते हैं। यह नहीं बताता कि कौन-सा सुधार रैंकिंग बढ़ाएगा, इसलिए इसे सर्च डेटा के साथ जोड़कर देखें।
शुरू करने से पहले क्रॉल का दायरा तय करें
फ़िल्टर, सॉर्ट विकल्प और ट्रैकिंग टैग आपके पेजों की संख्या से कहीं ज़्यादा URL बना सकते हैं, और उनमें से ज़्यादातर एक ही सूची दिखाते हैं। उन पैरामीटर और मीडिया फ़ाइलों को बाहर रखें, और हर सबडोमेन को अपने अलग प्रोजेक्ट की तरह क्रॉल करें। रिक्वेस्ट की दर कम रखें, ताकि असली विज़िटरों के लिए सर्वर तेज़ रहे। पेजिनेशन (page=) को दायरे में रखें, क्योंकि पेजों में बँटी सूचियों में ऐसे पेज हो सकते हैं जिन्हें आप इंडेक्स कराना चाहते हैं।
ज़्यादातर क्रॉलर इस तरह के रेगुलर एक्सप्रेशन में लिखे एक्सक्लूड नियम स्वीकार करते हैं। इन्हें एक छोटे क्रॉल पर परखें, और जाँचें कि URL की संख्या सिर्फ़ उन्हीं पैरामीटर के लिए घटे जिन्हें आप बाहर रखना चाहते थे।
स्कोर से पहले गंभीरता पढ़ें
हर टूल समस्याओं को स्तरों में बाँटता है और अपना स्वास्थ्य स्कोर निकालता है। टूल-दर-टूल लेबल अलग होते हैं, पर छाँटने का तर्क एक ही है। स्कोर किसी एक टूल का, तय सेटिंग्स के साथ, रुझान दिखाने वाली रेखा है, वह कोई ग्रेड नहीं जो Google देता है। स्तरों को इस क्रम में देखें:
स्तर
आम समस्याएँ
पहला कदम
इंडेक्स योग्य पेजों पर त्रुटियाँ
उन URL पर 4xx या 5xx जवाब जिन्हें आप रैंक कराना चाहते हैं, टूटे आंतरिक लिंक
पहले उन्हें ठीक करें जिन पेजों पर पहले से क्लिक आ रहे हैं
उन पेजों पर त्रुटियाँ जिन्हें आप इंडेक्स नहीं कराना चाहते
टूटी आंतरिक खोज, फ़िल्टर या बंद हो चुके कैंपेन के URL
वे आंतरिक लिंक हटाएँ जो अब भी उनकी ओर इशारा करते हैं
चेतावनियाँ
बहुत लंबे टाइटल, गायब विवरण, दोहराए गए हेडिंग
बैच में ठीक करें, आदर्श रूप से एक ही टेम्प्लेट बदलाव से
सूचनाएँ
छोटे सुधार के सुझाव
एक बार देखें, और तभी कार्रवाई करें जब वे मनी पेजों पर बार-बार आएँ
दो स्कोर नहीं, दो क्रॉल की तुलना करें
साइट ऑडिट का सबसे उपयोगी नतीजा दो रनों के बीच का अंतर है। पिछले रन की समस्या-सूची एक्सपोर्ट करें, उन्हीं सेटिंग्स से दोबारा क्रॉल करें, और समस्या के प्रकार व URL के हिसाब से गिनती की तुलना करें। नई समस्याओं को पहले देखें, क्योंकि लाइव पेज पर नई त्रुटि आम तौर पर हाल की रिलीज़ के बाद आती है। किसी ज़िम्मेदार व्यक्ति को सौंपने से पहले हर नए समूह को अपने चेंज लॉग से मिलाएँ।
उदाहरण के लिए, एक रन 42 त्रुटियाँ बताता है। चार हफ़्ते बाद का दूसरा रन 57 बताता है, और उनमें से 15 नई त्रुटियाँ उस हफ़्ते लाइव हुए प्राइसिंग टेम्प्लेट पर हैं। आप टेम्प्लेट को एक बार ठीक करते हैं। अगर गिनती फिर लगभग 42 पर आ जाती है, तो सुधार काम कर गया, और यही रन अगले के लिए बेसलाइन बन जाता है।
रूटीन को इतना छोटा रखें कि उसे दोहराया जा सके
जो ऑडिट पूरा दिन लेता है, उसे दोहराया नहीं जाएगा। दायरा, एक्सक्लूड नियम और गंभीरता की तालिका को एक ही कॉन्फ़िगरेशन में सहेजें, ताकि अगला रन मिनटों में हो जाए। क्रॉल शेड्यूल करें, और हर बार वही तीन फ़ाइलें एक्सपोर्ट करें: समस्या-सूची, इंडेक्स योग्य URL और वे URL जो क्लिक पाते हैं। हमारी ऑटोमेटेड SEO रिपोर्टिंग गाइड बताती है कि क्या ऑटोमेट करें और उसे कैसे सेट करें।
अगर आप अब भी क्रॉलर चुन रहे हैं, तो हमारी तकनीकी SEO टूल तुलना विकल्पों को उनके काम के हिसाब से रैंक करती है। साइट ऑडिट को शेड्यूल करना तभी सार्थक है जब कोई रनों के बीच का अंतर पढ़ता हो। वरना वह फ़ोल्डर में एक और एक्सपोर्ट भर है।
इस हफ़्ते कहाँ से शुरू करें
अगर आपने कभी ऑडिट नहीं किया, तो चार काम क्रम से करें। Search Console का 90 दिनों का डेटा एक्सपोर्ट करें और तारीख़ के साथ सहेजें। अपने मुख्य टेम्प्लेट को किसी क्रॉलर से क्रॉल करें, और अगर साइट छोटी है तो मुफ़्त 500-URL संस्करण से शुरू करें। इंडेक्सिंग रिपोर्ट पढ़ें और कारणों को छाँटें। फिर मिली तीन सबसे बड़ी टेम्प्लेट-स्तरीय समस्याएँ ठीक करें, और अगले री-क्रॉल चक्र के बाद फिर से मापें।
एक्सपोर्ट करें क्वेरी और पेज डेटा, और बेसलाइन सहेजें।
हर टेम्प्लेट के लिए एक उदाहरण URL क्रॉल करें, और स्टेटस कोड, टाइटल, canonical और robots निर्देश दर्ज करें।
इंडेक्सिंग रिपोर्ट पढ़ें, और हर स्थिति को ज़िम्मेदार व्यक्ति वाले सवाल में बदलें।
तीन सबसे बड़ी टेम्प्लेट समस्याएँ ठीक करें, फिर अगले री-क्रॉल चक्र के बाद सर्च डेटा की तुलना करें।
एक अच्छा ऑडिट किसी दस्तावेज़ पर खत्म नहीं होता। वह सुधारों की एक छोटी सूची पर खत्म होता है जिसे कोई इसी महीने कर रहा है, और एक बेसलाइन पर जो साबित करती है कि वे काम आए या नहीं।
अक्सर पूछे जाने वाले सवाल
SEO ऑडिट में कितना समय लगता है?
यह साइट के आकार और आप कितनी गहराई में जाना चाहते हैं, इस पर निर्भर करता है। आपके मुख्य टेम्प्लेट और सर्च डेटा का केंद्रित ऑडिट कुछ दिनों में हो सकता है। कई टेम्प्लेट वाली किसी बड़ी साइट का पूरा ऑडिट ज़्यादा समय लेता है, और उस समय का ज़्यादातर हिस्सा क्रॉलिंग में नहीं, बल्कि निदान और प्राथमिकता तय करने में जाता है।
SEO ऑडिट के लिए मुझे कौन-से टूल चाहिए?
कम से कम Google Search Console और Screaming Frog SEO Spider जैसा एक क्रॉलर, साथ में स्पीड के लिए PageSpeed Insights। Analytics और सर्वर लॉग अतिरिक्त संदर्भ देते हैं। बैकलिंक और प्रतियोगी डेटा के लिए पेड SEO सुइट मदद करते हैं, लेकिन पहले ऑडिट के लिए ये ज़रूरी नहीं हैं।
SEO ऑडिट और SEO चेकलिस्ट में क्या फ़र्क है?
चेकलिस्ट उन जाँचों की सूची देती है जो चलानी हैं। ऑडिट उन जाँचों को आपकी साइट पर चलाता है, तय करता है कि कौन-से निष्कर्ष मायने रखते हैं, और सुधारों को उस ट्रैफ़िक के हिसाब से क्रमबद्ध करता है जो वे दाँव पर लगाते हैं। चेकलिस्ट से ऑडिट बनाएँ, और ऑडिट से काम चुनें।
y!
30 दिनों का अपना कंटेंट प्लान मुफ़्त में पाएँ
हम आपके प्रतिस्पर्धियों, आपकी वेबसाइट और आपकी AI दृश्यता का विश्लेषण करते हैं, ताकि मुफ़्त में आपके लिए एक अनुकूल कंटेंट योजना बनाई जा सके।
“मैंने Sorank को एक असली क्लाइंट की साइट पर आज़माया और यह कमाल का है। यह वह सब कुछ करता है जिसके लिए एक एजेंसी आपसे हर महीने $1500 वसूलती है। अब उस क्लाइंट के लिए इसे प्रोडक्शन में डाला जा रहा है।”Guillaume Guersanguersanguillaume.com
“हम एक Ads एजेंसी हैं और हम अपने SEO को एक बार और हमेशा के लिए सही रास्ते पर लाना चाहते थे। Sorank ने हमें हमारी साइट की साफ तस्वीर दी, ऑप्टिमाइज़ेशन को प्राथमिकता देने में मदद की, और हमारे कंटेंट को सही तरीके से व्यवस्थित किया। टूल इस्तेमाल में आसान है, टीम के लिए अच्छी तरह डिज़ाइन किया गया है, और कई प्लेटफ़ॉर्म के बीच भागदौड़ किए बिना ट्रैकिंग को एक जगह रखने के लिए बहुत व्यावहारिक है। नए सिरे से SEO शुरू करने के लिए एक बहुत मज़बूत आधार।”Gaspard MadouiAds एजेंसी
“Sorank की बदौलत मैं GEO में विशेषज्ञ बन गई। GEO रैंकिंग मुझे ChatGPT पर क्लाइंट्स को उनकी प्रतियोगियों के मुकाबले उनकी पोज़िशन दिखाने देती है। यह एक असली व्यावसायिक अंतर है।”Mélanieफ्रीलांस SEO
“बेहतरीन सेवा है, हमारी वेबसाइट के लिए अच्छा काम करती है, और यह समझने में मदद करती है कि इसे कैसे सुधारें ताकि Google और दूसरी जगहों पर बेहतर रैंक हो। बधाई, ऐसे ही आगे बढ़ते रहिए। इसकी सिफ़ारिश है।”Hugo T.E-commerce व्यापारी


 Search Console