La privacy è importante per noi, quindi hai la possibilità di disabilitare alcuni tipi di archiviazione che potrebbero non essere necessari per il funzionamento di base del sito web. Il blocco delle categorie può influire sulla tua esperienza sul sito web. Ulteriori informazioni (Politica sui cookie)
Grazie! La tua richiesta è stata ricevuta!
Ops! Qualcosa è andato storto durante l'invio del modulo.
Strategia di link interni: il piano da esperti, dalle pagine prioritarie ai siti multilingue
Costruisci la tua strategia di link interni: pagine prioritarie, cluster, ancore, i 3 modelli a confronto, un piano in 7 passi e gli errori da correggere.
Un team pianifica la struttura di un sito web su una lavagna, con pagine collegate da linee.
Strumenti
In questa pagina
In breve
una strategia di link interni è un piano scritto che decide quali pagine ricevono link, da quali pagine e con quale testo di ancoraggio. Si regge su tre pilastri: un breve elenco di pagine prioritarie, cluster tematici che raggruppano i contenuti affini e regole per le ancore. Scegliete un modello di collegamento (una rete fitta «Wikipedia», un cocoon semantico o un silo basato sulla struttura degli URL), applicatelo con un crawler e poi misurate ogni mese link in entrata, profondità di clic e clic.
3 giorni gratis, poi smetti quando vuoi. Garanzia di risultati di 90 giorni, soggetta a condizioni.
Questa guida va oltre la definizione. Se vi servono solo le basi su cos'è un link interno, leggete prima la nostra definizione di link interni. Qui trattiamo il piano: come si muove il valore dei link in un sito, come scegliere le pagine che lo meritano, i tre modelli principali di collegamento con i loro compromessi, un metodo passo passo, i numeri da monitorare e gli errori che fanno perdere posizioni senza che ve ne accorgiate, compresi quelli tipici dei siti multilingue.
Cos'è una strategia di link interni (e cosa non è)
La maggior parte dei siti aggiunge link interni un articolo alla volta: un redattore ricorda un vecchio post e lo collega. Questa è una tattica. Una strategia funziona al contrario. Prima decidete dove volete che finisca l'autorevolezza, poi ogni nuovo link serve a quell'obiettivo.
Una vera strategia risponde per iscritto a quattro domande:
Quali pagine contano di più per il business e hanno bisogno di più link interni?
Quali pagine stanno insieme per argomento e come si collegano tra loro?
Quale testo di ancoraggio punta a ciascuna pagina importante e quali sono vietati?
Quale modello di collegamento segue il sito, in modo che ogni redattore e ogni template applichino la stessa logica?
Perché ai motori di ricerca interessano i link interni
I link interni svolgono tre compiti insieme. Permettono ai crawler di scoprire le pagine. Trasmettono una quota di autorevolezza (la logica alla base del PageRank). E le loro ancore, insieme al testo circostante, dicono a Google di cosa parla la pagina di destinazione. La documentazione di Google sui link sottoponibili a scansione lo dice chiaramente: «Ogni pagina che vi sta a cuore dovrebbe avere un link da almeno un'altra pagina del vostro sito.» La stessa pagina aggiunge che non esiste un numero ideale di link per pagina.
I motori di ricerca basati sull'IA si appoggiano agli stessi segnali. I loro crawler seguono i link per trovare le pagine, e una pagina sepolta a sei clic viene raramente recuperata, quindi raramente citata. Una struttura interna pulita aiuta sia Google sia i motori di risposta.
Cosa dicono i dati
Il più grande studio pubblico sul tema è di Cyrus Shepard di Zyppy (aggiornato il 23 febbraio 2026). Ha analizzato 23 milioni di link interni su 1800 siti e li ha confrontati con i clic della Search Console. È uno studio di correlazione: leggetelo come una direzione, non come una legge. La direzione, però, è chiara.
Cosa ci dicono 23 milioni di link interni
4xpiù clic da Google per gli URL con 40-44 link interni rispetto agli URL con 0-4
5xpiù traffico per le pagine con almeno un'ancora a corrispondenza esatta
50%più traffico, quasi, per le pagine che ricevono anche ancore con URL nudo
6%dei link interni non aveva alcun testo di ancoraggio
Fonte: Cyrus Shepard, studio Zyppy sui link interni (1800 siti, 520000 URL), aggiornato a febbraio 2026
Altri due risultati contano per il vostro piano. Il traffico ha smesso di crescere oltre circa 45-50 link, molto probabilmente perché quei link in più erano link di menu presenti su tutto il sito che puntavano a pagine deboli. E la varietà delle ancore che puntano a una pagina era fortemente correlata a più clic. Potete leggere lo studio Zyppy sui link interni completo per i grafici.
Come si muove davvero il valore dei link in un sito
Prima di pianificare serve un modello mentale di come scorre il valore. In modo semplificato: ogni pagina ha una certa quantità di autorevolezza (dai backlink e dai link interni che riceve). La divide tra i link che contiene. Un link nel testo principale, che ha buone probabilità di essere cliccato, conta più di un link nascosto nel footer. È l'idea del «surfer ragionevole» descritta in un brevetto di Google: i link non pesano tutti allo stesso modo.
Profondità di clic
La profondità di clic è il numero di clic dalla home page a una pagina. La home page di solito concentra più autorevolezza, quindi ogni livello in più diluisce ciò che arriva alla pagina. Una regola comune è tenere le pagine importanti entro tre clic. La profondità incide anche sulla frequenza di scansione: sui siti grandi con un crawl budget ridotto, le pagine profonde vengono visitate meno spesso e aggiornate più tardi nell'indice.
I cinque tipi di link interni
Non tutti i link hanno lo stesso ruolo. La vostra strategia deve dire a cosa serve ciascun tipo.
Tipo di link
Dove si trova
Ruolo principale
Peso come segnale
Cosa decidere
Link contestuale
Dentro il corpo del testo
Trasmettere pertinenza e autorevolezza tra pagine affini
Alto: circondato da testo tematico, probabile che venga cliccato
Quali pagine collegano dove, con quale ancora
Navigazione principale
Menu in testata, su ogni pagina
Dare alle sezioni principali un link da ogni URL
Medio: su tutto il sito, poco contesto
Solo 5-9 sezioni principali, mai pagine di coda lunga
Breadcrumb
Sopra il titolo
Spingere valore verso le categorie superiori, mostrare la gerarchia
Medio: strutturato, ancore coerenti
La logica del percorso e il markup BreadcrumbList
Blocco di contenuti correlati
Fine di un articolo o di una scheda prodotto
Collegare le pagine sorelle di un cluster
Medio: si può automatizzare
Regole: prima lo stesso cluster, poi i cluster vicini
Footer
In fondo a ogni pagina
Note legali, contatti, poche pagine chiave
Basso: Google svaluta ciò che si ripete
Tenerlo breve, evitare 80 link con parole chiave
La conseguenza pratica: quando volete rafforzare una pagina, i link contestuali da pagine forti e affini sono la prima leva. I link di menu sono la seconda, e sono una risorsa scarsa.
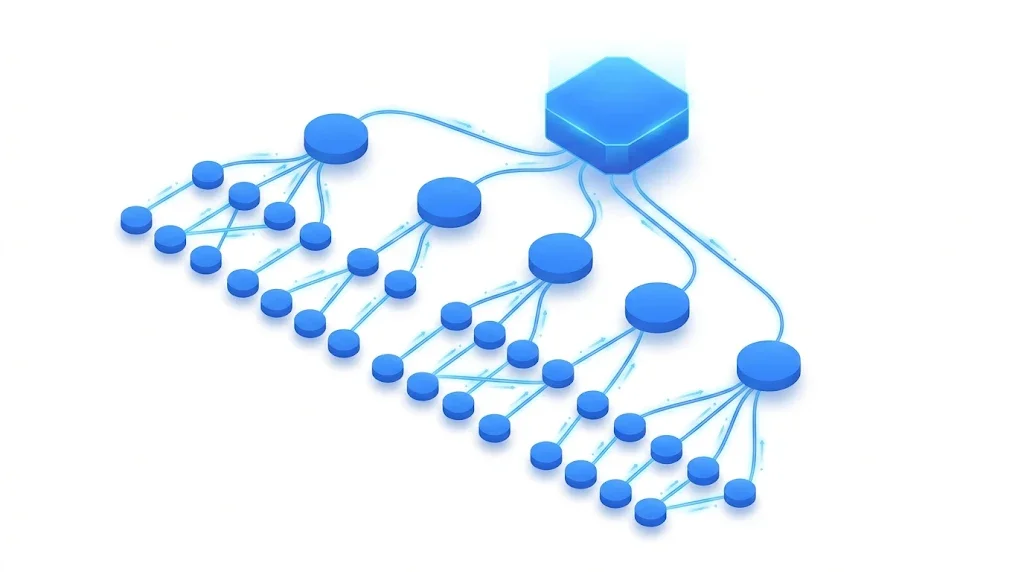
Una strategia di link interni decide dove fluisce l'autorevolezza: dalle pagine forti a quelle che contano di più.
Pilastro 1: scegliere le pagine prioritarie
Una strategia parte da un elenco breve. Se ogni pagina è prioritaria, nessuna lo è. Servono da 10 a 30 pagine per sezione del sito che ricevano la maggior parte dei link interni: le pagine che vendono, quelle che si posizionano già vicino al vertice e le guide che le sostengono.
Dove trovarle
Incrociate tre fonti:
Valore per il business: pagine di prodotto, servizio, prezzi e demo. Sono le pagine su cui volete che atterrino le persone.
Search Console: query posizionate dalla 4 alla 20 con impressioni reali. Pochi link interni forti bastano spesso a portare una pagina dalla posizione 8 alla 4. Filtrate il rapporto Rendimento per pagina, ordinate per impressioni e tenete le pagine con posizione media tra 4 e 20.
Backlink: pagine che ricevono molti link esterni. Hanno autorevolezza che potete ridistribuire alle pagine che ne hanno bisogno. Una pagina con 40 domini di riferimento e nessun link contestuale in uscita è potenziale sprecato.
Da tutti gli URL all'elenco prioritario
Tutti gli URL indicizzabiliScansione completa
Pagine con domanda di ricercaImpressioni in Search Console
Pagine vicine alla pagina 1Posizioni da 4 a 20
Pagine con valore per il businessRicavi o contatti
Pagine prioritarieDa 10 a 30 per sezione
Dare a ogni pagina prioritaria un ruolo e un obiettivo
Per ogni pagina dell'elenco, annotate nel piano tre cose: la query principale a cui punta, il cluster a cui appartiene e un numero obiettivo di link contestuali in entrata. Una griglia di partenza praticabile: pagine di conversione e guide pilastro con 10 o più link contestuali unici, articoli di cluster con 3-8, pagine di servizio con 0-2. Sono obiettivi di lavoro, non regole di Google. Adattateli alle dimensioni del sito: un sito di 60 pagine non può dare 15 link a 20 pagine.
Le pagine che fanno da ancoraggio al sito sono spesso chiamate contenuti cornerstone. La nostra guida ai contenuti cornerstone spiega come sceglierli e scriverli perché meritino i link che inviate loro.
Pilastro 2: costruire cluster tematici
Il secondo pilastro raggruppa le pagine per argomento. Un cluster è una pagina pilastro che copre un tema ampio, circondata da articoli più stretti che rispondono ciascuno a una domanda specifica. Pilastro e articoli si collegano a vicenda. Il risultato: Google vede un blocco di pagine che copre un tema in profondità, il che costruisce autorevolezza tematica, e ogni pagina trasmette pertinenza alle vicine.
Come costruire una mappa dei cluster in 5 passi
Elencare le queryEsportate le query di Search Console e la ricerca di parole chiave in un unico foglio.
Raggruppare per intento di ricercaLe query che restituiscono gli stessi risultati di Google appartengono alla stessa pagina. Risultati diversi significano pagine diverse.
Dare un nome al pilastroIl gruppo più ampio diventa la pagina pilastro. Ogni altro gruppo diventa un articolo del cluster.
Assegnare gli URL esistentiAssociate ogni pagina esistente a un solo gruppo. Due pagine su un gruppo sono un caso di cannibalizzazione da unire.
Tracciare i linkDal pilastro a ogni articolo, da ogni articolo al pilastro, dagli articoli solo ai loro fratelli più vicini.
Le regole di collegamento dentro un cluster
Dal pilastro agli articoli: un link contestuale per articolo, nella sezione che introduce il suo sottotema.
Dagli articoli al pilastro: un link, presto nel testo, con un'ancora vicina alla query principale del pilastro.
Da articolo ad articolo: solo quando il lettore ha davvero bisogno dell'altra pagina subito dopo. Due o tre link a pagine sorelle per articolo bastano e avanzano.
Tra cluster: consentito, ma in modo deliberato, da una frase che fa da ponte tra i due argomenti.
Raggruppare le query in base ai risultati di Google che condividono è il cuore del clustering delle parole chiave, e il modello completo di pilastro e satelliti è descritto nella nostra guida ai cluster tematici e alle pagine pilastro. Se volete una mappa già pronta, il generatore di cluster tematici di Sorank raggruppa le parole chiave in cluster e segnala le sovrapposizioni che causerebbero cannibalizzazione.
Pilastro 3: fissare le regole per il testo di ancoraggio
L'ancora è il testo cliccabile di un link. Google la legge come una breve descrizione della pagina di destinazione. La sua documentazione chiede ancore «descrittive, ragionevolmente concise e pertinenti» sia per la pagina in cui si trovano sia per quella a cui puntano, e mette in guardia contro testi generici come «clicca qui» e contro l'accumulo di parole chiave.
Le regole da scrivere
Un'ancora principale per pagina prioritaria, vicina alla sua query obiettivo, usata in alcuni link (non in tutti).
Variazioni intorno ad essa: corrispondenze parziali, sinonimi, domande, il titolo della pagina. I dati di Zyppy collegano la varietà delle ancore a più clic.
Mai la stessa ancora per due pagine diverse. Se «audit dei link interni» punta alla pagina A in un articolo e alla pagina B in un altro, dite a Google che entrambe le pagine rispondono alla stessa query. È una strada diretta verso la cannibalizzazione delle parole chiave.
Nessuna ancora generica nei link contestuali: «qui», «questo articolo», «leggi tutto».
Ancore che si leggono da sole. Google suggerisce un test semplice: leggete l'ancora isolata. Se non dice di cosa parla la destinazione, riscrivetela.
Testo di ancoraggio: prima e dopo una pulizia
Prima
«Clicca qui» verso la pagina dei prezzi
La stessa ancora che punta a due guide
Ancora ripiena: «miglior strumento audit SEO economico gratis 2026»
Link su immagine con attributo alt vuoto
Dopo
«confronta i nostri piani tariffari»
Una famiglia di ancore per pagina di destinazione
«fai un audit SEO gratuito»
Testo alt descrittivo, letto da Google come ancora
Nel codice, la differenza è questa. L'ultimo esempio riguarda i link su immagine: Google usa l'attributo alt come testo di ancoraggio.
<!-- Debole: ancora generica, senza contesto -->
<p>Per saperne di più, <a href="/it/blog-geo-seo/architettura-sito-seo">clicca qui</a>.</p>

<!-- Forte: ancora descrittiva dentro una frase pertinente -->
<p>Le pagine sepolte troppo in profondità vengono scansionate meno spesso, quindi controllate
prima la vostra <a href="/it/blog-geo-seo/architettura-sito-seo">profondità di scansione per directory</a>.</p>

<!-- Link su immagine: il testo alt diventa l'ancora -->
<a href="/it/prezzi"><img src="/img/plans.png" alt="Piani tariffari Sorank"></a>
Per un elenco completo dei tipi di ancora (esatta, parziale, di brand, URL nudo, generica), consultate la nostra guida al testo di ancoraggio.
Le tre strategie di link interni a confronto
Una volta definiti i pilastri, scegliete come si collegano le pagine. Ci sono tre modelli principali. La maggior parte dei siti reali li combina, ma uno deve guidare, altrimenti ogni redattore segue una logica diversa.
1. La strategia «Wikipedia»: collegare ogni pagina correlata
Principio. Ogni volta che una pagina cita un concetto che ha una pagina propria, la collega. I link vanno in ogni direzione tra tutte le pagine vicine, come su Wikipedia, dove un articolo può contenere centinaia di link interni.
Quando usarla. Grandi basi di conoscenza, glossari, documentazione, siti editoriali, qualsiasi sito in cui i lettori saltano da concetto a concetto.
Vantaggi. Profondità di clic molto bassa, scoperta rapida delle nuove pagine, molte variazioni di ancore, ottima per i lettori che esplorano. È semplice da applicare: se un termine ha una pagina, lo si collega.
Limiti. L'autorevolezza si distribuisce in modo uniforme, quindi non potete spingere poche pagine prioritarie. Su un sito piccolo con poca autorevolezza, la diluizione fa male. I confini tematici si sfumano e Google riceve un segnale più debole su cosa copre ciascuna sezione.
Esempio. Una voce di glossario sul «crawl budget» collega «scansione», «robots.txt», «sitemap», «file di log» ed «errori del server» nei primi paragrafi, e ciascuna di quelle pagine collega a sua volta.
2. Il cocoon semantico: pagine madre, figlie e sorelle
Principio. Reso popolare in Francia da Laurent Bourrelly con il nome «cocon sémantique», il cocoon organizza le pagine in una gerarchia rigida costruita a partire dall'intento di ricerca. Una pagina madre copre un intento ampio. Le pagine figlie coprono intenti più stretti al di sotto. Le pagine dello stesso livello sono sorelle. I link seguono regole precise: la madre collega tutte le sue figlie; ogni figlia collega verso l'alto la sua madre; una figlia collega le sorelle solo quando l'argomento scorre in modo naturale; e nulla collega fuori dal cocoon se non tramite la pagina in cima.
Quando usarlo. Nicchie competitive in cui l'autorevolezza tematica fa la differenza, siti che costruite da zero, sezioni che potete pianificare per intero prima di scrivere.
Vantaggi. Il segnale di pertinenza più forte dei tre modelli. L'autorevolezza si concentra dove la volete, perché i link risalgono verso la pagina madre. Ogni pagina ha un ruolo chiaro, il che previene la cannibalizzazione.
Limiti. Pesante da pianificare e da mantenere. Regole rigide possono forzare link artificiali o vietarne di utili. Difficile da applicare a posteriori su un sito esistente con anni di link non pianificati. I puristi vietano i link fuori dal cocoon, il che può danneggiare il lettore.
Esempio. Pagina madre: «scarpe da running». Figlie: «scarpe da trail», «scarpe da strada», «scarpe da running per piede piatto». Nipoti sotto «scarpe da trail»: «scarpe da trail impermeabili», «scarpe da trail per il fango». La pagina sulle impermeabili collega verso l'alto la pagina trail e di lato la pagina fango, mai direttamente la pagina strada.
La nostra guida completa al cocoon semantico spiega come costruirne uno livello per livello.
3. Il silo per URL: struttura per directory e breadcrumb
Principio. La gerarchia è scritta negli indirizzi. Ogni sezione ha una directory, ogni pagina sta nella directory del proprio argomento e il breadcrumb ricalca quel percorso. I link restano per lo più dentro il proprio silo: le pagine collegano la pagina della directory superiore e le sorelle della stessa directory.
/seo/                                  pagina di sezione (pilastro)
/seo/technical/                        pagina di categoria
/seo/technical/crawl-depth/            articolo
/seo/technical/orphan-pages/           articolo
/seo/content/                          pagina di categoria
/seo/content/topic-clusters/           articolo
Quando usarlo. Negozi online, cataloghi, siti di servizi locali, qualsiasi sito con un albero naturale di categorie. Si adatta anche ai team con molti redattori, perché la regola è visibile nell'indirizzo stesso.
Vantaggi. Facile da capire per tutti. Il breadcrumb crea in automatico link verso l'alto coerenti. I rapporti per directory (scansione, traffico, indicizzazione) diventano banali. È il modello che la maggior parte delle architetture di sito già segue, come spiega la nostra guida all'architettura del sito per la SEO.
Limiti. Una pagina può stare in una sola directory, mentre gli argomenti reali si sovrappongono. Spostare una pagina più tardi significa cambiarne l'URL e aggiungere un redirect. I silo rigidi bloccano utili link incrociati tra sezioni.
Quale modello dovrebbe guidare su un tipico sito aziendale?
Rete Wikipedia pura
Veloce da applicare
Bassa profondità di clic
Nessun modo di spingere le pagine prioritarie
Confini tematici sfumati
Silo o cocoon come ossatura, rete dentro i cluster
L'autorevolezza va alle pagine che vendono
Segnale tematico chiaro per sezione
I lettori ricevono comunque utili link incrociati
Richiede un piano scritto
La nostra raccomandazione per la maggior parte dei siti: usate il silo per URL o il cocoon come ossatura (decide dove finisce l'autorevolezza) e consentite una rete leggera dentro ogni cluster (mantiene le pagine utili per i lettori). Tenete i link tra silo rari e deliberati.
Passo passo: costruire e mettere in opera il piano
Ecco il metodo che usiamo, dall'audit alla messa in opera. Su un sito di qualche centinaio di pagine, calcolate da due a tre giorni di lavoro per il primo passaggio.
La messa in opera in 7 passi
Scansionare il sitoEsportate ogni URL indicizzabile con link in entrata, link in entrata unici, profondità di scansione e Link Score.
Trovare le orfaneConfrontate la scansione con la sitemap e con le pagine di Search Console. Tutto ciò che manca nella scansione non ha alcun link interno.
Correggere la strutturaPortate le pagine prioritarie a 3 clic, ripulite menu e footer, aggiungete i breadcrumb.
Scrivere il pianoUn foglio solo: pagine prioritarie, cluster, ancora principale, variazioni, link in entrata obiettivo, pagine di origine.
Aggiungere link contestualiPartite dalle pagine più forti (più backlink, più traffico) verso le pagine prioritarie.
Correggere redirect interni e link rottiOgni link interno deve puntare direttamente a un URL finale con codice 200.
Misurare e ripetereRiscansionate ogni mese, confrontate link in entrata e posizioni, aggiustate il piano ogni trimestre.
Passo 1: scansionare ed esportare
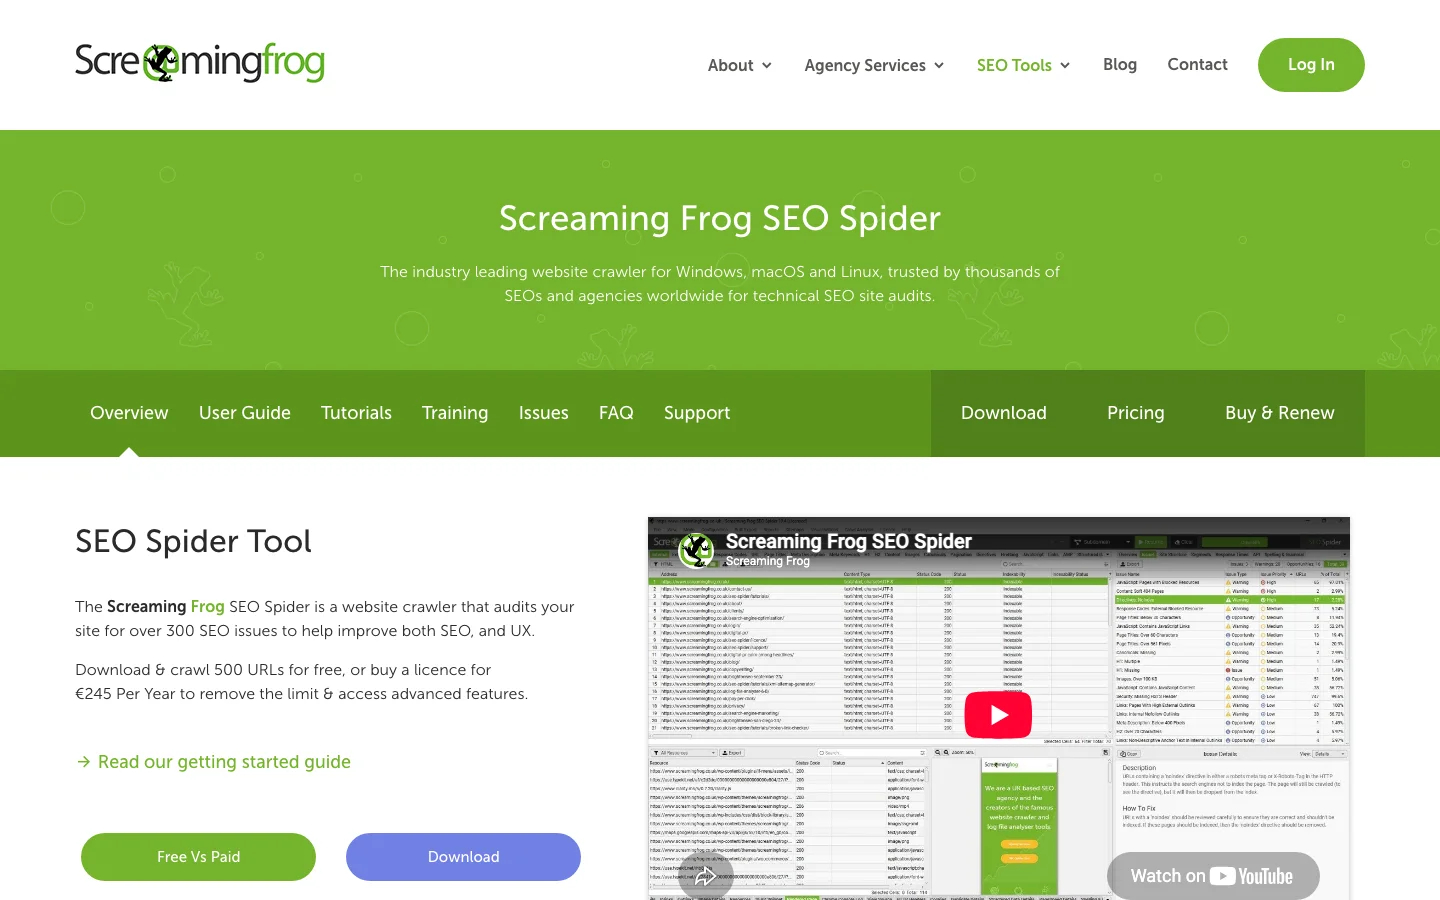
Usate un crawler come Screaming Frog SEO Spider. La versione gratuita scansiona fino a 500 URL, abbastanza per molti siti di piccole aziende. La nostra guida alla configurazione di Screaming Frog copre le impostazioni.
Screaming Frog SEO Spider: la versione gratuita scansiona fino a 500 URL e riporta link interni, profondità di scansione e Link Score.
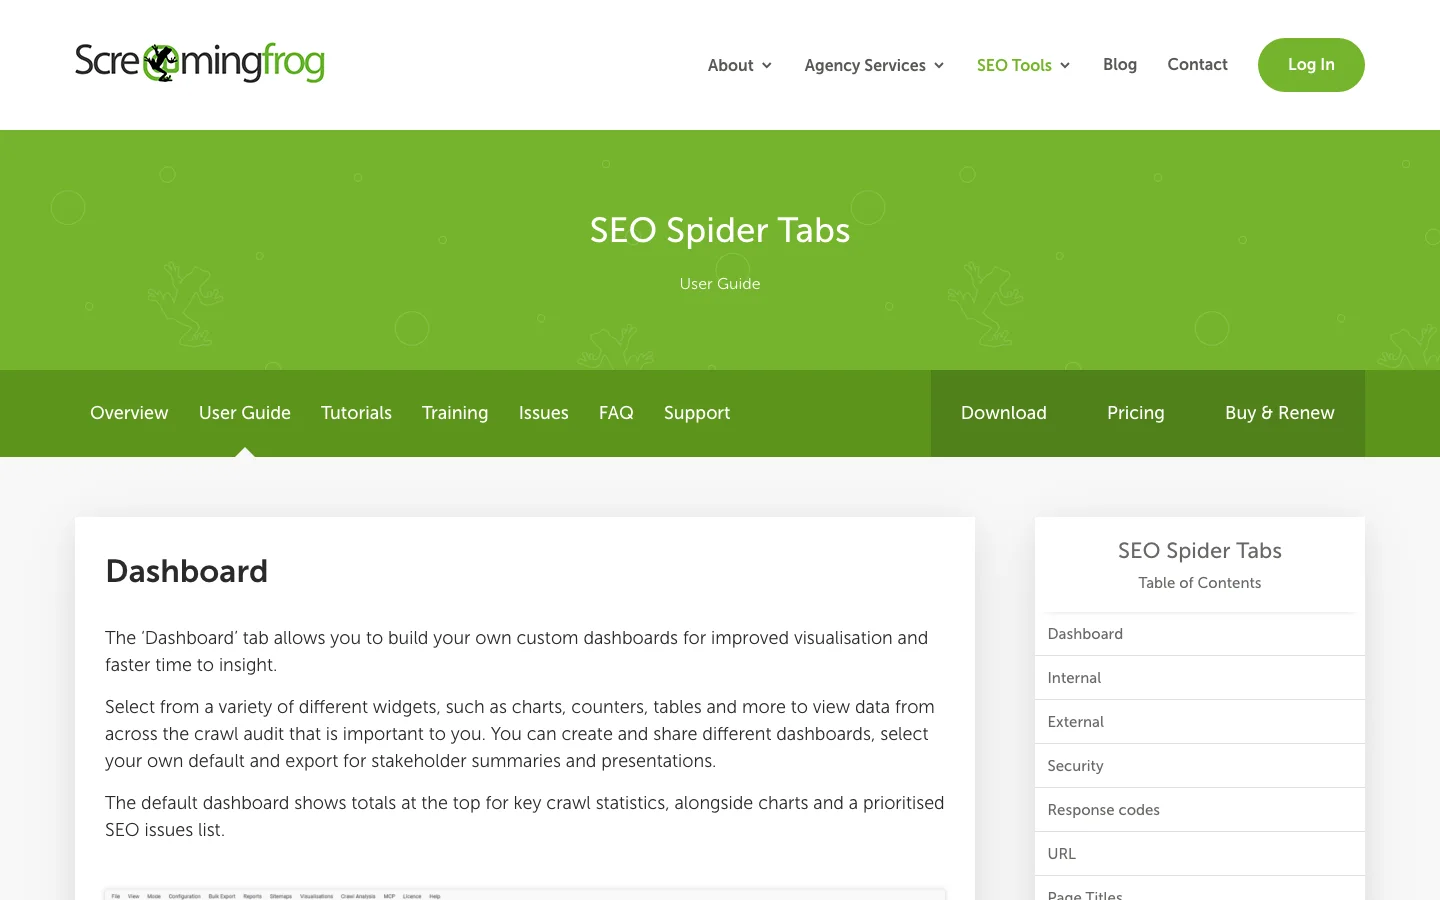
Nella scheda Internal, quattro colonne guidano il piano. La documentazione di Screaming Frog le definisce: Inlinks (numero di link interni verso l'URL), Unique Inlinks (una pagina collegata tre volte dalla stessa pagina conta una volta), Crawl Depth (clic dalla pagina iniziale) e Link Score (una metrica da 0 a 100 del valore relativo di una pagina in base ai suoi link interni, calcolata dopo un'analisi della scansione).
La guida utente di Screaming Frog definisce Inlinks, Unique Inlinks, Crawl Depth e Link Score.
Passo 2: trovare le pagine orfane con una formula
Un crawler trova solo le pagine collegate. Per trovare le orfane, confrontate l'elenco di tutti gli URL noti (sitemap XML più esportazione delle Pagine di Search Console) con la scansione. In Google Sheets, mettete tutti gli URL noti nella colonna A di un foglio «Known» e gli URL scansionati nella colonna A di un foglio «Crawl», poi usate questa formula (scritta con la sintassi inglese: se il vostro foglio di calcolo è in italiano, cambiano i nomi delle funzioni e il separatore):
Ogni URL restituito è noto a Google o alla vostra sitemap ma non riceve alcun link interno. Decidete per ciascuno: collegarlo dal suo cluster, unirlo a una pagina più forte o rimuoverlo con un redirect.
Passi da 3 a 5: correggere la struttura, poi aggiungere link dalla forza
Ordinate la scansione per Link Score o per domini di riferimento. Le vostre prime 20 pagine sono le donatrici. Per ogni pagina prioritaria, trovate da due a cinque donatrici su un argomento affine e aggiungete un link contestuale da ciascuna, con un'ancora presa dal piano. Mettere il link nella prima metà del testo, dentro una frase che spiega perché il lettore dovrebbe cliccare, segue la logica del surfer ragionevole.
Consiglio
Prima di modificare, controllate a cosa già punta una pagina. L'analizzatore di link interni gratuito di Sorank elenca ogni link interno di una pagina con la sua ancora, così individuate in pochi secondi ancore generiche e duplicati.
Passo 6: eliminare i redirect interni
Quando un URL cambia, i vecchi link interni continuano a puntare al redirect. Ogni salto spreca scansione e può perdere un po' di segnale. Dopo ogni migrazione, esportate i link interni la cui destinazione restituisce un 301 o un 302 e sostituiteli con l'URL finale. La nostra guida ai redirect SEO spiega i codici di stato, e il controllo dei link rotti gratuito trova i link morti su qualsiasi pagina.
Come misurare una strategia di link interni
Monitorate un piccolo insieme di numeri, nello stesso modo ogni mese, partendo dalle pagine prioritarie.
Metrica
Dove leggerla
Come appare un buon risultato
Azione se è fuori linea
Link contestuali in entrata unici
Crawler, scheda Internal
Pari o sopra l'obiettivo del piano
Aggiungere link dalle pagine donatrici
Profondità di scansione
Crawler
3 o meno per le pagine prioritarie
Collegare dal menu, da un hub o da una pagina di categoria
Pagine orfane
Sitemap e Search Console confrontate con la scansione
Zero tra le pagine che volete indicizzate
Collegare, unire o reindirizzare
Link interni verso redirect o errori
Crawler, codici di risposta delle destinazioni
Zero
Sostituire con l'URL finale
Posizione media e clic
Search Console, Rendimento per pagina
In crescita da 4 a 12 settimane dopo la pubblicazione dei link
Controllare le ancore e il contenuto stesso
Pagine indicizzate
Search Console, rapporto Pagine
Tutte le pagine prioritarie indicizzate
Ispezionare l'URL, verificare che i link siano scansionabili
Search Console fornisce i clic, le posizioni e lo stato di indicizzazione che servono per misurare l'effetto dei nuovi link interni.
Annotate la data di ogni lotto di nuovi link nel piano. Senza, non potete capire in Search Console se un cambio di posizionamento è venuto dai link, dal contenuto o da un aggiornamento dell'algoritmo.
Errori comuni nei link interni (e come correggerli)
Ognuno degli errori che seguono è frequente sui siti reali. Per ciascuno: cos'è, come individuarlo, come correggerlo.
1. Pagine orfane
Cos'è. Una pagina a cui non punta alcun link interno. Google può conoscerla comunque dalla sitemap, ma non riceve autorevolezza e poca scansione.
Come individuarlo. Il confronto tra sitemap e scansione del passo 2.
Come correggerlo. Collegatela dal suo pilastro e da una o due sorelle. Se nessuna pagina la collega in modo naturale, probabilmente non dovrebbe esistere da sola: unitela.
2. Pagine prioritarie sepolte troppo in profondità
Cos'è. Una pagina chiave per il business a cinque o sei clic dalla home page, spesso perché compare solo a pagina 4 di un blog paginato.
Come individuarlo. Filtrate la scansione per profondità maggiore di 3 e incrociatela con l'elenco delle priorità.
Come correggerlo. Aggiungetela a una pagina hub o di categoria, al menu pertinente, oppure collegatela da un articolo forte. Evitate di affidarvi alla sola paginazione per raggiungere i contenuti.
3. La stessa ancora che punta a più pagine
Cos'è. Due URL diversi ricevono la stessa ancora, così Google non sa quale risponda alla query.
Come individuarlo. Esportate tutti i link interni (ancora e destinazione), fate una tabella pivot per ancora e contate le destinazioni distinte. Ogni ancora con più di una destinazione è un campanello d'allarme.
Come correggerlo. Riassegnate ogni ancora a una sola pagina. Se entrambe le pagine rispondono davvero alla stessa query, unitele.
4. Link che Google non può seguire
Cos'è. Una navigazione costruita con pulsanti, eventi onclick o componenti di framework che non generano mai un vero link. Google afferma di seguire in modo affidabile gli elementi <a> con un attributo href, e che markup come <span href>, <a onclick> o URL javascript: non sono affidabili.
Come individuarlo. Scansionate con il rendering JavaScript disattivato, poi attivato. Le pagine trovate solo con il rendering attivo, o non trovate affatto, dipendono da link fragili. Lo strumento di ispezione URL di Search Console mostra l'HTML sottoposto a rendering.
Come correggerlo. Generate ogni link di navigazione come <a href="/it/blog-geo-seo/architettura-sito-seo">. La nostra guida alla SEO per JavaScript copre il lato del rendering.
5. Nofollow sui link interni
Cos'è. Aggiungere rel="nofollow" ai link interni per «scolpire» l'autorevolezza. Non trattiene l'autorevolezza sulla pagina, impedisce semplicemente che passi attraverso quel link.
Come individuarlo. Nel crawler, filtrate i link interni per l'attributo nofollow.
Come correggerlo. Togliete il nofollow dai link interni. Se una pagina non deve ricevere autorevolezza, rimuovete il link o mettete la pagina in noindex. Vedete la nostra pagina sui link nofollow.
6. Menu e footer gonfiati
Cos'è. Un mega menu con 150 link o un footer che elenca 80 pagine di parole chiave. Allora ogni pagina collega tutto, il che appiattisce le vostre priorità. I dati di Zyppy mostrano anche un traffico in calo oltre circa 50 link, probabilmente per questo tipo di link presenti su tutto il sito.
Come individuarlo. Contate i link nei template di testata e footer. Se i link presenti su tutto il sito superano quelli contestuali sulla maggior parte degli articoli, domina il template.
Come correggerlo. Tenete da 5 a 9 voci di primo livello nel menu, spostate le liste lunghe su pagine hub e riservate il footer a note legali, contatti e una manciata di pagine chiave.
7. Link interni tra lingue che non corrispondono
I siti multilingue aggiungono una famiglia di errori che la maggior parte delle guide salta. Per Google le versioni linguistiche sono pagine separate, e i link dicono a Google quali versioni stanno insieme. La nostra guida alla SEO internazionale copre l'impostazione generale; qui ci sono gli errori di collegamento.
7a. Una pagina in una lingua che collega una pagina in un'altra. Un articolo in francese collega la versione inglese di una guida, spesso perché un traduttore ha mantenuto il link originale. Il lettore francese atterra su contenuto in inglese e se ne va, e la guida francese perde un link interno che avrebbe dovuto ricevere.
Come individuarlo. In Screaming Frog, eseguite Bulk Export, Links, All Inlinks, poi filtrate le righe la cui origine è in una cartella di lingua e la destinazione in un'altra. Con cartelle come /fr/ e /en/, queste due espressioni regolari isolano le pagine francesi che collegano qualsiasi altra cartella di lingua:
Come correggerlo. Sostituite ogni link con la pagina equivalente nella stessa lingua. Gli unici link tra lingue che hanno posto nel corpo del testo sono il selettore di lingua e i rimandi deliberati («questo studio è disponibile solo in inglese»).
7b. Versioni che non puntano alla loro traduzione. La pagina francese ha un equivalente inglese, ma nulla le collega: niente hreflang, nessun selettore di lingua che punti alla traduzione esatta (il selettore porta alla home page inglese). Google può allora trattarle come pagine non correlate, o mostrare la lingua sbagliata nei risultati.
Come individuarlo. Controllate il selettore di lingua su un campione di pagine profonde: porta alla pagina tradotta o a una home page? Poi controllate i tag hreflang delle stesse pagine.
Come correggerlo. Fate puntare il selettore all'URL equivalente esatto e dichiarate ogni versione con hreflang. La documentazione di Google sulle versioni localizzate è severa: «Ogni versione linguistica deve elencare sé stessa e tutte le altre versioni linguistiche», e «se due pagine non puntano l'una all'altra, i tag verranno ignorati.»
<!-- Sulla pagina inglese E su quella francese -->
<link rel="alternate" hreflang="en" href="https://sorank.com/blog-geo-seo/site-architecture-seo" />
<link rel="alternate" hreflang="fr" href="https://sorank.com/fr/blog-geo-seo/architecture-site-seo" />
<link rel="alternate" hreflang="x-default" href="https://sorank.com/blog-geo-seo/site-architecture-seo" />
7c. Hreflang e link interni che raccontano storie diverse. L'hreflang dice che la pagina A in francese corrisponde alla pagina B in inglese, ma il canonical della pagina B punta altrove, oppure il selettore collega la pagina C, oppure i link interni francesi puntano a un URL reindirizzato mentre l'hreflang elenca quello finale. Google riceve segnali contraddittori e può ignorare il gruppo hreflang.
Come individuarlo. Su un campione di pagine, scrivete quattro URL affiancati: la destinazione dell'hreflang, la destinazione del selettore, il canonical della pagina di destinazione e l'URL finale dopo i redirect. Tutti e quattro devono essere identici.
Come correggerlo. Generate hreflang, canonical e link del selettore dalla stessa fonte di verità nel CMS (una tabella di traduzioni), mai a mano. Il generatore di hreflang gratuito di Sorank costruisce un insieme corretto e reciproco di tag, e la nostra guida all'hreflang spiega ogni attributo.
Attenzione
Gli slug tradotti cambiano l'URL in ogni lingua. Quando traducete un articolo, traducete anche i suoi link interni: ogni link deve puntare alla versione della pagina di destinazione nella stessa lingua, con uno slug che esista in quella lingua.
8. Collegare una volta e non farlo mai più
Cos'è. I nuovi articoli ricevono link verso i vecchi, ma i vecchi non collegano mai i nuovi. Le pagine fresche restano deboli per mesi.
Come individuarlo. Ordinate le pagine per data di pubblicazione e guardate i link in entrata unici dei contenuti degli ultimi tre mesi.
Come correggerlo. Rendetelo parte della pubblicazione: ogni nuovo articolo riceve da due a cinque link da pagine esistenti e affini il giorno in cui esce.
Controllo mensile dei link interni
Zero pagine orfane tra quelle che volete indicizzate
Ogni pagina prioritaria a 3 clic dalla home page
Nessuna ancora punta a più di un URL
Nessun link interno verso un redirect o una pagina di errore
Nessun nofollow sui link interni
Ogni link in una cartella di lingua punta alla stessa lingua
Hreflang, selettore e canonical puntano agli stessi URL
I nuovi articoli hanno ricevuto link da pagine più vecchie
Scalare i link interni senza perdere il controllo
Il collegamento manuale funziona bene fino a qualche decina di pagine. Oltre qualche centinaio, nessuno ricorda tutte le pagine e i link iniziano a puntare a contenuti obsoleti o cannibalizzanti. L'automazione aiuta, con tre salvaguardie:
Il piano resta umano. Gli strumenti possono suggerire link, ma l'elenco delle priorità, i cluster e le regole sulle ancore sono decisioni di business.
Pertinenza prima del volume. Un link automatico deve nascere da una frase che parla davvero dell'argomento di destinazione. Rifiutate i suggerimenti che corrispondono solo a una parola chiave.
Revisione a lotti che potete annullare. Applicate i link cluster per cluster, annotate la data, verificate l'impatto e poi proseguite.
È qui che si inserisce Sorank. Pianifica cluster tematici con controlli anti-cannibalizzazione tramite il suo generatore di cluster tematici, e la sua funzione di ottimizzazione dei contenuti riscrive e aggiorna le pagine più vecchie, il momento giusto per rinfrescare anche i loro link interni.
Cosa fare oggi
Non serve ricostruire tutto il sito per cominciare. In un pomeriggio:
Scansionate il sito ed esportate link in entrata, link in entrata unici e profondità di scansione.
Elencate 10 pagine prioritarie da Search Console (posizioni da 4 a 20) e dalla vostra offerta.
Eseguite la formula delle orfane e collegate o unite ogni orfana che volete indicizzata.
Per ogni pagina prioritaria, aggiungete tre link contestuali dalle vostre pagine affini più forti, con ancore prese da un elenco scritto.
Se il vostro sito è multilingue, eseguite l'espressione regolare tra lingue e correggete ogni link che non corrisponde.
Annotate la data di oggi nel piano e ricontrollate le posizioni tra sei settimane.
Poi decidete quale modello guida il vostro sito (silo, cocoon o rete) e scrivetelo. Una volta messi per iscritto il modello e le regole sulle ancore, ogni nuova pagina trova posto nella struttura invece di andare alla deriva fuori da essa.
Domande frequenti
Qual è la migliore strategia di link interni?
Per la maggior parte dei siti aziendali, l'approccio migliore è un silo per URL o un cocoon semantico come ossatura, in modo che l'autorevolezza fluisca verso le pagine prioritarie, con un collegamento incrociato leggero dentro ogni cluster tematico. Le reti pure del tipo «collega tutto» vanno bene per glossari e documentazione, ma rendono difficile spingere le pagine che vendono.
Quanti link interni dovrebbe avere una pagina?
Google dice che non esiste un numero ideale. Un obiettivo di lavoro utile è 10 o più link contestuali in entrata unici per le pagine prioritarie e da 3 a 8 per gli articoli di supporto, entro tre clic dalla home page. Lo studio di Zyppy su 23 milioni di link ha rilevato che il traffico smetteva di crescere oltre circa 45-50 link, soprattutto link di menu presenti su tutto il sito.
Una pagina in francese dovrebbe collegare la versione inglese di un articolo?
Solo tramite il selettore di lingua o come rimando deliberato. Nel corpo del testo, ogni link dovrebbe puntare alla pagina nella stessa lingua. Ogni pagina tradotta deve inoltre rimandare ai propri equivalenti con tag hreflang reciproci, coerenti con il selettore e con gli URL canonical.
y!
Ricevi gratis il tuo piano di contenuti per 30 giorni
Analizziamo i tuoi concorrenti, il tuo sito web e la tua visibilità nelle IA per creare gratuitamente un piano di contenuti su misura.
“Ho testato Sorank sul sito reale di un cliente ed è pazzesco. Fa tutto quello che un'agenzia fa pagare 1.500 € al mese. Ora va in produzione su quel cliente.”Guillaume Guersanguersanguillaume.com
“Siamo un'agenzia pubblicitaria e volevamo rimettere in carreggiata il nostro SEO una volta per tutte. Sorank ci ha dato una visione chiara del nostro sito, ci ha aiutato a dare priorità alle ottimizzazioni e a strutturare correttamente i nostri contenuti. Lo strumento è facile da usare, ben progettato per un team e molto pratico per centralizzare il monitoraggio senza dover destreggiarsi tra più piattaforme. Una base molto solida per ripartire da zero con il nostro SEO.”Gaspard MadouiAgenzia Pubblicitaria
“Mi sono specializzata in GEO grazie a Sorank. Il GEO Leaderboard mi permette di mostrare ai miei clienti il loro posizionamento rispetto ai concorrenti su ChatGPT. È un vero differenziatore commerciale.”MélanieFreelancer SEO
“Ottimo servizio, funziona bene per il nostro sito web e ci aiuta a capire come migliorarlo per posizionarci meglio su Google e altrove. Complimenti, continuate così, ve lo consiglio.”Hugo T.Commerciante e-commerce