构建内链策略:优先页面、主题集群、锚文本规则、三种链接模型对比、七步计划,以及需要修复的常见错误。
工具

简而言之
内链策略是一份书面计划,决定哪些页面接收链接、链接来自哪些页面、使用什么锚文本。它建立在三大支柱上:一份简短的优先页面清单、把相关内容归在一起的主题集群,以及锚文本规则。选定一种链接模型(密集的“维基百科”式网状结构、语义茧式结构或按网址目录划分的 silo),用爬虫落地,然后每月跟踪入链数、点击深度和点击量。
想深入了解?请询问
快速测验
哪种在线获客方式最适合您?
Sorank 符合您的回答


在您自己的网站上试用 3 天,看看您在 Google、ChatGPT 和其他 AI 中的位置。
开始 3 天免费试用免费 3 天,之后可随时停止。90 天效果保证,需符合条件。
本指南不止于定义。如果你只需要了解内部链接的基础,请先阅读我们的内部链接定义。这里讲的是计划本身:链接价值如何在网站中流动,如何选出值得获得这种价值的页面,三种主要链接模型及其取舍,分步骤的方法,需要跟踪的数字,以及悄悄拉低排名的错误,包括多语言网站特有的错误。
大多数网站是一篇文章一篇文章地添加内部链接:作者想起一篇旧文就链接过去。这只是战术。策略则相反:先决定权重最终要汇聚到哪里,再让每一条新链接都服务于这个目标。
真正的策略要用文字回答四个问题:
内部链接同时承担三项工作。它们让爬虫发现页面;它们传递一部分权重(这是 PageRank 的逻辑);它们的锚文本和周围文字告诉谷歌目标页面讲的是什么。谷歌关于可抓取链接的文档说得很直白:“你在意的每个页面,都应该至少有一个来自你网站其他页面的链接。”同一页还说明,每个页面的链接数量并没有理想值。
AI 搜索引擎依赖同样的信号。它们的爬虫顺着链接寻找页面,埋在六次点击之深的页面很少被抓取,因此也很少被引用。清晰的内部结构对谷歌和答案引擎都有好处。
这个主题下最大的公开研究来自 Zyppy 的 Cyrus Shepard(2026 年 2 月 23 日更新)。他分析了 1800 个网站的 2300 万条内部链接,并与 Search Console 的点击量对照。这是相关性研究,只能当作方向而不是定律。不过方向依然清楚。
2300 万条内部链接告诉我们什么
来源:Cyrus Shepard,Zyppy 内部链接研究(1800 个网站,520000 个网址),2026 年 2 月更新
另有两项发现对你的计划很重要。流量在大约 45 到 50 条链接之后不再上升,很可能是因为多出来的链接是指向弱页面的全站菜单链接。而且,指向一个页面的锚文本越多样,点击量越高,二者关联很强。完整图表请见 Zyppy 内部链接研究。
规划之前,你需要一个关于价值流动的思维模型。简化来说:每个页面都有一定量的权重(来自外链和它接收到的内部链接),并把这份权重分给自己包含的链接。放在正文里、很可能被点击的链接,比藏在页脚里的链接分量更重。这就是谷歌一项专利里描述的“理性冲浪者”思想:链接的权重并不相同。
点击深度是从首页到某个页面所需的点击次数。首页通常拥有最多的权重,所以每多一层,到达页面的权重就被稀释一些。常见规则是让重要页面保持在三次点击之内。深度还会影响抓取频率:在抓取预算紧张的大型网站上,深层页面被访问得更少,在索引中的更新也更晚。
并非所有链接的作用都一样。你的策略应说明每一类用来做什么。
| 链接类型 | 所在位置 | 主要作用 | 作为信号的权重 | 需要决定什么 |
|---|---|---|---|---|
| 上下文链接 | 正文内部 | 在相关页面之间传递相关性和权重 | 高:周围有主题文字,很可能被点击 | 哪些页面链接到哪里,用什么锚文本 |
| 主导航 | 页眉菜单,每个页面都有 | 让顶层栏目从每个网址都获得链接 | 中:全站出现,但缺少上下文 | 只放 5 到 9 个顶层栏目,绝不放长尾页面 |
| 面包屑导航 | 标题上方 | 把价值向上推给父级分类,展示层级 | 中:结构化,锚文本一致 | 路径逻辑和 BreadcrumbList 标记 |
| 相关内容区块 | 文章或产品页末尾 | 连接集群中的同级页面 | 中:可以自动化 | 规则:先同集群,再相邻集群 |
| 页脚 | 每个页面底部 | 法律信息、联系方式、少数关键页面 | 低:谷歌会降低重复模板内容的权重 | 保持简短,避免堆放 80 个关键词链接 |
实际结论是:想提升某个页面时,来自强势相关页面的上下文链接是你的第一个杠杆,菜单链接是第二个,而且这是稀缺资源。
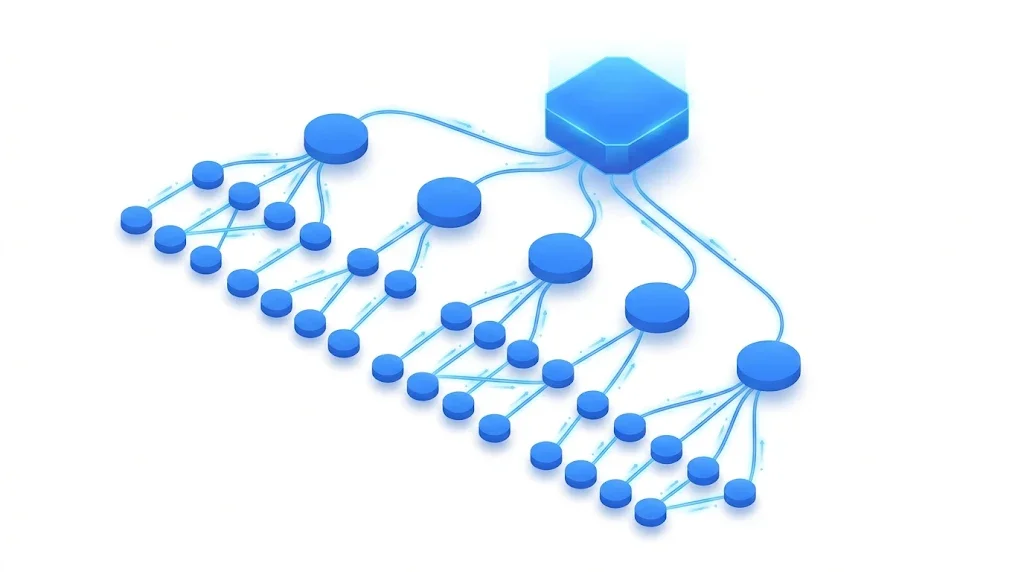
策略从一份简短的清单开始。如果每个页面都是优先页面,那就没有优先页面。你需要在网站的每个栏目里选出 10 到 30 个页面,让它们获得大部分内部链接:负责成交的页面、已经排在前列附近的页面,以及为它们提供支撑的指南。
交叉对照三个来源:
从全部网址到优先清单
在计划里为清单上的每个页面写下三件事:它瞄准的主要查询、它所属的集群,以及目标上下文入链数。一份可用的起步标准:转化页和支柱指南至少 10 条唯一上下文入链,集群文章 3 到 8 条,工具类页面 0 到 2 条。这些是工作目标,不是谷歌的规则。请根据网站规模调整:60 个页面的网站不可能给 20 个页面各 15 条链接。
充当网站锚点的页面通常被称为基石内容。我们关于基石内容的指南讲解了如何挑选和撰写,让它们配得上你投向它们的链接。
第二根支柱按主题给页面分组。集群由一个覆盖宽泛话题的支柱页面和围绕它的若干较窄的文章组成,每篇文章回答一个具体问题。支柱页和文章互相链接。结果是:谷歌看到一组深入覆盖某个主题的页面,从而建立主题权威,每个页面也把相关性传递给邻近页面。
五步构建集群地图
按共享的谷歌结果给查询分组,是关键词聚类的核心,完整的支柱与分支模型详见我们的主题集群与支柱页面指南。如果你想直接得到一张地图,Sorank 的主题集群生成器会把关键词分成集群,并标出会造成蚕食的重叠。
锚文本是链接中可点击的文字。谷歌把它当作目标页面的简短描述。其文档要求锚文本对它所在的页面和它指向的页面都“具有描述性、适度简洁且相关”,并警告不要使用“点击这里”之类的泛泛文字,也不要堆砌关键词。
锚文本:整改前后
在代码里,差别如下。最后一个例子对图片链接很重要:谷歌会把 alt 属性当作锚文本。
<!-- Weak: generic anchor, no context -->
<p>To learn more, <a href="/zh/blog-geo-seo/site-architecture-seo">click here</a>.</p>

<!-- Strong: descriptive anchor inside a relevant sentence -->
<p>Pages buried too deep get crawled less often, so check
your <a href="/zh/blog-geo-seo/site-architecture-seo">crawl depth by directory</a> first.</p>

<!-- Image link: the alt text becomes the anchor -->
<a href="/zh/pricing"><img src="/img/plans.png" alt="Sorank pricing plans"></a>关于锚文本类型的完整列表(完全匹配、部分匹配、品牌词、裸网址、泛泛词),请见我们的锚文本指南。
定好支柱之后,要选择页面如何连接。主要有三种模型。大多数真实网站会混合使用,但应有一种主导,否则每位编辑都会按不同的逻辑做事。
原理。每当一个页面提到某个有独立页面的概念,就链接过去。链接在所有相近页面之间向各个方向延伸,就像维基百科,一个词条可以含有数百条内部链接。
适用场景。大型知识库、词汇表、文档、媒体网站,以及读者会在概念之间来回跳转的任何网站。
优点。点击深度很低,新页面发现很快,锚文本变体丰富,非常适合喜欢探索的读者。应用简单:只要一个术语有页面,就链接它。
局限。权重被平均分散,所以无法推高少数优先页面。在权重不多的小网站上,这种稀释有害。主题边界变得模糊,谷歌对每个栏目覆盖内容得到的信号更弱。
示例。词汇表中的“抓取预算”词条,在前几段里链接到“抓取”“robots.txt”“站点地图”“日志文件”和“服务器错误”,这些页面也都链接回来。
原理。语义茧由 Laurent Bourrelly 在法国推广,称为“cocon sémantique”,它把页面组织成按搜索意图建立的严格层级。母页覆盖宽泛意图,其下的女页覆盖更窄的意图,同一层级的页面互为姐妹。链接遵循精确规则:母页链接到它所有的女页;每个女页链接回母页;女页只有在主题自然衔接时才链接姐妹页;除通过顶层页面外,没有任何链接指向茧之外。
适用场景。主题权威起决定作用的竞争激烈的细分领域、从零搭建的网站,以及可以在写作前完整规划的栏目。
优点。三种模型中相关性信号最强。权重集中在你想要的地方,因为链接向上回到母页。每个页面角色明确,可避免蚕食。
局限。规划和维护都很繁重。严格的规则可能逼出牵强的链接,或禁止有用的链接。很难套用到积累了多年无规划链接的老网站上。纯粹主义者禁止茧外链接,这可能损害读者体验。
示例。母页:“跑鞋”。女页:“越野跑鞋”“公路跑鞋”“扁平足跑鞋”。“越野跑鞋”之下的孙页:“防水越野鞋”“泥地越野鞋”。防水页向上链接到越野页,横向链接到泥地页,绝不直接链接公路页。
我们关于语义茧的完整指南讲解了如何逐层构建。
原理。层级写在网址里。每个栏目有一个目录,每个页面位于其主题的目录中,面包屑反映这条路径。链接大多留在各自的 silo 内:页面链接到上级目录页和同目录下的同级页面。
/seo/                                  section page (pillar)
/seo/technical/                        category page
/seo/technical/crawl-depth/            article
/seo/technical/orphan-pages/           article
/seo/content/                          category page
/seo/content/topic-clusters/ article适用场景。网店、目录站、本地服务网站,以及任何有天然分类树的网站。它也适合编辑众多的团队,因为规则直接体现在网址上。
优点。人人容易理解。面包屑自动生成一致的向上链接。按目录出报告(抓取、流量、索引)变得简单。这是大多数网站架构本来就遵循的模型,详见我们关于SEO 网站架构的指南。
局限。一个页面只能存在于一个目录,而真实的主题会交叉。之后移动页面意味着更改网址并添加重定向。严格的 silo 会阻断栏目之间有用的交叉链接。
添加面包屑标记,让谷歌理解路径。谷歌的面包屑结构化数据文档要求至少有两个 ListItem,每个都带有位置和名称:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "BreadcrumbList",
  "itemListElement": [
    {"@type": "ListItem", "position": 1, "name": "SEO", "item": "https://www.example.com/seo/"},
    {"@type": "ListItem", "position": 2, "name": "Technical SEO", "item": "https://www.example.com/seo/technical/"},
    {"@type": "ListItem", "position": 3, "name": "Crawl depth"}
  ]
}
</script>| 标准 | 维基百科网状 | 语义茧 | 网址 silo |
|---|---|---|---|
| 核心规则 | 链接每个相关概念 | 链接遵循意图层级 | 链接遵循目录树 |
| 最适合 | 词汇表、文档、媒体 | 竞争激烈的细分领域、新网站 | 网店、目录站、本地服务 |
| 权重流向 | 平均分散 | 集中在母页 | 集中在分类页 |
| 主题信号 | 弱到中 | 强 | 中到强 |
| 规划难度 | 低 | 高 | 中 |
| 维护难度 | 中(链接多) | 高 | 低 |
| 套用到老网站 | 容易 | 困难 | 中(需改网址) |
| 主要风险 | 稀释、没有优先级 | 牵强的链接、僵化 | 栏目孤立 |
典型的商业网站应该由哪种模型主导?
我们对大多数网站的建议:用网址 silo 或茧作为骨架(它决定权重最终落在哪里),并在每个集群内部允许轻量的网状链接(它让页面对读者仍然有用)。跨 silo 的链接要少而有意。
这是我们从审计到落地所用的方法。对于几百个页面的网站,第一轮需要两到三个工作日。
七步落地
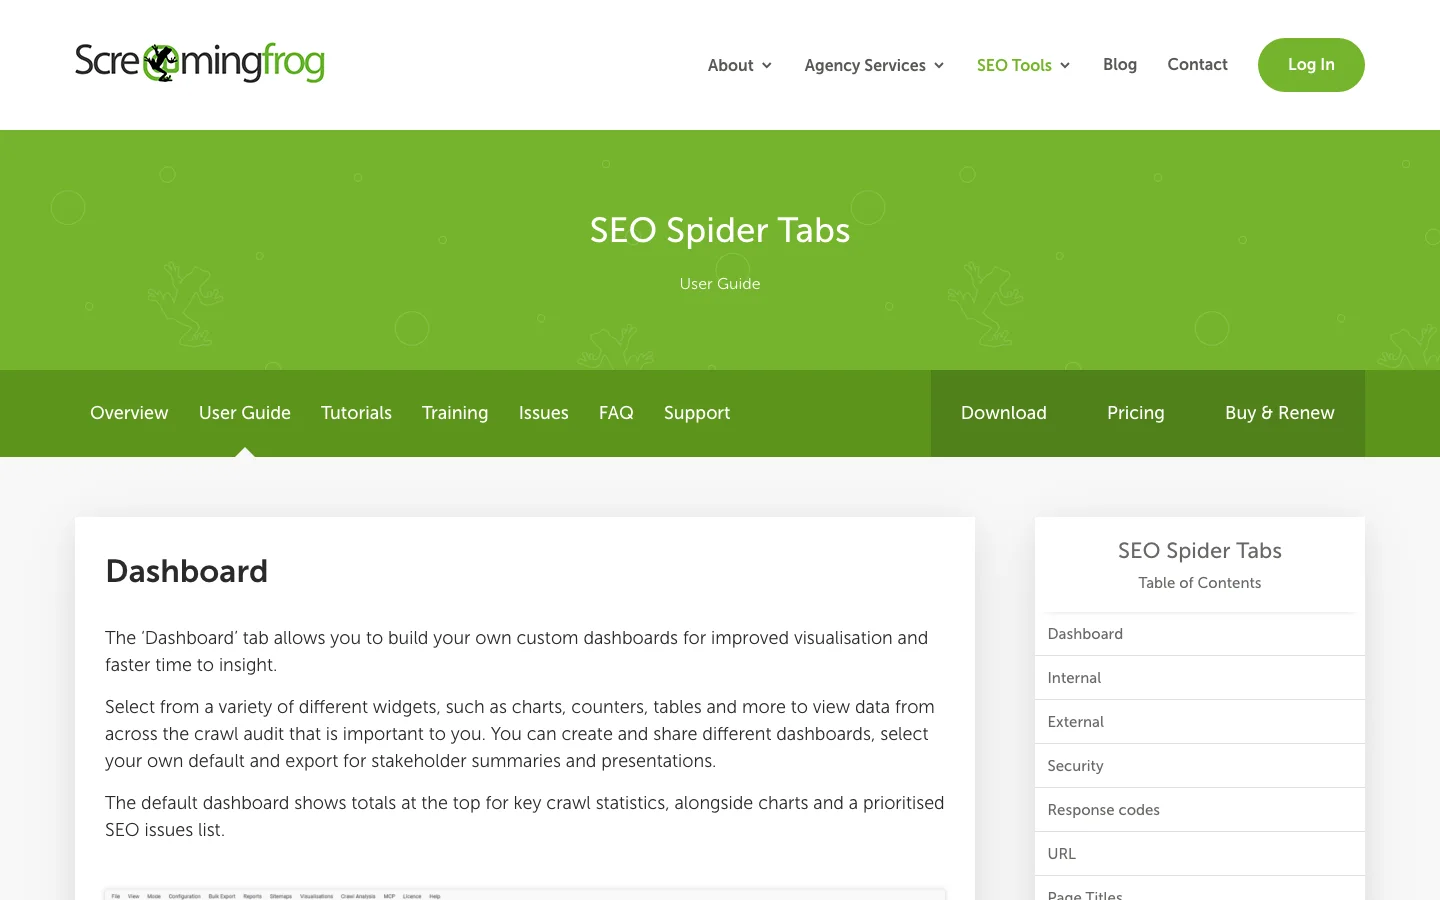
使用 Screaming Frog SEO Spider 之类的爬虫。免费版最多抓取 500 个网址,足够许多小型企业网站使用。我们的 Screaming Frog 设置指南介绍了配置方法。
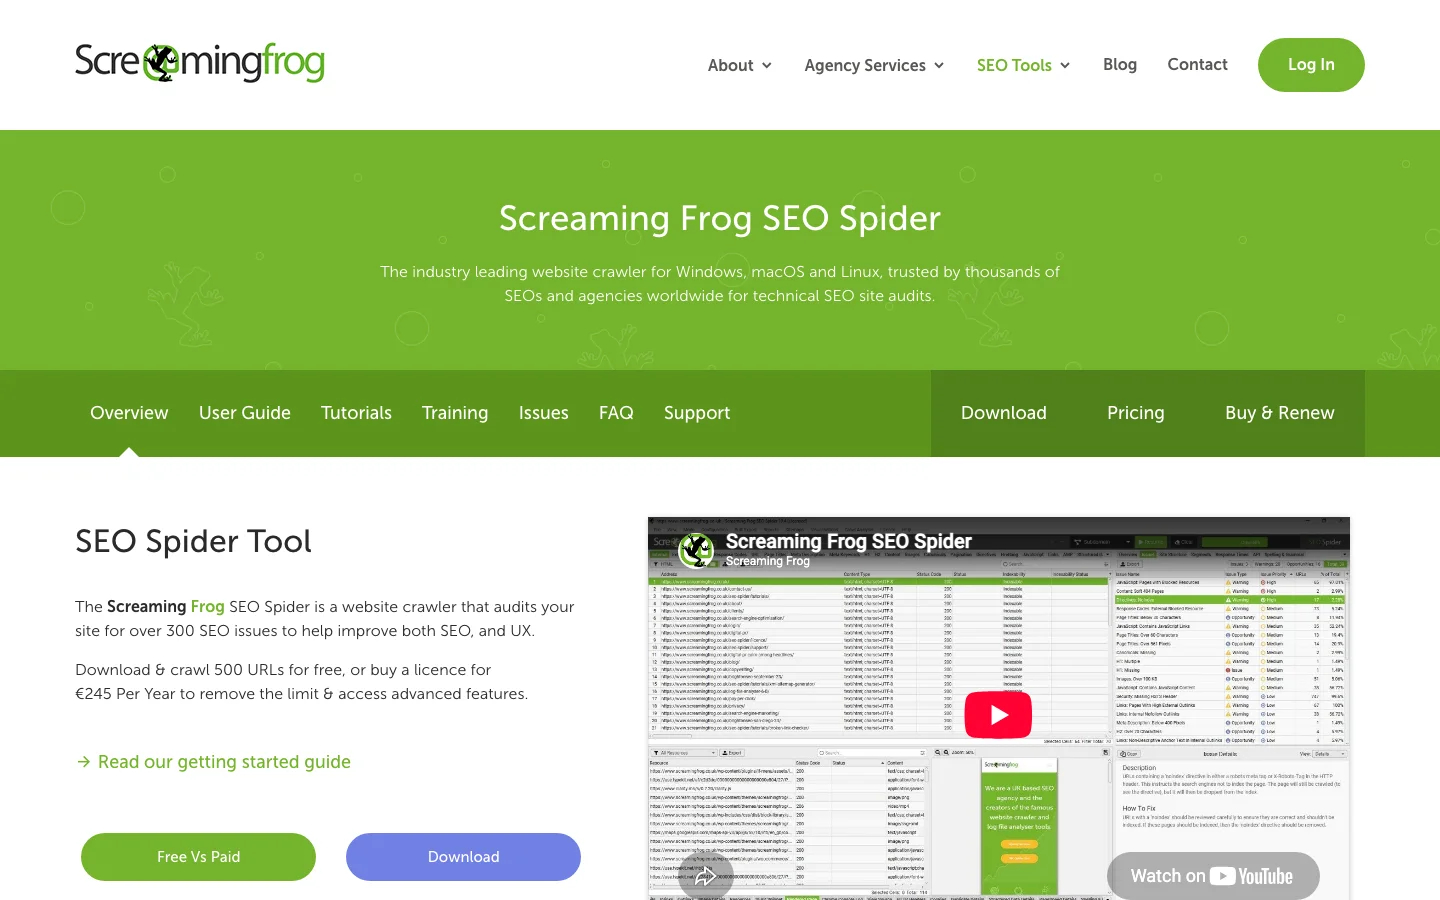
在 Internal 标签中,有四列决定你的计划。Screaming Frog 的文档对它们的定义是:Inlinks(指向该网址的内部链接数)、Unique Inlinks(同一页面链接三次只算一次)、Crawl Depth(距起始页面的点击数)和 Link Score(0 到 100 的指标,基于内部链接衡量页面的相对价值,在抓取分析后计算)。
爬虫只能找到有链接的页面。要找孤立页面,就把所有已知网址的列表(XML 站点地图加上 Search Console 页面导出)与抓取结果对比。在 Google 表格中,把所有已知网址放在“Known”工作表的 A 列,把已抓取的网址放在“Crawl”工作表的 A 列,然后输入:
=FILTER(Known!A2:A, Known!A2:A<>"", ISNA(MATCH(Known!A2:A, Crawl!A:A, 0)))返回的每个网址都是谷歌或你的站点地图已知、却没有任何内部链接的网址。对每一个做出决定:从其集群链接过去,合并到更强的页面,或用重定向移除。
按 Link Score 或引用域名数给抓取结果排序。你的前 20 个页面就是“捐赠者”。对每个优先页面,找到两到五个主题相关的捐赠者,各添加一条上下文链接,锚文本取自你的计划。把链接放在文章前半部分,放进一句向读者说明为什么要点击的话里,符合理性冲浪者的逻辑。
提示
编辑之前,先看看页面目前链接到哪些地方。免费的 Sorank 内部链接分析器会列出页面的每条内部链接及其锚文本,几秒钟就能发现泛泛锚文本和重复项。
网址变更后,旧的内部链接仍指向重定向。每多一跳都浪费抓取,还可能损失一点信号。每次迁移之后,导出目标返回 301 或 302 的内部链接,并替换为最终网址。我们关于 SEO 重定向的指南讲解了状态码,免费的失效链接检查器可以找出任何页面上的死链。
跟踪一小组数字,每月用同样的方式,先从优先页面开始。
| 指标 | 在哪里查看 | 理想状态 | 偏离时的措施 |
|---|---|---|---|
| 唯一上下文入链数 | 爬虫,Internal 标签 | 达到或高于计划目标 | 从捐赠页面添加链接 |
| 抓取深度 | 爬虫 | 优先页面 3 或以下 | 从菜单、枢纽页或分类页链接 |
| 孤立页面 | 站点地图和 Search Console 与抓取结果对比 | 想被索引的页面中为零 | 链接、合并或重定向 |
| 指向重定向或错误的内部链接 | 爬虫,链接目标的响应码 | 零 | 替换为最终网址 |
| 平均排名和点击量 | Search Console,按页面看效果 | 链接上线 4 到 12 周后上升 | 检查锚文本和内容本身 |
| 已索引页面 | Search Console,页面报告 | 优先页面全部被索引 | 检查网址,确认链接可被抓取 |
请在计划中记下每一批新链接的日期。没有日期,你就无法在 Search Console 中判断排名变化来自链接、内容还是算法更新。
下面每个错误在真实网站上都很常见。每一项都包括:它是什么、怎么发现、怎么修复。
是什么。没有任何内部链接指向的页面。谷歌也许通过站点地图知道它,但它得不到权重,抓取也很少。
怎么发现。使用第 2 步中站点地图与抓取结果的对比。
怎么修复。从它的支柱页和一两个同级页面链接过去。如果没有任何页面能自然地链接它,它大概不该单独存在:把它合并。
是什么。一个成交页面离首页有五六次点击,常常是因为它只出现在分页博客的第 4 页。
怎么发现。在抓取结果中筛选深度大于 3 的页面,并与优先清单交叉对照。
怎么修复。把它加入枢纽页或分类页、相应菜单,或从一篇强文章链接过去。避免只依靠分页来触达内容。
是什么。两个不同的网址接收到相同的锚文本,谷歌无法判断哪个才回答该查询。
怎么发现。导出所有内部链接(锚文本和目标),按锚文本做数据透视,统计不同的目标数。任何拥有多个目标的锚文本都是警示信号。
怎么修复。把每个锚文本只分配给一个页面。如果两个页面确实回答同一个查询,就合并它们。
是什么。用按钮、onclick 事件或从不渲染真实链接的框架组件搭建的导航。谷歌表示,它能可靠地跟踪带有 href 属性的 <a> 元素,而 <span href>、<a onclick> 或 javascript: 网址之类的标记并不可靠。
怎么发现。先关闭 JavaScript 渲染抓取,再开启渲染抓取。只有开启渲染才能发现的页面,或根本发现不了的页面,依赖脆弱的链接。Search Console 的网址检查工具会显示渲染后的 HTML。
怎么修复。把每条导航链接都渲染为 <a href="/zh/blog-geo-seo/site-architecture-seo">。我们关于 JavaScript SEO 的指南讲解渲染方面的内容。
是什么。给内部链接添加 rel="nofollow",以“雕刻”权重。它并不会把权重留在页面上,只是阻止权重通过这条链接流动。
怎么发现。在爬虫中按 nofollow 属性筛选内部链接。
怎么修复。去掉内部链接上的 nofollow。如果某个页面不该获得权重,就移除链接或对该页面设置 noindex。请见我们的 nofollow 链接页面。
是什么。带有 150 条链接的超级菜单,或列出 80 个关键词页面的页脚。这样每个页面都链接到所有页面,优先级就被抹平了。Zyppy 的数据也显示,流量在大约 50 条链接之后下降,很可能就源于这类全站链接。
怎么发现。统计页眉和页脚模板中的链接数。如果在大多数文章里全站链接多于上下文链接,说明模板占了主导。
怎么修复。菜单只保留 5 到 9 个顶层条目,把长列表移到枢纽页,页脚只用于法律信息、联系方式和少数关键页面。
多语言网站会多出一类大多数指南略过的错误。在谷歌眼中,各语言版本是独立的页面,链接告诉谷歌哪些版本属于一组。我们关于国际 SEO 的指南涵盖更广的设置;这里只讲链接错误。
7a. 一种语言的页面链接到另一种语言的页面。一篇法语文章链接到某指南的英语版本,常常是因为译者保留了原始链接。法语读者落到英语内容上就离开了,而法语指南也失去了本该获得的一条内部链接。
怎么发现。在 Screaming Frog 中运行 Bulk Export、Links、All Inlinks,然后筛选来源在一个语言文件夹、目标在另一个语言文件夹的行。对于 /fr/ 和 /en/ 这样的文件夹,下面两个正则表达式可以找出链接到任何其他语言文件夹的法语页面:
Source:      ^https://www\.example\.com/fr/
Destination: ^https://www\.example\.com/(?!fr/)[a-z]{2}/怎么修复。把每条链接替换为同一语言的对应页面。正文里唯一应保留的跨语言链接是语言切换器和有意的引用(“这项研究只有英文版”)。
7b. 各版本没有指向其译文。法语页面有英语对应页,但两者之间没有任何连接:没有 hreflang,语言切换器也没有指向确切的译文页(切换器跳到的是英语首页)。谷歌就可能把它们当作无关页面,或在结果中显示错误的语言。
怎么发现。抽样检查深层页面的语言切换器:它跳到的是译文页还是首页?然后检查同样页面上的 hreflang 标签。
怎么修复。让切换器链接到确切对应的网址,并用 hreflang 声明每个版本。谷歌关于本地化版本的文档很严格:“每个语言版本都必须列出自身以及所有其他语言版本”,并且“如果两个页面没有互相指向,这些标签将被忽略”。
<!-- On BOTH the English and the French page -->
<link rel="alternate" hreflang="en" href="https://sorank.com/blog-geo-seo/site-architecture-seo" />
<link rel="alternate" hreflang="fr" href="https://sorank.com/fr/blog-geo-seo/architecture-site-seo" />
<link rel="alternate" hreflang="x-default" href="https://sorank.com/blog-geo-seo/site-architecture-seo" />
7c. hreflang 和内部链接各说各话。hreflang 说法语页面 A 对应英语页面 B,但页面 B 的 canonical 指向别处,或切换器链接到页面 C,或法语内部链接指向已被重定向的网址,而 hreflang 列出的是最终网址。谷歌收到相互矛盾的信号,可能会忽略整个 hreflang 集合。
怎么发现。抽样页面,把四个网址并排写出:hreflang 目标、切换器目标、目标页面的 canonical,以及重定向后的最终网址。四者必须完全一致。
怎么修复。在 CMS 中从同一个事实来源(一张翻译对照表)生成 hreflang、canonical 和切换器链接,绝不要手工处理。免费的 Sorank hreflang 生成器可以生成正确且互相对应的标签集,我们的 hreflang 指南解释了每个属性。
警告
翻译后的 slug 会改变每种语言的网址。翻译文章时,也要翻译它的内部链接:每条链接都必须指向目标页面的同语言版本,并使用该语言中确实存在的 slug。
是什么。新文章会链接到旧文章,旧文章却从不链接新文章。新页面几个月都很弱。
怎么发现。按发布日期给页面排序,查看最近三个月内容的唯一入链数。
怎么修复。把它纳入发布流程:每篇新文章上线当天,都要从已有的相关页面获得两到五条链接。
每月内链检查
手工链接在几十个页面之内效果很好。超过几百个页面后,没人记得每个页面,链接开始指向过时或会造成蚕食的内容。自动化有帮助,但要有三道保障:
这正是 Sorank 的用武之地。它通过主题集群生成器规划带有防蚕食检查的主题集群,其内容优化功能会重写并更新旧页面,这正是刷新其内部链接的时机。
你不必重建整个网站才能开始。一个下午就可以:
然后决定由哪种模型主导你的网站(silo、茧或网状),并写下来。模型和锚文本规则一旦成文,每个新页面都会融入结构,而不是游离在外。
对大多数商业网站来说,最佳做法是以网址 silo 或语义茧为骨架,让权重流向优先页面,并在每个主题集群内部做轻量的交叉链接。“全部互链”的网状结构适合词汇表和文档,但很难推高能成交的页面。
谷歌表示没有理想数量。一个实用的工作目标是:优先页面有 10 条或更多唯一上下文入链,支撑文章有 3 到 8 条,并且都在距首页三次点击之内。Zyppy 对 2300 万条链接的研究发现,流量在大约 45 到 50 条链接之后不再上升,其中多数是全站菜单链接。
只能通过语言切换器或有意的引用。在正文内容中,每条链接都应指向同一语言的页面。每个译文页面还必须通过互相对应的 hreflang 标签链接到其对应版本,并与切换器和 canonical 网址保持一致。
我们免费分析您的竞争对手、网站和 AI 可见度,为您制定专属内容计划。
 AI 内容简报生成器
 FAQ 结构化数据生成器
 AI 文章选题生成器
 结构化数据验证工具(Schema 验证器)
 图片替代文本检查工具
 内部链接分析工具
 外链挑战
 AI meta 描述生成器
 AI 博客标题生成器
 Google 可收录性检查工具
 AI 文章大纲生成器
 UTM 链接生成器
 关键词聚类工具
 规范标签检查工具
 XML 站点地图生成器
 死链检查工具
 AI SEO 标题生成器
 标题评分工具
 搜索结果预览工具
 重定向检查工具
 hreflang 标签生成器
 标题结构分析工具
 HTTP 响应头检测工具
 Favicon 提取工具
 SEO 流量与收入预测计算器
 SEO 预算计算器
 排名提升模拟器
 关键词机会得分计算器
 GEO 内容投入计算器
 客户终身价值计算器
 点击率计算器
 AI 流量价值计算器
 AI 声量份额计算器
 Gemini 排名查询工具
 ROAS 计算器
 自然流量价值计算器
 本地 SEO 投资回报计算器
 外链建设成本计算器
 关键词密度计算器
 客户获取成本计算器
 单篇文章成本计算器
 跳出率计算器
 AI 引用率计算器
 结构化数据大语言模型审计
 llms.txt 生成器
 站点地图检查工具
 SERP 波动监测器
 字数统计工具
 结构化数据生成器
 关键词研究工具
 SEO 盈亏平衡计算器
 阅读时长计算器
 自然流量预估工具与网站流量查询
 ChatGPT 引荐流量估算器
 AI 曝光度得分计算器
 LLM 可读性检查器
 SearchGPT 就绪度检测工具
 ChatGPT 为什么不推荐我的网站
 URL 提取工具
 网页转 Markdown
 Robots 生成器
 OG 预览
 页面 SEO 审核:SEO 检查与 SEO 分析工具
 LTV 与 CAC 比率计算器
 GEO 回报率计算器
 转化率计算器
 网站可抓取性 AI 审计
 AI 搜索曝光度测试
 页面体积检测工具
 URL Slug 生成器
 Meta 标签生成器
 图片压缩工具
 网站图标生成器
 域名权重查询工具
 SERP 点击率计算器
 电商 SEO 投资回报率计算器
 内容营销投资回报率计算器
 AI 隐形成本计算器
 AI Overview 检查工具与 AI Overviews 排名检查
 Robots.txt 检查工具
 AI SEO 审核
 Perplexity 引用检测工具
 回答引擎优化审核
 ChatGPT 可见度检测工具
 外链分析工具
 SEO 与付费搜索省钱计算器
 SEO 声量占比计算器
 SaaS SEO ROI 计算器
 反向链接投资回报率计算器
 llms.txt 验证器
 LLM 引用检查器
 GEO 审核
 SEO ROI 计算器
 关键词价值计算器
5 条评价,评分 5/5
 “两年来,我 100% 的客户都来自 LinkedIn。每天发帖、评论、私信跟进……完全依赖算法。我知道自己需要做 SEO,但总是往后拖:太花时间、太技术、不是我的本行。有了 Sorank,我终于迈出了这一步。4 个月里,我在什么都不发的情况下每月获得 15 个自然线索。目前还没有做到和 LinkedIn 各占一半,但知道自己现在有了第二个能自动增长的线索来源,我睡得更踏实了。”

 Valentin Thomyoffbound.fr
 “我是开发者,不是做市场的。我的 Shopify 主题此前只靠口碑和广告在卖。有了 Sorank,我终于明白该如何搭建自己的 SEO,以及怎样写出能获得排名的文章。审计发现我的产品页面太慢了。两个月内,我的自然流量翻了一倍,当人们搜索 Shopify 主题时,我也开始出现在 ChatGPT 的回答里。而这一切每周只花大约 2 小时。”
 Thème FullStackgo.themefullstack.com
 “对市场营销机构来说是个很棒的工具!用它来审计网站、找出加载慢的页面、确定需要补充哪些内容以及补在哪里,都非常快。”
 Thomas Giraudthe-deployer.fr“我们是一家广告代理商,想要一劳永逸地把 SEO 重新做起来。Sorank 让我们清楚地看到自己网站的情况,帮助我们排定优化的优先级,并把内容结构梳理好。这个工具易于使用,很适合团队,而且非常实用,可以集中跟踪,不用在多个平台之间来回切换。这是我们重新开始做 SEO 的一个非常扎实的基础。”
 Gaspard Madoui广告代理商