了解自动内链的工作原理,对比 6 种方法,按步骤完成设置,并避开让自动链接变成垃圾链接的常见错误。
工具

简而言之
自动内链是指让软件来发现、推荐或插入你网站内部页面之间的链接,而不是一条一条手动添加。当机器承担繁琐的部分(抓取、匹配主题、找出孤立页面、记录每一条链接),而规则由你掌控(推送哪些页面、允许哪些锚文本、每页放多少链接)时,它的效果最好。请把它设置成“推荐、审核、发布、衡量”的流程,而不是一个见到关键词就加链接的插件。
想深入了解?请询问
快速测验
哪种在线获客方式最适合您?
Sorank 符合您的回答


在您自己的网站上试用 3 天,看看您在 Google、ChatGPT 和其他 AI 中的位置。
开始 3 天免费试用免费 3 天,之后可随时停止。90 天效果保证,需符合条件。
内部链接是从你网站的一个页面指向同一网站另一个页面的链接。它承担三项工作:帮助爬虫发现页面;通过锚文本和周围的文字告诉搜索引擎和 AI 系统目标页面讲的是什么;把权重从强页面传递给较弱的页面。如果你对这些基础概念还不熟悉,可以先看我们的内部链接定义。
所谓自动化,是指由程序负责以下一项或多项任务:
它不是:把同一个关键词链接塞进 500 个页面的手段,不能代替网站架构,也不是每篇文章底部的“相关文章”小部件。这些可以是自动化系统的一部分,但单独使用时大多只会制造噪音。
手动内链在 30 个页面的网站上没问题。但对于每周都发布内容的网站,它注定会失效,原因很简单:每篇新文章都会带来两项工作。它需要链接到已有页面,而旧页面也需要链接回它。第二项工作是所有人都会忘记的。发布两年之后,你会发现最近的文章没人链接,而旧文章仍然指向早已被替换的页面。
自动化前后的内部链接对比
本文聚焦于“机制”本身:方法、设置、一个可运行的脚本以及常见的失败模式。至于策略层面(优先推哪些页面、如何为多语言网站规划链接),请先阅读我们的内链策略专家指南。这两篇文章是配套使用的。
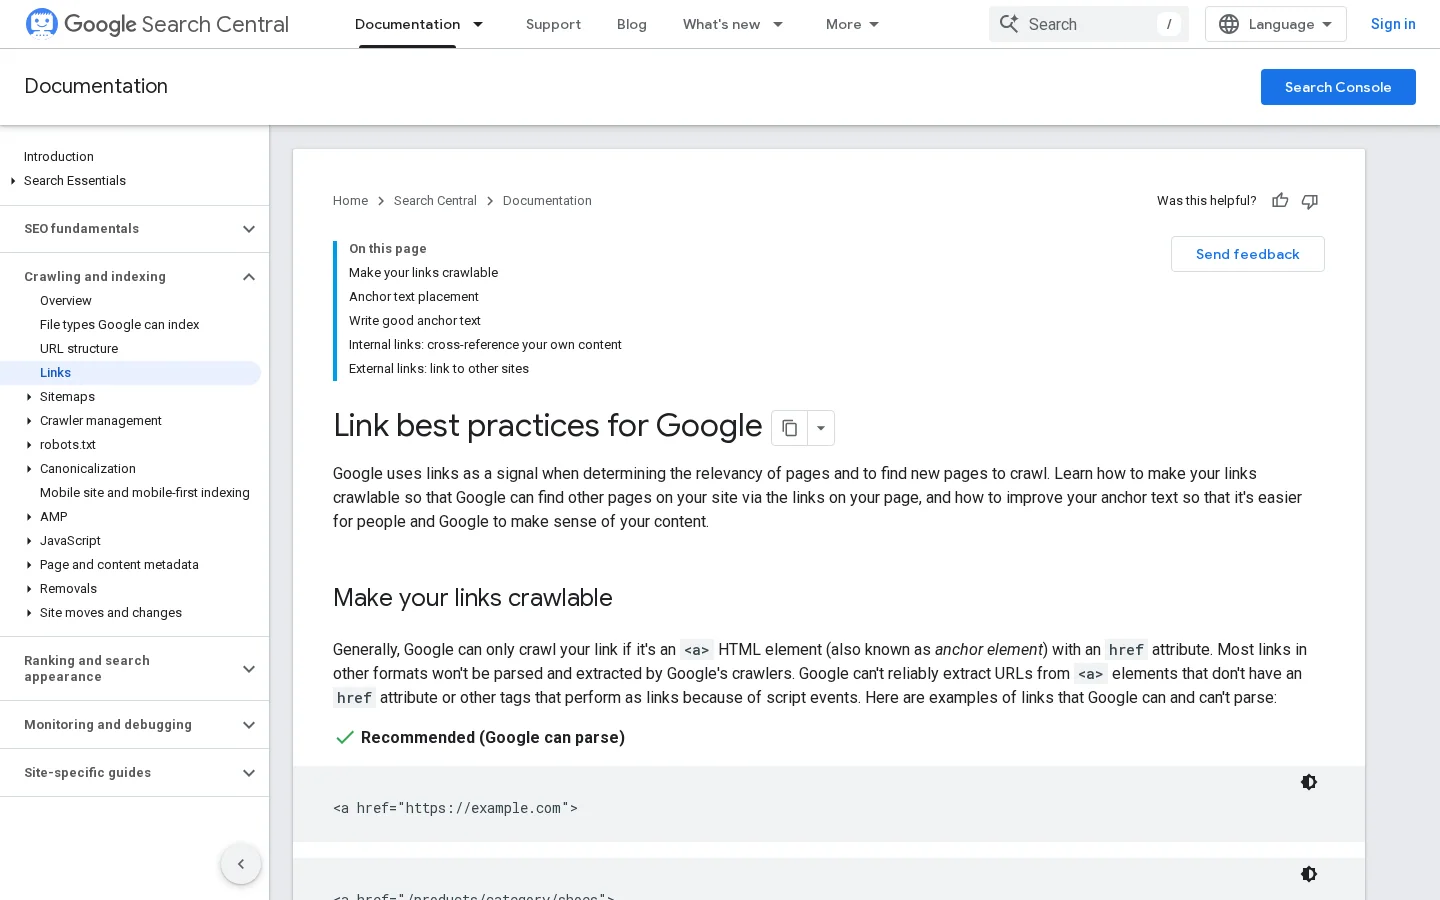
Google 对最低要求说得很明确。它的链接最佳做法文档指出:“你在意的每个页面都应该至少有一个来自你网站其他页面的链接”,而且 Google 通常只有在链接是带有 href 属性的 <a> 元素时才能抓取它。孤立页面并没有被禁止,但你等于把被发现和被理解的希望全押在了站点地图上。
除了最低要求,这一主题最好的公开数据集是 Zyppy 的 Cyrus Shepard 做的一项相关性研究:“23 Million Internal Links: SEO Case Study”(2026 年 2 月更新)。它把约 1800 个网站的内部链接数据与 Search Console 点击数据进行了匹配。
2300万条内部链接揭示了什么
来源:Cyrus Shepard,Zyppy,23 Million Internal Links SEO Case Study,2026 年 2 月更新
对自动化最有用的发现与数量有关。拥有 0 到 4 条内部链接的 URL 平均从 Google 获得 2 次点击,而拥有 40 到 44 条内部链接的 URL 获得的点击是前者的四倍。超过约 45 到 50 条链接后,效果开始反转。作者把这种下降很大程度上归因于全站导航链接,并且谨慎地指出这项研究只是相关性研究:方向上有参考价值,但不是证据。
由此得出两个实用结论。第一,缺少链接的页面收益最大,而这恰恰是自动化最擅长发现的。第二,研究发现锚文本的多样性与点击量相关,使用 URL 锚文本和完全匹配锚文本的页面表现更好。一个用同样三个词去链接每个页面的系统,就把这种多样性白白丢掉了。
GPTBot、ClaudeBot 和 PerplexityBot 等 AI 爬虫发现页面的方式与 Googlebot 相同:跟随 <a href> 链接。其中很多并不执行 JavaScript,所以在客户端注入的链接对它们来说可能根本不存在。我们的 AI 爬虫指南解释了每个机器人会抓取什么。干净、服务端渲染的内部链接既有利于搜索引擎,也有利于引用你页面的 AI 引擎。
每个成熟的工具,无论是插件、SaaS 还是你自己写的脚本,运行的都是同一条流水线。了解它,你就能在五分钟内评估一个工具:问问它每一步是怎么做的。
内链引擎的 6 步流水线
盘点必须把主要内容与模板区分开。页眉菜单中的链接出现在每个页面上,对 Google 理解目标页面帮助不大。而一篇相关文章第三段中的链接则能告诉它很多信息。好的引擎在分析前会去掉 nav、header、footer 和 aside,并且只在文章正文中插入链接。它们还会排除不可索引的 URL:任何返回重定向、404、带 noindex 或规范标签指向其他页面的 URL。
常见的表示方式有三种,从粗到细:
使用嵌入时,匹配就是计算向量之间的余弦相似度,得分介于 -1 和 1 之间(对文本来说实际上是 0 到 1)。你保留高于阈值的配对,以及每个页面的前 N 个。阈值是最重要的设置:太低,你会把讲蟒蛇(Python)的页面链接到讲 Python 编程语言的页面;太高,你只能找到几乎重复的页面。使用通用模型时,从 0.5 到 0.6 左右开始,然后在人工审核 50 条建议后再调整。
锚文本应该是源句子中已经存在的短语。插入新词意味着改写内容,那是另一项工作。引擎会在源文本中搜索能描述目标页面的短语:它的主关键词、H1、近似变体,或者目标页面在 Search Console 中已经获得排名的查询词。最后这一来源最好,因为它反映了真实用户如何描述这个页面。
规则决定质量的成败(见下文的专门章节)。插入发生在三个地方之一:存储的内容中(链接成为文章的一部分,永久存在,并在编辑器中可见);服务端渲染时(生成页面时由过滤器添加链接,容易回滚);或者在浏览器中通过 JavaScript 添加(对 SEO 来说最弱的选项)。无论采用哪种方式,每条自动链接的日志都必不可少:没有它,你就无法审计、衡量或撤销。
“自动内链”涵盖了差别很大的多种技术。大多数网站最终会组合使用其中两三种。
原理:你维护一张“短语对应 URL”的表,系统在短语出现的地方都加上链接。适用场景:术语表、产品名称、少量的核心转化页面。优点:可预测、透明、成本低。局限:不理解上下文,所有地方锚文本都一样,表格会逐渐过时。示例:每篇文章中第一次出现“抓取预算”时链接到抓取预算术语页面,每篇文章最多一条链接。
原理:CMS 根据网站结构生成链接:面包屑导航、分类列表、“相关文章”、上一篇和下一篇、列出子页面的中心页面。适用场景:始终使用,这是基础层。优点:无需维护,保证分类中的页面不会成为孤立页面。局限:模板链接携带的上下文很少,“相关文章”模块往往按日期或标签而不是语义来挑选。示例:每篇文章上的面包屑“博客 > SEO > 内部链接”。
原理:嵌入找出相关页面和候选锚文本,编辑逐条批准或拒绝。适用场景:大约 50 篇到数千篇文章的内容网站。优点:理解上下文,有人工把关,锚文本自然多样。局限:需要审核时间,质量取决于阈值。示例:当一篇关于“关键词蚕食”的文章发布时,工具会推荐五篇已经有句子提到关键词蚕食的旧文章。
原理:从每个页面提取实体,并链接到你网站上该实体的参考页面。适用场景:有大量命名对象的网站:品牌、地点、人物、食材、软件。优点:消歧能力好,能建立清晰的“一个实体,一个页面”映射。局限:需要实体到页面的映射表,在抽象主题上较弱。示例:一个旅游网站把每次提到“京都”的地方都链接到京都指南,而从不链接到京都酒店页面。
原理:把网站看作一张图。工具为每个页面计算一个内部得分(类似 PageRank 的指标)、从首页出发的点击深度以及入站链接数,然后提出能把权重传给优先页面、并把深层页面拉近表层的链接。适用场景:大型网站、电商、任何业务页面被埋得很深的网站。优点:针对一个目标进行优化,而不仅仅是相关性。局限:这个模型只是对 Google 如何衡量链接的近似,纯粹的图逻辑如果不结合相关性过滤,可能产生不相关的链接。示例:一个位于第 5 层的分类页面,从三篇在相关查询上有排名的强势指南获得链接,上升到第 2 层。
原理:在撰写内容时就放置链接,由手头有网站页面清单的作者或 AI 写作工具完成。适用场景:任何定期发布内容的网站。优点:链接是为它专门写的句子的一部分,所以锚文本读起来很自然。局限:它处理的是新页面的出站链接,而不是旧页面指向它的入站链接,因此必须配合一种回填方法。示例:Sorank 的 AI 博客文章生成器在撰写每篇文章时,就已经放好了指向你的服务、产品或分类页面的内部链接。
| 方法 | 相关性 | 运行成本 | 锚文本质量 | 配置错误时的风险 | 最适合 |
|---|---|---|---|---|---|
| 基于规则的关键词自动链接 | 低 | 低 | 重复 | 高(关键词堆砌) | 术语表、产品名称 |
| 结构和模板模块 | 中 | 很低 | 笼统 | 低 | 所有网站,作为基础层 |
| 带审核的语义推荐 | 高 | 中(需审核) | 自然多样 | 低 | 博客和内容中心 |
| 基于实体的链接 | 对命名对象高 | 中 | 精准 | 中 | 旅游、电商、产品目录 |
| 基于图(内部 PageRank) | 不稳定 | 高(需分析) | 取决于过滤器 | 中 | 大型网站、被埋没的核心页面 |
| 写作时加链接 | 高 | 低 | 最自然 | 低 | 经常发布内容的网站 |
在配置任何东西之前,先决定你希望链接画出什么形状。维基百科式网状结构把任何页面链接到任何相关页面;这是语义工具的默认输出,适合百科类内容。语义茧把链接限制在同一主题树中的页面之间,母页面向下链接,子页面向上和横向链接;你的规则必须禁止跨茧链接(顶层除外)。URL 筒仓遵循文件夹结构(/guides/seo/...);一条简单的规则“只在同一文件夹内链接,外加中心页面”就能实现它。主题集群介于语义茧和网状结构之间,详见我们的主题集群和支柱页面指南。我们关于SEO 网站架构的文章介绍了如何选择。
没有规则的链接引擎就是垃圾链接生成器。以下是第一次运行前要写下来的设置,以及可以作为起点的数值。
完全自动插入 vs 推荐加审核
绝不要在标题、目录、图片说明、引文、行动号召按钮、作者简介中插入链接,也不要插在已有的 <a> 内部(嵌套链接是无效的 HTML)。绝不要把页面链接到它自己、链接到会重定向的 URL,或链接到带 noindex 或规范指向其他 URL 的页面。
Google 的文档要求锚文本“具有描述性、相当简洁,并且与其所在页面相关”,并把“点击这里”和“阅读更多”列为过于笼统的例子。把这转化为规则:锚文本 2 到 6 个词,取自现有句子,每个目标在全站至少有两到三个不同的变体,每个锚文本只对应一种意图。如果“内链工具”在一个页面上指向免费分析器,在另一个页面上指向付费功能,你就是在给搜索引擎讲两个不同的故事。我们的锚文本指南详细介绍了各种锚文本类型。
无论你使用的是带设置界面的插件还是脚本,都把规则写成一个文件。它会成为你的文档和审计记录。
{
  "global": {
    "max_auto_links_per_page": 5,
    "max_links_per_target_per_page": 1,
    "min_words_between_links": 60,
    "similarity_threshold": 0.55,
    "insert_only_in": ["article .content"],
    "skip_selectors": ["h1", "h2", "h3", "h4", "a", "figcaption", "blockquote", ".toc", ".cta", "nav", "footer"],
    "skip_targets_if": ["redirect", "noindex", "canonical_elsewhere", "status_not_200"],
    "mode": "suggest"
  },
  "priority_targets": [
    {"url": "/pricing", "boost": 1.5},
    {"url": "/guides/internal-linking-strategy", "boost": 1.3}
  ],
  "rules": [
    {"phrase": "crawl budget", "target": "/glossary/crawl-budget", "max_site_uses": 40, "mode": "auto"},
    {"phrase": "topic cluster", "target": "/glossary/topic-cluster", "max_site_uses": 40, "mode": "auto"}
  ],
  "never_link": ["/legal", "/login", "/cart"]
}
提示
每条新规则都先以“suggest”模式启动。只有在你连续批准了它的 20 条建议且没有做任何修改之后,才把它切换为“auto”模式。
无论使用什么工具,这个方法都适用。对于几百个页面的网站,设置需要一天,之后每周大约一小时。
用 Screaming Frog 等桌面爬虫抓取整个网站(我们的 Screaming Frog 设置指南介绍了配置方法)。为每个可索引 URL 导出:入站内部链接(去重)、点击深度、出站链接,以及爬虫的内部链接得分。把抓取结果与 XML 站点地图对比:在站点地图中但没有被抓取发现的 URL,就是你的孤立页面。保存这份带日期的导出文件,它就是你的“之前”。
并不是每个页面都值得更多链接。建立一份简短的优先目标清单:能带来收入的页面、在有价值查询上排名第 5 到 20 位的页面(Search Console 效果报告,按排名筛选),以及你的基石内容。再加上每个孤立页面,以及每个距离首页超过 3 次点击的页面。这份清单就是规则中的“priority_targets”。
为每个优先目标收集 3 到 10 个锚文本短语。最好的来源是 Search Console:在效果报告中打开该页面,切换到“查询”标签,导出它已经获得展示的查询词。再加上 H1、主关键词和自然变体。删除任何有歧义或与其他页面共用的短语。
运行你的工具或脚本。对于每个目标,它应该返回锚文本出现在正文中、且主题足够接近的源页面。预计漏斗会急剧收窄:这说明过滤器在起作用。
链接候选是如何被过滤的
在一个有五列的电子表格中审核建议:源页面、目标页面、锚文本、句子、得分。要读整句话,而不只是看锚文本。凡是你自己不会写的,都拒绝。记下拒绝的原因(意思不对、过于推销、附近已经有链接):这些原因会变成新的规则。
每批发布 50 到 200 条链接,作用于一组你能追踪的页面。保留一组没有新增链接的相似页面作为对照组。这样点击量的变化就有了参照,这一点很重要,因为排名变化的原因有很多。
重新抓取网站。检查新链接是否以 <a href> 的形式出现在原始 HTML 中,而不是只在 JavaScript 运行后才出现。挑几个 URL,用 Search Console 中的网址检查工具查看 Google 看到的渲染后 HTML。
真正的收益来自持续运行。每次发布文章时,系统应该做两件事:从新文章向外链接(写作时完成),并建议旧页面链接到它(回填)。每次 URL 发生变化时,它应该更新或删除指向该 URL 的链接。
提示
想快速检查单个页面,把它的 URL 粘贴到我们免费的内部链接分析工具中:它会列出页面上的每条内部链接、锚文本和属性,让你确认一批自动链接是否按计划上线。
如果你的 CMS 没有好用的工具,或者你想确切了解供应商到底做了什么,一个可运行的原型只需要大约 60 行代码。这个版本读取站点地图,提取主要内容,用开源模型计算嵌入,并输出一个供人工审核的建议 CSV 文件。它从不改动你的网站。
pip install requests beautifulsoup4 sentence-transformersimport csv, re
from urllib.parse import urljoin
import requests
from bs4 import BeautifulSoup
from sentence_transformers import SentenceTransformer, util
SITEMAP = "https://example.com/sitemap.xml"
urls = re.findall(r"<loc>(.*?)</loc>", requests.get(SITEMAP, timeout=20).text)
pages = {}
for url in urls:
r = requests.get(url, timeout=20)
if r.status_code != 200 or r.url != url:
continue # skip errors and redirects
soup = BeautifulSoup(r.text, "html.parser")
robots = soup.find("meta", attrs={"name": "robots"})
if robots and "noindex" in robots.get("content", ""):
continue
main = soup.find("article") or soup.find("main") or soup.body
for tag in main.find_all(["nav", "header", "footer", "aside", "script", "style"]):
tag.decompose()
pages[url] = {
"h1": soup.h1.get_text(" ", strip=True) if soup.h1 else "",
"text": main.get_text(" ", strip=True),
"links": {urljoin(url, a["href"]).split("#")[0] for a in main.find_all("a", href=True)},
}model = SentenceTransformer("all-MiniLM-L6-v2")
keys = list(pages)
docs = [pages[u]["h1"] + ". " + pages[u]["text"][:2000] for u in keys]
emb = model.encode(docs, normalize_embeddings=True)
sim = util.cos_sim(emb, emb)
# Anchor bank: target URL -> phrases (H1 + queries exported from Search Console)
anchors = {u: [pages[u]["h1"].lower()] for u in keys}
# anchors["https://example.com/crawl-budget"] += ["crawl budget", "crawl budget optimization"]
THRESHOLD, MAX_PER_PAGE = 0.55, 5
def find_anchor(text, phrases):
for phrase in sorted(phrases, key=len, reverse=True):
if len(phrase.split()) < 2:
continue
m = re.search(r"\b" + re.escape(phrase) + r"\b", text, re.IGNORECASE)
if m:
start = max(0, m.start() - 120)
return m.group(0), text[start:m.end() + 120]
return None, None
rows = []
for i, src in enumerate(keys):
added = 0
for j in sorted(range(len(keys)), key=lambda k: -float(sim[i][k])):
score = float(sim[i][j])
if score < THRESHOLD or added == MAX_PER_PAGE:
break
tgt = keys[j]
if tgt == src or tgt in pages[src]["links"]:
continue
anchor, context = find_anchor(pages[src]["text"], anchors[tgt])
if anchor:
rows.append([src, tgt, anchor, round(score, 2), context])
added += 1
with open("link_suggestions.csv", "w", newline="", encoding="utf-8") as f:
csv.writer(f).writerows([["source", "target", "anchor", "score", "context"]] + rows)无需写代码,爬虫也能完成部分工作。在 Screaming Frog 中,Custom Search 功能可以找到包含某个短语的所有页面,而使用 XPath 的 Custom Extraction 可以统计指向某个目标的链接数。包含该短语、但指向目标的链接数为零的页面,就是你的候选。SEO Spider 用户指南还介绍了它的 Link Score:“一个介于 0 到 100 之间的指标,根据页面的内部链接计算其相对价值”,它需要在抓取后运行抓取分析(crawl analysis)。
count(//article//a[contains(@href, "/guides/internal-linking-strategy")])
自动链接的大多数问题都不是惩罚,而是浪费的链接、混乱的信号,以及读起来像机器写的页面。下面介绍如何发现并修正每一种错误。
是什么:一个没有设置上限的规则插件,用同一个锚文本在 400 个页面上把“SEO 审核”链接到同一个页面。如何发现:在爬虫的锚文本导出中,按出现频率对内部锚文本排序;一个短语以数百次相同的用法指向同一个 URL,就是信号。如何修正:为每条规则设置全站使用上限,要求每个目标至少有两个变体,并从只是顺带提及该主题的页面中删除链接。
是什么:词匹配上了,意思却不对(水果“苹果”被链接到讲 iPhone 的文章,印尼的“爪哇岛”被链接到 Java 编程教程)。如何发现:每月随机抽查 30 条自动链接,读完整的句子。如何修正:提高相似度阈值,同时要求短语匹配和主题匹配,并为有歧义的规则添加否定关键词。
是什么:引擎在一个 60 词的段落中堆了四条链接。读者不再点击,文字也变得难读。如何发现:计算主要内容中每 100 词的链接数;超过 3 条就值得检查。如何修正:设置自动链接之间的最小间距,以及把作者已放置链接也计算在内的每页上限。
是什么:H2、目录或现有锚文本内部的匹配被包上新链接,产生嵌套的 <a> 标签或变成蓝色的标题。如何发现:对几个页面运行 HTML 验证器,或在抓取结果中搜索包含链接的标题。如何修正:明确声明禁止的选择器,并在每条新规则上线前,先在测试副本上测试。
是什么:前端小部件在页面加载后注入链接,有时没有 href,有时只在滚动或点击之后才出现。如何发现:比较原始 HTML(查看源代码)与渲染后的 DOM,并在 Search Console 的网址检查中查看渲染后的 HTML。如何修正:把插入移到服务端或存储的内容中。我们的 JavaScript SEO 指南详细解释了渲染。
警告
许多 AI 爬虫根本不运行 JavaScript。一条只在脚本运行后才出现的链接,Googlebot 在渲染后也许能看到,但为 ChatGPT、Claude 或 Perplexity 提供数据的机器人却看不到。
是什么:根据旧的页面清单生成的自动链接,持续指向已经迁移或删除的 URL。如何发现:在抓取结果中按状态码(3xx、4xx)和不可索引的目标筛选内部链接;我们免费的死链检查工具可以针对单个页面完成这项检查。如何修正:每次运行前刷新页面清单,只接受返回 200、可索引且规范指向自身的目标,并在创建 301 时就地更新链接。
是什么:网站以为自己已经做好了内链,因为每篇文章结尾都有三篇相关文章。这些模块通常按标签或日期挑选,内容轮换,并完全跳过旧内容。如何发现:你的孤立页面报告(站点地图中有但抓取未到达,或只能通过分页到达的 URL)一直很长。如何修正:保留小部件,但在正文中添加上下文链接,并从中心页面添加固定链接。
是什么:“内链工具”在一些文章中链接到页面 A,在另一些文章中链接到页面 B。你分散了相关性信号,并可能加剧关键词蚕食。如何发现:根据抓取结果建立锚文本到目标的映射,标记任何对应多个目标的锚文本。如何修正:一个搜索意图对应一个目标页面;把较弱页面的锚文本重新分配。
是什么:链接被一个插件插入到内容中,后来插件被卸载了,或者没人知道哪些链接是自动添加的。如何发现:你回答不了“上个月工具添加了多少条链接?”这个问题。如何修正:把每条自动链接存入一张表(源页面、目标页面、锚文本、规则、日期、状态),如果技术栈允许,在 HTML 中用 data 属性标记它们,并确认你能一次性删除某条规则产生的所有链接。
| 错误 | 要寻找的信号 | 修正方法 |
|---|---|---|
| 每次出现都加链接 | 一个锚文本数百次指向同一个 URL | 全站上限、锚文本变体 |
| 语义错误 | 人工抽查中出现奇怪的句子 | 提高阈值、否定关键词 |
| 链接密度 | 每 100 词超过 3 条链接 | 词间距、每页上限 |
| 禁止区域 | 标题中的链接、嵌套锚文本 | 明确的跳过选择器 |
| 仅存在于 JavaScript 的链接 | 查看源代码时链接缺失 | 服务端插入 |
| 失效目标 | 抓取中出现 3xx 和 4xx 内部链接 | 刷新页面清单、只接受 200 的目标 |
| 只靠小部件 | 孤立页面清单很长 | 上下文链接和中心页面链接 |
| 一个锚文本两个目标 | 锚文本映射中有重复 | 一个意图,一个页面 |
| 没有日志 | 无法统计自动链接数量 | 链接表、data 属性、回滚 |
内部链接很少带来一夜之间的跃升。在获得链接的页面上衡量,与对照组比较,周期为 4 到 12 周。
每批链接上线后要追踪的指标
Search Console 的链接报告会显示你的“内部链接最多的网页”,并列出指向每个页面的页面。它适合用来做合理性检查(你的优先页面是否排在前面?),但 Google 的帮助页面提醒,其表格最多只显示 1000 行,而且该报告“并不是你网站上所有链接的完整列表”。把你自己的抓取结果作为事实依据,用 Search Console 来查看 Google 实际采集到了什么。
如果你能访问服务器日志,它们会显示每批链接上线后,Googlebot 和 AI 爬虫是否更频繁地访问新获得链接的页面。这是“发现”得到改善的最直接信号。我们的 SEO 日志文件分析指南解释了如何过滤机器人、解读抓取频率,以及为什么这对大型网站的抓取预算很重要。
如果目标页面的展示次数上升而对照组没有,链接很可能起了作用。如果两者都上升,很可能是季节性或算法因素。如果目标页面展示增加而点击没有增加,下一步该优化的是标题和内容,而不是增加更多链接。如果 12 周后毫无变化,检查基础问题:链接是否在原始 HTML 中?目标页面是否真的被编入索引?
起步并不需要大型工具。挑选一个 20 到 50 个页面的集群,抓取它,列出其中的孤立页面和优先页面,从 Search Console 建立锚文本库,然后通过一批经过审核的链接把它们连起来。衡量六周,把学到的东西写成规则,再扩展到下一个集群。
如果你经常发布内容,成本最低的收益来自写作时加链接:每篇新文章离开编辑器时,都应该已经带有指向正确页面的链接。这正是 Sorank 为你撰写和发布文章时所做的事,它的主题集群生成器会规划这些链接所遵循的集群,并内置防蚕食机制。对于旧页面,再结合上面介绍的方法进行经过审核的回填。
安全,只要链接相关、使用描述性锚文本,并控制在合理的上限之内。Google 的文档要求可抓取的链接和描述性锚文本,并警告不要过度链接,但并不反对自动化本身。风险来自那些用同一个锚文本链接每一次关键词出现的工具,所以请保留审核环节,并记录每一条自动链接。
Google 表示没有理想数量。一个实用的起点是:在一篇约 1500 词的文章中,除作者已放置的链接外,再添加 3 到 5 条自动上下文链接,每个目标只链接一次,并让链接之间保持一定距离。用你自己的页面来衡量和调整;Zyppy 的一项相关性研究发现,每个 URL 的入站内部链接增加到约 40 条时效果持续提升,超过约 45 到 50 条后出现反转。
不能。自动化负责执行策略:发现候选、插入链接并保持更新。你仍然需要决定优先推哪些页面、链接遵循哪种架构(网状结构、语义茧或筒仓),以及哪些锚文本属于哪个页面。
我们免费分析您的竞争对手、网站和 AI 可见度,为您制定专属内容计划。
 AI 内容简报生成器
 FAQ 结构化数据生成器
 AI 文章选题生成器
 结构化数据验证工具(Schema 验证器)
 图片替代文本检查工具
 内部链接分析工具
 外链挑战
 AI meta 描述生成器
 AI 博客标题生成器
 Google 可收录性检查工具
 AI 文章大纲生成器
 UTM 链接生成器
 关键词聚类工具
 规范标签检查工具
 XML 站点地图生成器
 死链检查工具
 AI SEO 标题生成器
 标题评分工具
 搜索结果预览工具
 重定向检查工具
 hreflang 标签生成器
 标题结构分析工具
 HTTP 响应头检测工具
 Favicon 提取工具
 SEO 流量与收入预测计算器
 SEO 预算计算器
 排名提升模拟器
 关键词机会得分计算器
 GEO 内容投入计算器
 客户终身价值计算器
 点击率计算器
 AI 流量价值计算器
 AI 声量份额计算器
 Gemini 排名查询工具
 ROAS 计算器
 自然流量价值计算器
 本地 SEO 投资回报计算器
 外链建设成本计算器
 关键词密度计算器
 客户获取成本计算器
 单篇文章成本计算器
 跳出率计算器
 AI 引用率计算器
 结构化数据大语言模型审计
 llms.txt 生成器
 站点地图检查工具
 SERP 波动监测器
 字数统计工具
 结构化数据生成器
 关键词研究工具
 SEO 盈亏平衡计算器
 阅读时长计算器
 自然流量预估工具与网站流量查询
 ChatGPT 引荐流量估算器
 AI 曝光度得分计算器
 LLM 可读性检查器
 SearchGPT 就绪度检测工具
 ChatGPT 为什么不推荐我的网站
 URL 提取工具
 网页转 Markdown
 Robots 生成器
 OG 预览
 页面 SEO 审核:SEO 检查与 SEO 分析工具
 LTV 与 CAC 比率计算器
 GEO 回报率计算器
 转化率计算器
 网站可抓取性 AI 审计
 AI 搜索曝光度测试
 页面体积检测工具
 URL Slug 生成器
 Meta 标签生成器
 图片压缩工具
 网站图标生成器
 域名权重查询工具
 SERP 点击率计算器
 电商 SEO 投资回报率计算器
 内容营销投资回报率计算器
 AI 隐形成本计算器
 AI Overview 检查工具与 AI Overviews 排名检查
 Robots.txt 检查工具
 AI SEO 审核
 Perplexity 引用检测工具
 回答引擎优化审核
 ChatGPT 可见度检测工具
 外链分析工具
 SEO 与付费搜索省钱计算器
 SEO 声量占比计算器
 SaaS SEO ROI 计算器
 反向链接投资回报率计算器
 llms.txt 验证器
 LLM 引用检查器
 GEO 审核
 SEO ROI 计算器
 关键词价值计算器
5 条评价,评分 5/5
 “两年来,我 100% 的客户都来自 LinkedIn。每天发帖、评论、私信跟进……完全依赖算法。我知道自己需要做 SEO,但总是往后拖:太花时间、太技术、不是我的本行。有了 Sorank,我终于迈出了这一步。4 个月里,我在什么都不发的情况下每月获得 15 个自然线索。目前还没有做到和 LinkedIn 各占一半,但知道自己现在有了第二个能自动增长的线索来源,我睡得更踏实了。”

 Valentin Thomyoffbound.fr
 “我是开发者,不是做市场的。我的 Shopify 主题此前只靠口碑和广告在卖。有了 Sorank,我终于明白该如何搭建自己的 SEO,以及怎样写出能获得排名的文章。审计发现我的产品页面太慢了。两个月内,我的自然流量翻了一倍,当人们搜索 Shopify 主题时,我也开始出现在 ChatGPT 的回答里。而这一切每周只花大约 2 小时。”
 Thème FullStackgo.themefullstack.com
 “对市场营销机构来说是个很棒的工具!用它来审计网站、找出加载慢的页面、确定需要补充哪些内容以及补在哪里,都非常快。”
 Thomas Giraudthe-deployer.fr“我们是一家广告代理商,想要一劳永逸地把 SEO 重新做起来。Sorank 让我们清楚地看到自己网站的情况,帮助我们排定优化的优先级,并把内容结构梳理好。这个工具易于使用,很适合团队,而且非常实用,可以集中跟踪,不用在多个平台之间来回切换。这是我们重新开始做 SEO 的一个非常扎实的基础。”
 Gaspard Madoui广告代理商