Integritet är viktigt för oss, så du kan välja att inaktivera vissa typer av lagring som kanske inte är nödvändig för webbplatsens grundläggande funktioner. Om du blockerar kategorier kan det påverka din upplevelse av webbplatsen. Mer information (Cookiepolicy)
Automatisk intern länkning: metoder, uppsättning och reglerna som håller det säkert
Lär dig hur automatisk intern länkning fungerar, jämför 6 metoder, följ en uppsättning steg för steg och undvik misstagen som gör autolänkar till spam.
Ett nät av sidor kopplade med interna länkar, där vissa placerats automatiskt och kontrollerats av en redaktör före publicering.
Verktyg
På den här sidan
Kort sagt
automatisk intern länkning innebär att ett program hittar, föreslår eller infogar länkarna mellan dina egna sidor, i stället för att du placerar varje länk för hand. Det fungerar bra när maskinen tar det tråkiga jobbet (crawla, matcha ämnen, hitta föräldralösa sidor, logga varje länk) och du behåller kontrollen över reglerna: vilka sidor som ska lyftas, vilka ankartexter som är tillåtna och hur många länkar per sida. Bygg upp det som "föreslå, godkänn, publicera, mät", inte som ett tillägg som länkar varje sökord det hittar.
3 dagar gratis, sedan kan du avsluta när du vill. 90 dagars resultatgaranti, villkor gäller.
Vad automatisk intern länkning är (och vad det inte är)
En intern länk är en länk från en sida på din webbplats till en annan sida på samma webbplats. Den gör tre saker: den låter crawlers upptäcka sidor, den berättar för sökmotorer och AI-system vad målsidan handlar om (genom ankartexten och orden runt omkring), och den för vidare auktoritet från starka sidor till svagare. Om grunderna är nya för dig, börja med vår definition av intern länkning.
Att automatisera det betyder att ett program sköter en eller flera av dessa uppgifter:
Inventering: crawla webbplatsen och lista varje sida, varje befintlig länk och varje ankartext.
Matchning: avgöra vilken sida som ska länka till vilken, utifrån sökord, betydelse eller entiteter.
Val av ankartext: hitta en fras som redan finns i källtexten och som beskriver målet.
Infogning: skriva in länken i HTML-koden, i CMS-databasen eller vid rendering.
Underhåll: rätta länkar när en URL ändras, en sida tas bort eller en ny artikel publiceras.
Vad det inte är: ett sätt att trycka in samma sökordslänk på 500 sidor, en ersättning för en webbplatsarkitektur eller en widget med relaterade inlägg längst ner i varje artikel. De kan ingå i ett automatiserat system, men på egen hand skapar de mest brus.
Varför manuell länkning inte håller
Manuell länkning fungerar på en webbplats med 30 sidor. Den fallerar på en webbplats som publicerar varje vecka, av en enkel anledning: varje ny artikel skapar två jobb. Den behöver länkar ut till befintliga sidor, och äldre sidor behöver länka tillbaka till den. Det andra jobbet är det alla glömmer. Efter två års publicering har du nya artiklar som ingen länkar till och gamla artiklar som fortfarande pekar på sidor du sedan dess har ersatt.
Intern länkning före och efter automatisering
Före (manuellt)
Nya artiklar får länkar ut, sällan länkar in
Föräldralösa sidor hopar sig utan att någon märker det
Länkar pekar på omdirigeringar och borttagna URL:er
Ankartexterna beror på vem som skrev artikeln
Efter (automatiserat, med granskning)
Varje ny sida får länkar in från relaterade sidor
Föräldralösa sidor flaggas vid varje crawl
Trasiga och omdirigerade mål uppdateras
Ankartexter följer skrivna regler och loggas
Den här artikeln handlar om maskineriet: metoder, inställningar, ett fungerande skript och vanliga felkällor. För den strategiska sidan (vilka sidor som ska prioriteras, hur man planerar länkar för en flerspråkig webbplats), läs först vår expertguide till strategi för intern länkning. De två texterna är gjorda för att användas tillsammans.
Varför det spelar roll: vad data säger om interna länkar
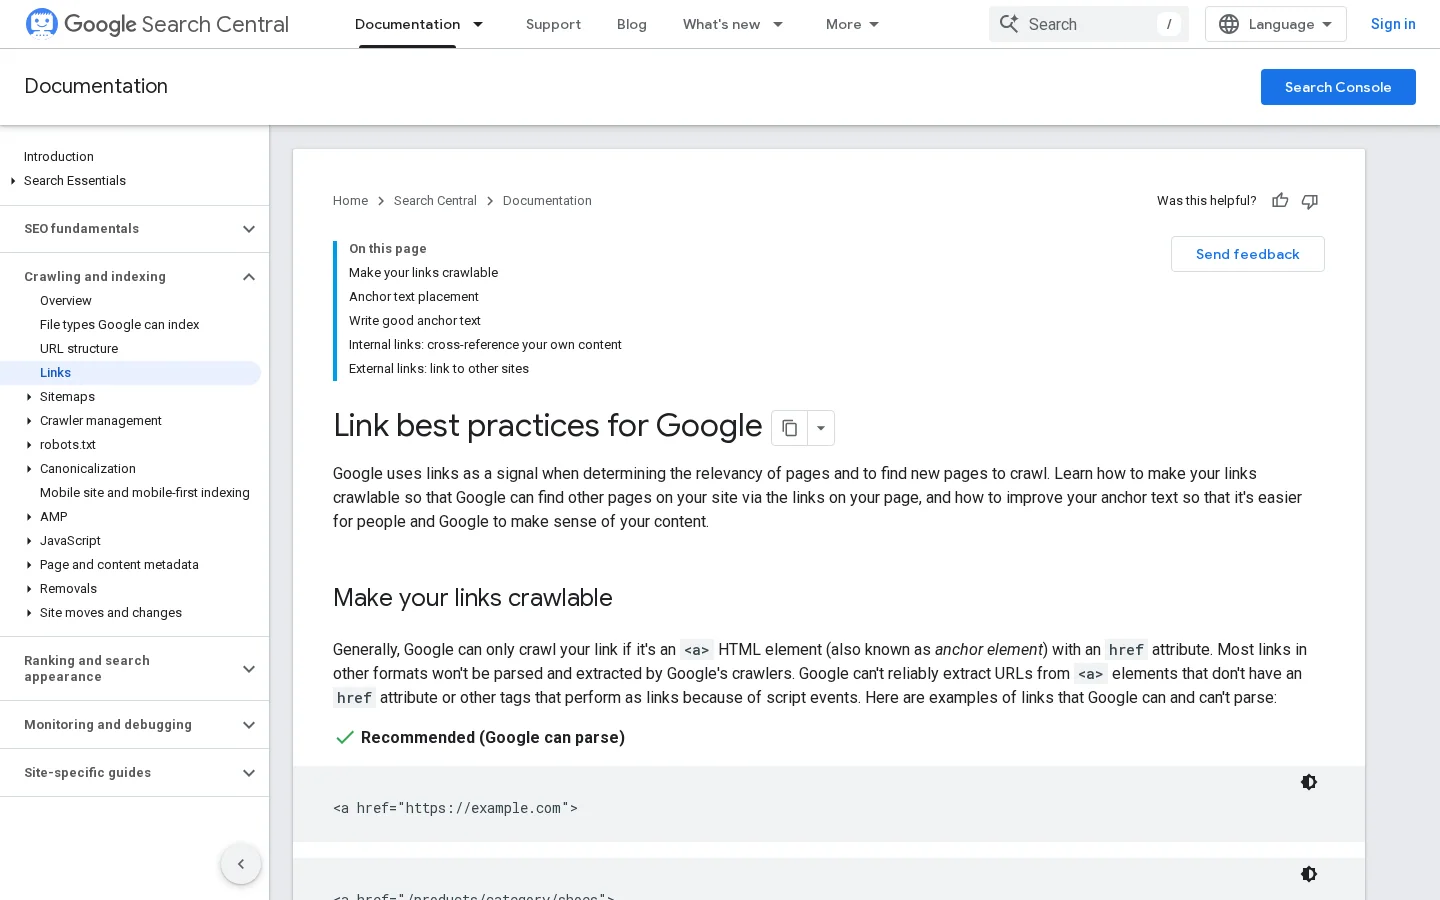
Google är tydligt med miniminivån. Dess dokumentation om bästa praxis för länkar säger att "varje sida du bryr dig om bör ha en länk från minst en annan sida på din webbplats", och att Google i regel bara kan crawla en länk om den är ett <a>-element med ett href-attribut. En föräldralös sida är inte förbjuden, men då satsar du på att sajtkartan ensam ska få den hittad och förstådd.
Utöver miniminivån är det bästa offentliga datasetet i ämnet en korrelationsstudie av Cyrus Shepard på Zyppy, "23 Million Internal Links: SEO Case Study" (uppdaterad i februari 2026). Den kopplade data om interna länkar från cirka 1800 webbplatser till klick i Search Console.
Vad 23 miljoner interna länkar visar
23 miljonerinterna länkar analyserade över cirka 520000 URL:er
1800webbplatser i datasetet, kopplade till klick i Google Search Console
5xminst fem gånger mer trafik för sidor med minst en intern ankartext med exakt matchning
6%över 6% av alla interna länkar saknade helt ankartext
Källa: Cyrus Shepard, Zyppy, 23 Million Internal Links SEO Case Study, uppdaterad februari 2026
Det mest användbara resultatet för automatisering handlar om volym. URL:er med 0 till 4 interna länkar fick i snitt 2 klick från Google, medan URL:er med 40 till 44 interna länkar fick fyra gånger så många. Efter ungefär 45 till 50 länkar vänder effekten. Författaren förklarar en stor del av nedgången med sidövergripande navigationslänkar, och han är noga med att kalla studien korrelationell: användbar som riktning, inte ett bevis.
Genomsnittliga Google-klick per URL efter antal interna länkar som pekar dit
0 till 4 interna länkar2 klick
40 till 44 interna länkar8 klick (4x)
Källa: Cyrus Shepard, Zyppy, 23 Million Internal Links SEO Case Study, uppdaterad februari 2026
Två praktiska lärdomar följer. För det första är det sidorna som saknar länkar som vinner mest, och det är precis vad automatisering är bra på att hitta. För det andra fann studien att variation i ankartexter korrelerade med klick, och att sidor med URL-ankare och ankare med exakt matchning presterade bättre. Ett system som länkar varje sida med samma tre ord kastar bort den variationen.
GEO-perspektivet
AI-crawlers som GPTBot, ClaudeBot och PerplexityBot upptäcker sidor på samma sätt som Googlebot: genom att följa <a href>-länkar. Många av dem kör inte JavaScript, så en länk som läggs in på klientsidan kanske helt enkelt inte finns för dem. Vår guide om AI-crawlers förklarar vad varje bot hämtar. Rena, serverrenderade interna länkar hjälper både sökmotorerna och de AI-motorer som citerar dina sidor.
Automatisk intern länkning: maskinen hittar och placerar länkarna, en människa sätter reglerna och kontrollerar resultatet.
Hur en motor för automatisk intern länkning fungerar under huven
Varje seriöst verktyg, oavsett om det är ett tillägg, en SaaS-tjänst eller ett skript du skriver själv, kör samma kedja. Om du känner till den kan du bedöma ett verktyg på fem minuter: fråga hur det gör varje steg.
De 6 stegen i en motor för intern länkning
InventeraCrawla eller läs CMS:et för att lista varje indexerbar sida, dess huvudinnehåll, titel, H1 och befintliga utgående länkar.
RepresenteraGör om varje sida till något jämförbart: en sökordslista, en uppsättning entiteter eller en embedding-vektor.
MatchaPoängsätt varje par av källa och mål efter relevans och behåll de bästa kandidaterna per sida.
Välj ankartextHitta en fras som redan finns i källtexten och som beskriver målet.
Tillämpa reglernaUpprätthåll tak, undantag, prioriteringar och förbjudna zoner (rubriker, befintliga länkar, navigering).
Infoga och loggaSkriv in länken, spara källa, mål, ankartext, regel och datum, och crawla sedan om för att verifiera.
Steg 1: inventering, och varför "huvudinnehåll" spelar roll
Inventeringen måste skilja huvudinnehållet från mallen. En länk i sidhuvudets meny visas på varje sida och säger Google lite om målet. En länk i tredje stycket av en relevant artikel säger mycket. Bra motorer tar bort nav, header, footer och aside före analysen och infogar bara i själva artikeltexten. De utesluter också icke-indexerbara URL:er: allt som returnerar en omdirigering, en 404, en noindex eller en canonical som pekar någon annanstans.
Steg 2: att representera sidor
Det finns tre vanliga representationer, från grov till fin:
Sökord: varje målsida äger en lista med fraser ("strategi för intern länkning", "länkstruktur"). Snabbt och förutsägbart, men blint för betydelse.
Entiteter: ett bibliotek för språkteknologi plockar ut namngivna saker (produkter, platser, begrepp) och kopplar dem till sidorna som täcker dem. Bättre på att skilja olika betydelser åt.
Embeddings: en språkmodell gör om varje sida till en vektor med några hundra tal. Sidor om liknande ämnen hamnar nära varandra, även om de inte delar ett enda exakt ord. Det är vad de flesta "AI"-verktyg för länkning använder i dag.
Steg 3: matchning
Med embeddings är matchningen en cosinuslikhet mellan vektorer, ett värde mellan -1 och 1 (i praktiken 0 till 1 för text). Du behåller par över ett tröskelvärde och de N bästa per sida. Tröskeln är den viktigaste inställningen: för låg och du länkar en sida om ormen python till en sida om programspråket Python; för hög och du hittar bara nästan identiska sidor. Börja runt 0,5 till 0,6 med en allmän modell och justera efter att ha granskat 50 förslag för hand.
Steg 4: val av ankartext
Ankartexten ska vara en fras som redan finns i källmeningen. Att infoga nya ord innebär att skriva om innehållet, vilket är ett annat jobb. Motorn söker i källtexten efter fraser som beskriver målet: dess huvudsökord, dess H1, närliggande varianter eller de sökfrågor som målet redan rankar för i Search Console. Den sista källan är bäst, eftersom den speglar hur riktiga människor beskriver sidan.
Steg 5 och 6: regler, infogning, logg
Det är i reglerna kvaliteten vinns eller förloras (se det särskilda avsnittet nedan). Infogningen sker på ett av tre ställen: i det lagrade innehållet (länken blir en del av artikeln, permanent och synlig i redigeraren), vid rendering på servern (ett filter lägger till länkar när sidan genereras, lätt att backa) eller i webbläsaren med JavaScript (det svagaste alternativet för SEO). Oavsett metod är en logg över varje automatisk länk inte valfri: utan den kan du inte granska, mäta eller ångra.
De 6 metoderna för automatisk intern länkning, jämförda
"Automatisk intern länkning" täcker väldigt olika tekniker. De flesta webbplatser hamnar i en kombination av två eller tre.
1. Regelbaserad automatisk sökordslänkning
Princip: du underhåller en tabell "fras leder till URL", och systemet länkar frasen överallt där den förekommer. När den ska användas: ordlistor, produktnamn, ett litet antal sidor som drar in pengar. Fördelar: förutsägbar, transparent, billig. Begränsningar: ingen förståelse för sammanhang, identiska ankartexter överallt, tabellen blir inaktuell. Exempel: varje första omnämnande av "crawlbudget" länkar till ordlistans sida om crawlbudget, med ett tak på en länk per artikel.
2. Strukturella moduler och mallmoduler
Princip: CMS:et genererar länkar från webbplatsens struktur: brödsmulor, kategorilistor, "relaterade artiklar", föregående och nästa, navsidor som listar sina undersidor. När den ska användas: alltid, det är grundlagret. Fördelar: inget underhåll, garanterar att ingen sida i en kategori blir föräldralös. Begränsningar: mallänkar har lite sammanhang, och moduler för "relaterade inlägg" väljer ofta efter datum eller tagg snarare än betydelse. Exempel: en brödsmula "Blogg > SEO > Intern länkning" i varje artikel.
3. Semantiska förslag med mänskligt godkännande
Princip: embeddings hittar relaterade sidor och tänkbara ankartexter; en redaktör godkänner eller avvisar varje förslag. När den ska användas: innehållssajter från cirka 50 till flera tusen artiklar. Fördelar: tar hänsyn till sammanhang, behåller en människa i loopen, ankartexterna varierar naturligt. Begränsningar: granskningstid, och kvaliteten beror på tröskelvärdet. Exempel: när en artikel om "sökordskannibalisering" publiceras föreslår verktyget fem äldre artiklar där en mening redan nämner kannibalisering.
4. Entitetsbaserad länkning
Princip: entiteter plockas ut från varje sida och länkas till den sida som är referensen för entiteten på din webbplats. När den ska användas: webbplatser med många namngivna saker: varumärken, platser, personer, ingredienser, programvara. Fördelar: bra på att skilja betydelser åt, bygger en ren karta "en entitet, en sida". Begränsningar: kräver en karta från entitet till sida, svagare på abstrakta ämnen. Exempel: en resesajt länkar varje omnämnande av "Kyoto" till sin Kyoto-guide och aldrig till sidan om hotell i Kyoto.
5. Grafstyrd länkning (intern PageRank)
Princip: webbplatsen behandlas som en graf. Verktyget räknar ut ett internt värde för varje sida (ett mått i stil med PageRank), dess klickdjup från startsidan och dess inkommande länkar, och föreslår sedan länkar som skickar auktoritet till prioriterade sidor och lyfter djupt liggande sidor närmare ytan. När den ska användas: stora webbplatser, e-handel, alla sajter där affärssidorna ligger begravda. Fördelar: optimerar mot ett mål, inte bara mot relevans. Begränsningar: modellen är en uppskattning av hur Google väger länkar, och ren graflogik kan skapa irrelevanta länkar om den inte kombineras med ett relevansfilter. Exempel: en kategorisida på djup 5 får länkar från tre starka guider som rankar för närliggande sökfrågor och flyttas upp till djup 2.
6. Länkning när texten skrivs
Princip: länkarna placeras medan innehållet skrivs, av en skribent eller ett AI-skrivverktyg som har webbplatsens inventering framför sig. När den ska användas: alla webbplatser som publicerar regelbundet. Fördelar: länken är en del av en mening som skrivits för den, så ankartexterna läses naturligt. Begränsningar: den hanterar länkar ut från den nya sidan, inte länkar in till den från äldre sidor, så den måste kombineras med en metod för efterlänkning. Exempel: Soranks AI-generator för bloggartiklar skriver varje artikel med interna länkar till dina tjänste-, produkt- eller kategorisidor redan på plats.
Metod
Relevans
Arbetsinsats
Ankartextens kvalitet
Risk vid felinställning
Passar bäst för
Regelbaserad automatisk sökordslänkning
Låg
Låg
Upprepande
Hög (sökordsstoppning)
Ordlistor, produktnamn
Strukturella moduler och mallmoduler
Medel
Mycket låg
Generisk
Låg
Alla webbplatser, som grundlager
Semantiska förslag med godkännande
Hög
Medel (granskning)
Naturlig och varierad
Låg
Bloggar och innehållsnav
Entitetsbaserad länkning
Hög för namngivna saker
Medel
Precis
Medel
Resor, e-handel, kataloger
Grafstyrd (intern PageRank)
Varierande
Hög (analys)
Beror på filtret
Medel
Stora sajter, begravda affärssidor
Länkning när texten skrivs
Hög
Låg
Mest naturlig
Låg
Sajter som publicerar ofta
Automatisering tjänar en arkitektur, den ersätter den inte
Innan du konfigurerar något, bestäm vilken form länkarna ska rita. Ett nät i Wikipedia-stil länkar vilken sida som helst till vilken relaterad sida som helst; det är standardresultatet från semantiska verktyg och fungerar bra för uppslagsinnehåll. En semantisk kokong begränsar länkarna till sidor i samma ämnesträd, där modersidor länkar nedåt och dottersidor länkar uppåt och i sidled; dina regler måste förbjuda länkar mellan kokonger utom på toppnivå. En URL-silo följer mappstrukturen (/guides/seo/...); en enkel regel "länka bara inom samma mapp, plus navsidan" upprätthåller den. Ämneskluster, som beskrivs i vår guide om ämneskluster och pelarsidor, ligger mellan kokongen och nätet. Vår artikel om webbplatsarkitektur för SEO tar upp hur du väljer.
Reglerna som håller automatiska länkar säkra
En länkmotor utan regler är en spamgenerator. Det här är inställningarna du ska skriva ner före den första körningen, med värden som fungerar som utgångspunkt.
Helt automatisk infogning eller föreslå och godkänn
Helt automatiskt
Skalar till vilken volym som helst direkt
Ingen redaktionell tid
Fel publiceras i stor skala
Konstiga ankartexter och fel sammanhang slinker igenom
Svårt att förklara varför en länk finns
Föreslå och godkänn
Maskinen hittar, människan bestämmer
Varje länk har en ägare och ett skäl
Reglerna förbättras utifrån avvisade förslag
Kan gå över till automatiskt för betrodda regler
Kräver granskningstid varje vecka
Tak och täthet
Automatiska länkar per sida: 3 till 5 i en artikel på 1500 ord, utöver de länkar skribenten själv placerat. Google säger att det inte finns något idealantal men varnar för överdriven länkning; dina egna data säger dig mer än någon tumregel.
En länk per mål och sida. Att länka samma URL tre gånger i en artikel tillför inget för läsaren och gör din rapportering grumlig.
Minsta avstånd: minst 50 till 80 ord mellan två automatiska länkar, så att styckena inte blir blå.
Max per ankarfras över hela sajten: sätt ett tak för hur många sidor som får använda exakt samma ankartext till samma mål, och tvinga sedan fram varianter.
Förbjudna zoner
Infoga aldrig i rubriker, innehållsförteckningen, bildtexter, citat, knappar för uppmaningar, författarrutor eller inuti en befintlig <a> (nästlade länkar är ogiltig HTML). Länka aldrig en sida till sig själv, till en URL som omdirigerar eller till en sida som är noindex eller har en canonical till en annan URL.
Regler för ankartext
Googles dokumentation ber om ankartext som är "beskrivande, någorlunda kortfattad och relevant för sidan den står på", och anger "klicka här" och "läs mer" som för generiska. Översätt det till regler: ankartexter på 2 till 6 ord, hämtade från den befintliga meningen, minst två eller tre olika varianter per mål över hela sajten, och en avsikt per ankartext. Om "verktyg för intern länkning" pekar på en gratis analysator på en sida och på en betald funktion på en annan, berättar du två olika historier för sökmotorerna. Vår guide om ankartext går igenom typerna av ankartext i detalj.
Alla sidor förtjänar inte fler länkar. Gör en kort lista med prioriterade mål: sidor som drar in pengar, sidor som rankar på position 5 till 20 för värdefulla sökfrågor (Search Console, rapporten Resultat, filtrera på position) och ditt hörnstensinnehåll. Lägg till varje föräldralös sida och varje sida som ligger djupare än 3 klick. Listan matar "priority_targets" i dina regler.
Steg 3: bygg ankarbanken
Samla 3 till 10 ankarfraser för varje prioriterat mål. Bästa källan är Search Console: öppna sidan i rapporten Resultat, gå till fliken Sökfrågor och exportera de sökfrågor den redan får visningar för. Lägg till H1, huvudsökordet och naturliga varianter. Ta bort allt som är tvetydigt eller som delas med en annan sida.
Steg 4: generera kandidater och filtrera dem
Kör ditt verktyg eller skript. För varje mål ska det returnera källsidor där ankartexten finns i brödtexten och där ämnet ligger tillräckligt nära. Räkna med att tratten smalnar av kraftigt: det är ett tecken på att filtren fungerar.
Hur länkkandidater filtreras
Alla par av källa och mål på webbplatsenAlla par
Par över likhetströskelnTopp 20 per sida
Par där en naturlig ankartext finns i textenAnkartext hittad
Par som klarar tak och förbjudna zonerRegler godkända
Länkar som godkänts och publicerats3 till 5 per sida
Steg 5: granska i omgångar
Granska förslagen i ett kalkylark med fem kolumner: källa, mål, ankartext, mening, poäng. Läs meningen, inte bara ankartexten. Avvisa allt du inte själv hade skrivit. Notera varför du avvisar (fel betydelse, för säljigt, redan länkat i närheten): de skälen blir nya regler.
Steg 6: publicera i vågor, inte allt på en gång
Publicera 50 till 200 länkar per våg, på en uppsättning sidor du kan följa. Behåll en kontrollgrupp med liknande sidor utan nya länkar. Förändringar i klick får då en referenspunkt, vilket är viktigt eftersom rankningar rör sig av många skäl.
Steg 7: crawla om och verifiera den renderade HTML-koden
Crawla om webbplatsen. Kontrollera att de nya länkarna syns som <a href> i den råa HTML-koden, inte bara efter att JavaScript körts. För några URL:er, använd verktyget för URL-granskning i Search Console och titta på den renderade HTML som Google ser.
Steg 8: koppla in det i publiceringen
Den verkliga vinsten är löpande. Varje gång en artikel publiceras ska systemet göra två saker: länka ut från den nya artikeln (när den skrivs) och föreslå länkar in till den från äldre sidor (efterlänkning). Varje gång en URL ändras ska det uppdatera eller ta bort länkarna som pekar på den.
Tips
För att snabbt kontrollera en sida, klistra in dess URL i vår kostnadsfria analysator för interna länkar: den listar varje intern länk på sidan, dess ankartext och dess attribut, så att du kan bekräfta att en våg av automatiska länkar gick ut som planerat.
Bygg ditt eget: ett skript för semantisk intern länkning i Python
Om ditt CMS saknar ett bra verktyg, eller om du vill förstå exakt vad en leverantör gör, tar en fungerande prototyp ungefär 60 rader. Den här versionen läser sajtkartan, plockar ut huvudinnehållet, räknar ut embeddings med en öppen källkodsmodell och skriver ut en CSV med förslag för manuell granskning. Den rör aldrig din webbplats.
import csv, re
from urllib.parse import urljoin
import requests
from bs4 import BeautifulSoup
from sentence_transformers import SentenceTransformer, util

SITEMAP = "https://example.com/sitemap.xml"
urls = re.findall(r"<loc>(.*?)</loc>", requests.get(SITEMAP, timeout=20).text)

pages = {}
for url in urls:
    r = requests.get(url, timeout=20)
    if r.status_code != 200 or r.url != url:
        continue  # skip errors and redirects
    soup = BeautifulSoup(r.text, "html.parser")
    robots = soup.find("meta", attrs={"name": "robots"})
    if robots and "noindex" in robots.get("content", ""):
        continue
    main = soup.find("article") or soup.find("main") or soup.body
    for tag in main.find_all(["nav", "header", "footer", "aside", "script", "style"]):
        tag.decompose()
    pages[url] = {
        "h1": soup.h1.get_text(" ", strip=True) if soup.h1 else "",
        "text": main.get_text(" ", strip=True),
        "links": {urljoin(url, a["href"]).split("#")[0] for a in main.find_all("a", href=True)},
    }
Embedda, matcha och hitta ankartexter
model = SentenceTransformer("all-MiniLM-L6-v2")
keys = list(pages)
docs = [pages[u]["h1"] + ". " + pages[u]["text"][:2000] for u in keys]
emb = model.encode(docs, normalize_embeddings=True)
sim = util.cos_sim(emb, emb)

# Anchor bank: target URL -> phrases (H1 + queries exported from Search Console)
anchors = {u: [pages[u]["h1"].lower()] for u in keys}
# anchors["https://example.com/crawl-budget"] += ["crawl budget", "crawl budget optimization"]

THRESHOLD, MAX_PER_PAGE = 0.55, 5

def find_anchor(text, phrases):
    for phrase in sorted(phrases, key=len, reverse=True):
        if len(phrase.split()) < 2:
            continue
        m = re.search(r"\b" + re.escape(phrase) + r"\b", text, re.IGNORECASE)
        if m:
            start = max(0, m.start() - 120)
            return m.group(0), text[start:m.end() + 120]
    return None, None

rows = []
for i, src in enumerate(keys):
    added = 0
    for j in sorted(range(len(keys)), key=lambda k: -float(sim[i][k])):
        score = float(sim[i][j])
        if score < THRESHOLD or added == MAX_PER_PAGE:
            break
        tgt = keys[j]
        if tgt == src or tgt in pages[src]["links"]:
            continue
        anchor, context = find_anchor(pages[src]["text"], anchors[tgt])
        if anchor:
            rows.append([src, tgt, anchor, round(score, 2), context])
            added += 1

with open("link_suggestions.csv", "w", newline="", encoding="utf-8") as f:
    csv.writer(f).writerows([["source", "target", "anchor", "score", "context"]] + rows)
Så gör du det redo för produktion
Respektera servern: lägg in en paus mellan anropen och en tydlig User-Agent, eller läs innehållet direkt från CMS:ets databas eller API i stället för att crawla.
Använd bättre text för embeddings: titel plus H1 plus de första 300 orden slår oftast hela sidan, som späder ut ämnet.
Skala matchningen: likhetsmatrisen växer med kvadraten på antalet sidor. Över 20000 sidor, använd ett index för ungefärliga närmaste grannar (till exempel FAISS) och jämför bara varje sida med sina 50 närmaste grannar.
Lägg till prioriteringar: multiplicera poängen med en förstärkning för prioriterade mål och med ett avdrag för mål som redan har många inkommande länkar.
Respektera din arkitektur: för en silo eller en kokong, släng par vars URL:er inte delar den tillåtna mappen eller det tillåtna ämnesträdet.
Infoga på serversidan: skriv in godkända länkar i det lagrade innehållet via CMS:ets API, aldrig via ett skript i frontend.
Hitta olänkade omnämnanden med en crawler
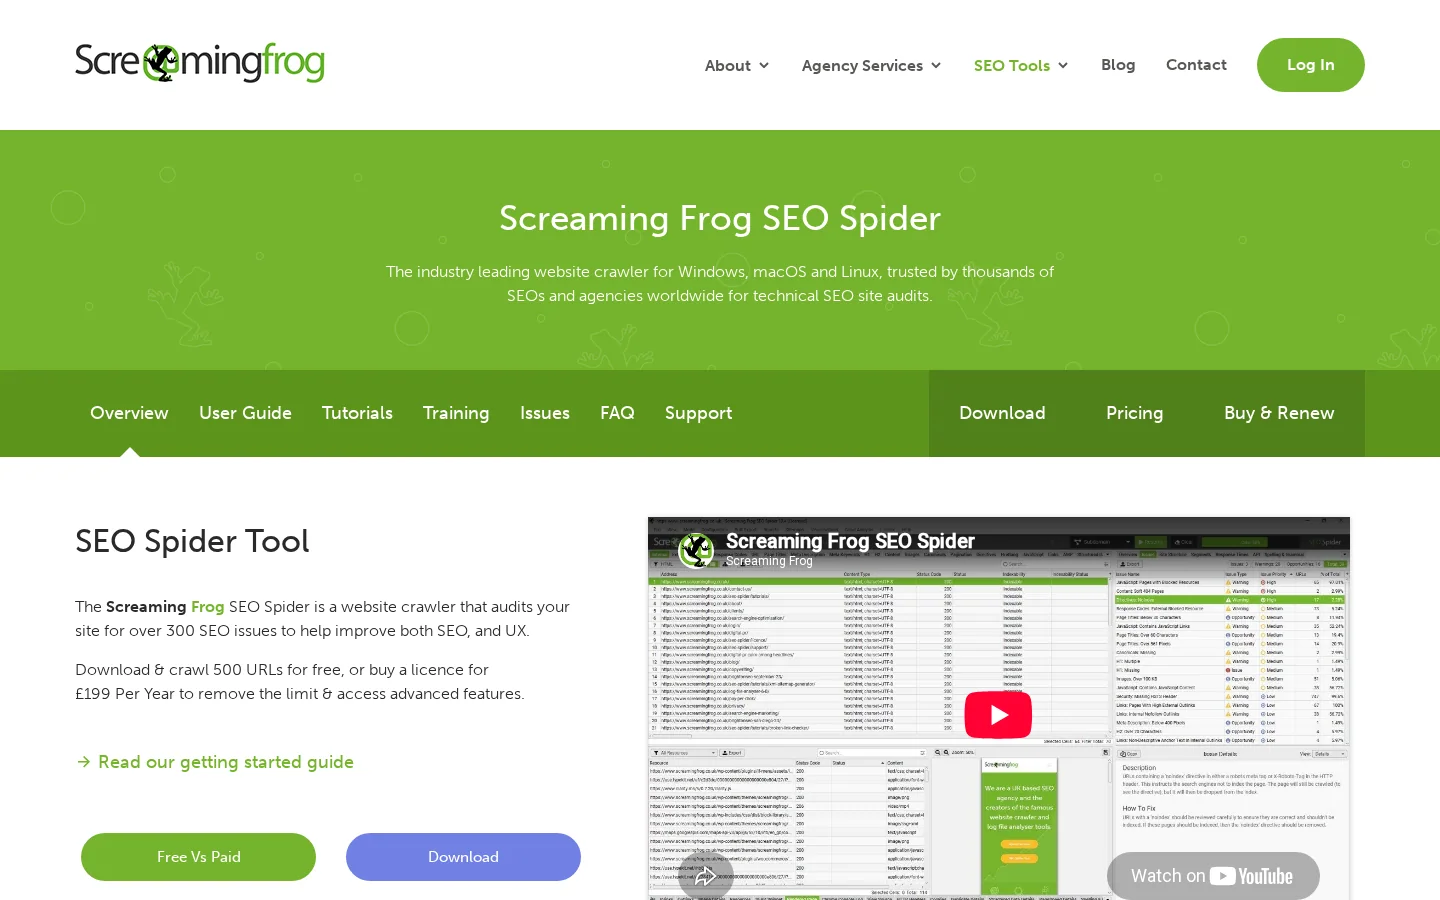
Utan att skriva kod kan en crawler göra en del av jobbet. I Screaming Frog hittar funktionen Custom Search varje sida som innehåller en fras, och Custom Extraction med XPath räknar länkarna till ett visst mål. Sidor som innehåller frasen men har noll länkar till målet är dina kandidater. Användarguiden för SEO Spider dokumenterar också dess Link Score, "ett mått mellan 0 och 100 som räknar ut en sidas relativa värde utifrån dess interna länkar", vilket kräver att du kör crawlanalysen efter crawlen.
Screaming Frog SEO Spider: crawla din webbplats, exportera interna länkar och ankartexter och hitta sidor som nämner ett ämne utan att länka till det.
Vanliga misstag med automatisk intern länkning (och hur du rättar dem)
De flesta problem med automatisk länkning är inga straff. Det är bortslösade länkar, förvirrande signaler och sidor som läses som om en maskin skrivit dem. Så här upptäcker och rättar du vart och ett.
1. Att länka varje förekomst av ett sökord
Vad det är: ett regelbaserat tillägg utan tak länkar "SEO-granskning" på 400 sidor med samma ankartext till samma sida. Hur du upptäcker det: i crawlerns export av ankartexter, sortera interna ankartexter efter frekvens; en fras med hundratals identiska användningar mot en URL är signalen. Hur du rättar det: sätt ett tak per regel över hela sajten, kräv minst två varianter per mål och ta bort länkarna från sidor där ämnet bara nämns i förbigående.
2. Att länka i fel betydelse
Vad det är: ordet matchar, betydelsen gör det inte ("Apple" frukten länkad till en artikel om iPhone, "Java" ön länkad till en programmeringsguide). Hur du upptäcker det: granska ett slumpmässigt urval på 30 automatiska länkar i månaden och läs hela meningen. Hur du rättar det: höj likhetströskeln, kräv både frasmatchning och ämnesmatchning, och lägg till negativa sökord för tvetydiga regler.
3. För många länkar per stycke
Vad det är: motorn staplar fyra länkar i ett stycke på 60 ord. Läsarna slutar klicka och texten blir svårläst. Hur du upptäcker det: räkna länkar per 100 ord huvudinnehåll; allt över 3 förtjänar en titt. Hur du rättar det: sätt ett minsta ordavstånd mellan automatiska länkar och ett tak per sida som räknar med de länkar skribenten redan placerat.
4. Länkar i rubriker, knappar eller inuti andra länkar
Vad det är: en träff inuti en H2, en innehållsförteckning eller en befintlig länk lindas in i en ny länk, vilket ger nästlade <a>-taggar eller blå rubriker. Hur du upptäcker det: kör en HTML-validator på några sidor, eller sök i crawlen efter rubriker som innehåller länkar. Hur du rättar det: deklarera förbjudna selektorer uttryckligen och testa dem på en testkopia före varje ny regel.
5. Länkar som bara finns i JavaScript
Vad det är: en widget i frontend lägger in länkar efter att sidan laddats, ibland utan href, ibland först efter en skrollning eller ett klick. Hur du upptäcker det: jämför den råa HTML-koden (visa källkod) med den renderade DOM:en, och kontrollera den renderade HTML-koden i URL-granskningen i Search Console. Hur du rättar det: flytta infogningen till servern eller in i det lagrade innehållet. Vår guide om JavaScript-SEO förklarar rendering i detalj.
Varning
Många AI-crawlers kör inte JavaScript alls. En länk som bara dyker upp efter att skripten körts kan vara synlig för Googlebot efter rendering men osynlig för de botar som matar ChatGPT, Claude eller Perplexity.
6. Länkar till omdirigeringar, noindex-sidor och 404:or
Vad det är: automatiska länkar som byggts från en gammal inventering pekar fortfarande på URL:er som flyttats eller tagits bort. Hur du upptäcker det: i en crawl, filtrera interna länkar efter statuskod (3xx, 4xx) och efter icke-indexerbart mål; vår kostnadsfria kontroll av trasiga länkar gör det för en enskild sida. Hur du rättar det: uppdatera inventeringen före varje körning, acceptera bara mål som svarar 200, är indexerbara och har en canonical till sig själva, och uppdatera länkarna på plats när en 301 skapas.
7. Att bara förlita sig på widgetar för "relaterade inlägg"
Vad det är: sajten tror att den är länkad eftersom varje artikel slutar med tre relaterade inlägg. De blocken väljer ofta efter tagg eller datum, roterar och hoppar helt över gammalt innehåll. Hur du upptäcker det: din rapport över föräldralösa sidor (URL:er i sajtkartan som crawlen inte når, eller bara når via paginering) förblir lång. Hur du rättar det: behåll widgeten, men lägg till kontextuella länkar i brödtexten och fasta länkar från navsidor.
8. En ankartext som pekar på två sidor
Vad det är: "verktyg för intern länkning" länkar till sida A i vissa artiklar och sida B i andra. Du splittrar relevanssignalerna och kan bidra till sökordskannibalisering. Hur du upptäcker det: bygg en karta från ankartext till mål utifrån crawlen och flagga varje ankartext med mer än ett mål. Hur du rättar det: en sökavsikt, en målsida; flytta över den svagare sidans ankartexter.
9. Ingen logg, ingen återställning
Vad det är: länkar infogades i innehållet av ett tillägg som senare avinstallerades, eller ingen vet vilka länkar som är automatiska. Hur du upptäcker det: du kan inte svara på "hur många länkar lade verktyget till förra månaden?". Hur du rättar det: spara varje automatisk länk i en tabell (källa, mål, ankartext, regel, datum, status), märk dem i HTML-koden med ett data-attribut om din plattform tillåter det, och kontrollera att du kan ta bort alla länkar från en regel i en enda åtgärd.
Misstag
Signal att leta efter
Åtgärd
Varje förekomst länkad
En ankartext använd hundratals gånger mot en URL
Tak över hela sajten, varianter av ankartext
Fel betydelse
Konstiga meningar i ett manuellt urval
Högre tröskel, negativa sökord
Länktäthet
Fler än 3 länkar per 100 ord
Ordavstånd, tak per sida
Förbjudna zoner
Länkar i rubriker, nästlade ankare
Uttryckliga undantagsselektorer
Länkar bara i JavaScript
Länkar saknas i källkoden
Infogning på serversidan
Döda mål
Interna 3xx- och 4xx-länkar i crawlen
Uppdatera inventeringen, bara mål som svarar 200
Bara widgetlänkning
Lång lista med föräldralösa sidor
Kontextuella länkar och navlänkar
En ankartext, två mål
Ankarkarta med dubbletter
En avsikt, en sida
Ingen logg
Kan inte räkna automatiska länkar
Länktabell, data-attribut, återställning
Så mäter du effekten av automatiska interna länkar
Interna länkar ger sällan ett lyft över en natt. Mät på sidorna som fått länkar, jämfört med kontrollgruppen, under 4 till 12 veckor.
Vad du ska följa efter varje våg av länkar
Antal föräldralösa sidor (sajtkarta jämfört med crawl)
Sidor djupare än 3 klick från startsidan
Unika inkommande interna länkar per prioriterad sida
Visningar och genomsnittlig position för målsidor i Search Console
Klick på målsidor jämfört med kontrollgruppen
Crawlfrekvens för målsidor i serverloggarna
Andel automatiska länkar som avvisas vid granskning (reglernas kvalitet)
Rapporten Länkar i Search Console
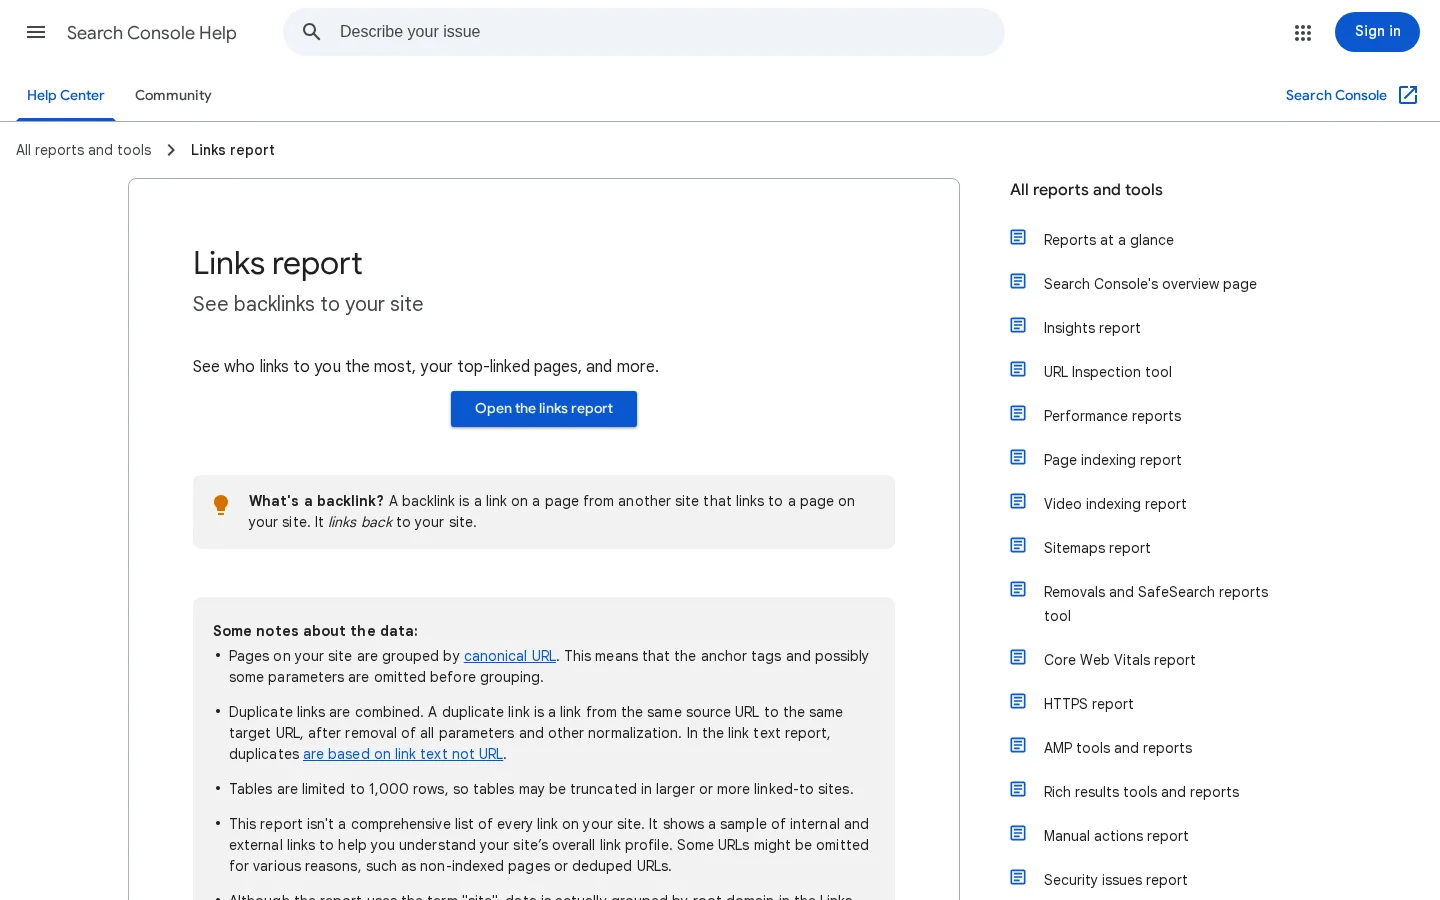
Rapporten Länkar i Search Console visar dina "mest internt länkade sidor" och, för var och en, sidorna som länkar dit. Den är användbar som rimlighetskontroll (ligger dina prioriterade sidor nära toppen?), men Googles hjälpsida varnar för att tabellerna är begränsade till 1000 rader och att rapporten "inte är en fullständig lista över alla länkar på din webbplats". Använd din egen crawl som sanningskälla och Search Console för att se vad Google faktiskt har plockat upp.
Rapporten Länkar i Search Console visar dina mest internt länkade sidor, med en gräns på 1000 rader: använd den som kontroll, inte som sanningskälla.
Serverloggar
Om du har tillgång till dem visar serverloggarna om Googlebot och AI-crawlers besöker de nyligen länkade sidorna oftare efter en våg. Det är den mest direkta signalen på att upptäckten förbättrats. Vår guide om loggfilsanalys för SEO förklarar hur du filtrerar botar och läser av crawlfrekvensen, och varför det spelar roll för crawlbudgeten på stora webbplatser.
Att läsa resultaten ärligt
Om visningarna ökar på målsidorna men inte i kontrollgruppen har länkarna troligen hjälpt. Om båda ökar är det sannolikt en säsongs- eller algoritmeffekt. Om målsidorna får fler visningar men inte fler klick är nästa hävstång titeln och innehållet, inte fler länkar. Och om inget rör sig efter 12 veckor, kontrollera grunderna: finns länkarna i den råa HTML-koden, och är målen faktiskt indexerade?
Var du börjar i dag
Du behöver inget stort verktyg för att komma igång. Välj ett kluster på 20 till 50 sidor, crawla det, lista dess föräldralösa och prioriterade sidor, bygg en ankarbank från Search Console och lägg till länkar i en granskad våg. Mät i sex veckor, skriv ner det du lärt dig som regler och utvidga sedan till nästa kluster.
Om du publicerar ofta är den billigaste vinsten att länka när texten skrivs: varje ny artikel ska lämna redigeraren med länkar till rätt sidor. Det är vad Sorank gör när det skriver och publicerar artiklar åt dig, och dess generator för ämneskluster planerar de kluster som länkarna följer, med inbyggt skydd mot kannibalisering. För de äldre sidorna, kombinera det med en granskad efterlänkning enligt metoden ovan.
Vanliga frågor
Är automatisk intern länkning säker för SEO?
Ja, så länge länkarna är relevanta, använder beskrivande ankartexter och håller sig inom rimliga tak. Googles dokumentation kräver crawlbara länkar med beskrivande ankartext och varnar för överdriven länkning, inte för automatisering i sig. Risken kommer från verktyg som länkar varje förekomst av ett sökord med samma ankartext, så behåll ett granskningssteg och logga varje automatisk länk.
Hur många interna länkar bör en artikel ha?
Google säger att det inte finns något idealantal. En praktisk utgångspunkt är 3 till 5 automatiska kontextuella länkar i en artikel på 1500 ord, utöver de länkar skribenten placerat, med en länk per mål och visst avstånd mellan länkarna. Mät på dina egna sidor och justera, eftersom en korrelationsstudie från Zyppy såg vinster upp till cirka 40 inkommande interna länkar per URL och en vändning efter ungefär 45 till 50.
Ersätter automatisk intern länkning en strategi för intern länkning?
Nej. Automatiseringen genomför en strategi: den hittar kandidater, infogar länkar och håller dem uppdaterade. Du måste fortfarande bestämma vilka sidor som ska prioriteras, vilken arkitektur länkarna ska följa (nät, semantisk kokong eller silo) och vilka ankartexter som hör till vilken sida.
y!
Få din innehållsplan för 30 dagar gratis
Vi analyserar dina konkurrenter, din webbplats och din synlighet i AI för att skapa en skräddarsydd innehållsplan, gratis.
“Jag testade Sorank på en riktig kundsajt och det är helt otroligt. Det gör allt som en byrå skulle ta 1500 dollar i månaden för. Den används nu i produktion för den kunden.”Guillaume Guersanguersanguillaume.com
“Vi är en annonsbyrå och ville få igång vår SEO på rätt spår en gång för alla. Sorank gav oss en tydlig bild av vår webbplats, hjälpte oss att prioritera optimeringarna och att strukturera vårt innehåll på rätt sätt. Verktyget är lätt att använda, väl genomtänkt för ett team och mycket praktiskt för att samla uppföljningen på ett ställe utan att jonglera med flera plattformar. En mycket stabil grund för att börja om från början med vår SEO.”Gaspard MadouiAnnonsbyrå
“Jag specialiserade mig på GEO tack vare Sorank. GEO-rankningen gör det möjligt för mig att visa mina kunder deras position jämfört med konkurrenterna i ChatGPT. Det är en verklig konkurrensfördel.”MélanieFrilans SEO-konsult
“Bra service, den fungerar bra för vår webbplats och hjälper oss att förstå hur vi kan förbättra den för att rankas bättre på Google och på andra ställen. Grattis, fortsätt så, jag rekommenderar det.”Hugo T.Handlare inom e-handel