Tùy chọn
Quyền riêng tư rất quan trọng với chúng tôi, vì vậy bạn có thể tắt một số loại lưu trữ không cần thiết cho hoạt động cơ bản của website. Việc chặn các nhóm này có thể ảnh hưởng đến trải nghiệm của bạn trên website. Thông tin thêm
Quyền riêng tư rất quan trọng với chúng tôi, vì vậy bạn có thể tắt một số loại lưu trữ không cần thiết cho hoạt động cơ bản của website. Việc chặn các nhóm này có thể ảnh hưởng đến trải nghiệm của bạn trên website. Thông tin thêm

Tìm hiểu cách liên kết nội bộ tự động hoạt động, so sánh 6 phương pháp, thiết lập từng bước và tránh những lỗi biến liên kết tự động thành spam.

Công cụ

Tóm tắt
liên kết nội bộ tự động là việc để phần mềm tìm, đề xuất hoặc chèn các liên kết giữa các trang trên website của bạn, thay vì đặt từng liên kết bằng tay. Cách này hiệu quả khi máy làm phần việc tẻ nhạt (crawl, ghép chủ đề, phát hiện trang mồ côi, ghi lại từng liên kết) còn bạn giữ quyền kiểm soát các quy tắc: trang nào cần đẩy, anchor text nào được phép, bao nhiêu liên kết mỗi trang. Hãy thiết lập nó theo quy trình "đề xuất, duyệt, xuất bản, đo lường", chứ không phải một plugin gắn liên kết vào mọi từ khóa nó gặp.
Muốn tìm hiểu sâu hơn? Hãy hỏi
Bài trắc nghiệm nhanh
Cách tìm khách hàng trực tuyến nào phù hợp với bạn nhất?
Sorank phù hợp với câu trả lời của bạn


Thử nghiệm trong 3 ngày trên chính website của bạn và xem vị trí của bạn trên Google, ChatGPT và các AI khác.
Bắt đầu dùng thử miễn phí 3 ngày3 ngày miễn phí, sau đó bạn có thể dừng bất cứ lúc nào. Cam kết kết quả trong 90 ngày, có điều kiện.
Liên kết nội bộ là liên kết từ một trang trên website của bạn sang một trang khác của cùng website. Nó làm ba việc: giúp trình thu thập dữ liệu khám phá trang, cho công cụ tìm kiếm và hệ thống AI biết trang đích nói về điều gì (qua anchor text và những từ xung quanh), và chuyển sức mạnh từ các trang mạnh sang các trang yếu hơn. Nếu bạn mới làm quen với kiến thức nền, hãy bắt đầu bằng định nghĩa liên kết nội bộ của chúng tôi.
Tự động hóa nghĩa là một chương trình đảm nhận một hoặc nhiều việc sau:
Nó không phải: cách nhồi cùng một liên kết từ khóa vào 500 trang, một thứ thay thế kiến trúc website, hay một widget "bài viết liên quan" ở cuối mỗi bài. Những thứ đó có thể là một phần của hệ thống tự động, nhưng nếu đứng riêng thì phần lớn chỉ tạo ra nhiễu.
Liên kết thủ công vẫn ổn với website 30 trang. Nó thất bại với website xuất bản mỗi tuần, vì một lý do đơn giản: mỗi bài mới tạo ra hai việc. Bài đó cần liên kết ra các trang hiện có, và các trang cũ cần liên kết ngược về nó. Việc thứ hai là việc ai cũng quên. Sau hai năm xuất bản, bạn có những bài mới không ai liên kết tới, và những bài cũ vẫn trỏ tới các trang đã bị thay thế từ lâu.
Liên kết nội bộ trước và sau khi tự động hóa
Bài viết này tập trung vào phần máy móc: phương pháp, thiết lập, một script chạy được và các kiểu lỗi. Về mặt chiến lược (ưu tiên trang nào, lên kế hoạch liên kết cho website đa ngôn ngữ ra sao), hãy đọc trước chiến lược liên kết nội bộ chuyên sâu của chúng tôi. Hai bài được thiết kế để dùng cùng nhau.
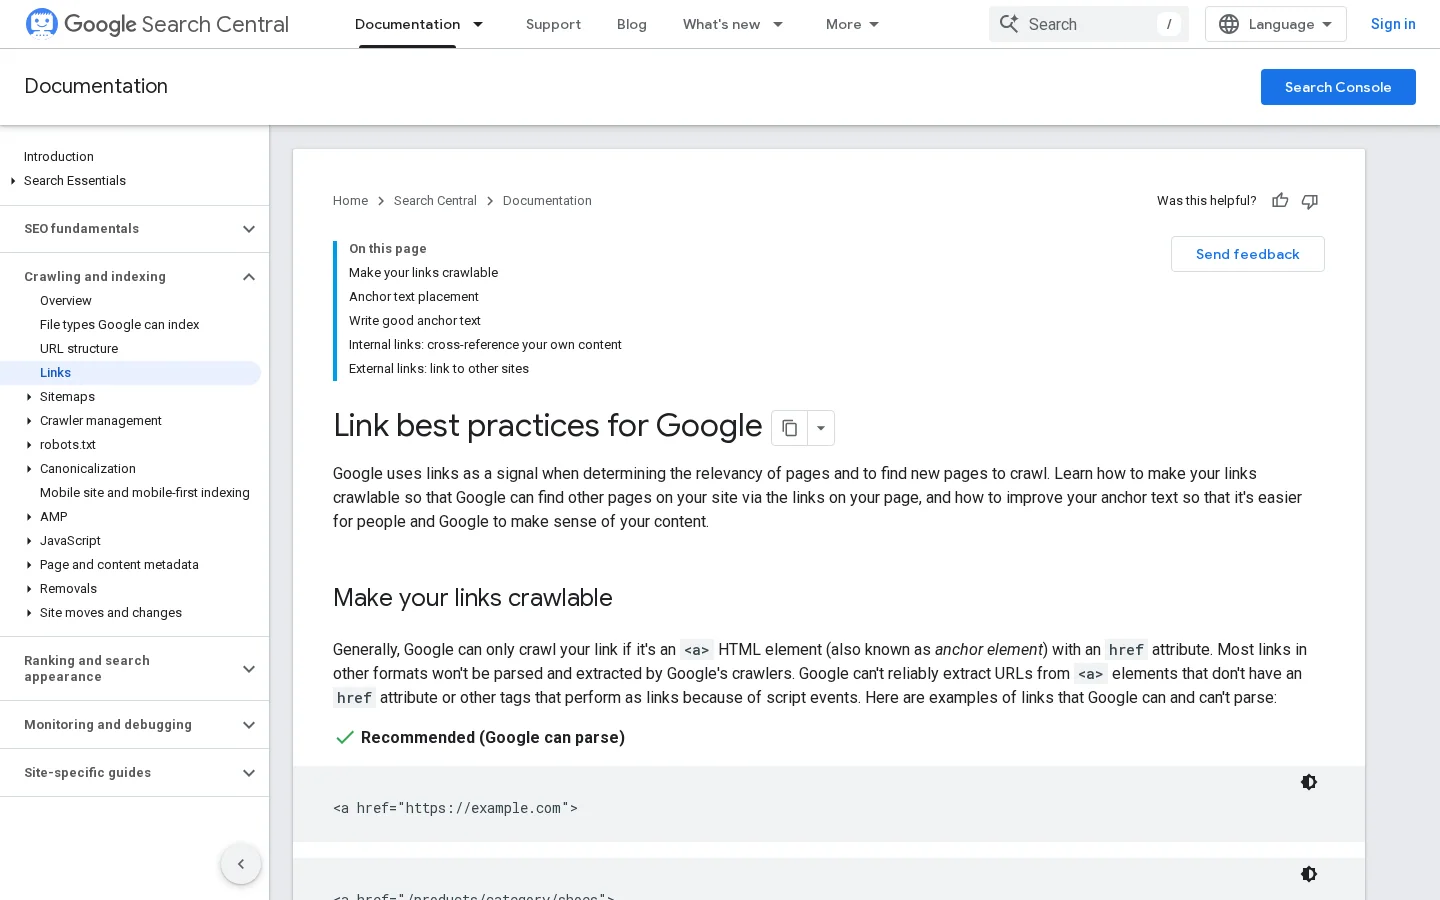
Google nói rõ mức tối thiểu. Tài liệu về các phương pháp hay nhất cho liên kết của Google nêu rằng "mọi trang bạn quan tâm đều nên có liên kết từ ít nhất một trang khác trên website của bạn", và Google nhìn chung chỉ có thể thu thập một liên kết nếu đó là phần tử <a> có thuộc tính href. Trang mồ côi không bị cấm, nhưng khi đó bạn đặt cược hoàn toàn vào sitemap để trang được tìm thấy và hiểu đúng.
Ngoài mức tối thiểu đó, bộ dữ liệu công khai tốt nhất về chủ đề này là nghiên cứu tương quan của Cyrus Shepard tại Zyppy, "23 Million Internal Links: SEO Case Study" (cập nhật tháng 2 năm 2026). Nghiên cứu đối chiếu dữ liệu liên kết nội bộ của khoảng 1800 website với số lượt nhấp từ Search Console.
23 triệu liên kết nội bộ cho thấy điều gì
Nguồn: Cyrus Shepard, Zyppy, 23 Million Internal Links SEO Case Study, cập nhật tháng 2 năm 2026
Phát hiện hữu ích nhất cho tự động hóa liên quan đến số lượng. URL có từ 0 đến 4 liên kết nội bộ nhận trung bình 2 lượt nhấp từ Google, trong khi URL có từ 40 đến 44 liên kết nội bộ nhận gấp bốn lần. Sau khoảng 45 đến 50 liên kết, hiệu ứng đảo chiều. Tác giả cho rằng phần lớn sự sụt giảm này đến từ các liên kết điều hướng xuất hiện trên toàn site, và ông thận trọng gọi đây là nghiên cứu tương quan: hữu ích về mặt định hướng, không phải bằng chứng.
Có hai bài học thực tế. Thứ nhất, những trang thiếu liên kết là những trang được lợi nhiều nhất, và đó chính là thứ tự động hóa tìm ra giỏi nhất. Thứ hai, nghiên cứu cho thấy sự đa dạng anchor có tương quan với lượt nhấp, và các trang có anchor dạng URL cùng anchor khớp chính xác hoạt động tốt hơn. Một hệ thống gắn liên kết cho mọi trang bằng đúng ba từ giống nhau sẽ vứt bỏ sự đa dạng đó.
Các trình thu thập AI như GPTBot, ClaudeBot và PerplexityBot khám phá trang giống như Googlebot: bằng cách đi theo các liên kết <a href>. Nhiều bot trong số đó không chạy JavaScript, nên một liên kết được chèn ở phía client có thể đơn giản là không tồn tại với chúng. Hướng dẫn của chúng tôi về trình thu thập AI giải thích mỗi bot lấy những gì. Liên kết nội bộ sạch, được render phía server giúp cả công cụ tìm kiếm lẫn các công cụ AI trích dẫn trang của bạn.
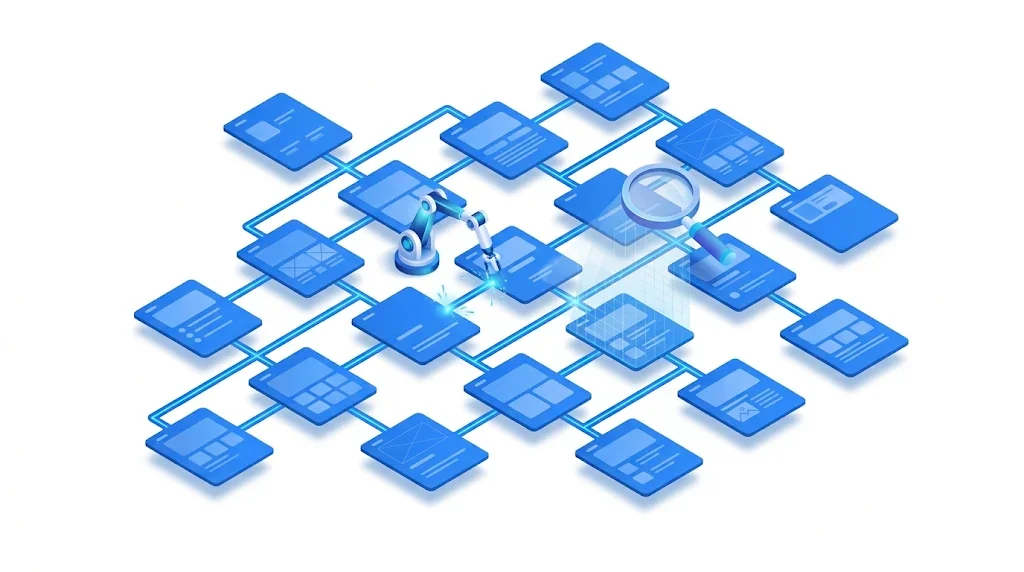
Mọi công cụ nghiêm túc, dù là plugin, SaaS hay script bạn tự viết, đều chạy cùng một quy trình. Nắm được nó, bạn có thể đánh giá một công cụ trong năm phút: hãy hỏi nó làm từng bước như thế nào.
Quy trình 6 bước của một công cụ liên kết nội bộ
Bước kiểm kê phải tách nội dung chính khỏi phần template. Một liên kết trong menu đầu trang xuất hiện trên mọi trang và cho Google biết rất ít về trang đích. Một liên kết trong đoạn thứ ba của một bài viết liên quan thì cho biết rất nhiều. Các công cụ tốt loại bỏ nav, header, footer và aside trước khi phân tích, và chỉ chèn liên kết vào thân bài. Chúng cũng loại các URL không thể lập chỉ mục: mọi URL trả về chuyển hướng, 404, noindex hoặc có canonical trỏ đi nơi khác.
Có ba cách biểu diễn phổ biến, từ thô đến tinh:
Với embedding, ghép cặp là độ tương đồng cosine giữa các vector, một điểm số từ -1 đến 1 (thực tế từ 0 đến 1 với văn bản). Bạn giữ các cặp vượt ngưỡng và N cặp tốt nhất cho mỗi trang. Ngưỡng là thiết lập quan trọng nhất: quá thấp, bạn sẽ nối trang về con trăn với trang về ngôn ngữ lập trình Python; quá cao, bạn chỉ tìm được các trang gần như trùng lặp. Hãy bắt đầu khoảng 0,5 đến 0,6 với một mô hình phổ thông, rồi điều chỉnh sau khi tự xem xét 50 đề xuất.
Anchor nên là một cụm từ đã có trong câu nguồn. Chèn thêm từ mới đồng nghĩa với viết lại nội dung, và đó là một việc khác. Công cụ tìm trong văn bản nguồn các cụm từ mô tả trang đích: từ khóa chính, H1, các biến thể gần, hoặc các truy vấn mà trang đích đã có thứ hạng trong Search Console. Nguồn cuối cùng là tốt nhất, vì nó phản ánh cách người thật mô tả trang đó.
Chất lượng được quyết định ở các quy tắc (xem phần riêng bên dưới). Việc chèn diễn ra ở một trong ba nơi: trong nội dung đã lưu (liên kết trở thành một phần của bài, cố định và hiển thị trong trình soạn thảo), tại thời điểm render trên server (một bộ lọc thêm liên kết khi trang được tạo, dễ hoàn tác), hoặc trong trình duyệt bằng JavaScript (lựa chọn yếu nhất cho SEO). Dù dùng cách nào, nhật ký cho mọi liên kết tự động là bắt buộc: không có nó, bạn không thể kiểm tra, đo lường hay hoàn tác.
"Liên kết nội bộ tự động" bao gồm những kỹ thuật rất khác nhau. Phần lớn website cuối cùng kết hợp hai hoặc ba phương pháp.
Nguyên lý: bạn duy trì một bảng "cụm từ dẫn tới URL", và hệ thống gắn liên kết cho cụm từ đó ở bất cứ đâu nó xuất hiện. Khi nào dùng: bảng thuật ngữ, tên sản phẩm, một nhóm nhỏ trang mang lại doanh thu. Ưu điểm: dễ đoán, minh bạch, rẻ. Hạn chế: không hiểu ngữ cảnh, anchor giống nhau ở mọi nơi, bảng nhanh lỗi thời. Ví dụ: mỗi lần đầu tiên nhắc tới "crawl budget" sẽ liên kết tới trang thuật ngữ crawl budget, giới hạn một liên kết mỗi bài.
Nguyên lý: CMS sinh liên kết từ cấu trúc website: breadcrumb, danh sách danh mục, "bài viết liên quan", bài trước và bài sau, các trang hub liệt kê trang con. Khi nào dùng: luôn luôn, đây là lớp nền. Ưu điểm: không cần bảo trì, đảm bảo không trang nào trong một danh mục bị mồ côi. Hạn chế: liên kết template mang ít ngữ cảnh, và các mô-đun "bài viết liên quan" thường chọn theo ngày hoặc thẻ thay vì theo nghĩa. Ví dụ: breadcrumb "Blog > SEO > Liên kết nội bộ" trên mọi bài viết.
Nguyên lý: embedding tìm các trang liên quan và anchor ứng viên; biên tập viên duyệt hoặc từ chối từng đề xuất. Khi nào dùng: website nội dung từ khoảng 50 đến vài nghìn bài. Ưu điểm: hiểu ngữ cảnh, con người vẫn tham gia quy trình, anchor đa dạng một cách tự nhiên. Hạn chế: tốn thời gian duyệt, và chất lượng phụ thuộc vào ngưỡng. Ví dụ: khi một bài về "ăn thịt từ khóa" (keyword cannibalization) được xuất bản, công cụ đề xuất năm bài cũ có một câu đã nhắc tới hiện tượng này.
Nguyên lý: thực thể được trích xuất từ mọi trang và liên kết tới trang đóng vai trò tham chiếu cho thực thể đó trên website của bạn. Khi nào dùng: website có nhiều thứ có tên: thương hiệu, địa điểm, con người, nguyên liệu, phần mềm. Ưu điểm: phân biệt nghĩa tốt, xây dựng được bản đồ "một thực thể, một trang" gọn gàng. Hạn chế: cần bản đồ từ thực thể tới trang, yếu hơn với chủ đề trừu tượng. Ví dụ: một website du lịch liên kết mọi lần nhắc tới "Kyoto" về trang cẩm nang Kyoto, không bao giờ về trang khách sạn ở Kyoto.
Nguyên lý: website được xem như một đồ thị. Công cụ tính điểm nội bộ cho mỗi trang (một chỉ số giống PageRank), độ sâu nhấp từ trang chủ và số liên kết vào, rồi đề xuất liên kết để dồn sức mạnh về các trang ưu tiên và kéo các trang nằm sâu lên gần bề mặt. Khi nào dùng: website lớn, thương mại điện tử, mọi website có trang kinh doanh bị chôn vùi. Ưu điểm: tối ưu theo một mục tiêu, không chỉ theo độ liên quan. Hạn chế: mô hình chỉ là ước lượng cách Google đánh trọng số liên kết, và logic đồ thị thuần túy có thể tạo liên kết không liên quan nếu không đi kèm bộ lọc độ liên quan. Ví dụ: một trang danh mục ở độ sâu 5 nhận liên kết từ ba bài hướng dẫn mạnh đang xếp hạng cho truy vấn liên quan, và lên độ sâu 2.
Nguyên lý: liên kết được đặt trong lúc soạn nội dung, bởi người viết hoặc công cụ viết bằng AI có sẵn danh mục trang của website. Khi nào dùng: mọi website xuất bản đều đặn. Ưu điểm: liên kết là một phần của câu được viết cho nó, nên anchor đọc tự nhiên. Hạn chế: nó xử lý liên kết ra từ trang mới, không xử lý liên kết vào từ các trang cũ, nên phải kết hợp với một phương pháp bổ sung ngược (backfill). Ví dụ: công cụ tạo bài blog bằng AI của Sorank viết mỗi bài với các liên kết nội bộ tới trang dịch vụ, sản phẩm hoặc danh mục của bạn đã được đặt sẵn.
| Phương pháp | Độ liên quan | Công sức vận hành | Chất lượng anchor | Rủi ro nếu cấu hình sai | Phù hợp nhất với |
|---|---|---|---|---|---|
| Tự động gắn liên kết từ khóa theo quy tắc | Thấp | Thấp | Lặp lại | Cao (nhồi từ khóa) | Bảng thuật ngữ, tên sản phẩm |
| Mô-đun cấu trúc và template | Trung bình | Rất thấp | Chung chung | Thấp | Mọi website, làm lớp nền |
| Đề xuất ngữ nghĩa có duyệt | Cao | Trung bình (duyệt) | Tự nhiên và đa dạng | Thấp | Blog và hub nội dung |
| Liên kết dựa trên thực thể | Cao với thứ có tên | Trung bình | Chính xác | Trung bình | Du lịch, thương mại điện tử, danh mục |
| Theo đồ thị (PageRank nội bộ) | Thay đổi | Cao (phân tích) | Tùy bộ lọc | Trung bình | Website lớn, trang doanh thu bị chôn vùi |
| Liên kết ngay khi viết | Cao | Thấp | Tự nhiên nhất | Thấp | Website xuất bản thường xuyên |
Trước khi cấu hình bất cứ thứ gì, hãy quyết định hình dạng mà các liên kết cần vẽ ra. Mạng lưới kiểu Wikipedia nối bất kỳ trang nào với bất kỳ trang liên quan nào; đây là đầu ra mặc định của công cụ ngữ nghĩa và phù hợp với nội dung kiểu bách khoa. Kén ngữ nghĩa giới hạn liên kết trong các trang cùng một cây chủ đề, với trang mẹ liên kết xuống và trang con liên kết lên và sang ngang; quy tắc của bạn phải cấm liên kết giữa các kén, trừ ở đỉnh. Silo theo URL đi theo cấu trúc thư mục (/guides/seo/...); một quy tắc đơn giản "chỉ liên kết trong cùng thư mục, cộng thêm trang hub" là đủ để thực thi. Topic cluster, được mô tả trong hướng dẫn của chúng tôi về topic cluster và pillar page, nằm giữa kén và mạng lưới. Bài viết của chúng tôi về kiến trúc website cho SEO giúp bạn lựa chọn.
Một công cụ liên kết không có quy tắc là một cỗ máy tạo spam. Đây là các thiết lập cần viết ra trước lần chạy đầu tiên, kèm giá trị phù hợp để bắt đầu.
Chèn hoàn toàn tự động so với đề xuất và duyệt
Không bao giờ chèn liên kết vào tiêu đề, mục lục, chú thích ảnh, trích dẫn, nút kêu gọi hành động, hộp thông tin tác giả, hay bên trong một thẻ <a> có sẵn (liên kết lồng nhau là HTML không hợp lệ). Không bao giờ liên kết một trang tới chính nó, tới một URL bị chuyển hướng, hay tới trang noindex hoặc có canonical trỏ sang URL khác.
Tài liệu của Google yêu cầu anchor text "mang tính mô tả, ngắn gọn hợp lý và liên quan đến trang chứa nó", đồng thời liệt kê "nhấp vào đây" và "đọc thêm" là quá chung chung. Hãy chuyển điều đó thành quy tắc: anchor từ 2 đến 6 từ, lấy từ câu có sẵn, ít nhất hai hoặc ba biến thể khác nhau cho mỗi đích trên toàn site, và một ý định cho mỗi anchor. Nếu "công cụ liên kết nội bộ" trỏ tới một công cụ phân tích miễn phí ở trang này và tới một tính năng trả phí ở trang khác, bạn đang kể cho công cụ tìm kiếm hai câu chuyện khác nhau. Hướng dẫn về anchor text của chúng tôi trình bày chi tiết các loại anchor.
Dù bạn dùng plugin có màn hình cài đặt hay một script, hãy viết các quy tắc thành một tệp. Tệp đó trở thành tài liệu và dấu vết kiểm tra của bạn.
{
  "global": {
    "max_auto_links_per_page": 5,
    "max_links_per_target_per_page": 1,
    "min_words_between_links": 60,
    "similarity_threshold": 0.55,
    "insert_only_in": ["article .content"],
    "skip_selectors": ["h1", "h2", "h3", "h4", "a", "figcaption", "blockquote", ".toc", ".cta", "nav", "footer"],
    "skip_targets_if": ["redirect", "noindex", "canonical_elsewhere", "status_not_200"],
    "mode": "suggest"
  },
  "priority_targets": [
    {"url": "/pricing", "boost": 1.5},
    {"url": "/guides/internal-linking-strategy", "boost": 1.3}
  ],
  "rules": [
    {"phrase": "crawl budget", "target": "/glossary/crawl-budget", "max_site_uses": 40, "mode": "auto"},
    {"phrase": "topic cluster", "target": "/glossary/topic-cluster", "max_site_uses": 40, "mode": "auto"}
  ],
  "never_link": ["/legal", "/login", "/cart"]
}
Mẹo
Bắt đầu mọi quy tắc mới ở chế độ "suggest". Chỉ chuyển sang "auto" sau khi bạn đã duyệt liên tiếp 20 đề xuất của quy tắc đó mà không phải sửa cái nào.
Phương pháp này áp dụng với mọi công cụ. Hãy dành một ngày để thiết lập với website vài trăm trang, sau đó khoảng một giờ mỗi tuần.
Crawl toàn bộ website bằng một trình crawl trên máy tính như Screaming Frog (hướng dẫn cài đặt Screaming Frog của chúng tôi đi qua từng bước cấu hình). Xuất ra, cho mỗi URL có thể lập chỉ mục: số liên kết nội bộ trỏ vào (không trùng lặp), độ sâu nhấp, liên kết ra, và điểm liên kết nội bộ do trình crawl tính. So sánh kết quả crawl với sitemap XML: các URL có trong sitemap nhưng không được crawl tìm thấy là trang mồ côi của bạn. Lưu bản xuất này kèm ngày. Đó là mốc "trước" của bạn.
Không phải trang nào cũng đáng có thêm liên kết. Lập một danh sách ngắn các đích ưu tiên: các trang mang lại doanh thu, các trang ở vị trí 5 đến 20 cho truy vấn có giá trị (Search Console, báo cáo Hiệu suất, lọc theo vị trí), và các bài nội dung nền tảng (cornerstone content) của bạn. Thêm mọi trang mồ côi và mọi trang sâu hơn 3 lần nhấp. Danh sách này cung cấp dữ liệu cho "priority_targets" trong quy tắc của bạn.
Với mỗi đích ưu tiên, thu thập 3 đến 10 cụm anchor. Nguồn tốt nhất là Search Console: mở trang trong báo cáo Hiệu suất, chuyển sang tab Truy vấn và xuất các truy vấn mà trang đã có lượt hiển thị. Thêm H1, từ khóa chính và các biến thể tự nhiên. Loại bỏ mọi cụm từ mơ hồ hoặc dùng chung với trang khác.
Chạy công cụ hoặc script của bạn. Với mỗi đích, nó sẽ trả về các trang nguồn có anchor xuất hiện trong thân bài và có chủ đề đủ gần. Hãy chờ đợi phễu thu hẹp mạnh: đó là dấu hiệu các bộ lọc đang hoạt động.
Các ứng viên liên kết được lọc như thế nào
Duyệt các đề xuất trong bảng tính với năm cột: nguồn, đích, anchor, câu, điểm số. Hãy đọc cả câu, không chỉ anchor. Từ chối mọi thứ bạn sẽ không tự viết. Ghi lại lý do từ chối (sai nghĩa, quá quảng cáo, đã có liên kết gần đó): những lý do này sẽ thành quy tắc mới.
Xuất bản 50 đến 200 liên kết mỗi đợt, trên một nhóm trang bạn có thể theo dõi. Giữ một nhóm đối chứng gồm các trang tương tự không có liên kết mới. Khi đó thay đổi về lượt nhấp có điểm so sánh, điều này quan trọng vì thứ hạng biến động vì nhiều lý do.
Crawl lại website. Kiểm tra rằng các liên kết mới xuất hiện dưới dạng <a href> trong HTML gốc, không chỉ sau khi JavaScript chạy. Với một vài URL, hãy dùng công cụ Kiểm tra URL trong Search Console và xem HTML đã render mà Google nhìn thấy.
Lợi ích thực sự đến từ tính liên tục. Mỗi khi một bài được xuất bản, hệ thống nên làm hai việc: liên kết ra từ bài mới (ngay khi viết) và đề xuất liên kết vào nó từ các trang cũ (backfill). Mỗi khi một URL thay đổi, hệ thống nên cập nhật hoặc gỡ các liên kết trỏ tới URL đó.
Mẹo
Để kiểm tra nhanh một trang, hãy dán URL vào công cụ phân tích liên kết nội bộ miễn phí của chúng tôi: nó liệt kê mọi liên kết nội bộ trên trang, anchor và thuộc tính của từng liên kết, để bạn xác nhận một đợt liên kết tự động đã được triển khai đúng kế hoạch.
Nếu CMS của bạn không có công cụ tốt, hoặc bạn muốn hiểu chính xác nhà cung cấp làm gì, một bản mẫu chạy được chỉ cần khoảng 60 dòng. Phiên bản này đọc sitemap, trích xuất nội dung chính, tính embedding bằng một mô hình mã nguồn mở và xuất ra tệp CSV chứa các đề xuất để con người duyệt. Nó không bao giờ động vào website của bạn.
pip install requests beautifulsoup4 sentence-transformersimport csv, re
from urllib.parse import urljoin
import requests
from bs4 import BeautifulSoup
from sentence_transformers import SentenceTransformer, util
SITEMAP = "https://example.com/sitemap.xml"
urls = re.findall(r"<loc>(.*?)</loc>", requests.get(SITEMAP, timeout=20).text)
pages = {}
for url in urls:
r = requests.get(url, timeout=20)
if r.status_code != 200 or r.url != url:
continue # skip errors and redirects
soup = BeautifulSoup(r.text, "html.parser")
robots = soup.find("meta", attrs={"name": "robots"})
if robots and "noindex" in robots.get("content", ""):
continue
main = soup.find("article") or soup.find("main") or soup.body
for tag in main.find_all(["nav", "header", "footer", "aside", "script", "style"]):
tag.decompose()
pages[url] = {
"h1": soup.h1.get_text(" ", strip=True) if soup.h1 else "",
"text": main.get_text(" ", strip=True),
"links": {urljoin(url, a["href"]).split("#")[0] for a in main.find_all("a", href=True)},
}model = SentenceTransformer("all-MiniLM-L6-v2")
keys = list(pages)
docs = [pages[u]["h1"] + ". " + pages[u]["text"][:2000] for u in keys]
emb = model.encode(docs, normalize_embeddings=True)
sim = util.cos_sim(emb, emb)
# Anchor bank: target URL -> phrases (H1 + queries exported from Search Console)
anchors = {u: [pages[u]["h1"].lower()] for u in keys}
# anchors["https://example.com/crawl-budget"] += ["crawl budget", "crawl budget optimization"]
THRESHOLD, MAX_PER_PAGE = 0.55, 5
def find_anchor(text, phrases):
for phrase in sorted(phrases, key=len, reverse=True):
if len(phrase.split()) < 2:
continue
m = re.search(r"\b" + re.escape(phrase) + r"\b", text, re.IGNORECASE)
if m:
start = max(0, m.start() - 120)
return m.group(0), text[start:m.end() + 120]
return None, None
rows = []
for i, src in enumerate(keys):
added = 0
for j in sorted(range(len(keys)), key=lambda k: -float(sim[i][k])):
score = float(sim[i][j])
if score < THRESHOLD or added == MAX_PER_PAGE:
break
tgt = keys[j]
if tgt == src or tgt in pages[src]["links"]:
continue
anchor, context = find_anchor(pages[src]["text"], anchors[tgt])
if anchor:
rows.append([src, tgt, anchor, round(score, 2), context])
added += 1
with open("link_suggestions.csv", "w", newline="", encoding="utf-8") as f:
csv.writer(f).writerows([["source", "target", "anchor", "score", "context"]] + rows)Không cần viết code, một trình crawl vẫn làm được một phần công việc. Trong Screaming Frog, tính năng Custom Search tìm mọi trang chứa một cụm từ, còn Custom Extraction với XPath đếm số liên kết tới một đích cụ thể. Các trang chứa cụm từ nhưng không có liên kết nào tới đích là ứng viên của bạn. Hướng dẫn sử dụng SEO Spider cũng mô tả Link Score, "một chỉ số từ 0 đến 100, tính giá trị tương đối của một trang dựa trên các liên kết nội bộ của nó", chỉ số này yêu cầu chạy crawl analysis sau khi crawl xong.
count(//article//a[contains(@href, "/guides/internal-linking-strategy")])
Phần lớn vấn đề với liên kết tự động không phải là án phạt. Đó là những liên kết lãng phí, tín hiệu gây nhiễu và những trang đọc lên như do máy viết. Dưới đây là cách phát hiện và sửa từng lỗi.
Lỗi là gì: một plugin dựa trên quy tắc được cài đặt không có giới hạn gắn liên kết "kiểm tra SEO" trên 400 trang với cùng một anchor tới cùng một trang. Cách phát hiện: trong bản xuất anchor text từ trình crawl, sắp xếp các anchor nội bộ theo tần suất; một cụm từ có hàng trăm lần dùng giống hệt nhau tới một URL là dấu hiệu. Cách sửa: giới hạn số lần dùng mỗi quy tắc trên toàn site, yêu cầu ít nhất hai biến thể cho mỗi đích, và gỡ liên kết khỏi những trang chỉ nhắc chủ đề một cách thoáng qua.
Lỗi là gì: từ khớp, nghĩa không khớp ("Apple" là quả táo lại liên kết tới bài về iPhone, "Java" là hòn đảo lại liên kết tới bài hướng dẫn lập trình). Cách phát hiện: mỗi tháng xem xét một mẫu ngẫu nhiên gồm 30 liên kết tự động và đọc trọn câu. Cách sửa: nâng ngưỡng tương đồng, yêu cầu khớp cả cụm từ lẫn chủ đề, và thêm từ khóa phủ định cho các quy tắc mơ hồ.
Lỗi là gì: công cụ chất bốn liên kết vào một đoạn 60 từ. Người đọc ngừng nhấp và văn bản trở nên khó đọc. Cách phát hiện: tính số liên kết trên mỗi 100 từ nội dung chính; mọi giá trị trên 3 đều đáng xem lại. Cách sửa: đặt khoảng cách tối thiểu tính bằng từ giữa các liên kết tự động và một giới hạn mỗi trang có tính cả những liên kết người viết đã đặt.
Lỗi là gì: một kết quả khớp bên trong H2, mục lục hoặc một anchor có sẵn bị bọc bởi liên kết mới, tạo ra thẻ <a> lồng nhau hoặc tiêu đề màu xanh. Cách phát hiện: chạy trình kiểm tra HTML trên vài trang, hoặc tìm trong kết quả crawl các tiêu đề có chứa liên kết. Cách sửa: khai báo rõ ràng các selector bị cấm và thử chúng trên bản staging trước mỗi quy tắc mới.
Lỗi là gì: một widget phía front-end chèn liên kết sau khi trang tải, đôi khi không có href, đôi khi chỉ sau khi cuộn hoặc nhấp. Cách phát hiện: so sánh HTML gốc (xem nguồn trang) với DOM đã render, và kiểm tra HTML đã render trong công cụ Kiểm tra URL của Search Console. Cách sửa: chuyển việc chèn liên kết sang server hoặc vào nội dung đã lưu. Hướng dẫn JavaScript SEO của chúng tôi giải thích chi tiết quá trình render.
Cảnh báo
Nhiều trình thu thập AI hoàn toàn không chạy JavaScript. Một liên kết chỉ xuất hiện sau khi script chạy có thể hiển thị với Googlebot sau khi render, nhưng lại vô hình với các bot cung cấp dữ liệu cho ChatGPT, Claude hay Perplexity.
Lỗi là gì: các liên kết tự động được xây từ một bản kiểm kê cũ vẫn trỏ tới URL đã bị di chuyển hoặc xóa. Cách phát hiện: trong kết quả crawl, lọc liên kết nội bộ theo mã trạng thái (3xx, 4xx) và theo đích không thể lập chỉ mục; công cụ kiểm tra liên kết hỏng miễn phí của chúng tôi làm việc này cho từng trang. Cách sửa: làm mới bản kiểm kê trước mỗi lần chạy, chỉ chấp nhận đích trả về 200, có thể lập chỉ mục và canonical về chính nó, và cập nhật liên kết tại chỗ khi tạo chuyển hướng 301.
Lỗi là gì: website tin rằng mình đã được liên kết đầy đủ vì mỗi bài đều kết thúc bằng ba bài liên quan. Những khối này thường chọn theo thẻ hoặc ngày, thay đổi luân phiên và bỏ qua hoàn toàn nội dung cũ. Cách phát hiện: báo cáo trang mồ côi của bạn (URL trong sitemap không được crawl chạm tới, hoặc chỉ chạm tới qua phân trang) vẫn dài. Cách sửa: giữ widget, nhưng thêm liên kết theo ngữ cảnh trong thân bài và liên kết cố định từ các trang hub.
Lỗi là gì: "công cụ liên kết nội bộ" trỏ tới trang A ở một số bài và trang B ở các bài khác. Bạn chia nhỏ tín hiệu liên quan và có thể làm trầm trọng thêm hiện tượng ăn thịt từ khóa. Cách phát hiện: xây dựng bản đồ anchor tới đích từ kết quả crawl và đánh dấu mọi anchor có nhiều hơn một đích. Cách sửa: một ý định tìm kiếm, một trang đích; gán lại các anchor của trang yếu hơn.
Lỗi là gì: liên kết được chèn vào nội dung bởi một plugin mà sau đó bị gỡ cài đặt, hoặc không ai biết liên kết nào là tự động. Cách phát hiện: bạn không trả lời được câu hỏi "tháng trước công cụ đã thêm bao nhiêu liên kết?". Cách sửa: lưu mọi liên kết tự động vào một bảng (nguồn, đích, anchor, quy tắc, ngày, trạng thái), đánh dấu chúng trong HTML bằng một thuộc tính data nếu hệ thống của bạn cho phép, và kiểm tra rằng bạn có thể gỡ toàn bộ liên kết của một quy tắc trong một thao tác.
| Lỗi | Dấu hiệu cần tìm | Cách sửa |
|---|---|---|
| Gắn liên kết mọi lần xuất hiện | Một anchor dùng hàng trăm lần tới một URL | Giới hạn toàn site, biến thể anchor |
| Sai nghĩa | Câu văn kỳ quặc trong mẫu kiểm tra thủ công | Ngưỡng cao hơn, từ khóa phủ định |
| Mật độ liên kết | Hơn 3 liên kết trên 100 từ | Khoảng cách từ, giới hạn mỗi trang |
| Vùng cấm | Liên kết trong tiêu đề, anchor lồng nhau | Selector loại trừ rõ ràng |
| Liên kết chỉ có trong JavaScript | Liên kết không có trong mã nguồn trang | Chèn phía server |
| Đích chết | Liên kết nội bộ 3xx và 4xx trong kết quả crawl | Làm mới kiểm kê, chỉ đích 200 |
| Chỉ liên kết bằng widget | Danh sách trang mồ côi dài | Liên kết theo ngữ cảnh và từ hub |
| Một anchor, hai đích | Bản đồ anchor có trùng lặp | Một ý định, một trang |
| Không có nhật ký | Không đếm được liên kết tự động | Bảng liên kết, thuộc tính data, hoàn tác |
Liên kết nội bộ hiếm khi tạo ra bước nhảy chỉ sau một đêm. Hãy đo trên các trang đã nhận liên kết, so với nhóm đối chứng, trong khoảng 4 đến 12 tuần.
Cần theo dõi gì sau mỗi đợt liên kết
Báo cáo Liên kết trong Search Console hiển thị "các trang được liên kết nội bộ nhiều nhất" và, với mỗi trang, các trang liên kết tới nó. Báo cáo này hữu ích để kiểm tra nhanh (các trang ưu tiên của bạn có nằm gần đầu danh sách không?), nhưng trang trợ giúp của Google lưu ý rằng các bảng bị giới hạn ở 1000 dòng và báo cáo "không phải là danh sách đầy đủ mọi liên kết trên website của bạn". Hãy coi dữ liệu crawl của chính bạn là nguồn chuẩn, và dùng Search Console để xem Google thực sự đã ghi nhận những gì.
Nếu bạn có quyền truy cập, nhật ký máy chủ cho biết Googlebot và các trình thu thập AI có ghé thăm các trang vừa được liên kết thường xuyên hơn sau một đợt hay không. Đó là tín hiệu trực tiếp nhất cho thấy khả năng khám phá đã được cải thiện. Hướng dẫn của chúng tôi về phân tích file log cho SEO giải thích cách lọc bot và đọc tần suất crawl, cũng như vì sao điều đó quan trọng với crawl budget trên các website lớn.
Nếu lượt hiển thị tăng ở trang đích nhưng không tăng ở nhóm đối chứng, nhiều khả năng các liên kết đã có tác dụng. Nếu cả hai đều tăng, đó có lẽ là hiệu ứng mùa vụ hoặc thuật toán. Nếu trang đích có thêm lượt hiển thị nhưng không có thêm lượt nhấp, đòn bẩy tiếp theo là tiêu đề và nội dung, không phải thêm liên kết. Và nếu sau 12 tuần không có gì thay đổi, hãy kiểm tra những điều cơ bản: liên kết có nằm trong HTML gốc không, và các trang đích có thực sự được lập chỉ mục không?
Bạn không cần một công cụ lớn để bắt đầu. Hãy chọn một cụm gồm 20 đến 50 trang, crawl nó, liệt kê các trang mồ côi và trang ưu tiên, xây dựng kho anchor từ Search Console, rồi thêm liên kết trong một đợt đã được duyệt. Đo lường trong sáu tuần, ghi lại những gì bạn học được thành quy tắc, rồi mở rộng sang cụm tiếp theo.
Nếu bạn xuất bản thường xuyên, lợi ích rẻ nhất là liên kết ngay khi viết: mỗi bài mới nên rời trình soạn thảo với các liên kết tới đúng trang. Đó chính là điều Sorank làm khi viết và xuất bản bài cho bạn, và công cụ tạo topic cluster của nó lên kế hoạch các cụm mà những liên kết này đi theo, có sẵn cơ chế chống ăn thịt từ khóa. Với các trang cũ, hãy kết hợp với một đợt backfill có duyệt theo phương pháp ở trên.
Có, miễn là liên kết phù hợp, dùng anchor text mang tính mô tả và nằm trong giới hạn hợp lý. Tài liệu của Google yêu cầu liên kết có thể thu thập được với anchor text mô tả và cảnh báo việc liên kết quá mức, chứ không cảnh báo bản thân việc tự động hóa. Rủi ro đến từ những công cụ gắn liên kết cho mọi lần xuất hiện của từ khóa bằng cùng một anchor, vì vậy hãy giữ bước duyệt và ghi nhật ký mọi liên kết tự động.
Google nói không có con số lý tưởng. Điểm khởi đầu thực tế là 3 đến 5 liên kết ngữ cảnh tự động trong một bài 1500 từ, ngoài các liên kết người viết đã đặt, với một liên kết cho mỗi đích và có khoảng cách giữa các liên kết. Hãy đo trên chính các trang của bạn và điều chỉnh, vì một nghiên cứu tương quan của Zyppy ghi nhận mức tăng tới khoảng 40 liên kết nội bộ trỏ vào mỗi URL và đảo chiều sau khoảng 45 đến 50.
Không. Tự động hóa thực thi một chiến lược: tìm ứng viên, chèn liên kết và giữ chúng luôn cập nhật. Bạn vẫn phải quyết định trang nào được ưu tiên, liên kết đi theo kiến trúc nào (mạng lưới, kén ngữ nghĩa hay silo) và anchor nào thuộc về trang nào.
Chúng tôi phân tích đối thủ, website và mức độ hiển thị trên AI của bạn để lập kế hoạch nội dung phù hợp, hoàn toàn miễn phí.
 Trình tạo brief nội dung AI
 Công cụ tạo schema FAQ
 Công cụ tạo ý tưởng bài blog bằng AI
 Công cụ kiểm tra dữ liệu có cấu trúc
 Công cụ kiểm tra văn bản thay thế
 Công cụ phân tích liên kết nội bộ
 Thử thách backlink
 Trình tạo mô tả meta
 Trình tạo tiêu đề blog AI
 Công cụ kiểm tra khả năng lập chỉ mục Google
 Trình tạo dàn ý blog AI
 Công cụ tạo liên kết UTM
 Công cụ phân cụm từ khóa
 Công cụ kiểm tra thẻ canonical
 Công cụ tạo sitemap XML
 Công cụ kiểm tra liên kết hỏng
 Công cụ tạo tiêu đề SEO bằng AI
 Công cụ phân tích tiêu đề
 Công cụ xem trước kết quả tìm kiếm
 Công cụ kiểm tra chuyển hướng
 Công cụ tạo thẻ hreflang
 Công cụ phân tích cấu trúc tiêu đề
 Công cụ kiểm tra HTTP header
 Công cụ trích xuất favicon
 Công cụ tính CTR SERP
 Công cụ tính tiết kiệm SEO so với quảng cáo tìm kiếm
 Máy tính tỷ lệ hiển thị SEO
 Máy tính ROI SEO
 Máy tính dự báo lưu lượng và doanh thu SEO
 Máy tính ngân sách SEO
 Máy tính điểm hòa vốn SEO
 Máy tính ROI SEO cho SaaS
 Máy tính ROAS
 Máy tính thời gian đọc
 Mô phỏng mức tăng thứ hạng
 Máy tính giá trị lưu lượng truy cập tự nhiên
 Máy ước tính lưu lượng tự nhiên và công cụ kiểm tra lưu lượng website
 Máy tính tỷ lệ LTV trên CAC
 Máy tính ROI SEO địa phương
 Máy tính chi phí xây dựng liên kết
 Máy tính giá trị từ khóa
 Máy tính điểm cơ hội từ khóa
 Máy tính mật độ từ khóa
 Máy tính ROI GEO
 Máy tính đầu tư nội dung GEO
 Máy tính ROI SEO thương mại điện tử
 Máy tính giá trị trọn đời của khách hàng
 Máy tính chi phí thu hút khách hàng
 Công cụ tính CTR
 Công cụ tính chi phí mỗi bài viết
 Công cụ tính tỷ lệ chuyển đổi
 Công cụ tính ROI marketing nội dung
 Công cụ ước tính lưu lượng giới thiệu từ ChatGPT
 Công cụ tính tỷ lệ thoát
 Công cụ tính ROI backlink
 Công cụ tính điểm hiển thị AI
 Công cụ tính giá trị lưu lượng AI
 Công cụ tính share of voice AI
 Công cụ tính chi phí vắng mặt trên AI
 Công cụ tính tỷ lệ trích dẫn AI
 Trình kiểm tra llms.txt
 Trình kiểm tra AI Overview và trình kiểm tra thứ hạng AI Overviews
 Trình kiểm tra robots.txt
 Kiểm tra SEO AI
 Công cụ kiểm tra độ dễ đọc cho LLM
 Công cụ kiểm tra mức sẵn sàng SearchGPT
 Kiểm tra LLM cho dữ liệu có cấu trúc
 Kiểm tra khả năng thu thập dữ liệu của website cho AI
 Vì sao ChatGPT không giới thiệu website của tôi
 Công cụ đo thứ hạng Gemini
 Kiểm tra thứ hạng Perplexity
 Kiểm tra trích dẫn LLM
 Kiểm tra tối ưu hóa công cụ trả lời
 Kiểm tra GEO
 Bài kiểm tra độ hiển thị trên tìm kiếm AI
 Công cụ kiểm tra độ hiển thị trên ChatGPT
 Trình tạo llms.txt
 Trích xuất URL
 Chuyển trang web sang Markdown
 Công cụ kiểm tra sitemap
 Cảm biến biến động SERP
 Công cụ kiểm tra kích thước trang
 Bộ đếm từ
 Trình tạo slug
 Trình tạo schema
 Trình tạo robots.txt
 Xem trước OG
 Trình tạo thẻ meta
 Trình nén ảnh
 Trình tạo favicon
 Kiểm tra OnPage: công cụ kiểm tra và phân tích SEO
 Công cụ phân tích backlink
 Công cụ nghiên cứu từ khóa
 Công cụ kiểm tra Domain Authority
5/5 từ 5 đánh giá
 “Tôi đã thử Sorank trên website thật của một khách hàng và nó quá tuyệt. Nó làm được mọi thứ mà một agency sẽ tính bạn $1500 mỗi tháng để làm. Giờ nó đang được đưa vào vận hành cho khách hàng đó.”

 Guillaume Guersanguersanguillaume.com“Chúng tôi là một agency quảng cáo và muốn đưa SEO của mình đi đúng hướng một lần cho xong. Sorank cho chúng tôi cái nhìn rõ ràng về website, giúp sắp xếp thứ tự ưu tiên các tối ưu, và cấu trúc nội dung một cách đúng đắn. Công cụ dễ dùng, được thiết kế tốt cho cả nhóm, và rất thiết thực để tập trung theo dõi mà không phải xoay xở qua nhiều nền tảng. Một nền tảng rất vững chắc để bắt đầu lại từ đầu với SEO của chúng tôi.”
 Gaspard MadouiAgency quảng cáo
 “Tôi chỉ để phần mềm Sorank làm việc của nó, và giờ DR của tôi là 25 và trang của tôi đang lên hạng cao hơn.”
 Lucas Flandrefoundertrace.fr“Tôi đã chuyên sâu về GEO nhờ Sorank. Bảng xếp hạng GEO giúp tôi cho khách hàng thấy vị trí của họ so với đối thủ trên ChatGPT. Đây là một điểm khác biệt thực sự về mặt thương mại.”
 MélanieSEO freelance“Dịch vụ rất tốt, hoạt động hiệu quả với website của chúng tôi và giúp hiểu cách cải thiện để xếp hạng cao hơn trên Google và các nơi khác. Chúc mừng, cứ tiếp tục nhé, tôi giới thiệu.”
 Hugo T.Chủ cửa hàng thương mại điện tử