Prywatność jest dla nas ważna, dlatego możesz wyłączyć niektóre rodzaje przechowywania danych, które nie są niezbędne do podstawowego działania strony. Zablokowanie kategorii może wpłynąć na Twoje doświadczenie podczas korzystania z witryny. Więcej informacji (Polityka cookies)
Dziękujemy! Twoje zgłoszenie zostało odebrane!
Ups! Podczas wysyłania formularza coś poszło nie tak.
Automatyczne linkowanie wewnętrzne: metody, wdrożenie i zasady bezpieczeństwa
Dowiedz się, jak działa automatyczne linkowanie wewnętrzne, porównaj 6 metod, wdroż je krok po kroku i unikaj błędów, które zamieniają autolinki w spam.
Sieć stron połączonych linkami wewnętrznymi, z których część umieszczono automatycznie i sprawdzono przez redaktora przed publikacją.
Narzędzia
Na tej stronie
W skrócie
automatyczne linkowanie wewnętrzne polega na tym, że oprogramowanie znajduje, proponuje lub wstawia linki między stronami Twojej witryny, zamiast umieszczać każdy z nich ręcznie. Działa dobrze, gdy maszyna wykonuje żmudną część pracy (crawlowanie, dopasowywanie tematów, wykrywanie stron osieroconych, rejestrowanie każdego linku), a Ty zachowujesz kontrolę nad zasadami: które strony wzmacniać, jakie anchory dopuszczać, ile linków na stronę. Ustaw to jako proces „proponuj, zatwierdzaj, publikuj, mierz”, a nie jako wtyczkę, która linkuje każde napotkane słowo kluczowe.
3 dni za darmo, potem rezygnujesz, kiedy chcesz. 90-dniowa gwarancja wyników, obowiązują warunki.
Czym jest automatyczne linkowanie wewnętrzne (a czym nie jest)
Link wewnętrzny to link z jednej strony Twojej witryny do innej strony tej samej witryny. Ma trzy zadania: pozwala robotom odkrywać strony, mówi wyszukiwarkom i systemom AI, o czym jest strona docelowa (poprzez tekst anchora i otaczające go słowa), oraz przekazuje autorytet z mocnych stron do słabszych. Jeśli podstawy są dla Ciebie nowe, zacznij od naszej definicji linkowania wewnętrznego.
Automatyzacja oznacza, że program wykonuje jedno lub kilka z tych zadań:
Odkrywanie: crawlowanie witryny, wypisanie każdej strony, każdego istniejącego linku i każdego anchora.
Dopasowanie: decyzja, która strona ma linkować do której, na podstawie słów kluczowych, znaczenia lub encji.
Wybór anchora: znalezienie frazy, która już występuje w tekście źródłowym i opisuje stronę docelową.
Wstawienie: zapisanie linku w HTML, w bazie danych CMS lub w momencie renderowania.
Utrzymanie: poprawianie linków, gdy zmienia się URL, strona zostaje usunięta lub publikujesz nowy artykuł.
Czym nie jest: sposobem na wciśnięcie tego samego linku na słowo kluczowe w 500 stron, zamiennikiem architektury witryny ani widżetem „powiązane wpisy” na dole każdego artykułu. Te elementy mogą być częścią zautomatyzowanego systemu, ale same w sobie generują głównie szum.
Dlaczego ręczne linkowanie przestaje działać
Ręczne linkowanie sprawdza się na witrynie z 30 stronami. Zawodzi na witrynie, która publikuje co tydzień, z prostego powodu: każdy nowy artykuł tworzy dwa zadania. Potrzebuje linków wychodzących do istniejących stron, a starsze strony potrzebują linków prowadzących do niego. O drugim zadaniu wszyscy zapominają. Po dwóch latach publikowania masz świeże artykuły, do których nikt nie linkuje, i stare artykuły, które wciąż wskazują strony już dawno zastąpione.
Linkowanie wewnętrzne przed automatyzacją i po niej
Przed (ręcznie)
Nowe artykuły dostają linki wychodzące, rzadko przychodzące
Strony osierocone gromadzą się niezauważone
Linki prowadzą do przekierowań i usuniętych URL-i
Anchory zależą od tego, kto pisał artykuł
Po (automatycznie, z weryfikacją)
Każda nowa strona dostaje linki z powiązanych stron
Strony osierocone są wykrywane przy każdym crawlu
Zepsute i przekierowane cele są aktualizowane
Anchory trzymają się spisanych zasad i są rejestrowane
Ten artykuł skupia się na mechanice: metodach, ustawieniach, działającym skrypcie i typowych awariach. Strategiczną stronę (które strony traktować priorytetowo, jak planować linki w witrynie wielojęzycznej) znajdziesz najpierw w naszej eksperckiej strategii linkowania wewnętrznego. Oba teksty są pomyślane do używania razem.
Dlaczego to ważne: co mówią dane o linkach wewnętrznych
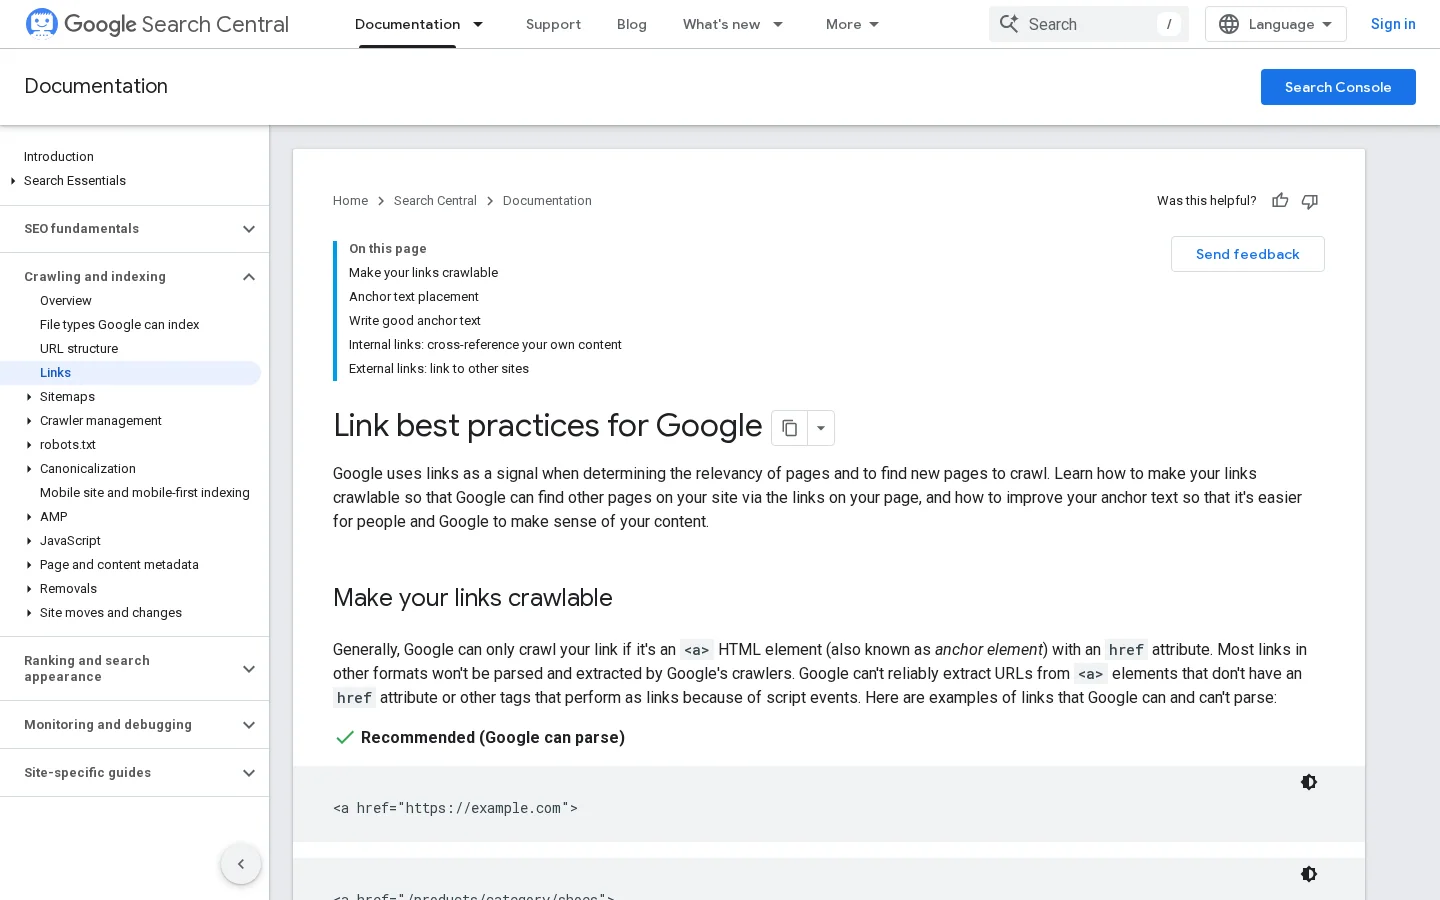
Google jasno określa minimum. Jego dokumentacja dobrych praktyk dotyczących linków mówi, że „każda strona, na której Ci zależy, powinna mieć link z co najmniej jednej innej strony Twojej witryny” i że Google co do zasady może przeskanować link tylko wtedy, gdy jest to element <a> z atrybutem href. Strona osierocona nie jest zakazana, ale wtedy stawiasz wyłącznie na mapę witryny, by została znaleziona i zrozumiana.
Poza minimum najlepszym publicznym zbiorem danych na ten temat jest badanie korelacyjne Cyrusa Sheparda z Zyppy, „23 Million Internal Links: SEO Case Study” (zaktualizowane w lutym 2026). Zestawiono w nim dane o linkach wewnętrznych z około 1800 witryn z kliknięciami z Search Console.
Co pokazuje 23 mln linków wewnętrznych
23 mlnprzeanalizowanych linków wewnętrznych w około 520000 URL-ach
1800witryn w zbiorze danych, zestawionych z kliknięciami z Google Search Console
5xco najmniej pięć razy więcej ruchu dla stron z co najmniej jednym wewnętrznym anchorem z dokładnym dopasowaniem
6%ponad 6% wszystkich linków wewnętrznych w ogóle nie miało tekstu anchora
Źródło: Cyrus Shepard, Zyppy, 23 Million Internal Links SEO Case Study, aktualizacja z lutego 2026
Najbardziej przydatny dla automatyzacji wniosek dotyczy liczby linków. URL-e z 0 do 4 linkami wewnętrznymi dostawały średnio 2 kliknięcia z Google, a URL-e z 40 do 44 linkami wewnętrznymi cztery razy więcej. Powyżej około 45 do 50 linków efekt się odwraca. Autor przypisuje dużą część tego spadku linkom nawigacyjnym obecnym w całej witrynie i ostrożnie nazywa badanie korelacyjnym: wskazuje kierunek, ale niczego nie dowodzi.
Średnia liczba kliknięć z Google na URL według liczby prowadzących do niego linków wewnętrznych
0 do 4 linków wewnętrznych2 kliknięcia
40 do 44 linków wewnętrznych8 kliknięć (4x)
Źródło: Cyrus Shepard, Zyppy, 23 Million Internal Links SEO Case Study, aktualizacja z lutego 2026
Wynikają z tego dwie praktyczne lekcje. Po pierwsze, najwięcej zyskują strony, którym brakuje linków, a właśnie takie strony automatyzacja znajduje najlepiej. Po drugie, badanie wykazało, że różnorodność anchorów korelowała z kliknięciami oraz że strony z anchorami w postaci URL-a i anchorami z dokładnym dopasowaniem radziły sobie lepiej. System, który linkuje każdą stronę tymi samymi trzema słowami, wyrzuca tę różnorodność do kosza.
Perspektywa GEO
Roboty AI, takie jak GPTBot, ClaudeBot i PerplexityBot, odkrywają strony tak samo jak Googlebot: podążając za linkami <a href>. Wiele z nich nie wykonuje JavaScriptu, więc link wstrzyknięty po stronie klienta może dla nich po prostu nie istnieć. Nasz przewodnik po robotach AI wyjaśnia, co pobiera każdy z nich. Czyste, renderowane po stronie serwera linki wewnętrzne pomagają zarówno wyszukiwarkom, jak i silnikom AI, które cytują Twoje strony.
Automatyczne linkowanie wewnętrzne: maszyna znajduje i umieszcza linki, a człowiek ustala zasady i sprawdza wynik.
Jak od środka działa silnik automatycznego linkowania wewnętrznego
Każde poważne narzędzie, czy to wtyczka, SaaS, czy własny skrypt, przechodzi przez ten sam ciąg kroków. Znając go, ocenisz narzędzie w pięć minut: zapytaj, jak realizuje każdy krok.
6 kroków silnika linkowania wewnętrznego
InwentaryzacjaPrzeskanuj witrynę lub odczytaj CMS, aby wypisać każdą indeksowalną stronę, jej treść główną, tytuł, H1 i istniejące linki wychodzące.
ReprezentacjaZamień każdą stronę w coś porównywalnego: listę słów kluczowych, zbiór encji lub wektor embeddingu.
DopasowanieOceń każdą parę źródło i cel pod kątem trafności, a potem zachowaj najlepszych kandydatów dla każdej strony.
Wybór anchoraZnajdź frazę, która już istnieje w tekście źródłowym i opisuje stronę docelową.
Zastosowanie zasadWymuś limity, wykluczenia, priorytety i strefy zakazane (nagłówki, istniejące linki, nawigacja).
Wstawienie i rejestrZapisz link, zachowaj źródło, cel, anchor, regułę i datę, a potem przeskanuj ponownie, aby to zweryfikować.
Krok 1: inwentaryzacja i dlaczego liczy się „treść główna”
Inwentaryzacja musi oddzielać treść główną od szablonu. Link w menu nagłówka pojawia się na każdej stronie i niewiele mówi Google o stronie docelowej. Link w trzecim akapicie trafnego artykułu mówi bardzo dużo. Dobre silniki usuwają nav, header, footer i aside przed analizą i wstawiają linki tylko w treść artykułu. Wykluczają też nieindeksowalne URL-e: wszystko, co zwraca przekierowanie, 404, noindex lub canonical wskazujący inny adres.
Krok 2: reprezentacja stron
Istnieją trzy popularne reprezentacje, od zgrubnej do precyzyjnej:
Słowa kluczowe: każda strona docelowa ma listę fraz („strategia linkowania wewnętrznego”, „struktura linków”). Szybkie i przewidywalne, ale ślepe na znaczenie.
Encje: biblioteka przetwarzania języka naturalnego wyodrębnia nazwane rzeczy (produkty, miejsca, pojęcia) i przypisuje je do stron, które je omawiają. Lepiej rozróżnia znaczenia.
Embeddingi: model językowy zamienia każdą stronę w wektor kilkuset liczb. Strony o podobnych tematach lądują blisko siebie, nawet jeśli nie mają wspólnych słów. Z tego korzysta dziś większość narzędzi do linkowania „z AI”.
Krok 3: dopasowanie
Przy embeddingach dopasowanie to podobieństwo cosinusowe między wektorami, wynik od -1 do 1 (w praktyce od 0 do 1 dla tekstu). Zachowujesz pary powyżej progu i N najlepszych na stronę. Próg to ustawienie, które liczy się najbardziej: za niski, a połączysz stronę o pytonie (wężu) ze stroną o Pythonie (języku); za wysoki, a znajdziesz tylko niemal duplikaty. Zacznij od około 0,5 do 0,6 przy modelu ogólnym, a potem skoryguj po ręcznym przejrzeniu 50 propozycji.
Krok 4: wybór anchora
Anchor powinien być frazą, która już występuje w zdaniu źródłowym. Wstawianie nowych słów oznacza przepisywanie treści, a to inne zadanie. Silnik szuka w tekście źródłowym fraz opisujących stronę docelową: jej głównego słowa kluczowego, H1, bliskich wariantów lub zapytań, na które strona docelowa już się wyświetla w Search Console. To ostatnie źródło jest najlepsze, bo odzwierciedla, jak prawdziwi ludzie opisują daną stronę.
Kroki 5 i 6: zasady, wstawienie, rejestr
To w zasadach wygrywa się lub przegrywa jakość (patrz osobna sekcja poniżej). Wstawienie odbywa się w jednym z trzech miejsc: w zapisanej treści (link staje się częścią artykułu, jest trwały i widoczny w edytorze), w momencie renderowania na serwerze (filtr dodaje linki przy generowaniu strony, łatwo to wycofać) lub w przeglądarce przez JavaScript (najsłabsza opcja dla SEO). Bez względu na metodę rejestr każdego automatycznego linku jest obowiązkowy: bez niego nie zrobisz audytu, pomiaru ani wycofania.
6 metod automatycznego linkowania wewnętrznego w porównaniu
„Automatyczne linkowanie wewnętrzne” obejmuje bardzo różne techniki. Większość witryn łączy w końcu dwie lub trzy z nich.
1. Autolinkowanie słów kluczowych oparte na regułach
Zasada: prowadzisz tabelę „fraza prowadzi do URL-a”, a system linkuje frazę wszędzie, gdzie się pojawia. Kiedy stosować: słowniki, nazwy produktów, mały zestaw stron sprzedażowych. Zalety: przewidywalne, przejrzyste, tanie. Ograniczenia: brak rozumienia kontekstu, wszędzie te same anchory, tabela się dezaktualizuje. Przykład: każda pierwsza wzmianka o „crawl budget” linkuje do hasła o crawl budget w słowniku, z limitem jednego linku na artykuł.
2. Moduły strukturalne i szablonowe
Zasada: CMS generuje linki ze struktury witryny: okruszki (breadcrumbs), listy kategorii, „powiązane artykuły”, poprzedni i następny wpis, strony hub wypisujące swoje podstrony. Kiedy stosować: zawsze, to warstwa bazowa. Zalety: zero utrzymania, gwarancja, że żadna strona w kategorii nie będzie osierocona. Ograniczenia: linki z szablonu niosą mało kontekstu, a moduły „powiązane wpisy” często wybierają po dacie lub tagu, a nie po znaczeniu. Przykład: okruszki „Blog > SEO > Linkowanie wewnętrzne” w każdym artykule.
3. Sugestie semantyczne z zatwierdzaniem przez człowieka
Zasada: embeddingi znajdują powiązane strony i kandydatów na anchory; redaktor zatwierdza lub odrzuca każdą sugestię. Kiedy stosować: witryny contentowe od około 50 do kilku tysięcy artykułów. Zalety: uwzględnia kontekst, człowiek zostaje w pętli, anchory naturalnie się różnią. Ograniczenia: czas na przegląd, a jakość zależy od progu. Przykład: po publikacji artykułu o „kanibalizacji słów kluczowych” narzędzie proponuje pięć starszych artykułów, w których jakieś zdanie już wspomina o kanibalizacji.
4. Linkowanie oparte na encjach
Zasada: encje są wyodrębniane z każdej strony i linkowane do strony, która jest w Twojej witrynie stroną referencyjną dla danej encji. Kiedy stosować: witryny z wieloma nazwanymi rzeczami: marki, miejsca, osoby, składniki, oprogramowanie. Zalety: dobre rozróżnianie znaczeń, buduje czystą mapę „jedna encja, jedna strona”. Ograniczenia: wymaga mapy encja do strony, słabsze przy tematach abstrakcyjnych. Przykład: serwis podróżniczy linkuje każdą wzmiankę o „Kioto” do przewodnika po Kioto, nigdy do strony z hotelami w Kioto.
5. Linkowanie oparte na grafie (wewnętrzny PageRank)
Zasada: witryna jest traktowana jak graf. Narzędzie liczy dla każdej strony wewnętrzny wynik (metrykę podobną do PageRank), jej głębokość kliknięć od strony głównej i liczbę linków przychodzących, a potem proponuje linki, które przesyłają autorytet do stron priorytetowych i przybliżają głęboko ukryte strony do powierzchni. Kiedy stosować: duże witryny, e-commerce, każda witryna, w której strony biznesowe są zakopane. Zalety: optymalizuje pod konkretny cel, a nie tylko pod trafność. Ograniczenia: model jest przybliżeniem tego, jak Google waży linki, a czysta logika grafu może tworzyć nietrafione linki, jeśli nie połączy się jej z filtrem trafności. Przykład: strona kategorii na głębokości 5 dostaje linki z trzech mocnych poradników, które rankują na powiązane zapytania, i przesuwa się na głębokość 2.
6. Linkowanie na etapie pisania
Zasada: linki są umieszczane podczas tworzenia treści przez autora lub narzędzie do pisania z AI, które ma przed sobą inwentarz witryny. Kiedy stosować: każda witryna, która publikuje regularnie. Zalety: link jest częścią zdania napisanego z myślą o nim, więc anchory brzmią naturalnie. Ograniczenia: obsługuje linki wychodzące z nowej strony, a nie linki do niej ze starszych stron, więc trzeba go połączyć z metodą uzupełniania wstecznego. Przykład:generator artykułów blogowych z AI od Sorank pisze każdy artykuł z linkami wewnętrznymi do Twoich stron usług, produktów lub kategorii już na swoim miejscu.
Metoda
Trafność
Nakład pracy
Jakość anchorów
Ryzyko przy złej konfiguracji
Najlepsze zastosowanie
Autolinkowanie słów kluczowych oparte na regułach
Niska
Niski
Powtarzalne
Wysokie (upychanie słów kluczowych)
Słowniki, nazwy produktów
Moduły strukturalne i szablonowe
Średnia
Bardzo niski
Ogólne
Niskie
Każda witryna, jako warstwa bazowa
Sugestie semantyczne z zatwierdzaniem
Wysoka
Średni (przegląd)
Naturalne i zróżnicowane
Niskie
Blogi i huby treści
Linkowanie oparte na encjach
Wysoka dla nazwanych rzeczy
Średni
Precyzyjne
Średnie
Turystyka, e-commerce, katalogi
Oparte na grafie (wewnętrzny PageRank)
Zmienna
Wysoki (analiza)
Zależy od filtra
Średnie
Duże witryny, zakopane strony sprzedażowe
Linkowanie na etapie pisania
Wysoka
Niski
Najbardziej naturalne
Niskie
Witryny, które często publikują
Automatyzacja służy architekturze, ale jej nie zastępuje
Zanim cokolwiek skonfigurujesz, zdecyduj, jaki kształt mają tworzyć linki. Siatka w stylu Wikipedii łączy dowolną stronę z dowolną powiązaną stroną; to domyślny wynik narzędzi semantycznych i dobrze sprawdza się przy treściach encyklopedycznych. Kokon semantyczny ogranicza linki do stron z tego samego drzewa tematycznego: strony matki linkują w dół, a strony córki w górę i na boki; Twoje zasady muszą zakazywać linków między kokonami poza samym szczytem. Silos URL podąża za strukturą folderów (/guides/seo/...); prosta reguła „linkuj tylko w obrębie tego samego folderu plus hub” go wymusza. Klastry tematyczne, opisane w naszym przewodniku po klastrach tematycznych i stronach filarowych, sytuują się między kokonem a siatką. Nasz artykuł o architekturze witryny pod SEO pomaga wybrać.
Zasady, które sprawiają, że automatyczne linki są bezpieczne
Silnik linkowania bez zasad to generator spamu. Oto ustawienia, które warto spisać przed pierwszym uruchomieniem, z wartościami, które sprawdzają się na start.
W pełni automatyczne wstawianie a proponowanie i zatwierdzanie
W pełni automatycznie
Natychmiast skaluje się do dowolnej liczby
Brak czasu redakcyjnego
Błędy są publikowane masowo
Dziwne anchory i złe konteksty przechodzą niezauważone
Trudno wyjaśnić, dlaczego dany link istnieje
Proponuj i zatwierdzaj
Maszyna znajduje, człowiek decyduje
Każdy link ma właściciela i powód
Zasady poprawiają się dzięki odrzuconym sugestiom
Można przejść na tryb auto dla zaufanych reguł
Wymaga co tydzień czasu na przegląd
Limity i gęstość
Automatyczne linki na stronę: 3 do 5 w artykule na 1500 słów, oprócz linków umieszczonych przez autora. Google mówi, że nie ma idealnej liczby, ale ostrzega przed nadmiernym linkowaniem; Twoje własne dane powiedzą więcej niż jakakolwiek reguła kciuka.
Jeden link do danego celu na stronę. Trzykrotne linkowanie tego samego URL-a w jednym artykule nic nie daje czytelnikom i zaciemnia raporty.
Minimalny odstęp: co najmniej 50 do 80 słów między dwoma automatycznymi linkami, żeby akapity nie zrobiły się niebieskie.
Maksimum na frazę anchora w całej witrynie: ogranicz liczbę stron, które mogą użyć dokładnie tego samego anchora dla tego samego celu, a potem wymuś warianty.
Strefy zakazane
Nigdy nie wstawiaj linków w nagłówki, spis treści, podpisy obrazów, cytaty, przyciski wezwania do działania, ramki autora ani wewnątrz istniejącego <a> (zagnieżdżone linki to niepoprawny HTML). Nigdy nie linkuj strony do niej samej, do URL-a, który przekierowuje, ani do strony z noindex lub z canonicalem na inny URL.
Zasady dotyczące anchorów
Dokumentacja Google prosi o tekst anchora, który jest „opisowy, rozsądnie zwięzły i związany ze stroną, na której się znajduje”, a „kliknij tutaj” i „czytaj więcej” podaje jako zbyt ogólne. Przełóż to na zasady: anchory od 2 do 6 słów, wzięte z istniejącego zdania, co najmniej dwa lub trzy różne warianty na cel w całej witrynie i jedna intencja na anchor. Jeśli „narzędzie do linkowania wewnętrznego” prowadzi na jednej stronie do darmowego analizatora, a na innej do płatnej funkcji, opowiadasz wyszukiwarkom dwie różne historie. Nasz przewodnik po tekście anchora szczegółowo omawia typy anchorów.
Nie każda strona zasługuje na więcej linków. Zbuduj krótką listę celów priorytetowych: strony, które zarabiają, strony na pozycjach od 5 do 20 na wartościowe zapytania (Search Console, raport Skuteczność, filtr po pozycji) oraz Twoje treści filarowe (cornerstone content). Dodaj każdą stronę osieroconą i każdą stronę głębiej niż 3 kliknięcia. Ta lista zasila „priority_targets” w Twoich zasadach.
Krok 3: zbuduj bank anchorów
Dla każdego celu priorytetowego zbierz od 3 do 10 fraz anchorów. Najlepszym źródłem jest Search Console: otwórz stronę w raporcie Skuteczność, przejdź na kartę Zapytania i wyeksportuj zapytania, na które strona już ma wyświetlenia. Dodaj H1, główne słowo kluczowe i naturalne warianty. Usuń wszystko, co niejednoznaczne lub współdzielone z inną stroną.
Krok 4: wygeneruj kandydatów i przefiltruj ich
Uruchom narzędzie lub skrypt. Dla każdego celu powinno zwrócić strony źródłowe, w których anchor występuje w treści, a temat jest wystarczająco bliski. Spodziewaj się, że lejek mocno się zwęzi: to znak, że filtry działają.
Jak filtrowani są kandydaci na linki
Każda para źródło i cel w witrynieWszystkie pary
Pary powyżej progu podobieństwa20 najlepszych na stronę
Pary, w których w tekście istnieje naturalny anchorAnchor znaleziony
Pary, które przechodzą limity i strefy zakazaneZasady spełnione
Linki zatwierdzone i opublikowane3 do 5 na stronę
Krok 5: przeglądaj partiami
Przeglądaj sugestie w arkuszu z pięcioma kolumnami: źródło, cel, anchor, zdanie, wynik. Czytaj zdanie, a nie tylko anchor. Odrzucaj wszystko, czego nie napisałbyś sam. Zapisuj powód odrzucenia (złe znaczenie, zbyt promocyjne, już podlinkowane w pobliżu): te powody staną się nowymi zasadami.
Krok 6: publikuj falami, a nie wszystko naraz
Publikuj od 50 do 200 linków na falę, na zestawie stron, który możesz śledzić. Zachowaj grupę kontrolną podobnych stron bez nowych linków. Zmiany w kliknięciach mają wtedy punkt odniesienia, co ma znaczenie, bo pozycje zmieniają się z wielu powodów.
Krok 7: przeskanuj ponownie i sprawdź wyrenderowany HTML
Przeskanuj witrynę ponownie. Sprawdź, czy nowe linki pojawiają się jako <a href> w surowym HTML, a nie dopiero po wykonaniu JavaScriptu. Dla kilku URL-i użyj narzędzia Sprawdzanie adresu URL w Search Console i obejrzyj wyrenderowany HTML, który widzi Google.
Krok 8: podłącz to do procesu publikacji
Prawdziwy zysk jest ciągły. Przy każdej publikacji artykułu system powinien zrobić dwie rzeczy: dodać linki wychodzące z nowego artykułu (na etapie pisania) i zaproponować linki do niego ze starszych stron (uzupełnianie wsteczne). Przy każdej zmianie URL-a powinien zaktualizować lub usunąć linki, które do niego prowadzą.
Wskazówka
Aby szybko sprawdzić jedną stronę, wklej jej URL do naszego darmowego analizatora linków wewnętrznych: wypisze każdy link wewnętrzny na stronie, jego anchor i atrybuty, więc potwierdzisz, że fala automatycznych linków poszła zgodnie z planem.
Zbuduj własny: skrypt do semantycznego linkowania wewnętrznego w Pythonie
Jeśli Twój CMS nie ma dobrego narzędzia albo chcesz dokładnie zrozumieć, co robi dostawca, działający prototyp zajmuje około 60 linii. Ta wersja czyta mapę witryny, wyodrębnia treść główną, liczy embeddingi modelem open source i zwraca plik CSV z sugestiami do przeglądu przez człowieka. Nigdy nie dotyka Twojej witryny.
import csv, re
from urllib.parse import urljoin
import requests
from bs4 import BeautifulSoup
from sentence_transformers import SentenceTransformer, util

SITEMAP = "https://example.com/sitemap.xml"
urls = re.findall(r"<loc>(.*?)</loc>", requests.get(SITEMAP, timeout=20).text)

pages = {}
for url in urls:
    r = requests.get(url, timeout=20)
    if r.status_code != 200 or r.url != url:
        continue  # skip errors and redirects
    soup = BeautifulSoup(r.text, "html.parser")
    robots = soup.find("meta", attrs={"name": "robots"})
    if robots and "noindex" in robots.get("content", ""):
        continue
    main = soup.find("article") or soup.find("main") or soup.body
    for tag in main.find_all(["nav", "header", "footer", "aside", "script", "style"]):
        tag.decompose()
    pages[url] = {
        "h1": soup.h1.get_text(" ", strip=True) if soup.h1 else "",
        "text": main.get_text(" ", strip=True),
        "links": {urljoin(url, a["href"]).split("#")[0] for a in main.find_all("a", href=True)},
    }
Embeddingi, dopasowanie i wyszukiwanie anchorów
model = SentenceTransformer("all-MiniLM-L6-v2")
keys = list(pages)
docs = [pages[u]["h1"] + ". " + pages[u]["text"][:2000] for u in keys]
emb = model.encode(docs, normalize_embeddings=True)
sim = util.cos_sim(emb, emb)

# Anchor bank: target URL -> phrases (H1 + queries exported from Search Console)
anchors = {u: [pages[u]["h1"].lower()] for u in keys}
# anchors["https://example.com/crawl-budget"] += ["crawl budget", "crawl budget optimization"]

THRESHOLD, MAX_PER_PAGE = 0.55, 5

def find_anchor(text, phrases):
    for phrase in sorted(phrases, key=len, reverse=True):
        if len(phrase.split()) < 2:
            continue
        m = re.search(r"\b" + re.escape(phrase) + r"\b", text, re.IGNORECASE)
        if m:
            start = max(0, m.start() - 120)
            return m.group(0), text[start:m.end() + 120]
    return None, None

rows = []
for i, src in enumerate(keys):
    added = 0
    for j in sorted(range(len(keys)), key=lambda k: -float(sim[i][k])):
        score = float(sim[i][j])
        if score < THRESHOLD or added == MAX_PER_PAGE:
            break
        tgt = keys[j]
        if tgt == src or tgt in pages[src]["links"]:
            continue
        anchor, context = find_anchor(pages[src]["text"], anchors[tgt])
        if anchor:
            rows.append([src, tgt, anchor, round(score, 2), context])
            added += 1

with open("link_suggestions.csv", "w", newline="", encoding="utf-8") as f:
    csv.writer(f).writerows([["source", "target", "anchor", "score", "context"]] + rows)
Jak przygotować go do produkcji
Szanuj serwer: dodaj opóźnienie między żądaniami i czytelny User-Agent albo czytaj treść bezpośrednio z bazy danych lub API CMS zamiast crawlować.
Użyj lepszego tekstu do embeddingów: tytuł plus H1 plus pierwsze 300 słów zwykle wypada lepiej niż cała strona, która rozmywa temat.
Skaluj dopasowanie: macierz podobieństwa rośnie z kwadratem liczby stron. Powyżej 20000 stron użyj indeksu przybliżonych najbliższych sąsiadów (na przykład FAISS) i porównuj każdą stronę tylko z jej 50 najbliższymi sąsiadami.
Dodaj priorytety: mnóż wynik przez premię dla celów priorytetowych i przez karę dla celów, które już mają wiele linków przychodzących.
Szanuj architekturę: w przypadku silosu lub kokonu odrzucaj pary, których URL-e nie mają wspólnego dozwolonego folderu lub drzewa tematycznego.
Wstawiaj po stronie serwera: zapisuj zatwierdzone linki w zapisanej treści przez API CMS, nigdy przez skrypt front-endowy.
Znajdź niepodlinkowane wzmianki crawlerem
Bez pisania kodu crawler może wykonać część pracy. W Screaming Frog funkcja Custom Search znajduje każdą stronę zawierającą daną frazę, a Custom Extraction z XPath liczy linki do wskazanego celu. Strony, które zawierają frazę, ale mają zero linków do celu, to Twoi kandydaci. Podręcznik użytkownika SEO Spider opisuje też jego Link Score, „metrykę od 0 do 100, która oblicza względną wartość strony na podstawie jej linków wewnętrznych”; wymaga ona uruchomienia analizy crawla po zakończeniu crawlowania.
Screaming Frog SEO Spider: przeskanuj witrynę, wyeksportuj linki wewnętrzne i anchory oraz znajdź strony, które wspominają temat, ale do niego nie linkują.
Częste błędy przy automatycznym linkowaniu wewnętrznym (i jak je naprawić)
Większość problemów z automatycznym linkowaniem to nie kary. To zmarnowane linki, mylące sygnały i strony, które brzmią, jakby napisała je maszyna. Oto jak wykryć i naprawić każdy z nich.
1. Linkowanie każdego wystąpienia słowa kluczowego
Na czym polega: wtyczka oparta na regułach, ustawiona bez limitów, linkuje „audyt SEO” na 400 stronach tym samym anchorem do tej samej strony. Jak go wykryć: w eksporcie anchorów z crawlera posortuj anchory wewnętrzne według częstotliwości; jedna fraza z setkami identycznych użyć do jednego URL-a to sygnał. Jak go naprawić: ogranicz użycia na regułę w całej witrynie, wymagaj co najmniej dwóch wariantów na cel i usuń linki ze stron, na których temat pojawia się tylko mimochodem.
2. Linkowanie w złym znaczeniu
Na czym polega: słowo pasuje, znaczenie nie („Apple” jako owoc podlinkowane do artykułu o iPhone'ach, „Jawa” jako wyspa do tutoriala programistycznego). Jak go wykryć: co miesiąc przeglądaj losową próbkę 30 automatycznych linków i czytaj całe zdanie. Jak go naprawić: podnieś próg podobieństwa, wymagaj zarówno dopasowania frazy, jak i tematu, i dodaj słowa wykluczające do niejednoznacznych reguł.
3. Za dużo linków na akapit
Na czym polega: silnik upycha cztery linki w akapicie liczącym 60 słów. Czytelnicy przestają klikać, a tekst staje się trudny do czytania. Jak go wykryć: policz linki na 100 słów treści głównej; wszystko powyżej 3 warto obejrzeć. Jak go naprawić: ustaw minimalny odstęp w słowach między automatycznymi linkami i limit na stronę, który uwzględnia linki już umieszczone przez autora.
4. Linki w nagłówkach, przyciskach lub wewnątrz innych linków
Na czym polega: dopasowanie wewnątrz H2, spisu treści lub istniejącego anchora zostaje owinięte nowym linkiem, co daje zagnieżdżone znaczniki <a> lub niebieskie nagłówki. Jak go wykryć: przepuść kilka stron przez walidator HTML albo wyszukaj w crawlu nagłówki zawierające linki. Jak go naprawić: jawnie zadeklaruj zakazane selektory i testuj je na kopii testowej przed każdą nową regułą.
5. Linki, które istnieją tylko w JavaScripcie
Na czym polega: widżet front-endowy wstrzykuje linki po załadowaniu strony, czasem bez href, czasem dopiero po przewinięciu lub kliknięciu. Jak go wykryć: porównaj surowy HTML (wyświetl źródło) z wyrenderowanym DOM i sprawdź wyrenderowany HTML w narzędziu Sprawdzanie adresu URL w Search Console. Jak go naprawić: przenieś wstawianie na serwer lub do zapisanej treści. Nasz przewodnik po JavaScript SEO szczegółowo wyjaśnia renderowanie.
Uwaga
Wiele robotów AI w ogóle nie uruchamia JavaScriptu. Link, który pojawia się dopiero po wykonaniu skryptów, może być widoczny dla Googlebota po renderowaniu, a jednocześnie niewidoczny dla botów zasilających ChatGPT, Claude czy Perplexity.
6. Linkowanie do przekierowań, stron noindex i błędów 404
Na czym polega: automatyczne linki zbudowane na starym inwentarzu wciąż wskazują URL-e, które zostały przeniesione lub usunięte. Jak go wykryć: w crawlu filtruj linki wewnętrzne po kodzie statusu (3xx, 4xx) i po nieindeksowalnym celu; nasz darmowy checker uszkodzonych linków robi to dla pojedynczej strony. Jak go naprawić: odświeżaj inwentarz przed każdym uruchomieniem, akceptuj tylko cele z kodem 200, indeksowalne i z canonicalem na siebie, a przy tworzeniu przekierowania 301 aktualizuj linki na miejscu.
7. Poleganie wyłącznie na widżetach „powiązane wpisy”
Na czym polega: witryna uważa, że jest dobrze podlinkowana, bo każdy artykuł kończy się trzema powiązanymi wpisami. Takie bloki często wybierają po tagu lub dacie, rotują i całkowicie pomijają starsze treści. Jak go wykryć: Twój raport stron osieroconych (URL-e z mapy witryny nieosiągnięte przez crawl albo osiągnięte tylko przez paginację) pozostaje długi. Jak go naprawić: zachowaj widżet, ale dodaj linki kontekstowe w treści i stałe linki ze stron hub.
8. Jeden anchor wskazujący dwie strony
Na czym polega: „narzędzie do linkowania wewnętrznego” prowadzi w jednych artykułach do strony A, a w innych do strony B. Rozdzielasz sygnały trafności i możesz napędzać kanibalizację słów kluczowych. Jak go wykryć: zbuduj z crawla mapę anchor do celu i oznacz każdy anchor z więcej niż jednym celem. Jak go naprawić: jedna intencja wyszukiwania, jedna strona docelowa; przypisz ponownie anchory słabszej strony.
9. Brak rejestru, brak możliwości wycofania
Na czym polega: linki zostały wstawione w treść przez wtyczkę, którą później odinstalowano, albo nikt nie wie, które linki są automatyczne. Jak go wykryć: nie potrafisz odpowiedzieć na pytanie „ile linków narzędzie dodało w zeszłym miesiącu?”. Jak go naprawić: przechowuj każdy automatyczny link w tabeli (źródło, cel, anchor, reguła, data, status), oznaczaj je w HTML atrybutem data, jeśli pozwala na to Twój stack, i sprawdź, czy potrafisz usunąć wszystkie linki z jednej reguły w jednej operacji.
Błąd
Sygnał do wyszukania
Naprawa
Każde wystąpienie podlinkowane
Jeden anchor użyty setki razy do jednego URL-a
Limity w całej witrynie, warianty anchorów
Złe znaczenie
Dziwne zdania w ręcznej próbce
Wyższy próg, słowa wykluczające
Gęstość linków
Ponad 3 linki na 100 słów
Odstęp w słowach, limit na stronę
Strefy zakazane
Linki w nagłówkach, zagnieżdżone anchory
Jawne selektory wykluczeń
Linki tylko w JavaScripcie
Linków brak w źródle strony
Wstawianie po stronie serwera
Martwe cele
Linki wewnętrzne 3xx i 4xx w crawlu
Odświeżony inwentarz, tylko cele 200
Linkowanie tylko widżetem
Długa lista stron osieroconych
Linki kontekstowe i z hubów
Jeden anchor, dwa cele
Mapa anchorów z duplikatami
Jedna intencja, jedna strona
Brak rejestru
Nie da się policzyć automatycznych linków
Tabela linków, atrybut data, wycofanie
Jak mierzyć wpływ automatycznych linków wewnętrznych
Linki wewnętrzne rzadko dają skok z dnia na dzień. Mierz na stronach, które dostały linki, w porównaniu z grupą kontrolną, w okresie od 4 do 12 tygodni.
Co śledzić po każdej fali linków
Liczba stron osieroconych (mapa witryny a crawl)
Strony głębiej niż 3 kliknięcia od strony głównej
Unikalne przychodzące linki wewnętrzne na stronę priorytetową
Wyświetlenia i średnia pozycja stron docelowych w Search Console
Kliknięcia stron docelowych w porównaniu z grupą kontrolną
Częstotliwość crawlowania stron docelowych w logach serwera
Odsetek automatycznych linków odrzuconych w przeglądzie (jakość zasad)
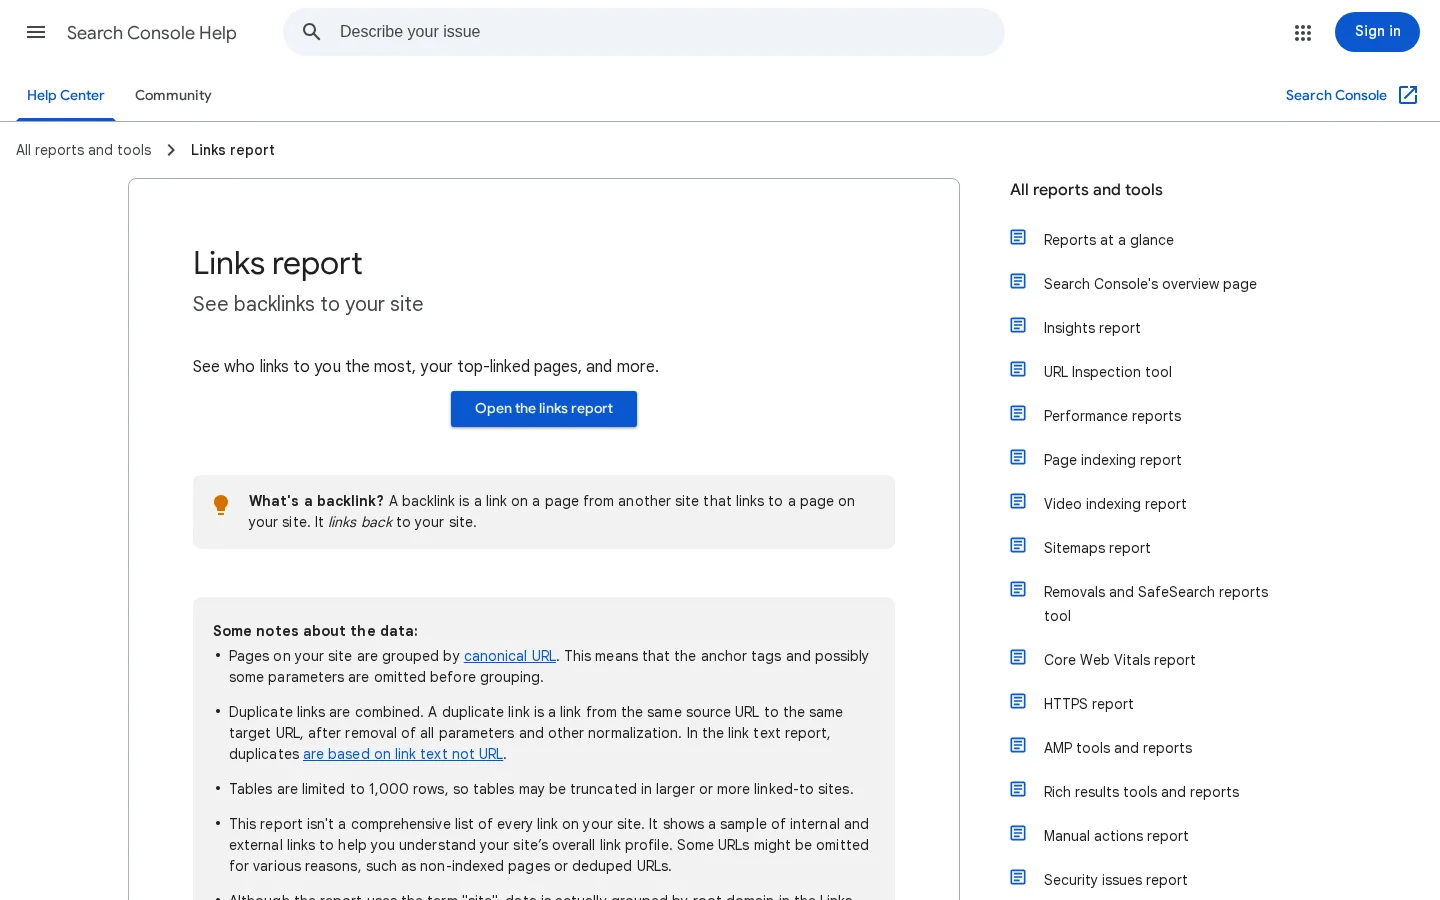
Raport Linki w Search Console
Raport Linki w Search Console pokazuje Twoje „strony z największą liczbą linków wewnętrznych” i dla każdej z nich strony, które do niej linkują. Przydaje się do szybkiej kontroli (czy Twoje strony priorytetowe są blisko góry?), ale strona pomocy Google ostrzega, że jego tabele są ograniczone do 1000 wierszy i że raport „nie jest pełną listą wszystkich linków w Twojej witrynie”. Traktuj własny crawl jako źródło prawdy, a Search Console jako podgląd tego, co Google faktycznie odczytał.
Raport Linki w Search Console pokazuje strony z największą liczbą linków wewnętrznych, z limitem 1000 wierszy: używaj go do kontroli, a nie jako źródła prawdy.
Logi serwera
Jeśli masz do nich dostęp, logi serwera pokazują, czy Googlebot i roboty AI odwiedzają nowo podlinkowane strony częściej po danej fali. To najbardziej bezpośredni sygnał, że odkrywanie się poprawiło. Nasz przewodnik po analizie logów serwera pod SEO wyjaśnia, jak filtrować boty i odczytywać częstotliwość crawlowania oraz dlaczego ma to znaczenie dla crawl budget w dużych witrynach.
Uczciwe czytanie wyników
Jeśli wyświetlenia rosną na stronach docelowych, ale nie w grupie kontrolnej, linki prawdopodobnie pomogły. Jeśli rosną w obu grupach, to raczej efekt sezonowy lub algorytmiczny. Jeśli strony docelowe zyskują wyświetlenia, ale nie kliknięcia, kolejną dźwignią jest tytuł i treść, a nie więcej linków. A jeśli po 12 tygodniach nic się nie rusza, sprawdź podstawy: czy linki są w surowym HTML i czy strony docelowe są faktycznie zaindeksowane?
Od czego zacząć już dziś
Nie potrzebujesz dużego narzędzia, żeby zacząć. Wybierz jeden klaster z 20 do 50 stron, przeskanuj go, wypisz jego strony osierocone i priorytetowe, zbuduj bank anchorów z Search Console i dodaj linki w jednej, przejrzanej fali. Mierz przez sześć tygodni, zapisz wnioski jako zasady, a potem rozszerz działanie na kolejny klaster.
Jeśli publikujesz często, najtańszym zyskiem jest linkowanie na etapie pisania: każdy nowy artykuł powinien opuszczać edytor z linkami do właściwych stron. Właśnie to robi Sorank, gdy pisze i publikuje artykuły za Ciebie, a jego generator klastrów tematycznych planuje klastry, którymi podążają te linki, z wbudowaną ochroną przed kanibalizacją. Dla starszych stron połącz to z przejrzanym uzupełnianiem wstecznym według opisanej wyżej metody.
Najczęściej zadawane pytania
Czy automatyczne linkowanie wewnętrzne jest bezpieczne dla SEO?
Tak, o ile linki są trafne, mają opisowe anchory i mieszczą się w rozsądnych limitach. Dokumentacja Google wymaga linków, które da się przeskanować, z opisowym tekstem anchora i ostrzega przed nadmiernym linkowaniem, a nie przed samą automatyzacją. Ryzyko tworzą narzędzia, które linkują każde wystąpienie słowa kluczowego tym samym anchorem, więc zachowaj etap przeglądu i rejestruj każdy automatyczny link.
Ile linków wewnętrznych powinien mieć artykuł?
Google mówi, że nie ma idealnej liczby. Praktycznym punktem wyjścia są 3 do 5 automatycznych linków kontekstowych w artykule na 1500 słów, oprócz linków umieszczonych przez autora, z jednym linkiem na cel i odstępem między linkami. Mierz na własnych stronach i koryguj, bo badanie korelacyjne Zyppy wykazało zyski do około 40 przychodzących linków wewnętrznych na URL i odwrócenie trendu po około 45 do 50.
Czy automatyczne linkowanie wewnętrzne zastępuje strategię linkowania wewnętrznego?
Nie. Automatyzacja realizuje strategię: znajduje kandydatów, wstawia linki i dba o ich aktualność. Nadal musisz zdecydować, które strony są priorytetowe, jaką architekturę mają tworzyć linki (siatka, kokon semantyczny czy silos) i które anchory należą do której strony.
y!
Odbierz za darmo plan treści na 30 dni
Analizujemy Twoich konkurentów, Twoją stronę i Twoją widoczność w AI, aby bezpłatnie przygotować dla Ciebie dopasowany plan treści.
“Przetestowałem Sorank na prawdziwej stronie klienta i to jest szalone. Robi wszystko, za co agencja policzyłaby Ci $1500 miesięcznie. Teraz trafia na produkcję u tego klienta.”Guillaume Guersanguersanguillaume.com
“Jesteśmy agencją reklamową i chcieliśmy raz na zawsze uporządkować nasze SEO. Sorank dał nam przejrzysty obraz naszej strony, pomógł ustalić priorytety optymalizacji i właściwie uporządkować nasze treści. Narzędzie jest proste w obsłudze, dobrze zaprojektowane do pracy zespołowej i bardzo praktyczne do centralizacji monitoringu bez żonglowania wieloma platformami. Bardzo solidna podstawa, by zacząć SEO od nowa.”Gaspard MadouiAgencja reklamowa
“Dzięki Sorank wyspecjalizowałem się w GEO. Ranking GEO pozwala mi pokazywać klientom ich pozycję na tle konkurencji w ChatGPT. To realna przewaga handlowa.”MélanieFreelancer SEO
“Świetna usługa, dobrze działa dla naszej strony i pomaga zrozumieć, jak ją ulepszyć, aby lepiej pozycjonować się w Google i nie tylko. Gratulacje, tak trzymać, polecam.”Hugo T.Sprzedawca e-commerce