A privacidade é importante para nós, então você tem a opção de desativar certos tipos de armazenamento que podem não ser necessários para o funcionamento básico do site. O bloqueio de categorias pode afetar sua experiência no site. Mais informações (Política de cookies)
Uma rede de páginas conectadas por links internos, alguns colocados automaticamente e revisados por um editor antes da publicação.
Ferramentas
Nesta página
Em resumo
linkagem interna automatizada significa deixar um software encontrar, sugerir ou inserir os links entre suas próprias páginas, em vez de colocar cada um à mão. Funciona bem quando a máquina faz a parte trabalhosa (rastrear, relacionar temas, detectar páginas órfãs, registrar cada link) e você mantém o controle das regras: quais páginas impulsionar, quais âncoras permitir, quantos links por página. Configure no modelo «sugerir, aprovar, publicar, medir», não como um plugin que transforma em link cada palavra-chave que encontra.
3 dias grátis, depois você para quando quiser. Garantia de resultados de 90 dias, sujeita a condições.
O que é linkagem interna automatizada (e o que não é)
Um link interno é um link de uma página do seu site para outra página do mesmo site. Ele tem três funções: permite que os rastreadores descubram as páginas, mostra aos buscadores e aos sistemas de IA do que trata a página de destino (pelo texto âncora e pelas palavras ao redor) e transmite autoridade das páginas fortes para as mais fracas. Se esses conceitos são novos para você, comece pela nossa definição de linkagem interna.
Automatizar significa que um programa cuida de uma ou mais destas tarefas:
Inventário: rastrear o site e listar cada página, cada link existente e cada âncora.
Correspondência: decidir qual página deve apontar para qual, com base em palavras-chave, significado ou entidades.
Escolha da âncora: encontrar uma expressão que já está no texto de origem e que descreve o destino.
Inserção: escrever o link no HTML, no banco de dados do CMS ou no momento da renderização.
Manutenção: corrigir os links quando uma URL muda, uma página é excluída ou um novo artigo é publicado.
O que não é: uma forma de enfiar o mesmo link de palavra-chave em 500 páginas, um substituto para a arquitetura do site ou um widget de «posts relacionados» no fim de cada artigo. Esses elementos podem fazer parte de um sistema automatizado, mas sozinhos produzem sobretudo ruído.
Por que a linkagem manual deixa de funcionar
A linkagem manual funciona em um site de 30 páginas. Ela falha em um site que publica toda semana, por um motivo simples: cada novo artigo cria duas tarefas. Ele precisa de links para páginas existentes, e as páginas mais antigas precisam de links para ele. A segunda tarefa é a que todo mundo esquece. Depois de dois anos publicando, você tem artigos recentes para os quais ninguém aponta e artigos antigos que ainda apontam para páginas que você já substituiu.
A linkagem interna antes e depois da automação
Antes (manual)
Novos artigos recebem links de saída, raramente de entrada
Páginas órfãs se acumulam sem ninguém perceber
Há links para redirecionamentos e URLs excluídas
As âncoras dependem de quem escreveu o artigo
Depois (automatizado, com revisão)
Cada nova página recebe links de páginas relacionadas
As órfãs são sinalizadas a cada rastreamento
Destinos quebrados ou redirecionados são atualizados
As âncoras seguem regras escritas e ficam registradas
Este artigo foca na mecânica: métodos, configurações, um script que funciona e os casos de falha. Para o lado estratégico (quais páginas priorizar, como planejar os links de um site multilíngue), leia antes a nossa estratégia avançada de linkagem interna. Os dois textos foram pensados para serem usados juntos.
Por que isso importa: o que os dados dizem sobre links internos
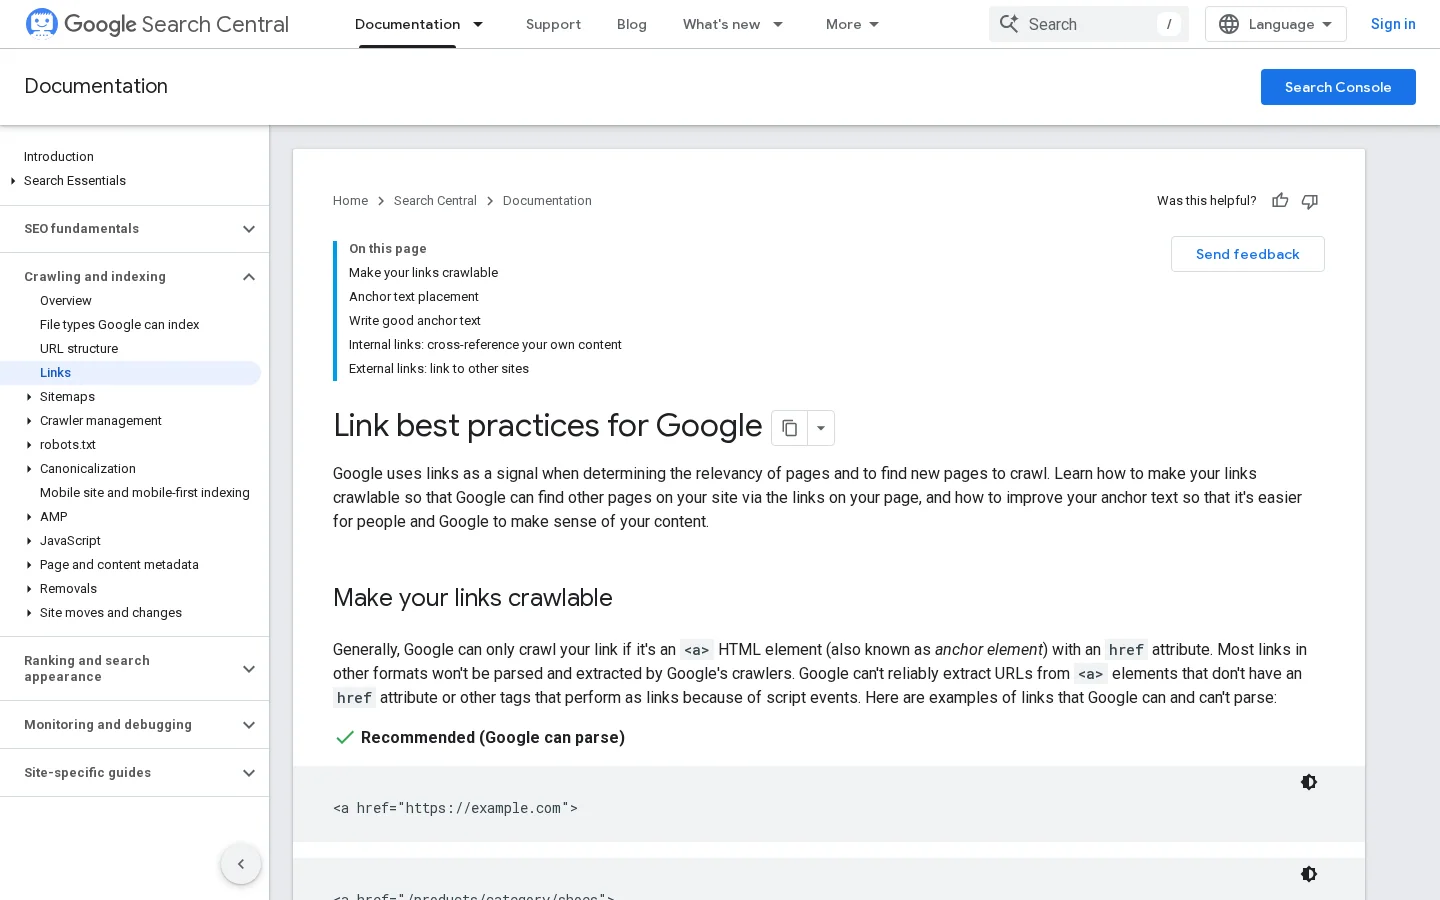
O Google é claro sobre o mínimo. A sua documentação de boas práticas para links afirma que «toda página importante para você deve ter um link de pelo menos uma outra página do seu site», e que o Google em geral só consegue rastrear um link se ele for um elemento <a> com um atributo href. Uma página órfã não é proibida, mas você aposta apenas no sitemap para que ela seja encontrada e compreendida.
Além do mínimo, o melhor conjunto de dados público sobre o tema é um estudo de correlação de Cyrus Shepard, da Zyppy, «23 Million Internal Links: SEO Case Study» (atualizado em fevereiro de 2026). Ele cruza os dados de links internos de cerca de 1800 sites com os cliques do Search Console.
O que 23 milhões de links internos revelam
23 milhõeslinks internos analisados em cerca de 520000 URLs
1800sites no conjunto de dados, cruzados com os cliques do Google Search Console
5xpelo menos cinco vezes mais tráfego para páginas com pelo menos uma âncora interna de correspondência exata
6%mais de 6% de todos os links internos não tinham nenhum texto âncora
Fonte: Cyrus Shepard, Zyppy, 23 Million Internal Links SEO Case Study, atualizado em fevereiro de 2026
A descoberta mais útil para a automação diz respeito ao volume. URLs com 0 a 4 links internos recebiam em média 2 cliques do Google, enquanto URLs com 40 a 44 links internos recebiam quatro vezes mais. A partir de cerca de 45 a 50 links, o efeito se inverte. O autor atribui boa parte dessa queda aos links de navegação presentes em todo o site, e faz questão de chamar o estudo de correlacional: útil como direção, não como prova.
Média de cliques do Google por URL segundo o número de links internos que ela recebe
0 a 4 links internos2 cliques
40 a 44 links internos8 cliques (4x)
Fonte: Cyrus Shepard, Zyppy, 23 Million Internal Links SEO Case Study, atualizado em fevereiro de 2026
Daí saem duas lições práticas. Primeiro, as páginas com poucos links são as que mais ganham, e é exatamente isso que a automação sabe encontrar. Segundo, o estudo observou que a variedade de âncoras tinha correlação com os cliques, e que páginas com âncoras em forma de URL e de correspondência exata se saíam melhor. Um sistema que liga cada página com as mesmas três palavras joga essa variedade fora.
O ângulo do GEO
Rastreadores de IA como GPTBot, ClaudeBot e PerplexityBot descobrem páginas do mesmo jeito que o Googlebot: seguindo links <a href>. Muitos não executam JavaScript, então um link injetado no navegador pode simplesmente não existir para eles. Nosso guia sobre rastreadores de IA explica o que cada bot busca. Links internos limpos e renderizados no servidor ajudam tanto os buscadores quanto os mecanismos de IA que citam suas páginas.
Linkagem interna automatizada: a máquina encontra e coloca os links, uma pessoa define as regras e confere o resultado.
Como funciona por dentro um motor de linkagem interna automatizada
Toda ferramenta séria, seja um plugin, um SaaS ou um script escrito por você, segue o mesmo pipeline. Conhecê-lo permite avaliar uma ferramenta em cinco minutos: pergunte como ela executa cada etapa.
O pipeline em 6 etapas de um motor de linkagem interna
InventariarRastrear o site ou ler o CMS para listar cada página indexável, seu conteúdo principal, título, H1 e links de saída existentes.
RepresentarTransformar cada página em algo comparável: uma lista de palavras-chave, um conjunto de entidades ou um vetor de embedding.
RelacionarPontuar cada par de origem e destino pela relevância e manter os melhores candidatos por página.
Escolher a âncoraEncontrar uma expressão que já existe no texto de origem e que descreve o destino.
Aplicar as regrasFazer valer limites, exclusões, prioridades e zonas proibidas (títulos, links existentes, navegação).
Inserir e registrarEscrever o link, guardar origem, destino, âncora, regra e data, e rastrear de novo para verificar.
Etapa 1: o inventário, e por que o «conteúdo principal» importa
O inventário precisa separar o conteúdo principal do template. Um link no menu do cabeçalho aparece em todas as páginas e diz pouco ao Google sobre o destino. Um link no terceiro parágrafo de um artigo relevante diz muito. Bons motores removem nav, header, footer e aside antes da análise e inserem apenas no corpo do artigo. Eles também excluem URLs não indexáveis: tudo o que retorna um redirecionamento, um 404, um noindex ou uma canônica apontando para outro lugar.
Etapa 2: representar as páginas
Existem três representações comuns, da mais grosseira à mais fina:
Palavras-chave: cada página de destino tem uma lista de expressões («estratégia de linkagem interna», «estrutura de links»). Rápido e previsível, mas cego ao significado.
Entidades: uma biblioteca de processamento de linguagem natural extrai itens nomeados (produtos, lugares, conceitos) e os associa às páginas que tratam deles. Melhor para resolver ambiguidades.
Embeddings: um modelo de linguagem transforma cada página em um vetor de algumas centenas de números. Páginas sobre temas parecidos ficam próximas, mesmo sem palavras exatas em comum. É o que a maioria das ferramentas de linkagem «com IA» usa hoje.
Etapa 3: a correspondência
Com embeddings, a correspondência é uma similaridade de cosseno entre vetores, uma pontuação entre -1 e 1 (na prática de 0 a 1 para texto). Você mantém os pares acima de um limiar e os N melhores por página. O limiar é a configuração que mais importa: baixo demais e você liga uma página sobre a píton (a cobra) a uma página sobre Python (a linguagem); alto demais e você só encontra quase duplicatas. Comece em torno de 0,5 a 0,6 com um modelo genérico e ajuste depois de revisar 50 sugestões à mão.
Etapa 4: a escolha da âncora
A âncora deve ser uma expressão que já está na frase de origem. Inserir palavras novas significa reescrever o conteúdo, e isso é outro trabalho. O motor procura no texto de origem expressões que descrevam o destino: sua palavra-chave principal, seu H1, variantes próximas ou as consultas pelas quais o destino já aparece no Search Console. Essa última fonte é a melhor, porque mostra como pessoas reais descrevem a página.
Etapas 5 e 6: regras, inserção, registro
É nas regras que a qualidade se ganha ou se perde (veja a seção dedicada mais abaixo). A inserção acontece em um de três lugares: no conteúdo armazenado (o link passa a fazer parte do artigo, permanente e visível no editor), na renderização no servidor (um filtro adiciona os links quando a página é gerada, fácil de desfazer) ou no navegador com JavaScript (a opção mais fraca para SEO). Seja qual for o método, um registro de cada link automático não é opcional: sem ele, você não consegue auditar, medir nem desfazer.
Os 6 métodos de linkagem interna automatizada, comparados
«Linkagem interna automatizada» abrange técnicas muito diferentes. A maioria dos sites acaba combinando duas ou três.
1. Linkagem automática por regras de palavras-chave
Princípio: você mantém uma tabela «expressão leva a URL», e o sistema transforma a expressão em link onde quer que ela apareça. Quando usar: glossários, nomes de produtos, um pequeno grupo de páginas de negócio. Vantagens: previsível, transparente, barato. Limites: nenhuma compreensão do contexto, âncoras idênticas em todo lugar, a tabela fica desatualizada. Exemplo: cada primeira menção a «orçamento de rastreamento» aponta para a página do glossário sobre crawl budget, com no máximo um link por artigo.
2. Módulos estruturais e de template
Princípio: o CMS gera links a partir da estrutura do site: breadcrumbs, listas de categorias, «posts relacionados», anterior e próximo, páginas hub que listam as páginas filhas. Quando usar: sempre, é a camada de base. Vantagens: zero manutenção, garante que nenhuma página de uma categoria fique órfã. Limites: links de template trazem pouco contexto, e os módulos de «posts relacionados» costumam escolher por data ou tag em vez de significado. Exemplo: um breadcrumb «Blog > SEO > Linkagem interna» em cada artigo.
3. Sugestões semânticas com aprovação humana
Princípio: os embeddings encontram páginas relacionadas e âncoras candidatas; um editor aprova ou rejeita cada sugestão. Quando usar: sites de conteúdo de cerca de 50 até vários milhares de artigos. Vantagens: leva o contexto em conta, mantém uma pessoa no processo, as âncoras variam naturalmente. Limites: tempo de revisão, e a qualidade depende do limiar. Exemplo: quando um artigo sobre «canibalização de palavras-chave» é publicado, a ferramenta propõe cinco artigos mais antigos em que uma frase já menciona canibalização.
4. Linkagem baseada em entidades
Princípio: as entidades são extraídas de cada página e ligadas à página de referência dessa entidade no seu site. Quando usar: sites com muitos itens nomeados: marcas, lugares, pessoas, ingredientes, softwares. Vantagens: boa desambiguação, constrói um mapa limpo de «uma entidade, uma página». Limites: precisa de um mapa de entidade para página, mais fraco em temas abstratos. Exemplo: um site de viagens liga cada menção a «Kyoto» ao seu guia de Kyoto, e nunca à página de hotéis em Kyoto.
5. Linkagem guiada pelo grafo (PageRank interno)
Princípio: o site é tratado como um grafo. A ferramenta calcula uma pontuação interna para cada página (uma métrica parecida com o PageRank), sua profundidade de clique a partir da página inicial e seus links de entrada, e depois propõe links que enviam autoridade para as páginas prioritárias e aproximam as páginas profundas da superfície. Quando usar: sites grandes, e-commerce, qualquer site com páginas de negócio enterradas. Vantagens: otimiza um objetivo, não só a relevância. Limites: o modelo é uma aproximação de como o Google pondera os links, e uma lógica de grafo pura pode criar links irrelevantes se não for combinada com um filtro de relevância. Exemplo: uma página de categoria na profundidade 5 recebe links de três guias fortes que se posicionam em consultas relacionadas e sobe para a profundidade 2.
6. Linkagem no momento da escrita
Princípio: os links são colocados durante a redação, por um redator ou por uma ferramenta de escrita com IA que tem o inventário do site diante de si. Quando usar: qualquer site que publica com regularidade. Vantagens: o link faz parte de uma frase escrita para ele, então as âncoras soam naturais. Limites: cuida dos links de saída da nova página, não dos links de entrada vindos de páginas antigas, por isso precisa ser combinado com um método de linkagem retroativa. Exemplo: o gerador de artigos de blog com IA da Sorank escreve cada artigo com links internos já colocados para as suas páginas de serviços, produtos ou categorias.
Método
Relevância
Esforço de operação
Qualidade das âncoras
Risco se mal configurado
Melhor uso
Linkagem automática por regras de palavras-chave
Baixa
Baixo
Repetitivas
Alto (keyword stuffing)
Glossários, nomes de produtos
Módulos estruturais e de template
Média
Muito baixo
Genéricas
Baixo
Todo site, como camada de base
Sugestões semânticas com aprovação
Alta
Médio (revisão)
Naturais e variadas
Baixo
Blogs e hubs de conteúdo
Linkagem baseada em entidades
Alta em itens nomeados
Médio
Precisas
Médio
Viagens, e-commerce, catálogos
Guiada pelo grafo (PageRank interno)
Variável
Alto (análise)
Depende do filtro
Médio
Sites grandes, páginas de negócio enterradas
Linkagem na escrita
Alta
Baixo
As mais naturais
Baixo
Sites que publicam com frequência
A automação serve a uma arquitetura, não a substitui
Antes de configurar qualquer coisa, decida qual forma os links devem desenhar. Uma malha estilo Wikipédia liga qualquer página a qualquer página relacionada; é o resultado padrão das ferramentas semânticas e funciona bem para conteúdo enciclopédico. Um casulo semântico restringe os links às páginas da mesma árvore temática, com páginas mães apontando para baixo e páginas filhas apontando para cima e para os lados; suas regras devem proibir links entre casulos, exceto no topo. Um silo por URL segue a estrutura de pastas (/guides/seo/...); uma regra simples «linkar só dentro da mesma pasta, mais o hub» basta para aplicá-lo. Os clusters de tópicos, descritos no nosso guia sobre clusters de tópicos e páginas pilar, ficam entre o casulo e a malha. Nosso artigo sobre arquitetura de site para SEO ajuda você a escolher.
As regras que deixam os links automáticos seguros
Um motor de linkagem sem regras é um gerador de spam. Estas são as configurações a registrar por escrito antes da primeira execução, com valores que servem de ponto de partida.
Inserção totalmente automática ou sugerir e aprovar
Totalmente automática
Escala na hora para qualquer volume
Nenhum tempo editorial
Os erros são publicados em grande escala
Âncoras estranhas e contextos errados passam
Difícil explicar por que um link existe
Sugerir e aprovar
A máquina encontra, a pessoa decide
Cada link tem um responsável e um motivo
As regras melhoram com as sugestões rejeitadas
Dá para passar ao automático nas regras confiáveis
Exige tempo de revisão toda semana
Limites e densidade
Links automáticos por página: de 3 a 5 em um artigo de 1500 palavras, além dos links colocados pelo redator. O Google diz que não existe um número ideal, mas alerta contra o excesso de links; seus próprios dados vão ensinar mais do que qualquer regra de bolso.
Um link por destino por página. Linkar a mesma URL três vezes em um artigo não acrescenta nada ao leitor e confunde seus relatórios.
Distância mínima: pelo menos 50 a 80 palavras entre dois links automáticos, para que os parágrafos não fiquem azuis.
Máximo por expressão de âncora no site: limite quantas páginas podem usar exatamente a mesma âncora para o mesmo destino e, a partir daí, obrigue o uso de variantes.
Zonas proibidas
Nunca insira links em títulos, no sumário, em legendas de imagem, citações, botões de call to action, caixas de autor ou dentro de um <a> existente (links aninhados são HTML inválido). Nunca ligue uma página a ela mesma, a uma URL que redireciona ou a uma página com noindex ou canonicalizada para outra URL.
Regras de âncora
A documentação do Google pede um texto âncora «descritivo, razoavelmente conciso e relevante para a página em que está», e cita «clique aqui» e «leia mais» como genéricos demais. Traduza isso em regras: âncoras de 2 a 6 palavras, tiradas da frase existente, pelo menos duas ou três variantes distintas por destino no site e uma intenção por âncora. Se «ferramenta de linkagem interna» aponta para um analisador gratuito em uma página e para um recurso pago em outra, você está contando duas histórias aos buscadores. Nosso guia de texto âncora detalha os tipos de âncora.
Rastreie o site inteiro com um rastreador de desktop como o Screaming Frog (nosso guia de configuração do Screaming Frog explica os ajustes). Exporte, para cada URL indexável: links internos de entrada (únicos), profundidade de clique, links de saída e a pontuação de link interno do rastreador. Compare o rastreamento com o seu sitemap XML: URLs que estão no sitemap mas não foram encontradas pelo rastreamento são suas páginas órfãs. Salve essa exportação com data. É o seu «antes».
Etapa 2: listar as páginas que devem receber links
Nem toda página merece mais links. Monte uma lista curta de destinos prioritários: páginas que geram receita, páginas nas posições 5 a 20 para consultas valiosas (Search Console, relatório de Desempenho, filtro por posição) e seus conteúdos pilar. Inclua cada página órfã e cada página a mais de 3 cliques de profundidade. Essa lista alimenta os «priority_targets» das suas regras.
Etapa 3: montar o banco de âncoras
Para cada destino prioritário, reúna de 3 a 10 expressões de âncora. A melhor fonte é o Search Console: abra a página no relatório de Desempenho, vá para a aba Consultas e exporte as consultas para as quais ela já recebe impressões. Acrescente o H1, a palavra-chave principal e variantes naturais. Retire tudo o que for ambíguo ou compartilhado com outra página.
Etapa 4: gerar candidatos e filtrá-los
Rode sua ferramenta ou seu script. Para cada destino, ela deve devolver páginas de origem em que a âncora aparece no corpo e cujo tema é próximo o bastante. Espere que o funil se estreite bastante: é sinal de que os filtros funcionam.
Como os links candidatos são filtrados
Todos os pares de origem e destino do siteTodos os pares
Pares acima do limiar de similaridadeTop 20 por página
Pares em que existe uma âncora natural no textoÂncora encontrada
Pares que respeitam limites e zonas proibidasRegras respeitadas
Links aprovados e publicados3 a 5 por página
Etapa 5: revisar em lotes
Revise as sugestões em uma planilha com cinco colunas: origem, destino, âncora, frase, pontuação. Leia a frase, não só a âncora. Rejeite tudo o que você não teria escrito. Anote por que rejeita (sentido errado, promocional demais, já linkado ali perto): esses motivos viram regras novas.
Etapa 6: publicar em ondas, não tudo de uma vez
Publique de 50 a 200 links por onda, em um conjunto de páginas que você consiga acompanhar. Mantenha um grupo de controle com páginas parecidas sem links novos. Assim as mudanças nos cliques têm um ponto de referência, o que importa porque as posições mudam por muitos motivos.
Etapa 7: rastrear de novo e verificar o HTML renderizado
Rastreie o site de novo. Confirme que os novos links aparecem como <a href> no HTML bruto, e não apenas depois da execução do JavaScript. Para algumas URLs, use a ferramenta de inspeção de URL do Search Console e veja o HTML renderizado que o Google enxerga.
Etapa 8: ligar o sistema à publicação
O ganho real é contínuo. A cada artigo publicado, o sistema deve fazer duas coisas: colocar links a partir do novo artigo (na escrita) e propor links para ele a partir de páginas mais antigas (linkagem retroativa). A cada mudança de URL, deve atualizar ou remover os links que apontam para ela.
Dica
Para verificar uma página rapidamente, cole a URL no nosso analisador de links internos gratuito: ele lista cada link interno da página, sua âncora e seus atributos, para você confirmar que uma onda de links automáticos saiu como planejado.
Faça você mesmo: um script de linkagem interna semântica em Python
Se o seu CMS não tem uma boa ferramenta, ou se você quer entender exatamente o que um fornecedor faz, um protótipo funcional cabe em cerca de 60 linhas. Esta versão lê o sitemap, extrai o conteúdo principal, calcula embeddings com um modelo de código aberto e gera um CSV de sugestões para revisão humana. Ele nunca mexe no seu site.
import csv, re
from urllib.parse import urljoin
import requests
from bs4 import BeautifulSoup
from sentence_transformers import SentenceTransformer, util

SITEMAP = "https://example.com/sitemap.xml"
urls = re.findall(r"<loc>(.*?)</loc>", requests.get(SITEMAP, timeout=20).text)

pages = {}
for url in urls:
    r = requests.get(url, timeout=20)
    if r.status_code != 200 or r.url != url:
        continue  # ignorar erros e redirecionamentos
    soup = BeautifulSoup(r.text, "html.parser")
    robots = soup.find("meta", attrs={"name": "robots"})
    if robots and "noindex" in robots.get("content", ""):
        continue
    main = soup.find("article") or soup.find("main") or soup.body
    for tag in main.find_all(["nav", "header", "footer", "aside", "script", "style"]):
        tag.decompose()
    pages[url] = {
        "h1": soup.h1.get_text(" ", strip=True) if soup.h1 else "",
        "text": main.get_text(" ", strip=True),
        "links": {urljoin(url, a["href"]).split("#")[0] for a in main.find_all("a", href=True)},
    }
Embeddings, correspondência e busca de âncoras
model = SentenceTransformer("all-MiniLM-L6-v2")
keys = list(pages)
docs = [pages[u]["h1"] + ". " + pages[u]["text"][:2000] for u in keys]
emb = model.encode(docs, normalize_embeddings=True)
sim = util.cos_sim(emb, emb)

# Banco de âncoras: URL de destino -> expressões (H1 + consultas exportadas do Search Console)
anchors = {u: [pages[u]["h1"].lower()] for u in keys}
# anchors["https://example.com/crawl-budget"] += ["crawl budget", "crawl budget optimization"]

THRESHOLD, MAX_PER_PAGE = 0.55, 5

def find_anchor(text, phrases):
    for phrase in sorted(phrases, key=len, reverse=True):
        if len(phrase.split()) < 2:
            continue
        m = re.search(r"\b" + re.escape(phrase) + r"\b", text, re.IGNORECASE)
        if m:
            start = max(0, m.start() - 120)
            return m.group(0), text[start:m.end() + 120]
    return None, None

rows = []
for i, src in enumerate(keys):
    added = 0
    for j in sorted(range(len(keys)), key=lambda k: -float(sim[i][k])):
        score = float(sim[i][j])
        if score < THRESHOLD or added == MAX_PER_PAGE:
            break
        tgt = keys[j]
        if tgt == src or tgt in pages[src]["links"]:
            continue
        anchor, context = find_anchor(pages[src]["text"], anchors[tgt])
        if anchor:
            rows.append([src, tgt, anchor, round(score, 2), context])
            added += 1

with open("link_suggestions.csv", "w", newline="", encoding="utf-8") as f:
    csv.writer(f).writerows([["source", "target", "anchor", "score", "context"]] + rows)
Como deixá-lo pronto para produção
Poupe o servidor: adicione uma pausa entre as requisições e um User-Agent claro, ou leia o conteúdo direto do banco de dados ou da API do CMS em vez de rastrear.
Use um texto melhor para os embeddings: título mais H1 mais as primeiras 300 palavras costumam funcionar melhor que a página inteira, que dilui o tema.
Escale a correspondência: a matriz de similaridade cresce com o quadrado do número de páginas. Acima de 20000 páginas, use um índice de vizinhos mais próximos aproximado (FAISS, por exemplo) e compare cada página apenas com seus 50 vizinhos mais próximos.
Adicione prioridades: multiplique a pontuação por um bônus para destinos prioritários e por uma penalidade para destinos que já têm muitos links de entrada.
Respeite sua arquitetura: em um silo ou casulo, descarte os pares cujas URLs não compartilham a pasta ou a árvore temática permitida.
Insira no servidor: grave os links aprovados no conteúdo armazenado pela API do CMS, nunca por um script no navegador.
Encontrar menções sem link com um rastreador
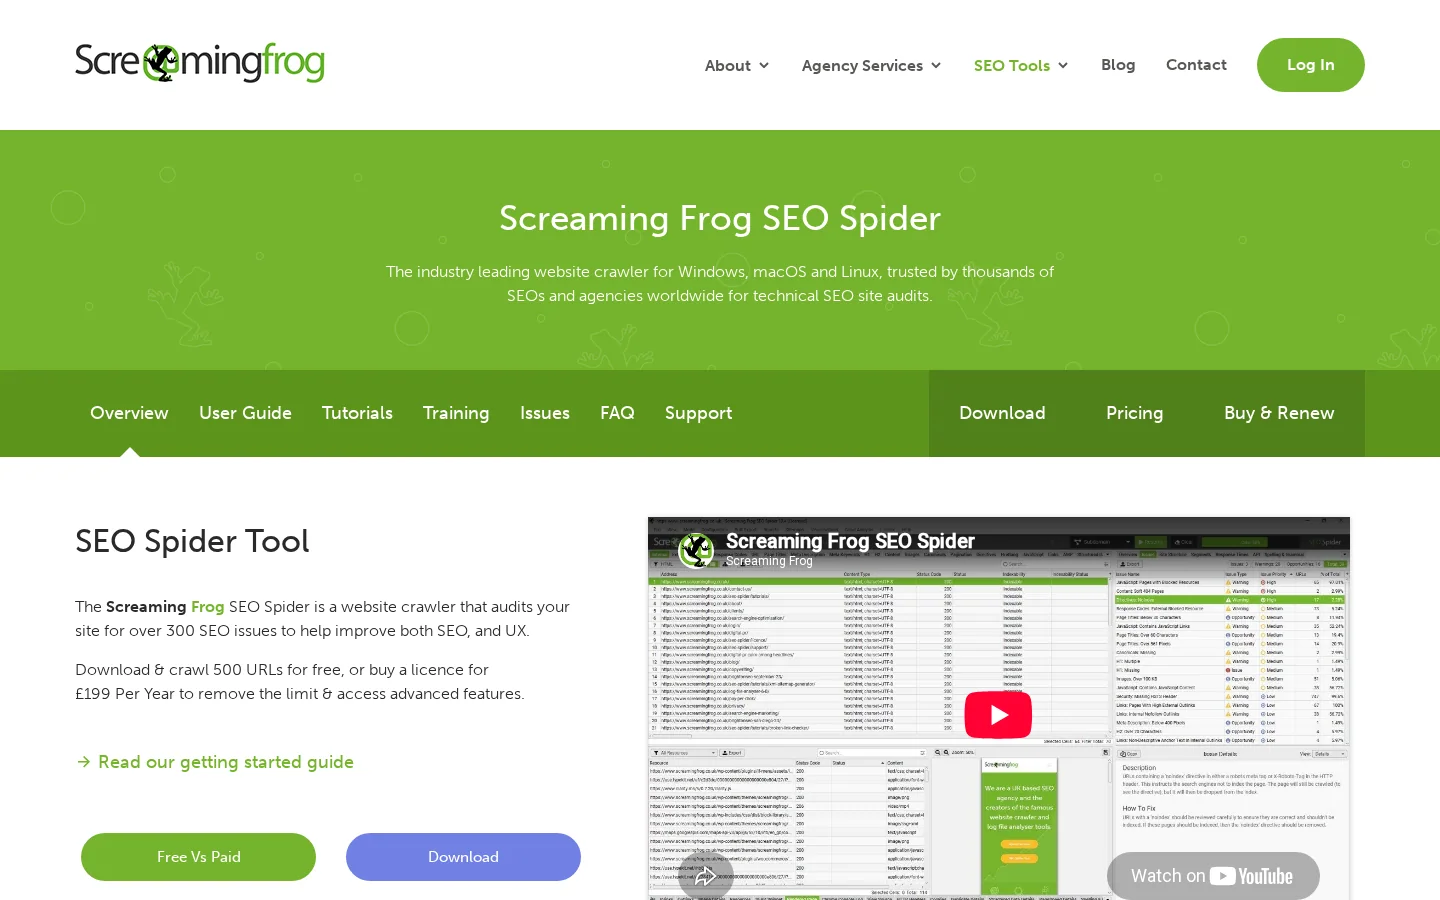
Sem escrever código, um rastreador pode fazer parte do trabalho. No Screaming Frog, o recurso Custom Search encontra cada página que contém uma expressão, e o Custom Extraction com XPath conta os links para um destino específico. As páginas que contêm a expressão mas não têm nenhum link para o destino são suas candidatas. O guia do usuário do SEO Spider também documenta o Link Score, «uma métrica de 0 a 100 que calcula o valor relativo de uma página com base em seus links internos», que exige rodar a crawl analysis depois do rastreamento.
Screaming Frog SEO Spider: rastreie seu site, exporte links internos e âncoras e encontre páginas que mencionam um tema sem linkar para ele.
Erros comuns na linkagem interna automatizada (e como corrigi-los)
A maioria dos problemas com linkagem automatizada não são penalidades. São links desperdiçados, sinais confusos e páginas que parecem escritas por uma máquina. Veja como identificar e corrigir cada um.
1. Linkar cada ocorrência de uma palavra-chave
O que é: um plugin de regras configurado sem limites linka «auditoria de SEO» em 400 páginas com a mesma âncora para a mesma página. Como identificar: na exportação de textos âncora do seu rastreador, ordene as âncoras internas por frequência; uma expressão usada centenas de vezes de forma idêntica para uma única URL é o sinal. Como corrigir: limite os usos por regra no site, exija pelo menos duas variantes por destino e remova os links das páginas em que o tema só é citado de passagem.
2. Linkar no sentido errado
O que é: a palavra bate, o significado não («maçã» a fruta ligada a um artigo sobre iPhone, «Java» a ilha ligada a um tutorial de programação). Como identificar: revise todo mês uma amostra aleatória de 30 links automáticos lendo a frase inteira. Como corrigir: aumente o limiar de similaridade, exija correspondência de expressão e de tema ao mesmo tempo e adicione palavras-chave negativas às regras ambíguas.
3. Links demais por parágrafo
O que é: o motor empilha quatro links em um parágrafo de 60 palavras. Os leitores param de clicar e o texto fica difícil de ler. Como identificar: calcule os links a cada 100 palavras de conteúdo principal; acima de 3 merece atenção. Como corrigir: defina uma distância mínima em palavras entre links automáticos e um limite por página que conte os links já colocados pelo redator.
4. Links em títulos, botões ou dentro de outros links
O que é: uma correspondência dentro de um H2, de um sumário ou de uma âncora existente é envolvida em um novo link, o que gera tags <a> aninhadas ou títulos azuis. Como identificar: passe algumas páginas por um validador de HTML, ou procure no rastreamento títulos que contenham links. Como corrigir: declare explicitamente os seletores proibidos e teste-os em uma cópia de staging antes de cada nova regra.
5. Links que só existem em JavaScript
O que é: um widget no navegador injeta links depois que a página carrega, às vezes sem href, às vezes só depois de uma rolagem ou um clique. Como identificar: compare o HTML bruto (código-fonte) com o DOM renderizado e confira o HTML renderizado na inspeção de URL do Search Console. Como corrigir: leve a inserção para o servidor ou para o conteúdo armazenado. Nosso guia de SEO para JavaScript explica a renderização em detalhes.
Atenção
Muitos rastreadores de IA não executam JavaScript de jeito nenhum. Um link que só aparece depois que os scripts rodam pode ficar visível para o Googlebot após a renderização, mas invisível para os bots que alimentam o ChatGPT, o Claude ou o Perplexity.
6. Linkar para redirecionamentos, páginas noindex e 404
O que é: links automáticos criados a partir de um inventário antigo continuam apontando para URLs que mudaram ou foram removidas. Como identificar: em um rastreamento, filtre os links internos por código de status (3xx, 4xx) e por destino não indexável; nosso verificador de links quebrados gratuito faz isso para uma página. Como corrigir: atualize o inventário antes de cada execução, aceite apenas destinos com status 200, indexáveis e com canônica própria, e atualize os links no lugar quando um 301 for criado.
7. Confiar só nos widgets de «posts relacionados»
O que é: o site acredita estar bem linkado porque cada artigo termina com três posts relacionados. Esses blocos costumam escolher por tag ou data, mudam o tempo todo e ignoram totalmente o conteúdo antigo. Como identificar: seu relatório de órfãs (URLs do sitemap não alcançadas pelo rastreamento, ou alcançadas só pela paginação) continua longo. Como corrigir: mantenha o widget, mas adicione links contextuais no corpo e links fixos a partir das páginas hub.
8. Fazer uma âncora apontar para duas páginas
O que é: «ferramenta de linkagem interna» aponta para a página A em alguns artigos e para a página B em outros. Você divide os sinais de relevância e pode alimentar a canibalização de palavras-chave. Como identificar: monte a partir do rastreamento um mapa de âncora para destino e sinalize qualquer âncora com mais de um destino. Como corrigir: uma intenção de busca, uma página de destino; reatribua as âncoras da página mais fraca.
9. Sem registro, sem volta
O que é: links foram inseridos no conteúdo por um plugin que depois foi desinstalado, ou ninguém sabe quais links são automáticos. Como identificar: você não consegue responder «quantos links a ferramenta adicionou no mês passado?». Como corrigir: guarde cada link automático em uma tabela (origem, destino, âncora, regra, data, status), marque-os no HTML com um atributo data se sua stack permitir e verifique se consegue remover todos os links de uma regra em uma única operação.
Erro
Sinal a procurar
Correção
Cada ocorrência linkada
Uma âncora usada centenas de vezes para uma URL
Limites no site todo, variantes de âncora
Sentido errado
Frases estranhas em uma amostra manual
Limiar mais alto, palavras-chave negativas
Densidade de links
Mais de 3 links a cada 100 palavras
Distância em palavras, limite por página
Zonas proibidas
Links em títulos, âncoras aninhadas
Seletores de exclusão explícitos
Links só em JavaScript
Links ausentes do código-fonte
Inserção no servidor
Destinos mortos
Links internos 3xx e 4xx no rastreamento
Inventário atualizado, só destinos com 200
Linkagem só por widget
Lista longa de órfãs
Links contextuais e a partir dos hubs
Uma âncora, dois destinos
Mapa de âncoras com duplicatas
Uma intenção, uma página
Sem registro
Impossível contar os links automáticos
Tabela de links, atributo data, reversão
Como medir o impacto dos links internos automáticos
Links internos raramente produzem um salto da noite para o dia. Meça nas páginas que receberam links, em comparação com o grupo de controle, ao longo de 4 a 12 semanas.
O que acompanhar depois de cada onda de links
Número de páginas órfãs (sitemap versus rastreamento)
Páginas a mais de 3 cliques da página inicial
Links internos de entrada únicos por página prioritária
Impressões e posição média das páginas de destino no Search Console
Cliques nas páginas de destino em comparação com o grupo de controle
Frequência de rastreamento das páginas de destino nos logs do servidor
Parcela de links automáticos rejeitados na revisão (qualidade das regras)
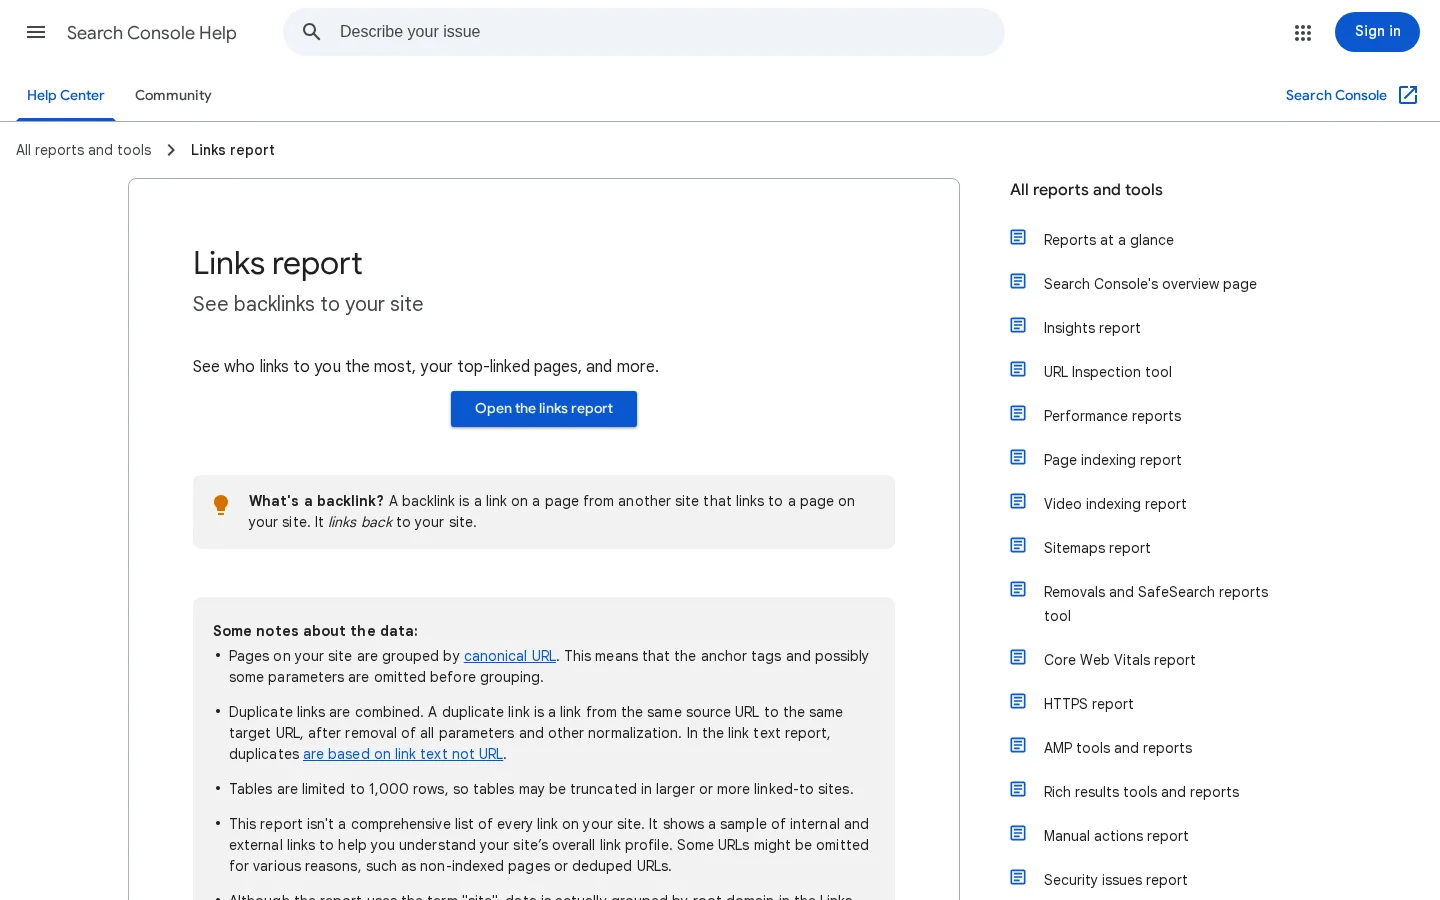
O relatório de Links do Search Console
O relatório de Links do Search Console mostra suas «páginas com mais links internos» e, para cada uma, as páginas que apontam para ela. Ele serve para uma checagem de coerência (suas páginas prioritárias estão no topo?), mas a página de ajuda do Google avisa que as tabelas são limitadas a 1000 linhas e que o relatório «não é uma lista completa de todos os links do seu site». Use o seu próprio rastreamento como fonte da verdade, e o Search Console para ver o que o Google realmente captou.
O relatório de Links do Search Console mostra suas páginas com mais links internos, com limite de 1000 linhas: use-o como checagem, não como fonte da verdade.
Logs do servidor
Se você tem acesso a eles, os logs do servidor mostram se o Googlebot e os rastreadores de IA visitam com mais frequência as páginas recém-linkadas depois de uma onda. É o sinal mais direto de que a descoberta melhorou. Nosso guia de análise de logs para SEO explica como filtrar os bots e ler a frequência de rastreamento, e por que isso importa para o crawl budget de sites grandes.
Ler os resultados com honestidade
Se as impressões sobem nas páginas de destino mas não no grupo de controle, os links provavelmente ajudaram. Se sobem nos dois, é provável que seja um efeito sazonal ou de algoritmo. Se as páginas de destino ganham impressões mas não cliques, a próxima alavanca é o título e o conteúdo, não mais links. E se nada se mexe depois de 12 semanas, confira o básico: os links estão no HTML bruto e os destinos estão de fato indexados?
Por onde começar hoje
Você não precisa de uma grande ferramenta para começar. Escolha um cluster de 20 a 50 páginas, rastreie, liste as órfãs e as páginas prioritárias, monte um banco de âncoras a partir do Search Console e adicione links em uma única onda revisada. Meça por seis semanas, transforme o que aprendeu em regras e passe para o próximo cluster.
Se você publica com frequência, o ganho mais barato é linkar na escrita: cada novo artigo deveria sair do editor com links para as páginas certas. É o que a Sorank faz quando escreve e publica artigos para você, e o seu gerador de clusters de tópicos planeja os clusters que esses links seguem, com proteção contra canibalização incluída. Para as páginas mais antigas, combine isso com uma linkagem retroativa revisada, seguindo o método acima.
Perguntas frequentes
A linkagem interna automatizada é segura para o SEO?
Sim, desde que os links sejam relevantes, usem âncoras descritivas e fiquem dentro de limites razoáveis. A documentação do Google pede links rastreáveis com texto âncora descritivo e alerta contra o excesso de links, não contra a automação em si. O risco vem das ferramentas que linkam cada ocorrência de uma palavra-chave com a mesma âncora, então mantenha uma etapa de revisão e registre cada link automático.
Quantos links internos um artigo deve ter?
O Google diz que não existe um número ideal. Um ponto de partida prático são 3 a 5 links contextuais automáticos em um artigo de 1500 palavras, além dos links colocados pelo redator, com um link por destino e alguma distância entre eles. Meça nas suas próprias páginas e ajuste: um estudo de correlação da Zyppy observou ganhos até cerca de 40 links internos de entrada por URL e uma inversão a partir de 45 a 50.
A linkagem interna automatizada substitui uma estratégia de linkagem interna?
Não. A automação executa uma estratégia: encontra candidatos, insere links e os mantém atualizados. Você ainda precisa decidir quais páginas priorizar, qual arquitetura os links devem seguir (malha, casulo semântico ou silo) e quais âncoras pertencem a cada página.
y!
Receba gratuitamente o seu plano de conteúdo para 30 dias
Analisamos seus concorrentes, seu site e sua visibilidade nas IA para criar, gratuitamente, um plano de conteúdo sob medida.
“Testei o Sorank no site real de um cliente e é uma loucura. Faz tudo aquilo que uma agência cobra 1.500 € por mês. Agora vai para produção nesse cliente.”Guillaume Guersanguersanguillaume.com
“Somos uma agência de publicidade e queríamos colocar nosso SEO nos trilhos de uma vez por todas. A Sorank nos deu uma visão clara do nosso site, ajudou-nos a priorizar as otimizações e estruturar corretamente nosso conteúdo. A ferramenta é fácil de usar, bem projetada para uma equipe e muito prática para centralizar o acompanhamento sem ter que fazer malabarismos entre várias plataformas. Uma base muito sólida para recomeçar do zero com nosso SEO.”Gaspard MadouiAgência de Publicidade
“Me especializei em GEO graças à Sorank. O GEO Leaderboard me permite mostrar aos meus clientes o seu posicionamento em relação aos concorrentes no ChatGPT. É um verdadeiro diferencial comercial.”MélanieFreelancer SEO
“Excelente serviço, funciona bem para o nosso site e nos ajuda a entender como melhorá-lo para nos posicionarmos melhor no Google e em outros lugares. Parabéns, continuem assim, eu recomendo.”Hugo T.Comerciante de e-commerce