환경 설정
개인정보 보호는 저희에게 중요합니다. 웹사이트의 기본 기능에 반드시 필요하지 않은 특정 유형의 저장소는 사용자가 직접 비활성화할 수 있습니다. 카테고리를 차단하면 웹사이트 이용 경험에 영향을 줄 수 있습니다. 더 보기
개인정보 보호는 저희에게 중요합니다. 웹사이트의 기본 기능에 반드시 필요하지 않은 특정 유형의 저장소는 사용자가 직접 비활성화할 수 있습니다. 카테고리를 차단하면 웹사이트 이용 경험에 영향을 줄 수 있습니다. 더 보기

자동 내부 링크의 작동 원리를 이해하고 6가지 방법을 비교하세요. 단계별로 설정하고, 자동 링크를 스팸으로 만드는 흔한 실수를 피하는 법을 알려드립니다.
도구

요약
자동 내부 링크란 내 사이트 페이지 사이의 링크를 하나하나 손으로 넣는 대신, 소프트웨어가 찾고 제안하고 삽입하게 하는 것입니다. 기계가 번거로운 일(크롤링, 주제 매칭, 고아 페이지 발견, 모든 링크 기록)을 맡고, 규칙(어떤 페이지를 밀어줄지, 어떤 앵커를 허용할지, 페이지당 링크를 몇 개까지 넣을지)은 사람이 통제할 때 잘 작동합니다. 보이는 키워드마다 링크를 거는 플러그인이 아니라 "제안, 승인, 게시, 측정"의 흐름으로 설정하세요.
더 알아보고 싶다면 물어보세요
간단 퀴즈
어떤 온라인 고객 확보 방식이 가장 맞습니까?
Sorank가 답변에 잘 맞습니다


귀사의 사이트에서 3일 동안 사용해 보시고 Google, ChatGPT 및 다른 AI에서 귀사의 현재 위치를 확인하십시오.
3일 무료 체험 시작3일 무료, 이후 언제든 해지할 수 있습니다. 90일 성과 보장, 조건 적용.
내부 링크는 내 사이트의 한 페이지에서 같은 사이트의 다른 페이지로 가는 링크입니다. 내부 링크에는 세 가지 역할이 있습니다. 크롤러가 페이지를 발견하게 하고, 앵커 텍스트와 주변 문장을 통해 검색엔진과 AI 시스템에 대상 페이지가 무엇에 관한 것인지 알려주며, 강한 페이지의 권위를 약한 페이지로 전달합니다. 기본 개념이 낯설다면 먼저 내부 링크 정의를 읽어 보세요.
자동화한다는 것은 프로그램이 다음 작업 중 하나 이상을 처리한다는 뜻입니다.
반대로, 같은 키워드 링크를 500개 페이지에 밀어 넣는 수단도, 사이트 구조를 대신하는 것도, 모든 글 하단의 "관련 글" 위젯도 아닙니다. 이런 것들은 자동화 시스템의 일부가 될 수는 있지만, 그것만으로는 대부분 잡음만 만듭니다.
수동 링크는 30페이지짜리 사이트에서는 문제없습니다. 하지만 매주 글을 발행하는 사이트에서는 단순한 이유로 무너집니다. 새 글 하나가 두 가지 일을 만들기 때문입니다. 새 글에서 기존 페이지로 링크를 걸어야 하고, 기존 페이지에서도 새 글로 링크를 걸어야 합니다. 모두가 잊는 건 두 번째 일입니다. 2년쯤 발행하고 나면, 아무도 링크하지 않는 최근 글과 이미 교체된 페이지를 여전히 가리키는 오래된 글이 남습니다.
자동화 전후의 내부 링크
이 글은 작동 방식, 즉 방법, 설정, 실제로 돌아가는 스크립트, 실패 유형에 집중합니다. 전략 측면(어떤 페이지를 우선할지, 다국어 사이트의 링크를 어떻게 설계할지)은 내부 링크 전략 전문가 가이드를 먼저 읽어 보세요. 두 글은 함께 쓰도록 만들었습니다.
최소 기준에 대해 Google은 분명하게 말합니다. 링크 권장사항 문서에 따르면 "중요한 모든 페이지는 사이트의 다른 페이지 중 적어도 하나에서 링크되어야" 하며, Google은 일반적으로 href 속성이 있는 <a> 요소인 링크만 크롤링할 수 있습니다. 고아 페이지가 금지된 것은 아니지만, 발견과 이해를 사이트맵 하나에만 맡기는 셈입니다.
최소 기준을 넘어서, 이 주제에 관한 가장 좋은 공개 데이터는 Zyppy의 Cyrus Shepard가 진행한 상관관계 연구 "23 Million Internal Links: SEO Case Study"(2026년 2월 업데이트)입니다. 약 1800개 웹사이트의 내부 링크 데이터를 Search Console 클릭 수와 대조했습니다.
2300만 개의 내부 링크가 보여주는 것
출처: Cyrus Shepard, Zyppy, 23 Million Internal Links SEO Case Study, 2026년 2월 업데이트
자동화에 가장 유용한 발견은 링크 수에 관한 것입니다. 내부 링크가 0~4개인 URL은 Google에서 평균 2회 클릭을 받은 반면, 40~44개인 URL은 그 4배를 받았습니다. 약 45~50개를 넘으면 효과가 반대로 돌아섭니다. 저자는 이 하락의 상당 부분을 사이트 전체 내비게이션 링크 탓으로 보며, 이 연구가 상관관계 연구라는 점, 즉 방향을 보여줄 뿐 증거는 아니라는 점을 분명히 합니다.
여기서 두 가지 실무 교훈이 나옵니다. 첫째, 링크가 부족한 페이지가 가장 많이 얻으며, 그런 페이지를 찾는 것은 자동화가 가장 잘하는 일입니다. 둘째, 연구에서는 앵커의 다양성이 클릭 수와 상관관계가 있었고, URL 앵커와 완전 일치 앵커가 있는 페이지의 성과가 더 좋았습니다. 모든 페이지를 같은 세 단어로 링크하는 시스템은 이 다양성을 버리는 셈입니다.
GPTBot, ClaudeBot, PerplexityBot 같은 AI 크롤러도 Googlebot과 같은 방식, 즉 <a href> 링크를 따라가며 페이지를 발견합니다. 이들 중 상당수는 JavaScript를 실행하지 않기 때문에, 클라이언트 측에서 삽입한 링크는 그들에게 존재하지 않을 수 있습니다. 각 봇이 무엇을 가져가는지는 AI 크롤러 가이드에서 설명합니다. 서버에서 렌더링된 깔끔한 내부 링크는 검색엔진과 내 페이지를 인용하는 AI 엔진 모두에 도움이 됩니다.
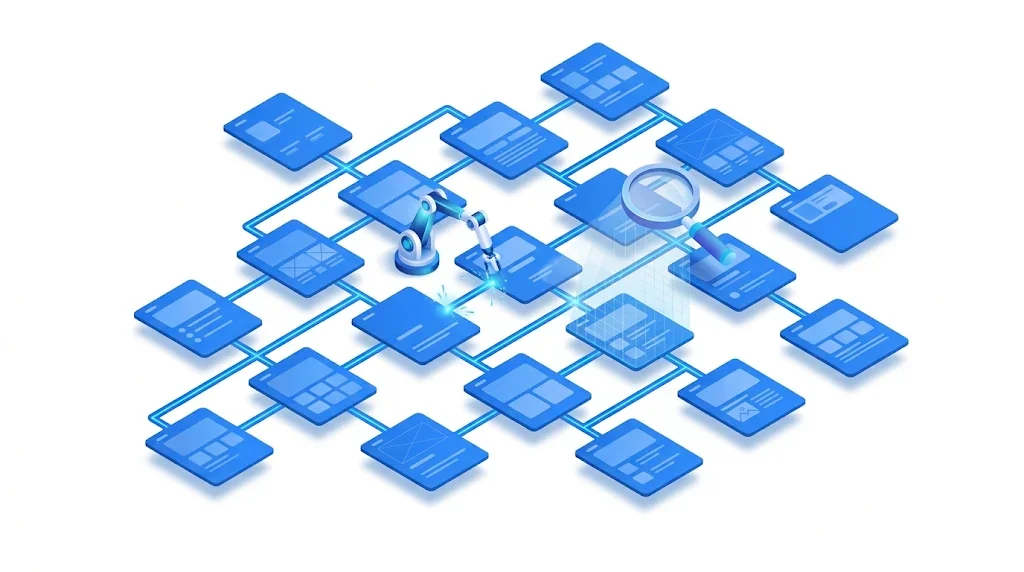
제대로 된 도구라면 플러그인이든 SaaS든 직접 만든 스크립트든 같은 파이프라인으로 돌아갑니다. 이를 알면 각 단계를 어떻게 처리하는지만 물어보고 5분 안에 도구를 판단할 수 있습니다.
내부 링크 엔진의 6단계 파이프라인
인벤토리는 본문과 템플릿을 구분해야 합니다. 헤더 메뉴의 링크는 모든 페이지에 나타나므로 대상 페이지에 대해 Google에 알려주는 것이 거의 없습니다. 반면 관련 글의 세 번째 문단에 있는 링크는 많은 것을 알려줍니다. 좋은 엔진은 분석 전에 nav, header, footer, aside를 제거하고 글 본문에만 삽입합니다. 또한 색인할 수 없는 URL, 즉 리디렉션, 404, noindex, 다른 곳을 가리키는 canonical을 반환하는 URL은 모두 제외합니다.
흔히 쓰는 표현 방식은 세 가지이며, 거친 것부터 정교한 것 순서로 보면 다음과 같습니다.
임베딩을 쓰면 매칭은 벡터 간 코사인 유사도로 계산하며, 점수는 -1에서 1 사이입니다(텍스트에서는 실제로 0에서 1). 임계값을 넘는 쌍과 페이지별 상위 N개를 남깁니다. 가장 중요한 설정은 임계값입니다. 너무 낮으면 비단뱀(Python)에 관한 페이지를 프로그래밍 언어 Python 페이지에 링크하게 되고, 너무 높으면 거의 중복된 페이지만 찾게 됩니다. 범용 모델이라면 0.5~0.6 정도에서 시작해, 제안 50개를 직접 검토한 뒤 조정하세요.
앵커는 출발 문장에 이미 있는 문구여야 합니다. 새 단어를 넣는다는 것은 본문을 고쳐 쓰는 것이고, 그건 다른 작업입니다. 엔진은 출발 페이지 본문에서 대상을 설명하는 문구를 찾습니다. 대상의 메인 키워드, H1, 가까운 변형, 또는 대상 페이지가 이미 Search Console에서 순위를 얻고 있는 검색어입니다. 마지막이 가장 좋은 출처입니다. 실제 사람들이 그 페이지를 어떻게 표현하는지 보여주기 때문입니다.
품질은 규칙에서 갈립니다(아래 전용 섹션 참고). 삽입은 세 곳 중 하나에서 일어납니다. 저장된 콘텐츠 안(링크가 글의 일부가 되어 영구적이고 편집기에서도 보임), 서버 렌더링 시점(페이지를 생성할 때 필터가 링크를 추가하며 되돌리기 쉬움), 또는 브라우저의 JavaScript(SEO에 가장 약한 선택)입니다. 어떤 방식이든 자동 링크 기록은 선택이 아닙니다. 기록이 없으면 감사도, 측정도, 되돌리기도 할 수 없습니다.
"자동 내부 링크"는 서로 매우 다른 기술을 아우릅니다. 대부분의 사이트는 결국 두세 가지를 조합해 씁니다.
원리: "문구와 대상 URL" 표를 관리하고, 시스템이 그 문구가 나오는 곳마다 링크를 겁니다. 언제 쓰나: 용어집, 제품명, 소수의 핵심 수익 페이지. 장점: 예측 가능하고 투명하며 저렴합니다. 한계: 맥락을 이해하지 못하고, 어디서나 같은 앵커가 쓰이며, 표가 금방 낡습니다. 예시: 글마다 "크롤 예산"이 처음 나오는 곳을 크롤 예산 용어집 페이지로 링크하되, 글당 1개로 제한합니다.
원리: CMS가 사이트 구조로부터 링크를 만듭니다. 이동 경로(breadcrumb), 카테고리 목록, "관련 글", 이전 글과 다음 글, 하위 페이지를 나열하는 허브 페이지 등입니다. 언제 쓰나: 항상. 기본 층입니다. 장점: 유지보수가 필요 없고, 카테고리 안의 페이지가 고아가 되지 않게 보장합니다. 한계: 템플릿 링크에는 맥락이 거의 없고, "관련 글" 모듈은 의미보다 날짜나 태그로 고르는 경우가 많습니다. 예시: 모든 글에 표시되는 이동 경로 "블로그 > SEO > 내부 링크".
원리: 임베딩으로 관련 페이지와 앵커 후보를 찾고, 편집자가 제안을 하나씩 승인하거나 거절합니다. 언제 쓰나: 글이 약 50개에서 수천 개인 콘텐츠 사이트. 장점: 맥락을 이해하고, 사람이 개입하며, 앵커가 자연스럽게 다양해집니다. 한계: 검토 시간이 들고, 품질은 임계값에 좌우됩니다. 예시: "키워드 카니발라이제이션" 글을 게시하면, 도구가 이미 카니발라이제이션을 언급하는 문장이 있는 기존 글 5개를 제안합니다.
원리: 모든 페이지에서 엔티티를 추출해, 내 사이트에서 그 엔티티의 기준이 되는 페이지로 링크합니다. 언제 쓰나: 브랜드, 장소, 인물, 재료, 소프트웨어처럼 고유한 대상이 많은 사이트. 장점: 중의성 해소가 잘 되고, "엔티티 하나에 페이지 하나"라는 깔끔한 지도가 생깁니다. 한계: 엔티티와 페이지의 대응표가 필요하고, 추상적인 주제에는 약합니다. 예시: 여행 사이트가 "교토"가 언급될 때마다 교토 가이드로 링크하고, 교토 호텔 페이지로는 절대 링크하지 않습니다.
원리: 사이트를 그래프로 다룹니다. 도구는 각 페이지의 내부 점수(PageRank와 비슷한 지표), 홈페이지로부터의 클릭 깊이, 들어오는 링크 수를 계산한 뒤, 우선 페이지로 권위를 보내고 깊은 페이지를 표면 가까이 끌어올리는 링크를 제안합니다. 언제 쓰나: 대규모 사이트, 이커머스, 비즈니스 페이지가 깊이 묻혀 있는 모든 사이트. 장점: 관련성만이 아니라 목표에 맞춰 최적화합니다. 한계: 이 모델은 Google이 링크를 평가하는 방식의 근사치일 뿐이며, 관련성 필터와 함께 쓰지 않으면 순수한 그래프 논리가 무관한 링크를 만들 수 있습니다. 예시: 클릭 깊이 5에 있던 카테고리 페이지가 관련 검색어에서 순위가 높은 강한 가이드 3개로부터 링크를 받아 깊이 2로 올라옵니다.
원리: 사이트 페이지 목록을 손에 쥔 작성자나 AI 글쓰기 도구가 콘텐츠를 쓰는 시점에 링크를 배치합니다. 언제 쓰나: 정기적으로 발행하는 모든 사이트. 장점: 링크가 그 링크를 위해 쓴 문장의 일부가 되므로 앵커가 자연스럽게 읽힙니다. 한계: 새 페이지에서 나가는 링크는 처리하지만 기존 페이지에서 들어오는 링크는 처리하지 않으므로, 백필 방법과 함께 써야 합니다. 예시: Sorank의 AI 블로그 글 생성기는 서비스, 제품, 카테고리 페이지로 가는 내부 링크를 이미 넣은 상태로 글을 씁니다.
| 방법 | 관련성 | 운영 부담 | 앵커 품질 | 설정 오류 시 위험 | 가장 잘 맞는 경우 |
|---|---|---|---|---|---|
| 규칙 기반 키워드 자동 링크 | 낮음 | 낮음 | 반복적 | 높음 (키워드 남용) | 용어집, 제품명 |
| 구조 및 템플릿 모듈 | 중간 | 매우 낮음 | 일반적 | 낮음 | 모든 사이트의 기본 층 |
| 승인 기반 시맨틱 제안 | 높음 | 중간 (검토) | 자연스럽고 다양함 | 낮음 | 블로그, 콘텐츠 허브 |
| 엔티티 기반 링크 | 고유 대상에서 높음 | 중간 | 정확함 | 중간 | 여행, 이커머스, 카탈로그 |
| 그래프 기반 (내부 PageRank) | 들쭉날쭉 | 높음 (분석) | 필터에 따라 다름 | 중간 | 대규모 사이트, 묻힌 수익 페이지 |
| 작성 시점 링크 | 높음 | 낮음 | 가장 자연스러움 | 낮음 | 자주 발행하는 사이트 |
무언가를 설정하기 전에 링크가 어떤 모양을 그릴지 먼저 정하세요. 위키백과식 메시는 어떤 페이지든 관련된 모든 페이지로 연결합니다. 시맨틱 도구의 기본 출력이며 백과사전형 콘텐츠에 잘 맞습니다. 시맨틱 코쿤은 같은 주제 트리 안의 페이지끼리만 링크하도록 제한하며, 상위 페이지는 아래로, 하위 페이지는 위와 옆으로 링크합니다. 규칙에서 최상위를 제외한 코쿤 간 링크를 금지해야 합니다. URL 사일로는 폴더 구조(/guides/seo/...)를 따릅니다. "같은 폴더 안과 허브 페이지로만 링크한다"는 단순한 규칙으로 구현할 수 있습니다. 토픽 클러스터와 필러 페이지 가이드에서 설명하는 토픽 클러스터는 코쿤과 메시의 중간에 있습니다. 어떤 것을 고를지는 SEO를 위한 사이트 구조 글에서 다룹니다.
규칙 없는 링크 엔진은 스팸 생성기입니다. 첫 실행 전에 적어 두어야 할 설정과, 출발점으로 쓸 수 있는 값을 소개합니다.
완전 자동 삽입 vs 제안 후 승인
제목, 목차, 이미지 캡션, 인용문, CTA 버튼, 저자 소개 상자, 기존 <a> 안(중첩 링크는 유효하지 않은 HTML)에는 절대 삽입하지 마세요. 페이지 자신, 리디렉션되는 URL, noindex 페이지나 다른 URL로 canonical이 지정된 페이지로도 링크하지 마세요.
Google 문서는 앵커 텍스트가 "설명적이고 적당히 간결하며 해당 페이지와 관련성이 있어야" 한다고 하며, "여기를 클릭"이나 "더 보기"를 너무 일반적인 예로 듭니다. 이를 규칙으로 옮기면 다음과 같습니다. 앵커는 2~6단어, 기존 문장에서 가져오고, 대상마다 사이트 전체에서 최소 두세 가지 변형을 두며, 앵커 하나에는 의도 하나만 대응시킵니다. "내부 링크 도구"가 어떤 글에서는 무료 분석기를, 다른 글에서는 유료 기능을 가리킨다면 검색엔진에 두 가지 다른 이야기를 하는 셈입니다. 앵커 유형은 앵커 텍스트 가이드에서 자세히 다룹니다.
설정 화면이 있는 플러그인을 쓰든 스크립트를 쓰든, 규칙은 파일로 적어 두세요. 그 파일이 문서가 되고 감사 기록이 됩니다.
{
  "global": {
    "max_auto_links_per_page": 5,
    "max_links_per_target_per_page": 1,
    "min_words_between_links": 60,
    "similarity_threshold": 0.55,
    "insert_only_in": ["article .content"],
    "skip_selectors": ["h1", "h2", "h3", "h4", "a", "figcaption", "blockquote", ".toc", ".cta", "nav", "footer"],
    "skip_targets_if": ["redirect", "noindex", "canonical_elsewhere", "status_not_200"],
    "mode": "suggest"
  },
  "priority_targets": [
    {"url": "/pricing", "boost": 1.5},
    {"url": "/guides/internal-linking-strategy", "boost": 1.3}
  ],
  "rules": [
    {"phrase": "crawl budget", "target": "/glossary/crawl-budget", "max_site_uses": 40, "mode": "auto"},
    {"phrase": "topic cluster", "target": "/glossary/topic-cluster", "max_site_uses": 40, "mode": "auto"}
  ],
  "never_link": ["/legal", "/login", "/cart"]
}
팁
새 규칙은 모두 "suggest" 모드로 시작하세요. 해당 규칙의 제안을 수정 없이 20개 연속으로 승인했을 때만 "auto"로 바꾸세요.
이 방법은 어떤 도구를 쓰든 적용됩니다. 수백 페이지 규모의 사이트라면 초기 설정에 하루, 이후에는 매주 한 시간 정도를 잡으세요.
Screaming Frog 같은 데스크톱 크롤러로 사이트 전체를 크롤링합니다(설정 방법은 Screaming Frog 설정 가이드에서 다룹니다). 색인 가능한 URL마다 들어오는 내부 링크 수(고유), 클릭 깊이, 나가는 링크, 크롤러의 내부 링크 점수를 내보냅니다. 크롤링 결과를 XML 사이트맵과 비교하세요. 사이트맵에는 있지만 크롤링으로 발견되지 않은 URL이 고아 페이지입니다. 이 내보내기 파일을 날짜와 함께 저장해 두세요. 이것이 "이전" 기록입니다.
모든 페이지가 더 많은 링크를 받을 가치가 있는 것은 아닙니다. 짧은 우선 대상 목록을 만드세요. 매출로 이어지는 페이지, 가치 있는 검색어에서 5~20위에 있는 페이지(Search Console 실적 보고서에서 게재순위로 필터링), 그리고 코너스톤 콘텐츠입니다. 여기에 모든 고아 페이지와 홈에서 3클릭보다 깊은 모든 페이지를 더합니다. 이 목록이 규칙의 "priority_targets"가 됩니다.
우선 대상마다 앵커 문구를 3~10개 모읍니다. 가장 좋은 출처는 Search Console입니다. 실적 보고서에서 해당 페이지를 열고 "검색어" 탭으로 전환한 뒤, 이미 노출이 발생한 검색어를 내보냅니다. H1, 메인 키워드, 자연스러운 변형도 추가합니다. 모호하거나 다른 페이지와 겹치는 문구는 뺍니다.
도구나 스크립트를 실행합니다. 대상마다 본문에 앵커가 등장하고 주제가 충분히 가까운 출발 페이지가 나와야 합니다. 깔때기가 크게 좁아질 것을 예상하세요. 필터가 제대로 작동한다는 신호입니다.
링크 후보가 걸러지는 과정
출발 페이지, 대상, 앵커, 문장, 점수의 다섯 열로 된 스프레드시트에서 제안을 검토합니다. 앵커만 보지 말고 문장 전체를 읽으세요. 내가 직접 썼다면 쓰지 않았을 것은 모두 거절합니다. 거절 이유(의미가 다름, 너무 홍보성, 근처에 이미 링크가 있음)를 적어 두면 그것이 새 규칙이 됩니다.
추적 가능한 페이지 묶음에 한 번에 50~200개 링크를 게시합니다. 새 링크를 넣지 않은 비슷한 페이지를 대조군으로 남겨 두세요. 순위는 여러 이유로 움직이므로, 클릭 변화에 비교 기준이 있어야 합니다.
사이트를 다시 크롤링합니다. 새 링크가 JavaScript 실행 후에만이 아니라 원본 HTML에 <a href>로 존재하는지 확인합니다. 몇몇 URL은 Search Console의 URL 검사 도구로 Google이 보는 렌더링된 HTML을 확인하세요.
진짜 효과는 지속적인 운영에서 나옵니다. 글이 게시될 때마다 시스템은 두 가지를 해야 합니다. 새 글에서 밖으로 링크하는 것(작성 시점)과, 기존 페이지에서 새 글로 들어오는 링크를 제안하는 것(백필)입니다. URL이 바뀔 때마다 그 URL을 가리키는 링크를 갱신하거나 제거해야 합니다.
팁
페이지 하나를 빠르게 확인하려면 URL을 무료 내부 링크 분석기에 붙여 넣으세요. 페이지의 모든 내부 링크와 앵커, 속성을 보여주므로 자동 링크가 계획대로 게시됐는지 확인할 수 있습니다.
CMS에 쓸 만한 도구가 없거나 업체가 정확히 무엇을 하는지 이해하고 싶다면, 작동하는 프로토타입은 60줄 정도면 됩니다. 이 버전은 사이트맵을 읽고, 본문을 추출하고, 오픈소스 모델로 임베딩을 계산한 뒤, 사람이 검토할 제안을 CSV로 출력합니다. 사이트는 전혀 건드리지 않습니다.
pip install requests beautifulsoup4 sentence-transformersimport csv, re
from urllib.parse import urljoin
import requests
from bs4 import BeautifulSoup
from sentence_transformers import SentenceTransformer, util
SITEMAP = "https://example.com/sitemap.xml"
urls = re.findall(r"<loc>(.*?)</loc>", requests.get(SITEMAP, timeout=20).text)
pages = {}
for url in urls:
r = requests.get(url, timeout=20)
if r.status_code != 200 or r.url != url:
continue # skip errors and redirects
soup = BeautifulSoup(r.text, "html.parser")
robots = soup.find("meta", attrs={"name": "robots"})
if robots and "noindex" in robots.get("content", ""):
continue
main = soup.find("article") or soup.find("main") or soup.body
for tag in main.find_all(["nav", "header", "footer", "aside", "script", "style"]):
tag.decompose()
pages[url] = {
"h1": soup.h1.get_text(" ", strip=True) if soup.h1 else "",
"text": main.get_text(" ", strip=True),
"links": {urljoin(url, a["href"]).split("#")[0] for a in main.find_all("a", href=True)},
}model = SentenceTransformer("all-MiniLM-L6-v2")
keys = list(pages)
docs = [pages[u]["h1"] + ". " + pages[u]["text"][:2000] for u in keys]
emb = model.encode(docs, normalize_embeddings=True)
sim = util.cos_sim(emb, emb)
# Anchor bank: target URL -> phrases (H1 + queries exported from Search Console)
anchors = {u: [pages[u]["h1"].lower()] for u in keys}
# anchors["https://example.com/crawl-budget"] += ["crawl budget", "crawl budget optimization"]
THRESHOLD, MAX_PER_PAGE = 0.55, 5
def find_anchor(text, phrases):
for phrase in sorted(phrases, key=len, reverse=True):
if len(phrase.split()) < 2:
continue
m = re.search(r"\b" + re.escape(phrase) + r"\b", text, re.IGNORECASE)
if m:
start = max(0, m.start() - 120)
return m.group(0), text[start:m.end() + 120]
return None, None
rows = []
for i, src in enumerate(keys):
added = 0
for j in sorted(range(len(keys)), key=lambda k: -float(sim[i][k])):
score = float(sim[i][j])
if score < THRESHOLD or added == MAX_PER_PAGE:
break
tgt = keys[j]
if tgt == src or tgt in pages[src]["links"]:
continue
anchor, context = find_anchor(pages[src]["text"], anchors[tgt])
if anchor:
rows.append([src, tgt, anchor, round(score, 2), context])
added += 1
with open("link_suggestions.csv", "w", newline="", encoding="utf-8") as f:
csv.writer(f).writerows([["source", "target", "anchor", "score", "context"]] + rows)코드를 쓰지 않아도 크롤러로 일부 작업을 할 수 있습니다. Screaming Frog에서 Custom Search 기능은 특정 문구가 들어간 모든 페이지를 찾고, XPath를 쓰는 Custom Extraction은 특정 대상으로 가는 링크 수를 셉니다. 문구는 있지만 대상으로 가는 링크가 0개인 페이지가 후보입니다. SEO Spider 사용자 가이드는 Link Score를 "내부 링크를 바탕으로 페이지의 상대적 가치를 계산하는 0에서 100 사이의 지표"로 설명하며, 크롤링 후 크롤 분석(crawl analysis)을 실행해야 합니다.
count(//article//a[contains(@href, "/guides/internal-linking-strategy")])
자동 링크의 문제는 대부분 페널티가 아닙니다. 낭비된 링크, 혼란스러운 신호, 기계가 쓴 것처럼 읽히는 페이지입니다. 각각을 찾아내고 고치는 방법을 정리했습니다.
무엇인가: 상한 없이 설정된 규칙 기반 플러그인이 400개 페이지에서 "SEO 감사"를 같은 앵커로 같은 페이지에 링크합니다. 찾는 법: 크롤러의 앵커 텍스트 내보내기에서 내부 앵커를 빈도순으로 정렬하세요. 한 문구가 수백 번 똑같이 한 URL을 가리키면 신호입니다. 고치는 법: 규칙마다 사이트 전체 사용 상한을 두고, 대상마다 최소 두 가지 변형을 요구하며, 주제를 지나가듯 언급만 하는 페이지에서는 링크를 뺍니다.
무엇인가: 단어는 맞는데 의미가 다릅니다(과일 "사과"가 iPhone 글로, 인도네시아의 "자바섬"이 Java 프로그래밍 튜토리얼로 링크됨). 찾는 법: 매달 자동 링크 30개를 무작위로 뽑아 문장 전체를 읽으세요. 고치는 법: 유사도 임계값을 올리고, 문구 일치와 주제 일치를 모두 요구하며, 모호한 규칙에는 제외 키워드를 추가합니다.
무엇인가: 엔진이 60단어 문단에 링크 네 개를 몰아넣습니다. 독자는 클릭을 멈추고 글은 읽기 어려워집니다. 찾는 법: 본문 100단어당 링크 수를 계산하세요. 3개를 넘으면 살펴볼 가치가 있습니다. 고치는 법: 자동 링크 사이의 최소 단어 간격과, 작성자가 넣은 링크까지 포함한 페이지당 상한을 설정합니다.
무엇인가: H2, 목차, 기존 앵커 안에서 일치한 문구에 새 링크가 씌워져 중첩된 <a> 태그나 파란 제목이 생깁니다. 찾는 법: 몇몇 페이지를 HTML 검사기에 돌리거나, 크롤링 결과에서 링크가 들어간 제목을 검색하세요. 고치는 법: 금지 선택자를 명시하고, 새 규칙을 적용할 때마다 스테이징 사본에서 먼저 테스트하세요.
무엇인가: 프런트엔드 위젯이 페이지 로드 후 링크를 삽입하며, 때로는 href가 없거나 스크롤이나 클릭 후에만 나타납니다. 찾는 법: 원본 HTML(페이지 소스 보기)과 렌더링된 DOM을 비교하고, Search Console의 URL 검사에서 렌더링된 HTML을 확인하세요. 고치는 법: 삽입을 서버나 저장된 콘텐츠로 옮기세요. 렌더링은 JavaScript SEO 가이드에서 자세히 설명합니다.
주의
많은 AI 크롤러는 JavaScript를 아예 실행하지 않습니다. 스크립트가 실행된 뒤에야 나타나는 링크는 렌더링 후의 Googlebot에게는 보일 수 있어도, ChatGPT, Claude, Perplexity에 데이터를 공급하는 봇에게는 보이지 않을 수 있습니다.
무엇인가: 오래된 인벤토리로 만든 자동 링크가 이미 옮겨졌거나 삭제된 URL을 계속 가리킵니다. 찾는 법: 크롤링 결과에서 내부 링크를 상태 코드(3xx, 4xx)와 색인 불가 대상으로 필터링하세요. 페이지 하나라면 무료 깨진 링크 검사기로 확인할 수 있습니다. 고치는 법: 실행할 때마다 인벤토리를 새로 고치고, 200을 반환하며 색인 가능하고 자기 자신을 canonical로 가진 대상만 받으며, 301을 만들 때 그 자리에서 링크를 갱신하세요.
무엇인가: 모든 글 끝에 관련 글 세 개가 있으니 링크가 충분하다고 믿습니다. 이런 블록은 대개 태그나 날짜로 고르고, 순환하며, 오래된 콘텐츠는 아예 건너뜁니다. 찾는 법: 고아 페이지 보고서(사이트맵에는 있지만 크롤링으로 도달하지 못하거나 페이지네이션으로만 도달하는 URL)가 계속 깁니다. 고치는 법: 위젯은 유지하되, 본문에 맥락 있는 링크를, 허브 페이지에서 고정 링크를 추가하세요.
무엇인가: "내부 링크 도구"가 어떤 글에서는 페이지 A로, 다른 글에서는 페이지 B로 링크됩니다. 관련성 신호가 분산되고 키워드 카니발라이제이션을 부추길 수 있습니다. 찾는 법: 크롤링 결과로 앵커와 대상의 대응표를 만들고, 대상이 둘 이상인 앵커를 표시하세요. 고치는 법: 검색 의도 하나에 대상 페이지 하나. 약한 페이지의 앵커를 다시 배정하세요.
무엇인가: 나중에 삭제된 플러그인이 콘텐츠에 링크를 넣었거나, 어떤 링크가 자동인지 아무도 모릅니다. 찾는 법: "지난달 도구가 링크를 몇 개 추가했나?"에 답할 수 없습니다. 고치는 법: 모든 자동 링크를 표(출발 페이지, 대상, 앵커, 규칙, 날짜, 상태)에 저장하고, 기술적으로 가능하면 HTML에 data 속성으로 표시하며, 규칙 하나가 만든 링크를 한 번에 모두 제거할 수 있는지 확인하세요.
| 실수 | 찾아야 할 신호 | 해결법 |
|---|---|---|
| 나올 때마다 링크 | 한 앵커가 수백 번 같은 URL을 가리킴 | 사이트 전체 상한, 앵커 변형 |
| 엉뚱한 의미 | 수동 샘플에서 어색한 문장 | 임계값 상향, 제외 키워드 |
| 링크 밀도 | 100단어당 링크 3개 초과 | 단어 간격, 페이지당 상한 |
| 금지 영역 | 제목 안의 링크, 중첩 앵커 | 명시적인 제외 선택자 |
| JavaScript 전용 링크 | 페이지 소스에 링크 없음 | 서버 측 삽입 |
| 죽은 대상 | 크롤링에서 3xx, 4xx 내부 링크 | 인벤토리 갱신, 200 대상만 |
| 위젯에만 의존 | 긴 고아 페이지 목록 | 맥락 링크와 허브 링크 |
| 앵커 하나에 대상 둘 | 앵커 대응표에 중복 | 의도 하나에 페이지 하나 |
| 기록 없음 | 자동 링크 수를 셀 수 없음 | 링크 표, data 속성, 롤백 |
내부 링크로 하룻밤 사이에 급등하는 일은 드뭅니다. 링크를 받은 페이지를 대조군과 비교하며 4~12주 동안 측정하세요.
링크를 게시할 때마다 추적할 항목
Search Console의 링크 보고서는 "내부 링크가 가장 많은 페이지"를 보여주고, 각 페이지로 링크하는 페이지도 확인할 수 있습니다. 우선 페이지가 상위에 있는지 같은 점검에는 유용하지만, Google 고객센터 페이지는 표가 1000행으로 제한되며 이 보고서가 "사이트의 모든 링크를 빠짐없이 담은 목록은 아니"라고 경고합니다. 기준 데이터로는 내 크롤링 결과를 쓰고, Search Console은 Google이 실제로 무엇을 수집했는지 보는 용도로 쓰세요.
서버 로그에 접근할 수 있다면, 링크를 게시한 뒤 Googlebot과 AI 크롤러가 새로 링크된 페이지를 더 자주 방문하는지 볼 수 있습니다. 발견이 개선됐다는 가장 직접적인 신호입니다. 봇을 걸러내고 크롤링 빈도를 읽는 방법, 그리고 대규모 사이트의 크롤 예산에 왜 중요한지는 SEO를 위한 로그 파일 분석 가이드에서 설명합니다.
대상 페이지의 노출이 늘고 대조군은 그대로라면 링크가 도움이 됐을 가능성이 큽니다. 둘 다 늘었다면 계절적 요인이나 알고리즘의 영향일 가능성이 높습니다. 대상 페이지의 노출은 늘었는데 클릭이 늘지 않는다면, 다음 수단은 링크 추가가 아니라 제목과 콘텐츠입니다. 12주가 지나도 아무 변화가 없다면 기본을 확인하세요. 링크가 원본 HTML에 있는지, 대상 페이지가 실제로 색인되어 있는지 말입니다.
시작하는 데 거창한 도구는 필요 없습니다. 20~50개 페이지로 된 클러스터 하나를 골라 크롤링하고, 고아 페이지와 우선 페이지를 정리하고, Search Console로 앵커 뱅크를 만든 뒤, 검토를 거친 링크를 한 번에 추가하세요. 6주 동안 측정하고, 배운 것을 규칙으로 적은 다음, 다음 클러스터로 넓혀 가세요.
자주 발행한다면 가장 저렴한 이득은 작성 시점 링크에서 나옵니다. 새 글은 모두 올바른 페이지로 가는 링크를 갖춘 채 편집기를 떠나야 합니다. Sorank가 글을 써서 게시할 때 하는 일이 바로 이것이며, 토픽 클러스터 생성기는 그 링크가 따르는 클러스터를 카니발라이제이션 방지 기능과 함께 설계합니다. 기존 페이지는 위에서 소개한 방법으로 검토를 거친 백필과 함께 운영하세요.
링크가 관련성 있고, 설명적인 앵커를 쓰며, 합리적인 상한 안에 있다면 안전합니다. Google 문서는 크롤링 가능한 링크와 설명적인 앵커 텍스트를 요구하고 과도한 링크를 경계하라고 할 뿐, 자동화 자체를 문제 삼지는 않습니다. 위험은 키워드가 나올 때마다 같은 앵커로 링크하는 도구에서 생기므로, 검토 단계를 유지하고 모든 자동 링크를 기록하세요.
Google은 이상적인 개수는 없다고 합니다. 실무적인 출발점은 1500단어 분량의 글에 작성자가 넣은 링크와 별도로 자동 맥락 링크 3~5개, 대상 하나당 링크 하나, 링크 사이에 일정한 간격을 두는 것입니다. 내 페이지에서 측정하며 조정하세요. Zyppy의 상관관계 연구에서는 URL당 내부 유입 링크가 약 40개까지 효과가 늘고, 약 45~50개를 넘으면 반대로 돌아섰습니다.
아니요. 자동화는 전략을 실행합니다. 후보를 찾고, 링크를 넣고, 최신 상태로 유지합니다. 어떤 페이지를 우선할지, 링크가 어떤 구조(메시, 시맨틱 코쿤, 사일로)를 따를지, 어떤 앵커가 어떤 페이지에 속하는지는 여전히 직접 정해야 합니다.
경쟁사, 웹사이트, AI 가시성을 분석해 맞춤 콘텐츠 계획을 무료로 만들어 드립니다.
 AI 콘텐츠 브리프 생성기
 FAQ 스키마 생성기
 AI 블로그 글 아이디어 생성기
 구조화 데이터 검사기(스키마 검사기)
 대체 텍스트 검사기
 내부 링크 분석기
 백링크 챌린지
 AI 메타 설명 생성기
 AI 블로그 제목 생성기
 Google 색인 가능성 검사기
 AI 글 개요 생성기
 UTM 링크 생성기
 키워드 클러스터링 도구
 canonical 태그 검사기
 XML 사이트맵 생성기
 깨진 링크 검사기
 AI SEO 제목 생성기
 제목 점수 분석기
 검색 결과 미리보기
 리디렉션 검사기
 hreflang 생성기
 제목 구조 분석기
 HTTP 헤더 검사기
 Favicon 추출기
 SEO 트래픽·매출 예측 계산기
 SEO 예산 계산기
 순위 상승 시뮬레이터
 키워드 기회 점수 계산기
 GEO 콘텐츠 투자 계산기
 고객 생애 가치 계산기
 CTR 계산기
 AI 트래픽 가치 계산기
 AI 점유율(SOV) 계산기
 Gemini 순위 도구
 ROAS 계산기
 오가닉 트래픽 가치 계산기
 로컬 SEO ROI 계산기
 링크 빌딩 비용 계산기
 키워드 밀도 계산기
 고객 획득 비용 계산기
 글 1편당 비용 계산기
 이탈률 계산기
 AI 인용률 계산기
 LLM용 구조화 데이터 진단
 llms.txt 생성기
 사이트맵 검사기
 SERP 변동성 센서
 단어 카운터
 Schema 마크업 생성기
 키워드 리서치 도구
 SEO 손익분기점 계산기
 읽기 시간 계산기
 오가닉 트래픽 추정기 및 웹사이트 트래픽 확인 도구
 ChatGPT 추천 트래픽 추정기
 AI 가시성 점수 계산기
 AI 가독성 검사기
 SearchGPT 준비도 검사기
 ChatGPT가 내 웹사이트를 추천하지 않는 이유
 URL 추출기
 웹페이지 Markdown 변환기
 robots.txt 생성기
 Open Graph 미리보기
 온페이지 SEO 점검: SEO 검사기 및 SEO 분석 도구
 LTV 대비 CAC 비율 계산기
 GEO ROI 계산기
 전환율 계산기
 AI 크롤러 접근 감사
 AI 검색 가시성 테스트
 페이지 용량 검사기
 URL 슬러그 생성기
 메타 태그 생성기
 이미지 압축기
 파비콘 생성기
 도메인 권위 검사기
 SERP CTR 계산기
 이커머스 SEO ROI 계산기
 콘텐츠 마케팅 ROI 계산기
 AI 비가시성 비용 계산기
 AI 개요 검사기 및 AI Overviews 순위 확인 도구
 robots.txt 검사기
 AI SEO 진단
 Perplexity 순위 검사기
 답변 엔진 최적화(AEO) 진단
 ChatGPT 가시성 체커
 백링크 분석 도구
 SEO 대 유료 검색 절감액 계산기
 SEO 점유율(SOV) 계산기
 SaaS SEO ROI 계산기
 백링크 ROI 계산기
 llms.txt 검증 도구
 LLM 인용 검사기
 GEO 진단
 SEO ROI 계산기
 키워드 가치 계산기
리뷰 5개, 평점 5/5
 “2년 동안 제 고객의 100%는 LinkedIn에서 왔습니다. 매일 게시물을 올리고, 댓글을 달고, DM으로 후속 연락을 하고… 알고리즘에 완전히 의존하는 방식이었습니다. SEO를 해야 한다는 것은 알았지만 늘 미뤘습니다. 시간이 오래 걸리고, 너무 기술적이며, 제 일이 아니라고 생각했기 때문입니다. Sorank와 함께 드디어 첫걸음을 내디뎠습니다. 4개월 만에 아무것도 게시하지 않고도 매달 15건의 오가닉 리드를 확보하고 있습니다. 아직 LinkedIn과 50 대 50은 아니지만, 자동 운영으로 성장하는 두 번째 리드 채널이 생겼다는 사실에 훨씬 마음이 놓입니다.”

 Valentin Thomyoffbound.fr“Sorank는 저희가 고객사에 제공하는 성과를 완전히 바꿔 놓았습니다. 이제 AI가 실제로 사용하는 키워드를 파악하고, 특정 경쟁사가 인용되는 이유를 이해하며, 이전에는 전혀 보지 못했던 기회를 발견합니다. 고객사는 더 빠른 순위 상승, AI 답변에서의 더 나은 가시성, 그리고 실행하는 모든 작업에 대한 더 명확한 ROI를 확인합니다.”
 Benjamin Rouxovirank.com
 “저는 마케터가 아니라 개발자입니다. 제 Shopify 테마는 입소문과 광고로만 팔리고 있었습니다. Sorank 덕분에 드디어 SEO를 어떻게 구조화하고 상위에 노출되는 글을 어떻게 써야 하는지 이해했습니다. 진단 결과 제품 페이지가 너무 느리다는 사실이 드러났습니다. 2개월 만에 오가닉 트래픽이 두 배가 되었고, 사람들이 Shopify 테마를 검색할 때 ChatGPT 답변에 등장하기 시작했습니다. 그 모든 것을 주당 약 2시간으로 해냈습니다.”
 Thème FullStackgo.themefullstack.com“Sorank는 저희 SEO 대행사의 운영 방식을 완전히 바꿔 놓았습니다. 모든 것이 한곳에 모이고 자동화되어 고객사마다 들이는 시간이 훨씬 줄었습니다. 예전에 몇 시간씩 걸리던 작업이 이제 몇 분이면 끝나고, 덕분에 드디어 사업 안에서 일하는 것을 멈추고 사업 위에서 일하기 시작할 수 있게 되었습니다.”
 Océane Bondismaison-leverage.com