Confidențialitatea contează pentru noi, așa că ai opțiunea de a dezactiva anumite tipuri de stocare care nu sunt necesare pentru funcționarea de bază a site-ului. Blocarea categoriilor poate afecta experiența ta pe site. Mai multe informații (Politica privind cookie-urile)
Mulțumim! Trimiterea ta a fost primită!
Ups! A apărut o eroare la trimiterea formularului.
Linkuire internă automată: metode, configurare și regulile care o fac sigură
Află cum funcționează linkuirea internă automată, compară 6 metode, configureaz-o pas cu pas și evită greșelile care transformă linkurile automate în spam.
O rețea de pagini conectate prin linkuri interne, unele plasate automat și verificate de un editor înainte de publicare.
Instrumente
Pe această pagină
Pe scurt
linkuirea internă automată înseamnă să lași un software să găsească, să propună sau să insereze linkurile dintre paginile site-ului tău, în loc să le plasezi pe fiecare manual. Funcționează bine când mașina face partea plictisitoare (crawling, potrivirea subiectelor, detectarea paginilor orfane, înregistrarea fiecărui link), iar tu păstrezi controlul asupra regulilor: ce pagini împingi, ce texte ancoră permiți, câte linkuri pe pagină. Configureaz-o ca un proces „propune, aprobă, publică, măsoară”, nu ca pe un plugin care pune link pe fiecare cuvânt cheie întâlnit.
3 zile gratuit, apoi renunți oricând vrei. Garanție de rezultate de 90 de zile, se aplică condiții.
Ce este linkuirea internă automată (și ce nu este)
Un link intern este un link de pe o pagină a site-ului tău către o altă pagină a aceluiași site. Are trei roluri: ajută crawlerele să descopere pagini, le spune motoarelor de căutare și sistemelor AI despre ce este pagina țintă (prin textul ancoră și cuvintele din jur) și transferă autoritate de la paginile puternice către cele mai slabe. Dacă noțiunile de bază sunt noi pentru tine, începe cu definiția linkuirii interne.
Automatizarea înseamnă că un program se ocupă de una sau mai multe dintre aceste sarcini:
Descoperire: crawling pe site, listarea fiecărei pagini, a fiecărui link existent și a fiecărei ancore.
Potrivire: decizia ce pagină trebuie să trimită link către care, pe baza cuvintelor cheie, a sensului sau a entităților.
Alegerea ancorei: găsirea unei expresii deja prezente în textul sursă, care descrie pagina țintă.
Inserare: scrierea linkului în HTML, în baza de date a CMS-ului sau în momentul randării.
Întreținere: repararea linkurilor când se schimbă un URL, se șterge o pagină sau apare un articol nou.
Ce nu este: o metodă de a îndesa același link pe cuvânt cheie în 500 de pagini, un înlocuitor pentru arhitectura site-ului sau un widget „articole similare” la finalul fiecărui articol. Acestea pot face parte dintr-un sistem automatizat, dar singure produc mai ales zgomot.
De ce linkuirea manuală cedează
Linkuirea manuală funcționează pe un site cu 30 de pagini. Eșuează pe un site care publică în fiecare săptămână, dintr-un motiv simplu: fiecare articol nou creează două sarcini. Are nevoie de linkuri către paginile existente, iar paginile mai vechi au nevoie de linkuri înapoi către el. A doua sarcină este cea pe care o uită toată lumea. După doi ani de publicare, ai articole recente către care nu trimite nimeni și articole vechi care încă trimit către pagini pe care le-ai înlocuit de mult.
Linkuirea internă înainte și după automatizare
Înainte (manual)
Articolele noi primesc linkuri de ieșire, rar linkuri de intrare
Paginile orfane se adună fără să le observe nimeni
Linkurile duc la redirecționări și URL-uri șterse
Ancorele depind de cine a scris articolul
După (automat, cu verificare)
Fiecare pagină nouă primește linkuri de la paginile înrudite
Paginile orfane sunt semnalate la fiecare crawl
Țintele stricate sau redirecționate sunt actualizate
Ancorele respectă reguli scrise și sunt înregistrate
Acest articol se concentrează pe mecanism: metode, setări, un script funcțional și tipurile de eșec. Pentru partea strategică (ce pagini prioritizezi, cum planifici linkurile pentru un site multilingv), citește mai întâi strategia noastră de linkuire internă la nivel de expert. Cele două texte sunt gândite să fie folosite împreună.
De ce contează: ce spun datele despre linkurile interne
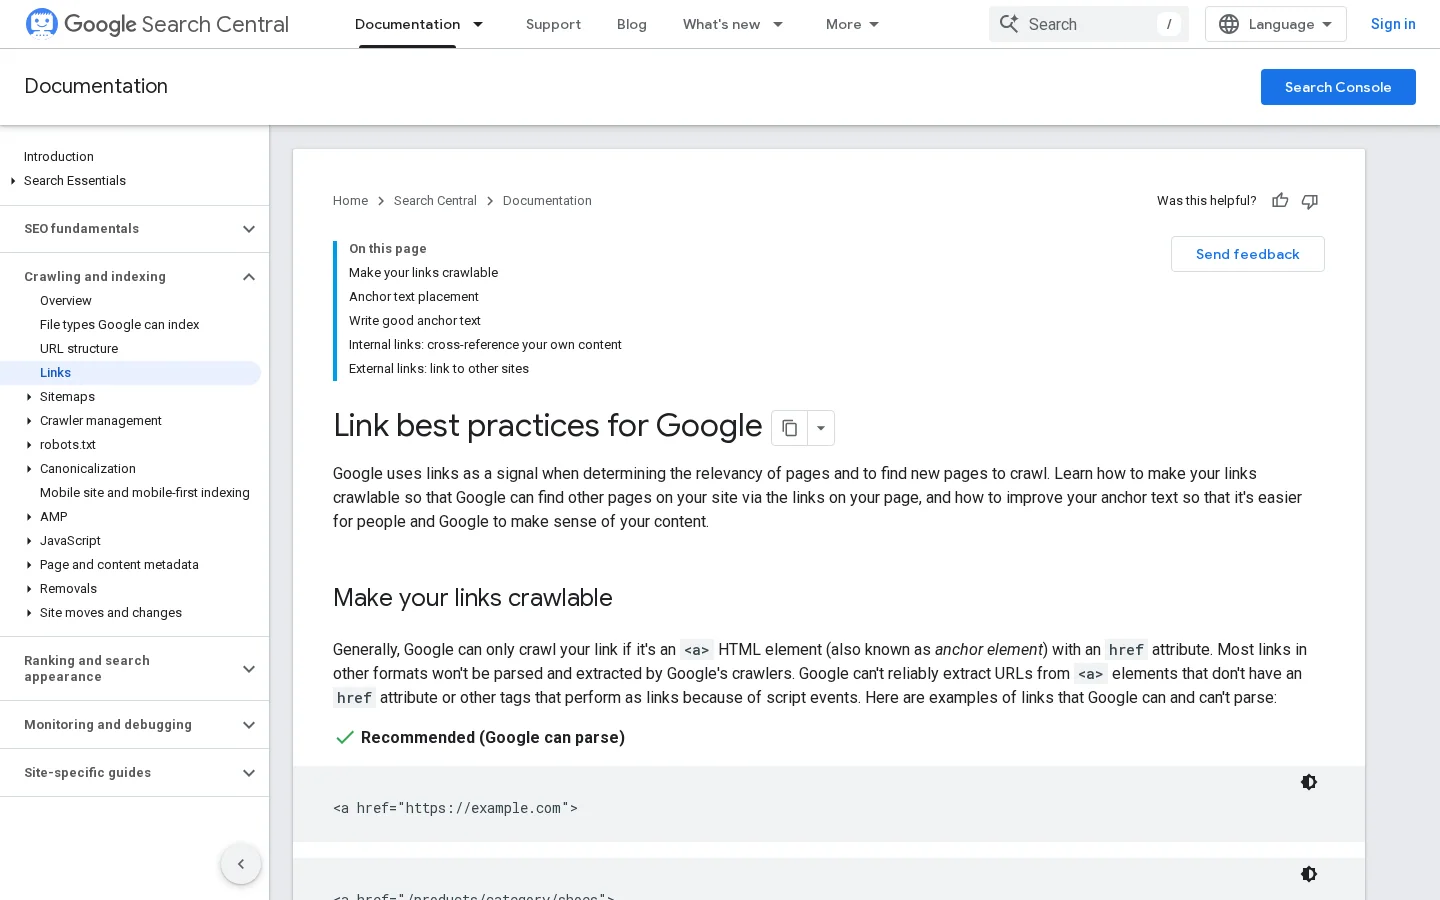
Google este explicit în privința minimului. Documentația sa despre bunele practici pentru linkuri spune că „fiecare pagină care contează pentru tine ar trebui să aibă un link de la cel puțin o altă pagină a site-ului” și că Google poate, în general, să acceseze cu crawlerul un link doar dacă este un element <a> cu atribut href. O pagină orfană nu este interzisă, dar atunci te bazezi doar pe sitemap ca să fie găsită și înțeleasă.
Dincolo de minim, cel mai bun set de date public pe acest subiect este studiul de corelație realizat de Cyrus Shepard la Zyppy, „23 Million Internal Links: SEO Case Study” (actualizat în februarie 2026). Studiul a pus în corespondență datele despre linkurile interne de pe aproximativ 1800 de site-uri cu clicurile din Search Console.
Ce dezvăluie 23 de milioane de linkuri interne
23 de milioanede linkuri interne analizate pe aproximativ 520000 de URL-uri
1800site-uri în setul de date, corelate cu clicurile din Google Search Console
5xtrafic de cel puțin cinci ori mai mare pentru paginile cu cel puțin o ancoră internă exact match
6%peste 6% din toate linkurile interne nu aveau deloc text ancoră
Sursă: Cyrus Shepard, Zyppy, 23 Million Internal Links SEO Case Study, actualizare din februarie 2026
Cea mai utilă constatare pentru automatizare privește volumul. URL-urile cu 0 până la 4 linkuri interne au primit în medie 2 clicuri de la Google, în timp ce URL-urile cu 40 până la 44 de linkuri interne au primit de patru ori mai multe. După aproximativ 45 până la 50 de linkuri, efectul se inversează. Autorul atribuie mare parte din această scădere linkurilor de navigare prezente pe tot site-ul și are grijă să numească studiul corelațional: util ca direcție, nu o dovadă.
Media clicurilor Google per URL în funcție de numărul de linkuri interne care trimit către el
0 până la 4 linkuri interne2 clicuri
40 până la 44 de linkuri interne8 clicuri (4x)
Sursă: Cyrus Shepard, Zyppy, 23 Million Internal Links SEO Case Study, actualizare din februarie 2026
De aici rezultă două lecții practice. Prima: paginile cărora le lipsesc linkurile câștigă cel mai mult, iar exact pe acestea le găsește cel mai bine automatizarea. A doua: studiul a constatat că diversitatea ancorelor se corelează cu clicurile și că paginile cu ancore de tip URL și ancore exact match au performat mai bine. Un sistem care pune link pe fiecare pagină cu aceleași trei cuvinte aruncă la gunoi această diversitate.
Perspectiva GEO
Crawlerele AI precum GPTBot, ClaudeBot și PerplexityBot descoperă paginile la fel ca Googlebot: urmând linkurile <a href>. Multe dintre ele nu execută JavaScript, așa că un link injectat pe partea de client poate pur și simplu să nu existe pentru ele. Ghidul nostru despre crawlerele AI explică ce preia fiecare bot. Linkurile interne curate, randate pe server, ajută atât motoarele de căutare, cât și motoarele AI care îți citează paginile.
Linkuirea internă automată: mașina găsește și plasează linkurile, omul stabilește regulile și verifică rezultatul.
Cum funcționează în culise un motor de linkuire internă automată
Orice instrument serios, fie el plugin, SaaS sau un script scris de tine, rulează același proces. Dacă îl cunoști, poți evalua un instrument în cinci minute: întreabă cum face fiecare pas.
Cei 6 pași ai unui motor de linkuire internă
InventarFă crawl sau citește CMS-ul pentru a lista fiecare pagină indexabilă, conținutul ei principal, titlul, H1 și linkurile de ieșire existente.
ReprezentareTransformă fiecare pagină în ceva comparabil: o listă de cuvinte cheie, un set de entități sau un vector de embedding.
PotrivireNotează relevanța fiecărei perechi sursă și țintă, apoi păstrează cei mai buni candidați pentru fiecare pagină.
Alegerea ancoreiGăsește o expresie care există deja în textul sursă și descrie ținta.
Aplicarea regulilorImpune limite, excluderi, priorități și zone interzise (titluri, linkuri existente, navigare).
Inserare și jurnalScrie linkul, salvează sursa, ținta, ancora, regula și data, apoi refă crawlul pentru verificare.
Pasul 1: inventarul și de ce contează „conținutul principal”
Inventarul trebuie să separe conținutul principal de șablon. Un link din meniul de sus apare pe fiecare pagină și îi spune Google prea puțin despre țintă. Un link din al treilea paragraf al unui articol relevant îi spune foarte mult. Motoarele bune elimină nav, header, footer și aside înainte de analiză și inserează linkuri doar în corpul articolului. Exclud și URL-urile neindexabile: tot ce returnează o redirecționare, un 404, un noindex sau un canonical către altă adresă.
Pasul 2: reprezentarea paginilor
Există trei reprezentări uzuale, de la grosieră la fină:
Cuvinte cheie: fiecare pagină țintă deține o listă de expresii („strategie de linkuire internă”, „structura linkurilor”). Rapid și previzibil, dar orb la sens.
Entități: o bibliotecă de procesare a limbajului natural extrage lucrurile numite (produse, locuri, concepte) și le asociază cu paginile care le tratează. Mai bună la dezambiguizare.
Embedding-uri: un model de limbaj transformă fiecare pagină într-un vector de câteva sute de numere. Paginile cu subiecte similare ajung aproape una de alta, chiar dacă nu au niciun cuvânt în comun. Aceasta este metoda folosită azi de majoritatea instrumentelor de linkuire „cu AI”.
Pasul 3: potrivirea
Cu embedding-uri, potrivirea este similaritatea cosinus dintre vectori, un scor între -1 și 1 (în practică între 0 și 1 pentru text). Păstrezi perechile peste un prag și primele N pentru fiecare pagină. Pragul este setarea care contează cel mai mult: prea mic și legi o pagină despre pitonul (șarpele) de o pagină despre limbajul Python; prea mare și găsești doar pagini aproape duplicate. Începe în jur de 0,5 până la 0,6 cu un model generalist, apoi ajustează după ce verifici manual 50 de sugestii.
Pasul 4: alegerea ancorei
Ancora ar trebui să fie o expresie deja prezentă în propoziția sursă. Inserarea de cuvinte noi înseamnă rescrierea conținutului, iar asta este altă treabă. Motorul caută în textul sursă expresii care descriu ținta: cuvântul cheie principal, H1, variante apropiate sau interogările pentru care ținta apare deja în Search Console. Această ultimă sursă este cea mai bună, pentru că reflectă felul în care oamenii reali descriu pagina.
Pașii 5 și 6: reguli, inserare, jurnal
Calitatea se câștigă sau se pierde în reguli (vezi secțiunea dedicată mai jos). Inserarea are loc într-unul din trei locuri: în conținutul stocat (linkul devine parte din articol, permanent și vizibil în editor), la randarea pe server (un filtru adaugă linkuri când pagina este generată, ușor de anulat) sau în browser, cu JavaScript (cea mai slabă opțiune pentru SEO). Indiferent de metodă, un jurnal al fiecărui link automat nu este opțional: fără el nu poți audita, măsura sau anula.
Cele 6 metode de linkuire internă automată, comparate
„Linkuirea internă automată” acoperă tehnici foarte diferite. Majoritatea site-urilor ajung să combine două sau trei dintre ele.
1. Autolinkuire pe cuvinte cheie, bazată pe reguli
Principiu: întreții un tabel „expresie duce la URL”, iar sistemul pune link pe expresie oriunde apare. Când o folosești: glosare, nume de produse, un set mic de pagini care aduc bani. Avantaje: previzibilă, transparentă, ieftină. Limite: nu înțelege contextul, aceleași ancore peste tot, tabelul se învechește. Exemplu: fiecare primă mențiune a „crawl budget” trimite către pagina de glosar despre crawl budget, cu o limită de un link pe articol.
2. Module structurale și de șablon
Principiu: CMS-ul generează linkuri din structura site-ului: breadcrumbs, liste de categorii, „articole similare”, anterior și următor, pagini hub care își listează paginile copil. Când o folosești: mereu, este stratul de bază. Avantaje: zero întreținere, garantează că nicio pagină dintr-o categorie nu rămâne orfană. Limite: linkurile din șablon au puțin context, iar modulele „articole similare” aleg adesea după dată sau etichetă, nu după sens. Exemplu: un breadcrumb „Blog > SEO > Linkuire internă” pe fiecare articol.
3. Sugestii semantice cu aprobare umană
Principiu: embedding-urile găsesc pagini înrudite și ancore candidate; un editor aprobă sau respinge fiecare sugestie. Când o folosești: site-uri de conținut de la aproximativ 50 la câteva mii de articole. Avantaje: ține cont de context, omul rămâne în proces, ancorele variază natural. Limite: timp de verificare, iar calitatea depinde de prag. Exemplu: când apare un articol despre „canibalizarea cuvintelor cheie”, instrumentul propune cinci articole mai vechi în care o propoziție menționează deja canibalizarea.
4. Linkuire pe bază de entități
Principiu: entitățile sunt extrase din fiecare pagină și legate de pagina care este referința pentru acea entitate pe site-ul tău. Când o folosești: site-uri cu multe lucruri numite: mărci, locuri, persoane, ingrediente, software. Avantaje: dezambiguizare bună, construiește o hartă curată „o entitate, o pagină”. Limite: necesită o hartă entitate către pagină, mai slabă pe subiecte abstracte. Exemplu: un site de călătorii trimite fiecare mențiune a „Kyoto” către ghidul despre Kyoto, niciodată către pagina cu hoteluri din Kyoto.
5. Linkuire ghidată de graf (PageRank intern)
Principiu: site-ul este tratat ca un graf. Instrumentul calculează pentru fiecare pagină un scor intern (o metrică asemănătoare PageRank), adâncimea în clicuri de la pagina principală și linkurile primite, apoi propune linkuri care trimit autoritate către paginile prioritare și aduc paginile adânci mai aproape de suprafață. Când o folosești: site-uri mari, ecommerce, orice site în care paginile de business sunt îngropate. Avantaje: optimizează pentru un obiectiv, nu doar pentru relevanță. Limite: modelul este doar o aproximare a modului în care Google cântărește linkurile, iar logica pură de graf poate crea linkuri irelevante dacă nu este combinată cu un filtru de relevanță. Exemplu: o pagină de categorie aflată la adâncimea 5 primește linkuri de la trei ghiduri puternice care se clasează pe interogări înrudite și urcă la adâncimea 2.
6. Linkuire în momentul scrierii
Principiu: linkurile sunt plasate în timp ce conținutul este redactat, de un autor sau de un instrument de scriere AI care are inventarul site-ului în față. Când o folosești: orice site care publică regulat. Avantaje: linkul face parte dintr-o propoziție scrisă pentru el, așa că ancorele sună natural. Limite: rezolvă linkurile care pleacă din pagina nouă, nu și linkurile către ea din paginile vechi, așa că trebuie combinată cu o metodă de completare retroactivă. Exemplu:generatorul de articole de blog cu AI de la Sorank scrie fiecare articol cu linkurile interne către paginile tale de servicii, produse sau categorii deja la locul lor.
Metodă
Relevanță
Efort de rulare
Calitatea ancorelor
Risc la configurare greșită
Potrivită pentru
Autolinkuire pe cuvinte cheie, bazată pe reguli
Scăzută
Scăzut
Repetitive
Ridicat (keyword stuffing)
Glosare, nume de produse
Module structurale și de șablon
Medie
Foarte scăzut
Generice
Scăzut
Orice site, ca strat de bază
Sugestii semantice cu aprobare
Ridicată
Mediu (verificare)
Naturale și variate
Scăzut
Bloguri și huburi de conținut
Linkuire pe bază de entități
Ridicată pentru lucruri numite
Mediu
Precise
Mediu
Turism, ecommerce, cataloage
Ghidată de graf (PageRank intern)
Variabilă
Ridicat (analiză)
Depinde de filtru
Mediu
Site-uri mari, pagini de bani îngropate
Linkuire în momentul scrierii
Ridicată
Scăzut
Cele mai naturale
Scăzut
Site-uri care publică des
Automatizarea servește o arhitectură, nu o înlocuiește
Înainte să configurezi ceva, decide ce formă vrei să deseneze linkurile. O rețea în stil Wikipedia leagă orice pagină de orice pagină înrudită; este rezultatul implicit al instrumentelor semantice și funcționează bine pentru conținut enciclopedic. Un cocon semantic limitează linkurile la paginile din același arbore tematic: paginile mamă trimit în jos, iar paginile fiică în sus și lateral; regulile tale trebuie să interzică linkurile între coconi, cu excepția vârfului. Un silo de URL-uri urmează structura folderelor (/guides/seo/...); o regulă simplă „pune linkuri doar în același folder, plus hub-ul” îl impune. Clusterele tematice, descrise în ghidul nostru despre clustere tematice și pagini pilon, se situează între cocon și rețea. Articolul nostru despre arhitectura site-ului pentru SEO te ajută să alegi.
Regulile care fac linkurile automate sigure
Un motor de linkuire fără reguli este un generator de spam. Acestea sunt setările de scris înainte de prima rulare, cu valori care funcționează ca punct de plecare.
Inserare complet automată vs propune și aprobă
Complet automat
Se scalează instant la orice volum
Fără timp editorial
Erorile se publică la scară
Ancorele ciudate și contextele greșite trec neobservate
Greu de explicat de ce există un link
Propune și aprobă
Mașina găsește, omul decide
Fiecare link are un responsabil și un motiv
Regulile se îmbunătățesc din sugestiile respinse
Poți trece pe automat pentru regulile de încredere
Necesită timp de verificare în fiecare săptămână
Limite și densitate
Linkuri automate pe pagină: 3 până la 5 într-un articol de 1500 de cuvinte, pe lângă linkurile puse de autor. Google spune că nu există un număr ideal, dar avertizează împotriva linkuirii excesive; propriile tale date îți vor spune mai mult decât orice regulă empirică.
Un singur link către o țintă pe pagină. A pune de trei ori link către același URL într-un articol nu aduce nimic cititorilor și îți încurcă rapoartele.
Distanță minimă: cel puțin 50 până la 80 de cuvinte între două linkuri automate, ca paragrafele să nu devină albastre.
Maximum per expresie ancoră pe tot site-ul: limitează câte pagini pot folosi exact aceeași ancoră pentru aceeași țintă, apoi impune variante.
Zone interzise
Nu insera niciodată linkuri în titluri, cuprins, legende de imagini, citate, butoane de apel la acțiune, casete de autor sau în interiorul unui <a> existent (linkurile imbricate sunt HTML invalid). Nu pune niciodată link de pe o pagină către ea însăși, către un URL care redirecționează sau către o pagină cu noindex ori cu canonical către alt URL.
Reguli pentru ancore
Documentația Google cere un text ancoră „descriptiv, rezonabil de concis și relevant pentru pagina pe care se află” și dă „click aici” și „citește mai mult” ca exemple prea generice. Transformă asta în reguli: ancore de 2 până la 6 cuvinte, preluate din propoziția existentă, cel puțin două sau trei variante diferite per țintă pe tot site-ul și o singură intenție per ancoră. Dacă „instrument de linkuire internă” trimite pe o pagină către un analizor gratuit și pe alta către o funcție plătită, le spui motoarelor de căutare două povești diferite. Ghidul nostru despre textul ancoră prezintă în detaliu tipurile de ancore.
Fă crawl pe tot site-ul cu un crawler desktop precum Screaming Frog (ghidul nostru de configurare Screaming Frog te trece prin setări). Exportă, pentru fiecare URL indexabil: linkurile interne primite (unice), adâncimea în clicuri, linkurile de ieșire și scorul de linkuri interne al crawlerului. Compară crawlul cu sitemap-ul XML: URL-urile prezente în sitemap, dar negăsite de crawl, sunt paginile tale orfane. Salvează acest export cu dată. Este situația ta „înainte”.
Pasul 2: listează paginile care trebuie să primească linkuri
Nu orice pagină merită mai multe linkuri. Fă o listă scurtă de ținte prioritare: paginile care aduc bani, paginile aflate pe pozițiile 5 până la 20 pentru interogări valoroase (Search Console, raportul Performanță, filtru după poziție) și conținutul tău pilon (cornerstone content). Adaugă fiecare pagină orfană și fiecare pagină aflată la mai mult de 3 clicuri adâncime. Această listă alimentează „priority_targets” din regulile tale.
Pasul 3: construiește banca de ancore
Pentru fiecare țintă prioritară, adună între 3 și 10 expresii ancoră. Cea mai bună sursă este Search Console: deschide pagina în raportul Performanță, treci la fila Interogări și exportă interogările pentru care pagina are deja afișări. Adaugă H1, cuvântul cheie principal și variantele naturale. Elimină tot ce este ambiguu sau împărțit cu altă pagină.
Pasul 4: generează candidați și filtrează-i
Rulează instrumentul sau scriptul. Pentru fiecare țintă, ar trebui să returneze paginile sursă în care ancora apare în corpul textului și subiectul este suficient de apropiat. Așteaptă-te ca pâlnia să se îngusteze puternic: este semn că filtrele funcționează.
Cum sunt filtrați candidații pentru linkuri
Fiecare pereche sursă și țintă de pe siteToate perechile
Perechi peste pragul de similaritateTop 20 pe pagină
Perechi în care există o ancoră naturală în textAncoră găsită
Perechi care trec de limite și zonele interziseReguli respectate
Linkuri aprobate și publicate3 până la 5 pe pagină
Pasul 5: verifică în loturi
Verifică sugestiile într-un tabel cu cinci coloane: sursă, țintă, ancoră, propoziție, scor. Citește propoziția, nu doar ancora. Respinge tot ce nu ai fi scris tu însuți. Notează de ce respingi (sens greșit, prea promoțional, deja are link în apropiere): aceste motive devin reguli noi.
Pasul 6: publică în valuri, nu dintr-odată
Publică între 50 și 200 de linkuri pe val, pe un set de pagini pe care îl poți urmări. Păstrează un grup de control cu pagini similare fără linkuri noi. Astfel, schimbările în clicuri au un punct de referință, ceea ce contează, pentru că pozițiile se mișcă din multe motive.
Pasul 7: refă crawlul și verifică HTML-ul randat
Refă crawlul pe site. Verifică dacă linkurile noi apar ca <a href> în HTML-ul brut, nu doar după rularea JavaScript. Pentru câteva URL-uri, folosește instrumentul de inspectare a adreselor URL din Search Console și uită-te la HTML-ul randat pe care îl vede Google.
Pasul 8: conectează-l la publicare
Câștigul real este continuu. De fiecare dată când se publică un articol, sistemul ar trebui să facă două lucruri: să pună linkuri din articolul nou (în momentul scrierii) și să propună linkuri către el din paginile vechi (completare retroactivă). De fiecare dată când se schimbă un URL, ar trebui să actualizeze sau să elimine linkurile care duc la el.
Sfat
Pentru a verifica rapid o pagină, lipește URL-ul ei în analizorul nostru gratuit de linkuri interne: listează fiecare link intern de pe pagină, ancora și atributele lui, ca să confirmi că un val de linkuri automate a plecat conform planului.
Construiește-ți propriul instrument: un script de linkuire internă semantică în Python
Dacă CMS-ul tău nu are un instrument bun sau vrei să înțelegi exact ce face un furnizor, un prototip funcțional are aproximativ 60 de linii. Această versiune citește sitemap-ul, extrage conținutul principal, calculează embedding-uri cu un model open source și generează un CSV cu sugestii pentru verificare umană. Nu atinge niciodată site-ul tău.
import csv, re
from urllib.parse import urljoin
import requests
from bs4 import BeautifulSoup
from sentence_transformers import SentenceTransformer, util

SITEMAP = "https://example.com/sitemap.xml"
urls = re.findall(r"<loc>(.*?)</loc>", requests.get(SITEMAP, timeout=20).text)

pages = {}
for url in urls:
    r = requests.get(url, timeout=20)
    if r.status_code != 200 or r.url != url:
        continue  # skip errors and redirects
    soup = BeautifulSoup(r.text, "html.parser")
    robots = soup.find("meta", attrs={"name": "robots"})
    if robots and "noindex" in robots.get("content", ""):
        continue
    main = soup.find("article") or soup.find("main") or soup.body
    for tag in main.find_all(["nav", "header", "footer", "aside", "script", "style"]):
        tag.decompose()
    pages[url] = {
        "h1": soup.h1.get_text(" ", strip=True) if soup.h1 else "",
        "text": main.get_text(" ", strip=True),
        "links": {urljoin(url, a["href"]).split("#")[0] for a in main.find_all("a", href=True)},
    }
Embedding, potrivire și găsirea ancorelor
model = SentenceTransformer("all-MiniLM-L6-v2")
keys = list(pages)
docs = [pages[u]["h1"] + ". " + pages[u]["text"][:2000] for u in keys]
emb = model.encode(docs, normalize_embeddings=True)
sim = util.cos_sim(emb, emb)

# Anchor bank: target URL -> phrases (H1 + queries exported from Search Console)
anchors = {u: [pages[u]["h1"].lower()] for u in keys}
# anchors["https://example.com/crawl-budget"] += ["crawl budget", "crawl budget optimization"]

THRESHOLD, MAX_PER_PAGE = 0.55, 5

def find_anchor(text, phrases):
    for phrase in sorted(phrases, key=len, reverse=True):
        if len(phrase.split()) < 2:
            continue
        m = re.search(r"\b" + re.escape(phrase) + r"\b", text, re.IGNORECASE)
        if m:
            start = max(0, m.start() - 120)
            return m.group(0), text[start:m.end() + 120]
    return None, None

rows = []
for i, src in enumerate(keys):
    added = 0
    for j in sorted(range(len(keys)), key=lambda k: -float(sim[i][k])):
        score = float(sim[i][j])
        if score < THRESHOLD or added == MAX_PER_PAGE:
            break
        tgt = keys[j]
        if tgt == src or tgt in pages[src]["links"]:
            continue
        anchor, context = find_anchor(pages[src]["text"], anchors[tgt])
        if anchor:
            rows.append([src, tgt, anchor, round(score, 2), context])
            added += 1

with open("link_suggestions.csv", "w", newline="", encoding="utf-8") as f:
    csv.writer(f).writerows([["source", "target", "anchor", "score", "context"]] + rows)
Cum îl pregătești pentru producție
Respectă serverul: adaugă o pauză între cereri și un User-Agent clar sau citește conținutul direct din baza de date ori din API-ul CMS-ului, în loc să faci crawl.
Folosește un text mai bun pentru embedding-uri: titlul plus H1 plus primele 300 de cuvinte dau de obicei rezultate mai bune decât pagina întreagă, care diluează subiectul.
Scalează potrivirea: matricea de similaritate crește cu pătratul numărului de pagini. Peste 20000 de pagini, folosește un index de vecini apropiați aproximativi (de exemplu FAISS) și compară fiecare pagină doar cu cei mai apropiați 50 de vecini.
Adaugă priorități: înmulțește scorul cu un bonus pentru țintele prioritare și cu o penalizare pentru țintele care au deja multe linkuri primite.
Respectă arhitectura: pentru un silo sau un cocon, elimină perechile ale căror URL-uri nu împart folderul sau arborele tematic permis.
Inserează pe server: scrie linkurile aprobate în conținutul stocat prin API-ul CMS-ului, niciodată printr-un script front-end.
Găsește mențiunile fără link cu un crawler
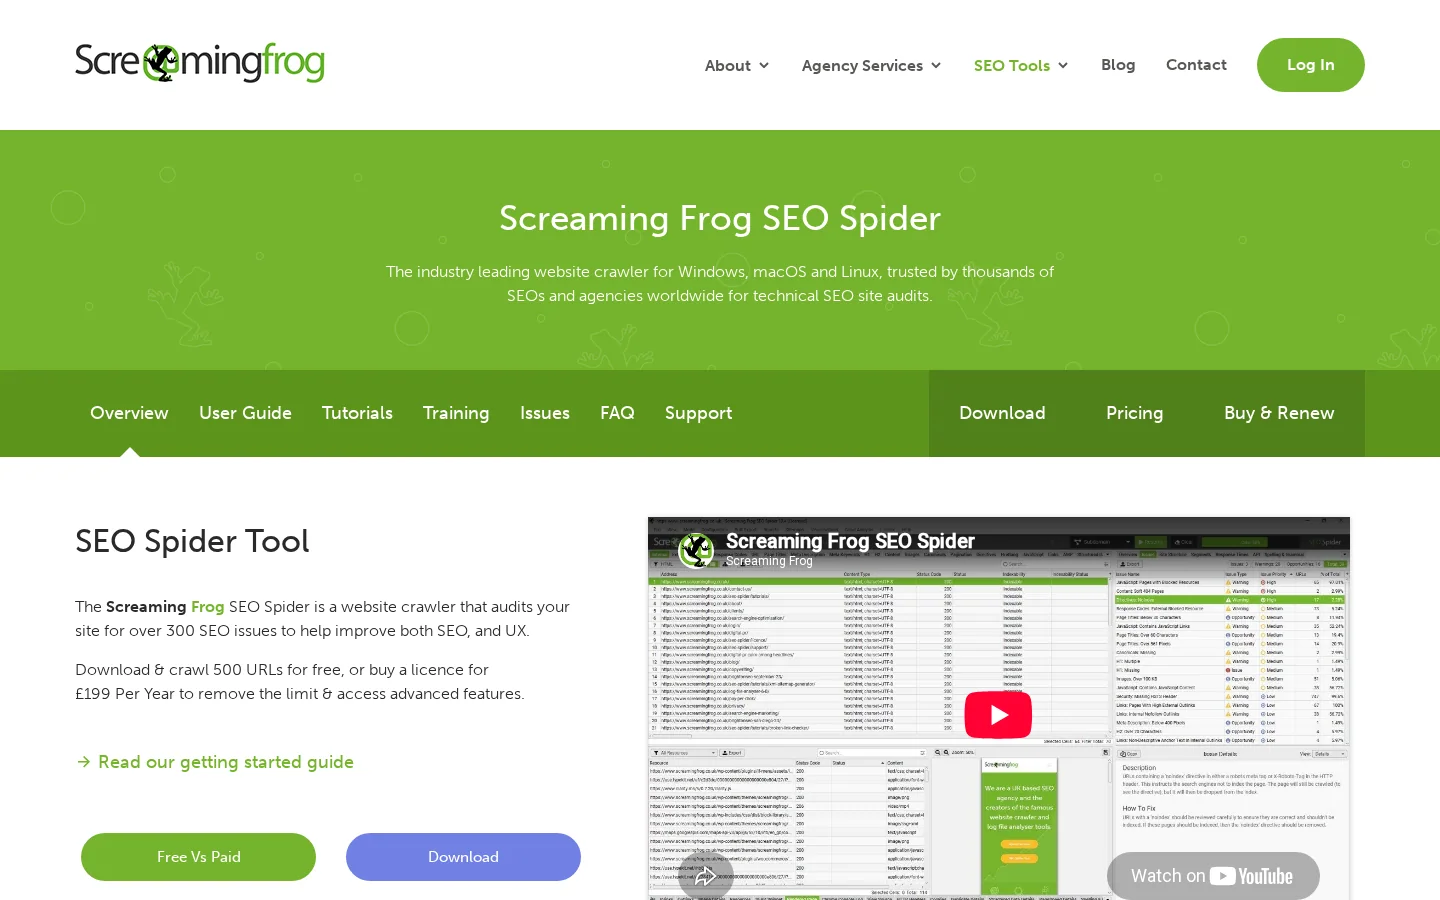
Fără să scrii cod, un crawler poate face o parte din treabă. În Screaming Frog, funcția Custom Search găsește fiecare pagină care conține o expresie, iar Custom Extraction cu XPath numără linkurile către o anumită țintă. Paginile care conțin expresia, dar au zero linkuri către țintă, sunt candidații tăi. Ghidul de utilizare SEO Spider documentează și Link Score, „o metrică între 0 și 100 care calculează valoarea relativă a unei pagini pe baza linkurilor sale interne”, care necesită rularea crawl analysis după crawl.
Screaming Frog SEO Spider: fă crawl pe site, exportă linkurile interne și ancorele și găsește paginile care menționează un subiect fără să trimită link către el.
Greșeli frecvente la linkuirea internă automată (și cum le corectezi)
Cele mai multe probleme ale linkuirii automate nu sunt penalizări. Sunt linkuri irosite, semnale confuze și pagini care par scrise de o mașină. Iată cum identifici și corectezi fiecare dintre ele.
1. Link pe fiecare apariție a unui cuvânt cheie
Ce este: un plugin bazat pe reguli, setat fără limite, pune link pe „audit SEO” în 400 de pagini, cu aceeași ancoră, către aceeași pagină. Cum o identifici: în exportul de texte ancoră din crawler, sortează ancorele interne după frecvență; o expresie cu sute de utilizări identice către un singur URL este semnalul. Cum o corectezi: limitează utilizările per regulă pe tot site-ul, cere cel puțin două variante per țintă și elimină linkurile din paginile în care subiectul este doar menționat în treacăt.
2. Link pe sensul greșit
Ce este: cuvântul se potrivește, sensul nu („Apple” fructul trimis către un articol despre iPhone, „Java” insula către un tutorial de programare). Cum o identifici: verifică lunar un eșantion aleatoriu de 30 de linkuri automate și citește propoziția întreagă. Cum o corectezi: ridică pragul de similaritate, cere atât potrivire de expresie, cât și de subiect, și adaugă cuvinte cheie negative la regulile ambigue.
3. Prea multe linkuri pe paragraf
Ce este: motorul îngrămădește patru linkuri într-un paragraf de 60 de cuvinte. Cititorii nu mai dau clic, iar textul devine greu de citit. Cum o identifici: calculează linkurile la 100 de cuvinte de conținut principal; orice valoare peste 3 merită verificată. Cum o corectezi: setează o distanță minimă în cuvinte între linkurile automate și o limită pe pagină care ia în calcul și linkurile puse deja de autor.
4. Linkuri în titluri, butoane sau în interiorul altor linkuri
Ce este: o potrivire dintr-un H2, dintr-un cuprins sau dintr-o ancoră existentă este învelită într-un link nou, ceea ce produce etichete <a> imbricate sau titluri albastre. Cum o identifici: trece câteva pagini printr-un validator HTML sau caută în crawl titlurile care conțin linkuri. Cum o corectezi: declară explicit selectorii interziși și testează-i pe o copie de staging înaintea fiecărei reguli noi.
5. Linkuri care există doar în JavaScript
Ce este: un widget front-end injectează linkuri după încărcarea paginii, uneori fără href, alteori doar după scroll sau clic. Cum o identifici: compară HTML-ul brut (vezi sursa paginii) cu DOM-ul randat și verifică HTML-ul randat în instrumentul de inspectare a adreselor URL din Search Console. Cum o corectezi: mută inserarea pe server sau în conținutul stocat. Ghidul nostru de JavaScript SEO explică randarea în detaliu.
Atenție
Multe crawlere AI nu rulează deloc JavaScript. Un link care apare doar după rularea scripturilor poate fi vizibil pentru Googlebot după randare, dar invizibil pentru boții care alimentează ChatGPT, Claude sau Perplexity.
6. Linkuri către redirecționări, pagini noindex și erori 404
Ce este: linkurile automate construite pe un inventar vechi continuă să trimită către URL-uri mutate sau eliminate. Cum o identifici: într-un crawl, filtrează linkurile interne după codul de stare (3xx, 4xx) și după ținta neindexabilă; verificatorul nostru gratuit de linkuri rupte face asta pentru o singură pagină. Cum o corectezi: reîmprospătează inventarul înainte de fiecare rulare, acceptă doar ținte cu cod 200, indexabile și cu canonical către ele însele, și actualizează linkurile pe loc când creezi o redirecționare 301.
7. Bazarea doar pe widgeturi „articole similare”
Ce este: site-ul crede că e bine legat pentru că fiecare articol se termină cu trei articole similare. Aceste blocuri aleg adesea după etichetă sau dată, se rotesc și sar complet peste conținutul vechi. Cum o identifici: raportul tău de pagini orfane (URL-uri din sitemap neatinse de crawl sau atinse doar prin paginare) rămâne lung. Cum o corectezi: păstrează widgetul, dar adaugă linkuri contextuale în corpul textului și linkuri fixe din paginile hub.
8. O singură ancoră către două pagini
Ce este: „instrument de linkuire internă” trimite către pagina A în unele articole și către pagina B în altele. Îți împarți semnalele de relevanță și poți alimenta canibalizarea cuvintelor cheie. Cum o identifici: construiește din crawl o hartă ancoră către țintă și marchează fiecare ancoră cu mai mult de o țintă. Cum o corectezi: o intenție de căutare, o pagină țintă; reatribuie ancorele paginii mai slabe.
9. Fără jurnal, fără posibilitate de anulare
Ce este: linkurile au fost inserate în conținut de un plugin dezinstalat ulterior sau nimeni nu știe care linkuri sunt automate. Cum o identifici: nu poți răspunde la întrebarea „câte linkuri a adăugat instrumentul luna trecută?”. Cum o corectezi: stochează fiecare link automat într-un tabel (sursă, țintă, ancoră, regulă, dată, stare), marchează-le în HTML cu un atribut data dacă tehnologia ta permite și verifică dacă poți elimina toate linkurile unei reguli printr-o singură operațiune.
Greșeală
Semnalul de căutat
Corecție
Link pe fiecare apariție
O ancoră folosită de sute de ori către un URL
Limite pe tot site-ul, variante de ancoră
Sens greșit
Propoziții ciudate într-un eșantion manual
Prag mai mare, cuvinte cheie negative
Densitatea linkurilor
Peste 3 linkuri la 100 de cuvinte
Distanță în cuvinte, limită pe pagină
Zone interzise
Linkuri în titluri, ancore imbricate
Selectori de excludere expliciți
Linkuri doar în JavaScript
Linkuri absente din sursa paginii
Inserare pe server
Ținte moarte
Linkuri interne 3xx și 4xx în crawl
Inventar reîmprospătat, doar ținte 200
Linkuire doar prin widget
Listă lungă de pagini orfane
Linkuri contextuale și din huburi
O ancoră, două ținte
Hartă de ancore cu duplicate
O intenție, o pagină
Fără jurnal
Linkurile automate nu pot fi numărate
Tabel de linkuri, atribut data, anulare
Cum măsori impactul linkurilor interne automate
Linkurile interne produc rareori un salt peste noapte. Măsoară pe paginile care au primit linkuri, comparativ cu grupul de control, pe o perioadă de 4 până la 12 săptămâni.
Ce urmărești după fiecare val de linkuri
Numărul de pagini orfane (sitemap vs crawl)
Pagini aflate la mai mult de 3 clicuri de pagina principală
Linkuri interne primite unice per pagină prioritară
Afișările și poziția medie ale paginilor țintă în Search Console
Clicurile pe paginile țintă comparativ cu grupul de control
Frecvența de crawl a paginilor țintă în logurile serverului
Procentul de linkuri automate respinse la verificare (calitatea regulilor)
Raportul Linkuri din Search Console
Raportul Linkuri din Search Console îți arată „paginile cu cele mai multe linkuri interne” și, pentru fiecare, paginile care trimit către ea. Este util pentru o verificare rapidă (paginile tale prioritare sunt aproape de vârf?), dar pagina de ajutor Google avertizează că tabelele sunt limitate la 1000 de rânduri și că raportul „nu este o listă completă a tuturor linkurilor de pe site-ul tău”. Folosește propriul crawl ca sursă de adevăr, iar Search Console pentru a vedea ce a preluat efectiv Google.
Raportul Linkuri din Search Console arată paginile cu cele mai multe linkuri interne, cu o limită de 1000 de rânduri: folosește-l pentru verificare, nu ca sursă de adevăr.
Logurile serverului
Dacă ai acces la ele, logurile serverului arată dacă Googlebot și crawlerele AI vizitează mai des paginile nou legate după un val. Acesta este cel mai direct semnal că descoperirea s-a îmbunătățit. Ghidul nostru despre analiza fișierelor log pentru SEO explică cum să filtrezi boții și să citești frecvența de crawl și de ce contează pentru crawl budget pe site-urile mari.
Interpretarea onestă a rezultatelor
Dacă afișările cresc pe paginile țintă, dar nu și în grupul de control, linkurile probabil au ajutat. Dacă cresc în ambele, este cel mai probabil un efect sezonier sau algoritmic. Dacă paginile țintă câștigă afișări, dar nu și clicuri, următoarea pârghie este titlul și conținutul, nu mai multe linkuri. Iar dacă nimic nu se mișcă după 12 săptămâni, verifică elementele de bază: sunt linkurile în HTML-ul brut și sunt țintele chiar indexate?
De unde să începi chiar azi
Nu ai nevoie de un instrument mare ca să începi. Alege un cluster de 20 până la 50 de pagini, fă crawl pe el, listează-i paginile orfane și prioritare, construiește o bancă de ancore din Search Console și adaugă linkurile într-un singur val verificat. Măsoară timp de șase săptămâni, notează ce ai învățat sub formă de reguli, apoi extinde la următorul cluster.
Dacă publici des, cel mai ieftin câștig este linkuirea în momentul scrierii: fiecare articol nou ar trebui să plece din editor cu linkuri către paginile potrivite. Exact asta face Sorank când scrie și publică articole pentru tine, iar generatorul său de clustere tematice planifică clusterele pe care le urmează aceste linkuri, cu protecție anti-canibalizare inclusă. Pentru paginile mai vechi, combină-l cu o completare retroactivă verificată, folosind metoda de mai sus.
Întrebări frecvente
Este linkuirea internă automată sigură pentru SEO?
Da, atâta timp cât linkurile sunt relevante, folosesc ancore descriptive și rămân în limite rezonabile. Documentația Google cere linkuri care pot fi accesate de crawler, cu text ancoră descriptiv, și avertizează împotriva linkuirii excesive, nu împotriva automatizării în sine. Riscul vine de la instrumentele care pun link pe fiecare apariție a unui cuvânt cheie cu aceeași ancoră, așa că păstrează o etapă de verificare și înregistrează fiecare link automat.
Câte linkuri interne ar trebui să aibă un articol?
Google spune că nu există un număr ideal. Un punct de plecare practic este 3 până la 5 linkuri contextuale automate într-un articol de 1500 de cuvinte, pe lângă linkurile puse de autor, cu un singur link per țintă și o distanță între linkuri. Măsoară pe propriile pagini și ajustează, pentru că un studiu de corelație Zyppy a observat câștiguri până la aproximativ 40 de linkuri interne primite per URL și o inversare după aproximativ 45 până la 50.
Înlocuiește linkuirea internă automată o strategie de linkuire internă?
Nu. Automatizarea execută o strategie: găsește candidați, inserează linkuri și le ține la zi. Tu trebuie în continuare să decizi ce pagini prioritizezi, ce arhitectură urmează linkurile (rețea, cocon semantic sau silo) și ce ancore aparțin fiecărei pagini.
y!
Primește gratuit planul tău de conținut pe 30 de zile
Analizăm concurenții, site-ul tău și vizibilitatea ta în AI pentru a crea gratuit un plan de conținut personalizat.
“Am testat Sorank pe un site real de client și este incredibil. Face tot ce o agenție ți-ar factura 1500$ pe lună. Acum este deja în producție la acel client.”Guillaume Guersanguersanguillaume.com
“Suntem o agenție de publicitate și am vrut să punem în sfârșit SEO-ul pe picioare. Sorank ne-a oferit o viziune clară asupra site-ului nostru, ne-a ajutat să prioritizăm optimizările și să ne structurăm conținutul corect. Instrumentul este ușor de utilizat, bine gândit pentru o echipă și foarte practic pentru a centraliza urmărirea fără să jonglăm între mai multe platforme. O bază foarte solidă pentru a începe din nou cu SEO-ul nostru.”Gaspard MadouiAgenție de publicitate
Dominiqueflight-sensations-idf.comAgrement și aviație
“Am lăsat pur și simplu software-ul Sorank să își facă treaba, iar acum DR-ul meu este 25 și pagina mea se clasează mai sus.”Lucas Flandrefoundertrace.fr
“M-am specializat în GEO datorită Sorank. Clasamentul GEO îmi permite să îmi arăt clienții poziția față de concurenți în ChatGPT. Este un avantaj comercial real.”MélanieFreelancer SEO
“Serviciu excelent, funcționează bine pentru site-ul nostru și ne ajută să înțelegem cum să îl îmbunătățim pentru a ne clasa mai bine pe Google și în alte părți. Felicitări, continuați așa, vă recomand.”Hugo T.Comerciant e-commerce