La confidentialité est importante pour nous. Vous avez donc la possibilité de désactiver certains types de stockage qui peuvent ne pas être nécessaires au fonctionnement de base du site Web. Le blocage des catégories peut avoir un impact sur votre expérience sur le site Web. Plus d'informations (Politique de cookies)
Merci ! Vos choix ont bien été enregistrés.
Oups ! Une erreur s'est produite lors de l'envoi du formulaire.
Maillage interne automatisé : méthodes, mise en place et règles pour le sécuriser
Comprenez le maillage interne automatisé, comparez 6 méthodes, suivez une mise en place pas à pas et évitez les erreurs qui transforment les liens en spam.
Un réseau de pages reliées par des liens internes, dont certains sont placés automatiquement et vérifiés par un éditeur avant publication.
Outils
Sur cette page
En bref
le maillage interne automatisé consiste à laisser un logiciel trouver, suggérer ou insérer les liens entre vos propres pages, au lieu de les placer un par un à la main. Il fonctionne bien quand la machine fait la partie fastidieuse (crawler, rapprocher les sujets, repérer les pages orphelines, enregistrer chaque lien) et que vous gardez la main sur les règles : quelles pages pousser, quelles ancres autoriser, combien de liens par page. Mettez-le en place sur le modèle « suggérer, valider, publier, mesurer », pas comme un plugin qui transforme chaque mot-clé en lien.
3 jours offerts, puis vous arrêtez quand vous voulez. Garantie résultats 90 jours, sous conditions.
Ce qu'est le maillage interne automatisé (et ce qu'il n'est pas)
Un lien interne est un lien d'une page de votre site vers une autre page du même site. Il a trois rôles : il permet aux robots de découvrir les pages, il indique aux moteurs de recherche et aux IA le sujet de la page cible (par le texte d'ancre et les mots qui l'entourent), et il transmet de l'autorité des pages fortes vers les pages plus faibles. Si ces bases sont nouvelles pour vous, commencez par notre définition du maillage interne.
Automatiser le maillage, c'est confier à un programme une ou plusieurs de ces tâches :
Inventaire : crawler le site, lister chaque page, chaque lien existant et chaque ancre.
Rapprochement : décider quelle page doit pointer vers laquelle, à partir des mots-clés, du sens ou des entités.
Choix de l'ancre : trouver une expression déjà présente dans le texte source qui décrit la cible.
Insertion : écrire le lien dans le HTML, dans la base de données du CMS ou au moment du rendu.
Maintenance : corriger les liens quand une URL change, qu'une page est supprimée ou qu'un nouvel article est publié.
Ce que ce n'est pas : un moyen de placer le même lien sur un mot-clé dans 500 pages, un substitut à une arborescence, ou un widget « articles similaires » en bas de chaque article. Ces éléments peuvent faire partie d'un système automatisé, mais seuls, ils produisent surtout du bruit.
Pourquoi le maillage manuel finit par lâcher
Le maillage manuel fonctionne sur un site de 30 pages. Il échoue sur un site qui publie chaque semaine, pour une raison simple : chaque nouvel article crée deux tâches. Il doit pointer vers des pages existantes, et des pages plus anciennes doivent pointer vers lui. La deuxième tâche est celle que tout le monde oublie. Après deux ans de publication, vous avez des articles récents vers lesquels personne ne pointe, et d'anciens articles qui renvoient encore vers des pages que vous avez remplacées depuis.
Le maillage interne avant et après l'automatisation
Avant (manuel)
Les nouveaux articles reçoivent des liens sortants, rarement des liens entrants
Les pages orphelines s'accumulent sans qu'on le voie
Des liens pointent vers des redirections et des URL supprimées
Les ancres dépendent de la personne qui a écrit l'article
Après (automatisé, avec validation)
Chaque nouvelle page reçoit des liens depuis des pages proches
Les orphelines sont signalées à chaque crawl
Les cibles cassées ou redirigées sont mises à jour
Les ancres suivent des règles écrites et sont enregistrées
Cet article porte sur la mécanique : méthodes, réglages, un script qui fonctionne et les cas d'échec. Pour le volet stratégique (quelles pages prioriser, comment planifier les liens d'un site multilingue), lisez d'abord notre stratégie de maillage interne d'expert. Les deux articles sont pensés pour être utilisés ensemble.
Pourquoi c'est important : ce que disent les données sur les liens internes
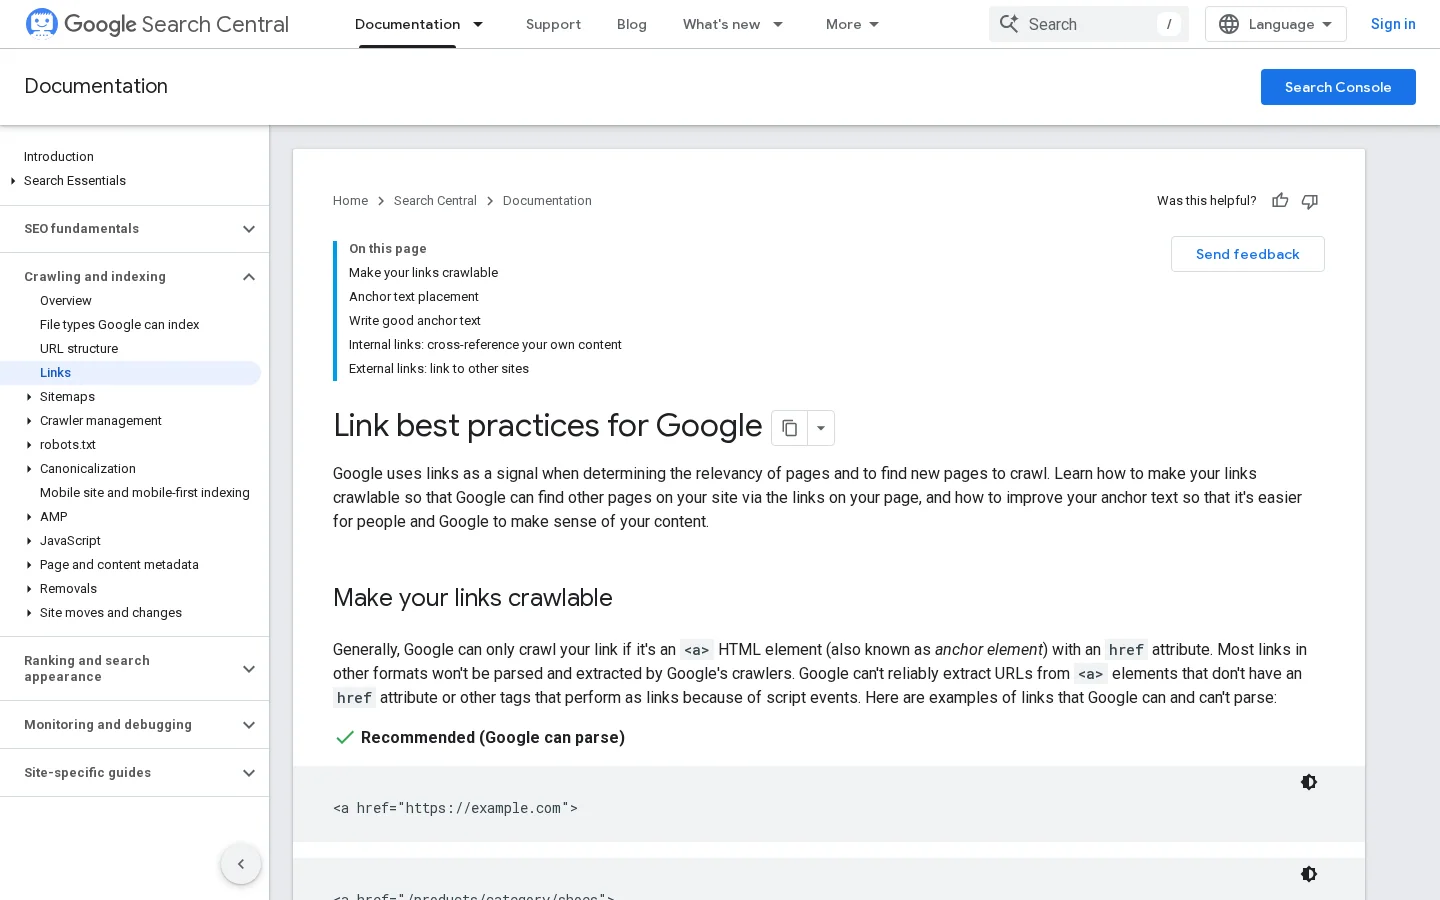
Google est clair sur le minimum. Sa documentation sur les bonnes pratiques des liens indique que « chaque page qui compte pour vous doit recevoir un lien depuis au moins une autre page de votre site », et que Google ne peut en général explorer un lien que s'il s'agit d'un élément <a> avec un attribut href. Une page orpheline n'est pas interdite, mais vous pariez sur le seul sitemap pour qu'elle soit trouvée et comprise.
Au-delà du minimum, le meilleur jeu de données public sur le sujet est une étude de corrélation de Cyrus Shepard chez Zyppy, « 23 Million Internal Links: SEO Case Study » (mise à jour en février 2026). Elle croise les données de liens internes d'environ 1800 sites avec leurs clics dans la Search Console.
Ce que révèlent 23 millions de liens internes
23 millionsliens internes analysés sur environ 520000 URL
1800sites dans le jeu de données, croisés avec les clics de la Google Search Console
5xau moins cinq fois plus de trafic pour les pages qui ont au moins une ancre interne en correspondance exacte
6%plus de 6% des liens internes n'avaient aucun texte d'ancre
Source : Cyrus Shepard, Zyppy, 23 Million Internal Links SEO Case Study, mise à jour en février 2026
Le résultat le plus utile pour l'automatisation concerne le volume. Les URL qui recevaient 0 à 4 liens internes obtenaient en moyenne 2 clics depuis Google, tandis que celles qui en recevaient 40 à 44 en obtenaient quatre fois plus. Au-delà d'environ 45 à 50 liens, l'effet s'inverse. L'auteur attribue une bonne partie de cette baisse aux liens de navigation présents sur tout le site, et il prend soin de qualifier l'étude de corrélationnelle : utile pour donner une direction, pas une preuve.
Clics Google moyens par URL selon le nombre de liens internes qu'elle reçoit
0 à 4 liens internes2 clics
40 à 44 liens internes8 clics (4x)
Source : Cyrus Shepard, Zyppy, 23 Million Internal Links SEO Case Study, mise à jour en février 2026
Deux leçons pratiques en découlent. D'abord, ce sont les pages qui manquent de liens qui gagnent le plus, et c'est précisément ce que l'automatisation sait trouver. Ensuite, l'étude a observé que la variété des ancres était corrélée aux clics, et que les pages avec des ancres en URL et en correspondance exacte faisaient mieux. Un système qui relie chaque page avec les trois mêmes mots jette cette variété à la poubelle.
L'angle GEO
Les robots des IA comme GPTBot, ClaudeBot et PerplexityBot découvrent les pages comme Googlebot : en suivant des liens <a href>. Beaucoup n'exécutent pas le JavaScript, donc un lien injecté côté navigateur peut tout simplement ne pas exister pour eux. Notre guide des robots d'IA explique ce que chaque robot récupère. Des liens internes propres et rendus côté serveur aident à la fois les moteurs de recherche et les moteurs d'IA qui citent vos pages.
Maillage interne automatisé : la machine trouve et place les liens, un humain fixe les règles et vérifie le résultat.
Comment fonctionne un moteur de maillage interne automatisé
Tout outil sérieux, qu'il s'agisse d'un plugin, d'un SaaS ou d'un script que vous écrivez, suit le même pipeline. Le connaître vous permet de juger un outil en cinq minutes : demandez comment il réalise chaque étape.
Le pipeline en 6 étapes d'un moteur de maillage interne
InventorierCrawler le site ou lire le CMS pour lister chaque page indexable, son contenu principal, son titre, son H1 et ses liens sortants existants.
ReprésenterTransformer chaque page en quelque chose de comparable : une liste de mots-clés, un ensemble d'entités ou un vecteur d'embedding.
RapprocherNoter chaque paire source et cible selon sa pertinence, puis garder les meilleurs candidats par page.
Choisir l'ancreTrouver une expression qui existe déjà dans le texte source et qui décrit la cible.
Appliquer les règlesFaire respecter les plafonds, exclusions, priorités et zones interdites (titres, liens existants, navigation).
Insérer et journaliserÉcrire le lien, enregistrer la source, la cible, l'ancre, la règle et la date, puis recrawler pour vérifier.
Étape 1 : l'inventaire, et pourquoi le « contenu principal » compte
L'inventaire doit séparer le contenu principal du gabarit. Un lien dans le menu d'en-tête apparaît sur toutes les pages et en dit peu à Google sur la cible. Un lien dans le troisième paragraphe d'un article pertinent lui en dit beaucoup. Les bons moteurs retirent nav, header, footer et aside avant l'analyse, et n'insèrent que dans le corps de l'article. Ils excluent aussi les URL non indexables : tout ce qui renvoie une redirection, une 404, un noindex ou une balise canonique qui pointe ailleurs.
Étape 2 : représenter les pages
Il existe trois représentations courantes, de la plus grossière à la plus fine :
Mots-clés : chaque page cible possède une liste d'expressions (« stratégie de maillage interne », « structure de liens »). Rapide et prévisible, mais aveugle au sens.
Entités : une bibliothèque de traitement du langage naturel extrait les éléments nommés (produits, lieux, concepts) et les associe aux pages qui les traitent. Meilleure pour lever les ambiguïtés.
Embeddings : un modèle de langage transforme chaque page en un vecteur de quelques centaines de nombres. Les pages aux sujets proches se retrouvent proches, même sans mot exact en commun. C'est ce qu'utilisent aujourd'hui la plupart des outils de maillage « IA ».
Étape 3 : le rapprochement
Avec des embeddings, le rapprochement est une similarité cosinus entre vecteurs, un score entre -1 et 1 (en pratique de 0 à 1 pour du texte). Vous gardez les paires au-dessus d'un seuil et les N meilleures par page. Le seuil est le réglage qui compte le plus : trop bas, vous reliez une page sur le python (le serpent) à une page sur Python (le langage) ; trop haut, vous ne trouvez que des quasi-doublons. Commencez vers 0,5 à 0,6 avec un modèle généraliste, puis ajustez après avoir relu 50 suggestions à la main.
Étape 4 : le choix de l'ancre
L'ancre doit être une expression déjà présente dans la phrase source. Insérer de nouveaux mots revient à réécrire le contenu, ce qui est un autre travail. Le moteur cherche dans le texte source des expressions qui décrivent la cible : son mot-clé principal, son H1, des variantes proches, ou les requêtes pour lesquelles la cible se positionne déjà dans la Search Console. Cette dernière source est la meilleure, car elle reflète la façon dont de vraies personnes décrivent la page.
Étapes 5 et 6 : règles, insertion, journal
C'est dans les règles que la qualité se gagne ou se perd (voir la section dédiée plus bas). L'insertion se fait à l'un de ces trois endroits : dans le contenu stocké (le lien fait partie de l'article, il est permanent et visible dans l'éditeur), au moment du rendu sur le serveur (un filtre ajoute les liens quand la page est générée, facile à annuler), ou dans le navigateur avec JavaScript (l'option la plus faible pour le SEO). Quelle que soit la méthode, un journal de chaque lien automatique n'est pas optionnel : sans lui, impossible d'auditer, de mesurer ou d'annuler.
Les 6 méthodes de maillage interne automatisé, comparées
« Maillage interne automatisé » recouvre des techniques très différentes. La plupart des sites finissent par en combiner deux ou trois.
1. Le maillage automatique par règles de mots-clés
Principe : vous tenez un tableau « expression vers URL », et le système transforme l'expression en lien partout où elle apparaît. Quand l'utiliser : glossaires, noms de produits, un petit ensemble de pages business. Avantages : prévisible, transparent, peu coûteux. Limites : aucune compréhension du contexte, ancres identiques partout, tableau qui vieillit. Exemple : chaque première mention de « budget de crawl » renvoie vers la page du glossaire sur le budget de crawl, avec un plafond d'un lien par article.
2. Les modules structurels et de gabarit
Principe : le CMS génère des liens à partir de la structure du site : fil d'Ariane, listes de catégories, « articles similaires », précédent et suivant, pages hubs qui listent leurs pages filles. Quand l'utiliser : toujours, c'est la couche de base. Avantages : zéro maintenance, garantit qu'aucune page d'une catégorie n'est orpheline. Limites : les liens de gabarit portent peu de contexte, et les modules « articles similaires » choisissent souvent par date ou par tag plutôt que par sens. Exemple : un fil d'Ariane « Blog > SEO > Maillage interne » sur chaque article.
3. Les suggestions sémantiques avec validation humaine
Principe : les embeddings trouvent les pages proches et les ancres candidates ; un éditeur valide ou rejette chaque suggestion. Quand l'utiliser : sites de contenu d'environ 50 à plusieurs milliers d'articles. Avantages : tient compte du contexte, garde un humain dans la boucle, ancres naturellement variées. Limites : temps de relecture, et une qualité qui dépend du seuil. Exemple : à la publication d'un article sur la « cannibalisation de mots-clés », l'outil propose cinq articles plus anciens où une phrase parle déjà de cannibalisation.
4. Le maillage par entités
Principe : les entités sont extraites de chaque page et reliées à la page de référence de cette entité sur votre site. Quand l'utiliser : sites riches en éléments nommés : marques, lieux, personnes, ingrédients, logiciels. Avantages : bonne désambiguïsation, construit une carte propre « une entité, une page ». Limites : nécessite une table entité vers page, moins efficace sur les sujets abstraits. Exemple : un site de voyage relie chaque mention de « Kyoto » à son guide de Kyoto, et jamais à la page des hôtels de Kyoto.
5. Le maillage piloté par le graphe (PageRank interne)
Principe : le site est traité comme un graphe. L'outil calcule un score interne pour chaque page (une métrique proche du PageRank), sa profondeur de clic depuis la page d'accueil et ses liens entrants, puis propose des liens qui envoient de l'autorité vers les pages prioritaires et rapprochent les pages profondes de la surface. Quand l'utiliser : gros sites, e-commerce, tout site dont les pages business sont enterrées. Avantages : optimise un objectif, pas seulement la pertinence. Limites : le modèle n'est qu'une approximation de la façon dont Google pondère les liens, et une logique de graphe pure peut créer des liens hors sujet si elle n'est pas couplée à un filtre de pertinence. Exemple : une page catégorie à 5 clics de profondeur reçoit des liens de trois guides forts qui se positionnent sur des requêtes proches, et remonte à 2 clics.
6. Le maillage au moment de la rédaction
Principe : les liens sont placés pendant la rédaction, par un rédacteur ou un outil de rédaction IA qui a l'inventaire du site sous les yeux. Quand l'utiliser : tout site qui publie régulièrement. Avantages : le lien fait partie d'une phrase écrite pour lui, donc les ancres se lisent naturellement. Limites : il gère les liens sortants de la nouvelle page, pas les liens entrants depuis les anciennes, donc il doit être associé à une méthode de rattrapage. Exemple : le générateur d'articles de blog IA de Sorank rédige chaque article avec des liens internes déjà en place vers vos pages de services, de produits ou de catégories.
Méthode
Pertinence
Effort de fonctionnement
Qualité des ancres
Risque si mal configurée
Cas idéal
Maillage automatique par règles de mots-clés
Faible
Faible
Répétitives
Élevé (bourrage de mots-clés)
Glossaires, noms de produits
Modules structurels et de gabarit
Moyenne
Très faible
Génériques
Faible
Tous les sites, comme couche de base
Suggestions sémantiques avec validation
Élevée
Moyen (relecture)
Naturelles et variées
Faible
Blogs et hubs de contenu
Maillage par entités
Élevée sur les éléments nommés
Moyen
Précises
Moyen
Voyage, e-commerce, catalogues
Piloté par le graphe (PageRank interne)
Variable
Élevé (analyse)
Dépend du filtre
Moyen
Gros sites, pages business enterrées
Maillage à la rédaction
Élevée
Faible
Les plus naturelles
Faible
Sites qui publient souvent
L'automatisation sert une architecture, elle ne la remplace pas
Avant de configurer quoi que ce soit, décidez de la forme que les liens doivent dessiner. Un maillage de type Wikipédia relie n'importe quelle page à n'importe quelle page proche ; c'est la sortie par défaut des outils sémantiques et cela convient bien aux contenus encyclopédiques. Un cocon sémantique limite les liens aux pages d'un même arbre thématique, les pages mères pointant vers le bas et les pages filles vers le haut et les sœurs ; vos règles doivent interdire les liens entre cocons, sauf au sommet. Un silo par l'URL suit l'arborescence des dossiers (/guides/seo/...) ; une règle simple « ne relier qu'à l'intérieur du même dossier, plus le hub » suffit à le faire respecter. Les clusters thématiques, décrits dans notre guide des clusters thématiques et pages piliers, se situent entre le cocon et le maillage libre. Notre article sur l'architecture de site pour le SEO vous aide à choisir.
Les règles qui sécurisent les liens automatiques
Un moteur de maillage sans règles est un générateur de spam. Voici les réglages à écrire avant le premier lancement, avec des valeurs qui servent de point de départ.
Insertion entièrement automatique ou suggestion avec validation
Entièrement automatique
Passe instantanément à n'importe quel volume
Aucun temps éditorial
Les erreurs sont publiées à grande échelle
Des ancres bizarres et des contextes faux passent
Difficile d'expliquer pourquoi un lien existe
Suggestion et validation
La machine trouve, l'humain décide
Chaque lien a un responsable et une raison
Les règles s'améliorent grâce aux suggestions rejetées
Passage en automatique possible pour les règles fiables
Demande du temps de relecture chaque semaine
Plafonds et densité
Liens automatiques par page : 3 à 5 dans un article de 1500 mots, en plus des liens placés par le rédacteur. Google dit qu'il n'existe pas de nombre idéal mais met en garde contre l'excès de liens ; vos propres données vous en apprendront plus que n'importe quelle règle empirique.
Un lien par cible et par page. Relier trois fois la même URL dans un article n'apporte rien au lecteur et brouille vos rapports.
Distance minimale : au moins 50 à 80 mots entre deux liens automatiques, pour que les paragraphes ne deviennent pas bleus.
Maximum par expression d'ancre sur le site : plafonnez le nombre de pages qui peuvent utiliser exactement la même ancre vers la même cible, puis imposez des variantes.
Zones interdites
N'insérez jamais dans les titres, la table des matières, les légendes d'images, les citations, les boutons d'appel à l'action, les encadrés auteur, ni à l'intérieur d'un <a> existant (les liens imbriqués sont du HTML invalide). Ne reliez jamais une page à elle-même, à une URL qui redirige, ou à une page en noindex ou canonisée vers une autre URL.
Règles d'ancre
La documentation de Google demande un texte d'ancre « descriptif, raisonnablement concis et pertinent par rapport à la page sur laquelle il se trouve », et cite « cliquez ici » et « en savoir plus » comme trop génériques. Traduisez cela en règles : ancres de 2 à 6 mots, prises dans la phrase existante, au moins deux ou trois variantes distinctes par cible sur le site, et une intention par ancre. Si « outil de maillage interne » pointe vers un analyseur gratuit sur une page et vers une fonctionnalité payante sur une autre, vous racontez deux histoires aux moteurs de recherche. Notre guide du texte d'ancre détaille les types d'ancres.
Crawlez tout le site avec un crawler de bureau comme Screaming Frog (notre guide de configuration de Screaming Frog détaille les réglages). Exportez, pour chaque URL indexable : les liens internes entrants (uniques), la profondeur de clic, les liens sortants et le score de lien interne du crawler. Comparez le crawl avec votre sitemap XML : les URL présentes dans le sitemap mais introuvables par le crawl sont vos pages orphelines. Enregistrez cet export avec une date. C'est votre « avant ».
Étape 2 : lister les pages qui doivent recevoir des liens
Toutes les pages ne méritent pas plus de liens. Dressez une courte liste de cibles prioritaires : les pages qui rapportent de l'argent, les pages positionnées entre la 5e et la 20e place sur des requêtes de valeur (Search Console, rapport Performances, filtre sur la position) et vos contenus piliers. Ajoutez chaque orpheline et chaque page à plus de 3 clics de profondeur. Cette liste alimente les « priority_targets » de vos règles.
Étape 3 : construire la banque d'ancres
Pour chaque cible prioritaire, rassemblez 3 à 10 expressions d'ancre. La meilleure source est la Search Console : ouvrez la page dans le rapport Performances, passez à l'onglet Requêtes et exportez les requêtes pour lesquelles elle obtient déjà des impressions. Ajoutez le H1, le mot-clé principal et des variantes naturelles. Retirez tout ce qui est ambigu ou partagé avec une autre page.
Étape 4 : générer les candidats et les filtrer
Lancez votre outil ou votre script. Pour chaque cible, il doit renvoyer des pages sources où l'ancre apparaît dans le corps et dont le sujet est suffisamment proche. Attendez-vous à ce que l'entonnoir se resserre fortement : c'est le signe que les filtres fonctionnent.
Comment les liens candidats sont filtrés
Toutes les paires source et cible du siteToutes les paires
Paires au-dessus du seuil de similaritéTop 20 par page
Paires où une ancre naturelle existe dans le texteAncre trouvée
Paires qui respectent les plafonds et les zones interditesRègles respectées
Liens validés et publiés3 à 5 par page
Étape 5 : relire par lots
Relisez les suggestions dans un tableur à cinq colonnes : source, cible, ancre, phrase, score. Lisez la phrase, pas seulement l'ancre. Rejetez tout ce que vous n'auriez pas écrit vous-même. Notez pourquoi vous rejetez (mauvais sens, trop promotionnel, déjà relié juste à côté) : ces raisons deviennent de nouvelles règles.
Étape 6 : publier par vagues, pas d'un coup
Publiez 50 à 200 liens par vague, sur un ensemble de pages que vous pouvez suivre. Gardez un groupe témoin de pages similaires sans nouveaux liens. Les variations de clics ont alors un point de référence, ce qui compte, car les positions bougent pour de nombreuses raisons.
Étape 7 : recrawler et vérifier le HTML rendu
Recrawlez le site. Vérifiez que les nouveaux liens apparaissent sous forme de <a href> dans le HTML brut, pas seulement après l'exécution du JavaScript. Pour quelques URL, utilisez l'outil d'inspection d'URL de la Search Console et regardez le HTML rendu que voit Google.
Étape 8 : brancher le système sur la publication
Le vrai gain est continu. À chaque publication d'article, le système doit faire deux choses : placer des liens depuis le nouvel article (à la rédaction) et proposer des liens vers lui depuis les pages plus anciennes (rattrapage). À chaque changement d'URL, il doit mettre à jour ou retirer les liens qui pointent vers elle.
Astuce
Pour vérifier une page rapidement, collez son URL dans notre analyseur de liens internes gratuit : il liste chaque lien interne de la page, son ancre et ses attributs, pour confirmer qu'une vague de liens automatiques est partie comme prévu.
Faites-le vous-même : un script de maillage interne sémantique en Python
Si votre CMS n'a pas de bon outil, ou si vous voulez comprendre exactement ce que fait un éditeur, un prototype fonctionnel tient en une soixantaine de lignes. Cette version lit le sitemap, extrait le contenu principal, calcule les embeddings avec un modèle open source et produit un CSV de suggestions à relire. Il ne touche jamais à votre site.
import csv, re
from urllib.parse import urljoin
import requests
from bs4 import BeautifulSoup
from sentence_transformers import SentenceTransformer, util

SITEMAP = "https://example.com/sitemap.xml"
urls = re.findall(r"<loc>(.*?)</loc>", requests.get(SITEMAP, timeout=20).text)

pages = {}
for url in urls:
    r = requests.get(url, timeout=20)
    if r.status_code != 200 or r.url != url:
        continue  # ignorer les erreurs et les redirections
    soup = BeautifulSoup(r.text, "html.parser")
    robots = soup.find("meta", attrs={"name": "robots"})
    if robots and "noindex" in robots.get("content", ""):
        continue
    main = soup.find("article") or soup.find("main") or soup.body
    for tag in main.find_all(["nav", "header", "footer", "aside", "script", "style"]):
        tag.decompose()
    pages[url] = {
        "h1": soup.h1.get_text(" ", strip=True) if soup.h1 else "",
        "text": main.get_text(" ", strip=True),
        "links": {urljoin(url, a["href"]).split("#")[0] for a in main.find_all("a", href=True)},
    }
Embeddings, rapprochement et recherche d'ancres
model = SentenceTransformer("all-MiniLM-L6-v2")
keys = list(pages)
docs = [pages[u]["h1"] + ". " + pages[u]["text"][:2000] for u in keys]
emb = model.encode(docs, normalize_embeddings=True)
sim = util.cos_sim(emb, emb)

# Banque d'ancres : URL cible -> expressions (H1 + requêtes exportées de la Search Console)
anchors = {u: [pages[u]["h1"].lower()] for u in keys}
# anchors["https://example.com/crawl-budget"] += ["crawl budget", "crawl budget optimization"]

THRESHOLD, MAX_PER_PAGE = 0.55, 5

def find_anchor(text, phrases):
    for phrase in sorted(phrases, key=len, reverse=True):
        if len(phrase.split()) < 2:
            continue
        m = re.search(r"\b" + re.escape(phrase) + r"\b", text, re.IGNORECASE)
        if m:
            start = max(0, m.start() - 120)
            return m.group(0), text[start:m.end() + 120]
    return None, None

rows = []
for i, src in enumerate(keys):
    added = 0
    for j in sorted(range(len(keys)), key=lambda k: -float(sim[i][k])):
        score = float(sim[i][j])
        if score < THRESHOLD or added == MAX_PER_PAGE:
            break
        tgt = keys[j]
        if tgt == src or tgt in pages[src]["links"]:
            continue
        anchor, context = find_anchor(pages[src]["text"], anchors[tgt])
        if anchor:
            rows.append([src, tgt, anchor, round(score, 2), context])
            added += 1

with open("link_suggestions.csv", "w", newline="", encoding="utf-8") as f:
    csv.writer(f).writerows([["source", "target", "anchor", "score", "context"]] + rows)
Comment le rendre prêt pour la production
Ménagez le serveur : ajoutez un délai entre les requêtes et un User-Agent clair, ou lisez le contenu directement depuis la base de données ou l'API du CMS au lieu de crawler.
Utilisez un meilleur texte pour les embeddings : titre plus H1 plus les 300 premiers mots donnent généralement de meilleurs résultats que la page entière, qui dilue le sujet.
Faites passer le rapprochement à l'échelle : la matrice de similarité grandit avec le carré du nombre de pages. Au-delà de 20000 pages, utilisez un index de plus proches voisins approximatif (FAISS, par exemple) et ne comparez chaque page qu'à ses 50 voisines les plus proches.
Ajoutez des priorités : multipliez le score par un bonus pour les cibles prioritaires et par une pénalité pour les cibles qui reçoivent déjà beaucoup de liens.
Respectez votre architecture : pour un silo ou un cocon, supprimez les paires dont les URL ne partagent pas le dossier ou l'arbre thématique autorisé.
Insérez côté serveur : écrivez les liens validés dans le contenu stocké via l'API du CMS, jamais via un script côté navigateur.
Trouver les mentions sans lien avec un crawler
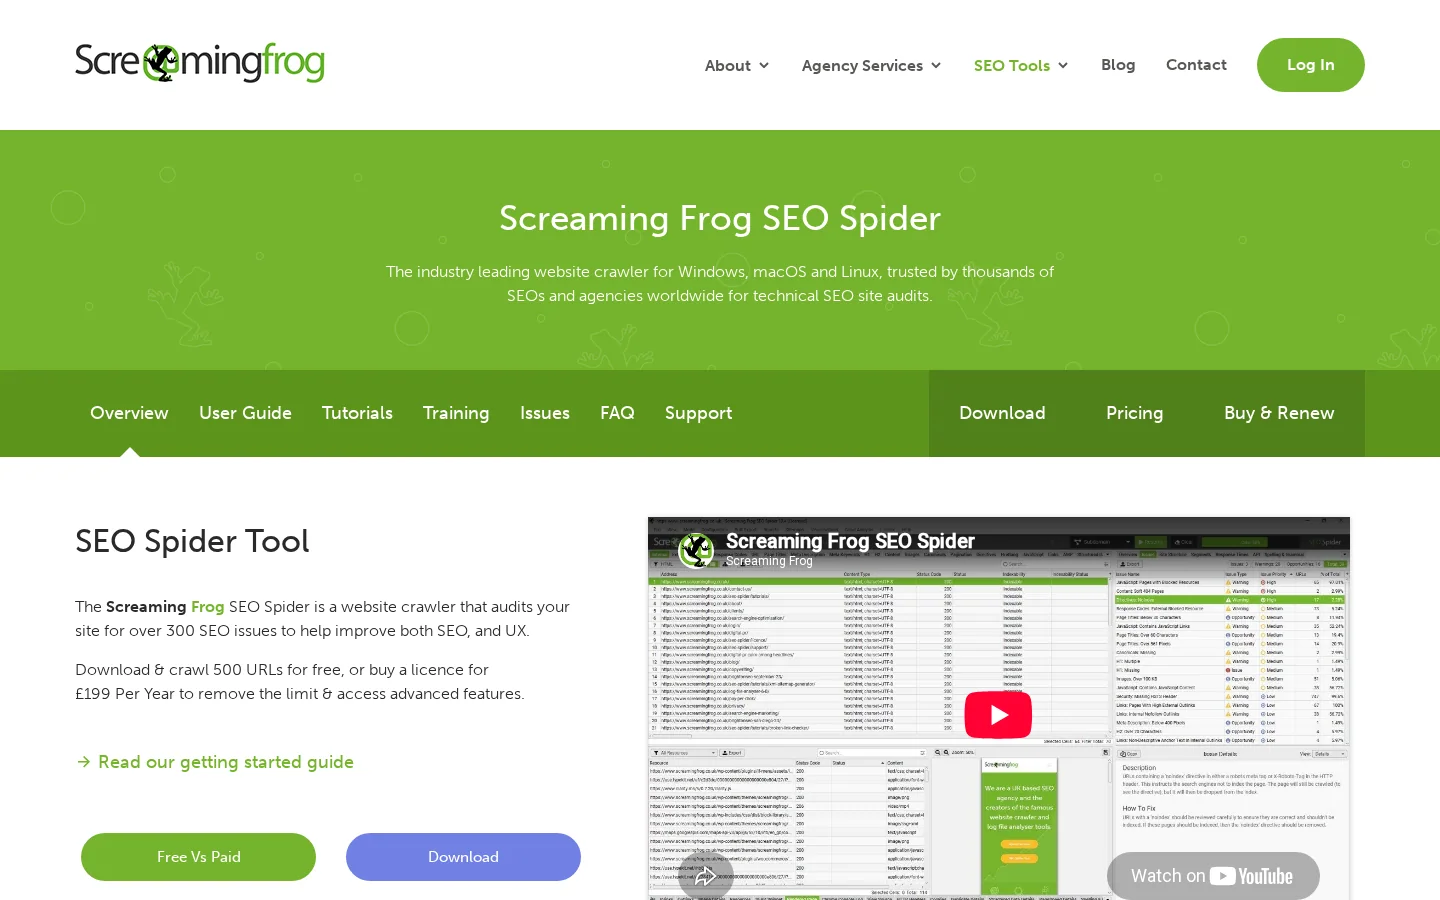
Sans écrire de code, un crawler peut faire une partie du travail. Dans Screaming Frog, la fonction Custom Search trouve chaque page qui contient une expression, et Custom Extraction en XPath compte les liens vers une cible donnée. Les pages qui contiennent l'expression mais n'ont aucun lien vers la cible sont vos candidates. Le guide utilisateur du SEO Spider documente aussi son Link Score, « une métrique de 0 à 100 qui calcule la valeur relative d'une page à partir de ses liens internes », qui nécessite de lancer la crawl analysis après le crawl.
Screaming Frog SEO Spider : crawlez votre site, exportez les liens internes et les ancres, et trouvez les pages qui parlent d'un sujet sans pointer vers lui.
Les erreurs courantes du maillage interne automatisé (et comment les corriger)
La plupart des problèmes de maillage automatisé ne sont pas des pénalités. Ce sont des liens gaspillés, des signaux confus et des pages qui semblent écrites par une machine. Voici comment repérer et corriger chacun d'eux.
1. Transformer chaque occurrence d'un mot-clé en lien
Ce que c'est : un plugin à règles réglé sans plafond relie « audit SEO » sur 400 pages, avec la même ancre, vers la même page. Comment le repérer : dans l'export des textes d'ancre de votre crawler, triez les ancres internes par fréquence ; une expression utilisée des centaines de fois à l'identique vers une seule URL est le signal. Comment le corriger : plafonnez les utilisations par règle sur le site, exigez au moins deux variantes par cible, et retirez les liens des pages où le sujet n'est mentionné qu'en passant.
2. Relier dans le mauvais sens
Ce que c'est : le mot correspond, le sens non (« pomme » le fruit relié à un article sur l'iPhone, « Java » l'île reliée à un tutoriel de programmation). Comment le repérer : relisez chaque mois un échantillon aléatoire de 30 liens automatiques en lisant la phrase entière. Comment le corriger : relevez le seuil de similarité, exigez à la fois une correspondance d'expression et une correspondance de sujet, et ajoutez des mots-clés négatifs aux règles ambiguës.
3. Trop de liens par paragraphe
Ce que c'est : le moteur empile quatre liens dans un paragraphe de 60 mots. Les lecteurs ne cliquent plus et le texte devient difficile à lire. Comment le repérer : calculez le nombre de liens pour 100 mots de contenu principal ; au-delà de 3, regardez de plus près. Comment le corriger : fixez une distance minimale en mots entre liens automatiques et un plafond par page qui compte les liens déjà placés par le rédacteur.
4. Des liens dans les titres, les boutons ou à l'intérieur d'autres liens
Ce que c'est : une correspondance dans un H2, une table des matières ou une ancre existante est enveloppée dans un nouveau lien, ce qui produit des balises <a> imbriquées ou des titres bleus. Comment le repérer : passez quelques pages dans un validateur HTML, ou cherchez dans le crawl les titres qui contiennent des liens. Comment le corriger : déclarez explicitement les sélecteurs interdits et testez-les sur une copie de préproduction avant chaque nouvelle règle.
5. Des liens qui n'existent qu'en JavaScript
Ce que c'est : un widget côté navigateur injecte des liens après le chargement de la page, parfois sans href, parfois seulement après un défilement ou un clic. Comment le repérer : comparez le HTML brut (code source) avec le DOM rendu, et vérifiez le HTML rendu dans l'inspection d'URL de la Search Console. Comment le corriger : déplacez l'insertion côté serveur ou dans le contenu stocké. Notre guide du SEO JavaScript explique le rendu en détail.
Attention
Beaucoup de robots d'IA n'exécutent pas du tout le JavaScript. Un lien qui n'apparaît qu'après l'exécution des scripts peut être visible pour Googlebot après le rendu, mais invisible pour les robots qui alimentent ChatGPT, Claude ou Perplexity.
6. Relier vers des redirections, des pages en noindex et des 404
Ce que c'est : des liens automatiques construits à partir d'un vieil inventaire continuent de pointer vers des URL déplacées ou supprimées. Comment le repérer : dans un crawl, filtrez les liens internes par code de statut (3xx, 4xx) et par cible non indexable ; notre vérificateur de liens cassés gratuit le fait pour une page. Comment le corriger : rafraîchissez l'inventaire avant chaque lancement, n'acceptez que des cibles en 200, indexables et auto-canoniques, et mettez à jour les liens sur place quand une 301 est créée.
7. Compter uniquement sur les widgets « articles similaires »
Ce que c'est : le site se croit bien maillé parce que chaque article se termine par trois articles similaires. Ces blocs choisissent souvent par tag ou par date, tournent, et ignorent complètement les anciens contenus. Comment le repérer : votre liste d'orphelines (URL du sitemap non atteintes par le crawl, ou atteintes seulement par la pagination) reste longue. Comment le corriger : gardez le widget, mais ajoutez des liens contextuels dans le corps du texte et des liens fixes depuis les pages hubs.
8. Faire pointer une même ancre vers deux pages
Ce que c'est : « outil de maillage interne » pointe vers la page A dans certains articles et vers la page B dans d'autres. Vous divisez les signaux de pertinence et pouvez nourrir la cannibalisation de mots-clés. Comment le repérer : construisez à partir du crawl une table ancre vers cible et signalez toute ancre qui a plus d'une cible. Comment le corriger : une intention de recherche, une page cible ; réaffectez les ancres de la page la plus faible.
9. Pas de journal, pas de retour arrière
Ce que c'est : des liens ont été insérés dans le contenu par un plugin désinstallé depuis, ou personne ne sait quels liens sont automatiques. Comment le repérer : vous ne savez pas répondre à « combien de liens l'outil a-t-il ajoutés le mois dernier ? ». Comment le corriger : stockez chaque lien automatique dans une table (source, cible, ancre, règle, date, statut), marquez-les dans le HTML avec un attribut data si votre stack le permet, et vérifiez que vous pouvez retirer tous les liens d'une règle en une seule opération.
Erreur
Signal à chercher
Correction
Chaque occurrence reliée
Une ancre utilisée des centaines de fois vers une URL
Plafonds sur le site, variantes d'ancre
Mauvais sens
Phrases bizarres dans un échantillon manuel
Seuil plus élevé, mots-clés négatifs
Densité de liens
Plus de 3 liens pour 100 mots
Distance en mots, plafond par page
Zones interdites
Liens dans les titres, ancres imbriquées
Sélecteurs d'exclusion explicites
Liens uniquement en JavaScript
Liens absents du code source
Insertion côté serveur
Cibles mortes
Liens internes 3xx et 4xx dans le crawl
Inventaire rafraîchi, cibles en 200 uniquement
Maillage par widget seulement
Longue liste d'orphelines
Liens contextuels et liens depuis les hubs
Une ancre, deux cibles
Table des ancres avec doublons
Une intention, une page
Pas de journal
Impossible de compter les liens automatiques
Table des liens, attribut data, retour arrière
Comment mesurer l'impact des liens internes automatiques
Les liens internes produisent rarement un bond du jour au lendemain. Mesurez sur les pages qui ont reçu des liens, par rapport au groupe témoin, sur 4 à 12 semaines.
Ce qu'il faut suivre après chaque vague de liens
Nombre de pages orphelines (sitemap contre crawl)
Pages à plus de 3 clics de la page d'accueil
Liens internes entrants uniques par page prioritaire
Impressions et position moyenne des pages cibles dans la Search Console
Clics sur les pages cibles par rapport au groupe témoin
Fréquence de crawl des pages cibles dans les logs serveur
Part des liens automatiques rejetés à la relecture (qualité des règles)
Le rapport Liens de la Search Console
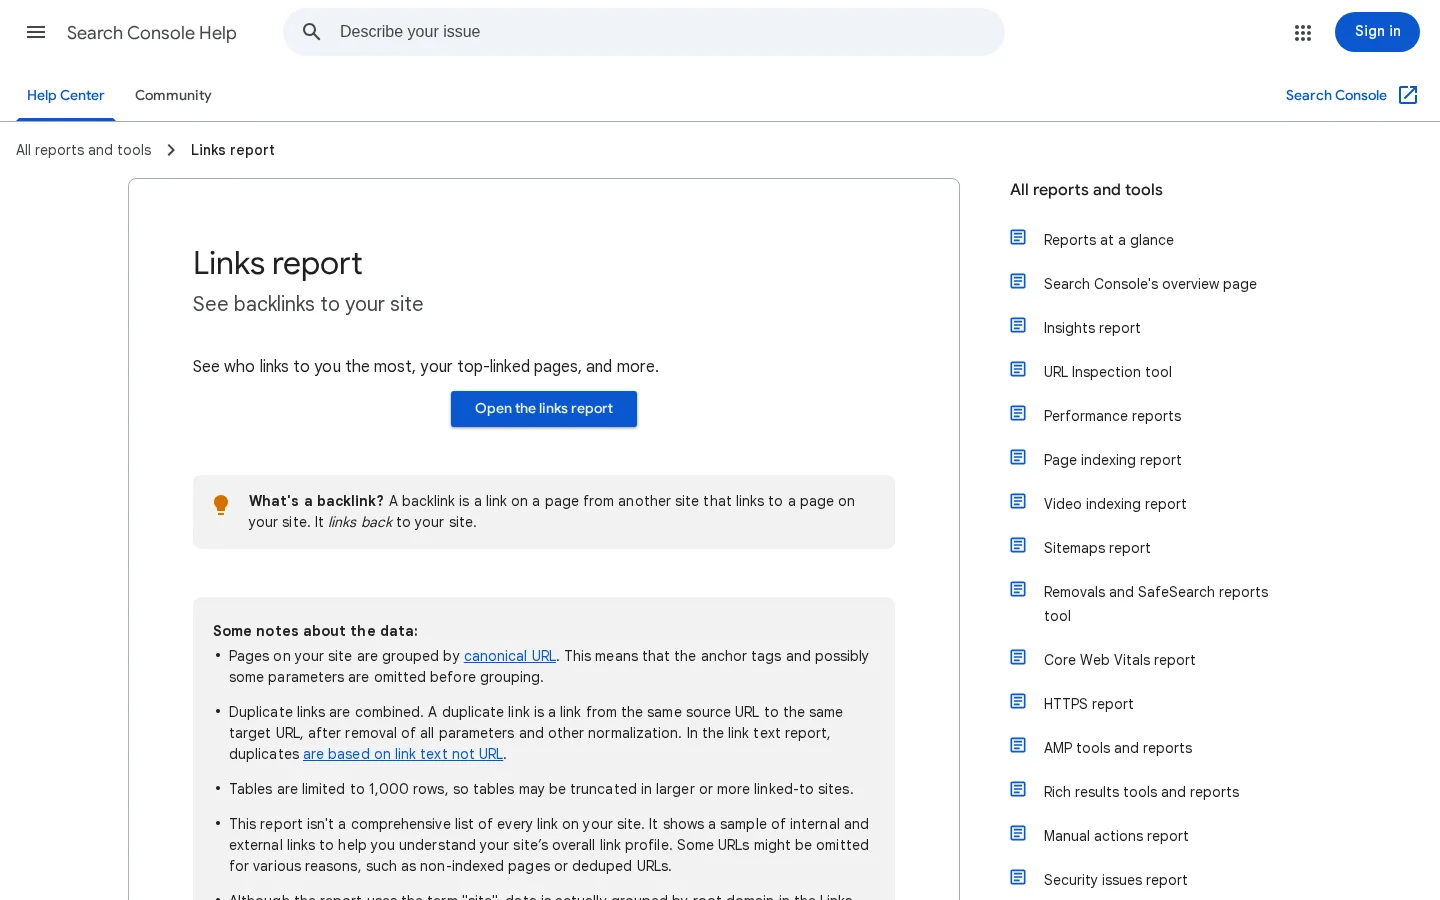
Le rapport Liens de la Search Console montre vos « pages qui reçoivent le plus de liens internes » et, pour chacune, les pages qui pointent vers elle. Il est utile pour un contrôle de cohérence (vos pages prioritaires sont-elles en haut ?), mais la page d'aide de Google précise que ses tableaux sont limités à 1000 lignes et que le rapport « n'est pas une liste exhaustive de tous les liens de votre site ». Faites de votre propre crawl la source de vérité, et utilisez la Search Console pour voir ce que Google a réellement pris en compte.
Le rapport Liens de la Search Console montre vos pages les plus reliées en interne, avec une limite de 1000 lignes : utilisez-le comme contrôle, pas comme source de vérité.
Les logs serveur
Si vous y avez accès, les logs serveur montrent si Googlebot et les robots d'IA visitent plus souvent les pages nouvellement reliées après une vague. C'est le signal le plus direct d'une meilleure découverte. Notre guide de l'analyse de logs pour le SEO explique comment filtrer les robots et lire la fréquence de crawl, et pourquoi c'est important pour le budget de crawl des gros sites.
Lire les résultats honnêtement
Si les impressions augmentent sur les pages cibles mais pas sur le groupe témoin, les liens ont probablement aidé. Si les deux augmentent, il s'agit sans doute d'un effet saisonnier ou algorithmique. Si les pages cibles gagnent des impressions mais pas de clics, le levier suivant est le titre et le contenu, pas plus de liens. Et si rien ne bouge après 12 semaines, vérifiez les bases : les liens sont-ils dans le HTML brut, et les cibles sont-elles vraiment indexées ?
Par où commencer aujourd'hui
Vous n'avez pas besoin d'un gros outil pour démarrer. Choisissez un cluster de 20 à 50 pages, crawlez-le, listez ses orphelines et ses pages prioritaires, construisez une banque d'ancres à partir de la Search Console, et ajoutez des liens en une seule vague relue. Mesurez pendant six semaines, transformez ce que vous avez appris en règles, puis passez au cluster suivant.
Si vous publiez souvent, le gain le moins coûteux est le maillage à la rédaction : chaque nouvel article devrait sortir de l'éditeur avec des liens vers les bonnes pages. C'est ce que fait Sorank quand il rédige et publie des articles pour vous, et son générateur de clusters thématiques planifie les clusters que suivent ces liens, avec une protection contre la cannibalisation intégrée. Pour les pages plus anciennes, combinez-le avec un rattrapage relu selon la méthode ci-dessus.
Questions fréquentes
Le maillage interne automatisé est-il sans risque pour le SEO ?
Oui, tant que les liens sont pertinents, utilisent des ancres descriptives et restent dans des plafonds raisonnables. La documentation de Google demande des liens explorables avec un texte d'ancre descriptif et met en garde contre l'excès de liens, pas contre l'automatisation elle-même. Le risque vient des outils qui relient chaque occurrence d'un mot-clé avec la même ancre : gardez une étape de validation et journalisez chaque lien automatique.
Combien de liens internes un article doit-il contenir ?
Google dit qu'il n'existe pas de nombre idéal. Un point de départ pratique est de 3 à 5 liens contextuels automatiques dans un article de 1500 mots, en plus des liens placés par le rédacteur, avec un lien par cible et de l'espace entre les liens. Mesurez sur vos propres pages et ajustez : une étude de corrélation de Zyppy a observé des gains jusqu'à environ 40 liens internes entrants par URL, puis une inversion vers 45 à 50.
Le maillage interne automatisé remplace-t-il une stratégie de maillage interne ?
Non. L'automatisation exécute une stratégie : elle trouve des candidats, insère les liens et les tient à jour. Vous devez toujours décider quelles pages prioriser, quelle architecture les liens doivent suivre (maillage libre, cocon sémantique ou silo) et quelles ancres appartiennent à quelle page.
y!
Recevez gratuitement votre plan de contenu pour 30 jours
Nous analysons vos concurrents, votre site et votre visibilité dans les IA pour créer gratuitement un plan de contenu sur mesure.
“J'ai testé Sorank sur un vrai site client et c'est dingue. Il fait tout ce qu'une agence facture 1'500€ par mois. Là, ça part en production sur ce client.”Guillaume Guersanguersanguillaume.com
“Nous sommes une agence Ads et nous voulions remettre notre SEO sur les rails une bonne fois pour toutes. Sorank nous a donné une vue claire de notre site, nous a aidés à prioriser les optimisations et à structurer correctement notre contenu. L'outil est facile à utiliser, bien pensé pour une équipe et très pratique pour centraliser le suivi sans avoir à jongler entre plusieurs plateformes. Une base très solide pour repartir à zéro avec notre SEO.”Gaspard MadouiAgence Publicitaire
Dominiqueflight-sensations-idf.comLoisirs et aviation
“J'ai simplement laissé le logiciel Sorank faire son travail, et aujourd'hui mon DR est de 25 et ma page se positionne mieux.”Lucas Flandrefoundertrace.fr
“Je me suis spécialisée en GEO grâce à Sorank. Le GEO Leaderboard me permet de montrer à mes clients leur positionnement vs leurs concurrents sur ChatGPT. C'est un vrai différenciateur commercial.”MélanieSEO indépendant
“Excellent service, fonctionne bien pour notre site web et nous aide à comprendre comment l'améliorer pour mieux nous positionner sur Google et ailleurs. Félicitations, continuez, je vous le recommande.”Hugo T.Marchand en ligne