設定
当社はプライバシーを重視しており、ウェブサイトの基本機能に必要のない特定のストレージを無効にするオプションを提供しています。カテゴリーをブロックすると、ウェブサイトでの体験に影響が出る可能性があります。詳細はこちら
当社はプライバシーを重視しており、ウェブサイトの基本機能に必要のない特定のストレージを無効にするオプションを提供しています。カテゴリーをブロックすると、ウェブサイトでの体験に影響が出る可能性があります。詳細はこちら

自動内部リンクの仕組みを理解し、6つの手法を比較。手順に沿って設定し、自動リンクをスパムに変えてしまうよくある失敗を避けましょう。
ツール

要点
自動内部リンクとは、サイト内のページ同士のリンクを1本ずつ手作業で張るのではなく、ソフトウェアに見つけさせ、提案させ、挿入させることです。面倒な作業(クロール、トピックのマッチング、孤立ページの発見、すべてのリンクの記録)を機械に任せ、ルール(どのページを強化するか、どのアンカーを許可するか、1ページに何本まで張るか)は自分で管理する、という形でうまく機能します。目に入ったキーワードをすべてリンクするプラグインとしてではなく、「提案、承認、公開、測定」の流れとして設定しましょう。
さらに詳しく知るには、こちらに質問
クイック診断
あなたに最適なオンライン集客の方法は?
Sorankはあなたの回答にぴったりです


ご自身のサイトで3日間お試しいただき、Google、ChatGPT、その他のAIでの現状をご確認ください。
3日間の無料トライアルを開始3日間無料、いつでも解約できます。90日間成果保証(条件あり)。
内部リンクとは、自分のサイトのあるページから同じサイトの別のページへ張るリンクです。内部リンクには3つの役割があります。クローラーにページを発見させること、アンカーテキストと周辺の文章を通じてリンク先ページの内容を検索エンジンや AI に伝えること、そして強いページから弱いページへ評価を渡すことです。基本がまだあいまいなら、まず内部リンクの定義をご覧ください。
自動化とは、プログラムが次のタスクのうち1つ以上を担うことを指します。
逆に、同じキーワードのリンクを500ページに詰め込む手段でも、サイト構造の代わりでも、全記事の下に出る「関連記事」ウィジェットでもありません。これらは自動化の一部にはなり得ますが、それ単体ではほとんどノイズしか生みません。
手作業のリンクは30ページのサイトなら問題ありません。しかし毎週記事を公開するサイトでは、単純な理由で破綻します。新しい記事が1本増えるたびに、仕事が2つ発生するからです。新記事から既存ページへリンクを張ること、そして既存ページから新記事へリンクを張り返すことです。忘れられがちなのは後者です。2年も公開を続けると、誰からもリンクされていない最近の記事と、すでに差し替えたページを指し続ける古い記事が残ります。
自動化の前と後の内部リンク
この記事では仕組みそのもの、つまり手法、設定、動くスクリプト、失敗パターンを扱います。戦略面(どのページを優先するか、多言語サイトのリンクをどう設計するか)については、先に内部リンク戦略の専門ガイドをお読みください。2つの記事はセットで使えるように書いています。
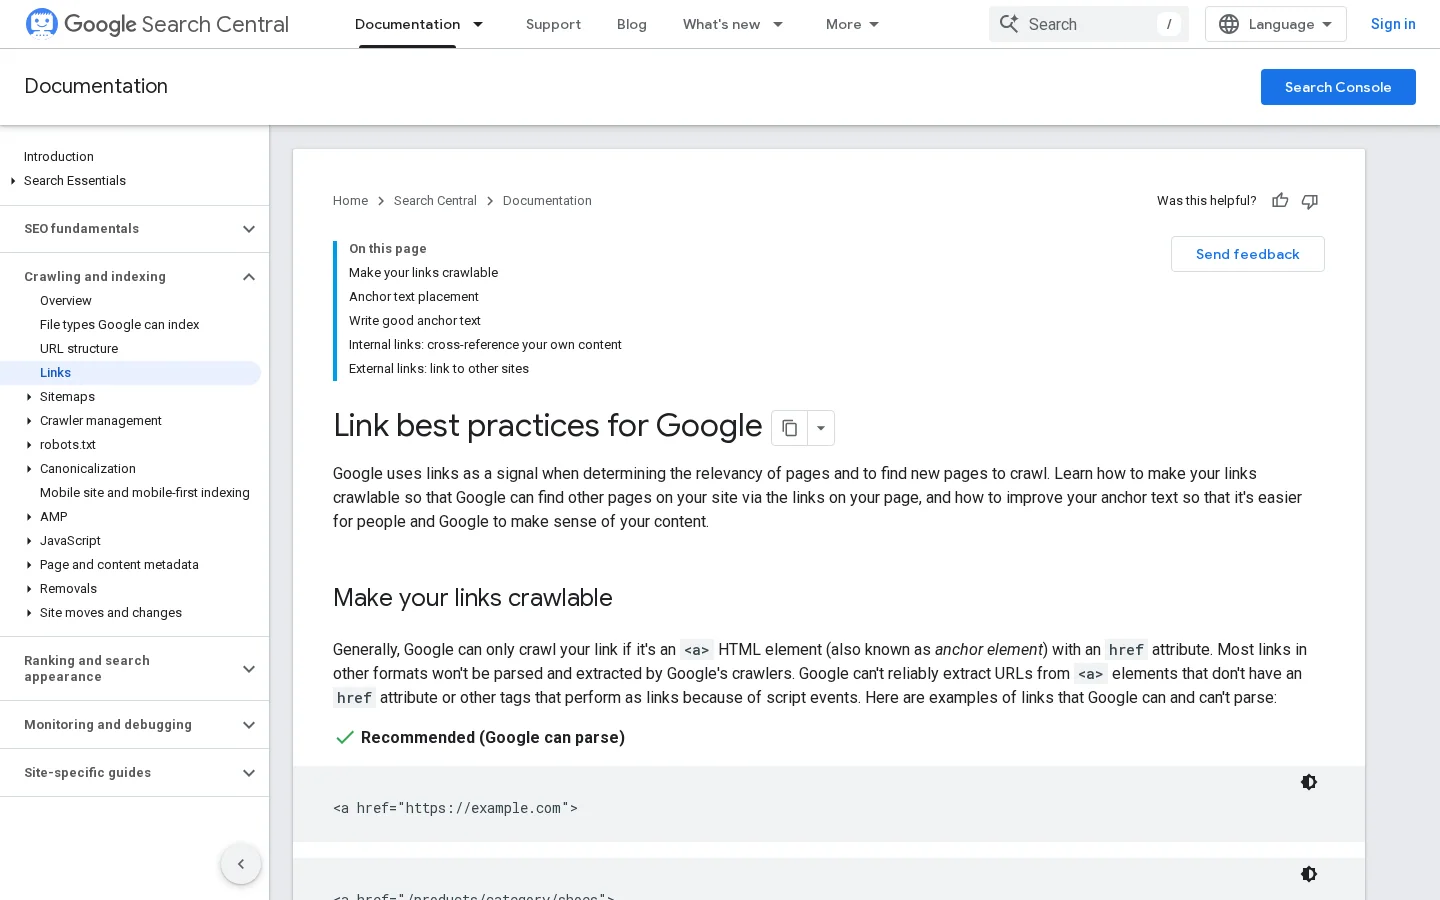
最低限のラインについて、Google ははっきり述べています。リンクに関するベストプラクティスのドキュメントには「重要なページには、サイト内の少なくとも1つの他のページからリンクを張る必要があります」とあり、Google がリンクをクロールできるのは、基本的に href 属性を持つ <a> 要素の場合だけです。孤立ページが禁止されているわけではありませんが、発見と理解をサイトマップだけに賭けることになります。
最低限を超えた部分で、このテーマについて最も参考になる公開データは、Zyppy の Cyrus Shepard による相関調査「23 Million Internal Links: SEO Case Study」(2026年2月更新)です。約1800サイトの内部リンクデータを Search Console のクリック数と照合しています。
2300万本の内部リンクからわかること
出典:Cyrus Shepard、Zyppy、23 Million Internal Links SEO Case Study、2026年2月更新
自動化にとって最も役立つのは、リンク数に関する発見です。内部リンクが0〜4本の URL は Google から平均2クリックしか得ていないのに対し、40〜44本の URL はその4倍を得ていました。約45〜50本を超えると効果は逆転します。著者はこの低下の多くをサイト全体のナビゲーションリンクによるものとし、相関調査であること、つまり方向性の参考にはなるが証明ではないことを慎重に強調しています。
ここから実務上の教訓が2つ得られます。1つ目は、リンクが足りないページほど伸びしろが大きく、それを見つけるのは自動化の得意分野だということ。2つ目は、アンカーの多様性がクリック数と相関し、URL アンカーや完全一致アンカーを持つページの成績が良かったことです。すべてのページを同じ3語でリンクするシステムは、この多様性を捨てていることになります。
GPTBot、ClaudeBot、PerplexityBot などの AI クローラーは、Googlebot と同じく <a href> リンクをたどってページを発見します。その多くは JavaScript を実行しないため、クライアント側で挿入したリンクは彼らにとって存在しないかもしれません。各ボットが何を取得するかは、AI クローラーのガイドで解説しています。サーバー側でレンダリングされたきれいな内部リンクは、検索エンジンにも、あなたのページを引用する AI エンジンにも役立ちます。
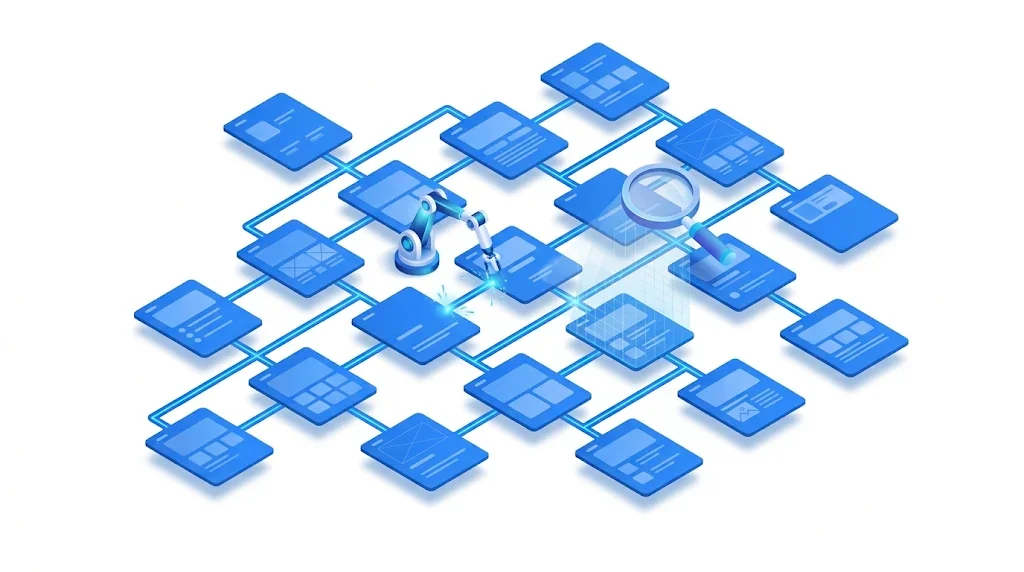
本格的なツールは、プラグインでも SaaS でも自作スクリプトでも、同じパイプラインで動いています。これを知っていれば、各ステップをどう処理しているかを聞くだけで、5分でツールを評価できます。
内部リンクエンジンの6ステップのパイプライン
棚卸しでは、本文とテンプレートを分ける必要があります。ヘッダーメニューのリンクは全ページに表示されるので、リンク先について Google にほとんど情報を与えません。一方、関連記事の第3段落にあるリンクは多くを伝えます。優れたエンジンは分析前に nav、header、footer、aside を取り除き、記事本文にだけ挿入します。また、インデックス対象外の URL も除外します。リダイレクト、404、noindex、別ページを指す canonical を返すものはすべて対象外です。
代表的な表現方法は3つあり、粗いものから細かいものへ並べると次のとおりです。
埋め込みを使う場合、マッチングはベクトル間のコサイン類似度で行います。スコアは-1から1の間(テキストでは実質0から1)です。しきい値を超えた組み合わせと、ページごとの上位 N 件を残します。最も重要な設定はしきい値です。低すぎると、ヘビのニシキヘビ(Python)のページをプログラミング言語 Python のページにリンクしてしまい、高すぎると、ほぼ重複したページしか見つかりません。汎用モデルなら0.5〜0.6あたりから始め、提案を50件手作業で確認してから調整しましょう。
アンカーは、リンク元の文にすでにあるフレーズにすべきです。新しい言葉を足すのは本文の書き換えであり、別の作業です。エンジンはリンク元の本文から、リンク先を説明するフレーズを探します。リンク先のメインキーワード、H1、近い言い換え、あるいはリンク先がすでに Search Console で順位を得ているクエリです。最後のものが最良の情報源です。実際のユーザーがそのページをどう表現しているかを反映しているからです。
品質を左右するのはルールです(後述の専用セクションを参照)。挿入場所は3つのうちいずれかです。保存されたコンテンツの中(リンクが記事の一部になり、恒久的でエディタでも見える)、サーバー側のレンダリング時(ページ生成時にフィルターがリンクを追加し、元に戻しやすい)、ブラウザ上の JavaScript(SEO にとって最も弱い選択肢)。どの方法でも、自動リンクの記録は必須です。記録がなければ、監査も測定も取り消しもできません。
「自動内部リンク」と一口に言っても、技術はまったく異なります。多くのサイトは最終的に2つか3つを組み合わせています。
原理:「フレーズとリンク先 URL」の対応表を管理し、そのフレーズが現れた場所に自動でリンクを張ります。使いどころ:用語集、製品名、少数の収益ページ。長所:予測しやすく、透明で、低コスト。短所:文脈を理解しない、どこでも同じアンカーになる、対応表が古くなる。例:各記事で「クロールバジェット」が最初に出たときだけ、クロールバジェットの用語ページへリンクする(1記事1本まで)。
原理:CMS がサイト構造からリンクを生成します。パンくずリスト、カテゴリー一覧、「関連記事」、前後の記事、子ページを一覧にするハブページなどです。使いどころ:常に。これが土台の層です。長所:メンテナンス不要で、カテゴリー内のページが孤立しないことを保証する。短所:テンプレートリンクは文脈が乏しく、「関連記事」モジュールは意味ではなく日付やタグで選ぶことが多い。例:全記事に表示されるパンくず「ブログ > SEO > 内部リンク」。
原理:埋め込みで関連ページとアンカー候補を見つけ、編集者が提案を1件ずつ承認または却下します。使いどころ:記事数が約50本から数千本のコンテンツサイト。長所:文脈を理解し、人の判断が入り、アンカーが自然にばらける。短所:レビューに時間がかかり、品質はしきい値次第。例:「キーワードカニバリゼーション」の記事を公開すると、すでに本文でカニバリゼーションに触れている過去記事5本をツールが提案する。
原理:各ページからエンティティを抽出し、サイト内でそのエンティティの基準となるページへリンクします。使いどころ:ブランド、地名、人物、食材、ソフトウェアなど固有の対象が多いサイト。長所:曖昧さの解消に強く、「1エンティティ1ページ」の整理された対応表ができる。短所:エンティティとページの対応表が必要で、抽象的なテーマには弱い。例:旅行サイトで「京都」への言及はすべて京都ガイドにリンクし、京都のホテルページにはリンクしない。
原理:サイトをグラフとして扱います。ツールは各ページの内部スコア(PageRank に似た指標)、トップページからのクリック深度、被リンク数を計算し、優先ページへ評価を流し、深い階層のページを浅い位置へ引き上げるリンクを提案します。使いどころ:大規模サイト、EC、ビジネス上重要なページが埋もれているサイト。長所:関連性だけでなく、目的に対して最適化できる。短所:モデルは Google によるリンク評価の近似にすぎず、関連性フィルターと組み合わせないと、純粋なグラフのロジックが無関係なリンクを生むことがある。例:クリック深度5のカテゴリーページが、関連クエリで上位の強いガイド3本からリンクを得て、深度2に上がる。
原理:サイトのページ一覧を手元に持った書き手や AI ライティングツールが、原稿を書く時点でリンクを配置します。使いどころ:定期的に記事を公開するすべてのサイト。長所:リンクのために書かれた文の一部になるので、アンカーが自然に読める。短所:新しいページからの発リンクは処理できるが、過去のページからの被リンクは処理しないため、バックフィルの手法と組み合わせる必要がある。例:Sorank の AI ブログ記事ジェネレーターは、サービス、製品、カテゴリーの各ページへの内部リンクをあらかじめ入れた状態で記事を書きます。
| 手法 | 関連性 | 運用の手間 | アンカーの質 | 設定ミス時のリスク | 向いているケース |
|---|---|---|---|---|---|
| ルールベースのキーワード自動リンク | 低 | 低 | 単調 | 高(キーワードの詰め込み) | 用語集、製品名 |
| 構造・テンプレートモジュール | 中 | 非常に低 | 汎用的 | 低 | すべてのサイトの土台 |
| 承認つきセマンティック提案 | 高 | 中(レビュー) | 自然で多様 | 低 | ブログ、コンテンツハブ |
| エンティティベースのリンク | 固有の対象では高 | 中 | 正確 | 中 | 旅行、EC、カタログ |
| グラフ駆動(内部 PageRank) | ばらつきあり | 高(分析) | フィルター次第 | 中 | 大規模サイト、埋もれた収益ページ |
| 執筆時のリンク | 高 | 低 | 最も自然 | 低 | 更新頻度の高いサイト |
何かを設定する前に、リンクで描きたい形を決めましょう。Wikipedia 型のメッシュは、あらゆるページを関連するあらゆるページにつなぎます。セマンティックツールの標準的な出力で、百科事典的なコンテンツに向いています。セマンティックコクーンは、同じトピックツリーのページ同士にリンクを限定し、親ページは下へ、子ページは上と横へリンクします。ルールで、最上位を除くコクーン間のリンクを禁止する必要があります。URL サイロはフォルダ構造(/guides/seo/...)に従います。「同じフォルダ内とハブページにだけリンクする」という単純なルールで実現できます。トピッククラスターとピラーページのガイドで説明しているトピッククラスターは、コクーンとメッシュの中間にあたります。どれを選ぶかはSEO のためのサイト構造の記事で解説しています。
ルールのないリンクエンジンはスパム生成器です。最初に実行する前に書き出しておくべき設定と、出発点として使える値を紹介します。
完全自動の挿入と、提案して承認する方式の比較
見出し、目次、画像のキャプション、引用、CTA ボタン、著者ボックス、既存の <a> の内側(入れ子のリンクは無効な HTML)には絶対に挿入しないでください。ページ自身へのリンク、リダイレクトする URL へのリンク、noindex のページや別 URL に canonical されたページへのリンクも禁止です。
Google のドキュメントは、アンカーテキストを「説明的で、適度に簡潔で、掲載されているページに関連したもの」にするよう求め、「ここをクリック」や「続きを読む」は一般的すぎる例として挙げています。これをルールに置き換えると、アンカーは2〜6語、既存の文から取り、リンク先ごとにサイト全体で少なくとも2〜3種類の言い換えを用意し、1つのアンカーには1つの意図を対応させる、となります。「内部リンクツール」がある記事では無料の分析ツールを、別の記事では有料機能を指していたら、検索エンジンに2つの別の話をしていることになります。アンカーの種類はアンカーテキストのガイドで詳しく解説しています。
設定画面のあるプラグインでもスクリプトでも、ルールはファイルとして書き出しましょう。それがドキュメントになり、監査の記録にもなります。
{
  "global": {
    "max_auto_links_per_page": 5,
    "max_links_per_target_per_page": 1,
    "min_words_between_links": 60,
    "similarity_threshold": 0.55,
    "insert_only_in": ["article .content"],
    "skip_selectors": ["h1", "h2", "h3", "h4", "a", "figcaption", "blockquote", ".toc", ".cta", "nav", "footer"],
    "skip_targets_if": ["redirect", "noindex", "canonical_elsewhere", "status_not_200"],
    "mode": "suggest"
  },
  "priority_targets": [
    {"url": "/pricing", "boost": 1.5},
    {"url": "/guides/internal-linking-strategy", "boost": 1.3}
  ],
  "rules": [
    {"phrase": "crawl budget", "target": "/glossary/crawl-budget", "max_site_uses": 40, "mode": "auto"},
    {"phrase": "topic cluster", "target": "/glossary/topic-cluster", "max_site_uses": 40, "mode": "auto"}
  ],
  "never_link": ["/legal", "/login", "/cart"]
}
ヒント
新しいルールはすべて「suggest」モードで始めましょう。そのルールの提案を、修正なしで20件続けて承認できたら「auto」に切り替えます。
この手順はツールに関係なく使えます。数百ページのサイトなら初期設定に1日、その後は週に1時間ほどを見込んでください。
Screaming Frog などのデスクトップクローラーでサイト全体をクロールします(設定方法は Screaming Frog 設定ガイドで解説しています)。インデックス対象の各 URL について、被内部リンク数(ユニーク)、クリック深度、発リンク、クローラーの内部リンクスコアをエクスポートします。クロール結果を XML サイトマップと比べ、サイトマップにあるのにクロールで見つからなかった URL が孤立ページです。このエクスポートを日付つきで保存しておきましょう。これが「導入前」の記録になります。
すべてのページにリンクを増やす価値があるわけではありません。優先対象の短いリストを作ります。売上につながるページ、価値の高いクエリで5〜20位にいるページ(Search Console の検索パフォーマンス レポートで掲載順位を絞り込む)、そしてコーナーストーンコンテンツです。さらに、すべての孤立ページと、トップから4クリック以上深いページを加えます。このリストがルールの「priority_targets」になります。
優先対象ごとに、アンカーフレーズを3〜10個集めます。最良の情報源は Search Console です。検索パフォーマンス レポートでそのページを開き、「クエリ」タブに切り替え、すでに表示回数のあるクエリをエクスポートします。H1、メインキーワード、自然な言い換えも加えます。曖昧なものや、他のページと共有しているものは除外します。
ツールまたはスクリプトを実行します。リンク先ごとに、本文にアンカーが登場し、トピックが十分近いリンク元ページが返ってくるはずです。ファネルが大きく絞られることを想定してください。それはフィルターが機能している証拠です。
リンク候補はこう絞り込まれる
リンク元、リンク先、アンカー、文、スコアの5列のスプレッドシートで提案を確認します。アンカーだけでなく、文全体を読んでください。自分なら書かないと思うものは却下します。却下の理由(意味が違う、宣伝色が強すぎる、近くにすでにリンクがある)を記録しておけば、それが新しいルールになります。
1回あたり50〜200本のリンクを、追跡できるページ群に公開します。新しいリンクを入れない似たページを対照群として残しておきます。順位はさまざまな理由で動くので、クリック数の変化に比較の基準を持たせることが重要です。
サイトを再クロールします。新しいリンクが JavaScript 実行後だけでなく、生の HTML に <a href> として存在することを確認します。いくつかの URL については、Search Console の URL 検査ツールで Google が見ているレンダリング後の HTML を確認しましょう。
本当の効果は継続運用から生まれます。記事を公開するたびに、システムは2つのことを行うべきです。新しい記事から外へリンクする(執筆時)ことと、過去のページから新記事へのリンクを提案する(バックフィル)ことです。URL が変わるたびに、そこを指すリンクを更新または削除します。
ヒント
1ページをすばやく確認したいときは、URL を無料の内部リンク分析ツールに貼り付けてください。ページ上のすべての内部リンクとアンカー、属性が一覧表示されるので、自動リンクが予定どおり公開されたかを確認できます。
CMS に良いツールがない場合や、ベンダーが何をしているのか正確に理解したい場合、動くプロトタイプは60行ほどで書けます。このバージョンはサイトマップを読み込み、本文を抽出し、オープンソースのモデルで埋め込みを計算し、人がレビューするための提案を CSV で出力します。サイト自体には一切手を加えません。
pip install requests beautifulsoup4 sentence-transformersimport csv, re
from urllib.parse import urljoin
import requests
from bs4 import BeautifulSoup
from sentence_transformers import SentenceTransformer, util
SITEMAP = "https://example.com/sitemap.xml"
urls = re.findall(r"<loc>(.*?)</loc>", requests.get(SITEMAP, timeout=20).text)
pages = {}
for url in urls:
r = requests.get(url, timeout=20)
if r.status_code != 200 or r.url != url:
continue # skip errors and redirects
soup = BeautifulSoup(r.text, "html.parser")
robots = soup.find("meta", attrs={"name": "robots"})
if robots and "noindex" in robots.get("content", ""):
continue
main = soup.find("article") or soup.find("main") or soup.body
for tag in main.find_all(["nav", "header", "footer", "aside", "script", "style"]):
tag.decompose()
pages[url] = {
"h1": soup.h1.get_text(" ", strip=True) if soup.h1 else "",
"text": main.get_text(" ", strip=True),
"links": {urljoin(url, a["href"]).split("#")[0] for a in main.find_all("a", href=True)},
}model = SentenceTransformer("all-MiniLM-L6-v2")
keys = list(pages)
docs = [pages[u]["h1"] + ". " + pages[u]["text"][:2000] for u in keys]
emb = model.encode(docs, normalize_embeddings=True)
sim = util.cos_sim(emb, emb)
# Anchor bank: target URL -> phrases (H1 + queries exported from Search Console)
anchors = {u: [pages[u]["h1"].lower()] for u in keys}
# anchors["https://example.com/crawl-budget"] += ["crawl budget", "crawl budget optimization"]
THRESHOLD, MAX_PER_PAGE = 0.55, 5
def find_anchor(text, phrases):
for phrase in sorted(phrases, key=len, reverse=True):
if len(phrase.split()) < 2:
continue
m = re.search(r"\b" + re.escape(phrase) + r"\b", text, re.IGNORECASE)
if m:
start = max(0, m.start() - 120)
return m.group(0), text[start:m.end() + 120]
return None, None
rows = []
for i, src in enumerate(keys):
added = 0
for j in sorted(range(len(keys)), key=lambda k: -float(sim[i][k])):
score = float(sim[i][j])
if score < THRESHOLD or added == MAX_PER_PAGE:
break
tgt = keys[j]
if tgt == src or tgt in pages[src]["links"]:
continue
anchor, context = find_anchor(pages[src]["text"], anchors[tgt])
if anchor:
rows.append([src, tgt, anchor, round(score, 2), context])
added += 1
with open("link_suggestions.csv", "w", newline="", encoding="utf-8") as f:
csv.writer(f).writerows([["source", "target", "anchor", "score", "context"]] + rows)コードを書かなくても、クローラーで作業の一部はこなせます。Screaming Frog では、Custom Search 機能で特定のフレーズを含む全ページを見つけ、XPath を使った Custom Extraction で特定のリンク先へのリンク数を数えられます。フレーズを含むのにリンク先へのリンクが0本のページが候補です。SEO Spider ユーザーガイドでは Link Score についても「内部リンクに基づいてページの相対的な価値を計算する、0から100の指標」と説明しており、クロール後にクロール分析(crawl analysis)を実行する必要があります。
count(//article//a[contains(@href, "/guides/internal-linking-strategy")])
自動リンクの問題の多くはペナルティではありません。無駄なリンク、紛らわしいシグナル、機械が書いたように読めるページです。それぞれの見つけ方と直し方を紹介します。
何が起きるか:上限を設定していないルールベースのプラグインが、400ページで「SEO 監査」を同じアンカーで同じページへリンクする。見つけ方:クローラーのアンカーテキストのエクスポートで内部アンカーを出現回数順に並べます。1つのフレーズが数百回、まったく同じ形で1つの URL を指していればそれが兆候です。直し方:ルールごとにサイト全体での使用上限を設け、リンク先ごとに最低2種類の言い換えを求め、トピックに軽く触れているだけのページからはリンクを外します。
何が起きるか:単語は一致しても意味が違う(果物の「アップル」が iPhone の記事に、インドネシアの「ジャワ島」がプログラミング言語 Java のチュートリアルにリンクされる)。見つけ方:毎月、自動リンクを30本ランダムに抜き出し、文全体を読みます。直し方:類似度のしきい値を上げ、フレーズの一致とトピックの一致の両方を条件にし、曖昧なルールには除外キーワードを追加します。
何が起きるか:エンジンが60語の段落に4本のリンクを詰め込む。読者はクリックしなくなり、文章も読みにくくなります。見つけ方:本文100語あたりのリンク数を計算し、3本を超えたら確認します。直し方:自動リンク同士の最小間隔と、書き手が張ったリンクも含めた1ページあたりの上限を設定します。
何が起きるか:H2、目次、既存のアンカーの中で一致したフレーズに新しいリンクがかかり、入れ子の <a> タグや青い見出しができる。見つけ方:いくつかのページを HTML バリデーターにかけるか、クロール結果からリンクを含む見出しを検索します。直し方:禁止セレクターを明示し、新しいルールを入れるたびにステージング環境のコピーで試します。
何が起きるか:フロントエンドのウィジェットがページ読み込み後にリンクを挿入する。href がない場合や、スクロールやクリックの後にしか現れない場合もあります。見つけ方:生の HTML(ページのソース)とレンダリング後の DOM を比べ、Search Console の URL 検査でレンダリング後の HTML を確認します。直し方:挿入をサーバー側か保存済みコンテンツに移します。レンダリングについては JavaScript SEO のガイドで詳しく解説しています。
注意
AI クローラーの多くは JavaScript をまったく実行しません。スクリプト実行後にしか現れないリンクは、レンダリング後の Googlebot には見えても、ChatGPT、Claude、Perplexity にデータを供給するボットには見えないことがあります。
何が起きるか:古いページ一覧をもとに作られた自動リンクが、移転や削除済みの URL を指し続ける。見つけ方:クロール結果で内部リンクをステータスコード(3xx、4xx)とインデックス対象外のリンク先で絞り込みます。1ページだけなら無料のリンク切れチェッカーで確認できます。直し方:実行のたびにページ一覧を更新し、200を返し、インデックス可能で、自分自身を canonical にしているリンク先だけを受け付け、301を作成したときはその場でリンクを更新します。
何が起きるか:全記事の最後に関連記事が3本並んでいるので、内部リンクは十分だと思い込む。こうしたブロックはタグや日付で選ばれ、入れ替わり、古いコンテンツをまったく拾わないことがよくあります。見つけ方:孤立ページのレポート(サイトマップにあるのにクロールで到達しない、またはページネーション経由でしか到達しない URL)がいつまでも長いままです。直し方:ウィジェットは残しつつ、本文中に文脈のあるリンクを、ハブページから固定のリンクを追加します。
何が起きるか:「内部リンクツール」がある記事ではページ A、別の記事ではページ B にリンクしている。関連性のシグナルが分散し、キーワードカニバリゼーションを招くことがあります。見つけ方:クロール結果からアンカーとリンク先の対応表を作り、リンク先が複数あるアンカーを洗い出します。直し方:1つの検索意図には1つのリンク先ページ。弱いほうのページのアンカーを付け替えます。
何が起きるか:プラグインがコンテンツにリンクを挿入した後でアンインストールされた、あるいはどのリンクが自動なのか誰も分からない。見つけ方:「先月ツールは何本のリンクを追加したか」に答えられません。直し方:自動リンクをすべてテーブル(リンク元、リンク先、アンカー、ルール、日付、ステータス)に保存し、技術的に可能なら HTML に data 属性で印をつけ、1つのルールによるリンクを一括で削除できることを確認しておきます。
| 失敗 | 探すべき兆候 | 直し方 |
|---|---|---|
| 出現するたびにリンク | 1つのアンカーが数百回、同じ URL を指す | サイト全体の上限、アンカーの言い換え |
| 意味の取り違え | 手作業のサンプルに不自然な文がある | しきい値を上げる、除外キーワード |
| リンク密度 | 100語あたり3本超 | 語数の間隔、ページごとの上限 |
| 禁止ゾーン | 見出し内のリンク、入れ子のアンカー | 明示的な除外セレクター |
| JavaScript だけのリンク | ページのソースにリンクがない | サーバー側での挿入 |
| 無効なリンク先 | クロールで 3xx や 4xx の内部リンク | 一覧の更新、200 のリンク先のみ |
| ウィジェット頼み | 孤立ページのリストが長い | 文脈リンクとハブからのリンク |
| 1アンカーに2リンク先 | アンカー対応表に重複 | 1意図1ページ |
| 記録なし | 自動リンクの本数を数えられない | リンク表、data 属性、ロールバック |
内部リンクで一夜にして順位が跳ね上がることはまずありません。リンクを受けたページを対照群と比べ、4〜12週間かけて測定します。
リンクを公開するたびに追跡する項目
Search Console のリンク レポートには「上位のリンクされているページ(内部リンク)」が表示され、各ページについてリンク元のページも確認できます。優先ページが上位にあるかといった健全性チェックには役立ちますが、Google のヘルプページには、表は1000行までに制限され、このレポートは「サイト上のすべてのリンクを網羅したリストではない」と記載されています。正しい数値の根拠には自分のクロール結果を使い、Search Console は Google が実際に何を拾ったかを見るために使いましょう。
サーバーログにアクセスできるなら、リンクを公開した後に Googlebot や AI クローラーが新たにリンクされたページを訪れる頻度が増えたかが分かります。発見が改善したことを示す最も直接的なシグナルです。ボットの絞り込み方やクロール頻度の読み方、大規模サイトのクロールバジェットにとってなぜ重要かは、SEO のためのログファイル分析のガイドで解説しています。
リンク先ページの表示回数が増え、対照群は変わらなければ、リンクが効いた可能性が高いです。両方が増えたなら、季節要因かアルゴリズムの影響でしょう。表示回数は増えたのにクリックが増えないなら、次に手を入れるべきはリンクの追加ではなく、タイトルとコンテンツです。12週間たっても何も変わらなければ、基本を確認してください。リンクは生の HTML にあるか、リンク先は本当にインデックスされているか。
始めるのに大がかりなツールは要りません。20〜50ページのクラスターを1つ選び、クロールし、孤立ページと優先ページを洗い出し、Search Console からアンカーバンクを作り、レビュー済みのリンクを1回分追加します。6週間測定し、学んだことをルールとして書き出してから、次のクラスターへ広げましょう。
頻繁に記事を公開しているなら、最も低コストで効果が出るのは執筆時のリンクです。新しい記事はすべて、正しいページへのリンクを持った状態でエディタを離れるべきです。Sorank が記事を書いて公開するときに行っているのがまさにこれで、トピッククラスタージェネレーターがリンクの従うクラスターを、カニバリゼーション対策を組み込んだうえで設計します。過去のページについては、上で紹介した方法でレビューつきのバックフィルを組み合わせてください。
リンクが関連性を持ち、説明的なアンカーを使い、適切な上限内に収まっていれば安全です。Google のドキュメントはクロール可能なリンクと説明的なアンカーテキストを求め、過剰なリンクに注意を促していますが、自動化そのものは問題にしていません。リスクは、キーワードが出るたびに同じアンカーでリンクするツールにあります。レビューの工程を残し、自動リンクをすべて記録しましょう。
Google は理想的な本数はないとしています。実務上の出発点は、1500語程度の記事で書き手が張ったリンクとは別に自動の文脈リンクを3〜5本、リンク先ごとに1本まで、リンク同士に間隔を空けることです。自サイトのページで測定して調整してください。Zyppy の相関調査では、URL あたりの被内部リンクが約40本までは効果が伸び、約45〜50本を超えると逆転していました。
いいえ。自動化は戦略を実行するものです。候補を見つけ、リンクを挿入し、最新の状態に保ちます。どのページを優先するか、リンクがどの構造(メッシュ、セマンティックコクーン、サイロ)に従うか、どのアンカーをどのページに割り当てるかは、引き続き自分で決める必要があります。
競合、あなたのサイト、AIでの可視性を分析し、あなた専用のコンテンツプランを無料で作成します。
 AI コンテンツブリーフ生成ツール
 FAQ スキーマ生成ツール
 AI ブログ記事アイデア生成ツール
 構造化データ検証ツール(スキーマバリデーター)
 代替テキストチェッカー
 内部リンク分析ツール
 被リンクチャレンジ
 AI メタディスクリプション生成ツール
 AI ブログタイトル生成ツール
 Google インデックス可否チェッカー
 AI 記事構成案生成ツール
 UTM リンク作成ツール
 キーワードのグループ化ツール
 canonical タグチェッカー
 XML サイトマップ生成ツール
 リンク切れチェッカー
 AI SEO タイトル生成ツール
 見出しアナライザー
 検索結果プレビューツール
 リダイレクトチェッカー
 hreflang タグ生成ツール
 見出し構造チェッカー
 HTTP ヘッダーチェッカー
 Favicon 抽出ツール
 SEO トラフィック・売上予測計算ツール
 SEO 予算計算ツール
 順位上昇シミュレーター
 キーワード機会スコア計算ツール
 GEO コンテンツ投資計算ツール
 顧客生涯価値計算ツール
 CTR 計算ツール
 AI トラフィック価値計算ツール
 AI シェア・オブ・ボイス計算ツール
 Gemini ランキングツール
 ROAS 計算ツール
 自然検索トラフィック価値計算ツール
 ローカル SEO ROI 計算ツール
 被リンク獲得コスト計算ツール
 キーワード密度計算ツール
 顧客獲得コスト計算ツール
 記事単価計算ツール
 直帰率計算ツール
 AI 引用率計算ツール
 LLM 向け構造化データ監査
 llms.txt ジェネレーター
 Sitemap チェッカー
 SERP 変動センサー
 文字数カウンター
 Schema マークアップ生成ツール
 キーワード調査ツール
 SEO 損益分岐点計算ツール
 読了時間計算ツール
 自然検索トラフィック予測ツール・サイトのアクセス数チェック
 ChatGPT 参照トラフィック予測ツール
 AI 可視性スコア計算ツール
 AI 可読性チェッカー
 SearchGPT 対応チェッカー
 ChatGPT が自社サイトを推薦しない理由
 URL 抽出ツール
 ウェブページ Markdown 変換ツール
 robots.txt 生成ツール
 Open Graph プレビュー
 オンページ SEO 監査:SEO チェッカーと SEO 分析ツール
 LTV:CAC 比率計算ツール
 GEO ROI 計算ツール
 コンバージョン率計算ツール
 AI クローラー巡回監査
 AI 検索可視性テスト
 ページサイズチェッカー
 URL スラッグ生成ツール
 メタタグ生成ツール
 画像圧縮ツール
 ファビコン生成ツール
 ドメインオーソリティチェッカー
 検索結果 CTR 計算ツール
 EC SEO ROI 計算ツール
 コンテンツマーケティング ROI 計算ツール
 AI での不可視コスト計算ツール
 AI Overviews チェッカーと AI Overviews 順位チェック
 robots.txt チェッカー
 SEO・AI 監査
 Perplexity ランキングチェッカー
 アンサーエンジン最適化の監査
 ChatGPT 可視性チェッカー
 被リンク分析ツール
 SEO とリスティング広告の節約額計算ツール
 SEO シェア・オブ・ボイス計算ツール
 SaaS SEO ROI 計算ツール
 被リンク ROI 計算ツール
 llms.txt バリデーター
 LLM 引用チェッカー
 GEO 監査
 SEO ROI 計算ツール
 キーワード価値計算ツール
5件のレビューで 5/5
 “2年間、クライアントの100%がLinkedIn経由でした。毎日の投稿、コメント、DMでのフォローアップ…完全にアルゴリズム頼みでした。SEOに取り組むべきだとわかっていても、時間がかかる、技術的すぎる、自分の仕事ではないと、いつも後回しにしていました。Sorankでようやく一歩を踏み出しました。4か月で、何も投稿しなくても毎月15件のオーガニックリードを獲得しています。まだLinkedInと半々ではありませんが、自動で育つ2つ目のリード源ができたことで安心して眠れるようになりました。”

 Valentin Thomyoffbound.fr“Sorankは、クライアントに提供する成果を大きく変えてくれました。AIが実際に使っているキーワードを特定し、特定の競合が引用される理由を理解し、以前は完全に見落としていたチャンスを見つけられるようになりました。クライアントは、より早い順位上昇、AIの回答での可視性向上、そしてすべての施策のROIがより明確になったことを実感しています。”
 Benjamin Rouxovirank.com
 “私はマーケターではなく開発者です。私のShopifyテーマは口コミと広告だけで売れていました。Sorankのおかげで、SEOの組み立て方と上位表示される記事の書き方がようやくわかりました。監査で商品ページが遅すぎることも判明しました。2か月でオーガニックトラフィックは2倍になり、ShopifyテーマについてChatGPTで検索されたときの回答にも表示され始めています。しかも、週に約2時間の作業だけです。”
 Thème FullStackgo.themefullstack.com“Sorankのおかげで、私たちのSEOエージェンシーの働き方は大きく変わりました。すべてが一元化・自動化されたため、クライアント1社あたりにかける時間が大幅に減りました。以前は何時間もかかっていた作業が今では数分で終わり、ようやくビジネスの中で働くのではなく、ビジネスそのものに取り組めるようになりました。”
 Océane Bondismaison-leverage.com