La privacy è importante per noi, quindi hai la possibilità di disabilitare alcuni tipi di archiviazione che potrebbero non essere necessari per il funzionamento di base del sito web. Il blocco delle categorie può influire sulla tua esperienza sul sito web. Ulteriori informazioni (Politica sui cookie)
Grazie! La tua richiesta è stata ricevuta!
Ops! Qualcosa è andato storto durante l'invio del modulo.
Link interni automatici: metodi, configurazione e regole per renderli sicuri
Scopri come funzionano i link interni automatici, confronta 6 metodi, segui la configurazione passo passo ed evita gli errori che li trasformano in spam.
Una rete di pagine collegate da link interni, alcuni inseriti automaticamente e controllati da un editor prima della pubblicazione.
Strumenti
In questa pagina
In breve
automatizzare i link interni significa lasciare che un software trovi, suggerisca o inserisca i link tra le tue pagine, invece di posizionarli uno per uno a mano. Funziona bene quando la macchina si occupa della parte noiosa (scansionare, collegare gli argomenti, individuare le pagine orfane, registrare ogni link) e tu mantieni il controllo delle regole: quali pagine spingere, quali anchor consentire, quanti link per pagina. Imposta il processo come «suggerire, approvare, pubblicare, misurare», non come un plugin che trasforma in link ogni parola chiave che incontra.
3 giorni gratis, poi smetti quando vuoi. Garanzia di risultati di 90 giorni, soggetta a condizioni.
Cosa sono i link interni automatici (e cosa non sono)
Un link interno è un link da una pagina del tuo sito a un'altra pagina dello stesso sito. Svolge tre compiti: permette ai crawler di scoprire le pagine, indica ai motori di ricerca e ai sistemi di IA di cosa parla la pagina di destinazione (attraverso l'anchor text e le parole intorno) e trasferisce autorevolezza dalle pagine forti a quelle più deboli. Se le basi sono nuove per te, parti dalla nostra definizione di link interni.
Automatizzare significa affidare a un programma uno o più di questi compiti:
Inventario: scansionare il sito ed elencare ogni pagina, ogni link esistente e ogni anchor.
Abbinamento: decidere quale pagina deve linkare a quale, in base a parole chiave, significato o entità.
Scelta dell'anchor: trovare un'espressione già presente nel testo di origine che descriva la destinazione.
Inserimento: scrivere il link nell'HTML, nel database del CMS o al momento del rendering.
Manutenzione: correggere i link quando cambia un URL, viene eliminata una pagina o viene pubblicato un nuovo articolo.
Cosa non è: un modo per infilare lo stesso link su una parola chiave in 500 pagine, un sostituto dell'architettura del sito o un widget «articoli correlati» in fondo a ogni articolo. Questi elementi possono far parte di un sistema automatizzato, ma da soli producono soprattutto rumore.
Perché i link manuali smettono di funzionare
I link manuali funzionano su un sito di 30 pagine. Falliscono su un sito che pubblica ogni settimana, per un motivo semplice: ogni nuovo articolo crea due compiti. Ha bisogno di link verso pagine esistenti, e le pagine più vecchie hanno bisogno di link verso di lui. Il secondo compito è quello che tutti dimenticano. Dopo due anni di pubblicazioni ti ritrovi con articoli recenti verso cui nessuno linka e articoli vecchi che puntano ancora a pagine che nel frattempo hai sostituito.
I link interni prima e dopo l'automazione
Prima (manuale)
I nuovi articoli ricevono link in uscita, raramente in entrata
Le pagine orfane si accumulano senza che nessuno se ne accorga
Ci sono link verso redirect e URL eliminati
Gli anchor dipendono da chi ha scritto l'articolo
Dopo (automatizzato, con revisione)
Ogni nuova pagina riceve link da pagine correlate
Le orfane vengono segnalate a ogni scansione
Le destinazioni rotte o reindirizzate vengono aggiornate
Gli anchor seguono regole scritte e vengono registrati
Questo articolo si concentra sulla meccanica: metodi, impostazioni, uno script funzionante e i casi di errore. Per la parte strategica (quali pagine privilegiare, come pianificare i link di un sito multilingue), leggi prima la nostra strategia esperta di link interni. I due articoli sono pensati per essere usati insieme.
Perché conta: cosa dicono i dati sui link interni
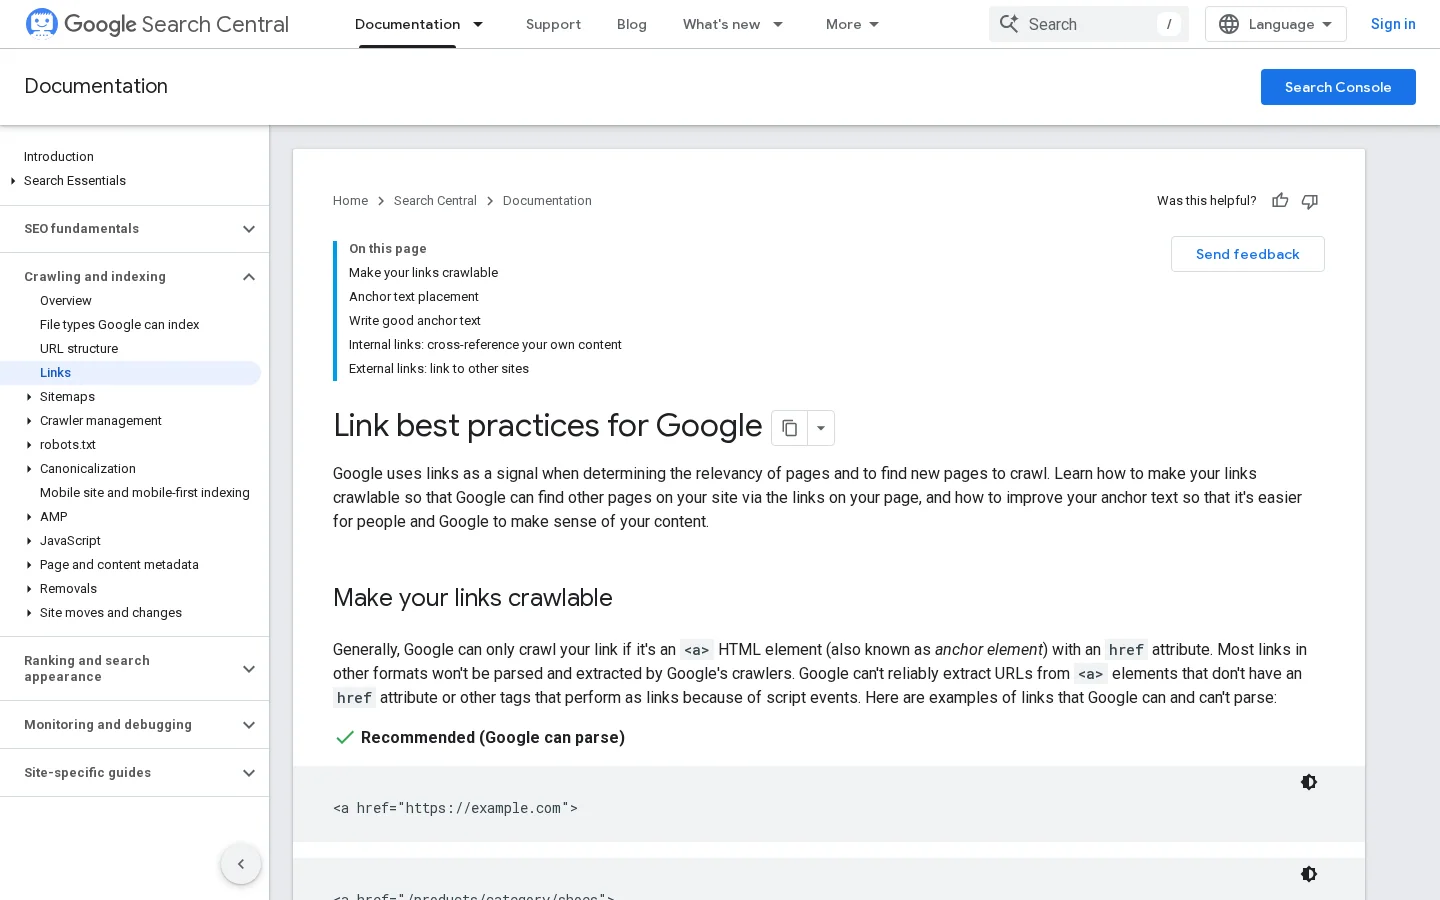
Google è chiaro sul minimo indispensabile. La sua documentazione sulle best practice per i link afferma che «ogni pagina che ti interessa dovrebbe avere un link da almeno un'altra pagina del tuo sito», e che in genere Google può scansionare un link solo se è un elemento <a> con un attributo href. Una pagina orfana non è vietata, ma scommetti solo sulla sitemap perché venga trovata e capita.
Oltre il minimo, il miglior set di dati pubblico sull'argomento è uno studio di correlazione di Cyrus Shepard di Zyppy, «23 Million Internal Links: SEO Case Study» (aggiornato a febbraio 2026). Incrocia i dati sui link interni di circa 1800 siti con i clic di Search Console.
Cosa rivelano 23 milioni di link interni
23 milionilink interni analizzati su circa 520000 URL
1800siti nel set di dati, incrociati con i clic di Google Search Console
5xalmeno cinque volte più traffico per le pagine con almeno un anchor interno a corrispondenza esatta
6%oltre il 6% di tutti i link interni non aveva alcun anchor text
Fonte: Cyrus Shepard, Zyppy, 23 Million Internal Links SEO Case Study, aggiornato a febbraio 2026
Il risultato più utile per l'automazione riguarda il volume. Gli URL con 0 a 4 link interni ricevevano in media 2 clic da Google, mentre quelli con 40 a 44 link interni ne ricevevano quattro volte tanti. Oltre circa 45 a 50 link, l'effetto si inverte. L'autore attribuisce gran parte di questo calo ai link di navigazione presenti in tutto il sito, e sottolinea che lo studio è correlazionale: utile come direzione, non come prova.
Clic medi da Google per URL in base al numero di link interni che riceve
Da 0 a 4 link interni2 clic
Da 40 a 44 link interni8 clic (4x)
Fonte: Cyrus Shepard, Zyppy, 23 Million Internal Links SEO Case Study, aggiornato a febbraio 2026
Ne derivano due lezioni pratiche. Primo, le pagine con pochi link sono quelle che guadagnano di più, ed è proprio ciò che l'automazione sa trovare. Secondo, lo studio ha rilevato che la varietà degli anchor era correlata ai clic, e che le pagine con anchor sotto forma di URL e a corrispondenza esatta andavano meglio. Un sistema che collega ogni pagina con le stesse tre parole butta via questa varietà.
Il punto di vista GEO
I crawler di IA come GPTBot, ClaudeBot e PerplexityBot scoprono le pagine come Googlebot: seguendo i link <a href>. Molti non eseguono JavaScript, quindi un link iniettato lato browser può semplicemente non esistere per loro. La nostra guida ai crawler di IA spiega cosa recupera ciascun bot. Link interni puliti e renderizzati lato server aiutano sia i motori di ricerca sia i motori di IA che citano le tue pagine.
Link interni automatici: la macchina trova e inserisce i link, una persona stabilisce le regole e controlla il risultato.
Come funziona dall'interno un motore di link interni automatici
Ogni strumento serio, che sia un plugin, un SaaS o uno script scritto da te, segue la stessa pipeline. Conoscerla ti permette di valutare uno strumento in cinque minuti: chiedi come gestisce ogni passaggio.
La pipeline in 6 passaggi di un motore di link interni
InventariareScansionare il sito o leggere il CMS per elencare ogni pagina indicizzabile, il suo contenuto principale, il titolo, l'H1 e i link in uscita esistenti.
RappresentareTrasformare ogni pagina in qualcosa di confrontabile: un elenco di parole chiave, un insieme di entità o un vettore di embedding.
AbbinareAssegnare un punteggio di pertinenza a ogni coppia di origine e destinazione, poi tenere i migliori candidati per pagina.
Scegliere l'anchorTrovare un'espressione già presente nel testo di origine che descriva la destinazione.
Applicare le regoleFar rispettare limiti, esclusioni, priorità e zone vietate (titoli, link esistenti, navigazione).
Inserire e registrareScrivere il link, salvare origine, destinazione, anchor, regola e data, poi rifare la scansione per verificare.
Passaggio 1: l'inventario, e perché il «contenuto principale» conta
L'inventario deve separare il contenuto principale dal template. Un link nel menu dell'header compare su ogni pagina e dice poco a Google sulla destinazione. Un link nel terzo paragrafo di un articolo pertinente gli dice molto. I buoni motori rimuovono nav, header, footer e aside prima dell'analisi, e inseriscono solo nel corpo dell'articolo. Escludono anche gli URL non indicizzabili: tutto ciò che restituisce un redirect, un 404, un noindex o un canonical che punta altrove.
Passaggio 2: rappresentare le pagine
Esistono tre rappresentazioni comuni, dalla più grezza alla più fine:
Parole chiave: ogni pagina di destinazione possiede un elenco di espressioni («strategia di link interni», «struttura dei link»). Veloce e prevedibile, ma cieca al significato.
Entità: una libreria di elaborazione del linguaggio naturale estrae elementi con nome (prodotti, luoghi, concetti) e li associa alle pagine che li trattano. Migliore per disambiguare.
Embedding: un modello linguistico trasforma ogni pagina in un vettore di qualche centinaio di numeri. Le pagine su argomenti simili finiscono vicine, anche senza parole esatte in comune. È ciò che usano oggi la maggior parte degli strumenti di link «con IA».
Passaggio 3: l'abbinamento
Con gli embedding, l'abbinamento è una similarità del coseno tra vettori, un punteggio tra -1 e 1 (in pratica tra 0 e 1 per il testo). Tieni le coppie sopra una soglia e le migliori N per pagina. La soglia è l'impostazione più importante: troppo bassa e colleghi una pagina sul pitone (il serpente) a una pagina su Python (il linguaggio); troppo alta e trovi solo quasi duplicati. Parti da circa 0,5 a 0,6 con un modello generico, poi regola dopo aver controllato a mano 50 suggerimenti.
Passaggio 4: la scelta dell'anchor
L'anchor dovrebbe essere un'espressione già presente nella frase di origine. Inserire parole nuove significa riscrivere il contenuto, e questo è un altro lavoro. Il motore cerca nel testo di origine espressioni che descrivano la destinazione: la sua parola chiave principale, il suo H1, varianti vicine o le query per cui la destinazione si posiziona già in Search Console. Quest'ultima fonte è la migliore, perché riflette come le persone reali descrivono la pagina.
Passaggi 5 e 6: regole, inserimento, registro
È nelle regole che la qualità si vince o si perde (vedi la sezione dedicata più sotto). L'inserimento avviene in uno di tre punti: nel contenuto salvato (il link diventa parte dell'articolo, permanente e visibile nell'editor), al rendering sul server (un filtro aggiunge i link quando la pagina viene generata, facile da annullare) o nel browser con JavaScript (l'opzione più debole per la SEO). Qualunque sia il metodo, un registro di ogni link automatico non è facoltativo: senza, non puoi verificare, misurare o annullare.
I 6 metodi per automatizzare i link interni a confronto
«Link interni automatizzati» comprende tecniche molto diverse. La maggior parte dei siti finisce per combinarne due o tre.
1. Link automatici basati su regole di parole chiave
Principio: mantieni una tabella «espressione porta a URL», e il sistema trasforma l'espressione in link ovunque compaia. Quando usarlo: glossari, nomi di prodotti, un piccolo gruppo di pagine commerciali. Vantaggi: prevedibile, trasparente, economico. Limiti: nessuna comprensione del contesto, anchor identici ovunque, la tabella invecchia. Esempio: ogni prima menzione di «crawl budget» linka alla pagina del glossario sul crawl budget, con un massimo di un link per articolo.
2. Moduli strutturali e di template
Principio: il CMS genera link dalla struttura del sito: breadcrumb, elenchi di categorie, «articoli correlati», precedente e successivo, pagine hub che elencano le pagine figlie. Quando usarlo: sempre, è lo strato di base. Vantaggi: zero manutenzione, garantisce che nessuna pagina di una categoria resti orfana. Limiti: i link di template portano poco contesto, e i moduli «articoli correlati» spesso scelgono per data o tag invece che per significato. Esempio: un breadcrumb «Blog > SEO > Link interni» su ogni articolo.
3. Suggerimenti semantici con approvazione umana
Principio: gli embedding trovano pagine correlate e anchor candidati; un editor approva o rifiuta ogni suggerimento. Quando usarlo: siti di contenuti da circa 50 a diverse migliaia di articoli. Vantaggi: tiene conto del contesto, mantiene una persona nel processo, gli anchor variano in modo naturale. Limiti: tempo di revisione, e la qualità dipende dalla soglia. Esempio: quando viene pubblicato un articolo sulla «cannibalizzazione delle parole chiave», lo strumento propone cinque articoli più vecchi in cui una frase cita già la cannibalizzazione.
4. Link basati sulle entità
Principio: le entità vengono estratte da ogni pagina e collegate alla pagina di riferimento per quell'entità sul tuo sito. Quando usarlo: siti con molti elementi con nome: marchi, luoghi, persone, ingredienti, software. Vantaggi: buona disambiguazione, costruisce una mappa pulita «un'entità, una pagina». Limiti: serve una mappa da entità a pagina, meno efficace sugli argomenti astratti. Esempio: un sito di viaggi collega ogni menzione di «Kyoto» alla sua guida di Kyoto, e mai alla pagina degli hotel a Kyoto.
5. Link guidati dal grafo (PageRank interno)
Principio: il sito viene trattato come un grafo. Lo strumento calcola un punteggio interno per ogni pagina (una metrica simile al PageRank), la sua profondità di clic dalla home page e i suoi link in entrata, poi propone link che portano autorevolezza alle pagine prioritarie e avvicinano alla superficie le pagine profonde. Quando usarlo: siti grandi, ecommerce, qualsiasi sito con pagine commerciali sepolte. Vantaggi: ottimizza un obiettivo, non solo la pertinenza. Limiti: il modello è un'approssimazione di come Google pesa i link, e una pura logica di grafo può creare link irrilevanti se non è combinata con un filtro di pertinenza. Esempio: una pagina categoria a profondità 5 riceve link da tre guide forti che si posizionano per query correlate, e sale a profondità 2.
6. Link in fase di scrittura
Principio: i link vengono posizionati durante la stesura, da chi scrive o da uno strumento di scrittura con IA che ha davanti l'inventario del sito. Quando usarlo: qualsiasi sito che pubblica con regolarità. Vantaggi: il link fa parte di una frase scritta per lui, quindi gli anchor si leggono in modo naturale. Limiti: gestisce i link in uscita dalla nuova pagina, non i link in entrata dalle pagine più vecchie, quindi va abbinato a un metodo di recupero. Esempio: il generatore di articoli per blog con IA di Sorank scrive ogni articolo con link interni già inseriti verso le tue pagine di servizi, prodotti o categorie.
Metodo
Pertinenza
Impegno di gestione
Qualità degli anchor
Rischio se configurato male
Ideale per
Link automatici basati su regole di parole chiave
Bassa
Basso
Ripetitivi
Alto (keyword stuffing)
Glossari, nomi di prodotti
Moduli strutturali e di template
Media
Molto basso
Generici
Basso
Ogni sito, come strato di base
Suggerimenti semantici con approvazione
Alta
Medio (revisione)
Naturali e vari
Basso
Blog e hub di contenuti
Link basati sulle entità
Alta sugli elementi con nome
Medio
Precisi
Medio
Viaggi, ecommerce, cataloghi
Guidati dal grafo (PageRank interno)
Variabile
Alto (analisi)
Dipende dal filtro
Medio
Siti grandi, pagine commerciali sepolte
Link in fase di scrittura
Alta
Basso
I più naturali
Basso
Siti che pubblicano spesso
L'automazione serve un'architettura, non la sostituisce
Prima di configurare qualsiasi cosa, decidi quale forma devono disegnare i link. Una rete in stile Wikipedia collega qualsiasi pagina a qualsiasi pagina correlata; è l'output predefinito degli strumenti semantici e funziona bene per i contenuti enciclopedici. Un bozzolo semantico limita i link alle pagine dello stesso albero tematico, con le pagine madri che linkano verso il basso e le figlie verso l'alto e di lato; le tue regole devono vietare i link tra bozzoli, tranne al vertice. Un silo per URL segue la struttura delle cartelle (/guides/seo/...); una regola semplice «linkare solo all'interno della stessa cartella, più l'hub» basta a farlo rispettare. I topic cluster, descritti nella nostra guida a topic cluster e pagine pilastro, stanno a metà tra il bozzolo e la rete. Il nostro articolo sull'architettura del sito per la SEO ti aiuta a scegliere.
Le regole che rendono sicuri i link automatici
Un motore di link senza regole è un generatore di spam. Queste sono le impostazioni da mettere per iscritto prima della prima esecuzione, con valori che funzionano come punto di partenza.
Inserimento completamente automatico o suggerimento con approvazione
Completamente automatico
Scala all'istante su qualsiasi volume
Nessun tempo editoriale
Gli errori vengono pubblicati su larga scala
Passano anchor strani e contesti sbagliati
Difficile spiegare perché esiste un link
Suggerire e approvare
La macchina trova, la persona decide
Ogni link ha un responsabile e un motivo
Le regole migliorano grazie ai suggerimenti rifiutati
Si può passare all'automatico per le regole affidabili
Richiede tempo di revisione ogni settimana
Limiti e densità
Link automatici per pagina: da 3 a 5 in un articolo di 1500 parole, oltre ai link inseriti da chi scrive. Google dice che non esiste un numero ideale ma mette in guardia contro l'eccesso di link; i tuoi dati ti diranno più di qualsiasi regola empirica.
Un link per destinazione per pagina. Linkare lo stesso URL tre volte in un articolo non aggiunge nulla per chi legge e confonde i tuoi report.
Distanza minima: almeno 50 a 80 parole tra due link automatici, così i paragrafi non diventano blu.
Massimo per espressione di anchor sul sito: limita quante pagine possono usare esattamente lo stesso anchor verso la stessa destinazione, poi imponi delle varianti.
Zone vietate
Non inserire mai link nei titoli, nell'indice, nelle didascalie delle immagini, nelle citazioni, nei pulsanti di call to action, nei box autore o all'interno di un <a> esistente (i link annidati sono HTML non valido). Non collegare mai una pagina a se stessa, a un URL che reindirizza o a una pagina in noindex o canonicalizzata verso un altro URL.
Regole per gli anchor
La documentazione di Google chiede un anchor text «descrittivo, ragionevolmente conciso e pertinente rispetto alla pagina in cui si trova», e indica «clicca qui» e «leggi di più» come troppo generici. Traducilo in regole: anchor da 2 a 6 parole, presi dalla frase esistente, almeno due o tre varianti diverse per destinazione sul sito e un intento per anchor. Se «strumento per link interni» punta a un analizzatore gratuito in una pagina e a una funzione a pagamento in un'altra, stai raccontando due storie ai motori di ricerca. La nostra guida all'anchor text approfondisce i tipi di anchor.
Passaggio 2: elencare le pagine che devono ricevere link
Non tutte le pagine meritano più link. Prepara un breve elenco di destinazioni prioritarie: pagine che generano fatturato, pagine in posizione tra 5 e 20 per query di valore (Search Console, rapporto Prestazioni, filtro per posizione) e i tuoi contenuti pilastro. Aggiungi ogni pagina orfana e ogni pagina a più di 3 clic di profondità. Questo elenco alimenta i «priority_targets» delle tue regole.
Passaggio 3: costruire la banca degli anchor
Per ogni destinazione prioritaria, raccogli da 3 a 10 espressioni di anchor. La fonte migliore è Search Console: apri la pagina nel rapporto Prestazioni, passa alla scheda Query ed esporta le query per cui ottiene già impressioni. Aggiungi l'H1, la parola chiave principale e varianti naturali. Elimina tutto ciò che è ambiguo o condiviso con un'altra pagina.
Passaggio 4: generare i candidati e filtrarli
Avvia il tuo strumento o il tuo script. Per ogni destinazione, deve restituire pagine di origine in cui l'anchor compare nel corpo e il cui argomento è abbastanza vicino. Aspettati che l'imbuto si restringa molto: è il segno che i filtri funzionano.
Come vengono filtrati i link candidati
Tutte le coppie di origine e destinazione del sitoTutte le coppie
Coppie sopra la soglia di similaritàTop 20 per pagina
Coppie in cui esiste un anchor naturale nel testoAnchor trovato
Coppie che rispettano limiti e zone vietateRegole rispettate
Link approvati e pubblicatiDa 3 a 5 per pagina
Passaggio 5: rivedere a lotti
Rivedi i suggerimenti in un foglio di calcolo con cinque colonne: origine, destinazione, anchor, frase, punteggio. Leggi la frase, non solo l'anchor. Rifiuta tutto ciò che non avresti scritto tu. Annota perché rifiuti (senso sbagliato, troppo promozionale, già linkato poco prima): quei motivi diventano nuove regole.
Passaggio 6: pubblicare a ondate, non tutto insieme
Pubblica da 50 a 200 link per ondata, su un insieme di pagine che puoi monitorare. Mantieni un gruppo di controllo di pagine simili senza nuovi link. Così le variazioni dei clic hanno un punto di riferimento, cosa importante perché i posizionamenti si muovono per molti motivi.
Passaggio 7: rifare la scansione e verificare l'HTML renderizzato
Scansiona di nuovo il sito. Verifica che i nuovi link compaiano come <a href> nell'HTML grezzo, non solo dopo l'esecuzione di JavaScript. Per alcuni URL, usa lo strumento di controllo URL di Search Console e guarda l'HTML renderizzato che vede Google.
Passaggio 8: collegarlo alla pubblicazione
Il vero vantaggio è continuo. A ogni pubblicazione, il sistema dovrebbe fare due cose: linkare dal nuovo articolo (in fase di scrittura) e proporre link verso di lui dalle pagine più vecchie (recupero). A ogni cambio di URL, dovrebbe aggiornare o rimuovere i link che puntano a quell'URL.
Consiglio
Per controllare rapidamente una pagina, incolla il suo URL nel nostro analizzatore di link interni gratuito: elenca ogni link interno della pagina, il suo anchor e i suoi attributi, così puoi confermare che un'ondata di link automatici è andata online come previsto.
Fai da te: uno script di link interni semantici in Python
Se il tuo CMS non ha un buon strumento, o vuoi capire esattamente cosa fa un fornitore, un prototipo funzionante sta in circa 60 righe. Questa versione legge la sitemap, estrae il contenuto principale, calcola gli embedding con un modello open source e produce un CSV di suggerimenti da rivedere. Non tocca mai il tuo sito.
import csv, re
from urllib.parse import urljoin
import requests
from bs4 import BeautifulSoup
from sentence_transformers import SentenceTransformer, util

SITEMAP = "https://example.com/sitemap.xml"
urls = re.findall(r"<loc>(.*?)</loc>", requests.get(SITEMAP, timeout=20).text)

pages = {}
for url in urls:
    r = requests.get(url, timeout=20)
    if r.status_code != 200 or r.url != url:
        continue  # saltare errori e redirect
    soup = BeautifulSoup(r.text, "html.parser")
    robots = soup.find("meta", attrs={"name": "robots"})
    if robots and "noindex" in robots.get("content", ""):
        continue
    main = soup.find("article") or soup.find("main") or soup.body
    for tag in main.find_all(["nav", "header", "footer", "aside", "script", "style"]):
        tag.decompose()
    pages[url] = {
        "h1": soup.h1.get_text(" ", strip=True) if soup.h1 else "",
        "text": main.get_text(" ", strip=True),
        "links": {urljoin(url, a["href"]).split("#")[0] for a in main.find_all("a", href=True)},
    }
Embedding, abbinamento e ricerca degli anchor
model = SentenceTransformer("all-MiniLM-L6-v2")
keys = list(pages)
docs = [pages[u]["h1"] + ". " + pages[u]["text"][:2000] for u in keys]
emb = model.encode(docs, normalize_embeddings=True)
sim = util.cos_sim(emb, emb)

# Banca degli anchor: URL di destinazione -> espressioni (H1 + query esportate da Search Console)
anchors = {u: [pages[u]["h1"].lower()] for u in keys}
# anchors["https://example.com/crawl-budget"] += ["crawl budget", "crawl budget optimization"]

THRESHOLD, MAX_PER_PAGE = 0.55, 5

def find_anchor(text, phrases):
    for phrase in sorted(phrases, key=len, reverse=True):
        if len(phrase.split()) < 2:
            continue
        m = re.search(r"\b" + re.escape(phrase) + r"\b", text, re.IGNORECASE)
        if m:
            start = max(0, m.start() - 120)
            return m.group(0), text[start:m.end() + 120]
    return None, None

rows = []
for i, src in enumerate(keys):
    added = 0
    for j in sorted(range(len(keys)), key=lambda k: -float(sim[i][k])):
        score = float(sim[i][j])
        if score < THRESHOLD or added == MAX_PER_PAGE:
            break
        tgt = keys[j]
        if tgt == src or tgt in pages[src]["links"]:
            continue
        anchor, context = find_anchor(pages[src]["text"], anchors[tgt])
        if anchor:
            rows.append([src, tgt, anchor, round(score, 2), context])
            added += 1

with open("link_suggestions.csv", "w", newline="", encoding="utf-8") as f:
    csv.writer(f).writerows([["source", "target", "anchor", "score", "context"]] + rows)
Come renderlo pronto per la produzione
Rispetta il server: aggiungi una pausa tra le richieste e uno User-Agent chiaro, oppure leggi il contenuto direttamente dal database o dall'API del CMS invece di scansionare.
Usa un testo migliore per gli embedding: titolo più H1 più le prime 300 parole di solito funzionano meglio della pagina intera, che diluisce l'argomento.
Fai scalare l'abbinamento: la matrice di similarità cresce con il quadrato del numero di pagine. Oltre 20000 pagine, usa un indice di vicini più prossimi approssimato (FAISS, per esempio) e confronta ogni pagina solo con i suoi 50 vicini più prossimi.
Aggiungi priorità: moltiplica il punteggio per un bonus per le destinazioni prioritarie e per una penalità per le destinazioni che hanno già molti link in entrata.
Rispetta la tua architettura: per un silo o un bozzolo, scarta le coppie i cui URL non condividono la cartella o l'albero tematico consentito.
Inserisci lato server: scrivi i link approvati nel contenuto salvato tramite l'API del CMS, mai tramite uno script nel browser.
Trovare le menzioni senza link con un crawler
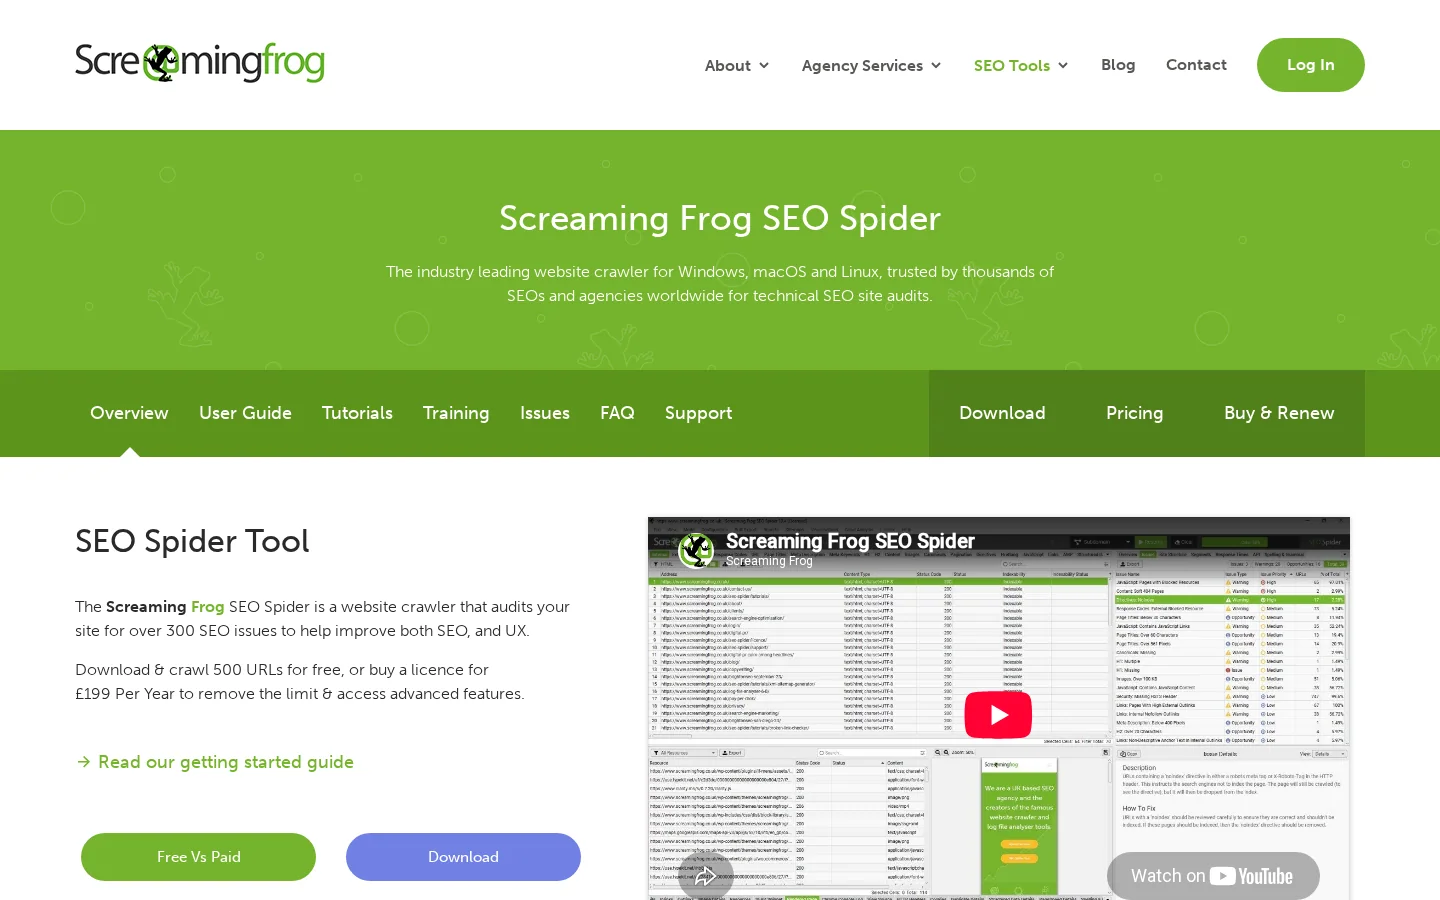
Senza scrivere codice, un crawler può fare parte del lavoro. In Screaming Frog, la funzione Custom Search trova ogni pagina che contiene un'espressione, e Custom Extraction con XPath conta i link verso una certa destinazione. Le pagine che contengono l'espressione ma non hanno alcun link alla destinazione sono le tue candidate. La guida utente di SEO Spider documenta anche il suo Link Score, «una metrica da 0 a 100 che calcola il valore relativo di una pagina in base ai suoi link interni», che richiede di eseguire la crawl analysis dopo la scansione.
Screaming Frog SEO Spider: scansiona il tuo sito, esporta link interni e anchor e trova le pagine che citano un argomento senza linkarlo.
Errori comuni nei link interni automatizzati (e come correggerli)
La maggior parte dei problemi dei link automatici non sono penalizzazioni. Sono link sprecati, segnali confusi e pagine che sembrano scritte da una macchina. Ecco come individuare e correggere ciascuno.
1. Linkare ogni occorrenza di una parola chiave
Cos'è: un plugin a regole impostato senza limiti linka «audit SEO» su 400 pagine con lo stesso anchor verso la stessa pagina. Come individuarlo: nell'export degli anchor text del tuo crawler, ordina gli anchor interni per frequenza; un'espressione usata centinaia di volte in modo identico verso un solo URL è il segnale. Come correggerlo: limita gli utilizzi per regola sul sito, richiedi almeno due varianti per destinazione e rimuovi i link dalle pagine in cui l'argomento è citato solo di passaggio.
2. Linkare nel senso sbagliato
Cos'è: la parola corrisponde, il significato no («mela» il frutto collegata a un articolo sugli iPhone, «Java» l'isola collegata a un tutorial di programmazione). Come individuarlo: rivedi ogni mese un campione casuale di 30 link automatici leggendo la frase intera. Come correggerlo: alza la soglia di similarità, richiedi sia una corrispondenza di espressione sia una corrispondenza di argomento e aggiungi parole chiave negative alle regole ambigue.
3. Troppi link per paragrafo
Cos'è: il motore ammassa quattro link in un paragrafo di 60 parole. I lettori smettono di cliccare e il testo diventa difficile da leggere. Come individuarlo: calcola i link ogni 100 parole di contenuto principale; oltre 3 merita un controllo. Come correggerlo: imposta una distanza minima in parole tra link automatici e un limite per pagina che conti i link già inseriti da chi scrive.
4. Link nei titoli, nei pulsanti o dentro altri link
Cos'è: una corrispondenza dentro un H2, un indice o un anchor esistente viene avvolta in un nuovo link, producendo tag <a> annidati o titoli blu. Come individuarlo: passa alcune pagine in un validatore HTML, oppure cerca nella scansione i titoli che contengono link. Come correggerlo: dichiara esplicitamente i selettori vietati e testali su una copia di staging prima di ogni nuova regola.
5. Link che esistono solo in JavaScript
Cos'è: un widget lato browser inietta link dopo il caricamento della pagina, a volte senza href, a volte solo dopo uno scroll o un clic. Come individuarlo: confronta l'HTML grezzo (codice sorgente) con il DOM renderizzato e controlla l'HTML renderizzato nel controllo URL di Search Console. Come correggerlo: sposta l'inserimento sul server o nel contenuto salvato. La nostra guida alla SEO per JavaScript spiega il rendering in dettaglio.
Attenzione
Molti crawler di IA non eseguono affatto JavaScript. Un link che compare solo dopo l'esecuzione degli script può essere visibile a Googlebot dopo il rendering, ma invisibile ai bot che alimentano ChatGPT, Claude o Perplexity.
6. Link verso redirect, pagine noindex e 404
Cos'è: i link automatici creati da un vecchio inventario continuano a puntare a URL spostati o rimossi. Come individuarlo: in una scansione, filtra i link interni per codice di stato (3xx, 4xx) e per destinazione non indicizzabile; il nostro controllo dei link rotti gratuito lo fa per una singola pagina. Come correggerlo: aggiorna l'inventario prima di ogni esecuzione, accetta solo destinazioni con stato 200, indicizzabili e con canonical su se stesse, e aggiorna i link direttamente quando viene creato un 301.
7. Affidarsi solo ai widget «articoli correlati»
Cos'è: il sito crede di essere ben collegato perché ogni articolo termina con tre articoli correlati. Questi blocchi spesso scelgono per tag o per data, ruotano e ignorano del tutto i contenuti vecchi. Come individuarlo: il tuo elenco di orfane (URL della sitemap non raggiunti dalla scansione, o raggiunti solo tramite paginazione) resta lungo. Come correggerlo: tieni il widget, ma aggiungi link contestuali nel corpo del testo e link fissi dalle pagine hub.
8. Far puntare un anchor a due pagine
Cos'è: «strumento per link interni» punta alla pagina A in alcuni articoli e alla pagina B in altri. Dividi i segnali di pertinenza e puoi alimentare la cannibalizzazione delle parole chiave. Come individuarlo: costruisci dalla scansione una mappa da anchor a destinazione e segnala ogni anchor con più di una destinazione. Come correggerlo: un intento di ricerca, una pagina di destinazione; riassegna gli anchor della pagina più debole.
9. Nessun registro, nessun ritorno indietro
Cos'è: i link sono stati inseriti nei contenuti da un plugin poi disinstallato, oppure nessuno sa quali link sono automatici. Come individuarlo: non sai rispondere a «quanti link ha aggiunto lo strumento il mese scorso?». Come correggerlo: salva ogni link automatico in una tabella (origine, destinazione, anchor, regola, data, stato), marcali nell'HTML con un attributo data se il tuo stack lo consente e verifica di poter rimuovere tutti i link di una regola con un'unica operazione.
Errore
Segnale da cercare
Correzione
Ogni occorrenza linkata
Un anchor usato centinaia di volte verso un URL
Limiti su tutto il sito, varianti di anchor
Senso sbagliato
Frasi strane in un campione manuale
Soglia più alta, parole chiave negative
Densità di link
Più di 3 link ogni 100 parole
Distanza in parole, limite per pagina
Zone vietate
Link nei titoli, anchor annidati
Selettori di esclusione espliciti
Link solo in JavaScript
Link assenti dal codice sorgente
Inserimento lato server
Destinazioni morte
Link interni 3xx e 4xx nella scansione
Inventario aggiornato, solo destinazioni con 200
Link solo tramite widget
Lungo elenco di orfane
Link contestuali e dagli hub
Un anchor, due destinazioni
Mappa degli anchor con duplicati
Un intento, una pagina
Nessun registro
Impossibile contare i link automatici
Tabella dei link, attributo data, ritorno indietro
Come misurare l'impatto dei link interni automatici
I link interni producono raramente un balzo da un giorno all'altro. Misura sulle pagine che hanno ricevuto link, rispetto al gruppo di controllo, per 4 a 12 settimane.
Cosa monitorare dopo ogni ondata di link
Numero di pagine orfane (sitemap rispetto alla scansione)
Pagine a più di 3 clic dalla home page
Link interni in entrata unici per pagina prioritaria
Impressioni e posizione media delle pagine di destinazione in Search Console
Clic sulle pagine di destinazione rispetto al gruppo di controllo
Frequenza di scansione delle pagine di destinazione nei log del server
Quota di link automatici rifiutati in revisione (qualità delle regole)
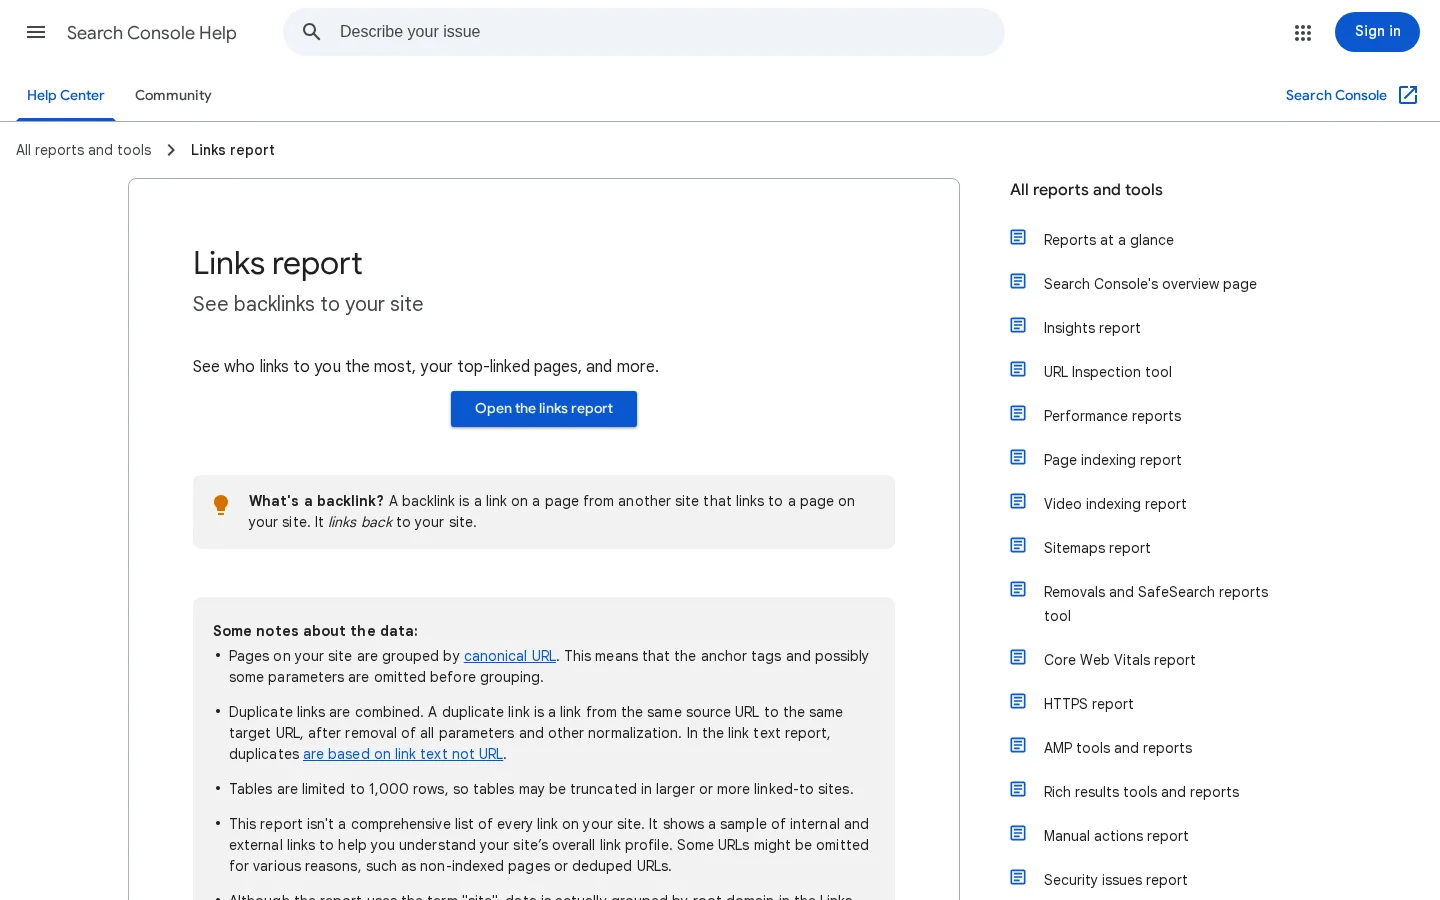
Il rapporto Link di Search Console
Il rapporto Link di Search Console mostra le tue «pagine con più link interni» e, per ciascuna, le pagine che la linkano. È utile come verifica di coerenza (le tue pagine prioritarie sono in alto?), ma la pagina di assistenza di Google avverte che le sue tabelle sono limitate a 1000 righe e che il rapporto «non è un elenco completo di tutti i link del tuo sito». Usa la tua scansione come fonte di verità, e Search Console per vedere cosa ha effettivamente rilevato Google.
Il rapporto Link di Search Console mostra le tue pagine con più link interni, con un limite di 1000 righe: usalo come verifica, non come fonte di verità.
Log del server
Se puoi accedervi, i log del server mostrano se Googlebot e i crawler di IA visitano più spesso le pagine appena collegate dopo un'ondata. È il segnale più diretto che la scoperta è migliorata. La nostra guida all'analisi dei log per la SEO spiega come filtrare i bot e leggere la frequenza di scansione, e perché conta per il crawl budget dei siti grandi.
Leggere i risultati con onestà
Se le impressioni salgono sulle pagine di destinazione ma non nel gruppo di controllo, probabilmente i link hanno aiutato. Se salgono in entrambi, è probabile un effetto stagionale o algoritmico. Se le pagine di destinazione guadagnano impressioni ma non clic, la leva successiva è il titolo e il contenuto, non altri link. E se dopo 12 settimane non si muove nulla, controlla le basi: i link sono nell'HTML grezzo, e le destinazioni sono davvero indicizzate?
Da dove iniziare oggi
Non ti serve un grande strumento per cominciare. Scegli un cluster di 20 a 50 pagine, scansionalo, elenca le sue orfane e le sue pagine prioritarie, costruisci una banca di anchor da Search Console e aggiungi i link in un'unica ondata revisionata. Misura per sei settimane, trasforma ciò che hai imparato in regole, poi passa al cluster successivo.
Se pubblichi spesso, il guadagno più economico sono i link in fase di scrittura: ogni nuovo articolo dovrebbe uscire dall'editor con link verso le pagine giuste. È ciò che fa Sorank quando scrive e pubblica articoli per te, e il suo generatore di topic cluster pianifica i cluster che quei link seguono, con protezione anti cannibalizzazione integrata. Per le pagine più vecchie, combinalo con un recupero revisionato seguendo il metodo descritto sopra.
Domande frequenti
I link interni automatici sono sicuri per la SEO?
Sì, a patto che i link siano pertinenti, usino anchor descrittivi e restino entro limiti ragionevoli. La documentazione di Google chiede link scansionabili con anchor text descrittivo e mette in guardia contro l'eccesso di link, non contro l'automazione in sé. Il rischio viene dagli strumenti che linkano ogni occorrenza di una parola chiave con lo stesso anchor, quindi mantieni un passaggio di revisione e registra ogni link automatico.
Quanti link interni dovrebbe avere un articolo?
Google dice che non esiste un numero ideale. Un punto di partenza pratico sono da 3 a 5 link contestuali automatici in un articolo di 1500 parole, oltre a quelli inseriti da chi scrive, con un link per destinazione e un po' di distanza tra i link. Misura sulle tue pagine e regola: uno studio di correlazione di Zyppy ha osservato miglioramenti fino a circa 40 link interni in entrata per URL e un'inversione intorno a 45 a 50.
I link interni automatici sostituiscono una strategia di link interni?
No. L'automazione esegue una strategia: trova i candidati, inserisce i link e li tiene aggiornati. Devi comunque decidere quali pagine privilegiare, quale architettura devono seguire i link (rete, bozzolo semantico o silo) e quali anchor appartengono a quale pagina.
y!
Ricevi gratis il tuo piano di contenuti per 30 giorni
Analizziamo i tuoi concorrenti, il tuo sito web e la tua visibilità nelle IA per creare gratuitamente un piano di contenuti su misura.
“Ho testato Sorank sul sito reale di un cliente ed è pazzesco. Fa tutto quello che un'agenzia fa pagare 1.500 € al mese. Ora va in produzione su quel cliente.”Guillaume Guersanguersanguillaume.com
“Siamo un'agenzia pubblicitaria e volevamo rimettere in carreggiata il nostro SEO una volta per tutte. Sorank ci ha dato una visione chiara del nostro sito, ci ha aiutato a dare priorità alle ottimizzazioni e a strutturare correttamente i nostri contenuti. Lo strumento è facile da usare, ben progettato per un team e molto pratico per centralizzare il monitoraggio senza dover destreggiarsi tra più piattaforme. Una base molto solida per ripartire da zero con il nostro SEO.”Gaspard MadouiAgenzia Pubblicitaria
“Mi sono specializzata in GEO grazie a Sorank. Il GEO Leaderboard mi permette di mostrare ai miei clienti il loro posizionamento rispetto ai concorrenti su ChatGPT. È un vero differenziatore commerciale.”MélanieFreelancer SEO
“Ottimo servizio, funziona bene per il nostro sito web e ci aiuta a capire come migliorarlo per posizionarci meglio su Google e altrove. Complimenti, continuate così, ve lo consiglio.”Hugo T.Commerciante e-commerce