Jouw privacy is belangrijk voor ons, daarom kun je bepaalde soorten opslag uitschakelen die niet nodig zijn voor de basiswerking van de website. Het blokkeren van categorieën kan invloed hebben op je ervaring op de website. Meer informatie (Cookiebeleid)
Bedankt! Je aanmelding is ontvangen!
Oeps! Er ging iets mis bij het versturen van het formulier.
Een netwerk van pagina's verbonden door interne links, waarvan sommige automatisch zijn geplaatst en vóór publicatie door een redacteur zijn gecontroleerd.
Tools
Op deze pagina
Kort gezegd
automatische interne links betekent dat software de links tussen je eigen pagina's vindt, voorstelt of invoegt, in plaats van dat je ze een voor een met de hand plaatst. Het werkt goed als de machine het saaie werk doet (crawlen, onderwerpen koppelen, weespagina's opsporen, elke link vastleggen) en jij de regels in handen houdt: welke pagina's je versterkt, welke ankerteksten zijn toegestaan, hoeveel links per pagina. Richt het in als "voorstellen, goedkeuren, publiceren, meten", niet als een plugin die elk zoekwoord dat hij tegenkomt linkt.
3 dagen gratis, daarna stop je wanneer je wilt. 90 dagen geld-terug-garantie, onder voorwaarden.
Wat automatische interne links zijn (en wat niet)
Een interne link is een link van een pagina op je website naar een andere pagina op dezelfde website. Hij heeft drie taken: crawlers pagina's laten ontdekken, zoekmachines en AI-systemen vertellen waar de doelpagina over gaat (via de ankertekst en de woorden eromheen) en autoriteit doorgeven van sterke naar zwakkere pagina's. Zijn de basisbegrippen nieuw voor je, begin dan met onze definitie van interne links.
Automatiseren betekent dat een programma een of meer van deze taken uitvoert:
Inventarisatie: de website crawlen en elke pagina, elke bestaande link en elk anker in kaart brengen.
Koppeling: bepalen welke pagina naar welke moet linken, op basis van zoekwoorden, betekenis of entiteiten.
Ankerkeuze: een formulering vinden die al in de brontekst staat en het doel beschrijft.
Invoegen: de link in de HTML schrijven, in de CMS-database of op het moment van renderen.
Onderhoud: links aanpassen als een URL verandert, een pagina wordt verwijderd of een nieuw artikel verschijnt.
Wat het niet is: een manier om dezelfde zoekwoordlink in 500 pagina's te proppen, een vervanging voor een sitestructuur of een widget "gerelateerde berichten" onder elk artikel. Die dingen kunnen deel uitmaken van een geautomatiseerd systeem, maar op zichzelf leveren ze vooral ruis op.
Waarom handmatig linken vastloopt
Handmatig linken werkt op een website van 30 pagina's. Het faalt op een website die elke week publiceert, om een eenvoudige reden: elk nieuw artikel levert twee taken op. Het heeft links nodig naar bestaande pagina's, en oudere pagina's hebben links nodig naar het nieuwe artikel. Die tweede taak vergeet iedereen. Na twee jaar publiceren heb je nieuwe artikelen waar niemand naar linkt en oude artikelen die nog verwijzen naar pagina's die je allang hebt vervangen.
Interne links voor en na automatisering
Voor (handmatig)
Nieuwe artikelen krijgen uitgaande links, zelden inkomende
Weespagina's stapelen zich ongemerkt op
Links wijzen naar redirects en verwijderde URL's
Ankers hangen af van wie het artikel schreef
Na (geautomatiseerd, met controle)
Elke nieuwe pagina krijgt links van verwante pagina's
Weespagina's worden bij elke crawl gesignaleerd
Kapotte en doorgestuurde doelen worden bijgewerkt
Ankers volgen vastgelegde regels en worden gelogd
Dit artikel gaat over de techniek: methoden, instellingen, een werkend script en de valkuilen. Voor de strategische kant (welke pagina's voorrang krijgen, hoe je links plant voor een meertalige website) lees je eerst onze expertstrategie voor interne links. De twee stukken zijn bedoeld om samen te gebruiken.
Waarom het ertoe doet: wat de data zeggen over interne links
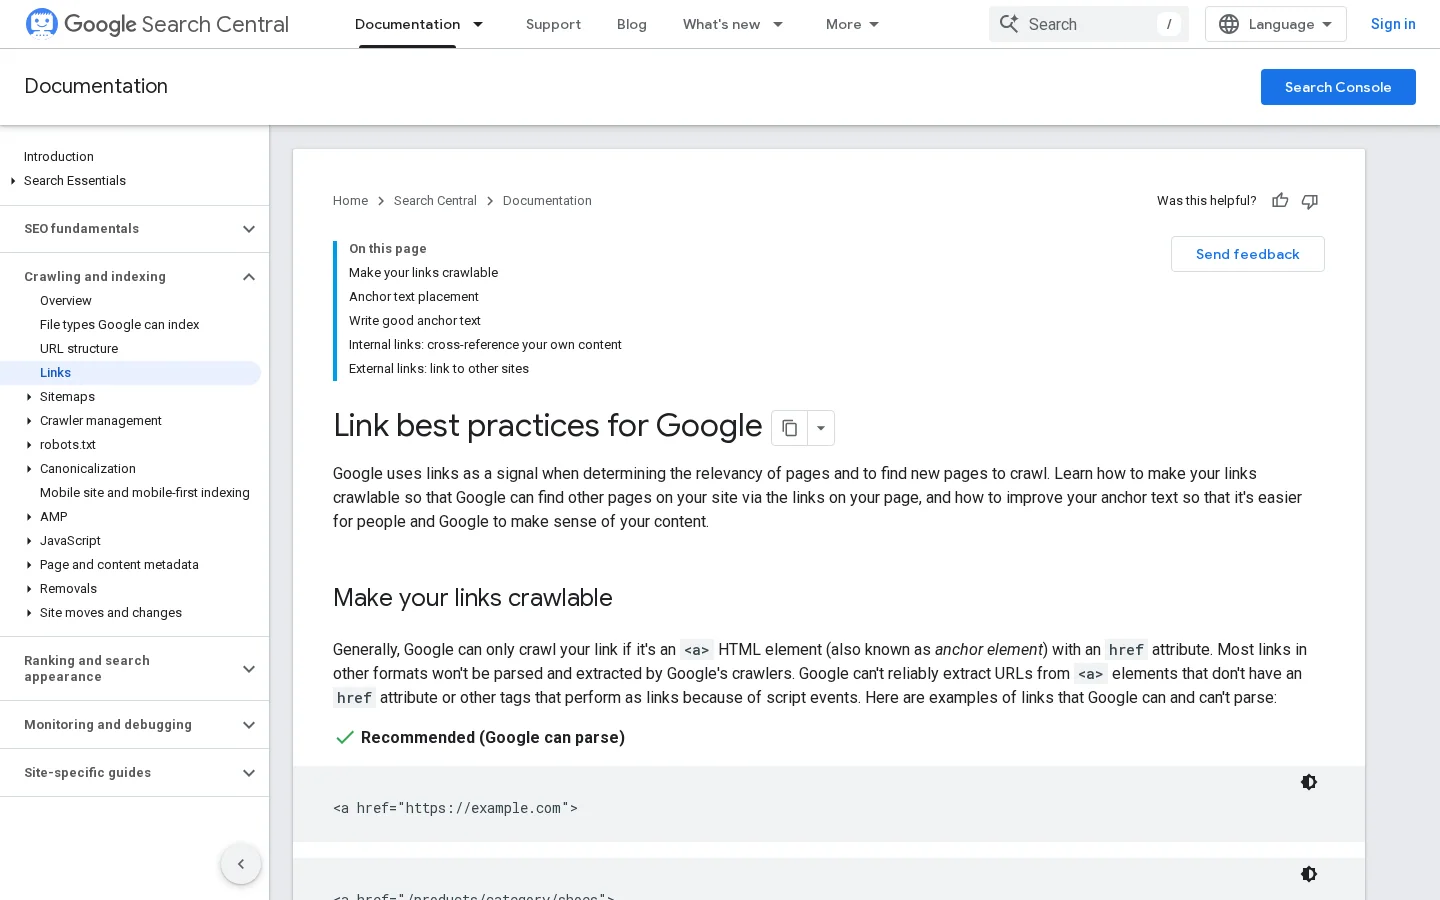
Google is duidelijk over het minimum. De documentatie over best practices voor links zegt dat "elke pagina die je belangrijk vindt een link moet hebben vanaf minstens één andere pagina op je site", en dat Google een link doorgaans alleen kan crawlen als het een <a>-element is met een href-attribuut. Een weespagina is niet verboden, maar je rekent dan alleen op de sitemap om haar te laten vinden en begrijpen.
Voorbij het minimum is de beste openbare dataset over dit onderwerp een correlatieonderzoek van Cyrus Shepard bij Zyppy, "23 Million Internal Links: SEO Case Study" (bijgewerkt in februari 2026). Het koppelt de interne-linkdata van ongeveer 1800 websites aan de klikken uit Search Console.
Wat 23 miljoen interne links laten zien
23 miljoeninterne links geanalyseerd op ongeveer 520000 URL's
1800websites in de dataset, gekoppeld aan klikken uit Google Search Console
5xminstens vijf keer meer verkeer voor pagina's met minstens één intern exact-match-anker
6%ruim 6% van alle interne links had helemaal geen ankertekst
Bron: Cyrus Shepard, Zyppy, 23 Million Internal Links SEO Case Study, bijgewerkt in februari 2026
De nuttigste bevinding voor automatisering gaat over volume. URL's met 0 tot 4 interne links kregen gemiddeld 2 klikken uit Google, URL's met 40 tot 44 interne links vier keer zoveel. Vanaf ongeveer 45 tot 50 links keert het effect om. De auteur schrijft een groot deel van die daling toe aan sitebrede navigatielinks en noemt het onderzoek nadrukkelijk correlatief: bruikbaar als richting, geen bewijs.
Gemiddelde Google-klikken per URL naar aantal inkomende interne links
0 tot 4 interne links2 klikken
40 tot 44 interne links8 klikken (4x)
Bron: Cyrus Shepard, Zyppy, 23 Million Internal Links SEO Case Study, bijgewerkt in februari 2026
Daar volgen twee praktische lessen uit. Ten eerste winnen de pagina's met te weinig links het meest, en juist die vindt automatisering goed. Ten tweede zag het onderzoek dat variatie in ankers samenhing met klikken, en dat pagina's met URL-ankers en exact-match-ankers beter presteerden. Een systeem dat elke pagina met dezelfde drie woorden linkt, gooit die variatie weg.
De GEO-invalshoek
AI-crawlers zoals GPTBot, ClaudeBot en PerplexityBot ontdekken pagina's op dezelfde manier als Googlebot: door <a href>-links te volgen. Veel van hen voeren geen JavaScript uit, dus een link die in de browser wordt toegevoegd, bestaat voor hen misschien gewoon niet. Onze gids over AI-crawlers legt uit wat elke bot ophaalt. Schone, server-side gerenderde interne links helpen zowel zoekmachines als de AI-systemen die je pagina's citeren.
Automatische interne links: de machine vindt en plaatst de links, een mens stelt de regels op en controleert het resultaat.
Hoe een engine voor automatische interne links onder de motorkap werkt
Elke serieuze tool, of het nu een plugin, een SaaS of een zelfgeschreven script is, doorloopt dezelfde pijplijn. Als je die kent, beoordeel je een tool in vijf minuten: vraag hoe hij elke stap uitvoert.
De pijplijn in 6 stappen van een interne-linkengine
InventariserenDe website crawlen of het CMS uitlezen om elke indexeerbare pagina met hoofdinhoud, titel, H1 en bestaande uitgaande links in kaart te brengen.
RepresenterenElke pagina omzetten in iets vergelijkbaars: een lijst zoekwoorden, een set entiteiten of een embeddingvector.
KoppelenElk paar van bron en doel op relevantie scoren en de beste kandidaten per pagina bewaren.
Anker kiezenEen formulering vinden die al in de brontekst staat en het doel beschrijft.
Regels toepassenLimieten, uitsluitingen, prioriteiten en verboden zones afdwingen (koppen, bestaande links, navigatie).
Invoegen en loggenDe link schrijven, bron, doel, anker, regel en datum opslaan en daarna opnieuw crawlen ter controle.
Stap 1: inventarisatie, en waarom de "hoofdinhoud" telt
De inventarisatie moet de hoofdinhoud scheiden van het template. Een link in het hoofdmenu staat op elke pagina en zegt Google weinig over het doel. Een link in de derde alinea van een relevant artikel zegt veel. Goede engines halen nav, header, footer en aside weg vóór de analyse en voegen alleen in de artikeltekst in. Ze sluiten ook niet-indexeerbare URL's uit: alles wat een redirect, een 404, een noindex of een canonical naar een andere URL teruggeeft.
Stap 2: pagina's representeren
Er zijn drie gangbare representaties, van grof naar fijn:
Zoekwoorden: elke doelpagina heeft een lijst formuleringen ("interne linkstrategie", "linkstructuur"). Snel en voorspelbaar, maar blind voor betekenis.
Entiteiten: een bibliotheek voor natuurlijke taalverwerking haalt benoemde zaken (producten, plaatsen, begrippen) uit de tekst en koppelt ze aan de pagina's die ze behandelen. Beter bij dubbelzinnigheid.
Embeddings: een taalmodel zet elke pagina om in een vector van een paar honderd getallen. Pagina's over vergelijkbare onderwerpen komen dicht bij elkaar te liggen, ook zonder gemeenschappelijke exacte woorden. Dit gebruiken de meeste "AI"-linktools vandaag.
Stap 3: koppelen
Met embeddings is koppelen een cosinusgelijkenis tussen vectoren, een score tussen -1 en 1 (bij tekst in de praktijk 0 tot 1). Je houdt paren boven een drempel en de beste N per pagina. De drempel is de belangrijkste instelling: te laag en je linkt een pagina over de python (de slang) aan een pagina over Python (de programmeertaal); te hoog en je vindt alleen bijna-duplicaten. Begin rond 0,5 tot 0,6 met een algemeen model en stel bij nadat je 50 voorstellen met de hand hebt bekeken.
Stap 4: ankerkeuze
Het anker moet een formulering zijn die al in de bronzin staat. Nieuwe woorden invoegen betekent de inhoud herschrijven, en dat is een ander werk. De engine zoekt in de brontekst naar formuleringen die het doel beschrijven: het hoofdzoekwoord, de H1, nauwe varianten of de zoekopdrachten waarop het doel al in Search Console rankt. Die laatste bron is de beste, omdat ze laat zien hoe echte mensen de pagina omschrijven.
Stap 5 en 6: regels, invoegen, logboek
In de regels wordt de kwaliteit gewonnen of verloren (zie de aparte sectie hieronder). Invoegen gebeurt op een van drie plekken: in de opgeslagen inhoud (de link wordt deel van het artikel, blijvend en zichtbaar in de editor), bij het renderen op de server (een filter voegt links toe als de pagina wordt gegenereerd, makkelijk terug te draaien) of in de browser met JavaScript (de zwakste optie voor SEO). Welke methode je ook kiest, een logboek van elke automatische link is niet optioneel: zonder logboek kun je niet controleren, meten of terugdraaien.
De 6 methoden voor automatische interne links vergeleken
"Automatische interne links" omvat heel verschillende technieken. De meeste websites combineren er uiteindelijk twee of drie.
1. Regelgebaseerd automatisch linken op zoekwoord
Principe: je houdt een tabel bij "formulering leidt naar URL", en het systeem linkt de formulering overal waar ze voorkomt. Wanneer gebruiken: woordenlijsten, productnamen, een kleine set commerciële pagina's. Voordelen: voorspelbaar, transparant, goedkoop. Beperkingen: geen begrip van context, overal dezelfde ankers, de tabel veroudert. Voorbeeld: elke eerste vermelding van "crawlbudget" linkt naar de woordenlijstpagina over crawlbudget, met maximaal één link per artikel.
2. Structuur- en templatemodules
Principe: het CMS maakt links op basis van de sitestructuur: broodkruimels, categorielijsten, "gerelateerde artikelen", vorige en volgende, hubpagina's die hun onderliggende pagina's opsommen. Wanneer gebruiken: altijd, het is de basislaag. Voordelen: geen onderhoud, geen enkele pagina in een categorie blijft wees. Beperkingen: templatelinks dragen weinig context, en modules voor "gerelateerde berichten" kiezen vaak op datum of tag in plaats van op betekenis. Voorbeeld: een broodkruimel "Blog > SEO > Interne links" op elk artikel.
3. Semantische voorstellen met menselijke goedkeuring
Principe: embeddings vinden verwante pagina's en mogelijke ankers; een redacteur keurt elk voorstel goed of af. Wanneer gebruiken: contentwebsites van ongeveer 50 tot enkele duizenden artikelen. Voordelen: houdt rekening met context, er blijft een mens betrokken, ankers variëren vanzelf. Beperkingen: controletijd, en de kwaliteit hangt af van de drempel. Voorbeeld: zodra een artikel over "keyword-kannibalisatie" verschijnt, stelt de tool vijf oudere artikelen voor waarin een zin al over kannibalisatie gaat.
4. Linken op basis van entiteiten
Principe: uit elke pagina worden entiteiten gehaald en gekoppeld aan de pagina die op jouw website de referentie voor die entiteit is. Wanneer gebruiken: websites met veel benoemde zaken: merken, plaatsen, personen, ingrediënten, software. Voordelen: goede disambiguatie, bouwt een schone kaart "één entiteit, één pagina". Beperkingen: vereist een koppeling van entiteit naar pagina, zwakker bij abstracte onderwerpen. Voorbeeld: een reiswebsite linkt elke vermelding van "Kyoto" naar haar Kyoto-gids, en nooit naar de pagina met hotels in Kyoto.
5. Linken op basis van de graaf (interne PageRank)
Principe: de website wordt als graaf behandeld. De tool berekent voor elke pagina een interne score (een maat die lijkt op PageRank), de klikdiepte vanaf de homepage en de inkomende links, en stelt dan links voor die autoriteit naar prioriteitspagina's sturen en diepe pagina's dichter naar de oppervlakte halen. Wanneer gebruiken: grote websites, e-commerce, elke website waar commerciële pagina's diep weggestopt zitten. Voordelen: optimaliseert op een doel, niet alleen op relevantie. Beperkingen: het model is een benadering van hoe Google links weegt, en pure graaflogica kan irrelevante links opleveren als je hem niet combineert met een relevantiefilter. Voorbeeld: een categoriepagina op klikdiepte 5 krijgt links van drie sterke gidsen die ranken op verwante zoekopdrachten, en komt op diepte 2 terecht.
6. Linken tijdens het schrijven
Principe: links worden geplaatst terwijl de tekst wordt geschreven, door een schrijver of een AI-schrijftool die de inventaris van de website voor zich heeft. Wanneer gebruiken: elke website die regelmatig publiceert. Voordelen: de link hoort bij een zin die ervoor geschreven is, dus de ankers lezen natuurlijk. Beperkingen: het regelt de uitgaande links van de nieuwe pagina, niet de inkomende links vanaf oudere pagina's, dus het moet gecombineerd worden met een methode om achteraf te linken. Voorbeeld: de AI-generator voor blogartikelen van Sorank schrijft elk artikel met interne links die al naar je dienst-, product- of categoriepagina's wijzen.
Methode
Relevantie
Inspanning bij gebruik
Kwaliteit van ankers
Risico bij verkeerde instelling
Meest geschikt voor
Regelgebaseerd automatisch linken op zoekwoord
Laag
Laag
Repetitief
Hoog (keyword stuffing)
Woordenlijsten, productnamen
Structuur- en templatemodules
Gemiddeld
Zeer laag
Algemeen
Laag
Elke website, als basislaag
Semantische voorstellen met goedkeuring
Hoog
Gemiddeld (controle)
Natuurlijk en gevarieerd
Laag
Blogs en contenthubs
Linken op basis van entiteiten
Hoog bij benoemde zaken
Gemiddeld
Precies
Gemiddeld
Reizen, e-commerce, catalogi
Op basis van de graaf (interne PageRank)
Wisselend
Hoog (analyse)
Hangt af van het filter
Gemiddeld
Grote websites, weggestopte commerciële pagina's
Linken tijdens het schrijven
Hoog
Laag
Het meest natuurlijk
Laag
Websites die vaak publiceren
Automatisering dient een architectuur, ze vervangt er geen
Bepaal voordat je iets instelt welke vorm de links moeten tekenen. Een netwerk in Wikipedia-stijl linkt elke pagina naar elke verwante pagina; dat is de standaarduitkomst van semantische tools en past goed bij encyclopedische inhoud. Een semantische cocon beperkt links tot pagina's binnen dezelfde onderwerpboom, waarbij moederpagina's naar beneden linken en dochterpagina's naar boven en opzij; je regels moeten links tussen cocons verbieden, behalve aan de top. Een URL-silo volgt de mappenstructuur (/guides/seo/...); een eenvoudige regel "alleen binnen dezelfde map linken, plus de hub" dwingt dat af. Topic clusters, beschreven in onze gids over topic clusters en pillarpagina's, zitten tussen de cocon en het netwerk in. Ons artikel over sitearchitectuur voor SEO helpt je kiezen.
De regels die automatische links veilig houden
Een linkengine zonder regels is een spamgenerator. Dit zijn de instellingen die je vastlegt vóór de eerste run, met waarden die werken als startpunt.
Volledig automatisch invoegen of voorstellen en goedkeuren
Volledig automatisch
Schaalt direct naar elk volume
Geen redactietijd
Fouten worden op grote schaal gepubliceerd
Rare ankers en verkeerde contexten glippen erdoor
Moeilijk uit te leggen waarom een link bestaat
Voorstellen en goedkeuren
De machine vindt, de mens beslist
Elke link heeft een eigenaar en een reden
Regels verbeteren dankzij afgewezen voorstellen
Betrouwbare regels kunnen naar automatisch
Vraagt elke week controletijd
Limieten en dichtheid
Automatische links per pagina: 3 tot 5 in een artikel van 1500 woorden, bovenop de links die de schrijver plaatste. Google zegt dat er geen ideaal aantal is, maar waarschuwt tegen overdadig linken; je eigen data vertellen je meer dan welke vuistregel ook.
Eén link per doel per pagina. Dezelfde URL drie keer linken in één artikel voegt niets toe voor lezers en vertroebelt je rapportage.
Minimale afstand: minstens 50 tot 80 woorden tussen twee automatische links, zodat alinea's niet blauw kleuren.
Maximum per ankerformulering op de website: beperk hoeveel pagina's exact hetzelfde anker naar hetzelfde doel mogen gebruiken en dwing daarna varianten af.
Verboden zones
Voeg nooit links in in koppen, de inhoudsopgave, bijschriften van afbeeldingen, citaten, call-to-actionknoppen, auteursblokken of binnen een bestaande <a> (geneste links zijn ongeldige HTML). Link een pagina nooit naar zichzelf, naar een URL die doorstuurt of naar een pagina met noindex of een canonical naar een andere URL.
Regels voor ankers
De documentatie van Google vraagt om ankertekst die "beschrijvend, redelijk beknopt en relevant is voor de pagina waarop hij staat", en noemt "klik hier" en "lees meer" te algemeen. Vertaal dat naar regels: ankers van 2 tot 6 woorden, uit de bestaande zin, minstens twee of drie verschillende varianten per doel op de website en één zoekintentie per anker. Als "tool voor interne links" op de ene pagina naar een gratis analysetool linkt en op een andere naar een betaalde functie, vertel je zoekmachines twee verhalen. Onze gids over ankertekst gaat dieper in op de soorten ankers.
Crawl de hele website met een desktopcrawler zoals Screaming Frog (onze gids voor het instellen van Screaming Frog loopt de configuratie door). Exporteer voor elke indexeerbare URL: inkomende interne links (uniek), klikdiepte, uitgaande links en de interne linkscore van de crawler. Vergelijk de crawl met je XML-sitemap: URL's die in de sitemap staan maar niet door de crawl gevonden worden, zijn je weespagina's. Sla deze export op met een datum. Dat is je "voor".
Stap 2: de pagina's opsommen die links moeten krijgen
Niet elke pagina verdient meer links. Maak een korte lijst met prioriteitsdoelen: pagina's die geld opleveren, pagina's op positie 5 tot 20 voor waardevolle zoekopdrachten (Search Console, Prestatierapport, filter op positie) en je cornerstone content. Voeg elke weespagina toe en elke pagina die dieper ligt dan 3 klikken. Deze lijst voedt de "priority_targets" in je regels.
Stap 3: de ankerbank opbouwen
Verzamel voor elk prioriteitsdoel 3 tot 10 ankerformuleringen. De beste bron is Search Console: open de pagina in het Prestatierapport, ga naar het tabblad Zoekopdrachten en exporteer de zoekopdrachten waarvoor ze al vertoningen krijgt. Voeg de H1, het hoofdzoekwoord en natuurlijke varianten toe. Schrap alles wat dubbelzinnig is of gedeeld wordt met een andere pagina.
Stap 4: kandidaten genereren en filteren
Draai je tool of script. Voor elk doel moet die bronpagina's teruggeven waar het anker in de tekst voorkomt en waarvan het onderwerp dichtbij genoeg ligt. Verwacht dat de trechter sterk versmalt: dat is een teken dat de filters werken.
Hoe linkkandidaten worden gefilterd
Elk paar van bron en doel op de websiteAlle paren
Paren boven de gelijkenisdrempelTop 20 per pagina
Paren met een natuurlijk anker in de tekstAnker gevonden
Paren die limieten en verboden zones respecterenRegels gehaald
Goedgekeurde en gepubliceerde links3 tot 5 per pagina
Stap 5: in batches controleren
Controleer de voorstellen in een spreadsheet met vijf kolommen: bron, doel, anker, zin, score. Lees de zin, niet alleen het anker. Wijs alles af wat je zelf niet zou hebben geschreven. Noteer waarom je afwijst (verkeerde betekenis, te commercieel, vlakbij al gelinkt): die redenen worden nieuwe regels.
Stap 6: in golven publiceren, niet alles tegelijk
Publiceer 50 tot 200 links per golf, op een groep pagina's die je kunt volgen. Houd een controlegroep van vergelijkbare pagina's zonder nieuwe links. Zo hebben veranderingen in klikken een referentiepunt, en dat is belangrijk, want posities bewegen om veel redenen.
Stap 7: opnieuw crawlen en de gerenderde HTML controleren
Crawl de website opnieuw. Controleer dat de nieuwe links als <a href> in de ruwe HTML staan, en niet pas verschijnen nadat JavaScript is uitgevoerd. Gebruik voor een paar URL's de URL-inspectietool van Search Console en bekijk de gerenderde HTML die Google ziet.
Stap 8: koppelen aan het publicatieproces
De echte winst is doorlopend. Bij elke publicatie moet het systeem twee dingen doen: vanuit het nieuwe artikel linken (tijdens het schrijven) en links naar het artikel voorstellen vanaf oudere pagina's (achteraf linken). Bij elke URL-wijziging moet het de links die ernaar wijzen bijwerken of verwijderen.
Tip
Wil je één pagina snel controleren, plak dan de URL in onze gratis interne-linkanalyse: die toont elke interne link op de pagina met anker en attributen, zodat je kunt bevestigen dat een golf automatische links is gepubliceerd zoals gepland.
Zelf bouwen: een semantisch script voor interne links in Python
Heeft je CMS geen goede tool, of wil je precies begrijpen wat een leverancier doet, dan past een werkend prototype in ongeveer 60 regels. Deze versie leest de sitemap, haalt de hoofdinhoud op, berekent embeddings met een opensourcemodel en levert een CSV met voorstellen om te controleren. Het script raakt je website nooit aan.
import csv, re
from urllib.parse import urljoin
import requests
from bs4 import BeautifulSoup
from sentence_transformers import SentenceTransformer, util

SITEMAP = "https://example.com/sitemap.xml"
urls = re.findall(r"<loc>(.*?)</loc>", requests.get(SITEMAP, timeout=20).text)

pages = {}
for url in urls:
    r = requests.get(url, timeout=20)
    if r.status_code != 200 or r.url != url:
        continue  # fouten en redirects overslaan
    soup = BeautifulSoup(r.text, "html.parser")
    robots = soup.find("meta", attrs={"name": "robots"})
    if robots and "noindex" in robots.get("content", ""):
        continue
    main = soup.find("article") or soup.find("main") or soup.body
    for tag in main.find_all(["nav", "header", "footer", "aside", "script", "style"]):
        tag.decompose()
    pages[url] = {
        "h1": soup.h1.get_text(" ", strip=True) if soup.h1 else "",
        "text": main.get_text(" ", strip=True),
        "links": {urljoin(url, a["href"]).split("#")[0] for a in main.find_all("a", href=True)},
    }
Embeddings, koppelen en ankers zoeken
model = SentenceTransformer("all-MiniLM-L6-v2")
keys = list(pages)
docs = [pages[u]["h1"] + ". " + pages[u]["text"][:2000] for u in keys]
emb = model.encode(docs, normalize_embeddings=True)
sim = util.cos_sim(emb, emb)

# Ankerbank: doel-URL -> formuleringen (H1 + zoekopdrachten geëxporteerd uit Search Console)
anchors = {u: [pages[u]["h1"].lower()] for u in keys}
# anchors["https://example.com/crawl-budget"] += ["crawl budget", "crawl budget optimization"]

THRESHOLD, MAX_PER_PAGE = 0.55, 5

def find_anchor(text, phrases):
    for phrase in sorted(phrases, key=len, reverse=True):
        if len(phrase.split()) < 2:
            continue
        m = re.search(r"\b" + re.escape(phrase) + r"\b", text, re.IGNORECASE)
        if m:
            start = max(0, m.start() - 120)
            return m.group(0), text[start:m.end() + 120]
    return None, None

rows = []
for i, src in enumerate(keys):
    added = 0
    for j in sorted(range(len(keys)), key=lambda k: -float(sim[i][k])):
        score = float(sim[i][j])
        if score < THRESHOLD or added == MAX_PER_PAGE:
            break
        tgt = keys[j]
        if tgt == src or tgt in pages[src]["links"]:
            continue
        anchor, context = find_anchor(pages[src]["text"], anchors[tgt])
        if anchor:
            rows.append([src, tgt, anchor, round(score, 2), context])
            added += 1

with open("link_suggestions.csv", "w", newline="", encoding="utf-8") as f:
    csv.writer(f).writerows([["source", "target", "anchor", "score", "context"]] + rows)
Zo maak je het geschikt voor productie
Ontzie de server: bouw een pauze in tussen verzoeken en gebruik een duidelijke User-Agent, of lees de inhoud direct uit de CMS-database of API in plaats van te crawlen.
Gebruik betere tekst voor embeddings: titel plus H1 plus de eerste 300 woorden werkt meestal beter dan de hele pagina, die het onderwerp verwatert.
Schaal het koppelen op: de gelijkenismatrix groeit met het kwadraat van het aantal pagina's. Boven 20000 pagina's gebruik je een index voor benaderde dichtstbijzijnde buren (bijvoorbeeld FAISS) en vergelijk je elke pagina alleen met haar 50 dichtstbijzijnde buren.
Voeg prioriteiten toe: vermenigvuldig de score met een bonus voor prioriteitsdoelen en een straf voor doelen die al veel inkomende links hebben.
Respecteer je architectuur: verwijder bij een silo of cocon de paren waarvan de URL's niet dezelfde toegestane map of onderwerpboom delen.
Voeg server-side in: schrijf goedgekeurde links via de CMS-API in de opgeslagen inhoud, nooit via een frontendscript.
Ongelinkte vermeldingen vinden met een crawler
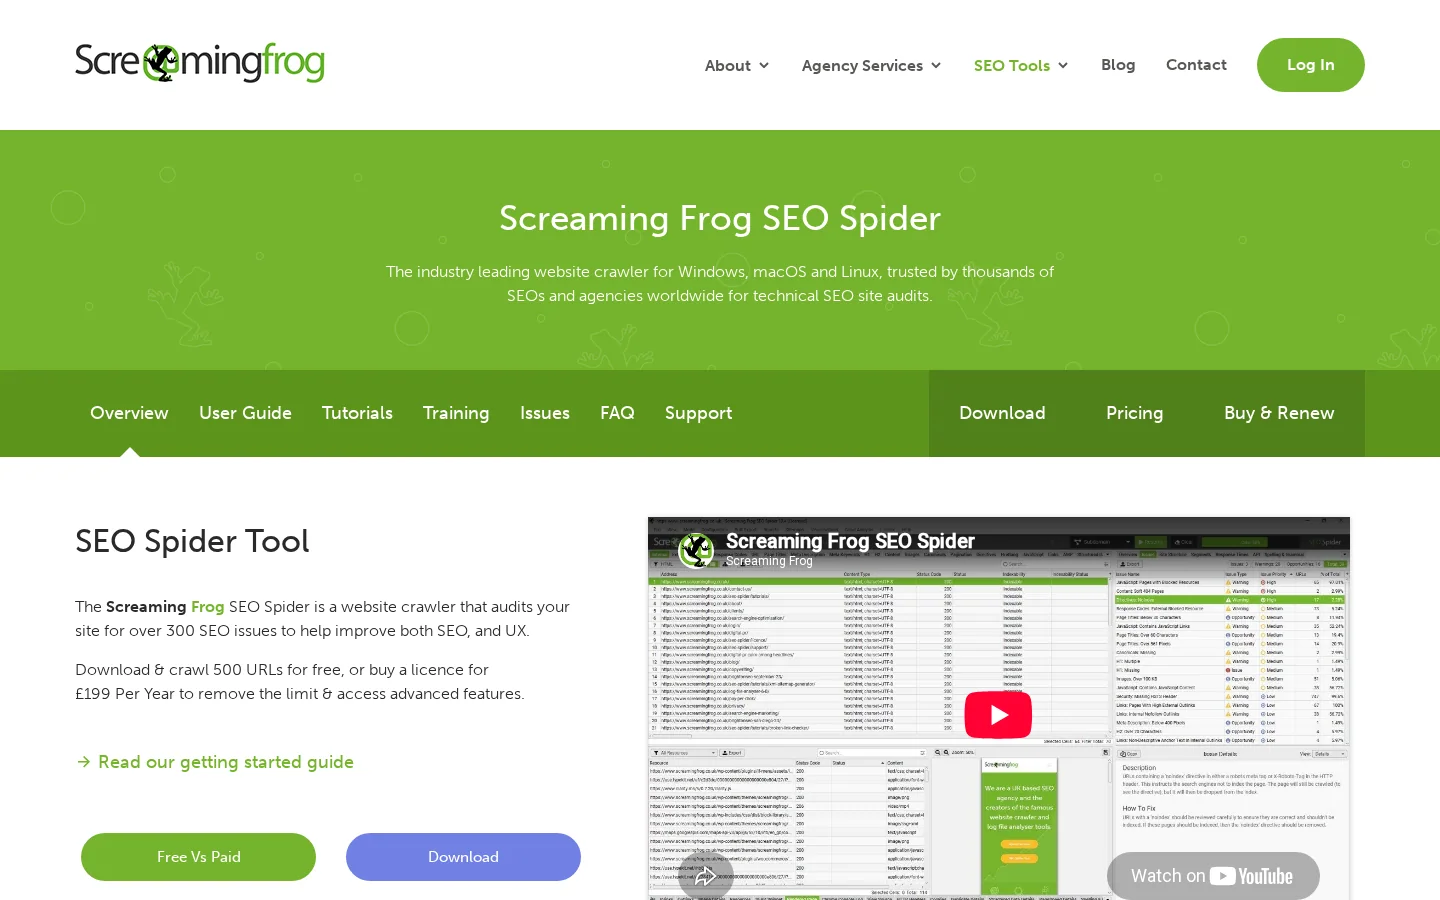
Ook zonder code kan een crawler een deel van het werk doen. In Screaming Frog vindt de functie Custom Search elke pagina met een bepaalde formulering, en Custom Extraction met XPath telt de links naar een bepaald doel. Pagina's die de formulering bevatten maar geen link naar het doel hebben, zijn je kandidaten. De gebruikershandleiding van de SEO Spider beschrijft ook de Link Score, "een maat tussen 0 en 100 die de relatieve waarde van een pagina berekent op basis van haar interne links", waarvoor je na de crawl de crawl analysis moet draaien.
Screaming Frog SEO Spider: crawl je website, exporteer interne links en ankers en vind pagina's die een onderwerp noemen zonder ernaar te linken.
Veelgemaakte fouten met automatische interne links (en hoe je ze oplost)
De meeste problemen met automatisch linken zijn geen penalty's. Het zijn verspilde links, verwarrende signalen en pagina's die lezen alsof een machine ze schreef. Zo herken en herstel je elk probleem.
1. Elke keer dat een zoekwoord voorkomt een link plaatsen
Wat het is: een regelgebaseerde plugin zonder limieten linkt "SEO-audit" op 400 pagina's met hetzelfde anker naar dezelfde pagina. Hoe je het herkent: sorteer in de ankertekstexport van je crawler de interne ankers op frequentie; één formulering die honderden keren identiek naar één URL wijst, is het signaal. Hoe je het oplost: beperk het gebruik per regel op de website, eis minstens twee varianten per doel en haal de links weg van pagina's waar het onderwerp alleen terloops wordt genoemd.
2. Linken in de verkeerde betekenis
Wat het is: het woord klopt, de betekenis niet ("appel" de vrucht gelinkt aan een artikel over iPhones, "Java" het eiland gelinkt aan een programmeertutorial). Hoe je het herkent: bekijk elke maand een willekeurige steekproef van 30 automatische links en lees de hele zin. Hoe je het oplost: verhoog de gelijkenisdrempel, eis zowel een match op formulering als op onderwerp en voeg uitsluitingswoorden toe aan dubbelzinnige regels.
3. Te veel links per alinea
Wat het is: de engine stapelt vier links in een alinea van 60 woorden. Lezers klikken niet meer en de tekst leest moeilijk. Hoe je het herkent: bereken het aantal links per 100 woorden hoofdinhoud; alles boven 3 verdient een nadere blik. Hoe je het oplost: stel een minimale afstand in woorden in tussen automatische links en een limiet per pagina die de al geplaatste links meetelt.
4. Links in koppen, knoppen of binnen andere links
Wat het is: een treffer in een H2, een inhoudsopgave of een bestaand anker wordt in een nieuwe link verpakt, wat geneste <a>-tags of blauwe koppen oplevert. Hoe je het herkent: haal een paar pagina's door een HTML-validator, of zoek in de crawl naar koppen die links bevatten. Hoe je het oplost: leg verboden selectors expliciet vast en test ze op een stagingkopie vóór elke nieuwe regel.
5. Links die alleen in JavaScript bestaan
Wat het is: een frontendwidget voegt links toe nadat de pagina is geladen, soms zonder href, soms pas na scrollen of klikken. Hoe je het herkent: vergelijk de ruwe HTML (paginabron) met de gerenderde DOM en controleer de gerenderde HTML in de URL-inspectie van Search Console. Hoe je het oplost: verplaats het invoegen naar de server of naar de opgeslagen inhoud. Onze gids over JavaScript-SEO legt renderen uitgebreid uit.
Let op
Veel AI-crawlers voeren helemaal geen JavaScript uit. Een link die pas verschijnt nadat scripts zijn uitgevoerd, kan na het renderen zichtbaar zijn voor Googlebot en toch onzichtbaar blijven voor de bots die ChatGPT, Claude of Perplexity voeden.
6. Linken naar redirects, noindex-pagina's en 404's
Wat het is: automatische links die op een oude inventaris zijn gebaseerd, blijven wijzen naar URL's die verplaatst of verwijderd zijn. Hoe je het herkent: filter in een crawl de interne links op statuscode (3xx, 4xx) en op niet-indexeerbaar doel; onze gratis checker voor kapotte links doet dat voor één pagina. Hoe je het oplost: ververs de inventaris vóór elke run, accepteer alleen doelen met status 200, indexeerbaar en met een canonical naar zichzelf, en werk links direct bij als er een 301 wordt aangemaakt.
7. Alleen vertrouwen op widgets "gerelateerde berichten"
Wat het is: de website denkt goed gelinkt te zijn omdat elk artikel eindigt met drie gerelateerde berichten. Die blokken kiezen vaak op tag of datum, wisselen steeds en slaan oude inhoud helemaal over. Hoe je het herkent: je overzicht van weespagina's (sitemap-URL's die de crawl niet bereikt, of alleen via paginering) blijft lang. Hoe je het oplost: houd de widget, maar voeg contextuele links in de tekst toe en vaste links vanaf hubpagina's.
8. Eén anker naar twee pagina's laten wijzen
Wat het is: "tool voor interne links" linkt in sommige artikelen naar pagina A en in andere naar pagina B. Je verdeelt de relevantiesignalen en kunt keyword-kannibalisatie voeden. Hoe je het herkent: maak uit de crawl een overzicht van anker naar doel en markeer elk anker met meer dan één doel. Hoe je het oplost: één zoekintentie, één doelpagina; wijs de ankers van de zwakkere pagina opnieuw toe.
9. Geen logboek, geen weg terug
Wat het is: links zijn in de inhoud gezet door een plugin die later is verwijderd, of niemand weet welke links automatisch zijn. Hoe je het herkent: je kunt de vraag "hoeveel links heeft de tool vorige maand toegevoegd?" niet beantwoorden. Hoe je het oplost: sla elke automatische link op in een tabel (bron, doel, anker, regel, datum, status), markeer ze in de HTML met een data-attribuut als je stack dat toelaat en controleer dat je alle links van één regel in één handeling kunt verwijderen.
Fout
Signaal om op te letten
Oplossing
Elke vermelding gelinkt
Eén anker honderden keren naar één URL
Sitebrede limieten, ankervarianten
Verkeerde betekenis
Vreemde zinnen in een handmatige steekproef
Hogere drempel, uitsluitingswoorden
Linkdichtheid
Meer dan 3 links per 100 woorden
Afstand in woorden, limiet per pagina
Verboden zones
Links in koppen, geneste ankers
Expliciete uitsluitingsselectors
Links alleen in JavaScript
Links ontbreken in de paginabron
Server-side invoegen
Dode doelen
Interne 3xx- en 4xx-links in de crawl
Inventaris verversen, alleen doelen met 200
Alleen linken via widgets
Lange lijst weespagina's
Contextuele links en hublinks
Eén anker, twee doelen
Ankeroverzicht met dubbelingen
Eén intentie, één pagina
Geen logboek
Automatische links zijn niet te tellen
Linktabel, data-attribuut, terugdraaien
Hoe je de impact van automatische interne links meet
Interne links zorgen zelden voor een sprong van de ene op de andere dag. Meet op de pagina's die links hebben gekregen, vergeleken met de controlegroep, over 4 tot 12 weken.
Wat je na elke golf links volgt
Aantal weespagina's (sitemap tegenover crawl)
Pagina's die meer dan 3 klikken van de homepage liggen
Unieke inkomende interne links per prioriteitspagina
Vertoningen en gemiddelde positie van doelpagina's in Search Console
Klikken op doelpagina's tegenover de controlegroep
Crawlfrequentie van doelpagina's in de serverlogs
Aandeel automatische links dat bij controle wordt afgewezen (kwaliteit van de regels)
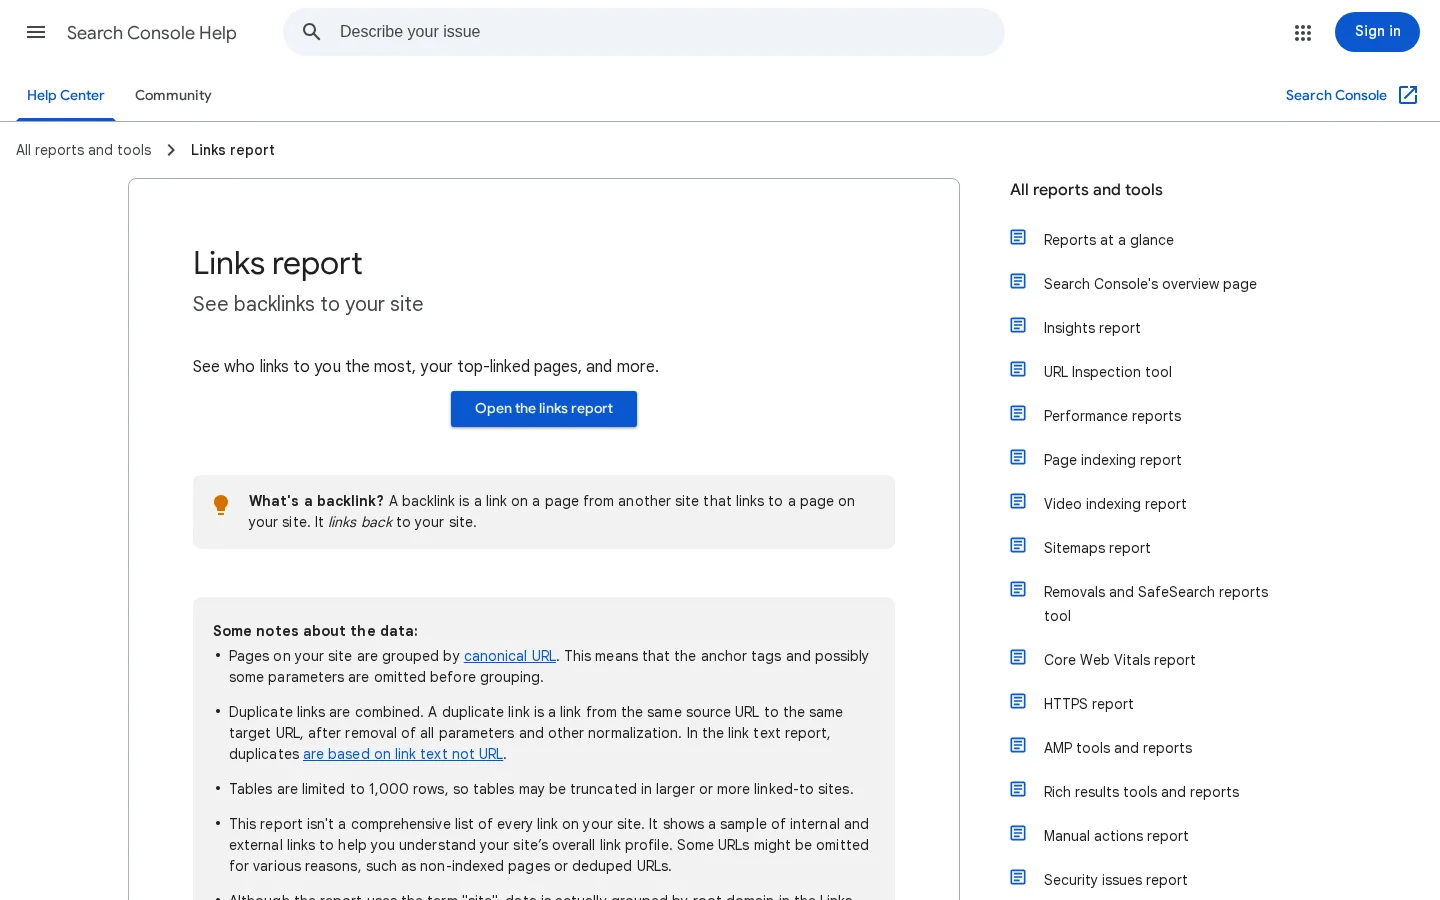
Het Links-rapport in Search Console
Het Links-rapport in Search Console toont je "meest intern gelinkte pagina's" en per pagina de pagina's die ernaar linken. Het is handig als sanity check (staan je prioriteitspagina's bovenaan?), maar de helppagina van Google waarschuwt dat de tabellen beperkt zijn tot 1000 rijen en dat het rapport "geen volledige lijst van alle links op je site" is. Gebruik je eigen crawl als bron van waarheid en Search Console om te zien wat Google daadwerkelijk heeft opgepikt.
Het Links-rapport in Search Console toont je meest intern gelinkte pagina's, met een limiet van 1000 rijen: gebruik het als controle, niet als bron van waarheid.
Serverlogs
Als je er toegang toe hebt, laten serverlogs zien of Googlebot en AI-crawlers de nieuw gelinkte pagina's na een golf vaker bezoeken. Dat is het meest directe signaal dat de vindbaarheid is verbeterd. Onze gids over logbestandanalyse voor SEO legt uit hoe je bots filtert en de crawlfrequentie leest, en waarom dat belangrijk is voor het crawlbudget van grote websites.
De resultaten eerlijk lezen
Stijgen de vertoningen op de doelpagina's maar niet in de controlegroep, dan hebben de links waarschijnlijk geholpen. Stijgen ze in beide, dan is het vermoedelijk een seizoens- of algoritme-effect. Krijgen doelpagina's meer vertoningen maar niet meer klikken, dan is de volgende hefboom de titel en de inhoud, niet meer links. En beweegt er na 12 weken niets, controleer dan de basis: staan de links in de ruwe HTML, en zijn de doelen echt geïndexeerd?
Waar je vandaag begint
Je hebt geen grote tool nodig om te beginnen. Kies een cluster van 20 tot 50 pagina's, crawl het, zet de weespagina's en prioriteitspagina's op een rij, bouw een ankerbank vanuit Search Console en voeg links toe in één gecontroleerde golf. Meet zes weken, leg wat je hebt geleerd vast als regels en ga dan door naar het volgende cluster.
Publiceer je vaak, dan is linken tijdens het schrijven de goedkoopste winst: elk nieuw artikel zou de editor moeten verlaten met links naar de juiste pagina's. Dat doet Sorank wanneer het artikelen voor je schrijft en publiceert, en de topic cluster generator plant de clusters die deze links volgen, met ingebouwde bescherming tegen kannibalisatie. Combineer dat voor oudere pagina's met een gecontroleerde ronde van achteraf linken volgens de methode hierboven.
Veelgestelde vragen
Zijn automatische interne links veilig voor SEO?
Ja, zolang de links relevant zijn, beschrijvende ankers gebruiken en binnen redelijke limieten blijven. De documentatie van Google vraagt om crawlbare links met beschrijvende ankertekst en waarschuwt tegen overdadig linken, niet tegen automatisering zelf. Het risico zit in tools die elke vermelding van een zoekwoord met hetzelfde anker linken, dus houd een controlestap aan en log elke automatische link.
Hoeveel interne links moet een artikel hebben?
Google zegt dat er geen ideaal aantal is. Een praktisch startpunt is 3 tot 5 automatische contextuele links in een artikel van 1500 woorden, bovenop de links die de schrijver plaatste, met één link per doel en wat afstand tussen de links. Meet op je eigen pagina's en stel bij: een correlatieonderzoek van Zyppy zag winst tot ongeveer 40 inkomende interne links per URL en een omslag vanaf ongeveer 45 tot 50.
Vervangen automatische interne links een interne-linkstrategie?
Nee. Automatisering voert een strategie uit: ze vindt kandidaten, voegt links in en houdt ze actueel. Je moet nog steeds bepalen welke pagina's voorrang krijgen, welke architectuur de links volgen (netwerk, semantische cocon of silo) en welke ankers bij welke pagina horen.
y!
Ontvang gratis je contentplan voor 30 dagen
We analyseren je concurrenten, je website en je AI-zichtbaarheid om gratis een contentplan op maat voor je te maken.
“Ik heb Sorank getest op de site van een echte klant en het is waanzinnig. Het doet alles waar een bureau je $1500 per maand voor rekent. Het gaat nu bij die klant in productie.”Guillaume Guersanguersanguillaume.com
“Wij zijn een advertentiebureau en wilden onze SEO eens en voor altijd weer op de rails krijgen. Sorank gaf ons een helder beeld van onze site, hielp ons optimalisaties te prioriteren en onze content goed te structureren. De tool is makkelijk in gebruik, goed ontworpen voor een team en erg handig om het volgen te centraliseren zonder met meerdere platforms te hoeven jongleren. Een heel solide basis om met onze SEO opnieuw te beginnen.”Gaspard MadouiAdvertentiebureau
“Dankzij Sorank heb ik me gespecialiseerd in GEO. Met de GEO-ranglijst kan ik mijn klanten hun positie ten opzichte van concurrenten in ChatGPT laten zien. Het is een echt commercieel onderscheidend vermogen.”MélanieFreelance SEO-specialist
“Geweldige service, werkt goed voor onze website en helpt ons begrijpen hoe we die kunnen verbeteren om beter te scoren in Google en elders. Gefeliciteerd, ga zo door, ik raad het aan.”Hugo T.E-commerce-ondernemer