La privacy è importante per noi, quindi hai la possibilità di disabilitare alcuni tipi di archiviazione che potrebbero non essere necessari per il funzionamento di base del sito web. Il blocco delle categorie può influire sulla tua esperienza sul sito web. Ulteriori informazioni (Politica sui cookie)
Grazie! La tua richiesta è stata ricevuta!
Ops! Qualcosa è andato storto durante l'invio del modulo.
Studio sugli annunci di ChatGPT: cosa mostrano le ricerche e come leggerle
Cosa misurano gli studi sugli annunci di ChatGPT, dove si contraddicono e come leggere i loro numeri prima di cambiare la tua strategia di annunci o di brand.
Illustrazione di una risposta di chat con una piccola scheda sponsorizzata etichettata sotto, accanto a un grafico a barre con i risultati degli studi.
Strumenti
In questa pagina
In breve
Gli annunci di ChatGPT sono spazi sponsorizzati che OpenAI mostra agli adulti con accesso effettuato nei piani Free e Go. Tre studi pubblicati tra agosto e novembre 2026 hanno misurato con quale frequenza compaiono questi annunci, se corrispondono alla domanda e a chi arrivano. Nessuno dimostra che gli annunci cambino la risposta in sé, e la maggior parte dei campioni è piccola o di breve durata.
3 giorni gratis, poi smetti quando vuoi. Garanzia di risultati di 90 giorni, soggetta a condizioni.
Cosa sono gli annunci di ChatGPT e i fatti su cui si basa ogni studio
Gli annunci di ChatGPT sono spazi sponsorizzati chiaramente etichettati che compaiono accanto alla risposta dell'assistente. Raggiungono gli adulti con accesso effettuato nei piani Free e Go, e nessun piano a pagamento li vede. Ogni studio qui sotto parte da queste regole, quindi ti servono prima di leggere qualsiasi numero.
OpenAI ha pubblicato l'annuncio del test il 9 febbraio 2026. La sua pagina dice che il test riguarda “utenti adulti con accesso effettuato dei piani Free e Go”, mentre Plus, Pro, Business, Enterprise ed Education non vedono annunci. Gli annunci sono “sempre chiaramente etichettati come sponsorizzati e separati visivamente dalla risposta organica”. OpenAI afferma inoltre che “gli annunci non influenzano le risposte che ChatGPT ti fornisce”, e che gli inserzionisti ricevono dati di prestazione aggregati, come visualizzazioni o clic, non le tue chat né i tuoi dati personali. L'annuncio di OpenAI sul test degli annunci in ChatGPT è il riferimento a cui rimandano tutti gli articoli sul tema, quindi leggilo per primo.
Tre studi pubblicati tra agosto e novembre 2026 sono le misurazioni pubbliche più dettagliate sugli annunci di ChatGPT che siamo riusciti a ricondurre alla pagina dell'editore. Pongono domande diverse, quindi non danno gli stessi numeri. La tabella mostra cosa ha misurato ciascuno e cosa lascia fuori.
Studio
Pubblicato
Dati
Cosa ha misurato
Cosa lascia fuori
SE Ranking
10 agosto 2026
50006 prompt commerciali in 20 nicchie statunitensi, dati raccolti il 23 luglio 2026
Tasso di annunci per prompt, pertinenza degli annunci rispetto al prompt, confronto con Google AI Mode
Plus e gli altri piani a pagamento, l'effetto degli annunci sulle risposte, qualsiasi trend (un solo scatto)
Seer Interactive
12 novembre 2026
161 sessioni di ricerca con IA registrate in nove studi di usabilità non moderati, da marzo a settembre 2026
Se utenti reali hanno visto annunci sullo schermo e se corrispondevano al prompt
Un campione rappresentativo di utenti (solo due dei nove studi hanno chiesto degli annunci)
Brookings
inizio ottobre 2026
91 account fittizi con accesso effettuato, più di 3600 annunci raccolti, account creati da gennaio a marzo 2026
Chi riceve annunci, verificato per reddito e per razza o origine etnica
La dimensione dei gruppi (solo pochi account per combinazione) e qualsiasi periodo successivo allo stop degli annunci agli account
I campioni dietro gli studi
50006prompt commerciali (SE Ranking)
161sessioni registrate (Seer Interactive)
91account fittizi (Brookings)
3600annunci raccolti (Brookings)
Fonti: SE Ranking, 10 agosto 2026; Seer Interactive, 12 novembre 2026; Brookings, ottobre 2026
Altri articoli su questo argomento provengono da strumenti GEO, e non siamo riusciti a verificare i loro dati su una fonte primaria, quindi li abbiamo lasciati fuori. Cita solo i numeri che puoi ricondurre alla pagina dell'editore, e controlla la riga del campione prima di ripetere qualsiasi cifra.
Come si misurano gli annunci di ChatGPT: la risposta, la scheda sponsorizzata e i dati dello studio.
Con quale frequenza compaiono annunci nelle risposte di ChatGPT?
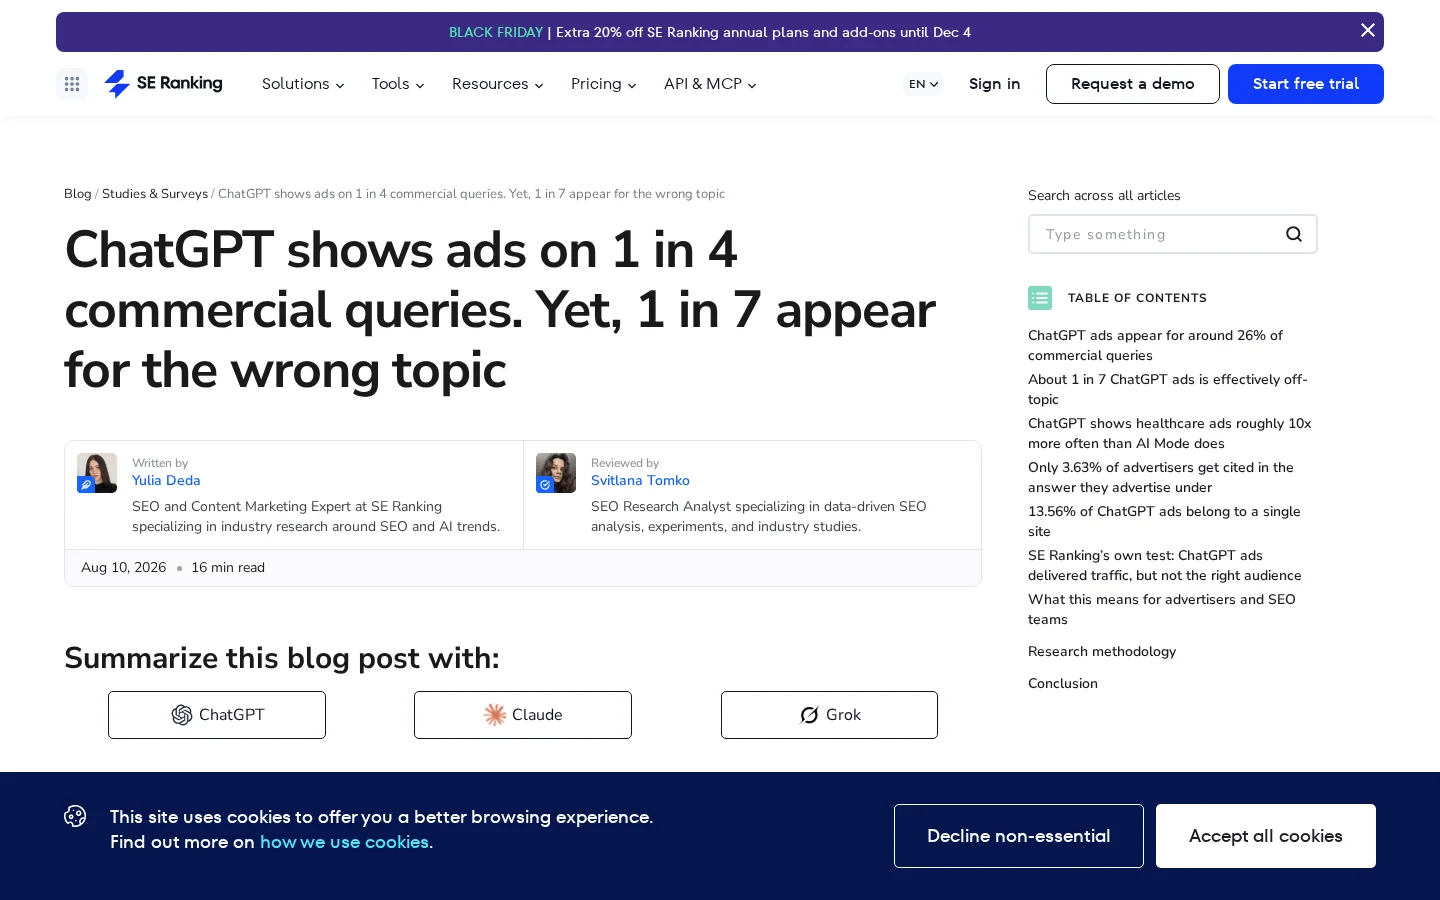
Nel campione di SE Ranking, il 25,94% dei prompt commerciali ha restituito un annuncio su ChatGPT, contro il 29,45% su Google AI Mode. Il tasso dipende molto dall'argomento, quindi un unico tasso complessivo dice poco sulle risposte che vedono i tuoi acquirenti.
SE Ranking ha usato 50006 prompt commerciali di 20 nicchie statunitensi, circa 2500 per nicchia. Per ogni prompt ha registrato la risposta generata, le fonti citate e qualsiasi spazio sponsorizzato. In totale, 12974 prompt hanno restituito un annuncio. I prompt provenivano da uno studio precedente dello stesso editore su AI Mode, il che rende confrontabili le due piattaforme. I dati sono stati raccolti il 23 luglio 2026, e lo studio è stato pubblicato il 10 agosto 2026 (SE Ranking, studio sugli annunci di ChatGPT, 10 agosto 2026).
Quota dei prompt commerciali che hanno restituito un annuncio
ChatGPT25,94%
Google AI Mode29,45%
Fonte: SE Ranking, 10 agosto 2026 (50006 prompt commerciali)
Il divario per argomento è molto più ampio di quello tra piattaforme. In sanità, lo studio ha trovato annunci sul 28,69% dei prompt di ChatGPT contro il 2,64% in AI Mode, più di dieci volte tanto. In notizie e politica, la cifra era del 28,76% su ChatGPT contro il 6,8% su AI Mode. I tassi complessivi sono simili, è il mix di argomenti che differenzia le piattaforme.
Esempio
Immagina che un acquirente chieda a ChatGPT quale software di contabilità sia adatto a un freelance. La risposta organica elenca tre strumenti, e accanto appare una scheda sponsorizzata per un quarto prodotto. È la situazione che misura il tasso: un annuncio nella stessa risposta della raccomandazione organica, non un annuncio che la sostituisce. È un'illustrazione, non un caso misurato.
Seer Interactive ha seguito un'altra strada. Il suo articolo del 12 novembre 2026 riporta 161 sessioni di ricerca con IA registrate mentre i partecipanti usavano i propri assistenti e pensavano ad alta voce. Nello studio sulle assicurazioni, 34 risposte su 76 osservabili (45%) contenevano un annuncio. Quella cifra riguarda un solo settore con 16 sessioni, quindi non è un tasso per ChatGPT in generale.
Seer riporta anche un trend a livello di utente: la quota di utenti di ChatGPT nelle sue sessioni che hanno visto un annuncio dentro la risposta è passata da 2 su 22 a marzo a 12 su 19 tra luglio e settembre 2026. Sono persone, non risposte, quindi mostrano che più partecipanti hanno visto un annuncio, non quante risposte ne contenessero uno. Il trend è il segnale più utile dei tre studi, e il meno preciso, perché i gruppi cambiano di mese in mese. Risposte e annunci cambiano da una settimana all'altra, per questo una singola rilevazione è una fotografia, non un verdetto.
Gli annunci corrispondono alla domanda?
Spesso, ma non sempre. SE Ranking stima che il 14,35% delle impressioni pubblicitarie non fosse più legato al prompt di quanto lo sarebbe un annuncio abbinato a caso. Seer ha riscontrato che ogni annuncio del suo studio sulle assicurazioni era pertinente al prompt. I due risultati vengono da campioni e test diversi, quindi descrivono cose diverse invece di contraddirsi.
Il test di SE Ranking funziona così. Calcola la similarità coseno basata su embedding tra prompt, annuncio e risposta, poi confronta ogni coppia reale prompt-annuncio con coppie mescolate a caso. Un annuncio è considerato fuori tema solo se la sua similarità cade nell'intervallo prodotto dalle coppie casuali. Un campione dei casi segnalati è stato poi riletto a mano. Ecco una lettura semplificata della logica:
sim_reale   = cos(embed(prompt), embed(annuncio))
sim_casuale = cos(embed(prompt), embed(annuncio_di_un_altro_prompt))   # coppie mescolate
fuori_tema  = sim_reale cade nell'intervallo prodotto da sim_casuale
È un test prudente. Un annuncio deve sembrare non più legato di un annuncio casuale per essere segnalato, quindi gli annunci poco pertinenti che sembrano un po' collegati passano come in tema. Gli autori dicono che il 14,35% è probabilmente una sottostima, perché la revisione manuale ha trovato più annunci poco pertinenti di quanti il test ne abbia colti. La dispersione tra gli argomenti è ampia: 2,6% per gli animali domestici, 51,1% per le relazioni e 54,2% per notizie e politica.
Due misure di pertinenza ed esposizione, da due studi
14,35%delle impressioni pubblicitarie non più legate al prompt di un annuncio casuale (SE Ranking)
45%delle risposte osservabili nelle sessioni assicurative conteneva un annuncio (Seer)
Fonti: SE Ranking, 10 agosto 2026; Seer Interactive, 12 novembre 2026
Fonte: SE Ranking, studio sugli annunci di ChatGPT, 10 agosto 2026
Seer aggiunge un punto che conta per i brand. In cinque dei sei settori con un compito di marca, la scheda sponsorizzata era di un'azienda diversa dal brand che l'utente aveva nominato. Quindi un prompt che nomina la tua azienda può mostrare l'annuncio del tuo concorrente nella stessa risposta. L'articolo di Seer nota anche che gli inserzionisti cambiano con la domanda, il che significa che gli inserzionisti che vedi dipendono da come è formulato il prompt.
Chi riceve gli annunci: cosa ha trovato l'audit di Brookings
L'audit di Brookings ha rilevato che gli account a reddito più basso avevano una probabilità significativamente maggiore di ricevere annunci, e non ha trovato prove che razza o origine etnica cambiassero la probabilità di riceverne uno. Gli autori avvertono che il campione è piccolo, quindi il risultato sulla razza, che è un risultato nullo, va trattato con cautela in entrambe le direzioni. Considera il risultato sul reddito come quello più solido.
Il disegno merita attenzione, perché è l'unico dei tre che controlla il profilo. I ricercatori hanno creato 91 account con accesso effettuato, distribuiti su tre gruppi razziali ed etnici (neri, ispanici e bianchi) e tre terzili di reddito, con almeno nove account per ogni combinazione di razza e reddito. Poiché le piattaforme non rivelano né reddito né razza, hanno usato la regione geografica come proxy, collegandosi da ciascun account con codici postali dalle caratteristiche corrispondenti. Ogni giorno gli account hanno ricevuto prompt in molte categorie di argomenti. Alcune erano categorie in cui gli annunci sono plausibili, come una ricetta di lasagne, altre erano categorie in cui OpenAI aveva detto che non avrebbe mostrato annunci, come la salute mentale. Lo studio ha raccolto più di 3600 annunci (Brookings, “Understanding the beginning of advertising on ChatGPT”, inizio ottobre 2026).
Come è stato condotto l'audit con account fittizi
Creare gli accountCostruire account con accesso effettuato e un profilo fisso in ogni gruppo.
Impostare la posizioneUsare codici postali con profili noti di reddito e razza come proxy.
Inviare ogni giorno gli stessi promptMescolare argomenti in cui gli annunci sono plausibili con argomenti in cui OpenAI dice di non mostrarne.
Salvare ogni annuncioRegistrare ogni annuncio con il prompt e l'account che l'ha ricevuto.
Confrontare i gruppiVerificare separatamente reddito e razza, e controllare la dimensione del campione prima di concludere.
Il risultato sul reddito deriva da 53 account che hanno ricevuto almeno un annuncio. Il loro reddito si concentrava attorno a una moda vicina a 60000 dollari, mentre gli account che non ne hanno mai ricevuto uno avevano il picco vicino a 80000 dollari. Il risultato è significativo nei termini dello studio, ma descrive un piccolo insieme di account di un unico periodo iniziale.
Lo studio si è anche concluso in anticipo. Circa un mese dopo l'inizio, a nessun account venivano mostrati altri annunci. Gli autori dicono che OpenAI potrebbe averli individuati. È un avvertimento per chi copia il metodo: una piattaforma che riconosce gli account di audit può cambiare ciò che vedono, quindi i dati che producono non sono un campione neutro. Lo studio non ha trovato prove che le salvaguardie sugli argomenti sensibili siano fallite, e anche qui gli autori invitano a non leggere troppo.
Gli annunci cambiano la risposta?
Nessuno studio pubblico finora mostra che lo facciano, e nessuno studio finora può dimostrare che non lo facciano. OpenAI afferma che gli annunci non influenzano le risposte. I tre studi registrano dove compaiono gli annunci e chi li vede, non se una risposta sarebbe diversa senza di essi.
I ricercatori esterni non possono disattivare gli annunci per una singola risposta, quindi non possono fare un controllo pulito. Il più vicino che possono ottenere è confrontare le risposte allo stesso prompt in giorni o account diversi. Quel confronto è viziato. Gli annunci compaiono soprattutto sui prompt commerciali, e i prompt commerciali producono già risposte diverse, con più elenchi di prodotti, confronti e fonti proprie. Una differenza nelle citazioni tra risposte con e senza annuncio non mostrerebbe da sola un'influenza.
Un test equo terrebbe costanti prompt, piano, posizione e giorno, poi registrerebbe le citazioni di ogni risposta, e ripeterebbe il test abbastanza volte da superare la rotazione degli annunci. Anche così misureresti ciò che l'assistente ha fatto, non il perché. Finché OpenAI non pubblica dati o un audit indipendente non verifica l'affermazione, tratta “gli annunci non influenzano le risposte” come la posizione dell'azienda. Gli studi pubblici non la confermano né la smentiscono.
Cosa possono e non possono dirti gli studi
Mostrato dagli studi
Con quale frequenza compaiono gli annunci, per insieme di prompt
Chi vede gli annunci, per piano e per profilo
Se un annuncio corrisponde al prompt
Non mostrato dagli studi
Se gli annunci cambiano la risposta
Prezzi d'asta o livelli di offerta
Trend su più mesi
Tre metodi di misurazione e cosa perde ciascuno
I tre studi usano tre metodi: un pannello fisso di prompt, sessioni di usabilità registrate e account fittizi. Ciascuno risponde bene a una domanda e ne perde altre, quindi confrontali per metodo e non per titolo. La dichiarazione di OpenAI è un quarto tipo di prova, un'affermazione dell'azienda e non una misurazione.
Pannello fisso di prompt (SE Ranking)
Il principio: far passare una lista fissa di prompt su ogni piattaforma e registrare ogni risposta e ogni annuncio. Quando usarlo: quando ti servono tassi su molti argomenti e vuoi confrontare le piattaforme. Vantaggio: la scala, e gli stessi prompt possono essere rieseguiti. Limite: l'insieme di prompt determina il risultato. Lo stesso SE Ranking avverte che le classifiche degli inserzionisti sono sensibili alla scelta delle parole chiave, che gli annunci ruotano così che lo stesso prompt può ricevere un annuncio diverso o nessuno se ripetuto, e che il bacino degli inserzionisti cambia rapidamente. Esempio: il divario in sanità (28,69% contro 2,64%) compare solo perché gli stessi prompt sanitari sono stati eseguiti su entrambe le piattaforme.
Sessioni registrate (Seer Interactive)
Il principio: partecipanti reali usano i propri strumenti di IA pensando ad alta voce, e lo schermo viene registrato. Seer ha campionato ogni registrazione ogni due secondi con riconoscimento del testo sul dispositivo per individuare gli spazi pubblicitari, poi ha verificato ciascuno a occhio rispetto a ciò che diceva il partecipante. Quando usarlo: quando vuoi sapere cosa vede davvero una persona sullo schermo. Vantaggio: l'annuncio era davvero a schermo, e ci sono le parole stesse del partecipante. Limite: 161 sessioni non sono un campione rappresentativo, e solo due dei nove studi hanno chiesto direttamente ai partecipanti degli annunci. In uno studio, la scansione automatica ha coinciso con la revisione manuale in ogni sessione e in ogni conteggio di annunci, ma ha sottostimato alcune varianti creative. Seer segnala inoltre che Gemini, Claude e Grok sono stati analizzati solo in alcuni studi, quindi l'assenza lì significa “quello che abbiamo osservato”, non “non esiste”.
Audit con account fittizi (Brookings)
Il principio: account controllati, con profili definiti, ricevono gli stessi prompt, quindi le differenze possono essere ricondotte al profilo. Quando usarlo: quando vuoi sapere chi viene raggiunto. Vantaggio: le variabili sono controllate, cosa che gli altri due metodi non possono fare. Limite: gruppi piccoli, la geografia come sostituto di reddito e razza, e il rischio di essere rilevati, che ha concluso in anticipo questo studio. Esempio: i 53 account che hanno ricevuto un annuncio, concentrati su redditi più bassi, contro quelli che non ne hanno mai ricevuto uno.
Metodo
Studio
Unità misurata
Domanda migliore
Principale punto cieco
Pannello fisso di prompt
SE Ranking
Prompt e risposta
Con quale frequenza, e corrisponde?
Dipende dall'insieme di prompt; un solo scatto
Sessioni registrate
Seer Interactive
Sessione e utente
Cosa vede un utente reale
Piccolo, non rappresentativo, poche domande dirette sugli annunci
Audit con account fittizi
Brookings
Account
Chi riceve annunci
Gruppi piccoli, rilevamento, fine anticipata
I numeri non coincidono per motivi che puoi nominare: prompt diversi (solo commerciali o un insieme più ampio), unità diverse (risposte, sessioni, utenti), periodi diversi (un giorno di luglio, da marzo a settembre, da gennaio a marzo) e piani diversi. Alcune sintesi secondarie attribuiscono a Seer una quota di risposte pertinenti del 38% su circa 55000 risposte. L'articolo di Seer che abbiamo letto non riporta una suddivisione del genere e copre 161 sessioni, quindi non siamo riusciti a confermare la cifra. Non citarla finché non la trovi sulla pagina dell'editore.
Quando sono stati raccolti i dati e quando sono stati pubblicati
Da gennaio a marzo 2026Brookings crea i suoi account fittizi.
9 febbraio 2026OpenAI annuncia il test degli annunci per adulti con accesso effettuato nei piani Free e Go.
Da marzo a settembre 2026Seer registra le sue sessioni di usabilità.
23 luglio 2026SE Ranking raccoglie i dati del pannello di prompt.
10 agosto 2026SE Ranking pubblica il suo studio sugli annunci di ChatGPT.
Inizio ottobre 2026Brookings pubblica il suo audit con account fittizi.
12 novembre 2026Seer Interactive pubblica il suo studio sulle sessioni.
Come misurare il tasso di annunci di ChatGPT nel tuo mercato, passo dopo passo
Esegui una lista fissa di 30 a 50 prompt di acquisto da un account Free con accesso effettuato, lo stesso giorno e nello stesso mercato, e registra ogni annuncio e ogni citazione del tuo dominio. Il tasso di annunci è il numero di risposte con un annuncio diviso per il totale delle risposte. Ripeti l'esecuzione in almeno tre giorni, perché gli annunci ruotano.
Prima di eseguire il test
Prompt scritti a partire da vere domande di acquirenti, non dalla tua lista di parole chiave
Un account che possiedi, sul piano Free, con accesso effettuato
Mercato e posizione fissi per tutta l'esecuzione
Uno screenshot salvato per ogni risposta, con data e ora
Colonne per prompt, data, annuncio sì o no, inserzionista, testo dell'annuncio e dominio citato sì o no
Una seconda persona che valuti ogni annuncio come pertinente o no
Attenzione
Non creare un insieme di account per copiare l'audit di Brookings. Gli autori dicono che, dopo circa un mese, tutti i loro account hanno smesso di ricevere altri annunci. Usa un account che possiedi, esegui i prompt a mano e leggi i termini di OpenAI prima di qualsiasi raccolta automatizzata. Un test manuale è più lento, ma protegge l'account e mantiene onesto il risultato.
Costruisci la lista di prompt. Scrivi da 30 a 50 prompt, mescolando domande commerciali (“miglior software di contabilità per freelance”) e domande informative (“come tengo traccia dell'IVA trimestrale”). I tassi di annunci cambiano in base all'intento, quindi una lista di soli prompt commerciali sovrastimerà il tasso del tuo mercato.
Fissa il contesto. Usa un account Free, lo stesso mercato e lo stesso giorno. Apri una chat nuova per ogni prompt, così i messaggi precedenti non orientano la risposta.
Registra ogni risposta. Annota se è comparso un annuncio, il nome dell'inserzionista, il testo dell'annuncio, e se il tuo dominio o un concorrente è citato nella risposta organica.
Calcola il tasso. Riporta i risultati in un foglio di calcolo. Con i prompt nella colonna A e il flag dell'annuncio (sì o no) nella colonna F, righe da 2 a 51, questa formula restituisce la quota di prompt con un annuncio:
=CONTA.SE(F2:F51;"sì")/CONTA.VALORI(A2:A51)
Verifica la pertinenza. Fai valutare ogni annuncio come in tema o no da due persone, poi confrontate. Dove non concordano, annota il prompt e l'annuncio, e stabilisci la regola prima di contare.
Ripeti. Esegui gli stessi prompt in tre giorni diversi e confronta i tassi. Un giorno mostra una risposta, tre giorni iniziano a mostrare uno schema.
Suggerimento
Prima di spendere qualsiasi cifra, verifica se ChatGPT nomina già il tuo brand nelle risposte organiche. Il nostro Controllo gratuito della visibilità su ChatGPT interroga ChatGPT con la ricerca web attiva, poi indica se il tuo dominio è citato come fonte e se il brand compare nella risposta.
Cosa significano gli studi per il tuo brand e per il tuo budget
Un annuncio compra uno spazio etichettato accanto alla risposta, non un posto dentro di essa. OpenAI dice che gli annunci non influenzano le risposte, quindi la citazione nella risposta organica non si può comprare con una campagna. Gli studi mostrano anche che la scheda sponsorizzata spesso proviene da un'azienda diversa da quella su cui l'utente ha chiesto. Pianifica per entrambi i canali e misurali separatamente.
Annuncio a pagamento o citazione organica
Annuncio a pagamento
Etichettato come sponsorizzato, e acquistato per clic o impressione
Mostrato solo agli utenti dei piani Free e Go
Si ferma quando finisce il budget
Citazione organica
Raggiunge gli utenti di tutti i piani
Dura finché durano i tuoi contenuti e le tue menzioni
Dipende da ciò che il modello recupera, e non si può pagare
I prompt di marca richiedono un'attenzione in più. Se la tua azienda è oggetto di una domanda, aspettati che lo spazio pubblicitario vada a qualcun altro. Monitora i prompt di marca per gli annunci come monitori la ricerca del brand su Google, e controlla almeno una volta a settimana, durante una campagna, l'annuncio che vedi per il tuo nome.
Testa budget piccoli e confronta il costo per acquisizione con le tue campagne di ricerca e social prima di spostare denaro. Il nostro approfondimento sugli annunci nelle risposte di IA confronta gli annunci dentro le risposte di IA con gli altri formati a pagamento, e la scrittura di annunci spiega come scrivere annunci brevi che si adattino alla conversazione.
Per il lato organico, monitora nel tempo una lista fissa di prompt invece di controllare a mano. Il monitoraggio delle menzioni IA di Sorank esegue i tuoi prompt su ChatGPT, Claude e Gemini ogni mese e mostra quali risposte menzionano il tuo brand e quali fonti citano. Se preferisci partire a mano, la nostra guida a un audit di visibilità IA spiega i passaggi, e la voce del glossario sulle citazioni IA definisce cosa conta come citazione.
Errori comuni nella lettura degli studi sugli annunci di ChatGPT
Gli errori più frequenti sono prendere un campione per l'intero mercato, mescolare risposte e utenti, e citare una cifra senza la sua unità o fonte. Ognuno è facile da riconoscere quando sai quale domanda porre.
Leggere uno studio nel modo sbagliato e nel modo giusto
Sbagliato
“ChatGPT mostra annunci su un quarto delle risposte”
“Quasi la metà degli utenti vede annunci”
“Gli annunci fanno sì che ChatGPT raccomandi brand”
Giusto
“25,94% di 50006 prompt commerciali nel campione USA di SE Ranking”
“45% delle risposte in uno studio sulle assicurazioni, 34 su 76”
“Annunci e citazioni sono comparsi insieme, e lo studio non verifica la causa”
Errore 1: prendere un campione per il mercato
Cos'è: un titolo che dice “ChatGPT mostra annunci sul X% delle risposte” quando il campione è una lista di prompt commerciali, o 16 sessioni assicurative. Come riconoscerlo: leggi la riga del campione prima del risultato, e verifica se sono descritti prompt, nicchie, sessioni o account. Come correggerlo: riformula l'affermazione con il suo campione, per esempio “nel campione di SE Ranking di 50006 prompt commerciali su 20 nicchie statunitensi”.
Errore 2: confondere le unità
Cos'è: mettere una quota di risposte accanto a una quota di utenti come se misurassero la stessa cosa. Il 45% di Seer è una quota di risposte in un solo settore, e il suo trend da 2 su 22 a 12 su 19 è una quota di utenti. Come riconoscerlo: cerca le parole “delle risposte”, “delle sessioni”, “degli utenti” o “degli account” accanto a ogni cifra. Come correggerlo: scrivi l'unità accanto a ogni numero che citi.
Errore 3: leggere uno scatto come un trend
Cos'è: chiamare trend il tasso di un solo giorno, o confrontare due studi fatti in mesi diversi come se fossero un'unica serie. Lo stesso SE Ranking avverte che gli annunci ruotano e che il bacino degli inserzionisti cambia rapidamente. Come riconoscerlo: controlla le date di raccolta. Un tasso di un giorno, o di un periodo di poche settimane, è una lettura. Come correggerlo: ripeti gli stessi prompt in più date, e confronta i tassi solo per gli stessi prompt.
Errore 4: dedurre un'influenza dalla coincidenza
Cos'è: concludere che gli annunci spingono le risposte verso o lontano da certi brand perché compaiono insieme. Gli annunci compaiono soprattutto sui prompt commerciali, e quelle risposte appaiono diverse comunque. Come riconoscerlo: ogni frase che dice che gli annunci “aumentano”, “riducono” o “modellano” le raccomandazioni, senza un controllo. Come correggerlo: scrivi “compare insieme a”, e nomina i fattori di confusione: tipo di prompt, argomento e piano.
Errore 5: citare una cifra che non hai rintracciato
Cos'è: ripetere un numero che compare in più articoli, nessuno dei quali rimanda alla pagina primaria, o il cui campione non corrisponde a quello dell'editore. Come riconoscerlo: cerca il numero sulla pagina dell'editore. Se non c'è, non appartiene a quello studio. Come correggerlo: apri la pagina primaria, trova la frase e cita la sua formulazione. Il 38% di risposte pertinenti citato sopra ne è un esempio: non l'abbiamo trovato sulla pagina di Seer, quindi non l'abbiamo usato.
Cosa fare questa settimana
Fai un piccolo test prima di prendere una decisione di budget. Misura il tasso di annunci per i tuoi prompt, registra le tue citazioni, e solo allora decidi se un test a pagamento ha senso per la tua categoria.
Un piano di una settimana
Scrivi 30 prompt di acquistoUsa le domande che i tuoi clienti fanno prima di comprare, tratte da conversazioni reali e chiamate commerciali.
Eseguili una volta su un account FreeStesso mercato, stesso giorno, una chat nuova per prompt, con screenshot.
Registra annunci e citazioniAnnota ogni annuncio, il suo inserzionista, e se il tuo dominio è citato nella risposta organica.
Ripeti in altri due giorniConfronta il tasso tra le tre esecuzioni prima di trarre una conclusione.
DecidiSe gli acquirenti della tua categoria vedono annunci, avvia un piccolo test a pagamento con tracciamento delle conversioni. Se no, investi nelle citazioni organiche.
La ricerca continuerà a cambiare man mano che la diffusione si allarga. Il metodo con cui la leggi durerà più di qualsiasi singola cifra, quindi tieni campione, unità e data accanto a ogni numero che citi.
Domande frequenti
ChatGPT mostra annunci?
Sì. Dal 9 febbraio 2026, OpenAI testa spazi sponsorizzati in ChatGPT per gli adulti con accesso effettuato nei piani Free e Go. Plus, Pro, Business, Enterprise ed Education non hanno annunci, e OpenAI afferma che gli annunci non influenzano le risposte.
Con quale frequenza compaiono annunci di ChatGPT nelle risposte?
Nel campione di SE Ranking di agosto 2026, il 25,94% dei prompt commerciali ha restituito un annuncio su ChatGPT, contro il 29,45% su Google AI Mode. Il tasso varia molto per argomento, con il divario maggiore in sanità, quindi la cifra descrive solo quel campione.
Gli annunci di ChatGPT cambiano la risposta?
Nessuno studio pubblico ha dimostrato che lo facciano, e nessuno può provare che non lo facciano. OpenAI dice che gli annunci non influenzano le risposte, ma gli studi esterni registrano solo dove compaiono gli annunci e chi li vede.
y!
Ricevi gratis il tuo piano di contenuti per 30 giorni
Analizziamo i tuoi concorrenti, il tuo sito web e la tua visibilità nelle IA per creare gratuitamente un piano di contenuti su misura.
“Ho testato Sorank sul sito reale di un cliente ed è pazzesco. Fa tutto quello che un'agenzia fa pagare 1.500 € al mese. Ora va in produzione su quel cliente.”Guillaume Guersanguersanguillaume.com
“Siamo un'agenzia pubblicitaria e volevamo rimettere in carreggiata il nostro SEO una volta per tutte. Sorank ci ha dato una visione chiara del nostro sito, ci ha aiutato a dare priorità alle ottimizzazioni e a strutturare correttamente i nostri contenuti. Lo strumento è facile da usare, ben progettato per un team e molto pratico per centralizzare il monitoraggio senza dover destreggiarsi tra più piattaforme. Una base molto solida per ripartire da zero con il nostro SEO.”Gaspard MadouiAgenzia Pubblicitaria
“Mi sono specializzata in GEO grazie a Sorank. Il GEO Leaderboard mi permette di mostrare ai miei clienti il loro posizionamento rispetto ai concorrenti su ChatGPT. È un vero differenziatore commerciale.”MélanieFreelancer SEO
“Ottimo servizio, funziona bene per il nostro sito web e ci aiuta a capire come migliorarlo per posizionarci meglio su Google e altrove. Complimenti, continuate così, ve lo consiglio.”Hugo T.Commerciante e-commerce


 ChatGPT