A privacidade é importante para nós, então você tem a opção de desativar certos tipos de armazenamento que podem não ser necessários para o funcionamento básico do site. O bloqueio de categorias pode afetar sua experiência no site. Mais informações (Política de cookies)
Ilustração de uma resposta de chat com um pequeno cartão patrocinado identificado abaixo, ao lado de um gráfico de barras com os resultados dos estudos.
Ferramentas
Nesta página
Resumo
Os anúncios do ChatGPT são espaços patrocinados que a OpenAI exibe para adultos conectados nos planos Free e Go. Três estudos publicados entre agosto e novembro de 2026 mediram com que frequência esses anúncios aparecem, se combinam com a pergunta e quem os recebe. Nenhum deles prova que os anúncios mudam a própria resposta, e a maioria das amostras é pequena ou de curta duração.
3 dias grátis, depois você para quando quiser. Garantia de resultados de 90 dias, sujeita a condições.
O que são os anúncios do ChatGPT e os fatos em que todos os estudos se apoiam
Os anúncios do ChatGPT são espaços patrocinados, claramente identificados, exibidos ao lado da resposta do assistente. Eles alcançam adultos conectados nos planos Free e Go, e nenhum plano pago os vê. Todos os estudos abaixo partem dessas regras, então você precisa delas antes de ler qualquer número.
A OpenAI publicou o anúncio do teste em 9 de fevereiro de 2026. A página diz que o teste abrange “usuários adultos conectados nos planos de assinatura Free e Go”, enquanto Plus, Pro, Business, Enterprise e Education não veem anúncios. Os anúncios são “sempre claramente identificados como patrocinados e visualmente separados da resposta orgânica”. A OpenAI também afirma que “os anúncios não influenciam as respostas que o ChatGPT dá a você”, e que os anunciantes recebem dados de desempenho agregados, como visualizações ou cliques, e não suas conversas ou dados pessoais. O anúncio da OpenAI sobre o teste de anúncios no ChatGPT é a referência citada por todos os textos sobre o tema, então leia-o primeiro.
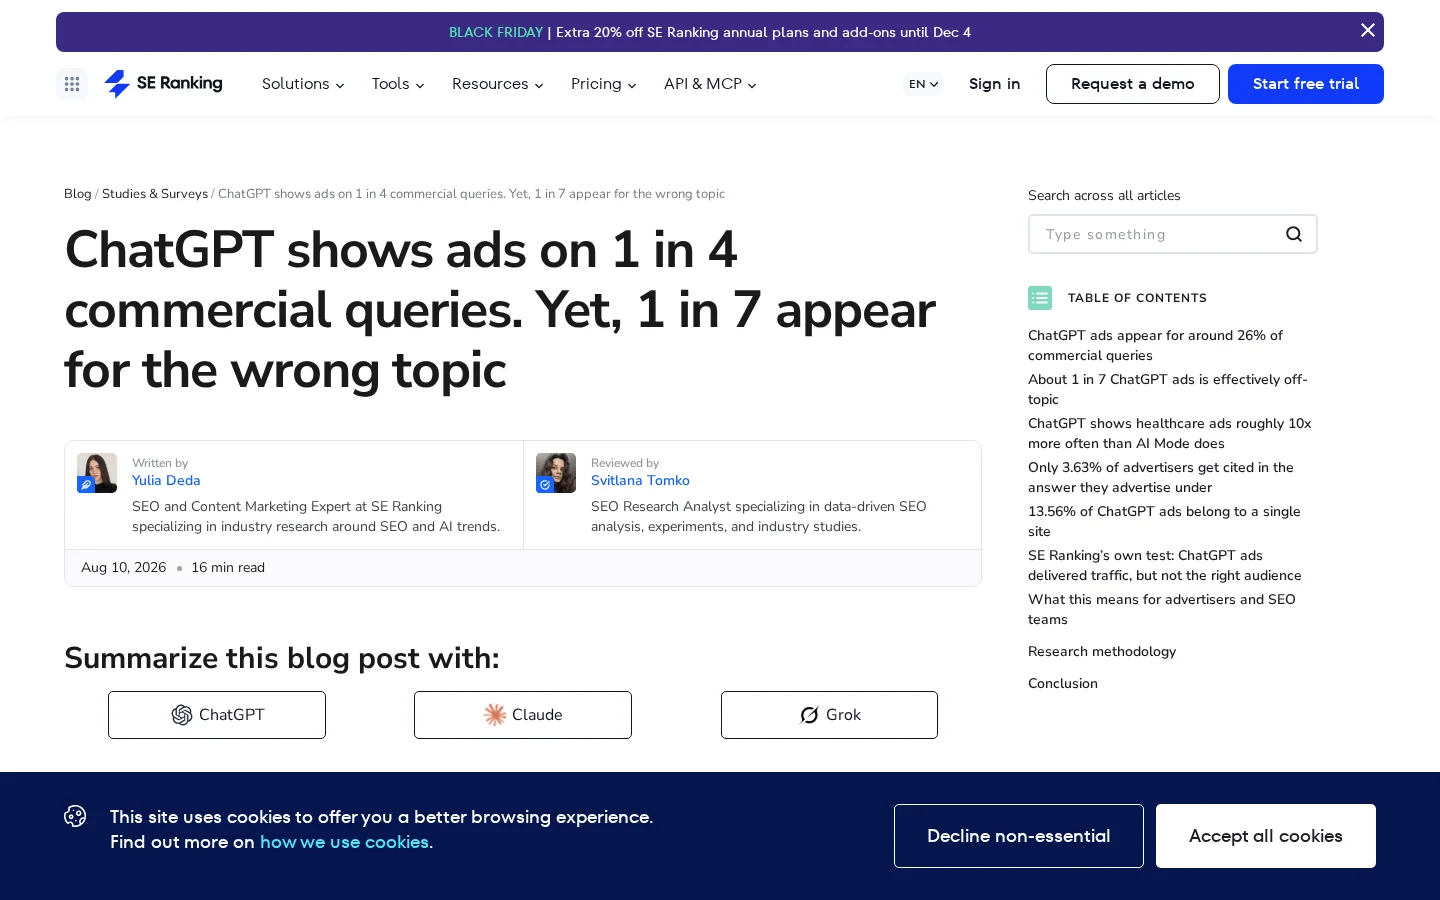
Três estudos publicados entre agosto e novembro de 2026 são as medições públicas mais detalhadas sobre anúncios do ChatGPT que conseguimos rastrear até a página do próprio editor. Eles fazem perguntas diferentes, então não dão os mesmos números. A tabela mostra o que cada um mediu e o que deixa de fora.
Estudo
Publicado em
Dados
O que mediu
O que deixa de fora
SE Ranking
10 de agosto de 2026
50006 prompts comerciais em 20 nichos dos EUA, dados coletados em 23 de julho de 2026
Taxa de anúncios por prompt, relevância dos anúncios para o prompt, comparação com o Google AI Mode
Plus e outros planos pagos, o efeito dos anúncios nas respostas, qualquer tendência (um único retrato)
Seer Interactive
12 de novembro de 2026
161 sessões gravadas de busca com IA, de nove estudos de usabilidade sem moderação, de março a setembro de 2026
Se usuários reais viram anúncios na tela e se eles combinavam com o prompt
Uma amostra representativa de usuários (apenas dois dos nove estudos perguntaram sobre anúncios)
Brookings
início de outubro de 2026
91 contas fictícias conectadas, mais de 3600 anúncios coletados, contas criadas de janeiro a março de 2026
Quem recebe anúncios, testado por renda e por raça ou etnia
O tamanho dos grupos (poucas contas por combinação) e qualquer período depois de as contas deixarem de receber anúncios
As amostras por trás dos estudos
50006prompts comerciais (SE Ranking)
161sessões gravadas (Seer Interactive)
91contas fictícias (Brookings)
3600anúncios coletados (Brookings)
Fontes: SE Ranking, 10 de agosto de 2026; Seer Interactive, 12 de novembro de 2026; Brookings, outubro de 2026
Outros textos sobre o tema vêm de ferramentas de GEO, e não conseguimos verificar os números deles em uma fonte primária, então os deixamos de fora. Cite apenas os números que você consegue rastrear até a página do editor, e confira a linha de amostra antes de repetir qualquer um deles.
Como os anúncios do ChatGPT são medidos: a resposta, o cartão patrocinado e os dados do estudo.
Com que frequência os anúncios aparecem nas respostas do ChatGPT?
Na amostra da SE Ranking, 25,94% dos prompts comerciais retornaram um anúncio no ChatGPT, contra 29,45% no Google AI Mode. A taxa depende muito do tema, então uma taxa geral única diz pouco sobre as respostas que os seus compradores veem.
A SE Ranking usou 50006 prompts comerciais de 20 nichos dos EUA, cerca de 2500 por nicho. Para cada prompt, registrou a resposta gerada, as fontes citadas e qualquer espaço patrocinado. No total, 12974 prompts retornaram um anúncio. Os prompts vieram de um estudo anterior do mesmo editor sobre o AI Mode, o que torna as duas plataformas comparáveis. Os dados foram coletados em 23 de julho de 2026, e o estudo foi publicado em 10 de agosto de 2026 (SE Ranking, estudo sobre anúncios do ChatGPT, 10 de agosto de 2026).
Proporção de prompts comerciais que retornaram um anúncio
ChatGPT25,94%
Google AI Mode29,45%
Fonte: SE Ranking, 10 de agosto de 2026 (50006 prompts comerciais)
A diferença por tema é muito maior que a diferença entre plataformas. Em saúde, o estudo encontrou anúncios em 28,69% dos prompts do ChatGPT contra 2,64% no AI Mode, mais de dez vezes mais. Em notícias e política, o número foi de 28,76% no ChatGPT contra 6,8% no AI Mode. As taxas gerais são parecidas, e é a mistura de temas que diferencia as plataformas.
Exemplo
Imagine que um comprador pergunte ao ChatGPT qual software de contabilidade serve para um freelancer. A resposta orgânica lista três ferramentas, e um cartão patrocinado de um quarto produto aparece ao lado. Essa é a situação que a taxa mede: um anúncio na mesma resposta da recomendação orgânica, e não um anúncio que a substitui. É uma ilustração, não um caso medido.
A Seer Interactive seguiu outro caminho. Seu artigo de 12 de novembro de 2026 relata 161 sessões de busca com IA gravadas enquanto os participantes usavam os próprios assistentes e pensavam em voz alta. No estudo de seguros, 34 de 76 respostas observáveis (45%) traziam um anúncio. Esse número é de um único setor com 16 sessões, então não é uma taxa do ChatGPT em geral.
A Seer também relata uma tendência no nível do usuário: a parcela de usuários do ChatGPT em suas sessões que viram um anúncio dentro da resposta subiu de 2 de 22 em março para 12 de 19 entre julho e setembro de 2026. São pessoas, não respostas, então mostram que mais participantes viram um anúncio, e não quantas respostas traziam um. A tendência é o sinal mais útil dos três estudos, e também o menos preciso, porque os grupos mudam de um mês para o outro. Respostas e anúncios mudam de uma semana para outra, por isso uma leitura isolada é um retrato do momento, não um veredito.
Os anúncios combinam com a pergunta?
Muitas vezes, mas nem sempre. A SE Ranking estima que 14,35% das impressões de anúncios não estavam mais relacionadas ao seu prompt do que um anúncio pareado ao acaso. A Seer constatou que todos os anúncios do seu estudo de seguros eram relevantes para o prompt. Os dois resultados vêm de amostras e testes diferentes, então descrevem coisas distintas e não se contradizem.
O teste da SE Ranking funciona assim. Ele calcula a similaridade de cosseno baseada em embeddings entre o prompt, o anúncio e a resposta, e depois compara cada par real de prompt e anúncio com pares embaralhados ao acaso. Um anúncio só é considerado fora do tema se a sua similaridade cair dentro da faixa produzida pelos pares aleatórios. Uma amostra dos casos marcados foi revisada à mão depois. Esta é uma leitura simplificada da lógica:
sim_real    = cos(embed(prompt), embed(anuncio))
sim_aleat   = cos(embed(prompt), embed(anuncio_de_outro_prompt))   # pares embaralhados
fora_tema   = sim_real cai dentro da faixa produzida por sim_aleat
É um teste conservador. Um anúncio precisa parecer não mais relacionado que um anúncio aleatório para ser marcado, então anúncios fracamente relevantes que parecem um pouco relacionados passam como se estivessem no tema. Os autores dizem que 14,35% provavelmente é uma subestimativa, porque a revisão manual encontrou mais anúncios fracamente relevantes do que o teste detectou. A variação entre temas é grande: 2,6% em animais de estimação, 51,1% em relacionamentos e 54,2% em notícias e política.
Duas medidas de relevância e exposição, de dois estudos
14,35%das impressões de anúncios não mais relacionadas ao prompt do que um anúncio aleatório (SE Ranking)
45%das respostas observáveis nas sessões de seguros traziam um anúncio (Seer)
Fontes: SE Ranking, 10 de agosto de 2026; Seer Interactive, 12 de novembro de 2026
Fonte: SE Ranking, estudo sobre anúncios do ChatGPT, 10 de agosto de 2026
A Seer acrescenta um ponto que importa para as marcas. Em cinco dos seis setores com uma tarefa de marca, o cartão patrocinado era de uma empresa diferente da marca que o usuário citou. Então um prompt que menciona a sua empresa pode mostrar o anúncio do seu concorrente na mesma resposta. O artigo da Seer também observa que os anunciantes mudam conforme a pergunta, o que significa que os anunciantes que você vê dependem da forma como o prompt foi escrito.
Quem recebe os anúncios: o que a auditoria da Brookings encontrou
A auditoria da Brookings constatou que contas de renda mais baixa tinham probabilidade significativamente maior de receber anúncios, e não encontrou evidência de que raça ou etnia mudassem a chance de uma conta receber um. Os autores alertam que a amostra é pequena, então o resultado sobre raça, que é um achado nulo, exige cuidado nos dois sentidos. Trate o resultado sobre renda como o mais forte.
O desenho vale a pena ser conhecido, porque é o único dos três que controla o perfil. Os pesquisadores criaram 91 contas conectadas em três grupos raciais e étnicos (negros, hispânicos e brancos) e três faixas de renda, com pelo menos nove contas em cada combinação de raça e renda. Como as plataformas não revelam renda nem raça, usaram a região geográfica como aproximação, acessando cada conta a partir de CEPs com essas características. Todos os dias, as contas receberam prompts em muitas categorias de temas. Algumas eram categorias em que anúncios são plausíveis, como uma receita de lasanha, e outras eram categorias em que a OpenAI disse que não exibiria anúncios, como saúde mental. O estudo coletou mais de 3600 anúncios (Brookings, “Understanding the beginning of advertising on ChatGPT”, início de outubro de 2026).
Como a auditoria com contas fictícias foi feita
Criar as contasMontar contas conectadas com um perfil fixo em cada grupo.
Definir a localizaçãoUsar CEPs com perfis conhecidos de renda e raça como aproximação.
Enviar os mesmos prompts todos os diasMisturar temas em que anúncios são plausíveis com temas em que a OpenAI diz não exibir nenhum.
Salvar cada anúncioRegistrar cada anúncio com o prompt e a conta que o recebeu.
Comparar os gruposTestar renda e raça separadamente, e verificar o tamanho da amostra antes de concluir.
O resultado sobre renda vem de 53 contas que receberam pelo menos um anúncio. A renda delas se concentrava em torno de uma moda perto de 60000 dólares, enquanto as contas que nunca receberam um tinham pico perto de 80000 dólares. O resultado é significativo nos termos do estudo, mas descreve um conjunto pequeno de contas de um único período inicial.
O estudo também terminou antes do previsto. Cerca de um mês depois, nenhuma conta recebia mais anúncios. Os autores dizem que a OpenAI pode tê-las identificado. Isso é um alerta para quem copiar o método: uma plataforma que reconhece contas de auditoria pode mudar o que elas veem, então os dados que produzem não são uma amostra neutra. O estudo não encontrou evidência de que as salvaguardas em temas sensíveis tenham falhado, e os autores também alertam contra interpretar isso em excesso.
Os anúncios mudam a resposta?
Nenhum estudo público até agora mostra que mudam, e nenhum estudo até agora consegue provar que não mudam. A OpenAI afirma que os anúncios não influenciam as respostas. Os três estudos registram onde os anúncios aparecem e quem os vê, não se uma resposta seria diferente sem eles.
Pesquisadores externos não conseguem desligar os anúncios para uma única resposta, então não têm um controle limpo. O mais próximo que conseguem é comparar as respostas para o mesmo prompt em dias ou contas diferentes. Essa comparação é contaminada. Os anúncios aparecem principalmente em prompts comerciais, e os prompts comerciais já produzem respostas diferentes, com mais listas de produtos, comparações e fontes próprias. Uma diferença nas citações entre respostas com e sem anúncio não mostraria influência por si só.
Um teste justo manteria constantes o prompt, o plano, a localização e o dia, registraria as citações de cada resposta e repetiria o teste vezes suficientes para superar a rotação dos anúncios. Mesmo assim, você estaria medindo o que o assistente fez, não por que fez. Até que a OpenAI publique dados ou uma auditoria independente teste a afirmação, trate “os anúncios não influenciam as respostas” como a posição da empresa. Os estudos públicos nem confirmam nem refutam isso.
O que os estudos podem e não podem dizer
Mostrado pelos estudos
Com que frequência os anúncios aparecem, por conjunto de prompts
Quem vê os anúncios, por plano e por perfil
Se um anúncio combina com o prompt
Não mostrado pelos estudos
Se os anúncios mudam a resposta
Preços de leilão ou níveis de lance
Tendências ao longo de vários meses
Três métodos de medição e o que cada um deixa passar
Os três estudos usam três métodos: um painel fixo de prompts, sessões de usabilidade gravadas e contas fictícias. Cada um responde bem a uma pergunta e deixa outras de lado, então compare-os por método e não pela manchete. A declaração da própria OpenAI é um quarto tipo de evidência, uma afirmação da empresa e não uma medição.
Painel fixo de prompts (SE Ranking)
O princípio: passar uma lista fixa de prompts por cada plataforma e registrar cada resposta e cada anúncio. Quando usar: quando você precisa de taxas em muitos temas e quer comparar plataformas. Vantagem: a escala, e os mesmos prompts podem ser rodados de novo. Limite: o conjunto de prompts define o resultado. A própria SE Ranking alerta que os rankings de anunciantes são sensíveis à escolha de palavras-chave, que os anúncios rotacionam, de modo que o mesmo prompt pode receber outro anúncio ou nenhum ao ser repetido, e que o grupo de anunciantes muda rapidamente. Exemplo: a diferença em saúde (28,69% contra 2,64%) só aparece porque os mesmos prompts de saúde foram rodados nas duas plataformas.
Sessões gravadas (Seer Interactive)
O princípio: participantes reais usam as próprias ferramentas de IA pensando em voz alta, e a tela é gravada. A Seer amostrou cada gravação a cada dois segundos com reconhecimento de texto no próprio dispositivo para encontrar unidades de anúncio, e depois conferiu cada uma a olho em relação ao que o participante dizia. Quando usar: quando você quer saber o que uma pessoa realmente vê na tela. Vantagem: o anúncio estava de fato na tela, e as palavras do próprio participante estão ali. Limite: 161 sessões não são uma amostra representativa, e apenas dois dos nove estudos perguntaram diretamente aos participantes sobre anúncios. Em um estudo, a varredura automática coincidiu com a revisão manual em todas as sessões e em todas as contagens de anúncios, mas subcontou algumas variações criativas. A Seer também observa que Gemini, Claude e Grok foram varridos apenas em alguns estudos, então a ausência deles significa “o que observamos”, e não “não existe”.
Auditoria com contas fictícias (Brookings)
O princípio: contas controladas, com perfis definidos, recebem os mesmos prompts, então as diferenças podem ser atribuídas ao perfil. Quando usar: quando você quer saber quem é alvo. Vantagem: as variáveis são controladas, algo que os outros dois métodos não conseguem fazer. Limite: grupos pequenos, a geografia como substituta de renda e raça, e o risco de detecção, que encerrou este estudo antes do prazo. Exemplo: as 53 contas que receberam um anúncio, concentradas em rendas mais baixas, em comparação com as que nunca receberam um.
Método
Estudo
Unidade medida
Melhor pergunta
Principal ponto cego
Painel fixo de prompts
SE Ranking
Prompt e resposta
Com que frequência, e combina?
Depende do conjunto de prompts; um retrato do momento
Sessões gravadas
Seer Interactive
Sessão e usuário
O que um usuário real vê
Pequena, não representativa, poucas perguntas diretas sobre anúncios
Auditoria com contas fictícias
Brookings
Conta
Quem recebe anúncios
Grupos pequenos, detecção, encerramento antecipado
Os números não batem por motivos que você consegue nomear: prompts diferentes (só comerciais ou uma mistura mais ampla), unidades diferentes (respostas, sessões, usuários), períodos diferentes (um dia de julho, de março a setembro, de janeiro a março) e planos diferentes. Alguns resumos secundários atribuem à Seer uma parcela de respostas no tema de 38% sobre cerca de 55000 respostas. O artigo da Seer que lemos não traz essa divisão e cobre 161 sessões, então não conseguimos confirmar o número. Não o cite até encontrá-lo na página do editor.
Quando os dados foram coletados e quando foram publicados
De janeiro a março de 2026A Brookings cria suas contas fictícias.
9 de fevereiro de 2026A OpenAI anuncia o teste de anúncios para adultos conectados nos planos Free e Go.
De março a setembro de 2026A Seer grava suas sessões de usabilidade.
23 de julho de 2026A SE Ranking coleta os dados do seu painel de prompts.
10 de agosto de 2026A SE Ranking publica seu estudo sobre anúncios do ChatGPT.
Início de outubro de 2026A Brookings publica sua auditoria com contas fictícias.
12 de novembro de 2026A Seer Interactive publica seu estudo de sessões.
Como medir a taxa de anúncios do ChatGPT no seu próprio mercado, passo a passo
Rode uma lista fixa de 30 a 50 prompts de compradores a partir de uma conta Free conectada, no mesmo dia e no mesmo mercado, e registre cada anúncio e cada citação do seu domínio. A taxa de anúncios é o número de respostas que trouxeram um anúncio dividido por todas as respostas. Repita a rodada em pelo menos três dias, porque os anúncios rotacionam.
Antes de rodar o teste
Prompts escritos a partir de perguntas reais de compradores, e não da sua lista de palavras-chave
Uma conta sua, no plano Free, conectada
Mercado e localização fixos durante toda a rodada
Uma captura de tela salva de cada resposta, com data e hora
Colunas para prompt, data, anúncio sim ou não, anunciante, texto do anúncio e domínio citado sim ou não
Uma segunda pessoa para avaliar cada anúncio como no tema ou não
Atenção
Não crie um conjunto de contas para copiar a auditoria da Brookings. Os autores dizem que, depois de cerca de um mês, todas as contas deles deixaram de receber mais anúncios. Use uma conta sua, rode os prompts manualmente e leia os termos da OpenAI antes de qualquer coleta automatizada. Um teste manual é mais lento, mas protege a conta e mantém o resultado honesto.
Monte a lista de prompts. Escreva de 30 a 50 prompts, misturando perguntas comerciais (“melhor software de contabilidade para freelancers”) com perguntas informativas (“como acompanho o imposto trimestral”). As taxas de anúncios variam conforme a intenção, então uma lista só com prompts comerciais vai superestimar a taxa do seu mercado.
Defina o contexto. Use uma conta Free, o mesmo mercado e o mesmo dia. Abra um chat novo para cada prompt, para que mensagens anteriores não direcionem a resposta.
Registre cada resposta. Anote se apareceu um anúncio, o nome do anunciante, o texto do anúncio e se o seu domínio ou um concorrente aparece citado na resposta orgânica.
Calcule a taxa. Coloque os resultados em uma planilha. Com os prompts na coluna A e o indicador de anúncio (sim ou não) na coluna F, linhas 2 a 51, esta fórmula devolve a proporção de prompts com anúncio:
=CONT.SE(F2:F51;"sim")/CONTAR.VAL(A2:A51)
Verifique a relevância. Peça para duas pessoas marcarem cada anúncio como no tema ou não, e compare. Onde discordarem, anote o prompt e o anúncio, e defina a regra antes de contar.
Repita. Rode os mesmos prompts em três dias diferentes e compare as taxas. Um dia mostra uma resposta; três dias começam a mostrar um padrão.
Dica
Antes de gastar qualquer coisa, verifique se o ChatGPT já menciona a sua marca nas respostas orgânicas. Nossa ferramenta gratuita de visibilidade no ChatGPT consulta o ChatGPT com a busca na web ativada e informa se o seu domínio é citado como fonte e se a sua marca aparece na resposta.
O que os estudos significam para a sua marca e o seu orçamento
Um anúncio compra um espaço identificado ao lado da resposta, e não um lugar dentro dela. A OpenAI diz que os anúncios não influenciam as respostas, então a citação na resposta orgânica não pode ser comprada com uma campanha. Os estudos também mostram que o cartão patrocinado muitas vezes vem de uma empresa diferente daquela sobre a qual o usuário perguntou. Planeje para os dois canais e meça-os separadamente.
Anúncio pago ou citação orgânica
Anúncio pago
Identificado como patrocinado, e comprado por clique ou impressão
Exibido apenas para usuários dos planos Free e Go
Para quando o orçamento acaba
Citação orgânica
Alcança usuários de todos os planos
Dura enquanto durarem os seus conteúdos e menções
Depende do que o modelo recupera, e você não pode pagar por ela
Os prompts de marca exigem atenção extra. Se a sua empresa é o assunto de uma pergunta, espere que o espaço do anúncio vá para outra pessoa. Acompanhe os prompts de marca para anúncios da mesma forma que acompanha a busca por marca no Google, e confira pelo menos uma vez por semana, durante uma campanha, o anúncio que aparece com o seu próprio nome.
Teste orçamentos pequenos e compare o custo por aquisição com as suas campanhas de busca e redes sociais antes de mover dinheiro. Nosso guia sobre anúncios em respostas de IA compara os anúncios dentro das respostas de IA com outros formatos pagos, e a redação de anúncios explica como escrever anúncios curtos que combinem com a conversa.
No lado orgânico, acompanhe uma lista fixa de prompts ao longo do tempo, em vez de conferir à mão. O monitoramento de menções de IA da Sorank executa os seus prompts no ChatGPT, Claude e Gemini todo mês e mostra quais respostas mencionam a sua marca e quais fontes elas citam. Se você preferir começar manualmente, nosso guia sobre uma auditoria de visibilidade em IA explica os passos, e o verbete do glossário sobre citações de IA define o que conta como citação.
Erros comuns ao ler estudos sobre anúncios do ChatGPT
Os erros mais frequentes são tomar uma amostra pelo mercado inteiro, misturar respostas com usuários e citar um número sem a sua unidade ou fonte. Cada um é fácil de identificar quando você sabe qual pergunta fazer.
Ler um estudo do jeito errado e do jeito certo
Errado
“O ChatGPT mostra anúncios em um quarto das respostas”
“Quase metade dos usuários vê anúncios”
“Os anúncios fazem o ChatGPT recomendar marcas”
Certo
“25,94% de 50006 prompts comerciais na amostra dos EUA da SE Ranking”
“45% das respostas em um estudo de seguros, 34 de 76”
“Anúncios e citações apareceram juntos, e o estudo não testa a causa”
Erro 1: tratar uma amostra como o mercado
O que é: uma manchete que diz “o ChatGPT mostra anúncios em X% das respostas” quando a amostra é uma lista de prompts comerciais, ou 16 sessões de seguros. Como identificar: leia a linha da amostra antes do resultado, e veja se os prompts, nichos, sessões ou contas estão descritos. Como corrigir: reformule a afirmação com a sua amostra, por exemplo “na amostra da SE Ranking de 50006 prompts comerciais em 20 nichos dos EUA”.
Erro 2: confundir as unidades
O que é: colocar uma proporção de respostas ao lado de uma proporção de usuários como se medissem a mesma coisa. Os 45% da Seer são uma proporção de respostas em um único setor, e a tendência de 2 de 22 para 12 de 19 é uma proporção de usuários. Como identificar: procure as palavras “das respostas”, “das sessões”, “dos usuários” ou “das contas” ao lado de cada número. Como corrigir: escreva a unidade ao lado de cada número que citar.
Erro 3: ler um retrato do momento como tendência
O que é: chamar de tendência a taxa de um único dia, ou comparar dois estudos feitos em meses diferentes como se fossem uma única série. A própria SE Ranking alerta que os anúncios rotacionam e que o grupo de anunciantes muda rapidamente. Como identificar: confira as datas de coleta. Uma taxa de um dia, ou de um período de algumas semanas, é uma leitura. Como corrigir: repita os mesmos prompts em várias datas, e compare as taxas somente para os mesmos prompts.
Erro 4: deduzir influência a partir da coincidência
O que é: concluir que os anúncios empurram as respostas para certas marcas ou para longe delas porque aparecem juntos. Os anúncios aparecem principalmente em prompts comerciais, e essas respostas já parecem diferentes de qualquer forma. Como identificar: qualquer frase que diga que os anúncios “aumentam”, “reduzem” ou “moldam” as recomendações, sem um controle. Como corrigir: escreva “aparece junto com”, e nomeie os fatores de confusão: tipo de prompt, tema e plano.
Erro 5: citar um número que você não rastreou
O que é: repetir um número que aparece em vários textos, nenhum dos quais aponta para a página primária, ou cuja amostra não corresponde à do editor. Como identificar: procure o número na página do editor. Se ele não estiver lá, não pertence àquele estudo. Como corrigir: abra a página primária, encontre a frase e cite o texto exato. Os 38% de respostas no tema mencionados acima são um exemplo: não encontramos o número na página da Seer, então não o usamos.
O que fazer esta semana
Faça um teste pequeno antes de tomar uma decisão de orçamento. Meça a taxa de anúncios para os seus próprios prompts, registre as suas próprias citações, e só então decida se um teste pago faz sentido para a sua categoria.
Um plano de uma semana
Escreva 30 prompts de compradoresUse as perguntas que os seus clientes fazem antes de comprar, tiradas de conversas reais e ligações de vendas.
Rode-os uma vez em uma conta FreeMesmo mercado, mesmo dia, um chat novo por prompt, com capturas de tela.
Registre anúncios e citaçõesAnote cada anúncio, o anunciante, e se o seu domínio é citado na resposta orgânica.
Repita em mais dois diasCompare a taxa entre as três rodadas antes de tirar uma conclusão.
DecidaSe os compradores da sua categoria veem anúncios, faça um pequeno teste pago com rastreamento de conversões. Se não, invista em citações orgânicas.
A pesquisa vai continuar mudando conforme a implantação se expande. O método que você usa para lê-la vai durar mais do que qualquer número isolado, então mantenha a amostra, a unidade e a data ao lado de cada número que citar.
Perguntas frequentes
O ChatGPT mostra anúncios?
Sim. Desde 9 de fevereiro de 2026, a OpenAI testa espaços patrocinados no ChatGPT para adultos conectados nos planos Free e Go. Plus, Pro, Business, Enterprise e Education não têm anúncios, e a OpenAI afirma que os anúncios não influenciam as respostas.
Com que frequência os anúncios do ChatGPT aparecem nas respostas?
Na amostra da SE Ranking de agosto de 2026, 25,94% dos prompts comerciais retornaram um anúncio no ChatGPT, contra 29,45% no Google AI Mode. A taxa varia muito por tema, com a maior diferença em saúde, então o número descreve apenas essa amostra.
Os anúncios do ChatGPT mudam a resposta?
Nenhum estudo público mostrou que mudam, e nenhum consegue provar que não mudam. A OpenAI diz que os anúncios não influenciam as respostas, mas os estudos externos registram apenas onde os anúncios aparecem e quem os vê.
y!
Receba gratuitamente o seu plano de conteúdo para 30 dias
Analisamos seus concorrentes, seu site e sua visibilidade nas IA para criar, gratuitamente, um plano de conteúdo sob medida.
“Testei o Sorank no site real de um cliente e é uma loucura. Faz tudo aquilo que uma agência cobra 1.500 € por mês. Agora vai para produção nesse cliente.”Guillaume Guersanguersanguillaume.com
“Somos uma agência de publicidade e queríamos colocar nosso SEO nos trilhos de uma vez por todas. A Sorank nos deu uma visão clara do nosso site, ajudou-nos a priorizar as otimizações e estruturar corretamente nosso conteúdo. A ferramenta é fácil de usar, bem projetada para uma equipe e muito prática para centralizar o acompanhamento sem ter que fazer malabarismos entre várias plataformas. Uma base muito sólida para recomeçar do zero com nosso SEO.”Gaspard MadouiAgência de Publicidade
“Me especializei em GEO graças à Sorank. O GEO Leaderboard me permite mostrar aos meus clientes o seu posicionamento em relação aos concorrentes no ChatGPT. É um verdadeiro diferencial comercial.”MélanieFreelancer SEO
“Excelente serviço, funciona bem para o nosso site e nos ajuda a entender como melhorá-lo para nos posicionarmos melhor no Google e em outros lugares. Parabéns, continuem assim, eu recomendo.”Hugo T.Comerciante de e-commerce


 ChatGPT