Præferencer
Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information
Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information

Hvad undersøgelserne om ChatGPT-annoncer måler, hvor de er uenige, og hvordan du læser deres tal, før du ændrer din annonce- eller brandstrategi.

Kort fortalt
ChatGPT-annoncer er sponsorerede placeringer, som OpenAI viser for loggede voksne brugere på gratisabonnementet Free og Go. Tre undersøgelser, offentliggjort mellem august og november 2026, har målt, hvor ofte annoncerne vises, om de passer til spørgsmålet, og hvem der får dem. Ingen af dem beviser, om annoncer ændrer selve svaret, og de fleste stikprøver er små eller korte.
Vil du vide mere? Spørg
Hurtig quiz
Hvordan får du nævnt af ChatGPT og andre AI-assistenter?
Sorank matcher dine svar


Test det i 3 dage på dit eget site, og se, hvor du står på Google, ChatGPT og de andre AI'er.
Start prøveperiode på 3 dage3 dage gratis, derefter stopper du, når du vil. 90 dages resultatgaranti, betingelser gælder.
ChatGPT-annoncer er mærkede sponsorerede placeringer, der vises ved siden af assistentens svar. De når loggede voksne brugere på Free- og Go-niveauerne, og ingen betalt abonnement ser dem. Alle undersøgelserne nedenfor tager udgangspunkt i disse regler, så du har brug for dem, før du læser nogen tal.
OpenAI offentliggjorde sin testmeddelelse den 9. februar 2026. Siden siger, at testen omfatter "logged-in adult users on the Free and Go subscription tiers", mens Plus, Pro, Business, Enterprise og Education ikke har annoncer. Annoncer er "always clearly labeled as sponsored and visually separated from the organic answer". OpenAI oplyser også, at "ads do not influence the answers ChatGPT gives you", og at annoncører får samlede resultatdata, som visninger eller klik, og ikke dine chats eller personlige oplysninger. OpenAI's meddelelse om test af annoncer i ChatGPT er den reference, alle artikler henviser til, så læs den først.
Planreglen betyder noget for målingen. En undersøgelse på en Plus-konto finder nul annoncer, og det siger intet om markedet. Det afspejler planen. Hvis du vil have det bredere billede af, hvordan assistenten opbygger sine svar, så start med hvordan ChatGPT fungerer, fra træning til websøgning og kilder og modelsiden for ChatGPT. Til købersiden af annoncesystemet dækker vores guide til ChatGPT-annoncer og OpenAI Ads Manager opsætning og måling.
Tre undersøgelser, offentliggjort mellem august og november 2026, er de mest detaljerede offentlige målinger af ChatGPT-annoncer, vi kunne spore tilbage til udgiverens egen side. De stiller forskellige spørgsmål, så de giver ikke de samme tal. Tabellen viser, hvad hver af dem målte, og hvad de ikke dækker.
| Undersøgelse | Offentliggjort | Data | Hvad den målte | Hvad den ikke dækker |
|---|---|---|---|---|
| SE Ranking | 10. august 2026 | 50006 kommercielle prompts på tværs af 20 amerikanske nicher, data indsamlet 23. juli 2026 | Annoncefrekvens pr. prompt, annoncernes relevans for prompten, sammenligning med Google AI Mode | Plus og andre betalte planer, annoncernes effekt på svarene, eventuel tendens (et enkelt øjebliksbillede) |
| Seer Interactive | 12. november 2026 | 161 optagne AI-søgesessioner fra ni umodererede brugbarhedsstudier, marts til september 2026 | Om rigtige brugere så annoncer på skærmen, og om de passede til prompten | En repræsentativ stikprøve af brugere (kun to af de ni studier spurgte til annoncer) |
| Brookings | Tidligt i oktober 2026 | 91 loggede sokkedukke-konti, over 3600 annoncer indsamlet, konti oprettet januar til marts 2026 | Hvem der får annoncer, testet efter indkomst og efter race eller etnicitet | Gruppestørrelse (kun få konti pr. kombination) og perioden efter, at kontiene holdt op med at få flere annoncer |
Stikprøverne bag undersøgelserne
Kilder: SE Ranking, 10. august 2026; Seer Interactive, 12. november 2026; Brookings, oktober 2026
Andre artikler om emnet kommer fra GEO-værktøjer, og vi kunne ikke kontrollere deres tal mod en primærkilde, så vi har udeladt dem. Citer kun tal, du kan spore til udgiverens egen side, og tjek stikprøvelinjen, før du gentager et af dem.
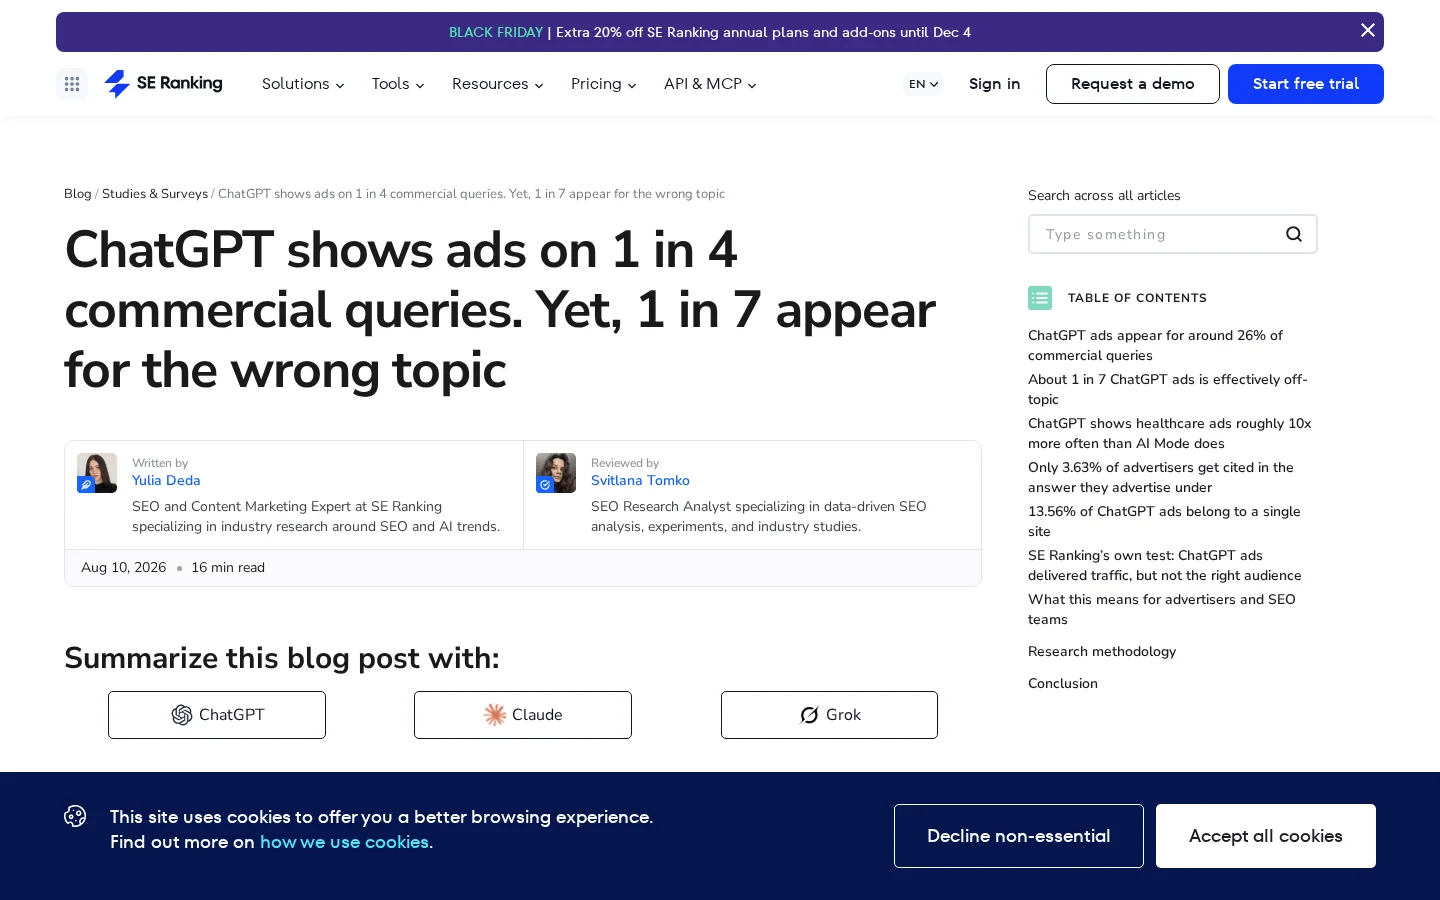
I SE Rankings stikprøve gav 25,94 % af de kommercielle prompts en annonce i ChatGPT, mod 29,45 % i Google AI Mode. Andelen afhænger kraftigt af emnet, så ét samlet tal fortæller dig lidt om de svar, dine egne købere ser.
SE Ranking brugte 50006 kommercielle prompts fra 20 amerikanske nicher, cirka 2500 pr. niche. For hver prompt registrerede de det genererede svar, de citerede kilder og eventuelle sponsorerede placeringer. I alt gav 12974 prompts en annonce. Prompterne stammede fra en tidligere AI Mode-undersøgelse fra samme udgiver, hvilket gør de to platforme sammenlignelige. Data blev indsamlet den 23. juli 2026, og undersøgelsen blev offentliggjort den 10. august 2026 (SE Ranking, ChatGPT ads study, 10. august 2026).
Forskellen mellem emner er meget større end forskellen mellem platforme. Inden for sundhed fandt undersøgelsen annoncer på 28,69 % af ChatGPT-prompterne mod 2,64 % i AI Mode, mere end ti gange højere. Under Nyheder og politik var tallet 28,76 % i ChatGPT mod 6,8 % i AI Mode. De samlede andele ligner hinanden, og det er emnefordelingen, hvor platformene adskiller sig.
Eksempel
Forestil dig, at en køber spørger ChatGPT, hvilket regnskabsprogram der passer til en freelancer. Det organiske svar nævner tre værktøjer, og et sponsoreret kort for et fjerde produkt vises ved siden af. Det er den situation, andelen måler: en annonce i samme svar som den organiske anbefaling, ikke en annonce, der erstattede den. Dette er en illustration, ikke en målt sag.
Seer Interactive valgte en anden metode. Deres artikel fra 12. november 2026 rapporterer 161 AI-søgesessioner, der blev optaget, mens deltagerne brugte deres egne assistenter og tænkte højt. I forsikringsundersøgelsen bar 34 af 76 observerbare svar (45 %) en annonce. Tallet dækker ét område med 16 sessioner, så det er ikke en andel for ChatGPT generelt.
Seer rapporterer også en tendens på brugerniveau: andelen af ChatGPT-brugere i deres sessioner, der så en annonce i svaret, steg fra 2 af 22 i marts til 12 af 19 fra juli til september 2026. Det er personer, ikke svar, så de viser, at flere deltagere så en annonce, ikke hvor mange svar der bar en. Tendensen er det mest brugbare signal i de tre undersøgelser og det mindst præcise, fordi grupperne varierer fra måned til måned. Svar og annoncer ændrer sig fra den ene uge til den næste, og derfor er en enkelt måling et øjebliksbillede, ikke en dom.
Ofte, men ikke altid. SE Ranking anslår, at 14,35 % af annonsevisningerne ikke var mere relateret til deres prompt end et tilfældigt parret annonce. Seer fandt, at hver annonce i deres forsikringsundersøgelse var relevant for prompten. De to resultater kommer fra forskellige stikprøver og forskellige tests, så de beskriver forskellige ting og modsiger ikke hinanden.
SE Rankings test fungerer sådan her. Den beregner en embedding-baseret cosinuslighed mellem prompten, annoncen og svaret og sammenligner derefter hvert rigtige par af prompt og annonce med tilfældigt blandede par. En annonce tæller kun som ikke-målrettet, når dens lighed falder inden for det interval, som tilfældige par giver. En stikprøve af de markerede tilfælde blev derefter gennemgået manuelt. Her er en forenklet udgave af logikken:
sim_real   = cos(embed(prompt), embed(ad))
sim_random = cos(embed(prompt), embed(ad_from_another_prompt))   # blandede par
off_target = sim_real falder inden for intervallet, som sim_random giver
Det er en konservativ test. En annonce skal se lige så lidt relateret ud som en tilfældig annonce for at blive markeret, så svagt relevante annoncer, der ser lidt relaterede ud, består som om de er på emnet. Forfatterne siger, at 14,35 % sandsynligvis er et underskøn, fordi manuel gennemgang fandt flere svagt relevante annoncer, end testen fangede. Spredningen mellem emner er stor: 2,6 % for Kæledyr, 51,1 % for Parforhold og 54,2 % for Nyheder og politik.
To mål for relevans og eksponering, fra to undersøgelser
Kilder: SE Ranking, 10. august 2026; Seer Interactive, 12. november 2026
Seer tilføjer et punkt, der har betydning for brands. I fem af seks brancher med en brandet opgave var det sponsorerede kort for et andet firma end det brand, brugeren nævnte. En prompt, der nævner din virksomhed, kan altså vise din konkurrents annonce i samme svar. Seers artikel bemærker også, at annoncørerne skifter med spørgsmålet, hvilket betyder, at de annoncører, du ser, afhænger af, hvordan prompten er formuleret.
Brookings' revision fandt, at konti med lavere indkomst var væsentligt mere tilbøjelige til at få annoncer, og fandt ingen tegn på, at race eller etnicitet ændrede, om en konto fik en. Forfatterne advarer om, at stikprøven er lille, så racresultatet, som er et nulfund, skal behandles forsigtigt i begge retninger. Behandl indkomstresultatet som det stærkeste.
Designet er værd at kende, fordi det er den eneste af de tre undersøgelser, der kontrollerer profilen. Forskerne oprettede 91 loggede konti på tværs af tre race- og etnicitetsgrupper (sorte, hispaniske og hvide) og tre indkomstterciler, med mindst ni konti i hver kombination af race og indkomst. Da platforme ikke viser indkomst eller race, brugte de geografisk region som stedfortræder ved at tilgå hver konto fra postnumre med disse kendetegn. Hver dag fik kontiene prompts inden for mange emnekategorier. Nogle kategorier var sådan, at annoncer er sandsynlige, som en lasagneopskrift, og andre var sådan, at OpenAI havde sagt, at de ikke ville vise annoncer, som mental sundhed. Undersøgelsen indsamlede over 3600 annoncer (Brookings, "Understanding the beginning of advertising on ChatGPT", tidligt i oktober 2026).
Sådan blev sokkedukke-revisionen gennemført
Indkomstresultatet kommer fra 53 konti, der fik mindst én annonce. Deres indkomst samlede sig omkring en typisk værdi nær 60000 dollars, mens de konti, der aldrig fik en, toppede omkring 80000 dollars. Resultatet er signifikant efter undersøgelsens målestok, men det beskriver et lille udsnit af konti fra en enkelt tidlig periode.
Undersøgelsen sluttede også tidligt. Ca. en måned inde holdt alle konti op med at få flere annoncer. Forfatterne siger, at OpenAI muligvis har opdaget dem. Det er en advarsel til alle, der kopierer metoden: en platform, der opdager revisionskonti, kan ændre, hvad de ser, så de data, de giver, er ikke en neutral stikprøve. Undersøgelsen fandt ingen tegn på, at beskyttelsen af følsomme emner svigtede, og forfatterne advarer også mod at læse for meget ind i det.
Ingen offentlig undersøgelse har indtil videre vist, at de gør, og ingen undersøgelse kan endnu bevise, at de ikke gør. OpenAI siger, at annoncer ikke påvirker svarene. De tre undersøgelser registrerer, hvor annoncer vises, og hvem der ser dem, ikke om et svar ville se anderledes ud uden dem.
Udenforstående forskere kan ikke slå annoncer fra for et enkelt svar, så de kan ikke køre en ren kontrolgruppe. Det tætteste, de kan komme, er at sammenligne svar på samme prompt på tværs af dage eller konti. Den sammenligning er forvansket: annoncer vises primært på kommercielle prompts, og kommercielle prompts giver allerede forskellige svar, med flere produktlister, sammenligninger og egne kilder. En forskel i citater mellem svar med og uden annoncer ville ikke i sig selv vise påvirkning.
En fair test ville holde prompt, plan, placering og dag konstante, registrere citaterne i hvert svar og gentage testen nok gange til at se forbi rotationen af annoncer. Selv da måler du, hvad assistenten gjorde, ikke hvorfor. Indtil OpenAI offentliggør data, eller en uafhængig revision tester påstanden, bør du opfatte "ads do not influence answers" som virksomhedens holdning. De offentlige undersøgelser hverken bekræfter eller afviser den.
Hvad undersøgelserne kan og ikke kan fortælle dig
De tre undersøgelser bruger tre metoder: et fast promptpanel, optagede brugbarhedssessioner og sokkedukke-konti. Hver besvarer ét spørgsmål godt og overser de andre, så sammenlign dem efter metode og ikke efter overskriftstallet. OpenAI's egen udtalelse er en fjerde slags belæg, en virksomhedspåstand snarere end en måling.
Princippet: kør en fast liste af prompts gennem hver platform og registrer hvert svar og hver annonce. Hvornår du bruger det: når du har brug for andele på tværs af mange emner og vil sammenligne platforme. Fordel: skala, og de samme prompts kan køres igen. Begrænsning: promptsættet bestemmer resultatet. SE Ranking advarer selv om, at annoncørrangeringer er følsomme over for søgeordsvalg, at annoncer roterer, så samme prompt ved gentagelse kan få en anden annonce eller ingen, og at annoncørpuljen ændrer sig hurtigt. Eksempel: forskellen inden for sundhed (28,69 % mod 2,64 %) opstår kun, fordi de samme sundhedsprompts blev kørt på begge platforme.
Princippet: rigtige deltagere bruger deres egne AI-værktøjer, mens de tænker højt, og skærmen optages. Seer udtog hver optagelse hvert andet sekund med tekstgenkendelse på enheden for at finde annonceenheder og kontrollerede derefter hver enhed med øjnene mod det, deltageren sagde. Hvornår du bruger det: når du vil vide, hvad en person faktisk ser på skærmen. Fordel: annoncen var virkelig på skærmen, og deltagerens egne ord er med. Begrænsning: 161 sessioner er ikke en repræsentativ stikprøve, og kun to af de ni undersøgelser spurgte deltagerne direkte om annoncer. I en undersøgelse stemte den automatiske scanning overens med manuel gennemgang i hver session og for antal annoncer, men den undertællede nogle kreative variationer. Seer bemærker også, at Gemini, Claude og Grok kun blev scannet i nogle undersøgelser, så en manglende annonce der betyder "det, vi observerede", ikke "findes ikke".
Princippet: kontrollerede konti med faste profiler får de samme prompts, så forskelle kan føres tilbage til profilen. Hvornår du bruger det: når du vil vide, hvem der bliver målrettet. Fordel: variablerne er kontrolleret, hvilket de to andre metoder ikke kan. Begrænsning: små grupper, geografi som stedfortræder for indkomst og race, og risikoen for at blive opdaget, som afsluttede denne undersøgelse tidligt. Eksempel: de 53 konti, der fik en annonce, samlet omkring lavere indkomster, mod dem der aldrig fik en.
| Metode | Undersøgelse | Målt enhed | Bedste spørgsmål | Største blinde plet |
|---|---|---|---|---|
| Fast promptpanel | SE Ranking | Prompt og svar | Hvor ofte, og matcher den? | Afhænger af promptsættet; et øjebliksbillede |
| Optagede sessioner | Seer Interactive | Session og bruger | Hvad en rigtig bruger ser | Lille, ikke repræsentativ, få direkte spørgsmål om annoncer |
| Sokkedukke-revision | Brookings | Konto | Hvem der får annoncer | Små grupper, opdagelse, tidlig afslutning |
Tallene er uenige af grunde, du kan nævne: forskellige prompts (kun kommercielle, eller en bredere blanding), forskellige enheder (svar, sessioner, brugere), forskellige perioder (én dag i juli, marts til september, januar til marts) og forskellige planniveauer. Nogle sekundære resuméer tilskriver Seer en andel på 38 % på emnet ud af cirka 55000 svar. Seer-artiklen, vi læste, rapporterer ingen sådan opdeling og dækker 161 sessioner, så vi kunne ikke bekræfte tallet. Citer det ikke, før du finder det på udgiverens egen side.
Hvornår data blev indsamlet, og hvornår det blev offentliggjort
Kør en fast liste med 30 til 50 købsprompts fra én loggede Free-konto, samme dag og på samme marked, og registrer hver annonce og hver citering af dit domæne. Annoncefrekvensen er antallet af svar, der bar en annonce, divideret med alle svar. Gentag kørslen på mindst tre dage, fordi annoncer roterer.
Før du kører testen
Advarsel
Opret ikke et sæt konti for at kopiere Brookings-revisionen. Forfatterne siger, at alle deres konti holdt op med at få flere annoncer ca. en måned inde. Brug én konto, du ejer, kør prompterne manuelt, og læs OpenAI's vilkår, før du laver nogen automatiseret indsamling. En manuel test er langsommere, men den holder kontoen sikker og resultatet ærligt.
=ANTAL.HVIS(F2:F51;"ja")/ANTALV(A2:A51)Tip
Før du bruger penge, så tjek, om ChatGPT allerede nævner dit brand i organiske svar. Vores gratis ChatGPT Visibility Checker spørger ChatGPT med websøgning slået til og viser, om dit domæne citeres som kilde, og om dit brand nævnes i svaret.
En annonce køber en mærket plads ved siden af svaret, ikke en plads i det. OpenAI siger, at annoncer ikke påvirker svarene, så citeringen i det organiske svar kan ikke købes med en kampagne. Undersøgelserne viser også, at det sponsorerede kort ofte kommer fra en anden virksomhed end den, en bruger spurgte om. Planlæg for begge kanaler, og mål dem hver for sig.
Betalt annonce eller organisk citering
Brandprompts kræver ekstra opmærksomhed. Hvis din virksomhed er emnet for et spørgsmål, så forvent, at annonceplaceringen går til en anden. Følg brandprompts for annoncer på samme måde, som du følger brandsøgninger på Google, og tjek mindst én gang om ugen den annonce, du ser for dit eget navn i løbet af en kampagne.
Test budgetter i det små, og sammenlign omkostningen pr. erhvervelse med dine søge- og sociale kampagner, før du flytter penge. Vores forklaring om AI-annoncer sammenligner annoncer i AI-svar med andre betalte formater, og annoncetekster dækker, hvordan du skriver korte annoncer, der passer til samtalen.
For den organiske side, følg en fast liste af prompts over tid i stedet for at tjekke manuelt. Sorank's AI Mention Tracking kører dine prompts i ChatGPT, Claude og Gemini hver måned og viser, hvilke svar der nævner dit brand, og hvilke kilder de citerer. Hvis du hellere vil starte manuelt, forklarer vores guide til en AI-synlighedsrevision trinene, og ordlisteposten om AI-citeringer definerer, hvad der tæller som en citering.
De mest almindelige fejl er at behandle en stikprøve som hele markedet, at blande svar sammen med brugere, og at citere et tal uden dets enhed eller kilde. Hver enkelt er let at fange, når du kender det spørgsmål, du skal stille.
At læse en undersøgelse forkert og rigtigt
Hvad det er: en overskrift, der siger "ChatGPT viser annoncer i X % af svarene", når stikprøven er en liste af kommercielle prompts eller 16 forsikringssessioner. Sådan opdager du det: læs stikprøvelinjen før resultatet, og tjek, om prompts, nicher, sessioner eller konti er beskrevet. Sådan retter du det: formuler påstanden igen med dens stikprøve, for eksempel "i SE Rankings stikprøve på 50006 kommercielle prompts på tværs af 20 amerikanske nicher".
Hvad det er: at sætte en andel af svar ved siden af en andel af brugere, som om de målte det samme. Seers 45 % er en andel af svar i ét område, og dens tendens fra 2 af 22 til 12 af 19 er en andel af brugere. Sådan opdager du det: led efter ordene "af svarene", "af sessionerne", "af brugerne" eller "af kontiene" ved siden af hvert tal. Sådan retter du det: skriv enheden ved siden af hvert tal, du citerer.
Hvad det er: at kalde en enkelt dags andel for en tendens, eller at sammenligne to undersøgelser lavet i forskellige måneder, som om de var én serie. SE Ranking advarer selv om, at annoncer roterer, og at annoncørpuljen ændrer sig hurtigt. Sådan opdager du det: tjek indsamlingsdatoerne. En andel fra én dag, eller fra en periode på få uger, er en måling. Sådan retter du det: gentag de samme prompts på flere datoer, og sammenlign kun andele for de samme prompts.
Hvad det er: at konkludere, at annoncer skubber svar hen mod eller væk fra brands, fordi de optræder sammen. Annoncer vises for det meste på kommercielle prompts, og de svar ser alligevel anderledes ud. Sådan opdager du det: enhver sætning, der siger, at annoncer "øger", "reducerer" eller "former" anbefalinger uden en kontrolgruppe. Sådan retter du det: skriv "optræder sammen med", og nævn de forvirrende faktorer: promptens type, emne og plan.
Hvad det er: at gentage et tal, der optræder i flere artikler, hvor ingen linker til primærsiden, eller hvis stikprøve ikke matcher udgiverens. Sådan opdager du det: søg efter tallet på udgiverens side. Hvis det ikke står der, hører det ikke til den undersøgelse. Sådan retter du det: åbn primærsiden, find sætningen, og citer dens ordlyd. Tallet 38 % om emnet ovenfor er et eksempel: vi kunne ikke finde det på Seers side, så vi brugte det ikke.
Kør en lille test, før du træffer en budgetbeslutning. Mål annoncefrekvensen for dine egne prompts, registrer dine egne citeringer, og beslut først derefter, om en betalt test giver mening for din kategori.
En plan for én uge
Forskningen vil fortsat ændre sig, efterhånden som udrulningen bliver bredere. Metoden, du bruger til at læse den, holder længere end ethvert enkelt tal, så behold stikprøven, enheden og datoen ved siden af hvert tal, du citerer.
Ja. Siden den 9. februar 2026 har OpenAI testet sponsorerede placeringer i ChatGPT for loggede voksne brugere på gratisplanerne Free og Go. Plus, Pro, Business, Enterprise og Education har ingen annoncer, og OpenAI siger, at annoncer ikke påvirker svarene.
I SE Rankings stikprøve fra august 2026 gav 25,94 % af de kommercielle prompts en annonce i ChatGPT, mod 29,45 % i Google AI Mode. Andelen varierer meget efter emne, og sundhed har det største gab, så tallet gælder kun for den stikprøve.
Ingen offentlig undersøgelse har vist, at de gør, og ingen kan bevise, at de ikke gør. OpenAI siger, at annoncer ikke påvirker svarene, men eksterne undersøgelser registrerer kun, hvor annoncer vises, og hvem der ser dem.
Vi analyserer dine konkurrenter, dit website og din synlighed i AI for at lave en skræddersyet indholdsplan gratis.
 AI-generator til indholdsbrief
 FAQ-schemagenerator
 AI-generator til blogidéer
 Validator for struktureret data (schema-validator)
 Tjek af alt-tekst
 Analyse af interne links
 Backlink-udfordringen
 AI-generator til metabeskrivelser
 AI-generator til blogtitler
 Tjek af indekserbarhed
 AI-generator til blogdispositioner
 UTM-linkgenerator
 Værktøj til søgeordsclustering
 Tjek af canonical-tag
 XML-sitemap-generator
 Tjek af ødelagte links
 AI-generator til SEO-titler
 Overskriftsanalysator
 SERP-forhåndsvisning
 Redirect-tjekker
 Hreflang-generator
 Overskriftsanalysator
 HTTP-headertjekker
 Favicon-udtrækker
 SERP CTR-beregner
 Beregner for besparelse ved SEO vs. betalt søgning
 Beregner af SEO-synlighedsandel
 Beregner af SEO-afkast
 Beregner af SEO-trafik- og omsætningsprognose
 Beregner af SEO-budget
 Beregner af SEO-break-even
 Beregner af SaaS-SEO-afkast
 Beregner af ROAS
 Beregner af læsetid
 Simulator for placeringsgevinst
 Beregner for værdi af organisk trafik
 Estimator for organisk trafik og tjek af webstedstrafik
 Beregner for LTV/CAC-forhold
 Beregner for lokal SEO-afkast
 Beregner for linkbuilding-omkostninger
 Beregner for søgeordsværdi
 Beregner for søgeordsmulighed
 Beregner for nøgleordstæthed
 Beregner for GEO-ROI
 Beregner for investering i GEO-indhold
 Ecommerce SEO-ROI-beregner
 Beregner for kundens levetidsværdi
 CAC-beregner
 Beregner for CTR
 Beregner for omkostning pr. artikel
 Beregner for konverteringsrate
 Beregner for ROI på content marketing
 Estimator for henvisningstrafik fra ChatGPT
 Beregner for bounce rate
 Beregner for backlinks ROI
 Beregner for AI-synlighedsscore
 AI-trafikværdi-beregner
 AI-share of voice-beregner
 Beregner for omkostningen ved AI-usynlighed
 AI-citationsrate-beregner
 llms.txt-validator
 AI Overview-tjekker og rangeringstjekker for AI Overviews
 Robots.txt-tjekker
 AI-SEO-audit
 LLM-læsbarhedstjek
 SearchGPT-klartjek
 LLM-audit af strukturerede data
 AI-crawlbarhedsaudit for websites
 Hvorfor anbefaler ChatGPT ikke mit website?
 Gemini-rangeringsværktøj
 Perplexity-placeringstjek
 LLM-citeringstjek
 AEO-audit
 GEO-audit
 Test af synlighed i AI-søgning
 Tjek af ChatGPT-synlighed
 llms.txt-generator
 URL-udtrækker
 Webside til Markdown
 Sitemap-tjek
 SERP-volatilitetsmåler
 Sidestørrelsestjek
 Ordtæller
 Slug-generator
 Schema-generator
 Robotgenerator
 OG-forhåndsvisning
 Metatag-generator
 Billedkompressor
 Favicon-generator
 On-page SEO-audit: SEO-tjek og SEO-analyse
 Backlinkanalyseværktøj
 Værktøj til søgeordsanalyse
 Domain Authority-tjek
 “Jeg testede Sorank på en rigtig kundes site, og det er vanvittigt. Det gør alt, et bureau ville opkræve dig 1500 dollar om måneden for. Det går nu i produktion på den kunde.”

 Guillaume Guersanguersanguillaume.com“Vi er et annoncebureau, og vi ville have vores SEO på rette spor en gang for alle. Sorank gav os et klart overblik over vores site, hjalp os med at prioritere optimeringer og strukturere vores indhold ordentligt. Værktøjet er nemt at bruge, velegnet til et team og meget praktisk til at samle opfølgningen et sted uden at jonglere med flere platforme. Et meget solidt fundament til at starte forfra med vores SEO.”
 Gaspard MadouiAnnoncebureau
 “Jeg lod bare Sorank-softwaren gøre sit arbejde, og nu er min DR 25, og min side rangerer højere.”
 Lucas Flandrefoundertrace.fr“Jeg specialiserede mig i GEO takket være Sorank. GEO-ranglisten gør det muligt at vise mine kunder deres placering i forhold til konkurrenterne på ChatGPT. Det er en reel kommerciel fordel.”
 MélanieSEO-freelancer“Fantastisk service, den virker godt til vores hjemmeside og hjælper os med at forstå, hvordan vi kan forbedre den for at rangere bedre på Google og andre steder. Tillykke, bliv ved, jeg anbefaler det.”
 Hugo T.Netbutiksejer