Datenschutz ist uns wichtig. Deshalb können Sie bestimmte Speicherarten deaktivieren, die für die grundlegende Funktion der Website nicht erforderlich sind. Das Blockieren einzelner Kategorien kann Ihr Erlebnis auf der Website beeinträchtigen. Weitere Informationen (Cookie-Richtlinie)
Vielen Dank! Ihre Auswahl wurde gespeichert.
Hoppla! Beim Absenden des Formulars ist ein Fehler aufgetreten.
ChatGPT-Werbung im Test: Was die Studien zeigen und wie du sie richtig liest
Was die Studien zur ChatGPT-Werbung messen, wo sie sich widersprechen und wie du ihre Zahlen liest, bevor du deine Anzeigen- oder Markenstrategie änderst.
Illustration einer Chat-Antwort mit einer kleinen, als gesponsert gekennzeichneten Karte darunter, neben einem Balkendiagramm mit Studienergebnissen.
Werkzeuge
Auf dieser Seite
Kurz gesagt
ChatGPT-Werbung sind gesponserte Anzeigen, die OpenAI angemeldeten Erwachsenen mit den Tarifen Free und Go zeigt. Drei zwischen August und November 2026 veröffentlichte Studien haben gemessen, wie oft diese Anzeigen erscheinen, ob sie zur Frage passen und wen sie erreichen. Keine von ihnen beweist, dass Anzeigen die Antwort selbst verändern, und die meisten Stichproben sind klein oder kurz.
3 Tage kostenlos, danach beenden Sie jederzeit. 90-Tage-Ergebnisgarantie, es gelten Bedingungen.
Was ChatGPT-Werbung ist und welche Fakten alle Studien voraussetzen
ChatGPT-Werbung sind klar als gesponsert gekennzeichnete Platzierungen neben der Antwort des Assistenten. Sie erreichen angemeldete Erwachsene in den Tarifen Free und Go, kein kostenpflichtiger Tarif sieht sie. Jede der folgenden Studien geht von diesen Regeln aus, du brauchst sie also, bevor du irgendeine Zahl liest.
OpenAI hat die Ankündigung des Tests am 9. Februar 2026 veröffentlicht. Die Seite sagt, der Test betreffe „angemeldete erwachsene Nutzer der Abo-Tarife Free und Go“, während Plus, Pro, Business, Enterprise und Education keine Werbung sehen. Anzeigen sind „immer klar als gesponsert gekennzeichnet und visuell von der organischen Antwort getrennt“. OpenAI erklärt außerdem, dass „Anzeigen die Antworten, die ChatGPT dir gibt, nicht beeinflussen“, und dass Werbetreibende aggregierte Leistungsdaten wie Aufrufe oder Klicks erhalten, nicht deine Chats oder persönlichen Daten. Die Ankündigung von OpenAI zum Test von Anzeigen in ChatGPT ist die Referenz, auf die sich alle Beiträge beziehen, lies sie also zuerst.
Drei zwischen August und November 2026 veröffentlichte Studien sind die detailliertesten öffentlichen Messungen von ChatGPT-Werbung, die wir bis zur Seite des Herausgebers zurückverfolgen konnten. Sie stellen unterschiedliche Fragen und liefern deshalb nicht dieselben Zahlen. Die Tabelle zeigt, was jede gemessen hat und was sie auslässt.
Studie
Veröffentlicht
Daten
Was gemessen wurde
Was ausgelassen wird
SE Ranking
10. August 2026
50006 kommerzielle Prompts aus 20 US-Nischen, Datenerhebung am 23. Juli 2026
Anzeigenquote pro Prompt, Relevanz der Anzeigen zum Prompt, Vergleich mit Google AI Mode
Plus und andere kostenpflichtige Tarife, die Wirkung von Anzeigen auf Antworten, jeder Trend (eine Momentaufnahme)
Seer Interactive
12. November 2026
161 aufgezeichnete KI-Suchsitzungen aus neun unmoderierten Usability-Studien, März bis September 2026
Ob echte Nutzer Anzeigen auf dem Bildschirm sahen und ob sie zum Prompt passten
Eine repräsentative Nutzerstichprobe (nur zwei der neun Studien fragten nach Anzeigen)
Brookings
Anfang Oktober 2026
91 angemeldete Sock-Puppet-Konten, mehr als 3600 gesammelte Anzeigen, Konten erstellt Januar bis März 2026
Wer Anzeigen erhält, getestet nach Einkommen sowie nach Hautfarbe oder ethnischer Zugehörigkeit
Gruppengröße (nur wenige Konten pro Kombination) und jeder Zeitraum nach dem Ende neuer Anzeigen für die Konten
Die Stichproben hinter den Studien
50006kommerzielle Prompts (SE Ranking)
161aufgezeichnete Sitzungen (Seer Interactive)
91Sock-Puppet-Konten (Brookings)
3600gesammelte Anzeigen (Brookings)
Quellen: SE Ranking, 10. August 2026; Seer Interactive, 12. November 2026; Brookings, Oktober 2026
Andere Beiträge zu diesem Thema stammen von GEO-Tools, und wir konnten ihre Zahlen nicht mit einer Primärquelle abgleichen, deshalb haben wir sie weggelassen. Zitiere nur Zahlen, die du auf der Seite des Herausgebers findest, und prüfe die Stichprobenzeile, bevor du sie weitergibst.
So werden ChatGPT-Anzeigen gemessen: die Antwort, die gesponserte Karte und die Studiendaten.
Wie oft erscheinen Anzeigen in ChatGPT-Antworten?
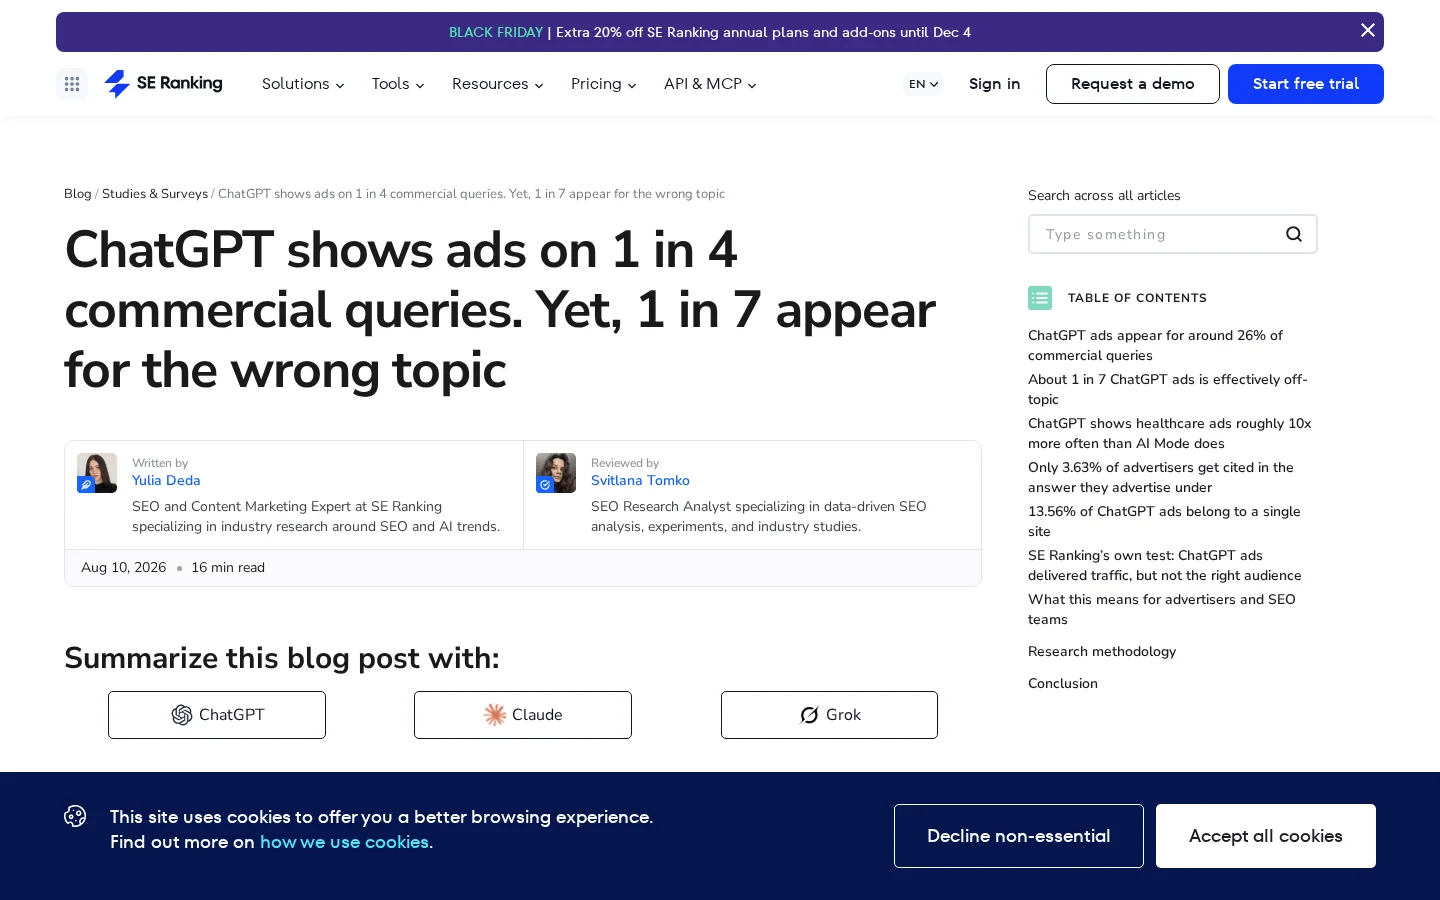
In der Stichprobe von SE Ranking lieferten 25,94 % der kommerziellen Prompts auf ChatGPT eine Anzeige, gegenüber 29,45 % bei Google AI Mode. Die Quote hängt stark vom Thema ab, eine einzige Gesamtquote sagt deshalb wenig darüber, welche Antworten deine eigenen Käufer sehen.
SE Ranking hat 50006 kommerzielle Prompts aus 20 US-Nischen verwendet, etwa 2500 pro Nische. Für jeden Prompt wurden die generierte Antwort, ihre zitierten Quellen und jede gesponserte Platzierung erfasst. Insgesamt lieferten 12974 Prompts eine Anzeige. Die Prompts stammten aus einer früheren Studie des gleichen Herausgebers zu AI Mode, dadurch sind die beiden Plattformen vergleichbar. Die Daten wurden am 23. Juli 2026 erhoben, die Studie am 10. August 2026 veröffentlicht (SE Ranking, ChatGPT-Anzeigenstudie, 10. August 2026).
Anteil der kommerziellen Prompts, die eine Anzeige lieferten
ChatGPT25,94 %
Google AI Mode29,45 %
Quelle: SE Ranking, 10. August 2026 (50006 kommerzielle Prompts)
Der Unterschied nach Thema ist viel größer als der zwischen den Plattformen. Im Gesundheitsbereich fand die Studie Anzeigen bei 28,69 % der ChatGPT-Prompts gegenüber 2,64 % bei AI Mode, mehr als zehnmal so viel. Bei Nachrichten und Politik lag der Wert bei 28,76 % auf ChatGPT gegenüber 6,8 % bei AI Mode. Die Gesamtquoten ähneln sich, der Themenmix ist der Punkt, an dem sich die Plattformen unterscheiden.
Beispiel
Stell dir vor, ein Käufer fragt ChatGPT, welche Buchhaltungssoftware zu einem Freelancer passt. Die organische Antwort nennt drei Tools, und daneben erscheint eine gesponserte Karte für ein viertes Produkt. Genau diese Situation misst die Quote: eine Anzeige in derselben Antwort wie die organische Empfehlung, nicht eine Anzeige, die sie ersetzt. Das ist eine Veranschaulichung, kein gemessener Fall.
Seer Interactive ist einen anderen Weg gegangen. Sein Artikel vom 12. November 2026 berichtet über 161 KI-Suchsitzungen, die aufgezeichnet wurden, während Teilnehmer ihre eigenen Assistenten nutzten und laut dachten. In der Versicherungsstudie trugen 34 von 76 beobachtbaren Antworten (45 %) eine Anzeige. Diese Zahl bezieht sich auf eine einzige Branche mit 16 Sitzungen, sie ist also keine Quote für ChatGPT im Allgemeinen.
Seer nennt auch einen Trend auf Nutzerebene: Der Anteil der ChatGPT-Nutzer in seinen Sitzungen, die eine Anzeige in der Antwort gesehen haben, stieg von 2 von 22 im März auf 12 von 19 von Juli bis September 2026. Das sind Personen, keine Antworten. Sie zeigen also, dass mehr Teilnehmer eine Anzeige gesehen haben, nicht wie viele Antworten eine enthielten. Der Trend ist das nützlichste Signal der drei Studien und zugleich das ungenaueste, weil sich die Gruppen von Monat zu Monat unterscheiden. Antworten und Anzeigen wechseln von einer Woche zur nächsten, deshalb ist ein einzelner Messwert eine Momentaufnahme, kein Urteil.
Passen die Anzeigen zur Frage?
Oft, aber nicht immer. SE Ranking schätzt, dass 14,35 % der Anzeigenimpressionen nicht stärker mit ihrem Prompt zusammenhingen als eine zufällig gepaarte Anzeige. Seer fand, dass jede Anzeige in seiner Versicherungsstudie zum Prompt passte. Die beiden Ergebnisse stammen aus unterschiedlichen Stichproben und Tests, sie beschreiben also verschiedene Dinge und widersprechen sich nicht.
Der Test von SE Ranking funktioniert so. Er berechnet die auf Embeddings basierende Kosinus-Ähnlichkeit zwischen Prompt, Anzeige und Antwort und vergleicht dann jedes echte Paar aus Prompt und Anzeige mit zufällig gemischten Paaren. Eine Anzeige gilt nur dann als themenfremd, wenn ihre Ähnlichkeit in den Bereich fällt, den zufällige Paare erzeugen. Eine Stichprobe der markierten Fälle wurde danach von Hand geprüft. Hier ist eine vereinfachte Lesart der Logik:
sim_real   = cos(embed(prompt), embed(anzeige))
sim_zufall = cos(embed(prompt), embed(anzeige_aus_anderem_prompt))   # gemischte Paare
themenfremd = sim_real liegt im Bereich, den sim_zufall erzeugt
Dieser Test ist konservativ. Eine Anzeige muss nicht stärker zusammenhängen als eine zufällige Anzeige, um markiert zu werden. Schwach relevante Anzeigen, die etwas passend wirken, gelten deshalb als themenpassend. Die Autoren sagen, dass 14,35 % wahrscheinlich zu niedrig ist, weil die manuelle Prüfung mehr schwach relevante Anzeigen fand, als der Test erkannte. Die Streuung nach Thema ist groß: 2,6 % bei Haustieren, 51,1 % bei Beziehungen und 54,2 % bei Nachrichten und Politik.
Zwei Maße für Relevanz und Reichweite aus zwei Studien
14,35 %der Anzeigenimpressionen, die nicht stärker zum Prompt passten als eine zufällige Anzeige (SE Ranking)
45 %der beobachtbaren Antworten in den Versicherungssitzungen enthielten eine Anzeige (Seer)
Quellen: SE Ranking, 10. August 2026; Seer Interactive, 12. November 2026
Quelle: SE Ranking, ChatGPT-Anzeigenstudie, 10. August 2026
Seer nennt einen Punkt, der für Marken wichtig ist. In fünf von sechs Branchen mit einer markenbezogenen Aufgabe war die gesponserte Karte für ein anderes Unternehmen als die Marke, die der Nutzer genannt hatte. Ein Prompt, der dein Unternehmen nennt, kann also in derselben Antwort die Anzeige deines Wettbewerbers zeigen. Der Artikel von Seer merkt außerdem an, dass sich die Werbetreibenden mit der Frage ändern, die Anzeigen, die du siehst, hängen also davon ab, wie der Prompt formuliert ist.
Wer bekommt die Anzeigen: Was das Audit von Brookings ergab
Das Audit von Brookings ergab, dass Konten mit niedrigerem Einkommen deutlich häufiger Anzeigen erhielten, und keine Hinweise darauf, dass Hautfarbe oder ethnische Zugehörigkeit änderten, ob ein Konto eine bekam. Die Autoren warnen, dass die Stichprobe klein ist, deshalb braucht das Ergebnis zur Hautfarbe, das ein Nullbefund ist, Vorsicht in beide Richtungen. Behandle das Einkommensergebnis als das stärkere.
Das Design lohnt einen Blick, weil es die einzige der drei Studien ist, die das Profil kontrolliert. Die Forschenden erstellten 91 angemeldete Konten in drei ethnischen Gruppen (Schwarze, Hispanics und Weiße) und drei Einkommensdritteln, mit mindestens neun Konten für jede Kombination aus Hautfarbe und Einkommen. Da Plattformen weder Einkommen noch Hautfarbe offenlegen, nutzten sie die geografische Region als Stellvertreter, indem sie jedes Konto aus Postleitzahlen mit diesen Merkmalen aufriefen. Jeden Tag wurden die Konten mit Prompts aus vielen Themenbereichen versorgt. Manche Kategorien waren solche, bei denen Anzeigen plausibel sind, etwa ein Lasagne-Rezept, andere solche, bei denen OpenAI gesagt hatte, keine Anzeigen auszuspielen, etwa psychische Gesundheit. Die Studie sammelte mehr als 3600 Anzeigen (Brookings, „Understanding the beginning of advertising on ChatGPT“, Anfang Oktober 2026).
So lief das Sock-Puppet-Audit ab
Konten erstellenAngemeldete Konten mit einem festen Profil in jeder Gruppe anlegen.
Standort festlegenPostleitzahlen mit bekanntem Einkommens- und Herkunftsprofil als Stellvertreter nutzen.
Dieselben Prompts täglich sendenThemen mischen, bei denen Anzeigen plausibel sind, mit Themen, bei denen OpenAI keine ausspielt.
Jede Anzeige speichernJede Anzeige mit dem Prompt und dem Konto notieren, das sie erhielt.
Gruppen vergleichenEinkommen und Herkunft getrennt testen und vor einer Schlussfolgerung die Stichprobengröße prüfen.
Das Einkommensergebnis stammt von 53 Konten, die mindestens eine Anzeige erhielten. Ihr Einkommen konzentrierte sich um einen Modus nahe 60000 Dollar, während die Konten ohne Anzeige ihren Höchstwert bei etwa 80000 Dollar hatten. Das Ergebnis ist im Sinne der Studie signifikant, beschreibt aber eine kleine Menge Konten aus einer einzigen frühen Phase.
Die Studie endete außerdem vorzeitig. Etwa einen Monat nach Beginn bekam kein Konto mehr Anzeigen ausgespielt. Die Autoren sagen, OpenAI habe die Konten womöglich erkannt. Das ist eine Warnung für alle, die die Methode übernehmen wollen: Eine Plattform, die Audit-Konten erkennt, kann verändern, was sie sehen, die erzeugten Daten sind also keine neutrale Stichprobe. Die Studie fand keinen Beleg dafür, dass Schutzmechanismen bei sensiblen Themen versagt hätten, und auch davor warnen die Autoren, dies überzubewerten.
Verändern Anzeigen die Antwort?
Bisher zeigt keine öffentliche Studie, dass sie das tun, und keine Studie kann bisher beweisen, dass sie es nicht tun. OpenAI sagt, Anzeigen beeinflussen Antworten nicht. Die drei Studien erfassen, wo Anzeigen erscheinen und wer sie sieht, nicht, ob eine Antwort ohne sie anders ausfiele.
Externe Forschende können Anzeigen für eine einzelne Antwort nicht abschalten, sie haben also keine saubere Kontrollgruppe. Das Nächstliegende ist, Antworten auf denselben Prompt über Tage oder Konten hinweg zu vergleichen. Dieser Vergleich ist verzerrt. Anzeigen erscheinen vor allem bei kommerziellen Prompts, und kommerzielle Prompts liefern ohnehin andere Antworten, mit mehr Produktlisten, Vergleichen und eigenen Quellen. Ein Unterschied bei den Zitaten zwischen Antworten mit und ohne Anzeige würde für sich allein keinen Einfluss zeigen.
Ein fairer Test würde Prompt, Tarif, Standort und Tag konstant halten, dann die Zitate jeder Antwort festhalten und den Test oft genug wiederholen, um über die Rotation der Anzeigen hinwegzusehen. Selbst dann misst du, was der Assistent getan hat, nicht warum. Bis OpenAI Daten veröffentlicht oder ein unabhängiges Audit die Aussage prüft, behandle „Anzeigen beeinflussen Antworten nicht“ als die Position des Unternehmens. Die öffentlichen Studien bestätigen sie nicht und widerlegen sie nicht.
Was die Studien sagen können und was nicht
Von den Studien gezeigt
Wie oft Anzeigen erscheinen, nach Prompt-Set
Wer Anzeigen sieht, nach Tarif und Profil
Ob eine Anzeige zum Prompt passt
Von den Studien nicht gezeigt
Ob Anzeigen die Antwort verändern
Auktionspreise oder Gebotshöhen
Trends über mehrere Monate
Drei Messmethoden und was jede übersieht
Die drei Studien nutzen drei Methoden: ein festes Prompt-Panel, aufgezeichnete Usability-Sitzungen und Sock-Puppet-Konten. Jede beantwortet eine Frage gut und übersieht die anderen, vergleiche sie also nach Methode und nicht nach Schlagzeile. Die Aussage von OpenAI selbst ist eine vierte Art von Beleg, eine Behauptung des Unternehmens und keine Messung.
Festes Prompt-Panel (SE Ranking)
Das Prinzip: Eine feste Liste von Prompts läuft über jede Plattform, und jede Antwort und jede Anzeige wird festgehalten. Wann du es nutzt: wenn du Quoten über viele Themen brauchst und Plattformen vergleichen willst. Vorteil: die Skalierung, und dieselben Prompts lassen sich erneut ausführen. Grenze: das Prompt-Set bestimmt das Ergebnis. SE Ranking selbst warnt, dass Rankings der Werbetreibenden von der Keyword-Auswahl abhängen, dass Anzeigen rotieren, sodass derselbe Prompt bei Wiederholung eine andere oder gar keine Anzeige bekommt, und dass sich der Pool der Werbetreibenden schnell ändert. Beispiel: Die Lücke im Gesundheitsbereich (28,69 % gegenüber 2,64 %) entsteht nur, weil dieselben Gesundheitsprompts auf beiden Plattformen liefen.
Aufgezeichnete Sitzungen (Seer Interactive)
Das Prinzip: Echte Teilnehmer nutzen ihre eigenen KI-Werkzeuge und denken dabei laut, der Bildschirm wird aufgezeichnet. Seer prüfte jede Aufnahme alle zwei Sekunden mit einer Texterkennung auf dem Gerät auf Anzeigenelemente und kontrollierte jedes danach mit eigenen Augen anhand dessen, was der Teilnehmer sagte. Wann du es nutzt: wenn du wissen willst, was ein Mensch tatsächlich auf dem Bildschirm sieht. Vorteil: Die Anzeige war wirklich auf dem Bildschirm, und die eigenen Worte des Teilnehmers sind dabei. Grenze: 161 Sitzungen sind keine repräsentative Stichprobe, und nur zwei der neun Studien fragten die Teilnehmer direkt nach Anzeigen. In einer Studie stimmte der automatische Scan bei jeder Sitzung und jeder Anzeigenanzahl mit der manuellen Prüfung überein, zählte aber manche Kreativ-Varianten zu niedrig. Seer weist außerdem darauf hin, dass Gemini, Claude und Grok nur in einigen Studien gescannt wurden, ein Fehlen dort bedeutet also „was wir beobachtet haben“, nicht „es gibt keine“.
Sock-Puppet-Audit (Brookings)
Das Prinzip: Kontrollierte Konten mit festen Profilen erhalten dieselben Prompts, Unterschiede lassen sich also auf das Profil zurückführen. Wann du es nutzt: wenn du wissen willst, wer gezielt angesprochen wird. Vorteil: Die Variablen sind kontrolliert, was die beiden anderen Methoden nicht können. Grenze: kleine Gruppen, Geografie als Ersatz für Einkommen und Herkunft und das Entdeckungsrisiko, das diese Studie vorzeitig beendete. Beispiel: Die 53 Konten, die eine Anzeige erhielten, konzentrierten sich auf niedrigere Einkommen, verglichen mit denen, die nie eine bekamen.
Methode
Studie
Gemessene Einheit
Beste Frage
Größter blinder Fleck
Festes Prompt-Panel
SE Ranking
Prompt und Antwort
Wie oft, und passt es?
Hängt vom Prompt-Set ab; eine Momentaufnahme
Aufgezeichnete Sitzungen
Seer Interactive
Sitzung und Nutzer
Was ein echter Nutzer sieht
Klein, nicht repräsentativ, wenige direkte Fragen zu Anzeigen
Sock-Puppet-Audit
Brookings
Konto
Wer Anzeigen erhält
Kleine Gruppen, Entdeckung, vorzeitiges Ende
Die Zahlen widersprechen sich aus Gründen, die du benennen kannst: unterschiedliche Prompts (nur kommerzielle oder eine breitere Mischung), unterschiedliche Einheiten (Antworten, Sitzungen, Nutzer), unterschiedliche Zeiträume (ein Tag im Juli, März bis September, Januar bis März) und unterschiedliche Tarife. Manche Sekundärzusammenfassungen schreiben Seer einen Anteil themenpassender Antworten von 38 % aus rund 55000 Antworten zu. Der Seer-Artikel, den wir gelesen haben, enthält keine solche Aufteilung und umfasst 161 Sitzungen, deshalb konnten wir die Zahl nicht bestätigen. Zitiere sie nicht, bevor du sie auf der Seite des Herausgebers findest.
Wann die Daten erhoben und wann sie veröffentlicht wurden
Januar bis März 2026Brookings erstellt seine Sock-Puppet-Konten.
9. Februar 2026OpenAI kündigt den Anzeigentest für angemeldete Erwachsene in den Tarifen Free und Go an.
März bis September 2026Seer zeichnet seine Usability-Sitzungen auf.
23. Juli 2026SE Ranking erhebt seine Daten zum Prompt-Panel.
10. August 2026SE Ranking veröffentlicht seine Studie zu ChatGPT-Anzeigen.
Anfang Oktober 2026Brookings veröffentlicht sein Sock-Puppet-Audit.
12. November 2026Seer Interactive veröffentlicht seine Sitzungsstudie.
So misst du die ChatGPT-Anzeigenquote in deinem eigenen Markt, Schritt für Schritt
Führe eine feste Liste von 30 bis 50 Käufer-Prompts von einem angemeldeten Free-Konto aus durch, am selben Tag und im selben Markt, und notiere jede Anzeige und jede Nennung deiner Domain als Quelle. Die Anzeigenquote ist die Zahl der Antworten mit Anzeige geteilt durch alle Antworten. Wiederhole den Lauf an mindestens drei Tagen, weil Anzeigen rotieren.
Bevor du den Test startest
Prompts aus echten Käuferfragen geschrieben, nicht aus deiner Keyword-Liste
Ein Konto, das dir gehört, im Tarif Free, angemeldet
Markt und Standort für den gesamten Lauf festgelegt
Ein Screenshot pro Antwort gespeichert, mit Datum und Uhrzeit
Spalten für Prompt, Datum, Anzeige ja oder nein, Werbetreibender, Anzeigentext und deine Domain zitiert ja oder nein
Eine zweite Person, die jede Anzeige als themenpassend oder nicht bewertet
Warnung
Erstelle keine Konten, um das Brookings-Audit nachzubauen. Die Autoren sagen, dass nach etwa einem Monat keines ihrer Konten mehr Anzeigen ausgespielt bekam. Nutze ein Konto, das dir gehört, führe die Prompts von Hand aus und lies die Nutzungsbedingungen von OpenAI, bevor du automatisiert Daten sammelst. Ein manueller Test ist langsamer, schützt aber das Konto und hält das Ergebnis ehrlich.
Erstelle die Prompt-Liste. Schreibe 30 bis 50 Prompts, gemischt aus kommerziellen Fragen („beste Buchhaltungssoftware für Freelancer“) und informativen („wie verfolge ich die Quartalssteuer“). Anzeigenquoten unterscheiden sich nach Absicht, eine Liste nur mit kommerziellen Prompts überschätzt die Quote für deinen Markt.
Lege den Kontext fest. Nutze ein Free-Konto, denselben Markt und denselben Tag. Öffne für jeden Prompt einen neuen Chat, damit frühere Nachrichten die Antwort nicht lenken.
Halte jede Antwort fest. Notiere, ob eine Anzeige erschien, den Namen des Werbetreibenden, den Anzeigentext und ob deine Domain oder ein Wettbewerber in der organischen Antwort zitiert wird.
Berechne die Quote. Trage die Ergebnisse in eine Tabelle ein. Mit den Prompts in Spalte A und dem Anzeigenkennzeichen (ja oder nein) in Spalte F, Zeilen 2 bis 51, liefert diese Formel den Anteil der Prompts mit Anzeige:
=ZÄHLENWENN(F2:F51;"ja")/ANZAHL2(A2:A51)
Prüfe die Relevanz. Lass zwei Personen jede Anzeige als themenpassend oder nicht markieren und vergleiche dann. Wo sie abweichen, notiere Prompt und Anzeige und lege die Regel fest, bevor du zählst.
Wiederhole. Führe dieselben Prompts an drei verschiedenen Tagen aus und vergleiche die Quoten. Ein Tag zeigt eine Antwort, drei Tage beginnen, ein Muster zu zeigen.
Tipp
Bevor du etwas ausgibst, prüfe, ob ChatGPT deine Marke in organischen Antworten schon nennt. Unser kostenloser ChatGPT-Sichtbarkeits-Checker fragt ChatGPT mit eingeschalteter Websuche ab und zeigt, ob deine Domain als Quelle zitiert wird und ob deine Marke in der Antwort genannt wird.
Was die Studien für deine Marke und dein Budget bedeuten
Eine Anzeige kauft einen gekennzeichneten Platz neben der Antwort, nicht einen Platz darin. OpenAI sagt, Anzeigen beeinflussen Antworten nicht, die Nennung in der organischen Antwort lässt sich also nicht mit einer Kampagne kaufen. Die Studien zeigen außerdem, dass die gesponserte Karte oft von einem anderen Unternehmen stammt als dem, nach dem ein Nutzer gefragt hat. Plane für beide Kanäle und miss sie getrennt.
Bezahlte Anzeige oder organische Nennung
Bezahlte Anzeige
Als gesponsert gekennzeichnet und pro Klick oder Impression gekauft
Nur Nutzern der Tarife Free und Go gezeigt
Endet, wenn das Budget endet
Organische Nennung
Erreicht Nutzer in allen Tarifen
Hält so lange wie deine Inhalte und Erwähnungen
Hängt davon ab, was das Modell abruft, und lässt sich nicht bezahlen
Markenbezogene Prompts brauchen besondere Aufmerksamkeit. Wenn dein Unternehmen Gegenstand einer Frage ist, rechne damit, dass der Anzeigenplatz an jemand anderen geht. Verfolge markenbezogene Prompts für Anzeigen so, wie du die Markensuche bei Google verfolgst, und prüfe während einer Kampagne mindestens einmal pro Woche, welche Anzeige für deinen eigenen Namen erscheint.
Teste mit kleinen Budgets und vergleiche die Kosten pro Akquise mit deinen Such- und Social-Kampagnen, bevor du Geld verschiebst. Unser Überblick zu KI-Anzeigen vergleicht Anzeigen in KI-Antworten mit anderen bezahlten Formaten, und Anzeigentexte schreiben erklärt, wie du kurze Anzeigen formulierst, die zum Gespräch passen.
Für den organischen Teil verfolge eine feste Liste von Prompts über die Zeit, statt von Hand nachzusehen. Das AI Mention Tracking von Sorank führt deine Prompts jeden Monat auf ChatGPT, Claude und Gemini aus und zeigt, welche Antworten deine Marke erwähnen und welche Quellen sie zitieren. Wenn du lieber zuerst von Hand prüfst, erklärt unser Leitfaden zu einem KI-Sichtbarkeitsaudit die Schritte, und der Glossareintrag zu KI-Zitaten definiert, was als Zitat zählt.
Typische Fehler beim Lesen von Studien zu ChatGPT-Anzeigen
Die häufigsten Fehler sind, eine Stichprobe für den ganzen Markt zu halten, Antworten mit Nutzern zu verwechseln und eine Zahl ohne Einheit oder Quelle zu zitieren. Jeder Fehler lässt sich leicht erkennen, sobald du weißt, welche Frage du stellen musst.
Eine Studie falsch und richtig lesen
Falsch
„ChatGPT zeigt auf einem Viertel der Antworten Anzeigen“
„Fast die Hälfte der Nutzer sieht Anzeigen“
„Anzeigen bringen ChatGPT dazu, Marken zu empfehlen“
Richtig
„25,94 % von 50006 kommerziellen Prompts in der US-Stichprobe von SE Ranking“
„45 % der Antworten in einer Versicherungsstudie, 34 von 76“
„Anzeigen und Zitate traten zusammen auf, die Studie prüft keine Ursache“
Fehler 1: eine Stichprobe als Markt behandeln
Was es ist: eine Schlagzeile, die sagt „ChatGPT zeigt Anzeigen bei X % der Antworten“, obwohl die Stichprobe eine Liste kommerzieller Prompts oder 16 Versicherungssitzungen ist. Wie du es erkennst: Lies die Stichprobenzeile vor dem Ergebnis und prüfe, ob Prompts, Nischen, Sitzungen oder Konten beschrieben sind. Wie du es behebst: Formuliere die Aussage mit ihrer Stichprobe neu, zum Beispiel „in der Stichprobe von SE Ranking mit 50006 kommerziellen Prompts aus 20 US-Nischen“.
Fehler 2: die Einheiten verwechseln
Was es ist: einen Anteil an Antworten neben einen Anteil an Nutzern stellen, als würden sie dasselbe messen. Die 45 % von Seer sind ein Anteil an Antworten in einer einzelnen Branche, und der Trend von 2 von 22 auf 12 von 19 ist ein Anteil an Nutzern. Wie du es erkennst: Achte auf die Wörter „der Antworten“, „der Sitzungen“, „der Nutzer“ oder „der Konten“ neben jeder Zahl. Wie du es behebst: Schreibe die Einheit neben jede Zahl, die du zitierst.
Fehler 3: eine Momentaufnahme als Trend lesen
Was es ist: die Quote eines einzelnen Tages als Trend bezeichnen oder zwei Studien aus verschiedenen Monaten vergleichen, als wären sie eine Reihe. SE Ranking selbst warnt, dass Anzeigen rotieren und sich der Pool der Werbetreibenden schnell ändert. Wie du es erkennst: Prüfe die Erhebungsdaten. Eine Quote von einem Tag oder aus wenigen Wochen ist ein Messwert. Wie du es behebst: Wiederhole dieselben Prompts an mehreren Terminen und vergleiche Quoten nur für dieselben Prompts.
Fehler 4: aus dem gemeinsamen Auftreten auf Einfluss schließen
Was es ist: der Schluss, Anzeigen lenken Antworten zu oder weg von bestimmten Marken, weil beides zusammen auftritt. Anzeigen erscheinen vor allem bei kommerziellen Prompts, und diese Antworten sehen ohnehin anders aus. Wie du es erkennst: jeder Satz, der sagt, Anzeigen „erhöhen“, „senken“ oder „formen“ Empfehlungen, ohne Kontrollgruppe. Wie du es behebst: Schreibe „tritt zusammen mit auf“ und benenne die Störfaktoren: Prompt-Typ, Thema und Tarif.
Fehler 5: eine Zahl zitieren, die du nicht zurückverfolgt hast
Was es ist: eine Zahl wiederholen, die in mehreren Beiträgen steht, von denen keiner auf die Primärseite verlinkt, oder deren Stichprobe nicht zu der des Herausgebers passt. Wie du es erkennst: Suche die Zahl auf der Seite des Herausgebers. Wenn sie dort nicht steht, gehört sie nicht zu dieser Studie. Wie du es behebst: Öffne die Primärseite, finde den Satz und zitiere seinen Wortlaut. Die oben erwähnten 38 % themenpassender Antworten sind ein Beispiel: Wir haben sie auf der Seite von Seer nicht gefunden und deshalb nicht verwendet.
Was du diese Woche tun solltest
Mache einen kleinen Test, bevor du eine Budgetentscheidung triffst. Miss die Anzeigenquote für deine eigenen Prompts, halte deine eigenen Zitate fest, und entscheide erst dann, ob ein bezahlter Test für deine Kategorie sinnvoll ist.
Ein Wochenplan
Schreibe 30 Käufer-PromptsNutze die Fragen, die deine Kunden vor dem Kauf stellen, aus echten Gesprächen und Verkaufsanrufen.
Führe sie einmal auf einem Free-Konto ausGleicher Markt, gleicher Tag, ein neuer Chat pro Prompt, mit Screenshots.
Protokolliere Anzeigen und ZitateNotiere jede Anzeige, ihren Werbetreibenden und ob deine Domain in der organischen Antwort zitiert wird.
Wiederhole an zwei weiteren TagenVergleiche die Quote über die drei Läufe, bevor du eine Schlussfolgerung ziehst.
EntscheideWenn Käufer in deiner Kategorie Anzeigen sehen, starte einen kleinen bezahlten Test mit Conversion-Tracking. Wenn nicht, investiere in organische Zitate.
Die Forschung wird sich weiter verändern, während der Rollout breiter wird. Die Methode, mit der du sie liest, hält länger als jede einzelne Zahl, also halte Stichprobe, Einheit und Datum neben jeder Zahl fest, die du zitierst.
Häufig gestellte Fragen
Zeigt ChatGPT Werbung an?
Ja. Seit dem 9. Februar 2026 testet OpenAI gesponserte Platzierungen in ChatGPT für angemeldete Erwachsene in den Tarifen Free und Go. Plus, Pro, Business, Enterprise und Education haben keine Werbung, und OpenAI sagt, dass Anzeigen Antworten nicht beeinflussen.
Wie oft erscheinen ChatGPT-Anzeigen in Antworten?
In der Stichprobe von SE Ranking vom August 2026 lieferten 25,94 % der kommerziellen Prompts auf ChatGPT eine Anzeige, gegenüber 29,45 % bei Google AI Mode. Die Quote schwankt stark nach Thema, im Gesundheitsbereich ist die Lücke am größten, die Zahl gilt also nur für diese Stichprobe.
Verändern ChatGPT-Anzeigen die Antwort?
Keine öffentliche Studie hat gezeigt, dass sie das tun, und keine kann beweisen, dass sie es nicht tun. OpenAI sagt, Anzeigen beeinflussen Antworten nicht, externe Studien erfassen aber nur, wo Anzeigen erscheinen und wer sie sieht.
y!
Erhalten Sie kostenlos Ihren Content-Plan für 30 Tage
Wir analysieren Ihre Wettbewerber, Ihre Website und Ihre KI-Sichtbarkeit, um kostenlos einen maßgeschneiderten Content-Plan für Sie zu erstellen.
“Ich habe Sorank auf einer echten Kundenwebsite getestet, und es ist der Wahnsinn. Es macht alles, wofür eine Agentur 1.500 € im Monat berechnet. Jetzt geht es bei diesem Kunden in den Produktivbetrieb.”Guillaume Guersanguersanguillaume.com
“Wir sind eine Ads-Agentur und wollten unser SEO endgültig wieder auf Kurs bringen. Sorank hat uns eine klare Übersicht über unsere Website verschafft, uns geholfen, Optimierungen zu priorisieren und unsere Inhalte richtig zu strukturieren. Das Tool ist einfach zu bedienen, gut für ein Team konzipiert und sehr praktisch, um das Tracking zu zentralisieren, ohne zwischen mehreren Plattformen jonglieren zu müssen. Eine sehr solide Grundlage, um mit unserem SEO neu zu starten.”Gaspard MadouiWerbeagentur
“Ich habe mich dank Sorank auf GEO spezialisiert. Das GEO Leaderboard ermöglicht es mir, meinen Kunden ihre Position im Vergleich zu ihren Wettbewerbern auf ChatGPT zu zeigen. Das ist ein echter kommerzieller Differenzierungsfaktor.”MélanieFreelancer im Bereich SEO
“Hervorragender Service, funktioniert gut für unsere Website und hilft uns zu verstehen, wie wir sie verbessern können, um auf Google und anderswo besser zu ranken. Herzlichen Glückwunsch, machen Sie weiter, ich empfehle es.”Hugo T.E-Commerce-Händler