La privacidad es importante para nosotros, por lo que tiene la opción de desactivar ciertos tipos de almacenamiento que pueden no ser necesarios para el funcionamiento básico del sitio web. Bloquear categorías puede afectar a su experiencia en el sitio web. Más información (Política de cookies)
Ilustración de una respuesta de chat con una pequeña tarjeta patrocinada identificada debajo, junto a un gráfico de barras con resultados de estudios.
Herramientas
En esta página
En resumen
Los anuncios de ChatGPT son espacios patrocinados que OpenAI muestra a adultos con sesión iniciada en los planes Free y Go. Tres estudios publicados entre agosto y noviembre de 2026 han medido con qué frecuencia aparecen esos anuncios, si coinciden con la pregunta y a quién llegan. Ninguno demuestra que los anuncios cambien la respuesta en sí, y la mayoría de las muestras son pequeñas o de corta duración.
3 días gratis y luego lo dejas cuando quieras. Garantía de resultados de 90 días, sujeta a condiciones.
Qué son los anuncios de ChatGPT y los datos en los que se basa todo estudio
Los anuncios de ChatGPT son espacios patrocinados claramente identificados que aparecen junto a la respuesta del asistente. Llegan a adultos con sesión iniciada en los planes Free y Go, y ningún plan de pago los ve. Cada estudio que sigue parte de estas reglas, así que necesitas conocerlas antes de leer cualquier cifra.
OpenAI publicó el anuncio de la prueba el 9 de febrero de 2026. Su página dice que la prueba incluye a “usuarios adultos con sesión iniciada en los planes Free y Go”, mientras que Plus, Pro, Business, Enterprise y Education no ven anuncios. Los anuncios están “siempre claramente identificados como patrocinados y separados visualmente de la respuesta orgánica”. OpenAI afirma también que “los anuncios no influyen en las respuestas que ChatGPT te da”, y que los anunciantes reciben datos de rendimiento agregados, como visualizaciones o clics, y no tus conversaciones ni tus datos personales. El anuncio de OpenAI sobre la prueba de anuncios en ChatGPT es la referencia que citan todos los artículos sobre el tema, así que léelo primero.
Tres estudios publicados entre agosto y noviembre de 2026 son las mediciones públicas más detalladas de los anuncios de ChatGPT que pudimos rastrear hasta la página del propio editor. Plantean preguntas distintas, así que no dan las mismas cifras. La tabla muestra qué midió cada uno y qué deja fuera.
Estudio
Publicado
Datos
Qué midió
Qué deja fuera
SE Ranking
10 de agosto de 2026
50006 consultas comerciales en 20 nichos de EE. UU., datos recogidos el 23 de julio de 2026
Tasa de anuncios por consulta, relevancia de los anuncios para la consulta, comparación con Google AI Mode
Plus y otros planes de pago, el efecto de los anuncios en las respuestas, cualquier tendencia (una sola foto)
Seer Interactive
12 de noviembre de 2026
161 sesiones grabadas de búsqueda con IA, de nueve estudios de usabilidad sin moderar, de marzo a septiembre de 2026
Si usuarios reales vieron anuncios en pantalla y si coincidían con la consulta
Una muestra representativa de usuarios (solo dos de los nueve estudios preguntaron por los anuncios)
Brookings
principios de octubre de 2026
91 cuentas ficticias con sesión iniciada, más de 3600 anuncios recogidos, cuentas creadas de enero a marzo de 2026
Quién recibe anuncios, probado por ingresos y por raza u origen étnico
El tamaño de los grupos (solo unas pocas cuentas por combinación) y cualquier periodo posterior a que las cuentas dejaran de recibir anuncios
Las muestras detrás de los estudios
50006consultas comerciales (SE Ranking)
161sesiones grabadas (Seer Interactive)
91cuentas ficticias (Brookings)
3600anuncios recogidos (Brookings)
Fuentes: SE Ranking, 10 de agosto de 2026; Seer Interactive, 12 de noviembre de 2026; Brookings, octubre de 2026
Otros artículos sobre este tema proceden de herramientas GEO, y no pudimos contrastar sus cifras con una fuente primaria, así que los dejamos fuera. Cita solo las cifras que puedas rastrear hasta la página del editor, y revisa la línea de muestra antes de repetir cualquiera de ellas.
Cómo se miden los anuncios de ChatGPT: la respuesta, la tarjeta patrocinada y los datos del estudio.
¿Con qué frecuencia aparecen anuncios en las respuestas de ChatGPT?
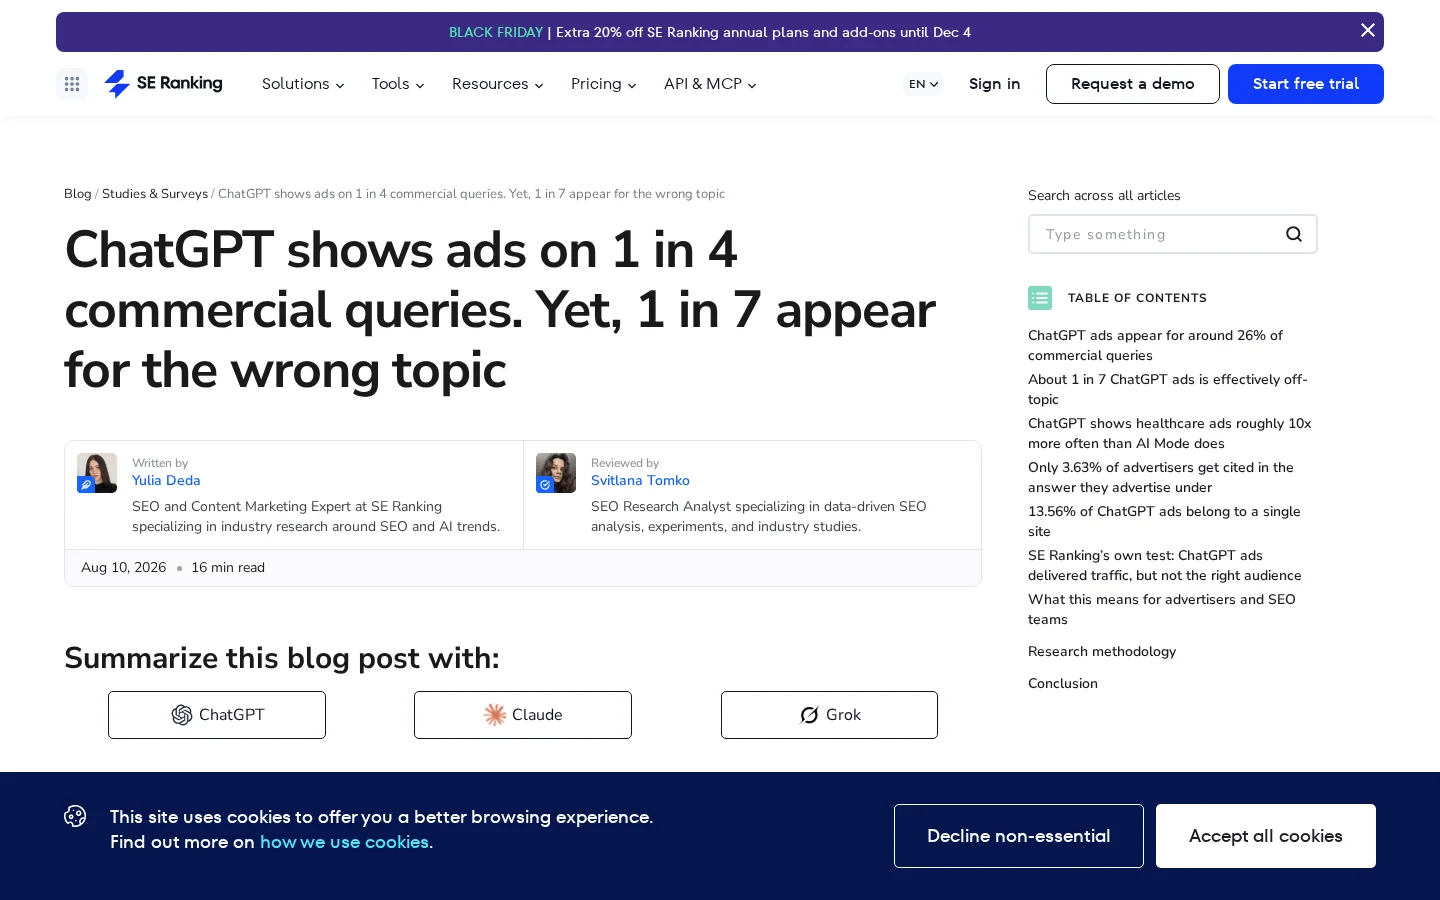
En la muestra de SE Ranking, el 25,94 % de las consultas comerciales devolvió un anuncio en ChatGPT, frente al 29,45 % en Google AI Mode. La tasa depende mucho del tema, así que una única tasa global dice poco sobre las respuestas que ven tus propios compradores.
SE Ranking usó 50006 consultas comerciales de 20 nichos de EE. UU., unas 2500 por nicho. Para cada consulta registró la respuesta generada, sus fuentes citadas y cualquier espacio patrocinado. En total, 12974 consultas devolvieron un anuncio. Las consultas procedían de un estudio anterior del mismo editor sobre AI Mode, lo que hace comparables las dos plataformas. Los datos se recogieron el 23 de julio de 2026, y el estudio se publicó el 10 de agosto de 2026 (SE Ranking, estudio sobre los anuncios de ChatGPT, 10 de agosto de 2026).
Porcentaje de consultas comerciales que devolvieron un anuncio
ChatGPT25,94 %
Google AI Mode29,45 %
Fuente: SE Ranking, 10 de agosto de 2026 (50006 consultas comerciales)
La diferencia por tema es mucho mayor que la diferencia entre plataformas. En salud, el estudio encontró anuncios en el 28,69 % de las consultas de ChatGPT frente al 2,64 % en AI Mode, más de diez veces más. En noticias y política, la cifra fue del 28,76 % en ChatGPT frente al 6,8 % en AI Mode. Las tasas globales se parecen, y la mezcla de temas es donde difieren las plataformas.
Ejemplo
Imagina que un comprador le pregunta a ChatGPT qué software de contabilidad le conviene a un autónomo. La respuesta orgánica enumera tres herramientas, y junto a ella aparece una tarjeta patrocinada de un cuarto producto. Esa es la situación que mide la tasa: un anuncio en la misma respuesta que la recomendación orgánica, no un anuncio que la sustituye. Es una ilustración, no un caso medido.
Seer Interactive siguió otro camino. Su artículo del 12 de noviembre de 2026 recoge 161 sesiones de búsqueda con IA grabadas mientras los participantes usaban sus propios asistentes y pensaban en voz alta. En el estudio de seguros, 34 de 76 respuestas observables (45 %) llevaban un anuncio. Esa cifra corresponde a un solo sector con 16 sesiones, así que no es una tasa de ChatGPT en general.
Seer también informa de una tendencia a nivel de usuario: la proporción de usuarios de ChatGPT en sus sesiones que vieron un anuncio dentro de la respuesta pasó de 2 de 22 en marzo a 12 de 19 entre julio y septiembre de 2026. Son personas, no respuestas, así que muestran que más participantes vieron un anuncio, no cuántas respuestas llevaban uno. La tendencia es la señal más útil de los tres estudios, y la menos precisa, porque los grupos cambian de un mes a otro. Las respuestas y los anuncios cambian de una semana a otra, por eso una sola lectura es una foto puntual, no un veredicto.
¿Los anuncios coinciden con la pregunta?
A menudo, pero no siempre. SE Ranking calcula que el 14,35 % de las impresiones publicitarias no estaban más relacionadas con su consulta que un anuncio emparejado al azar. Seer comprobó que todos los anuncios de su estudio de seguros eran relevantes para la consulta. Los dos resultados proceden de muestras y pruebas distintas, así que describen cosas diferentes en lugar de contradecirse.
La prueba de SE Ranking funciona así. Calcula la similitud coseno basada en embeddings entre la consulta, el anuncio y la respuesta, y después compara cada par real de consulta y anuncio con pares mezclados al azar. Un anuncio solo se considera fuera de tema si su similitud cae dentro del rango que producen los pares aleatorios. Después se revisó a mano una muestra de los casos marcados. Esta es una lectura simplificada de la lógica:
sim_real    = cos(embed(consulta), embed(anuncio))
sim_azar    = cos(embed(consulta), embed(anuncio_de_otra_consulta))   # pares mezclados
fuera_tema  = sim_real cae dentro del rango que produce sim_azar
Es una prueba conservadora. Un anuncio tiene que parecer no más relacionado que un anuncio aleatorio para que se marque, así que los anuncios poco relevantes que parecen algo relacionados pasan como si estuvieran en tema. Los autores dicen que el 14,35 % probablemente se queda corto, porque la revisión manual encontró más anuncios poco relevantes de los que detectó la prueba. La dispersión por tema es amplia: 2,6 % en mascotas, 51,1 % en relaciones y 54,2 % en noticias y política.
Dos medidas de relevancia y exposición, de dos estudios
14,35 %de las impresiones publicitarias no más relacionadas con la consulta que un anuncio al azar (SE Ranking)
45 %de las respuestas observables en las sesiones de seguros llevaban un anuncio (Seer)
Fuentes: SE Ranking, 10 de agosto de 2026; Seer Interactive, 12 de noviembre de 2026
Fuente: SE Ranking, estudio sobre anuncios de ChatGPT, 10 de agosto de 2026
Seer añade un punto que importa a las marcas. En cinco de las seis verticales con una tarea de marca, la tarjeta patrocinada era de una empresa distinta a la marca que el usuario había nombrado. Así que una consulta que menciona tu empresa puede mostrar el anuncio de tu competidor en la misma respuesta. El artículo de Seer también señala que los anunciantes cambian según la pregunta, lo que significa que los anunciantes que ves dependen de cómo esté formulada la consulta.
Quién recibe los anuncios: lo que encontró la auditoría de Brookings
La auditoría de Brookings encontró que las cuentas de menores ingresos tenían una probabilidad significativamente mayor de recibir anuncios, y no halló pruebas de que la raza o el origen étnico cambiaran que una cuenta recibiera uno. Los autores advierten de que la muestra es pequeña, así que el resultado sobre raza, que es un hallazgo nulo, requiere cautela en ambos sentidos. Trata el resultado sobre ingresos como el más sólido.
El diseño merece conocerse, porque es el único de los tres que controla el perfil. Los investigadores crearon 91 cuentas con sesión iniciada repartidas entre tres grupos raciales y étnicos (negros, hispanos y blancos) y tres tercios de ingresos, con al menos nueve cuentas en cada combinación de raza e ingresos. Como las plataformas no revelan ni los ingresos ni la raza, usaron la región geográfica como aproximación, accediendo a cada cuenta desde códigos postales con esas características. Cada día, las cuentas recibieron consultas de muchas categorías de temas. Algunas eran categorías donde los anuncios son plausibles, como una receta de lasaña, y otras eran categorías donde OpenAI dijo que no mostraría anuncios, como la salud mental. El estudio recogió más de 3600 anuncios (Brookings, “Understanding the beginning of advertising on ChatGPT”, principios de octubre de 2026).
Cómo se realizó la auditoría con cuentas ficticias
Crear las cuentasCrear cuentas con sesión iniciada y un perfil fijo en cada grupo.
Fijar la ubicaciónUsar códigos postales con perfiles conocidos de ingresos y raza como aproximación.
Enviar las mismas consultas a diarioMezclar temas donde los anuncios son plausibles con temas donde OpenAI dice que no muestra ninguno.
Guardar cada anuncioRegistrar cada anuncio con la consulta y la cuenta que lo recibió.
Comparar los gruposProbar por separado ingresos y raza, y comprobar el tamaño de la muestra antes de concluir.
El resultado sobre ingresos procede de 53 cuentas que recibieron al menos un anuncio. Sus ingresos se concentraban alrededor de una moda cercana a 60000 dólares, mientras que las cuentas que nunca recibieron uno tenían su pico cerca de 80000 dólares. El resultado es significativo en los términos del estudio, pero describe un conjunto pequeño de cuentas de un único periodo temprano.
El estudio también terminó antes de tiempo. Un mes después, ninguna cuenta recibía ya más anuncios. Los autores dicen que OpenAI podría haberlas detectado. Es una advertencia para quien copie el método: una plataforma que detecta cuentas de auditoría puede cambiar lo que ven, así que los datos que producen no son una muestra neutra. El estudio no encontró pruebas de que fallaran las salvaguardas en temas sensibles, y los autores advierten también contra leer demasiado en ello.
¿Los anuncios cambian la respuesta?
Ningún estudio público hasta ahora muestra que lo hagan, y ningún estudio hasta ahora puede demostrar que no lo hagan. OpenAI afirma que los anuncios no influyen en las respuestas. Los tres estudios registran dónde aparecen los anuncios y quién los ve, no si una respuesta sería diferente sin ellos.
Los investigadores externos no pueden desactivar los anuncios para una única respuesta, así que no pueden hacer un control limpio. Lo más cercano es comparar las respuestas a una misma consulta en distintos días o cuentas. Esa comparación está contaminada. Los anuncios aparecen sobre todo en consultas comerciales, y las consultas comerciales ya producen respuestas distintas, con más listas de productos, comparativas y fuentes propias. Una diferencia en las citas entre respuestas con anuncio y sin anuncio no mostraría por sí sola una influencia.
Una prueba justa mantendría constantes la consulta, el plan, la ubicación y el día, luego registraría las citas de cada respuesta, y repetiría la prueba las veces suficientes para superar la rotación de anuncios. Aun así, mediríamos lo que hizo el asistente, no por qué. Hasta que OpenAI publique datos o una auditoría independiente pruebe la afirmación, trata “los anuncios no influyen en las respuestas” como la postura de la empresa. Los estudios públicos ni la confirman ni la refutan.
Lo que los estudios pueden y no pueden decirte
Lo que muestran los estudios
Con qué frecuencia aparecen los anuncios, por conjunto de consultas
Quién ve los anuncios, por plan y por perfil
Si un anuncio coincide con la consulta
Lo que no muestran los estudios
Si los anuncios cambian la respuesta
Precios de subasta o niveles de puja
Tendencias a lo largo de varios meses
Tres métodos de medición y lo que pasa por alto cada uno
Los tres estudios usan tres métodos: un panel fijo de consultas, sesiones de usabilidad grabadas y cuentas ficticias. Cada uno responde bien a una pregunta y pasa por alto las demás, así que compáralos por método y no por titular. La declaración de OpenAI es un cuarto tipo de evidencia, una afirmación de la empresa y no una medición.
Panel fijo de consultas (SE Ranking)
El principio: pasar una lista fija de consultas por cada plataforma y registrar cada respuesta y cada anuncio. Cuándo usarlo: cuando necesitas tasas de muchos temas y quieres comparar plataformas. Ventaja: la escala, y las mismas consultas pueden repetirse. Límite: el conjunto de consultas determina el resultado. El propio SE Ranking advierte de que los rankings de anunciantes son sensibles a la elección de palabras clave, de que los anuncios rotan, de modo que la misma consulta puede recibir otro anuncio o ninguno al repetirla, y de que el grupo de anunciantes cambia deprisa. Ejemplo: la diferencia en salud (28,69 % frente a 2,64 %) aparece solo porque se lanzaron las mismas consultas de salud en ambas plataformas.
Sesiones grabadas (Seer Interactive)
El principio: participantes reales usan sus propias herramientas de IA pensando en voz alta, y se graba la pantalla. Seer muestreó cada grabación cada dos segundos con reconocimiento de texto en el propio dispositivo para encontrar unidades publicitarias, y después revisó cada una a ojo frente a lo que decía el participante. Cuándo usarlo: cuando quieres saber qué ve de verdad una persona en pantalla. Ventaja: el anuncio estaba realmente en pantalla, y están las propias palabras del participante. Límite: 161 sesiones no son una muestra representativa, y solo dos de los nueve estudios preguntaron a los participantes directamente por los anuncios. En un estudio, el escaneo automático coincidió con la revisión manual en cada sesión y en cada recuento de anuncios, pero no contó algunas variantes de creatividades. Seer también señala que Gemini, Claude y Grok solo se escanearon en algunos estudios, así que la ausencia allí significa “lo que observamos”, no “no existe”.
Auditoría con cuentas ficticias (Brookings)
El principio: cuentas controladas, con perfiles definidos, reciben las mismas consultas, así que las diferencias pueden atribuirse al perfil. Cuándo usarlo: cuando quieres saber quién es el objetivo. Ventaja: las variables están controladas, algo que los otros dos métodos no pueden hacer. Límite: grupos pequeños, la geografía como sustituto de los ingresos y la raza, y el riesgo de detección, que acabó antes de tiempo con este estudio. Ejemplo: las 53 cuentas que recibieron un anuncio, agrupadas en ingresos más bajos, frente a las que nunca recibieron uno.
Método
Estudio
Unidad medida
Mejor pregunta
Principal punto ciego
Panel fijo de consultas
SE Ranking
Consulta y respuesta
¿Con qué frecuencia, y coincide?
Depende del conjunto de consultas; una foto puntual
Sesiones grabadas
Seer Interactive
Sesión y usuario
Lo que ve un usuario real
Pequeña, no representativa, pocas preguntas directas sobre anuncios
Auditoría con cuentas ficticias
Brookings
Cuenta
Quién recibe anuncios
Grupos pequeños, detección, final anticipado
Las cifras no coinciden por razones que puedes nombrar: consultas distintas (solo comerciales o una mezcla más amplia), unidades distintas (respuestas, sesiones, usuarios), periodos distintos (un día de julio, de marzo a septiembre, de enero a marzo) y planes distintos. Algunos resúmenes secundarios atribuyen a Seer una proporción de respuestas en tema del 38 % sobre unas 55000 respuestas. El artículo de Seer que leímos no informa de ninguna división así y abarca 161 sesiones, por lo que no pudimos confirmar la cifra. No la cites hasta que la encuentres en la página del editor.
Cuándo se recogieron los datos y cuándo se publicaron
De enero a marzo de 2026Brookings crea sus cuentas ficticias.
9 de febrero de 2026OpenAI anuncia la prueba de anuncios para adultos con sesión iniciada en los planes Free y Go.
De marzo a septiembre de 2026Seer graba sus sesiones de usabilidad.
23 de julio de 2026SE Ranking recoge sus datos del panel de consultas.
10 de agosto de 2026SE Ranking publica su estudio sobre los anuncios de ChatGPT.
Principios de octubre de 2026Brookings publica su auditoría con cuentas ficticias.
12 de noviembre de 2026Seer Interactive publica su estudio de sesiones.
Cómo medir la tasa de anuncios de ChatGPT en tu propio mercado, paso a paso
Lanza una lista fija de 30 a 50 consultas de compradores desde una cuenta Free con sesión iniciada, el mismo día y en el mismo mercado, y anota cada anuncio y cada cita de tu dominio. La tasa de anuncios es el número de respuestas que llevaron un anuncio dividido entre todas las respuestas. Repite la prueba en al menos tres días, porque los anuncios rotan.
Antes de hacer la prueba
Consultas escritas a partir de preguntas reales de compradores, no de tu lista de palabras clave
Una cuenta tuya, en el plan Free, con sesión iniciada
Mercado y ubicación fijos durante toda la prueba
Una captura de pantalla guardada de cada respuesta, con fecha y hora
Columnas para la consulta, la fecha, anuncio sí o no, el anunciante, el texto del anuncio y tu dominio citado sí o no
Una segunda persona que valore si cada anuncio está en tema o no
Advertencia
No crees un conjunto de cuentas para copiar la auditoría de Brookings. Los autores dicen que, al cabo de un mes, todas sus cuentas dejaron de recibir más anuncios. Usa una cuenta tuya, lanza las consultas a mano y lee las condiciones de OpenAI antes de cualquier recogida automatizada. Una prueba manual es más lenta, pero protege la cuenta y mantiene honesto el resultado.
Construye la lista de consultas. Escribe entre 30 y 50 consultas, mezclando preguntas comerciales (“mejor software de contabilidad para autónomos”) con preguntas informativas (“cómo llevar el seguimiento de los impuestos trimestrales”). Las tasas de anuncios varían según la intención, así que una lista solo con consultas comerciales exagerará la tasa de tu mercado.
Fija el contexto. Usa una sola cuenta Free, el mismo mercado y el mismo día. Abre un chat nuevo para cada consulta, para que los mensajes anteriores no dirijan la respuesta.
Registra cada respuesta. Anota si apareció un anuncio, el nombre del anunciante, el texto del anuncio y si tu dominio o un competidor aparece citado en la respuesta orgánica.
Calcula la tasa. Pasa los resultados a una hoja de cálculo. Con las consultas en la columna A y la marca de anuncio (sí o no) en la columna F, filas 2 a 51, esta fórmula devuelve la proporción de consultas con anuncio:
=CONTAR.SI(F2:F51;"sí")/CONTARA(A2:A51)
Comprueba la relevancia. Pide a dos personas que marquen cada anuncio como en tema o no, y compara. Donde no coincidan, anota la consulta y el anuncio, y decide la regla antes de contar.
Repite. Lanza las mismas consultas en tres días distintos y compara las tasas. Un día te da una respuesta; tres días empiezan a mostrar un patrón.
Consejo
Antes de gastar nada, comprueba si ChatGPT ya menciona tu marca en sus respuestas orgánicas. Nuestro comprobador gratuito de visibilidad en ChatGPT consulta a ChatGPT con la búsqueda web activada y te indica si tu dominio aparece citado como fuente y si tu marca se nombra en la respuesta.
Qué significan los estudios para tu marca y tu presupuesto
Un anuncio compra un espacio identificado junto a la respuesta, no un lugar dentro de ella. OpenAI dice que los anuncios no influyen en las respuestas, así que la cita en la respuesta orgánica no se puede comprar con una campaña. Los estudios también muestran que la tarjeta patrocinada suele proceder de una empresa distinta a la que el usuario preguntó. Planifica para ambos canales y mídelos por separado.
Anuncio de pago o cita orgánica
Anuncio de pago
Identificado como patrocinado, y comprado por clic o impresión
Solo se muestra a usuarios de los planes Free y Go
Se detiene cuando se acaba el presupuesto
Cita orgánica
Llega a usuarios de todos los planes
Dura mientras duren tus contenidos y tus menciones
Depende de lo que recupere el modelo, y no se puede pagar
Las consultas de marca requieren atención especial. Si tu empresa es el tema de una pregunta, espera que el espacio publicitario vaya a otra. Sigue las consultas de marca para anuncios como sigues la búsqueda de marca en Google, y revisa al menos una vez por semana, durante una campaña, el anuncio que aparece con tu propio nombre.
Prueba con presupuestos pequeños y compara el coste por adquisición con tus campañas de búsqueda y redes sociales antes de mover dinero. Nuestro explicador sobre anuncios en las respuestas de IA compara los anuncios dentro de las respuestas de IA con otros formatos de pago, y la redacción publicitaria explica cómo escribir anuncios breves que encajen con la conversación.
En cuanto al lado orgánico, sigue una lista fija de consultas a lo largo del tiempo en lugar de comprobarlas a mano. El seguimiento de menciones de IA de Sorank lanza tus consultas en ChatGPT, Claude y Gemini cada mes y muestra qué respuestas mencionan tu marca y qué fuentes citan. Si prefieres empezar a mano, nuestra guía de una auditoría de visibilidad en IA explica los pasos, y la entrada del glosario sobre citas de IA define qué cuenta como cita.
Errores comunes al leer estudios sobre anuncios de ChatGPT
Los errores más frecuentes son tomar una muestra por el mercado completo, mezclar respuestas con usuarios y citar una cifra sin su unidad ni su fuente. Cada uno es fácil de detectar una vez que sabes qué pregunta hacer.
Leer un estudio de forma incorrecta y de forma correcta
Incorrecto
“ChatGPT muestra anuncios en una cuarta parte de las respuestas”
“Casi la mitad de los usuarios ven anuncios”
“Los anuncios hacen que ChatGPT recomiende marcas”
Correcto
“25,94 % de 50006 consultas comerciales en la muestra de EE. UU. de SE Ranking”
“45 % de las respuestas en un estudio de seguros, 34 de 76”
“Anuncios y citas aparecieron juntos, y el estudio no prueba la causa”
Error 1: tomar una muestra por el mercado
Qué es: un titular que dice “ChatGPT muestra anuncios en un X % de las respuestas” cuando la muestra es una lista de consultas comerciales, o 16 sesiones de seguros. Cómo detectarlo: lee la línea de la muestra antes del resultado, y comprueba si se describen las consultas, los nichos, las sesiones o las cuentas. Cómo corregirlo: reformula la afirmación con su muestra, por ejemplo “en la muestra de SE Ranking de 50006 consultas comerciales en 20 nichos de EE. UU.”.
Error 2: confundir las unidades
Qué es: poner una proporción de respuestas junto a una proporción de usuarios como si midieran lo mismo. El 45 % de Seer es una proporción de respuestas en un solo sector, y su tendencia de 2 de 22 a 12 de 19 es una proporción de usuarios. Cómo detectarlo: busca las palabras “de respuestas”, “de sesiones”, “de usuarios” o “de cuentas” junto a cada cifra. Cómo corregirlo: escribe la unidad junto a cada número que cites.
Error 3: leer una foto puntual como una tendencia
Qué es: llamar tendencia a la tasa de un solo día, o comparar dos estudios hechos en meses distintos como si fueran una sola serie. El propio SE Ranking advierte de que los anuncios rotan y de que el grupo de anunciantes cambia deprisa. Cómo detectarlo: revisa las fechas de recogida. Una tasa de un día, o de un periodo de unas pocas semanas, es una lectura. Cómo corregirlo: repite las mismas consultas en varias fechas, y compara las tasas solo para las mismas consultas.
Error 4: deducir influencia de la coincidencia
Qué es: concluir que los anuncios empujan las respuestas hacia o lejos de ciertas marcas porque ambos aparecen juntos. Los anuncios aparecen sobre todo en consultas comerciales, y esas respuestas ya son distintas de todos modos. Cómo detectarlo: cualquier frase que diga que los anuncios “aumentan”, “reducen” o “moldean” las recomendaciones, sin un control. Cómo corregirlo: escribe “aparece junto con”, y nombra los factores de confusión: tipo de consulta, tema y plan.
Error 5: citar una cifra que no has rastreado
Qué es: repetir un número que aparece en varios artículos, ninguno de los cuales enlaza la página primaria, o cuya muestra no coincide con la del editor. Cómo detectarlo: busca el número en la página del editor. Si no está, no pertenece a ese estudio. Cómo corregirlo: abre la página primaria, encuentra la frase y cita su redacción. El 38 % de respuestas en tema mencionado antes es un ejemplo: no lo encontramos en la página de Seer, así que no lo usamos.
Qué hacer esta semana
Haz una prueba pequeña antes de tomar una decisión de presupuesto. Mide la tasa de anuncios para tus propias consultas, registra tus propias citas, y solo entonces decide si tiene sentido una prueba de pago para tu categoría.
Plan de una semana
Escribe 30 consultas de compradoresUsa las preguntas que tus clientes hacen antes de comprar, sacadas de conversaciones reales y llamadas de ventas.
Lánzalas una vez en una cuenta FreeMismo mercado, mismo día, un chat nuevo por consulta, con capturas de pantalla.
Registra anuncios y citasAnota cada anuncio, su anunciante y si tu dominio aparece citado en la respuesta orgánica.
Repite en dos días másCompara la tasa entre las tres pruebas antes de sacar una conclusión.
DecideSi los compradores de tu categoría ven anuncios, lanza una prueba de pago pequeña con seguimiento de conversiones. Si no, dedica el esfuerzo a las citas orgánicas.
La investigación seguirá cambiando a medida que se amplíe el despliegue. El método que uses para leerla durará más que cualquier cifra concreta, así que mantén la muestra, la unidad y la fecha junto a cada número que cites.
Preguntas frecuentes
¿ChatGPT muestra anuncios?
Sí. Desde el 9 de febrero de 2026, OpenAI prueba espacios patrocinados en ChatGPT para adultos con sesión iniciada en los planes Free y Go. Plus, Pro, Business, Enterprise y Education no tienen anuncios, y OpenAI afirma que los anuncios no influyen en las respuestas.
¿Con qué frecuencia aparecen los anuncios de ChatGPT en las respuestas?
En la muestra de SE Ranking de agosto de 2026, el 25,94 % de las consultas comerciales devolvió un anuncio en ChatGPT, frente al 29,45 % en Google AI Mode. La tasa varía mucho según el tema, con la mayor diferencia en salud, así que la cifra describe solo esa muestra.
¿Los anuncios de ChatGPT cambian la respuesta?
Ningún estudio público ha demostrado que lo hagan, y ninguno puede probar que no lo hagan. OpenAI dice que los anuncios no influyen en las respuestas, pero los estudios externos solo registran dónde aparecen los anuncios y quién los ve.
y!
Consiga gratis su plan de contenidos para 30 días
Analizamos a sus competidores, su sitio web y su visibilidad en las IA para crear gratis un plan de contenidos a medida.
“He probado Sorank en el sitio real de un cliente y es una locura. Hace todo aquello por lo que una agencia cobra 1.500 € al mes. Ahora se pone en producción en ese cliente.”Guillaume Guersanguersanguillaume.com
“Somos una agencia de publicidad y queríamos poner en marcha nuestro SEO de una vez por todas. Sorank nos dio una visión clara de nuestro sitio, nos ayudó a priorizar las optimizaciones y a estructurar correctamente nuestro contenido. La herramienta es fácil de usar, bien diseñada para un equipo y muy práctica para centralizar el seguimiento sin tener que hacer malabares entre varias plataformas. Una base muy sólida para empezar de nuevo con nuestro SEO.”Gaspard MadouiAgencia de Publicidad
“Me especialicé en GEO gracias a Sorank. El GEO Leaderboard me permite mostrar a mis clientes su posicionamiento frente a sus competidores en ChatGPT. Es un verdadero diferenciador comercial.”MélanieFreelancer SEO
“Excelente servicio, funciona bien para nuestro sitio web y nos ayuda a entender cómo mejorarlo para posicionarnos mejor en Google y en otros lugares. Felicitaciones, continúen así, se lo recomiendo.”Hugo T.Comerciante e-commerce


 ChatGPT