Jouw privacy is belangrijk voor ons, daarom kun je bepaalde soorten opslag uitschakelen die niet nodig zijn voor de basiswerking van de website. Het blokkeren van categorieën kan invloed hebben op je ervaring op de website. Meer informatie (Cookiebeleid)
Bedankt! Je aanmelding is ontvangen!
Oeps! Er ging iets mis bij het versturen van het formulier.
Illustratie van een chatantwoord met een kleine gelabelde gesponsorde kaart eronder, naast een staafdiagram met onderzoeksresultaten.
Tools
Op deze pagina
Kort samengevat
ChatGPT-advertenties zijn gesponsorde plaatsingen die OpenAI toont aan ingelogde volwassenen op de Free- en Go-abonnementen. Drie onderzoeken die tussen augustus en november 2026 zijn gepubliceerd, hebben gemeten hoe vaak deze advertenties verschijnen, of ze bij de vraag passen en wie ze krijgt. Geen van de drie bewijst dat advertenties het antwoord zelf veranderen, en de meeste steekproeven zijn klein of kort.
3 dagen gratis, daarna stop je wanneer je wilt. 90 dagen geld-terug-garantie, onder voorwaarden.
Wat ChatGPT-advertenties zijn, en de feiten waarop elk onderzoek steunt
ChatGPT-advertenties zijn duidelijk als gesponsord gelabelde plaatsingen die naast het antwoord van de assistent verschijnen. Ze bereiken ingelogde volwassenen op de Free- en Go-abonnementen, en geen betaald abonnement ziet ze. Elk onderzoek hieronder gaat uit van deze regels, dus je hebt ze nodig voordat je een getal leest.
OpenAI publiceerde de aankondiging van de test op 9 februari 2026. De pagina zegt dat de test gaat over “ingelogde volwassen gebruikers van de abonnementen Free en Go”, terwijl Plus, Pro, Business, Enterprise en Education geen advertenties zien. Advertenties zijn “altijd duidelijk als gesponsord gelabeld en visueel gescheiden van het organische antwoord”. OpenAI stelt ook dat “advertenties de antwoorden die ChatGPT je geeft niet beïnvloeden”, en dat adverteerders geaggregeerde prestatiegegevens krijgen, zoals weergaven of kliks, en niet je gesprekken of persoonlijke gegevens. De aankondiging van OpenAI over het testen van advertenties in ChatGPT is de bron waarnaar elk artikel verwijst, lees hem dus als eerste.
Drie onderzoeken die tussen augustus en november 2026 zijn gepubliceerd, zijn de meest gedetailleerde openbare metingen van ChatGPT-advertenties die we konden herleiden tot de eigen pagina van de uitgever. Ze stellen verschillende vragen, dus ze geven niet dezelfde getallen. De tabel laat zien wat elk onderzoek heeft gemeten en wat het weglaat.
Onderzoek
Gepubliceerd
Gegevens
Wat gemeten is
Wat wegblijft
SE Ranking
10 augustus 2026
50006 commerciële prompts over 20 Amerikaanse niches, gegevens verzameld op 23 juli 2026
Advertentiepercentage per prompt, relevantie van advertenties voor de prompt, vergelijking met Google AI Mode
Plus en andere betaalde abonnementen, het effect van advertenties op antwoorden, elke trend (één momentopname)
Seer Interactive
12 november 2026
161 opgenomen AI-zoeksessies uit negen niet-gemodereerde gebruiksonderzoeken, maart tot september 2026
Of echte gebruikers advertenties op het scherm zagen en of die bij de prompt pasten
Een representatieve steekproef van gebruikers (slechts twee van de negen onderzoeken vroegen naar advertenties)
Brookings
begin oktober 2026
91 ingelogde sokpop-accounts, meer dan 3600 verzamelde advertenties, accounts aangemaakt januari tot maart 2026
Wie advertenties krijgt, getest op inkomen en op ras of etnische afkomst
De groepsgrootte (maar enkele accounts per combinatie) en elke periode nadat de accounts geen nieuwe advertenties meer kregen
De steekproeven achter de onderzoeken
50006commerciële prompts (SE Ranking)
161opgenomen sessies (Seer Interactive)
91sokpop-accounts (Brookings)
3600verzamelde advertenties (Brookings)
Bronnen: SE Ranking, 10 augustus 2026; Seer Interactive, 12 november 2026; Brookings, oktober 2026
Andere artikelen over dit onderwerp komen van GEO-tools, en we konden hun cijfers niet controleren met een primaire bron, dus we hebben ze weggelaten. Citeer alleen getallen die je kunt herleiden tot de pagina van de uitgever, en controleer de steekproefregel voordat je een getal herhaalt.
Hoe ChatGPT-advertenties worden gemeten: het antwoord, de gesponsorde kaart en de onderzoeksgegevens.
Hoe vaak verschijnen advertenties in ChatGPT-antwoorden?
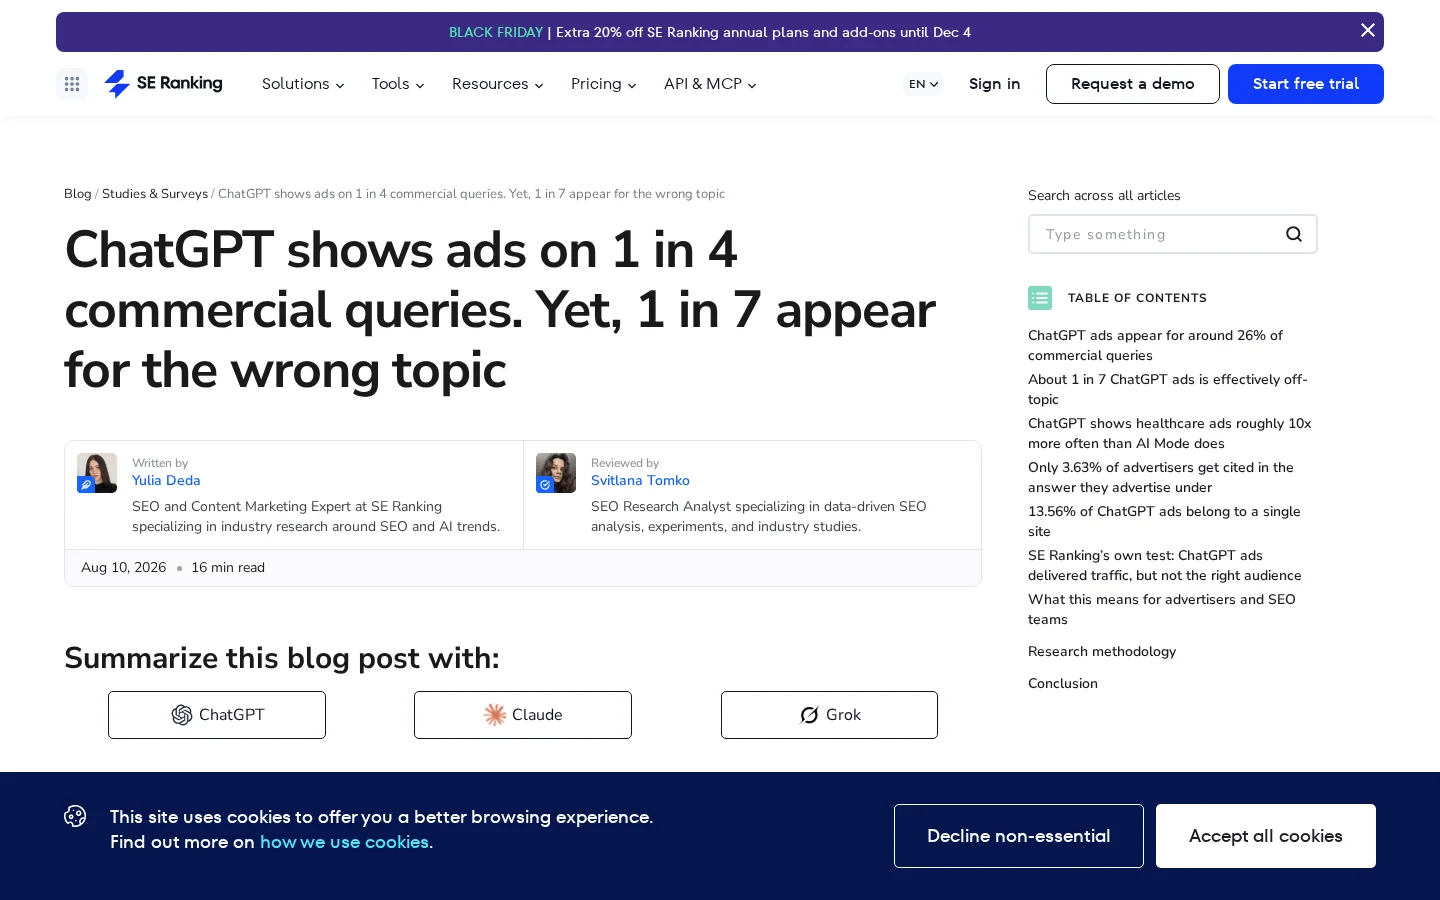
In de steekproef van SE Ranking leverden 25,94% van de commerciële prompts een advertentie op in ChatGPT, tegenover 29,45% in Google AI Mode. Het percentage hangt sterk af van het onderwerp, dus één totaalpercentage zegt weinig over de antwoorden die jouw kopers zien.
SE Ranking gebruikte 50006 commerciële prompts uit 20 Amerikaanse niches, ongeveer 2500 per niche. Voor elke prompt legde het onderzoek het gegenereerde antwoord, de geciteerde bronnen en elke gesponsorde plaatsing vast. In totaal leverden 12974 prompts een advertentie op. De prompts kwamen uit een eerder onderzoek van dezelfde uitgever naar AI Mode, waardoor de twee platforms vergelijkbaar zijn. De gegevens zijn verzameld op 23 juli 2026, en het onderzoek is gepubliceerd op 10 augustus 2026 (SE Ranking, onderzoek naar ChatGPT-advertenties, 10 augustus 2026).
Aandeel commerciële prompts dat een advertentie opleverde
ChatGPT25,94%
Google AI Mode29,45%
Bron: SE Ranking, 10 augustus 2026 (50006 commerciële prompts)
Het verschil per onderwerp is veel groter dan het verschil tussen platforms. In de gezondheidszorg vond het onderzoek advertenties bij 28,69% van de ChatGPT-prompts tegenover 2,64% in AI Mode, meer dan tien keer zoveel. Bij nieuws en politiek was het cijfer 28,76% op ChatGPT tegenover 6,8% op AI Mode. De totaalpercentages lijken op elkaar, het mengsel van onderwerpen is waar de platforms verschillen.
Voorbeeld
Stel dat een koper ChatGPT vraagt welke boekhoudsoftware past bij een zzp'er. Het organische antwoord noemt drie tools, en ernaast verschijnt een gesponsorde kaart voor een vierde product. Dat is de situatie die het percentage meet: een advertentie in hetzelfde antwoord als de organische aanbeveling, niet een advertentie die die vervangt. Dit is een illustratie, geen gemeten geval.
Seer Interactive koos een andere weg. Het artikel van 12 november 2026 beschrijft 161 AI-zoeksessies die zijn opgenomen terwijl deelnemers hun eigen assistenten gebruikten en hardop dachten. In het verzekeringsonderzoek droeg 34 van de 76 waarneembare antwoorden (45%) een advertentie. Dat getal gaat over één branche met 16 sessies, het is dus geen percentage voor ChatGPT in het algemeen.
Seer rapporteert ook een trend op gebruikersniveau: het aandeel ChatGPT-gebruikers in zijn sessies dat een advertentie in het antwoord zag, steeg van 2 op 22 in maart naar 12 op 19 van juli tot september 2026. Dat zijn mensen, geen antwoorden, dus het laat zien dat meer deelnemers een advertentie zagen, niet hoeveel antwoorden er een bevatten. De trend is het nuttigste signaal van de drie onderzoeken, en het minst precies, omdat de groepen van maand tot maand verschillen. Antwoorden en advertenties veranderen van week tot week, daarom is één meting een momentopname, geen oordeel.
Passen de advertenties bij de vraag?
Vaak, maar niet altijd. SE Ranking schat dat 14,35% van de advertentievertoningen niet meer met hun prompt samenhing dan een willekeurig gekoppelde advertentie. Seer ontdekte dat elke advertentie in zijn verzekeringsonderzoek relevant was voor de prompt. De twee resultaten komen uit verschillende steekproeven en tests, ze beschrijven dus verschillende dingen en spreken elkaar niet tegen.
De test van SE Ranking werkt zo. Het berekent de op embeddings gebaseerde cosinusgelijkenis tussen prompt, advertentie en antwoord, en vergelijkt daarna elk echt paar van prompt en advertentie met willekeurig geschudde paren. Een advertentie telt alleen als niet-relevant wanneer de gelijkenis binnen het bereik valt dat willekeurige paren opleveren. Een steekproef van de gemarkeerde gevallen is daarna met de hand nagekeken. Dit is een vereenvoudigde lezing van de logica:
sim_echt    = cos(embed(prompt), embed(advertentie))
sim_willek  = cos(embed(prompt), embed(advertentie_van_een_andere_prompt))   # geschudde paren
niet_relevant = sim_echt valt binnen het bereik dat sim_willek oplevert
Dit is een voorzichtige test. Een advertentie moet niet meer verwant lijken dan een willekeurige advertentie om gemarkeerd te worden, dus zwak relevante advertenties die enigszins verwant lijken, slagen als on-topic. De auteurs zeggen dat 14,35% waarschijnlijk een onderschatting is, omdat de handmatige controle meer zwak relevante advertenties vond dan de test opving. De spreiding over onderwerpen is groot: 2,6% bij huisdieren, 51,1% bij relaties en 54,2% bij nieuws en politiek.
Twee maten voor relevantie en bereik, uit twee onderzoeken
14,35%van de advertentievertoningen die niet meer aan de prompt gerelateerd waren dan een willekeurige advertentie (SE Ranking)
45%van de waarneembare antwoorden in de verzekeringssessies droeg een advertentie (Seer)
Bronnen: SE Ranking, 10 augustus 2026; Seer Interactive, 12 november 2026
Bron: SE Ranking, onderzoek naar ChatGPT-advertenties, 10 augustus 2026
Seer voegt een punt toe dat voor merken belangrijk is. In vijf van de zes verticals met een merkopdracht ging de gesponsorde kaart over een ander bedrijf dan het merk dat de gebruiker had genoemd. Een prompt die jouw bedrijf noemt, kan dus de advertentie van je concurrent tonen in hetzelfde antwoord. Het artikel van Seer merkt ook op dat adverteerders meeveranderen met de vraag, wat betekent dat de adverteerders die je ziet afhangen van hoe de prompt is geformuleerd.
Wie krijgt de advertenties: wat de Brookings-audit vond
De audit van Brookings vond dat accounts met een lager inkomen significant vaker advertenties kregen, en er was geen bewijs dat ras of etnische afkomst bepaalde of een account er een kreeg. De auteurs waarschuwen dat de steekproef klein is, dus het resultaat over ras, dat een nulbevinding is, vraagt in beide richtingen om voorzichtigheid. Beschouw het resultaat over inkomen als het sterkste.
Het ontwerp is het waard om te kennen, omdat het het enige van de drie onderzoeken is dat het profiel controleert. De onderzoekers maakten 91 ingelogde accounts verdeeld over drie raciale en etnische groepen (zwart, Hispanic en wit) en drie inkomenstertielen, met minstens negen accounts in elke combinatie van ras en inkomen. Omdat platforms inkomen noch ras tonen, gebruikten ze de geografische regio als indicator, door elk account te openen vanaf postcodes met die kenmerken. Elke dag kregen de accounts prompts in veel onderwerpcategorieën. Sommige categorieën waren er waar advertenties plausibel zijn, zoals een lasagnerecept, andere waren categorieën waarvoor OpenAI had gezegd geen advertenties te tonen, zoals geestelijke gezondheid. Het onderzoek verzamelde meer dan 3600 advertenties (Brookings, “Understanding the beginning of advertising on ChatGPT”, begin oktober 2026).
Zo is de sokpop-audit uitgevoerd
De accounts aanmakenMaak ingelogde accounts met een vast profiel in elke groep.
De locatie instellenGebruik postcodes met bekende inkomens- en raciale profielen als indicator.
Dagelijks dezelfde prompts sturenMeng onderwerpen waar advertenties plausibel zijn met onderwerpen waar OpenAI zegt er geen te tonen.
Elke advertentie opslaanLeg elke advertentie vast met de prompt en het account dat hem kreeg.
De groepen vergelijkenTest inkomen en ras afzonderlijk, en controleer de steekproefgrootte voordat je conclusies trekt.
Het resultaat over inkomen komt van 53 accounts die minstens één advertentie kregen. Hun inkomen clusterde rond een modus nabij 60000 dollar, terwijl de accounts die er nooit een kregen, piekten rond 80000 dollar. Het resultaat is significant in de termen van het onderzoek, maar het beschrijft een kleine set accounts uit één vroege periode.
Het onderzoek eindigde ook vroeg. Ongeveer een maand na de start kreeg geen enkel account nog meer advertenties te zien. De auteurs zeggen dat OpenAI ze mogelijk heeft herkend. Dat is een waarschuwing voor wie de methode kopieert: een platform dat auditaccounts herkent, kan veranderen wat ze zien, dus de gegevens die ze opleveren zijn geen neutrale steekproef. Het onderzoek vond geen bewijs dat de waarborgen rond gevoelige onderwerpen faalden, en ook daarvoor waarschuwen de auteurs om er niet te veel in te lezen.
Veranderen advertenties het antwoord?
Geen enkel openbaar onderzoek tot nu toe laat zien dat ze dat doen, en geen enkel onderzoek tot nu toe kan bewijzen dat ze dat niet doen. OpenAI stelt dat advertenties de antwoorden niet beïnvloeden. De drie onderzoeken leggen vast waar advertenties verschijnen en wie ze ziet, niet of een antwoord zonder hen anders zou zijn.
Externe onderzoekers kunnen advertenties niet uitschakelen voor één enkel antwoord, dus ze kunnen geen schone controlegroep maken. Het dichtstbijzijnde wat ze kunnen doen, is antwoorden op dezelfde prompt vergelijken over dagen of accounts heen. Die vergelijking is vertekend. Advertenties verschijnen vooral bij commerciële prompts, en commerciële prompts leveren al andere antwoorden op, met meer productlijsten, vergelijkingen en eigen bronnen. Een verschil in bronvermeldingen tussen antwoorden met en zonder advertentie zou op zichzelf geen invloed aantonen.
Een eerlijke test zou de prompt, het abonnement, de locatie en de dag constant houden, daarna de bronvermeldingen van elk antwoord vastleggen, en de test vaak genoeg herhalen om de rotatie van advertenties te overstijgen. Ook dan meet je wat de assistent deed, niet waarom. Totdat OpenAI gegevens publiceert of een onafhankelijke audit de bewering toetst, behandel je “advertenties beïnvloeden de antwoorden niet” als het standpunt van het bedrijf. De openbare onderzoeken bevestigen het noch weerleggen het.
Wat de onderzoeken wel en niet kunnen vertellen
Wat de onderzoeken laten zien
Hoe vaak advertenties verschijnen, per promptset
Wie advertenties ziet, per abonnement en per profiel
Of een advertentie bij de prompt past
Wat de onderzoeken niet laten zien
Of advertenties het antwoord veranderen
Veilingprijzen of biedniveaus
Trends over meerdere maanden
Drie meetmethoden, en wat elk mist
De drie onderzoeken gebruiken drie methoden: een vast promptpanel, opgenomen gebruiksessies en sokpop-accounts. Elk beantwoordt één vraag goed en mist de andere, vergelijk ze dus op methode en niet op kop. De verklaring van OpenAI zelf is een vierde soort bewijs, een claim van het bedrijf en geen meting.
Vast promptpanel (SE Ranking)
Het principe: een vaste lijst prompts over elk platform laten lopen en elk antwoord en elke advertentie vastleggen. Wanneer gebruiken: wanneer je percentages over veel onderwerpen nodig hebt en platforms wilt vergelijken. Voordeel: de schaal, en dezelfde prompts kunnen opnieuw worden gedraaid. Beperking: de promptset bepaalt het resultaat. SE Ranking zelf waarschuwt dat ranglijsten van adverteerders gevoelig zijn voor de keuze van zoekwoorden, dat advertenties roteren zodat dezelfde prompt bij herhaling een andere advertentie of geen krijgt, en dat de pool van adverteerders snel verandert. Voorbeeld: het verschil in de gezondheidszorg (28,69% tegenover 2,64%) verschijnt alleen omdat dezelfde zorgprompts op beide platforms zijn gedraaid.
Opgenomen sessies (Seer Interactive)
Het principe: echte deelnemers gebruiken hun eigen AI-tools terwijl ze hardop denken, en het scherm wordt opgenomen. Seer bemonsterde elke opname elke twee seconden met tekstherkenning op het apparaat om advertentie-eenheden te vinden, en controleerde daarna elk met het oog tegen wat de deelnemer zei. Wanneer gebruiken: wanneer je wilt weten wat een persoon echt op het scherm ziet. Voordeel: de advertentie stond echt op het scherm, en de eigen woorden van de deelnemer staan erbij. Beperking: 161 sessies zijn geen representatieve steekproef, en slechts twee van de negen onderzoeken vroegen deelnemers rechtstreeks naar advertenties. In één onderzoek kwam de automatische scan bij elke sessie en elk aantal advertenties overeen met de handmatige controle, maar telde sommige creatieve varianten te laag. Seer wijst er ook op dat Gemini, Claude en Grok alleen in sommige onderzoeken zijn gescand, dus een afwezigheid daar betekent “wat we hebben waargenomen”, niet “er bestaat niets”.
Sokpop-audit (Brookings)
Het principe: gecontroleerde accounts met vaste profielen krijgen dezelfde prompts, dus verschillen zijn terug te voeren op het profiel. Wanneer gebruiken: wanneer je wilt weten wie er wordt getarget. Voordeel: de variabelen zijn gecontroleerd, wat de andere twee methoden niet kunnen. Beperking: kleine groepen, geografie als stand-in voor inkomen en ras, en het risico op ontdekking, dat dit onderzoek vroegtijdig beëindigde. Voorbeeld: de 53 accounts die een advertentie kregen, geclusterd rond lagere inkomens, tegenover de accounts die nooit een kregen.
Methode
Onderzoek
Gemeten eenheid
Beste vraag
Belangrijkste blinde vlek
Vast promptpanel
SE Ranking
Prompt en antwoord
Hoe vaak, en past het?
Hangt af van de promptset; een momentopname
Opgenomen sessies
Seer Interactive
Sessie en gebruiker
Wat een echte gebruiker ziet
Klein, niet representatief, weinig directe vragen over advertenties
Sokpop-audit
Brookings
Account
Wie advertenties krijgt
Kleine groepen, ontdekking, vroegtijdig einde
De getallen verschillen om redenen die je kunt benoemen: andere prompts (alleen commerciële of een bredere mix), andere eenheden (antwoorden, sessies, gebruikers), andere periodes (één dag in juli, maart tot september, januari tot maart) en andere abonnementsniveaus. Sommige secundaire samenvattingen schrijven Seer een on-topic aandeel van 38% toe, van ongeveer 55000 antwoorden. Het artikel van Seer dat wij lazen geeft geen zo'n verdeling en beslaat 161 sessies, dus we konden het getal niet bevestigen. Citeer het niet voordat je het op de pagina van de uitgever vindt.
Wanneer de gegevens zijn verzameld en wanneer ze zijn gepubliceerd
Januari tot maart 2026Brookings maakt zijn sokpop-accounts aan.
9 februari 2026OpenAI kondigt de advertentietest aan voor ingelogde volwassenen op de Free- en Go-abonnementen.
Maart tot september 2026Seer neemt zijn gebruiksessies op.
23 juli 2026SE Ranking verzamelt zijn gegevens uit het promptpanel.
10 augustus 2026SE Ranking publiceert zijn onderzoek naar ChatGPT-advertenties.
Begin oktober 2026Brookings publiceert zijn sokpop-audit.
12 november 2026Seer Interactive publiceert zijn sessieonderzoek.
Zo meet je het ChatGPT-advertentiepercentage in je eigen markt, stap voor stap
Draai een vaste lijst van 30 tot 50 kopersprompts vanaf één ingelogd Free-account, op dezelfde dag en in dezelfde markt, en leg elke advertentie en elke vermelding van je domein vast. Het advertentiepercentage is het aantal antwoorden met een advertentie gedeeld door alle antwoorden. Herhaal de run op minstens drie dagen, omdat advertenties roteren.
Voordat je de test draait
Prompts geschreven op basis van echte vragen van kopers, niet van je zoekwoordenlijst
Één account van jezelf, op het Free-abonnement, ingelogd
Markt en locatie vastgezet voor de hele run
Een screenshot opgeslagen van elk antwoord, met datum en tijd
Kolommen voor prompt, datum, advertentie ja of nee, adverteerder, advertentietekst en je domein geciteerd ja of nee
Een tweede persoon die elke advertentie beoordeelt als on-topic of niet
Waarschuwing
Maak geen reeks accounts aan om de Brookings-audit te kopiëren. De auteurs zeggen dat na ongeveer een maand al hun accounts geen extra advertenties meer kregen. Gebruik een account van jezelf, draai de prompts met de hand en lees de voorwaarden van OpenAI voordat je geautomatiseerd gegevens verzamelt. Een handmatige test is trager, maar hij beschermt het account en houdt het resultaat eerlijk.
Bouw de promptlijst. Schrijf 30 tot 50 prompts, gemengd uit commerciële vragen (“beste boekhoudsoftware voor zzp'ers”) en informatieve vragen (“hoe hou ik de kwartaalbelasting bij”). Advertentiepercentages verschillen per intentie, dus een lijst met alleen commerciële prompts overschat het percentage voor jouw markt.
Stel de context in. Gebruik één Free-account, dezelfde markt en dezelfde dag. Open een nieuwe chat voor elke prompt, zodat eerdere berichten het antwoord niet sturen.
Leg elk antwoord vast. Noteer of er een advertentie verscheen, de naam van de adverteerder, de advertentietekst, en of je domein of een concurrent in het organische antwoord wordt geciteerd.
Bereken het percentage. Zet de resultaten in een spreadsheet. Met de prompts in kolom A en de advertentievlag (ja of nee) in kolom F, rijen 2 tot en met 51, geeft deze formule het aandeel prompts met een advertentie:
=AANTAL.ALS(F2:F51;"ja")/AANTALARG(A2:A51)
Controleer de relevantie. Laat twee personen elke advertentie als on-topic of niet markeren, en vergelijk daarna. Waar ze het oneens zijn, noteer je de prompt en de advertentie, en bepaal je de regel voordat je telt.
Herhaal. Draai dezelfde prompts op drie verschillende dagen en vergelijk de percentages. Eén dag geeft één antwoord; drie dagen beginnen een patroon te tonen.
Tip
Controleer voordat je iets uitgeeft of ChatGPT je merk al noemt in organische antwoorden. Onze gratis ChatGPT-zichtbaarheidscheck vraagt ChatGPT met websearch ingeschakeld en meldt of je domein als bron wordt geciteerd en of je merk in het antwoord wordt genoemd.
Wat de onderzoeken betekenen voor je merk en je budget
Een advertentie koopt een gelabelde plek naast het antwoord, geen plek erin. OpenAI zegt dat advertenties de antwoorden niet beïnvloeden, dus de vermelding in het organische antwoord kun je niet met een campagne kopen. De onderzoeken laten ook zien dat de gesponsorde kaart vaak van een ander bedrijf komt dan waar de gebruiker naar vroeg. Plan voor beide kanalen en meet ze afzonderlijk.
Betaalde advertentie of organische vermelding
Betaalde advertentie
Gelabeld als gesponsord, en gekocht per klik of vertoning
Alleen getoond aan gebruikers van de Free- en Go-abonnementen
Stopt wanneer het budget stopt
Organische vermelding
Bereikt gebruikers op elk abonnement
Blijft zolang je content en vermeldingen blijven bestaan
Hangt af van wat het model ophaalt, en je kunt er niet voor betalen
Merkprompts vragen extra aandacht. Als jouw bedrijf het onderwerp van een vraag is, reken dan erop dat de advertentieplek naar iemand anders gaat. Volg merkprompts voor advertenties zoals je merkzoekopdrachten op Google volgt, en controleer tijdens een campagne minstens één keer per week de advertentie die je eigen naam oplevert.
Test met kleine budgetten en vergelijk de kosten per acquisitie met je zoek- en social-campagnes voordat je geld verschuift. Onze uitleg over advertenties in AI-antwoorden vergelijkt advertenties binnen AI-antwoorden met andere betaalde formats, en advertentieteksten schrijven behandelt hoe je korte advertenties schrijft die bij het gesprek passen.
Voor de organische kant volg je een vaste lijst prompts in de tijd, in plaats van met de hand te controleren. De AI Mention Tracking van Sorank draait je prompts elke maand op ChatGPT, Claude en Gemini en laat zien welke antwoorden je merk noemen en welke bronnen ze citeren. Als je liever eerst met de hand begint, legt onze gids over een AI-zichtbaarheidsaudit de stappen uit, en de glossaryvermelding over AI-citaties definieert wat als citatie telt.
Veelvoorkomende fouten bij het lezen van onderzoeken naar ChatGPT-advertenties
De meest voorkomende fouten zijn een steekproef behandelen als de hele markt, antwoorden met gebruikers verwarren, en een getal citeren zonder eenheid of bron. Elke fout is makkelijk te herkennen zodra je weet welke vraag je moet stellen.
Een onderzoek op de verkeerde en op de juiste manier lezen
Fout
“ChatGPT toont advertenties bij een kwart van de antwoorden”
“Bijna de helft van de gebruikers ziet advertenties”
“Advertenties zorgen dat ChatGPT merken aanbeveelt”
Juist
“25,94% van 50006 commerciële prompts in de Amerikaanse steekproef van SE Ranking”
“45% van de antwoorden in één verzekeringsonderzoek, 34 van 76”
“Advertenties en citaties kwamen samen voor, en het onderzoek test de oorzaak niet”
Fout 1: een steekproef als markt behandelen
Wat het is: een kop die zegt “ChatGPT toont advertenties bij X% van de antwoorden” terwijl de steekproef een lijst commerciële prompts is, of 16 verzekeringssessies. Hoe je het herkent: lees de steekproefregel vóór het resultaat, en controleer of de prompts, niches, sessies of accounts zijn beschreven. Hoe je het oplost: formuleer de bewering opnieuw met de steekproef erbij, bijvoorbeeld “in de steekproef van SE Ranking van 50006 commerciële prompts uit 20 Amerikaanse niches”.
Fout 2: de eenheden verwarren
Wat het is: een aandeel antwoorden naast een aandeel gebruikers zetten alsof ze hetzelfde meten. De 45% van Seer is een aandeel antwoorden in één branche, en de trend van 2 op 22 naar 12 op 19 is een aandeel gebruikers. Hoe je het herkent: kijk naar de woorden “van de antwoorden”, “van de sessies”, “van de gebruikers” of “van de accounts” naast elk cijfer. Hoe je het oplost: schrijf de eenheid naast elk getal dat je citeert.
Fout 3: een momentopname lezen als trend
Wat het is: het percentage van één dag een trend noemen, of twee onderzoeken uit verschillende maanden vergelijken alsof het één reeks is. SE Ranking zelf waarschuwt dat advertenties roteren en dat de pool van adverteerders snel verandert. Hoe je het herkent: controleer de verzameldata. Een percentage van één dag, of van een periode van enkele weken, is een meting. Hoe je het oplost: herhaal dezelfde prompts op meerdere data, en vergelijk percentages alleen voor dezelfde prompts.
Fout 4: invloed afleiden uit gelijktijdigheid
Wat het is: concluderen dat advertenties antwoorden naar of van bepaalde merken wegduwen omdat ze samen voorkomen. Advertenties verschijnen vooral bij commerciële prompts, en die antwoorden zien er sowieso anders uit. Hoe je het herkent: elke zin die zegt dat advertenties aanbevelingen “verhogen”, “verlagen” of “vormgeven”, zonder controlegroep. Hoe je het oplost: schrijf “komt samen voor met”, en noem de verstorende factoren: type prompt, onderwerp en abonnement.
Fout 5: een getal citeren dat je niet hebt herleid
Wat het is: een getal herhalen dat in meerdere artikelen staat, waarvan geen enkel naar de primaire pagina linkt, of waarvan de steekproef niet overeenkomt met die van de uitgever. Hoe je het herkent: zoek het getal op de pagina van de uitgever. Staat het er niet op, dan hoort het niet bij dat onderzoek. Hoe je het oplost: open de primaire pagina, vind de zin en citeer de bewoordingen. Het eerder genoemde on-topic percentage van 38% is een voorbeeld: we vonden het niet op de pagina van Seer, dus hebben we het niet gebruikt.
Wat je deze week moet doen
Draai een kleine test voordat je een budgetbeslissing neemt. Meet het advertentiepercentage voor je eigen prompts, leg je eigen citaties vast, en beslis pas daarna of een betaalde test zinvol is voor jouw categorie.
Een plan voor één week
Schrijf 30 koperspromptsGebruik de vragen die je klanten stellen voordat ze kopen, uit echte gesprekken en verkoopgesprekken.
Draai ze één keer op één Free-accountDezelfde markt, dezelfde dag, één nieuwe chat per prompt, met screenshots.
Leg advertenties en citaties vastNoteer elke advertentie, de adverteerder, en of je domein in het organische antwoord wordt geciteerd.
Herhaal op twee extra dagenVergelijk het percentage over de drie runs voordat je een conclusie trekt.
BeslisAls kopers in jouw categorie advertenties zien, start dan een kleine betaalde test met conversietracking. Zo niet, steek de inspanning in organische citaties.
Het onderzoek blijft veranderen naarmate de uitrol zich verbreedt. De methode waarmee je het leest, gaat langer mee dan elk afzonderlijk getal, dus houd de steekproef, de eenheid en de datum naast elk getal dat je citeert.
Veelgestelde vragen
Toont ChatGPT advertenties?
Ja. Sinds 9 februari 2026 test OpenAI gesponsorde plaatsingen in ChatGPT voor ingelogde volwassenen op de abonnementen Free en Go. Plus, Pro, Business, Enterprise en Education hebben geen advertenties, en OpenAI stelt dat advertenties de antwoorden niet beïnvloeden.
Hoe vaak verschijnen ChatGPT-advertenties in antwoorden?
In de steekproef van SE Ranking van augustus 2026 leverden 25,94% van de commerciële prompts een advertentie op in ChatGPT, tegenover 29,45% in Google AI Mode. Het percentage varieert sterk per onderwerp, met het grootste verschil in de gezondheidszorg, dus het getal beschrijft alleen die steekproef.
Veranderen ChatGPT-advertenties het antwoord?
Geen enkel openbaar onderzoek heeft laten zien dat ze dat doen, en geen enkel kan bewijzen dat ze dat niet doen. OpenAI stelt dat advertenties de antwoorden niet beïnvloeden, maar externe onderzoeken leggen alleen vast waar advertenties verschijnen en wie ze ziet.
y!
Ontvang gratis je contentplan voor 30 dagen
We analyseren je concurrenten, je website en je AI-zichtbaarheid om gratis een contentplan op maat voor je te maken.
“Ik heb Sorank getest op de site van een echte klant en het is waanzinnig. Het doet alles waar een bureau je $1500 per maand voor rekent. Het gaat nu bij die klant in productie.”Guillaume Guersanguersanguillaume.com
“Wij zijn een advertentiebureau en wilden onze SEO eens en voor altijd weer op de rails krijgen. Sorank gaf ons een helder beeld van onze site, hielp ons optimalisaties te prioriteren en onze content goed te structureren. De tool is makkelijk in gebruik, goed ontworpen voor een team en erg handig om het volgen te centraliseren zonder met meerdere platforms te hoeven jongleren. Een heel solide basis om met onze SEO opnieuw te beginnen.”Gaspard MadouiAdvertentiebureau
“Dankzij Sorank heb ik me gespecialiseerd in GEO. Met de GEO-ranglijst kan ik mijn klanten hun positie ten opzichte van concurrenten in ChatGPT laten zien. Het is een echt commercieel onderscheidend vermogen.”MélanieFreelance SEO-specialist
“Geweldige service, werkt goed voor onze website en helpt ons begrijpen hoe we die kunnen verbeteren om beter te scoren in Google en elders. Gefeliciteerd, ga zo door, ik raad het aan.”Hugo T.E-commerce-ondernemer