ChatGPT 广告研究:研究显示了什么,以及如何解读
ChatGPT 广告研究测量了什么、哪些结论相互矛盾,以及在调整广告或品牌策略之前,如何逐步读懂它们的数字。
简而言之
ChatGPT 广告是 OpenAI 向 Free 和 Go 套餐中已登录成年用户展示的赞助广告位。2026 年 8 月至 11 月间发布的三项研究,测量了这些广告的出现频率、与问题的相关程度,以及哪些人会看到它们。三项研究都没有证明广告是否会改变回答本身,而且大多数样本规模较小或时间较短。
想深入了解?请询问
快速测验
如何让 ChatGPT 和其他 AI 提到您?
Sorank 符合您的回答


在您自己的网站上试用 3 天,看看您在 Google、ChatGPT 和其他 AI 中的位置。
开始 3 天免费试用免费 3 天,之后可随时停止。90 天效果保证,需符合条件。
ChatGPT 广告是与助手回答并排显示的、带有明确标识的赞助广告位。它们面向 Free 和 Go 套餐中已登录的成年用户,任何付费套餐都看不到。下面的每项研究都以这些规则为出发点,因此在阅读任何数字之前,你需要先了解它们。
OpenAI 于 2026 年 2 月 9 日发布了测试公告。其页面写道,测试面向 "logged-in adult users on the Free and Go subscription tiers",而 Plus、Pro、Business、Enterprise 和 Education 套餐没有广告。广告 "always clearly labeled as sponsored and visually separated from the organic answer",即始终明确标注为赞助内容,并在视觉上与自然回答分开。OpenAI 还表示 "ads do not influence the answers ChatGPT gives you",并称广告主只会获得浏览量或点击量等汇总效果数据,而不会获得你的聊天内容或个人信息。OpenAI 关于在 ChatGPT 中测试广告的公告是所有相关文章都会引用的参考资料,所以请先阅读它。
套餐规则对测量很重要。在 Plus 账号上做的研究会发现零广告,但这并不代表市场情况,而是反映了套餐本身。如果你想了解助手如何构建回答的全貌,可以先读ChatGPT 的工作原理:从训练到网页搜索和引用,以及ChatGPT 模型页面。至于广告体系的买方视角,我们的ChatGPT 广告与 OpenAI 广告管理器指南涵盖了设置和测量方法。
2026 年 8 月至 11 月间发布的三项研究,是我们能够追溯到发布方自有页面的、关于 ChatGPT 广告最详细的公开测量。它们提出的问题各不相同,因此给出的数字也不一样。下表显示了每项研究测量了什么,又遗漏了什么。
| 研究 | 发布时间 | 数据 | 测量内容 | 遗漏内容 |
|---|---|---|---|---|
| SE Ranking | 2026 年 8 月 10 日 | 覆盖美国 20 个细分领域的 50006 条商业提示词,数据于 2026 年 7 月 23 日收集 | 每条提示词的广告率、广告与提示词的相关性、与 Google AI Mode 的比较 | Plus 及其他付费套餐、广告对回答的影响、任何趋势(仅为一次快照) |
| Seer Interactive | 2026 年 11 月 12 日 | 来自九项无主持可用性研究的 161 次 AI 搜索会话记录,时间为 2026 年 3 月至 9 月 | 真实用户屏幕上是否看到了广告,以及广告是否与提示词匹配 | 具有代表性的用户样本(九项研究中只有两项询问了广告) |
| Brookings | 2026 年 10 月初 | 91 个已登录的傀儡账号,收集到 3600 多条广告,账号创建于 2026 年 1 月至 3 月 | 谁会收到广告,分别按收入以及按种族或族裔进行测试 | 群组规模(每种组合只有少量账号),以及账号停止接收更多广告之后的任何时段 |
研究背后的样本
来源:SE Ranking,2026 年 8 月 10 日;Seer Interactive,2026 年 11 月 12 日;Brookings,2026 年 10 月
关于这一话题的其他文章来自 GEO 工具,我们无法将其数字与原始来源核对,因此没有采用。只引用你能够追溯到发布方自有页面的数字,并在重复任何数字之前检查样本说明。
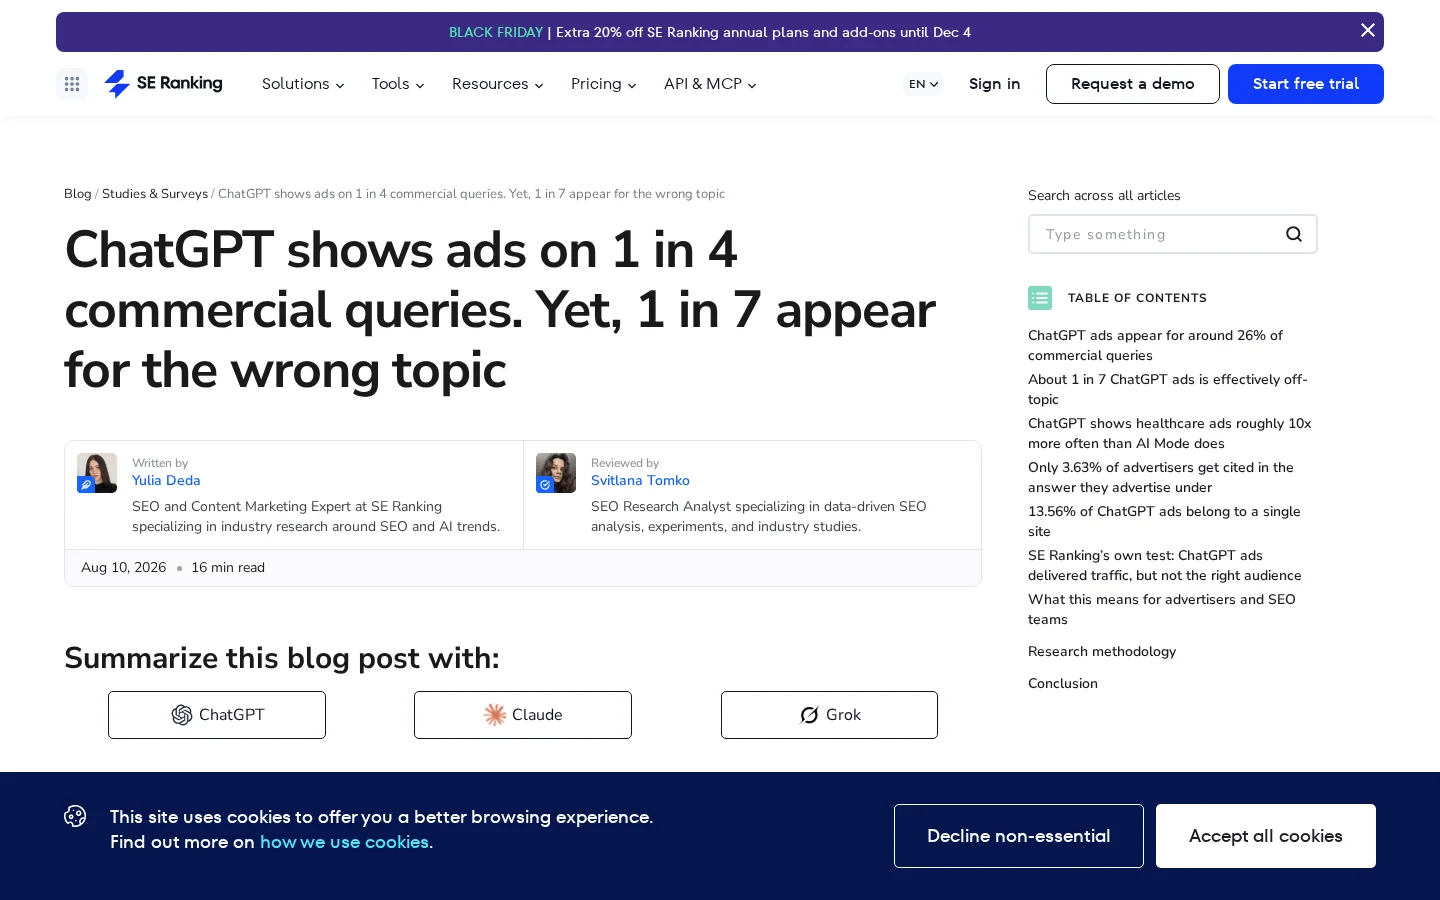
在 SE Ranking 的样本中,ChatGPT 上有 25.94% 的商业提示词返回了广告,而 Google AI Mode 上为 29.45%。这一比率与话题关系很大,因此单一的总体比率对于你的买家所看到的回答说明不了多少。
SE Ranking 使用了来自美国 20 个细分领域的 50006 条商业提示词,每个领域约 2500 条。对于每条提示词,它记录了生成的回答、引用的来源以及任何赞助广告位。总计有 12974 条提示词返回了广告。这些提示词来自同一发布方早先关于 AI Mode 的研究,这使两个平台具有可比性。数据于 2026 年 7 月 23 日收集,研究于 2026 年 8 月 10 日发布(SE Ranking,ChatGPT 广告研究,2026 年 8 月 10 日)。
话题之间的差距远大于平台之间的差距。在医疗保健领域,该研究发现 ChatGPT 的提示词中有 28.69% 出现了广告,而 AI Mode 中为 2.64%,高出十倍以上。在新闻与政治领域,ChatGPT 为 28.76%,AI Mode 为 6.8%。总体比率看起来相近,平台之间的差异在于话题构成。
示例
假设一位买家问 ChatGPT,哪款会计软件适合自由职业者。自然回答列出了三款工具,旁边还出现了一张第四款产品的赞助卡片。这正是该比率所衡量的情况:广告出现在与自然推荐相同的回答中,而不是取代了它。这只是一个示意,不是实测案例。
Seer Interactive 采取了不同的方法。其2026 年 11 月 12 日的文章报告了 161 次 AI 搜索会话,这些会话是在参与者使用自己的助手并边想边说时记录下来的。在保险研究中,76 个可观察的回答中有 34 个(45%)带有广告。该数字只涵盖一个垂直领域中的 16 次会话,因此并不代表 ChatGPT 的总体比率。
Seer 还报告了一个用户层面的趋势:在其会话中,看到回答内广告的 ChatGPT 用户比例,从 3 月的 22 人中有 2 人,上升到 2026 年 7 月至 9 月的 19 人中有 12 人。这些是人,而不是回答,因此它们说明的是更多参与者看到了广告,而不是有多少回答带有广告。这一趋势是三项研究中最有用的信号,也是最不精确的,因为各月的群体不同。回答和广告每周都在变化,这就是为什么单次读数只是快照,而不是定论。
通常匹配,但并非总是如此。SE Ranking 估计,14.35% 的广告展示与其提示词的相关性,并不高于随机配对的广告。Seer 发现,其保险研究中的每条广告都与提示词相关。两项结果来自不同的样本和不同的测试,因此它们描述的是不同的事情,而不是互相矛盾。
SE Ranking 的测试方式是这样的。它基于嵌入(embedding)计算提示词、广告和回答之间的余弦相似度,然后将每一对真实的提示词和广告,与随机打乱的配对进行比较。只有当广告的相似度落在随机配对所产生的范围之内时,它才会被计为偏离主题。被标记的案例样本随后由人工复核。以下是对该逻辑的简化说明:
sim_real   = cos(embed(prompt), embed(ad))
sim_random = cos(embed(prompt), embed(ad_from_another_prompt))   # shuffled pairs
off_target = sim_real falls inside the range produced by sim_random
这是一个保守的测试。广告必须看起来并不比随机广告更相关,才会被标记,因此那些看起来有些相关的弱相关广告会被视为切题。作者表示,14.35% 很可能是低估,因为人工复核发现的弱相关广告比测试捕捉到的更多。不同话题之间的差异很大:宠物为 2.6%,人际关系为 51.1%,新闻与政治为 54.2%。
两项研究中的两个相关性与曝光指标
来源:SE Ranking,2026 年 8 月 10 日;Seer Interactive,2026 年 11 月 12 日
Seer 提出了一个对品牌很重要的观点。在六个有品牌任务的垂直领域中,有五个领域的赞助卡片所推广的公司,与用户提到的品牌并不相同。因此,提示词中提到你公司的时候,同一回答里可能出现的是你竞争对手的广告。Seer 的文章还指出,广告主会随问题而变,这意味着你看到的广告主取决于提示词的措辞。
Brookings 的审计发现,低收入账号收到广告的可能性显著更高,而且没有证据表明种族或族裔会改变账号是否收到广告。作者提醒,样本规模较小,因此种族方面的结果属于无显著差异的发现,在两个方向上都需要谨慎对待。请把收入方面的结果视为更有力的那一个。
这一设计值得了解,因为它是三项研究中唯一控制了用户画像的。研究人员创建了 91 个已登录账号,涵盖三个种族和族裔群体(黑人、西班牙裔和白人)以及三个收入三分位,每种种族和收入组合至少有九个账号。由于平台不公开收入或种族信息,他们以地理区域作为代理,通过具有这些特征的邮政编码访问每个账号。每天,这些账号都会在许多话题类别中接收提示词。有些类别是广告可能出现的,例如千层面食谱;有些则是 OpenAI 表示不会投放广告的,例如心理健康。该研究共收集了 3600 多条广告(Brookings,"Understanding the beginning of advertising on ChatGPT",2026 年 10 月初)。
傀儡账号审计是如何进行的
收入方面的发现来自 53 个至少收到一条广告的账号。它们的收入集中在约 60000 美元附近的众数,而从未收到广告的账号则在约 80000 美元处达到峰值。按照该研究的标准,这一结果具有统计显著性,但它描述的只是单一早期时段中的一小部分账号。
该研究也提前结束了。大约一个月后,所有账号都停止接收更多广告。作者表示,OpenAI 可能已经识别出了它们。这对于想要复制该方法的人来说是一个警示:能够识别审计账号的平台可能会改变它们所看到的内容,因此它们产生的数据并不是中立的样本。研究没有发现敏感话题的防护机制失效的证据,作者同样提醒不要过度解读这一点。
到目前为止,没有任何公开研究表明它们会,也没有任何研究能够证明它们不会。OpenAI 表示广告不会影响回答。这三项研究记录的是广告出现在哪里,以及谁看到了它们,而不是没有广告时回答是否会有所不同。
外部研究人员无法为某一个回答关闭广告,因此无法进行干净的对照实验。他们能做的最接近的事情,是比较同一提示词在不同日期或不同账号下的回答。但这种比较存在混杂因素。广告主要出现在商业提示词上,而商业提示词本身就会产生不同的回答,它们包含更多的产品列表、比较和自身的来源。有广告与无广告的回答之间存在引用差异,这本身并不能说明存在影响。
公平的测试会保持提示词、套餐、位置和日期不变,然后记录每个回答的引用,并且重复足够多次,以穿透广告轮换的影响。即便如此,你测量的也只是助手做了什么,而不是为什么。在 OpenAI 公布数据或独立审计检验这一说法之前,请把 "ads do not influence answers" 视为该公司的立场。公开研究既不证实,也不反驳这一点。
这些研究能说明什么,不能说明什么
三项研究使用了三种方法:固定提示词面板、记录下来的可用性会话,以及傀儡账号。每种方法都能很好地回答一个问题,同时遗漏其他问题,因此应按方法而不是标题数字进行比较。OpenAI 自己的声明是第四类证据,它是公司的主张,而不是测量结果。
原理:在每个平台上运行一份固定的提示词清单,并记录每个回答和每条广告。何时使用:当你需要跨多个话题的比率,并希望比较平台时。优势:规模大,同一批提示词可以重复运行。局限:提示词集决定了结果。SE Ranking 本身警告说,广告主排名对关键词选择很敏感;广告会轮换,因此同一提示词在重复运行时可能得到不同的广告,或者根本没有广告;广告主池变化很快。示例:医疗保健领域的差距(28.69% 对 2.64%)之所以出现,只是因为在两个平台上运行了相同的医疗提示词。
原理:真实参与者在边想边说的同时使用他们自己的 AI 工具,屏幕被录制下来。Seer 每两秒对每段录像采样一次,借助设备端文字识别找出广告单元,然后将每个单元与参与者所说的内容逐一人工核对。何时使用:当你想知道一个人在屏幕上实际看到了什么时。优势:广告确实出现在屏幕上,参与者自己的话也都保留着。局限:161 次会话不是具有代表性的样本,九项研究中只有两项直接询问了参与者关于广告的问题。在其中一项研究中,自动扫描在每次会话和广告数量上都与人工复核一致,但它漏掉了一些创意变体。Seer 还指出,Gemini、Claude 和 Grok 只在部分研究中被扫描,因此那里没有观察到广告,意味着“我们观察到的情况”,而不是“不存在”。
原理:设定了画像的受控账号接收相同的提示词,因此差异可以追溯到画像本身。何时使用:当你想知道谁是广告的定向对象时。优势:变量得到控制,这是另外两种方法做不到的。局限:群组小,以地理位置代替收入和种族,以及存在被识别的风险,后者正是导致该研究提前结束的原因。示例:收到广告的 53 个账号,其收入集中在较低水平,而从未收到广告的账号则不同。
| 方法 | 研究 | 测量单位 | 最佳问题 | 主要盲点 |
|---|---|---|---|---|
| 固定提示词面板 | SE Ranking | 提示词和回答 | 出现频率如何,是否匹配? | 取决于提示词集;只是一个快照 |
| 记录的会话 | Seer Interactive | 会话和用户 | 真实用户看到了什么 | 规模小、不具代表性、直接询问广告的问题少 |
| 傀儡账号审计 | Brookings | 账号 | 谁会收到广告 | 群组小、存在被识别的风险、提前结束 |
各项数字之间存在分歧,原因可以一一列出:提示词不同(仅商业类,或更广泛的组合)、单位不同(回答、会话或用户)、时段不同(2026 年 7 月的一天、3 月至 9 月、1 月至 3 月),以及套餐层级不同。一些二手摘要将 Seer 的一个相关比例归为 38%,来自约 55000 个回答。但我们阅读的 Seer 文章没有给出这样的拆分,而且涵盖的是 161 次会话,因此我们无法确认这个数字。在你在发布方的页面上找到它之前,请不要引用。
数据何时收集,何时发布
使用同一个已登录的 Free 账号,在同一天、同一市场,运行一份由 30 到 50 条买家提示词组成的固定清单,并记录每一条广告,以及你的域名被引用的每一次。广告率是带有广告的回答数除以全部回答数。由于广告会轮换,请至少在三天内重复运行。
开始测试之前
警告
不要为了复制 Brookings 的审计而创建一组账号。作者表示,大约一个月后,他们所有的账号都停止接收更多广告。请使用你自己拥有的一个账号,手动运行提示词,并在进行任何自动化收集之前阅读 OpenAI 的条款。手动测试较慢,但它能保护账号安全,并让结果保持客观。
=COUNTIF(F2:F51,"yes")/COUNTA(A2:A51)提示
在花费任何费用之前,先检查 ChatGPT 是否已经在自然回答中提到你的品牌。我们的免费工具ChatGPT Visibility Checker会在开启网页搜索的情况下询问 ChatGPT,然后报告你的域名是否被引用为来源,以及你的品牌是否在回答中被提及。
广告购买的是回答旁边一个带标签的位置,而不是回答内部的位置。OpenAI 表示广告不会影响回答,因此自然回答中的引用无法通过广告活动购买。研究还表明,赞助卡片往往来自与用户所询问的公司不同的公司。两个渠道都要做规划,并分别进行衡量。
付费广告还是自然引用
品牌类提示词需要额外注意。如果你的公司是某个问题的主题,那么预计广告位会被其他人占据。请像跟踪 Google 上的品牌搜索那样,跟踪提示词中的品牌广告,并且在投放期间至少每周检查一次,看看以你公司名称出现的广告。
先用小预算测试,并在转移资金之前,将每次获客成本与搜索和社交活动进行比较。我们的AI 广告入门指南比较了 AI 回答内的广告与其他付费形式,广告文案则讲解如何撰写适合对话语境的简短广告。
在自然引用方面,请随时间跟踪一份固定的提示词清单,而不是手动检查。Sorank 的 AI 提及追踪每月在 ChatGPT、Claude 和 Gemini 上运行你的提示词,并显示哪些回答提到了你的品牌,以及它们引用了哪些来源。如果你想先手动操作,我们的AI 可见性审计指南解释了具体步骤,关于 AI 引用的词条则定义了什么才算引用。
最常见的错误包括:把样本当成整个市场,把回答与用户混为一谈,以及引用数字时不附带单位或来源。只要知道该问什么问题,每一个错误都很容易发现。
错误地阅读研究与正确地阅读研究
是什么:标题写着“ChatGPT 在 X% 的回答中显示广告”,而样本其实只是一份商业提示词清单,或是 16 次保险会话。如何识别:在看结果之前先读样本说明,并检查提示词、细分领域、会话或账号是否有描述。如何修正:用其样本重新表述该结论,例如“在 SE Ranking 对美国 20 个细分领域的 50006 条商业提示词的样本中”。
是什么:把回答的比例与用户的比例并列,仿佛它们衡量的是同一件事。Seer 的 45% 是一个垂直领域中回答的比例,而其从 2/22 到 12/19 的趋势则是用户的比例。如何识别:看看每个数字旁边是否写着“of responses”“of sessions”“of users”或“of accounts”。如何修正:在你引用的每一个数字旁边都写明单位。
是什么:把某一天的比率称为趋势,或者把两项在不同月份进行的研究当作同一个序列来比较。SE Ranking 本身也警告说,广告会轮换,广告主池变化很快。如何识别:检查数据收集的日期。来自一天、或来自几周时段的比率,只是一次读数。如何修正:在多个日期重复相同的提示词,并且只比较相同提示词的比率。
是什么:因为广告与品牌推荐同时出现,就断定广告会把回答推向某些品牌或远离某些品牌。广告大多出现在商业提示词上,而这些回答本身看起来就不一样。如何识别:任何声称广告会“增加”“减少”或“塑造”推荐、却没有对照组的句子。如何修正:改写为“与……同时出现”,并列出混杂因素:提示词类型、话题和套餐。
是什么:重复一个出现在多篇文章中的数字,而这些文章都没有链接到原始页面,或者其样本与发布方的样本不符。如何识别:在发布方的页面上搜索这个数字。如果找不到,它就不属于那项研究。如何修正:打开原始页面,找到对应的句子,并引用其原文措辞。上文中的 38% 相关性数字就是一个例子:我们在 Seer 的页面上找不到它,因此没有使用。
在做出预算决定之前,先进行一次小规模测试。测量你自己的提示词的广告率,记录你自己的引用,然后再决定你所在的品类是否值得做一次付费测试。
一周计划
随着投放范围的扩大,研究还会持续变化。你用来解读研究的方法,比任何单一数字都更持久,因此请把样本、单位和日期,与你引用的每一个数字放在一起。
会。自 2026 年 2 月 9 日起,OpenAI 在 ChatGPT 中为 Free 和 Go 套餐的已登录成年用户测试赞助广告位。Plus、Pro、Business、Enterprise 和 Education 套餐没有广告,OpenAI 表示广告不会影响回答。
在 SE Ranking 2026 年 8 月的样本中,ChatGPT 上有 25.94% 的商业提示词返回了广告,而 Google AI Mode 上为 29.45%。这一比率因话题差异很大,医疗保健领域的差距最大,因此该数字只描述这一样本。
目前没有公开研究表明它们会改变,也没有研究能证明它们不会。OpenAI 表示广告不会影响回答,但外部研究只记录了广告出现在哪里,以及谁看到了它们。
我们免费分析您的竞争对手、网站和 AI 可见度,为您制定专属内容计划。
 AI 内容简报生成器
 FAQ 结构化数据生成器
 AI 文章选题生成器
 结构化数据验证工具(Schema 验证器)
 图片替代文本检查工具
 内部链接分析工具
 外链挑战
 AI meta 描述生成器
 AI 博客标题生成器
 Google 可收录性检查工具
 AI 文章大纲生成器
 UTM 链接生成器
 关键词聚类工具
 规范标签检查工具
 XML 站点地图生成器
 死链检查工具
 AI SEO 标题生成器
 标题评分工具
 搜索结果预览工具
 重定向检查工具
 hreflang 标签生成器
 标题结构分析工具
 HTTP 响应头检测工具
 Favicon 提取工具
 SEO 流量与收入预测计算器
 SEO 预算计算器
 排名提升模拟器
 关键词机会得分计算器
 GEO 内容投入计算器
 客户终身价值计算器
 点击率计算器
 AI 流量价值计算器
 AI 声量份额计算器
 Gemini 排名查询工具
 ROAS 计算器
 自然流量价值计算器
 本地 SEO 投资回报计算器
 外链建设成本计算器
 关键词密度计算器
 客户获取成本计算器
 单篇文章成本计算器
 跳出率计算器
 AI 引用率计算器
 结构化数据大语言模型审计
 llms.txt 生成器
 站点地图检查工具
 SERP 波动监测器
 字数统计工具
 结构化数据生成器
 关键词研究工具
 SEO 盈亏平衡计算器
 阅读时长计算器
 自然流量预估工具与网站流量查询
 ChatGPT 引荐流量估算器
 AI 曝光度得分计算器
 LLM 可读性检查器
 SearchGPT 就绪度检测工具
 ChatGPT 为什么不推荐我的网站
 URL 提取工具
 网页转 Markdown
 Robots 生成器
 OG 预览
 页面 SEO 审核:SEO 检查与 SEO 分析工具
 LTV 与 CAC 比率计算器
 GEO 回报率计算器
 转化率计算器
 网站可抓取性 AI 审计
 AI 搜索曝光度测试
 页面体积检测工具
 URL Slug 生成器
 Meta 标签生成器
 图片压缩工具
 网站图标生成器
 域名权重查询工具
 SERP 点击率计算器
 电商 SEO 投资回报率计算器
 内容营销投资回报率计算器
 AI 隐形成本计算器
 AI Overview 检查工具与 AI Overviews 排名检查
 Robots.txt 检查工具
 AI SEO 审核
 Perplexity 引用检测工具
 回答引擎优化审核
 ChatGPT 可见度检测工具
 外链分析工具
 SEO 与付费搜索省钱计算器
 SEO 声量占比计算器
 SaaS SEO ROI 计算器
 反向链接投资回报率计算器
 llms.txt 验证器
 LLM 引用检查器
 GEO 审核
 SEO ROI 计算器
 关键词价值计算器
 “两年来,我 100% 的客户都来自 LinkedIn。每天发帖、评论、私信跟进……完全依赖算法。我知道自己需要做 SEO,但总是往后拖:太花时间、太技术、不是我的本行。有了 Sorank,我终于迈出了这一步。4 个月里,我在什么都不发的情况下每月获得 15 个自然线索。目前还没有做到和 LinkedIn 各占一半,但知道自己现在有了第二个能自动增长的线索来源,我睡得更踏实了。”

 Valentin Thomyoffbound.fr
 “我是开发者,不是做市场的。我的 Shopify 主题此前只靠口碑和广告在卖。有了 Sorank,我终于明白该如何搭建自己的 SEO,以及怎样写出能获得排名的文章。审计发现我的产品页面太慢了。两个月内,我的自然流量翻了一倍,当人们搜索 Shopify 主题时,我也开始出现在 ChatGPT 的回答里。而这一切每周只花大约 2 小时。”
 Thème FullStackgo.themefullstack.com
 “对市场营销机构来说是个很棒的工具!用它来审计网站、找出加载慢的页面、确定需要补充哪些内容以及补在哪里,都非常快。”
 Thomas Giraudthe-deployer.fr“我们是一家广告代理商,想要一劳永逸地把 SEO 重新做起来。Sorank 让我们清楚地看到自己网站的情况,帮助我们排定优化的优先级,并把内容结构梳理好。这个工具易于使用,很适合团队,而且非常实用,可以集中跟踪,不用在多个平台之间来回切换。这是我们重新开始做 SEO 的一个非常扎实的基础。”
 Gaspard Madoui广告代理商