환경 설정
개인정보 보호는 저희에게 중요합니다. 웹사이트의 기본 기능에 반드시 필요하지 않은 특정 유형의 저장소는 사용자가 직접 비활성화할 수 있습니다. 카테고리를 차단하면 웹사이트 이용 경험에 영향을 줄 수 있습니다. 더 보기
개인정보 보호는 저희에게 중요합니다. 웹사이트의 기본 기능에 반드시 필요하지 않은 특정 유형의 저장소는 사용자가 직접 비활성화할 수 있습니다. 카테고리를 차단하면 웹사이트 이용 경험에 영향을 줄 수 있습니다. 더 보기

 ChatGPT 광고 연구: 연구가 보여 주는 것과 읽는 방법
ChatGPT 광고 연구가 무엇을 측정하는지, 결과가 어디서 엇갈리는지, 광고나 브랜드 전략을 바꾸기 전에 수치를 단계별로 읽는 방법을 알려 드립니다.
요약
ChatGPT 광고는 OpenAI가 Free 및 Go 요금제의 로그인한 성인 사용자에게 보여주는 스폰서 광고 영역입니다. 2026년 8월부터 11월 사이에 발표된 세 편의 연구는 이 광고가 얼마나 자주 나타나는지, 질문과 얼마나 잘 맞는지, 그리고 누가 광고를 받는지를 측정했습니다. 어느 연구도 광고가 답변 자체를 바꾸는지는 증명하지 못했고, 대부분의 표본은 작거나 기간이 짧습니다.
더 알아보고 싶다면 물어보세요
간단 퀴즈
ChatGPT와 다른 AI 어시스턴트에 언급되려면 어떻게 해야 합니까?
Sorank가 답변에 잘 맞습니다


귀사의 사이트에서 3일 동안 사용해 보시고 Google, ChatGPT 및 다른 AI에서 귀사의 현재 위치를 확인하십시오.
3일 무료 체험 시작3일 무료, 이후 언제든 해지할 수 있습니다. 90일 성과 보장, 조건 적용.
ChatGPT 광고는 어시스턴트의 답변 옆에 표시되는, 스폰서임이 분명히 표시된 영역입니다. Free 및 Go 요금제의 로그인한 성인 사용자에게 노출되며, 유료 요금제 사용자에게는 보이지 않습니다. 아래의 모든 연구는 이 규칙을 출발점으로 삼으므로, 어떤 수치를 읽기 전에 이 규칙을 먼저 이해해야 합니다.
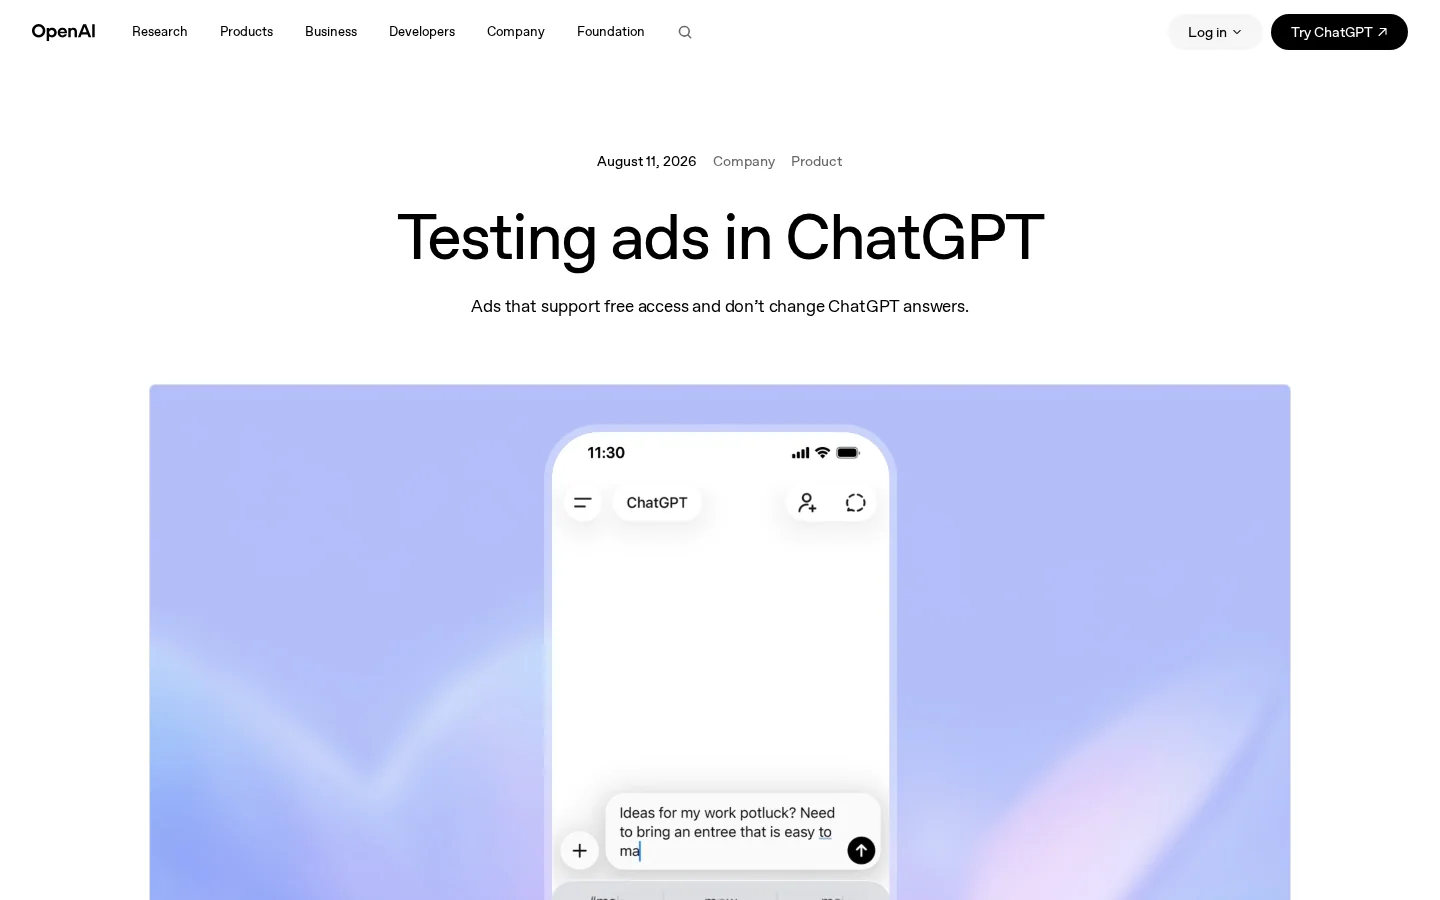
OpenAI는 2026년 2월 9일에 테스트 발표문을 게시했습니다. 페이지에는 테스트 대상이 "logged-in adult users on the Free and Go subscription tiers"이며, Plus, Pro, Business, Enterprise, Education에는 광고가 없다고 적혀 있습니다. 광고는 "always clearly labeled as sponsored and visually separated from the organic answer"라고 명시되어 있습니다. OpenAI는 또한 "ads do not influence the answers ChatGPT gives you"라고 밝히고 있으며, 광고주에게는 조회수나 클릭 수 같은 집계된 성과 데이터만 제공되고 대화 내용이나 개인 정보는 제공되지 않는다고 말합니다. ChatGPT 광고 테스트에 관한 OpenAI 발표문은 모든 해설 글이 가리키는 기준 자료이므로, 먼저 읽어 보시기 바랍니다.
요금제 규칙은 측정에 중요합니다. Plus 계정으로 진행한 연구에서는 광고가 0건으로 나오지만, 이는 시장에 대해 아무것도 말해 주지 않고 요금제를 반영할 뿐입니다. 어시스턴트가 답변을 어떻게 구성하는지 더 넓게 알고 싶다면 ChatGPT의 작동 방식: 학습부터 웹 검색과 인용까지와 ChatGPT 모델 페이지부터 살펴보세요. 광고 시스템의 구매자 관점은 ChatGPT 광고와 OpenAI 광고 관리자 가이드에서 설정과 측정을 다룹니다.
2026년 8월부터 11월 사이에 발표된 세 편의 연구는, 발행 기관의 자체 페이지까지 추적할 수 있었던 ChatGPT 광고에 대한 가장 자세한 공개 측정입니다. 각 연구는 서로 다른 질문을 던지므로 같은 수치가 나오지 않습니다. 아래 표는 각 연구가 무엇을 측정했고 무엇을 빠뜨렸는지 보여 줍니다.
| 연구 | 발표일 | 데이터 | 측정 내용 | 빠진 내용 |
|---|---|---|---|---|
| SE Ranking | 2026년 8월 10일 | 미국 20개 니치의 상업용 프롬프트 50006개, 데이터 수집일 2026년 7월 23일 | 프롬프트별 광고 비율, 광고와 프롬프트의 관련성, Google AI Mode와의 비교 | Plus 및 기타 유료 요금제, 광고가 답변에 미치는 영향, 어떤 추세(한 번의 스냅숏) |
| Seer Interactive | 2026년 11월 12일 | 2026년 3월부터 9월까지 진행된 비중재 사용성 연구 9건에서 기록한 AI 검색 세션 161개 | 실제 사용자가 화면에서 광고를 봤는지, 프롬프트와 맞았는지 | 대표성 있는 사용자 표본(9건 중 2건만 광고에 대해 질문함) |
| Brookings | 2026년 10월 초 | 로그인한 가짜(sock-puppet) 계정 91개, 수집된 광고 3600개 이상, 계정은 2026년 1월부터 3월 사이에 생성 | 누가 광고를 받는지, 소득별 및 인종·민족별로 검증 | 집단 규모(조합마다 계정이 소수), 계정이 추가 광고를 받지 않게 된 이후 기간 |
연구의 바탕이 된 표본
출처: SE Ranking, 2026년 8월 10일; Seer Interactive, 2026년 11월 12일; Brookings, 2026년 10월
이 주제를 다룬 다른 해설 글들은 GEO 도구에서 나온 것이며, 그 수치를 1차 출처와 대조할 수 없었기 때문에 제외했습니다. 발행 기관의 페이지까지 추적할 수 있는 수치만 인용하고, 어떤 수치든 반복하기 전에 표본 설명을 확인하세요.
SE Ranking의 표본에서는 ChatGPT의 상업용 프롬프트 중 25.94%에서 광고가 나왔습니다. Google AI Mode에서는 29.45%였습니다. 이 비율은 주제에 따라 크게 달라지므로, 전체 비율 하나만으로는 고객이 보는 답변에 대해 거의 알 수 없습니다.
SE Ranking은 미국 20개 니치에서 가져온 상업용 프롬프트 50006개를 사용했고, 니치당 약 2500개였습니다. 프롬프트마다 생성된 답변, 인용된 출처, 스폰서 영역의 유무를 기록했습니다. 전체적으로 12974개의 프롬프트에서 광고가 나왔습니다. 프롬프트는 같은 발행 기관이 이전에 진행한 AI Mode 연구에서 가져왔기 때문에 두 플랫폼을 비교할 수 있습니다. 데이터는 2026년 7월 23일에 수집되었고, 연구는 2026년 8월 10일에 발표되었습니다(SE Ranking, ChatGPT 광고 연구, 2026년 8월 10일).
주제에 따른 차이가 플랫폼 간 차이보다 훨씬 큽니다. 헬스케어에서는 ChatGPT 프롬프트의 28.69%에서 광고가 나왔지만, AI Mode에서는 2.64%였습니다. 10배 이상 차이입니다. 뉴스와 정치 분야에서는 ChatGPT 28.76%, AI Mode 6.8%였습니다. 전체 비율은 비슷해 보이며, 플랫폼 간 차이는 주제 구성에서 나옵니다.
예시
프리랜서에게 어떤 회계 소프트웨어가 맞는지 ChatGPT에 묻는 구매자를 상상해 보세요. 자연 답변은 도구 세 가지를 나열하고, 그 옆에 네 번째 제품의 스폰서 카드가 나타납니다. 비율이 측정하는 상황이 바로 이것입니다. 즉, 자연 추천과 같은 답변 안에 있는 광고이며, 그 추천을 대신하는 광고가 아닙니다. 이것은 설명을 위한 예시이며, 측정된 사례가 아닙니다.
Seer Interactive는 다른 방식을 택했습니다. 2026년 11월 12일자 글은 참가자들이 자신의 어시스턴트를 사용하며 소리 내어 생각을 말하는 동안 기록한 AI 검색 세션 161개를 보고합니다. 보험 연구에서는 관찰 가능한 답변 76개 중 34개(45%)에 광고가 있었습니다. 이 수치는 세션 16개뿐인 한 분야에 한정된 것이므로 ChatGPT 전반의 비율이 아닙니다.
Seer는 사용자 단위의 추세도 보고합니다. 이 세션들에서 답변 안의 광고를 본 ChatGPT 사용자의 비율은 3월에 22명 중 2명이었는데, 2026년 7월부터 9월 사이에는 19명 중 12명으로 올랐습니다. 이것은 답변이 아니라 사람을 센 것이므로, 더 많은 참가자가 광고를 보았다는 뜻이지, 광고가 붙은 답변이 몇 개인지를 뜻하지는 않습니다. 이 추세는 세 연구 중 가장 유용한 신호이지만, 달마다 집단이 달라지므로 가장 정밀하지는 않습니다. 답변과 광고는 주마다 바뀌므로, 한 번의 측정값은 판정이 아니라 스냅숏입니다.
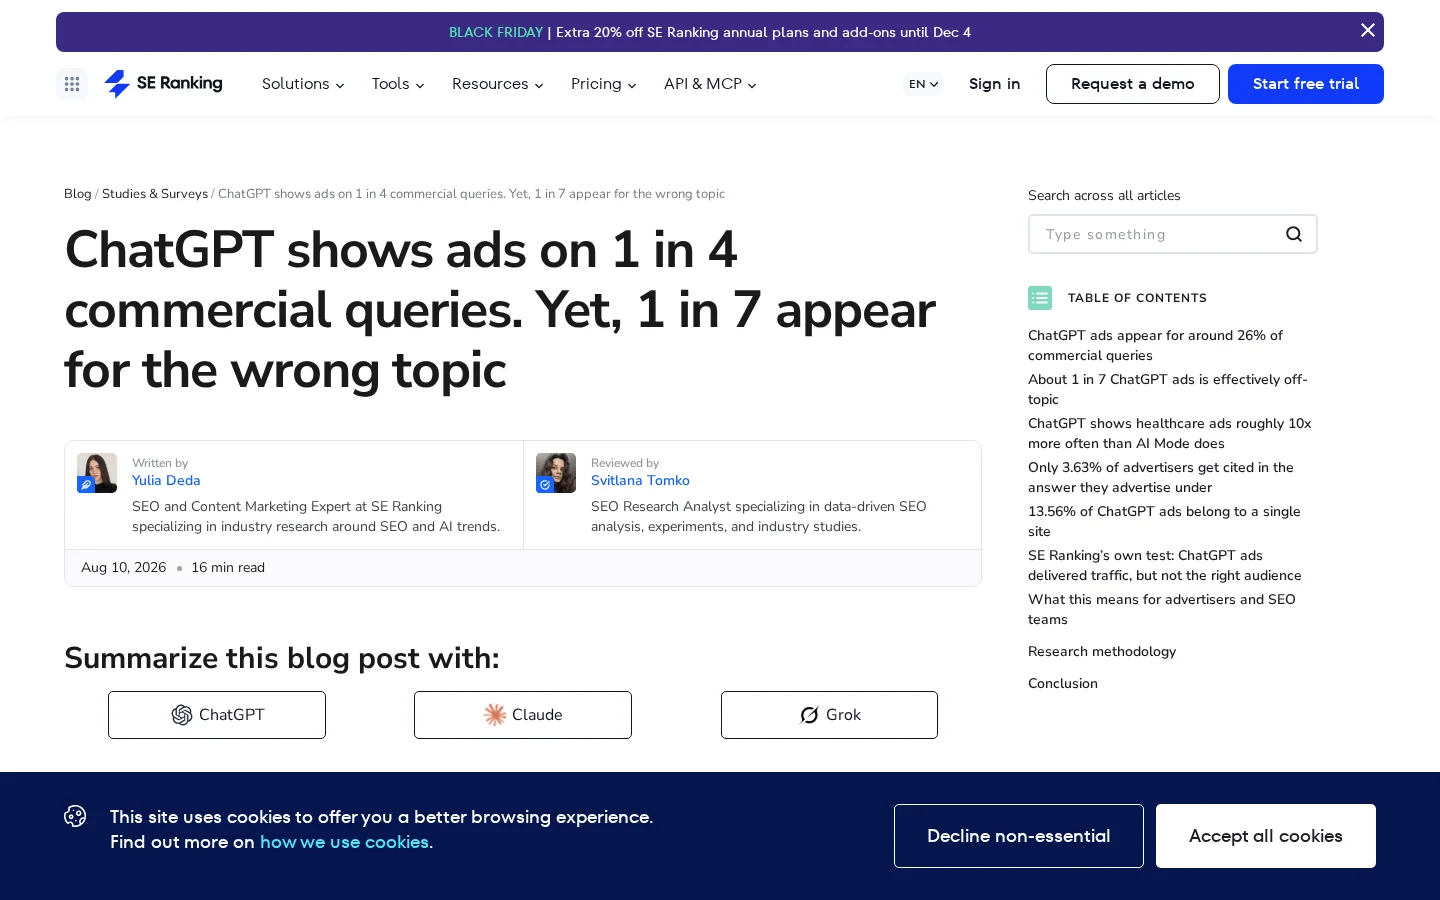
대개는 맞지만 항상 그렇지는 않습니다. SE Ranking은 광고 노출의 14.35%가 무작위로 짝지어진 광고보다 프롬프트와 더 관련이 있지는 않았다고 추정합니다. Seer는 보험 연구의 모든 광고가 프롬프트와 관련이 있었다고 밝혔습니다. 두 결과는 서로 다른 표본과 서로 다른 검증에서 나온 것이므로, 서로 모순되는 것이 아니라 서로 다른 것을 설명합니다.
SE Ranking의 검증은 이렇게 작동합니다. 프롬프트, 광고, 답변 사이의 임베딩 기반 코사인 유사도를 계산한 뒤, 실제 프롬프트-광고 쌍을 무작위로 섞은 쌍과 비교합니다. 광고의 유사도가 무작위 쌍이 만들어 내는 범위 안에 들어갈 때만 주제에서 벗어난 것으로 계산합니다. 표시된 사례의 일부는 이후 사람이 직접 검토했습니다. 로직을 단순화하면 다음과 같습니다.
sim_real   = cos(embed(prompt), embed(ad))
sim_random = cos(embed(prompt), embed(ad_from_another_prompt))   # shuffled pairs
off_target = sim_real falls inside the range produced by sim_random
이 검증은 보수적입니다. 광고가 무작위 광고보다 더 관련 있어 보이지 않아야 표시되므로, 어느 정도 관련 있어 보이는 약한 관련성의 광고는 주제에 맞는 것으로 통과합니다. 저자들은 사람의 검토에서 검증이 잡아낸 것보다 약하게 관련된 광고가 더 많이 나왔으므로 14.35%는 과소 추정일 가능성이 높다고 말합니다. 주제별 편차도 큽니다. 반려동물은 2.6%, 인간관계는 51.1%, 뉴스와 정치는 54.2%입니다.
두 연구의 관련성 및 노출 지표
출처: SE Ranking, 2026년 8월 10일; Seer Interactive, 2026년 11월 12일
Seer는 브랜드에게 중요한 점도 덧붙입니다. 브랜드 과제가 있는 여섯 개 분야 중 다섯 곳에서, 스폰서 카드는 사용자가 언급한 브랜드와 다른 회사의 것이었습니다. 따라서 회사 이름을 포함한 프롬프트가 같은 답변 안에서 경쟁사의 광고를 보여 줄 수 있습니다. Seer의 글은 또한 질문에 따라 광고주도 달라진다고 지적합니다. 즉, 보이는 광고주는 프롬프트의 표현 방식에 따라 달라집니다.
Brookings 감사는 소득이 낮은 계정이 광고를 받을 가능성이 뚜렷하게 높다는 것을 밝혔고, 인종이나 민족이 계정의 광고 수신 여부를 바꾼다는 증거는 찾지 못했습니다. 저자들은 표본이 작다고 경고하며, 차이가 없다는 결과인 인종 결과는 양쪽 방향 모두에서 조심해서 다뤄야 한다고 말합니다. 소득 결과를 더 강한 결과로 보세요.
이 설계는 알아 둘 가치가 있습니다. 세 연구 중 프로필을 통제한 것은 이 연구뿐이기 때문입니다. 연구자들은 세 가지 인종·민족 집단(흑인, 히스패닉, 백인)과 세 가지 소득 삼분위에 걸쳐 로그인한 계정 91개를 만들었고, 인종과 소득 조합마다 최소 9개의 계정을 두었습니다. 플랫폼이 소득이나 인종을 공개하지 않으므로, 연구자들은 지리적 지역을 대리 변수로 사용해 해당 특성을 가진 우편번호에서 각 계정에 접속했습니다. 매일 계정들에는 여러 주제 범주의 프롬프트가 전송되었습니다. 광고가 나올 법한 범주도 있었고(예: 라자냐 레시피), OpenAI가 광고를 제공하지 않겠다고 말한 범주도 있었습니다(예: 정신 건강). 이 연구는 3600개가 넘는 광고를 수집했습니다(Brookings, "Understanding the beginning of advertising on ChatGPT", 2026년 10월 초).
가짜 계정 감사를 진행한 방법
소득 결과는 광고를 최소 한 번 받은 계정 53개에서 나왔습니다. 이 계정들의 소득은 약 60000달러 부근의 최빈값을 중심으로 몰려 있었고, 광고를 한 번도 받지 않은 계정들은 약 80000달러에서 정점을 찍었습니다. 이 결과는 연구의 기준으로 보면 유의미하지만, 초기 한 시기의 소수 계정 집합을 설명할 뿐입니다.
이 연구는 또한 조기에 끝났습니다. 약 한 달이 지나자 모든 계정이 더 이상 광고를 받지 않게 되었습니다. 저자들은 OpenAI가 이들을 탐지했을 수도 있다고 말합니다. 이것은 같은 방법을 따라 하려는 사람에게 주는 경고입니다. 감사 계정을 알아볼 수 있는 플랫폼은 그 계정이 보는 내용을 바꿀 수 있으므로, 그들이 만들어 내는 데이터는 중립적인 표본이 아닙니다. 이 연구는 민감한 주제에 대한 보호 장치가 실패했다는 증거를 찾지 못했으며, 저자들은 이 부분을 과하게 해석하지 말라고도 경고합니다.
지금까지 이를 보여 준 공개 연구는 없으며, 광고가 바꾸지 않는다는 것을 증명할 수 있는 연구도 없습니다. OpenAI는 광고가 답변에 영향을 주지 않는다고 말합니다. 세 연구가 기록하는 것은 광고가 어디에 나타나고 누가 보는지이며, 광고가 없었다면 답변이 달랐을지는 기록하지 않습니다.
외부 연구자는 한 번의 답변에 대해 광고를 끌 수 없으므로 깔끔한 대조군을 만들 수 없습니다. 그들이 가장 가깝게 할 수 있는 것은 같은 프롬프트에 대한 답변을 날짜나 계정에 걸쳐 비교하는 것입니다. 하지만 이 비교에는 교란 변수가 있습니다. 광고는 주로 상업용 프롬프트에 나타나고, 상업용 프롬프트는 원래부터 제품 목록, 비교, 자체 출처가 더 많아서 답변이 다르게 나오기 때문입니다. 광고가 있는 답변과 없는 답변 사이의 인용 차이만으로는 영향이 있었다고 말할 수 없습니다.
공정한 테스트는 프롬프트, 요금제, 위치, 날짜를 일정하게 유지하고, 각 답변의 인용을 기록한 뒤, 광고 순환의 영향을 넘어설 만큼 충분히 반복하는 것입니다. 그렇게 해도 측정하는 것은 어시스턴트가 무엇을 했는지이지, 왜 했는지가 아닙니다. OpenAI가 데이터를 공개하거나 독립적인 감사가 이 주장을 검증하기 전까지는 "ads do not influence answers"를 회사의 입장으로 취급하세요. 공개된 연구는 이를 확인하지도 반박하지도 않습니다.
연구가 말해 줄 수 있는 것과 없는 것
세 연구는 고정 프롬프트 패널, 기록된 사용성 세션, 가짜 계정이라는 세 가지 방법을 사용합니다. 각 방법은 한 가지 질문에는 잘 답하지만 나머지는 놓치므로, 헤드라인 숫자가 아니라 방법별로 비교하세요. OpenAI의 공식 입장은 측정이 아니라 기업의 주장이라는 네 번째 종류의 근거입니다.
원리: 고정된 프롬프트 목록을 각 플랫폼에서 실행하고, 모든 답변과 광고를 기록합니다. 언제 사용하나: 여러 주제에 걸친 비율이 필요하고, 플랫폼을 비교하고 싶을 때. 장점: 규모가 크고, 같은 프롬프트를 다시 실행할 수 있습니다. 한계: 프롬프트 집합이 결과를 결정합니다. SE Ranking 스스로도 광고주 순위가 키워드 선택에 민감하다고 경고하며, 광고가 순환하므로 같은 프롬프트라도 반복 시 다른 광고가 나오거나 광고가 전혀 없을 수 있고, 광고주 풀이 빠르게 바뀐다고 말합니다. 예시: 헬스케어 격차(28.69% 대 2.64%)는 같은 헬스케어 프롬프트를 두 플랫폼에서 실행했기 때문에 드러난 것입니다.
원리: 실제 참가자가 자신의 AI 도구를 사용하면서 소리 내어 생각하고, 화면을 녹화합니다. Seer는 각 녹화를 2초마다 샘플링하고, 기기 내 텍스트 인식으로 광고 단위를 찾은 뒤, 각 단위를 참가자가 한 말과 맞춰 눈으로 확인했습니다. 언제 사용하나: 사람이 실제로 화면에서 무엇을 보는지 알고 싶을 때. 장점: 광고가 실제로 화면에 있었고, 참가자의 말도 그대로 남아 있습니다. 한계: 161개 세션은 대표 표본이 아니며, 9건의 연구 중 광고에 대해 참가자에게 직접 물은 것은 2건뿐입니다. 한 연구에서는 자동 스캔이 모든 세션과 광고 수에서 사람의 검토와 일치했지만, 일부 창작 변형은 놓쳤습니다. Seer는 또한 Gemini, Claude, Grok은 일부 연구에서만 스캔되었으므로, 거기서 광고가 보이지 않는 것은 "우리가 관찰한 것"을 뜻할 뿐 "존재하지 않는다"는 뜻이 아니라고 지적합니다.
원리: 설정된 프로필을 가진 통제된 계정들이 같은 프롬프트를 받으므로, 차이를 프로필로 추적할 수 있습니다. 언제 사용하나: 누가 타깃이 되는지 알고 싶을 때. 장점: 변수를 통제할 수 있으며, 다른 두 방법은 할 수 없는 일입니다. 한계: 집단이 작고, 소득과 인종 대신 지리를 사용하며, 탐지 위험이 있어 이 연구가 조기에 끝난 원인이 되었습니다. 예시: 광고를 받은 계정 53개는 낮은 소득에 몰려 있었지만, 광고를 한 번도 받지 않은 계정은 그렇지 않았습니다.
| 방법 | 연구 | 측정 단위 | 가장 좋은 질문 | 주요 사각지대 |
|---|---|---|---|---|
| 고정 프롬프트 패널 | SE Ranking | 프롬프트와 답변 | 얼마나 자주 나오며, 맞는가? | 프롬프트 집합에 좌우됨; 스냅숏 |
| 기록된 세션 | Seer Interactive | 세션과 사용자 | 실제 사용자가 보는 것 | 작고 대표성이 없으며, 광고에 대한 직접 질문이 적음 |
| 가짜 계정 감사 | Brookings | 계정 | 누가 광고를 받는가 | 작은 집단, 탐지, 조기 종료 |
수치들이 서로 맞지 않는 데에는 설명할 수 있는 이유가 있습니다. 프롬프트가 다르고(상업용만, 또는 더 넓은 혼합), 단위가 다르고(답변, 세션, 사용자), 기간이 다르며(7월 하루, 3월부터 9월, 1월부터 3월), 요금제 등급도 다릅니다. 일부 2차 요약은 Seer의 관련 비율을 약 55000개 답변 중 38%라고 귀속시킵니다. 하지만 우리가 읽은 Seer 글에는 그런 구분이 없고, 161개 세션을 다루므로 이 수치는 확인할 수 없었습니다. 발행 기관의 페이지에서 찾기 전에는 인용하지 마세요.
데이터가 수집된 시기와 발표된 시기
같은 날, 같은 시장에서 로그인한 Free 계정 하나로 30에서 50개 구매자 프롬프트의 고정 목록을 실행하고, 모든 광고와 내 도메인이 인용된 모든 경우를 기록하세요. 광고 비율은 광고가 붙은 답변 수를 전체 답변 수로 나눈 값입니다. 광고는 순환하므로, 최소 3일 동안 실행을 반복하세요.
테스트를 실행하기 전에
경고
Brookings 감사를 따라 하려고 계정 집합을 만들지 마세요. 저자들은 약 한 달 뒤 자신들의 모든 계정이 더 이상 광고를 받지 않게 되었다고 말합니다. 내가 소유한 계정 하나를 사용하고, 프롬프트는 직접 실행하며, 자동 수집을 하기 전에 OpenAI의 약관을 읽으세요. 수동 테스트는 느리지만 계정을 안전하게 지키고 결과를 정직하게 유지합니다.
=COUNTIF(F2:F51,"yes")/COUNTA(A2:A51)팁
무엇에든 돈을 쓰기 전에, ChatGPT가 이미 자연 답변에서 내 브랜드를 언급하고 있는지 확인하세요. 우리의 무료 ChatGPT Visibility Checker는 웹 검색을 켠 상태로 ChatGPT에 묻고, 내 도메인이 출처로 인용되는지, 브랜드가 답변에 언급되는지 알려 줍니다.
광고는 답변 안이 아니라 답변 옆에 있는 표시된 자리를 삽니다. OpenAI는 광고가 답변에 영향을 주지 않는다고 말하므로, 자연 답변의 인용은 광고 캠페인으로 살 수 없습니다. 연구들은 또한 스폰서 카드가 사용자가 물은 회사와 다른 회사에서 나오는 경우가 많다는 것을 보여 줍니다. 두 채널 모두를 계획에 넣고, 각각을 따로 측정하세요.
유료 광고와 자연 인용
브랜드 프롬프트에는 특별한 주의가 필요합니다. 내 회사가 질문의 주제라면, 광고 자리는 다른 누군가에게 돌아갈 것이라고 예상하세요. 브랜드 프롬프트의 광고는 Google에서 브랜드 검색을 추적하듯이 추적하고, 캠페인 중에는 최소 주 1회 내 회사 이름으로 나오는 광고를 확인하세요.
예산은 작게 테스트하고, 자금을 옮기기 전에 획득 비용을 검색 및 소셜 캠페인과 비교하세요. AI 광고 설명 글은 AI 답변 안의 광고와 다른 유료 형식을 비교하고, 광고 카피라이팅은 대화에 맞는 짧은 광고를 쓰는 방법을 다룹니다.
자연 인용 쪽에서는 손으로 확인하는 대신, 고정된 프롬프트 목록을 시간에 걸쳐 추적하세요. Sorank의 AI 언급 추적은 내 프롬프트를 ChatGPT, Claude, Gemini에서 매달 실행하고, 어떤 답변이 내 브랜드를 언급하는지, 어떤 출처를 인용하는지 보여 줍니다. 먼저 직접 해 보고 싶다면, AI 가시성 감사 가이드가 단계를 설명하고, AI 인용에 관한 용어집 항목이 무엇이 인용으로 간주되는지 정의합니다.
가장 흔한 실수는 표본을 시장 전체로 취급하는 것, 답변과 사용자를 뒤섞는 것, 단위나 출처 없이 수치를 인용하는 것입니다. 어떤 질문을 던져야 하는지 알면, 이 실수들은 모두 쉽게 잡아낼 수 있습니다.
연구를 잘못 읽는 방법과 바르게 읽는 방법
무엇인가: 표본이 상업용 프롬프트 목록이거나 보험 세션 16개뿐인데도 "ChatGPT는 답변의 X%에 광고를 보여 준다"라는 헤드라인을 다는 것. 어떻게 알아보나: 결과보다 먼저 표본 설명 줄을 읽고, 프롬프트, 니치, 세션, 계정이 설명되어 있는지 확인하세요. 어떻게 고치나: 주장을 표본과 함께 다시 쓰세요. 예를 들어 "미국 20개 니치에 걸친 상업용 프롬프트 50006개로 이루어진 SE Ranking 표본에서"처럼 씁니다.
무엇인가: 답변의 비율과 사용자의 비율을 나란히 놓고, 같은 것을 측정한 것처럼 다루는 것. Seer의 45%는 한 분야에서 답변 중 차지하는 비율이고, 22명 중 2명에서 19명 중 12명으로 올라간 추세는 사용자의 비율입니다. 어떻게 알아보나: 각 숫자 옆에 "of responses", "of sessions", "of users", "of accounts"가 있는지 보세요. 어떻게 고치나: 인용하는 모든 숫자 옆에 단위를 적으세요.
무엇인가: 하루의 비율을 추세라고 부르거나, 서로 다른 달에 진행된 두 연구를 하나의 시계열처럼 비교하는 것. SE Ranking 스스로도 광고가 순환하고 광고주 풀이 빠르게 바뀐다고 경고합니다. 어떻게 알아보나: 데이터 수집 날짜를 확인하세요. 하루 또는 몇 주 동안의 비율은 하나의 측정값일 뿐입니다. 어떻게 고치나: 같은 프롬프트를 여러 날짜에 반복하고, 같은 프롬프트끼리만 비율을 비교하세요.
무엇인가: 광고와 브랜드가 함께 나타난다는 이유로, 광고가 답변을 브랜드 쪽으로 또는 브랜드에서 멀어지게 민다고 결론짓는 것. 광고는 주로 상업용 프롬프트에 나타나고, 그런 답변은 원래부터 다르게 보입니다. 어떻게 알아보나: 대조군 없이 광고가 추천을 "늘린다", "줄인다", "형성한다"고 말하는 문장. 어떻게 고치나: "와 함께 나타난다"라고 쓰고, 교란 요인을 명시하세요. 프롬프트 유형, 주제, 요금제가 여기에 해당합니다.
무엇인가: 여러 글에 나오지만, 어느 것도 1차 페이지로 연결하지 않거나, 표본이 발행 기관의 표본과 맞지 않는 수치를 반복하는 것. 어떻게 알아보나: 발행 기관의 페이지에서 그 수치를 검색하세요. 거기 없다면 그 연구에 속한 수치가 아닙니다. 어떻게 고치나: 1차 페이지를 열고, 해당 문장을 찾아, 그 표현을 그대로 인용하세요. 위에서 언급한 관련성 38% 수치가 그 예입니다. Seer 페이지에서 찾지 못했으므로 사용하지 않았습니다.
예산 결정을 내리기 전에 작은 테스트를 하세요. 내 프롬프트의 광고 비율을 측정하고, 내 인용을 기록한 다음, 그 뒤에 내 카테고리에서 유료 테스트가 의미가 있는지 결정하세요.
일주일 계획
롤아웃이 확대됨에 따라 연구는 계속 바뀔 것입니다. 연구를 읽는 방법은 어떤 단일 수치보다 오래 쓰일 것이므로, 인용하는 모든 수치 곁에 표본, 단위, 날짜를 함께 두세요.
네. 2026년 2월 9일부터 OpenAI는 Free 및 Go 요금제의 로그인한 성인 사용자를 대상으로 ChatGPT에서 스폰서 광고 영역을 테스트하고 있습니다. Plus, Pro, Business, Enterprise, Education 요금제에는 광고가 없으며, OpenAI는 광고가 답변에 영향을 주지 않는다고 말합니다.
SE Ranking의 2026년 8월 표본에서는 ChatGPT의 상업용 프롬프트 중 25.94%에서 광고가 나왔고, Google AI Mode에서는 29.45%였습니다. 비율은 주제에 따라 크게 달라지며 헬스케어의 격차가 가장 커서, 이 수치는 그 표본만 설명합니다.
답변을 바꾼다고 보여 준 공개 연구는 없고, 바꾸지 않는다고 증명할 수 있는 연구도 없습니다. OpenAI는 광고가 답변에 영향을 주지 않는다고 말하지만, 외부 연구는 광고가 어디에 나타나고 누가 보는지만 기록합니다.
경쟁사, 웹사이트, AI 가시성을 분석해 맞춤 콘텐츠 계획을 무료로 만들어 드립니다.
 AI 콘텐츠 브리프 생성기
 FAQ 스키마 생성기
 AI 블로그 글 아이디어 생성기
 구조화 데이터 검사기(스키마 검사기)
 대체 텍스트 검사기
 내부 링크 분석기
 백링크 챌린지
 AI 메타 설명 생성기
 AI 블로그 제목 생성기
 Google 색인 가능성 검사기
 AI 글 개요 생성기
 UTM 링크 생성기
 키워드 클러스터링 도구
 canonical 태그 검사기
 XML 사이트맵 생성기
 깨진 링크 검사기
 AI SEO 제목 생성기
 제목 점수 분석기
 검색 결과 미리보기
 리디렉션 검사기
 hreflang 생성기
 제목 구조 분석기
 HTTP 헤더 검사기
 Favicon 추출기
 SEO 트래픽·매출 예측 계산기
 SEO 예산 계산기
 순위 상승 시뮬레이터
 키워드 기회 점수 계산기
 GEO 콘텐츠 투자 계산기
 고객 생애 가치 계산기
 CTR 계산기
 AI 트래픽 가치 계산기
 AI 점유율(SOV) 계산기
 Gemini 순위 도구
 ROAS 계산기
 오가닉 트래픽 가치 계산기
 로컬 SEO ROI 계산기
 링크 빌딩 비용 계산기
 키워드 밀도 계산기
 고객 획득 비용 계산기
 글 1편당 비용 계산기
 이탈률 계산기
 AI 인용률 계산기
 LLM용 구조화 데이터 진단
 llms.txt 생성기
 사이트맵 검사기
 SERP 변동성 센서
 단어 카운터
 Schema 마크업 생성기
 키워드 리서치 도구
 SEO 손익분기점 계산기
 읽기 시간 계산기
 오가닉 트래픽 추정기 및 웹사이트 트래픽 확인 도구
 ChatGPT 추천 트래픽 추정기
 AI 가시성 점수 계산기
 AI 가독성 검사기
 SearchGPT 준비도 검사기
 ChatGPT가 내 웹사이트를 추천하지 않는 이유
 URL 추출기
 웹페이지 Markdown 변환기
 robots.txt 생성기
 Open Graph 미리보기
 온페이지 SEO 점검: SEO 검사기 및 SEO 분석 도구
 LTV 대비 CAC 비율 계산기
 GEO ROI 계산기
 전환율 계산기
 AI 크롤러 접근 감사
 AI 검색 가시성 테스트
 페이지 용량 검사기
 URL 슬러그 생성기
 메타 태그 생성기
 이미지 압축기
 파비콘 생성기
 도메인 권위 검사기
 SERP CTR 계산기
 이커머스 SEO ROI 계산기
 콘텐츠 마케팅 ROI 계산기
 AI 비가시성 비용 계산기
 AI 개요 검사기 및 AI Overviews 순위 확인 도구
 robots.txt 검사기
 AI SEO 진단
 Perplexity 순위 검사기
 답변 엔진 최적화(AEO) 진단
 ChatGPT 가시성 체커
 백링크 분석 도구
 SEO 대 유료 검색 절감액 계산기
 SEO 점유율(SOV) 계산기
 SaaS SEO ROI 계산기
 백링크 ROI 계산기
 llms.txt 검증 도구
 LLM 인용 검사기
 GEO 진단
 SEO ROI 계산기
 키워드 가치 계산기
 “2년 동안 제 고객의 100%는 LinkedIn에서 왔습니다. 매일 게시물을 올리고, 댓글을 달고, DM으로 후속 연락을 하고… 알고리즘에 완전히 의존하는 방식이었습니다. SEO를 해야 한다는 것은 알았지만 늘 미뤘습니다. 시간이 오래 걸리고, 너무 기술적이며, 제 일이 아니라고 생각했기 때문입니다. Sorank와 함께 드디어 첫걸음을 내디뎠습니다. 4개월 만에 아무것도 게시하지 않고도 매달 15건의 오가닉 리드를 확보하고 있습니다. 아직 LinkedIn과 50 대 50은 아니지만, 자동 운영으로 성장하는 두 번째 리드 채널이 생겼다는 사실에 훨씬 마음이 놓입니다.”

 Valentin Thomyoffbound.fr“Sorank는 저희가 고객사에 제공하는 성과를 완전히 바꿔 놓았습니다. 이제 AI가 실제로 사용하는 키워드를 파악하고, 특정 경쟁사가 인용되는 이유를 이해하며, 이전에는 전혀 보지 못했던 기회를 발견합니다. 고객사는 더 빠른 순위 상승, AI 답변에서의 더 나은 가시성, 그리고 실행하는 모든 작업에 대한 더 명확한 ROI를 확인합니다.”
 Benjamin Rouxovirank.com
 “저는 마케터가 아니라 개발자입니다. 제 Shopify 테마는 입소문과 광고로만 팔리고 있었습니다. Sorank 덕분에 드디어 SEO를 어떻게 구조화하고 상위에 노출되는 글을 어떻게 써야 하는지 이해했습니다. 진단 결과 제품 페이지가 너무 느리다는 사실이 드러났습니다. 2개월 만에 오가닉 트래픽이 두 배가 되었고, 사람들이 Shopify 테마를 검색할 때 ChatGPT 답변에 등장하기 시작했습니다. 그 모든 것을 주당 약 2시간으로 해냈습니다.”
 Thème FullStackgo.themefullstack.com“Sorank는 저희 SEO 대행사의 운영 방식을 완전히 바꿔 놓았습니다. 모든 것이 한곳에 모이고 자동화되어 고객사마다 들이는 시간이 훨씬 줄었습니다. 예전에 몇 시간씩 걸리던 작업이 이제 몇 분이면 끝나고, 덕분에 드디어 사업 안에서 일하는 것을 멈추고 사업 위에서 일하기 시작할 수 있게 되었습니다.”
 Océane Bondismaison-leverage.com