La confidentialité est importante pour nous. Vous avez donc la possibilité de désactiver certains types de stockage qui peuvent ne pas être nécessaires au fonctionnement de base du site Web. Le blocage des catégories peut avoir un impact sur votre expérience sur le site Web. Plus d'informations (Politique de cookies)
Merci ! Vos choix ont bien été enregistrés.
Oups ! Une erreur s'est produite lors de l'envoi du formulaire.
Étude des publicités ChatGPT : ce que montrent les recherches et comment les lire
Ce que mesurent les études sur les publicités ChatGPT, où elles divergent et comment lire leurs chiffres avant de modifier votre stratégie publicitaire.
Illustration d'une réponse de chat avec une petite carte sponsorisée identifiée en dessous, à côté d'un graphique à barres des résultats d'études.
Outils
Sur cette page
En bref
Les publicités ChatGPT sont des emplacements sponsorisés qu'OpenAI affiche aux adultes connectés des offres Free et Go. Trois études publiées entre août et novembre 2026 ont mesuré à quelle fréquence ces publicités apparaissent, si elles correspondent à la question et à qui elles s'adressent. Aucune ne prouve qu'elles modifient la réponse elle-même, et la plupart des échantillons sont petits ou courts.
3 jours offerts, puis vous arrêtez quand vous voulez. Garantie résultats 90 jours, sous conditions.
Ce que sont les publicités ChatGPT, et les faits sur lesquels reposent toutes les études
Les publicités ChatGPT sont des emplacements sponsorisés clairement signalés, affichés à côté de la réponse de l'assistant. Elles touchent les adultes connectés des offres Free et Go, et aucune offre payante ne les voit. Chaque étude ci-dessous part de ces règles, il faut donc les connaître avant de lire le moindre chiffre.
OpenAI a publié l'annonce de son test le 9 février 2026. Sa page indique que le test concerne « les utilisateurs adultes connectés des offres Free et Go », tandis que Plus, Pro, Business, Enterprise et Education n'ont aucune publicité. Les publicités sont « toujours clairement signalées comme sponsorisées et visuellement séparées de la réponse organique ». OpenAI affirme aussi que « les publicités n'influencent pas les réponses que ChatGPT vous donne », et que les annonceurs reçoivent des données de performance globales, comme les vues ou les clics, et non vos conversations ni vos informations personnelles. L'annonce d'OpenAI sur le test des publicités dans ChatGPT est la référence que citent tous les articles sur le sujet, lisez-la en premier.
Trois études publiées entre août et novembre 2026 sont les mesures publiques les plus détaillées des publicités ChatGPT que nous ayons pu retrouver jusqu'à la page de leur éditeur. Elles posent des questions différentes, elles ne donnent donc pas les mêmes chiffres. Le tableau montre ce que chacune a mesuré et ce qu'elle laisse de côté.
Étude
Publiée le
Données
Ce qu'elle mesure
Ce qu'elle laisse de côté
SE Ranking
10 août 2026
50006 requêtes commerciales sur 20 niches américaines, données collectées le 23 juillet 2026
Taux de publicités par requête, pertinence des publicités par rapport à la requête, comparaison avec le Mode IA de Google
Les offres Plus et autres offres payantes, l'effet des publicités sur les réponses, toute tendance (un seul instantané)
Seer Interactive
12 novembre 2026
161 sessions de recherche IA enregistrées lors de neuf études d'utilisabilité non modérées, de mars à septembre 2026
Si de vrais utilisateurs ont vu des publicités à l'écran, et si elles correspondaient à la requête
Un échantillon représentatif d'utilisateurs (seules deux des neuf études interrogeaient sur les publicités)
Brookings
début octobre 2026
91 comptes connectés fictifs, plus de 3600 publicités collectées, comptes créés de janvier à mars 2026
Qui reçoit des publicités, testé selon le revenu et selon la race ou l'origine ethnique
La taille des groupes (quelques comptes seulement par combinaison), et toute période après l'arrêt de l'envoi de nouvelles publicités aux comptes
Les échantillons derrière les études
50006requêtes commerciales (SE Ranking)
161sessions enregistrées (Seer Interactive)
91comptes fictifs (Brookings)
3600publicités collectées (Brookings)
Sources : SE Ranking, 10 août 2026 ; Seer Interactive, 12 novembre 2026 ; Brookings, octobre 2026
Les autres articles sur ce sujet viennent d'outils GEO, et nous n'avons pas pu vérifier leurs chiffres auprès d'une source primaire, nous les avons donc laissés de côté. Ne citez que les chiffres que vous pouvez retrouver sur la page de l'éditeur, et vérifiez la ligne d'échantillon avant de les répéter.
Comment les publicités ChatGPT sont mesurées : la réponse, la carte sponsorisée et les données de l'étude.
À quelle fréquence les publicités apparaissent-elles dans les réponses de ChatGPT ?
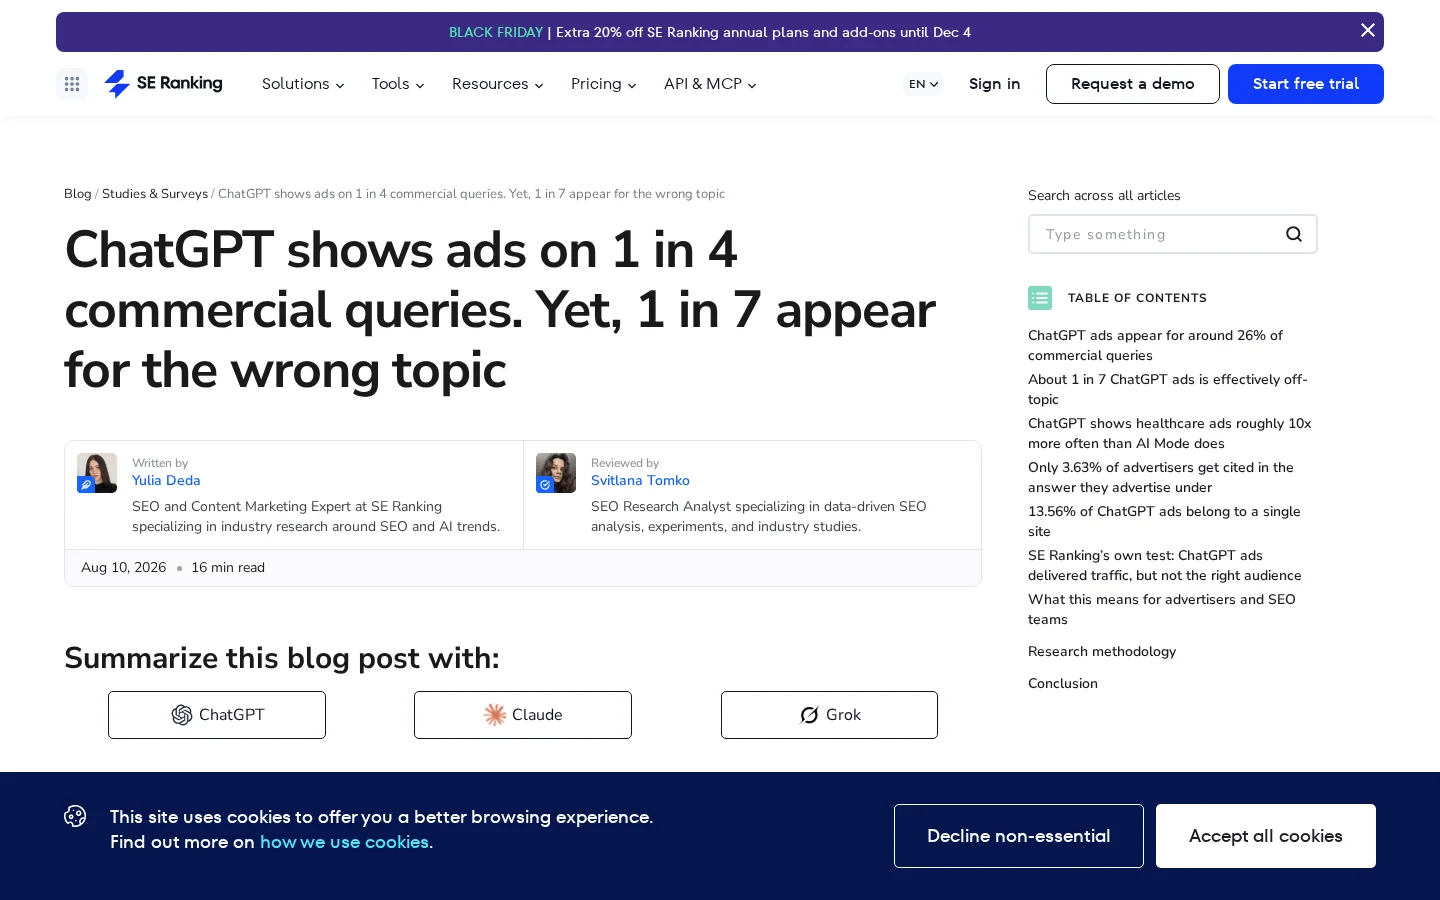
Dans l'échantillon de SE Ranking, 25,94 % des requêtes commerciales ont affiché une publicité sur ChatGPT, contre 29,45 % sur le Mode IA de Google. Le taux dépend fortement du sujet, donc un taux global unique vous apprend peu sur les réponses que voient vos propres acheteurs.
SE Ranking a utilisé 50006 requêtes commerciales issues de 20 niches américaines, soit environ 2500 par niche. Pour chaque requête, l'étude a relevé la réponse générée, ses sources citées et tout emplacement sponsorisé. Au total, 12974 requêtes ont affiché une publicité. Les requêtes venaient d'une étude précédente de même éditeur sur le Mode IA, ce qui rend les deux plateformes comparables. Les données ont été collectées le 23 juillet 2026, et l'étude a été publiée le 10 août 2026 (SE Ranking, étude sur les publicités ChatGPT, 10 août 2026).
Part des requêtes commerciales ayant affiché une publicité
ChatGPT25,94 %
Mode IA de Google29,45 %
Source : SE Ranking, 10 août 2026 (50006 requêtes commerciales)
L'écart selon le sujet est bien plus grand que l'écart entre plateformes. En santé, l'étude relève des publicités sur 28,69 % des requêtes ChatGPT contre 2,64 % en Mode IA, soit plus de dix fois plus. Pour l'actualité et la politique, le chiffre atteint 28,76 % sur ChatGPT contre 6,8 % en Mode IA. Les taux globaux se ressemblent, c'est la répartition des sujets qui différencie les plateformes.
Exemple
Imaginez qu'un acheteur demande à ChatGPT quel logiciel de comptabilité convient à un indépendant. La réponse organique cite trois outils, et une carte sponsorisée pour un quatrième produit apparaît à côté. C'est la situation que mesure le taux : une publicité dans la même réponse que la recommandation organique, et non une publicité qui la remplace. C'est une illustration, pas un cas mesuré.
Seer Interactive a choisi une autre méthode. Son article du 12 novembre 2026 rapporte 161 sessions de recherche IA enregistrées pendant que des participants utilisaient leurs propres assistants en pensant à voix haute. Dans l'étude sur l'assurance, 34 réponses sur 76 observables (45 %) comportaient une publicité. Ce chiffre porte sur un seul secteur avec 16 sessions, ce n'est donc pas un taux pour ChatGPT en général.
Seer signale aussi une tendance au niveau des utilisateurs : la part des utilisateurs de ChatGPT dans ses sessions qui ont vu une publicité dans une réponse est passée de 2 sur 22 en mars à 12 sur 19 de juillet à septembre 2026. Il s'agit de personnes, pas de réponses : cela montre que davantage de participants ont vu une publicité, pas combien de réponses en comportaient une. Cette tendance est le signal le plus utile des trois études, et le moins précis, parce que les groupes changent d'un mois à l'autre. Les réponses et les publicités changent d'une semaine à l'autre, c'est pourquoi une seule mesure est un instantané, pas un verdict.
Les publicités correspondent-elles à la question ?
Souvent, mais pas toujours. SE Ranking estime que 14,35 % des impressions publicitaires n'étaient pas plus liées à leur requête qu'une publicité associée au hasard. Seer a constaté que chaque publicité de son étude sur l'assurance était pertinente pour la requête. Les deux résultats viennent d'échantillons et de tests différents, ils décrivent donc des choses différentes plutôt que de se contredire.
Le test de SE Ranking fonctionne ainsi. Il calcule la similarité cosinus basée sur les embeddings entre la requête, la publicité et la réponse, puis compare chaque couple réel requête-publicité à des couples mélangés au hasard. Une publicité n'est considérée hors sujet que si sa similarité se situe dans la plage produite par les couples aléatoires. Un échantillon des cas signalés a ensuite été relu à la main. Voici une lecture simplifiée de la logique :
sim_reelle = cos(embed(requête), embed(publicité))
sim_aleatoire = cos(embed(requête), embed(publicité_d_une_autre_requête))   # couples mélangés
hors_sujet = sim_reelle se situe dans la plage produite par sim_aleatoire
C'est un test prudent. Une publicité doit paraître aussi peu liée qu'une publicité au hasard pour être signalée, donc les publicités faiblement pertinentes qui semblent un peu liées passent comme étant dans le sujet. Les auteurs disent que 14,35 % est probablement une sous-estimation, car la relecture manuelle a trouvé plus de publicités faiblement pertinentes que le test n'en a détecté. L'écart selon les sujets est large : 2,6 % pour les animaux de compagnie, 51,1 % pour les relations et 54,2 % pour l'actualité et la politique.
Deux mesures de pertinence et d'exposition, issues de deux études
14,35 %des impressions publicitaires non plus liées à la requête qu'une publicité au hasard (SE Ranking)
45 %des réponses observables des sessions sur l'assurance comportaient une publicité (Seer)
Sources : SE Ranking, 10 août 2026 ; Seer Interactive, 12 novembre 2026
Source : SE Ranking, étude sur les publicités ChatGPT, 10 août 2026
Seer ajoute un point qui compte pour les marques. Dans cinq des six secteurs où la tâche portait sur une marque, la carte sponsorisée concernait une autre entreprise que la marque citée par l'utilisateur. Une requête qui nomme votre entreprise peut donc afficher la publicité de votre concurrent dans la même réponse. L'article de Seer note aussi que les annonceurs changent selon la question, ce qui signifie que les annonceurs que vous voyez dépendent de la façon dont la requête est formulée.
Qui reçoit les publicités : ce qu'a révélé l'audit de Brookings
L'audit de Brookings montre que les comptes à revenu plus faible étaient nettement plus susceptibles de recevoir des publicités, et ne trouve aucune preuve que la race ou l'origine ethnique change la probabilité d'en recevoir une. Les auteurs préviennent que l'échantillon est petit, donc le résultat sur la race, qui est une absence d'effet, doit être pris avec prudence dans les deux sens. Considérez le résultat sur le revenu comme le plus solide.
La conception mérite d'être connue, car c'est la seule des trois études qui contrôle le profil. Les chercheurs ont créé 91 comptes connectés répartis entre trois groupes raciaux ou ethniques (Noirs, Hispaniques et Blancs) et trois tiers de revenu, avec au moins neuf comptes pour chaque combinaison de race et de revenu. Comme les plateformes n'exposent ni le revenu ni la race, ils ont utilisé la région géographique comme indicateur, en accédant à chaque compte depuis des codes postaux présentant ces caractéristiques. Chaque jour, les comptes ont reçu des requêtes dans de nombreuses catégories. Certaines étaient des catégories où des publicités sont plausibles, comme une recette de lasagnes, d'autres des catégories où OpenAI a dit ne pas diffuser de publicités, comme la santé mentale. L'étude a collecté plus de 3600 publicités (Brookings, « Understanding the beginning of advertising on ChatGPT », début octobre 2026).
Comment l'audit avec comptes fictifs a été mené
Créer les comptesCréer des comptes connectés avec un profil fixe dans chaque groupe.
Définir la localisationUtiliser des codes postaux aux profils de revenu et de race connus comme indicateur.
Envoyer les mêmes requêtes chaque jourMélanger des sujets où des publicités sont plausibles et des sujets où OpenAI dit n'en diffuser aucune.
Garder chaque publicitéNoter chaque publicité avec la requête et le compte qui l'a reçue.
Comparer les groupesTester séparément le revenu et la race, et vérifier la taille de l'échantillon avant de conclure.
Le résultat sur le revenu provient de 53 comptes qui ont reçu au moins une publicité. Leur revenu se regroupait autour d'un mode proche de 60000 dollars, tandis que les comptes qui n'en ont jamais reçu culminaient vers 80000 dollars. Le résultat est significatif au sens de l'étude, mais il décrit un petit ensemble de comptes issus d'une seule période précoce.
L'étude s'est aussi arrêtée tôt. Un mois environ après le début, tous les comptes ont cessé de recevoir de nouvelles publicités. Les auteurs disent qu'OpenAI a peut-être détecté les comptes. C'est un avertissement pour quiconque voudrait reprendre la méthode : une plateforme qui repère les comptes d'audit peut modifier ce qu'ils voient, les données produites ne sont donc pas un échantillon neutre. L'étude n'a trouvé aucune preuve que les garde-fous sur les sujets sensibles aient échoué, et les auteurs mettent aussi en garde contre une lecture trop poussée de ce point.
Les publicités modifient-elles la réponse ?
Aucune étude publique à ce jour ne montre qu'elles le font, et aucune ne peut prouver qu'elles ne le font pas. OpenAI affirme que les publicités n'influencent pas les réponses. Les trois études enregistrent où les publicités apparaissent et qui les voit, pas si une réponse serait différente sans elles.
Les chercheurs extérieurs ne peuvent pas désactiver les publicités pour une seule réponse, donc ils ne peuvent pas mener un contrôle propre. Le plus proche qu'ils puissent faire est de comparer les réponses à une même requête selon les jours ou les comptes. Cette comparaison est biaisée. Les publicités apparaissent surtout sur les requêtes commerciales, et ces requêtes produisent déjà des réponses différentes, avec davantage de listes de produits, de comparatifs et de sources propres. Une différence de citations entre réponses avec et sans publicité ne montrerait pas à elle seule une influence.
Un test équitable maintiendrait constants la requête, l'offre, la localisation et le jour, puis relèverait les citations de chaque réponse, et répéterait le test assez de fois pour dépasser la rotation des publicités. Même dans ce cas, vous mesureriez ce que l'assistant a fait, pas pourquoi. Tant qu'OpenAI ne publie pas de données ou qu'un audit indépendant ne teste pas cette affirmation, considérez « les publicités n'influencent pas les réponses » comme la position de l'entreprise. Les études publiques ne la confirment ni ne la réfutent.
Ce que les études peuvent et ne peuvent pas vous dire
Montré par les études
À quelle fréquence les publicités apparaissent, par jeu de requêtes
Qui voit les publicités, selon l'offre et le profil
Si une publicité correspond à la requête
Non montré par les études
Si les publicités modifient la réponse
Les prix aux enchères ou les niveaux d'enchères
Les tendances sur plusieurs mois
Trois méthodes de mesure, et ce que chacune rate
Les trois études utilisent trois méthodes : un panel fixe de requêtes, des sessions d'utilisabilité enregistrées et des comptes fictifs. Chacune répond bien à une question et laisse les autres de côté, comparez-les donc par méthode plutôt que par titre. La déclaration d'OpenAI est un quatrième type de preuve, une affirmation de l'entreprise et non une mesure.
Panel fixe de requêtes (SE Ranking)
Le principe : faire passer une liste fixe de requêtes sur chaque plateforme et noter chaque réponse et chaque publicité. Quand l'utiliser : quand vous avez besoin de taux sur de nombreux sujets et voulez comparer les plateformes. Avantage : l'échelle, et les mêmes requêtes peuvent être relancées. Limite : le jeu de requêtes fixe le résultat. SE Ranking lui-même avertit que le classement des annonceurs dépend du choix des mots-clés, que les publicités tournent si bien qu'une même requête peut recevoir une autre publicité ou aucune à la répétition, et que le vivier d'annonceurs change vite. Exemple : l'écart en santé (28,69 % contre 2,64 %) n'apparaît que parce que les mêmes requêtes de santé ont été lancées sur les deux plateformes.
Sessions enregistrées (Seer Interactive)
Le principe : de vrais participants utilisent leurs propres outils d'IA en pensant à voix haute, et l'écran est enregistré. Seer a échantillonné chaque enregistrement toutes les deux secondes avec une reconnaissance de texte sur l'appareil pour repérer les emplacements publicitaires, puis a vérifié chacun à l'œil par rapport à ce que disait le participant. Quand l'utiliser : quand vous voulez savoir ce qu'une personne voit réellement à l'écran. Avantage : la publicité était bien affichée à l'écran, et les propres mots du participant sont là. Limite : 161 sessions ne forment pas un échantillon représentatif, et seules deux des neuf études ont interrogé directement les participants sur les publicités. Dans une étude, le scan automatique a coïncidé avec la relecture manuelle pour chaque session et chaque nombre de publicités, mais il a sous-compté certaines variantes de créations. Seer note aussi que Gemini, Claude et Grok n'ont été scannés que dans certaines études, donc une absence là-bas signifie « ce que nous avons observé », pas « il n'en existe aucune ».
Audit avec comptes fictifs (Brookings)
Le principe : des comptes contrôlés, aux profils définis, reçoivent les mêmes requêtes, donc les différences peuvent être rattachées au profil. Quand l'utiliser : quand vous voulez savoir qui est ciblé. Avantage : les variables sont contrôlées, ce que les deux autres méthodes ne permettent pas. Limite : de petits groupes, la géographie utilisée comme substitut du revenu et de la race, et le risque de détection, qui a mis fin tôt à cette étude. Exemple : les 53 comptes qui ont reçu une publicité, regroupés autour de revenus plus faibles, face à ceux qui n'en ont jamais reçu.
Méthode
Étude
Unité mesurée
Meilleure question
Principal angle mort
Panel fixe de requêtes
SE Ranking
Requête et réponse
À quelle fréquence, et y a-t-il correspondance ?
Dépend du jeu de requêtes ; un instantané
Sessions enregistrées
Seer Interactive
Session et utilisateur
Ce que voit un vrai utilisateur
Petit échantillon, non représentatif, peu de questions directes sur les publicités
Audit avec comptes fictifs
Brookings
Compte
Qui reçoit des publicités
Petits groupes, détection, arrêt précoce
Les chiffres ne concordent pas, pour des raisons que vous pouvez nommer : des requêtes différentes (commerciales seulement, ou un mélange plus large), des unités différentes (réponses, sessions, utilisateurs), des périodes différentes (une journée de juillet, de mars à septembre, de janvier à mars) et des offres différentes. Certaines synthèses secondaires attribuent à Seer une part de réponses pertinentes de 38 % sur environ 55000 réponses. L'article de Seer que nous avons lu ne présente aucune répartition de ce type et porte sur 161 sessions, nous n'avons donc pas pu confirmer ce chiffre. Ne le citez pas tant que vous ne l'avez pas trouvé sur la page de l'éditeur.
Quand les données ont été collectées et quand elles ont été publiées
De janvier à mars 2026Brookings crée ses comptes fictifs.
9 février 2026OpenAI annonce le test des publicités pour les adultes connectés des offres Free et Go.
De mars à septembre 2026Seer enregistre ses sessions d'utilisabilité.
23 juillet 2026SE Ranking collecte ses données sur le panel de requêtes.
10 août 2026SE Ranking publie son étude sur les publicités ChatGPT.
Début octobre 2026Brookings publie son audit avec comptes fictifs.
12 novembre 2026Seer Interactive publie son étude sur les sessions.
Comment mesurer le taux de publicités ChatGPT sur votre propre marché, étape par étape
Lancez une liste fixe de 30 à 50 requêtes d'acheteurs depuis un compte Free connecté, le même jour et sur le même marché, puis notez chaque publicité et chaque citation de votre domaine. Le taux de publicités est le nombre de réponses comportant une publicité divisé par le nombre total de réponses. Répétez le test sur au moins trois jours, car les publicités tournent.
Avant de lancer le test
Requêtes écrites à partir de vraies questions d'acheteurs, et non de votre liste de mots-clés
Un compte que vous possédez, sur l'offre Free, connecté
Marché et localisation fixés pour toute la série
Une capture d'écran enregistrée pour chaque réponse, avec la date et l'heure
Colonnes pour la requête, la date, publicité oui ou non, l'annonceur, le texte de la publicité et votre domaine cité oui ou non
Une deuxième personne qui note chaque publicité comme pertinente ou non
Attention
Ne créez pas un ensemble de comptes pour reproduire l'audit de Brookings. Les auteurs disent qu'un mois environ après le début, tous leurs comptes ont cessé de recevoir de nouvelles publicités. Utilisez un compte que vous possédez, lancez les requêtes à la main, et lisez les conditions d'OpenAI avant toute collecte automatisée. Un test manuel est plus lent, mais il protège le compte et garde le résultat honnête.
Construisez la liste de requêtes. Écrivez 30 à 50 requêtes, en mêlant des questions commerciales (« meilleur logiciel de comptabilité pour indépendants ») et des questions informatives (« comment suivre ma TVA trimestrielle »). Les taux de publicités varient selon l'intention, donc une liste de requêtes uniquement commerciales surestimera le taux pour votre marché.
Fixez le contexte. Utilisez un seul compte Free, le même marché et le même jour. Ouvrez une conversation vierge pour chaque requête, afin que les messages précédents n'orientent pas la réponse.
Notez chaque réponse. Indiquez si une publicité est apparue, le nom de l'annonceur, le texte de la publicité, et si votre domaine ou un concurrent est cité dans la réponse organique.
Calculez le taux. Reportez les résultats dans un tableur. Avec les requêtes en colonne A et l'indicateur de publicité (oui ou non) en colonne F, lignes 2 à 51, cette formule donne la part des requêtes avec une publicité :
=NB.SI(F2:F51;"oui")/NBVAL(A2:A51)
Vérifiez la pertinence. Faites noter par deux personnes chaque publicité comme pertinente ou non, puis comparez. Là où elles divergent, notez la requête et la publicité, et fixez la règle avant de compter.
Répétez. Lancez les mêmes requêtes sur trois jours différents et comparez les taux. Un jour ne donne qu'une réponse, trois jours commencent à dessiner un schéma.
Astuce
Avant de dépenser quoi que ce soit, vérifiez si ChatGPT cite déjà votre marque dans ses réponses organiques. Notre Vérificateur de visibilité ChatGPT gratuit interroge ChatGPT avec la recherche web activée, puis indique si votre domaine est cité comme source et si votre marque est nommée dans la réponse.
Ce que les études signifient pour votre marque et votre budget
Une publicité achète un emplacement signalé à côté de la réponse, pas une place à l'intérieur. OpenAI affirme que les publicités n'influencent pas les réponses, la citation dans la réponse organique ne peut donc pas être achetée avec une campagne. Les études montrent aussi que la carte sponsorisée vient souvent d'une entreprise différente de celle sur laquelle l'utilisateur s'est renseigné. Prévoyez les deux canaux, et mesurez-les séparément.
Publicité payante ou citation organique
Publicité payante
Signalée comme sponsorisée, et achetée au clic ou à l'impression
Affichée aux seuls utilisateurs Free et Go
S'arrête quand le budget s'arrête
Citation organique
Atteint les utilisateurs de toutes les offres
Dure aussi longtemps que vos contenus et vos mentions
Dépend de ce que le modèle récupère, et on ne peut pas la payer
Les requêtes de marque demandent une attention particulière. Si votre entreprise est le sujet d'une question, attendez-vous à ce que l'emplacement publicitaire aille à quelqu'un d'autre. Suivez les requêtes de marque pour les publicités comme vous suivez la recherche de marque sur Google, et vérifiez au moins une fois par semaine pendant une campagne la publicité qui apparaît pour votre propre nom.
Testez des budgets réduits et comparez le coût par acquisition avec vos campagnes de recherche et sociales avant de déplacer de l'argent. Notre article sur les publicités dans les réponses IA compare les publicités intégrées aux réponses IA avec les autres formats payants, et la rédaction publicitaire explique comment écrire des annonces courtes qui s'intègrent à la conversation.
Pour le volet organique, suivez une liste fixe de requêtes dans le temps au lieu de vérifier à la main. Le suivi des mentions IA de Sorank lance vos requêtes sur ChatGPT, Claude et Gemini chaque mois et montre quelles réponses mentionnent votre marque et quelles sources elles citent. Si vous préférez commencer à la main, notre guide sur un audit de visibilité IA explique les étapes, et la fiche du glossaire sur les citations IA définit ce qui compte comme citation.
Erreurs courantes en lisant les études sur les publicités ChatGPT
Les erreurs les plus fréquentes consistent à prendre un échantillon pour tout le marché, à confondre réponses et utilisateurs, et à citer un chiffre sans son unité ni sa source. Chacune est facile à repérer une fois que vous savez quelle question poser.
Lire une étude de la mauvaise façon et de la bonne façon
Mauvais
« ChatGPT affiche des publicités sur un quart des réponses »
« Presque la moitié des utilisateurs voient des publicités »
« Les publicités poussent ChatGPT à recommander des marques »
Bon
« 25,94 % de 50006 requêtes commerciales dans l'échantillon américain de SE Ranking »
« 45 % des réponses dans une étude sur l'assurance, 34 sur 76 »
« Publicités et citations sont apparues ensemble, et l'étude ne teste pas la cause »
Erreur 1 : prendre un échantillon pour le marché
Ce que c'est : un titre qui dit « ChatGPT affiche des publicités sur X % des réponses » alors que l'échantillon est une liste de requêtes commerciales, ou 16 sessions d'assurance. Comment la repérer : lisez la ligne d'échantillon avant le résultat, et vérifiez si les requêtes, niches, sessions ou comptes sont décrits. Comment la corriger : reformulez l'affirmation avec son échantillon, par exemple « dans l'échantillon de SE Ranking de 50006 requêtes commerciales sur 20 niches américaines ».
Erreur 2 : confondre les unités
Ce que c'est : mettre côte à côte une part de réponses et une part d'utilisateurs comme si elles mesuraient la même chose. Les 45 % de Seer sont une part de réponses dans un seul secteur, et sa tendance de 2 sur 22 à 12 sur 19 est une part d'utilisateurs. Comment la repérer : cherchez les mots « des réponses », « des sessions », « des utilisateurs » ou « des comptes » à côté de chaque chiffre. Comment la corriger : écrivez l'unité à côté de chaque nombre que vous citez.
Erreur 3 : lire un instantané comme une tendance
Ce que c'est : appeler tendance le taux d'une seule journée, ou comparer deux études menées à des mois différents comme si elles formaient une seule série. SE Ranking lui-même avertit que les publicités tournent et que le vivier d'annonceurs change vite. Comment la repérer : vérifiez les dates de collecte. Un taux issu d'une journée, ou d'une période de quelques semaines, est une mesure ponctuelle. Comment la corriger : répétez les mêmes requêtes sur plusieurs dates, et comparez les taux seulement pour les mêmes requêtes.
Erreur 4 : déduire une influence de la simple coïncidence
Ce que c'est : conclure que les publicités poussent les réponses vers ou loin de certaines marques parce que les deux apparaissent ensemble. Les publicités apparaissent surtout sur les requêtes commerciales, et ces réponses sont de toute façon différentes. Comment la repérer : toute phrase qui dit que les publicités « augmentent », « réduisent » ou « façonnent » les recommandations, sans contrôle. Comment la corriger : écrivez « apparaît avec », et nommez les facteurs de confusion : type de requête, sujet et offre.
Erreur 5 : citer un chiffre que vous n'avez pas retrouvé
Ce que c'est : répéter un nombre qui apparaît dans plusieurs articles, dont aucun ne renvoie à la page primaire, ou dont l'échantillon ne correspond pas à celui de l'éditeur. Comment la repérer : cherchez le nombre sur la page de l'éditeur. S'il n'y est pas, il n'appartient pas à cette étude. Comment la corriger : ouvrez la page primaire, trouvez la phrase et citez sa formulation. Le chiffre de 38 % de réponses pertinentes mentionné plus haut en est un exemple : nous ne l'avons pas trouvé sur la page de Seer, nous ne l'avons donc pas utilisé.
Que faire cette semaine
Faites un petit test avant de prendre une décision budgétaire. Mesurez le taux de publicités pour vos propres requêtes, relevez vos propres citations, et seulement ensuite décidez si un test payant a du sens pour votre catégorie.
Plan d'une semaine
Écrivez 30 requêtes d'acheteursUtilisez les questions que vos clients posent avant d'acheter, tirées de vraies conversations et d'appels commerciaux.
Lancez-les une fois sur un compte FreeMême marché, même jour, une conversation vierge par requête, avec des captures d'écran.
Notez publicités et citationsRelevez chaque publicité, son annonceur, et si votre domaine est cité dans la réponse organique.
Répétez sur deux autres joursComparez le taux sur les trois séries avant de tirer une conclusion.
DécidezSi les acheteurs de votre catégorie voient des publicités, lancez un petit test payant avec un suivi des conversions. Sinon, investissez dans les citations organiques.
La recherche va continuer d'évoluer à mesure que le déploiement s'élargit. La méthode que vous utilisez pour la lire durera plus longtemps que n'importe quel chiffre isolé, alors gardez l'échantillon, l'unité et la date à côté de chaque nombre que vous citez.
Questions fréquentes
ChatGPT affiche-t-il des publicités ?
Oui. Depuis le 9 février 2026, OpenAI teste des emplacements sponsorisés dans ChatGPT pour les adultes connectés des offres Free et Go. Plus, Pro, Business, Enterprise et Education n'ont aucune publicité, et OpenAI affirme que les publicités n'influencent pas les réponses.
À quelle fréquence les publicités ChatGPT apparaissent-elles dans les réponses ?
Dans l'échantillon de SE Ranking d'août 2026, 25,94 % des requêtes commerciales ont affiché une publicité sur ChatGPT, contre 29,45 % sur le Mode IA de Google. Le taux varie fortement selon le sujet, la santé présentant le plus grand écart, donc ce chiffre ne décrit que cet échantillon.
Les publicités ChatGPT modifient-elles la réponse ?
Aucune étude publique n'a montré qu'elles le font, et aucune ne peut prouver qu'elles ne le font pas. OpenAI affirme que les publicités n'influencent pas les réponses, mais les études externes enregistrent seulement où les publicités apparaissent et qui les voit.
y!
Recevez gratuitement votre plan de contenu pour 30 jours
Nous analysons vos concurrents, votre site et votre visibilité dans les IA pour créer gratuitement un plan de contenu sur mesure.
“J'ai testé Sorank sur un vrai site client et c'est dingue. Il fait tout ce qu'une agence facture 1'500€ par mois. Là, ça part en production sur ce client.”Guillaume Guersanguersanguillaume.com
“Nous sommes une agence Ads et nous voulions remettre notre SEO sur les rails une bonne fois pour toutes. Sorank nous a donné une vue claire de notre site, nous a aidés à prioriser les optimisations et à structurer correctement notre contenu. L'outil est facile à utiliser, bien pensé pour une équipe et très pratique pour centraliser le suivi sans avoir à jongler entre plusieurs plateformes. Une base très solide pour repartir à zéro avec notre SEO.”Gaspard MadouiAgence Publicitaire
Dominiqueflight-sensations-idf.comLoisirs et aviation
“J'ai simplement laissé le logiciel Sorank faire son travail, et aujourd'hui mon DR est de 25 et ma page se positionne mieux.”Lucas Flandrefoundertrace.fr
“Je me suis spécialisée en GEO grâce à Sorank. Le GEO Leaderboard me permet de montrer à mes clients leur positionnement vs leurs concurrents sur ChatGPT. C'est un vrai différenciateur commercial.”MélanieSEO indépendant
“Excellent service, fonctionne bien pour notre site web et nous aide à comprendre comment l'améliorer pour mieux nous positionner sur Google et ailleurs. Félicitations, continuez, je vous le recommande.”Hugo T.Marchand en ligne


 ChatGPT