Innstillinger
Personvern er viktig for oss, så du kan velge å slå av enkelte typer lagring som ikke er nødvendig for at nettstedet skal fungere grunnleggende. Blokkering av kategorier kan påvirke opplevelsen din på nettstedet. Mer informasjon
Personvern er viktig for oss, så du kan velge å slå av enkelte typer lagring som ikke er nødvendig for at nettstedet skal fungere grunnleggende. Blokkering av kategorier kan påvirke opplevelsen din på nettstedet. Mer informasjon

Hva studiene om ChatGPT-annonser måler, hvor de er uenige, og hvordan du leser tallene deres før du endrer annonse- eller merkevarestrategien din.

Kort sagt
ChatGPT-annonser er sponsede plasseringer som OpenAI viser til innloggede voksne på gratisabonnementet Free og Go. Tre studier publisert mellom august og november 2026 måler hvor ofte annonsene vises, om de passer til spørsmålet, og hvem som får dem. Ingen av dem viser om annonser endrer selve svaret, og de fleste utvalgene er små eller korte.
Vil du vite mer? Spør
Rask quiz
Hvordan får du omtale fra ChatGPT og andre AI-assistenter?
Sorank passer til svarene dine


Prøv det i 3 dager på ditt eget nettsted, og se hvor du står på Google, ChatGPT og de andre AI-assistentene.
Start en gratis prøveperiode på 3 dager3 dager gratis, deretter kan du stoppe når du vil. 90 dagers resultatgaranti, vilkår gjelder.
ChatGPT-annonser er merkede sponsede plasseringer som vises ved siden av assistentens svar. De når innloggede voksne på Free- og Go-nivåene, og ingen betalt abonnement ser dem. Alle studiene nedenfor tar utgangspunkt i disse reglene, så du trenger dem før du leser noen tall.
OpenAI publiserte testkunngjøringen sin 9. februar 2026. Siden sier at testen gjelder "logged-in adult users on the Free and Go subscription tiers", mens Plus, Pro, Business, Enterprise og Education ikke har annonser. Annonser er "always clearly labeled as sponsored and visually separated from the organic answer". OpenAI sier også at "ads do not influence the answers ChatGPT gives you", og at annonsører får samlede resultatdata, for eksempel visninger eller klikk, ikke chattene dine eller personopplysninger. OpenAI sin kunngjøring om testing av annonser i ChatGPT er referansen alle oppsummeringene peker på, så les den først.
Planregelen betyr noe for målingen. En studie gjort på en Plus-konto finner null annonser, og det sier ingenting om markedet. Det speiler planen. Vil du ha det bredere bildet av hvordan assistenten bygger svarene sine, start med hvordan ChatGPT fungerer, fra trening til nettsøk og kilder og modellsiden for ChatGPT. For kjøperens side av annonsesystemet dekker vår guide til ChatGPT-annonser og OpenAI Ads Manager oppsett og måling.
Tre studier publisert mellom august og november 2026 er de mest detaljerte offentlige målingene av ChatGPT-annonser vi kunne spore tilbake til utgiverens egen side. De stiller ulike spørsmål, så de gir ikke de samme tallene. Tabellen viser hva hver av dem målte, og hva de ikke dekker.
| Studie | Publisert | Data | Det den målte | Det den ikke dekker |
|---|---|---|---|---|
| SE Ranking | 10. august 2026 | 50006 kommersielle prompter på tvers av 20 amerikanske nisjer, data samlet inn 23. juli 2026 | Annonsefrekvens per prompt, annonsenes relevans for prompten, sammenligning med Google AI Mode | Plus og andre betalte planer, effekten av annonser på svarene, eventuell trend (ett enkelt øyeblikksbilde) |
| Seer Interactive | 12. november 2026 | 161 innspilte AI-søkeøkter fra ni umodererte brukbarhetsstudier, mars til september 2026 | Om ekte brukere så annonser på skjermen, og om de passet til prompten | Et representativt utvalg brukere (bare to av de ni studiene spurte om annonser) |
| Brookings | Tidlig i oktober 2026 | 91 innloggede sokkedukke-kontoer, over 3600 annonser samlet inn, kontoer opprettet januar til mars 2026 | Hvem som får annonser, testet etter inntekt og etter rase eller etnisk tilhørighet | Gruppestørrelse (bare noen få kontoer per kombinasjon) og perioden etter at kontoene sluttet å få flere annonser |
Utvalgene bak studiene
Kilder: SE Ranking, 10. august 2026; Seer Interactive, 12. november 2026; Brookings, oktober 2026
Andre oppsummeringer om emnet kommer fra GEO-verktøy, og vi kunne ikke kontrollere tallene deres mot en primærkilde, så vi har utelatt dem. Siter bare tall du kan spore tilbake til utgiverens egen side, og sjekk utvalgslinjen før du gjentar noen av dem.
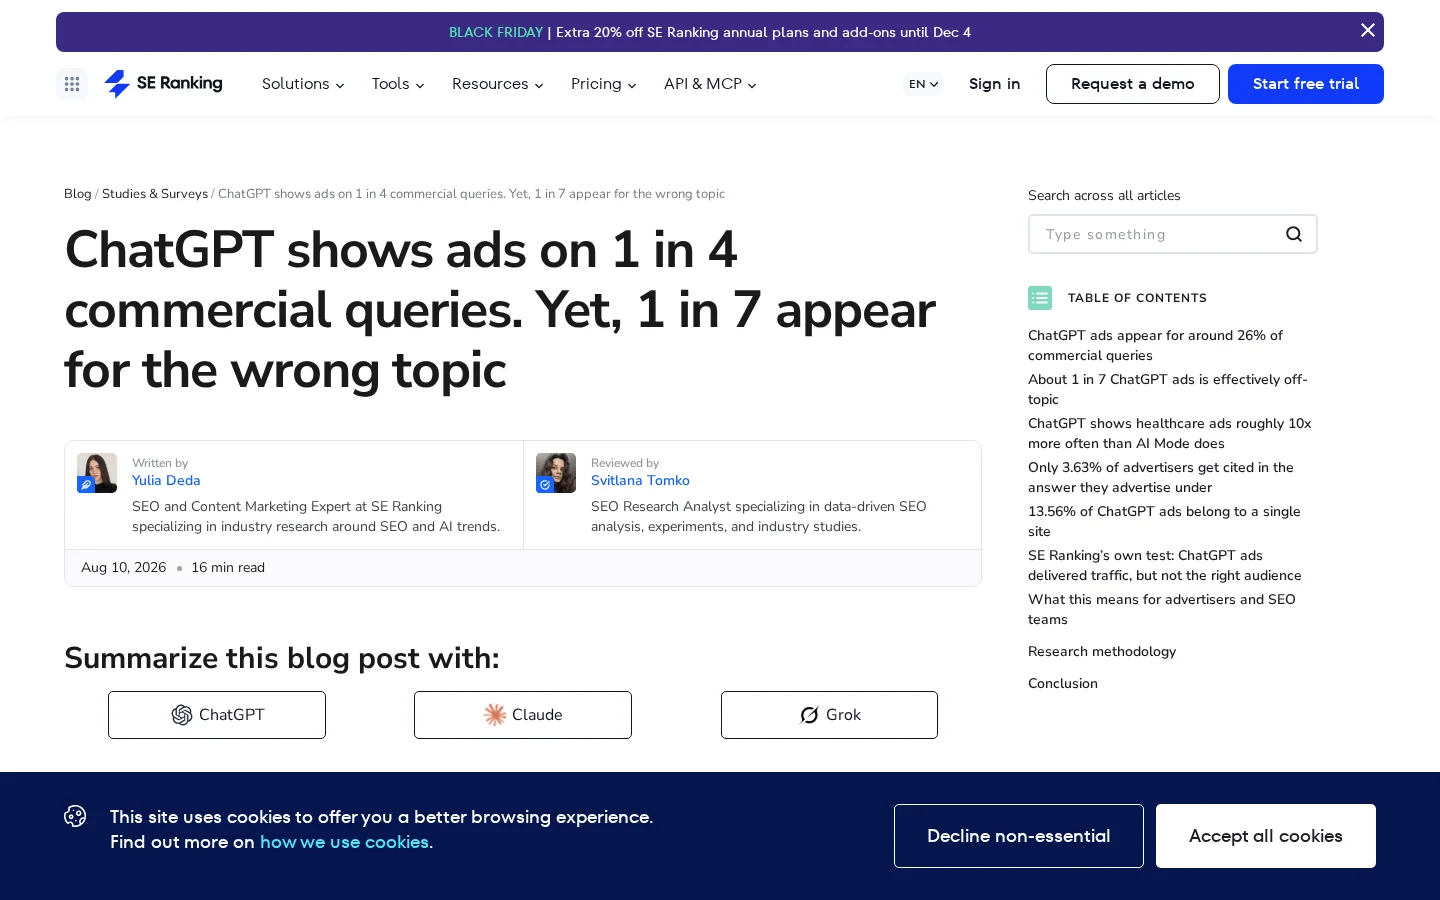
I SE Rankings utvalg fikk 25,94 % av de kommersielle promptene en annonse i ChatGPT, mot 29,45 % i Google AI Mode. Andelen avhenger sterkt av emnet, så ett samlet tall sier lite om hva kjøperne dine faktisk ser.
SE Ranking brukte 50006 kommersielle prompter fra 20 amerikanske nisjer, omtrent 2500 per nisje. For hver prompt registrerte de det genererte svaret, kildene som ble sitert og eventuelle sponsede plasseringer. Totalt ga 12974 prompter en annonse. Promptene kom fra en tidligere AI Mode-studie fra samme utgiver, noe som gjør de to plattformene sammenlignbare. Dataene ble samlet inn 23. juli 2026, og studien ble publisert 10. august 2026 (SE Ranking, ChatGPT ads study, 10. august 2026).
Forskjellen mellom emner er mye større enn forskjellen mellom plattformer. Innen helse fant studien annonser på 28,69 % av ChatGPT-promptene, mot 2,64 % i AI Mode, altså mer enn ti ganger så høyt. Under Nyheter og politikk var tallet 28,76 % i ChatGPT mot 6,8 % i AI Mode. De samlede andelene ser like ut, og det er emnefordelingen som skiller plattformene.
Eksempel
Tenk deg at en kjøper spør ChatGPT hvilket regnskapsprogram som passer en frilanser. Det organiske svaret nevner tre verktøy, og et sponset kort for et fjerde produkt vises ved siden av. Det er situasjonen andelen måler: en annonse i samme svar som den organiske anbefalingen, ikke en annonse som erstattet den. Dette er en illustrasjon, ikke et målt tilfelle.
Seer Interactive valgte en annen vei. Deres artikkel fra 12. november 2026 rapporterer 161 AI-søkeøkter som ble tatt opp mens deltakerne brukte sine egne assistenter og tenkte høyt. I forsikringsstudien hadde 34 av 76 observerbare svar (45 %) en annonse. Tallet gjelder ett område med 16 økter, så det er ikke en andel for ChatGPT generelt.
Seer rapporterer også en trend på brukernivå: andelen ChatGPT-brukere i øktene deres som så en annonse i svaret, økte fra 2 av 22 i mars til 12 av 19 fra juli til september 2026. Dette er personer, ikke svar, så de viser at flere deltakere så en annonse, ikke hvor mange svar som hadde en. Trenden er det mest nyttige signalet i de tre studiene og det minst presise, fordi gruppene varierer fra måned til måned. Svar og annonser endrer seg fra den ene uken til den neste, og derfor er en enkelt måling et øyeblikksbilde, ikke en dom.
Ofte, men ikke alltid. SE Ranking anslår at 14,35 % av annonsevisningene ikke var mer relatert til prompten sin enn en tilfeldig paret annonse. Seer fant at hver annonse i forsikringsstudien deres var relevant for prompten. De to resultatene kommer fra ulike utvalg og ulike tester, så de beskriver ulike ting og motsier ikke hverandre.
SE Rankings test fungerer slik. Den beregner en embedding-basert cosinuslikhet mellom prompten, annonsen og svaret, og sammenligner deretter hvert ekte par av prompt og annonse med tilfeldig blandede par. En annonse regnes som feilrettet bare når likheten faller innenfor intervallet som tilfeldige par gir. Et utvalg av de flaggede tilfellene ble deretter gjennomgått for hånd. Her er logikken i forenklet form:
sim_real   = cos(embed(prompt), embed(ad))
sim_random = cos(embed(prompt), embed(ad_from_another_prompt))   # blandede par
off_target = sim_real faller innenfor intervallet som sim_random gir
Dette er en konservativ test. En annonse må se like lite relatert ut som en tilfeldig annonse for å bli flagget, så svakt relevante annonser som ser noe relatert ut, godkjennes som på emnet. Forfatterne sier at 14,35 % sannsynligvis er et underestimat, fordi manuell gjennomgang fant flere svakt relevante annonser enn testen fanget. Spredningen mellom emner er stor: 2,6 % for Kjæledyr, 51,1 % for Forhold og 54,2 % for Nyheter og politikk.
To mål for relevans og eksponering, fra to studier
Kilder: SE Ranking, 10. august 2026; Seer Interactive, 12. november 2026
Seer tilfører et poeng som betyr noe for merkevarer. I fem av seks kategorier med en merkevareoppgave var det sponsede kortet for et annet selskap enn merkevaren brukeren nevnte. En prompt som nevner selskapet ditt kan altså vise konkurrentens annonse i samme svar. Seers artikkel legger også merke til at annonsørene skifter med spørsmålet, noe som betyr at hvilke annonsører du ser, avhenger av hvordan prompten er formulert.
Brookings-revisjonen fant at kontoer med lavere inntekt var klart mer tilbøyelige til å få annonser, og fant ingen tegn til at rase eller etnisk tilhørighet endret om en konto fikk en. Forfatterne advarer om at utvalget er lite, så rasefunnet, som er et nullfunn, må tolkes forsiktig i begge retninger. Behandle inntektsfunnet som det sterkere.
Designet er verdt å kjenne, fordi det er den eneste av de tre studiene som kontrollerer profilen. Forskerne opprettet 91 innloggede kontoer i tre rase- og etnisitetsgrupper (svarte, latinamerikanske og hvite) og tre inntektstersiler, med minst ni kontoer i hver kombinasjon av rase og inntekt. Siden plattformene ikke viser inntekt eller rase, brukte de geografisk region som stand-in, ved å nå hver konto fra postnummer med disse kjennetegnene. Hver dag fikk kontoene prompter innenfor mange emnekategorier. Noen kategorier var slike der annonser er sannsynlige, som en lasagneoppskrift, og andre var slike der OpenAI hadde sagt at de ikke viser annonser, som psykisk helse. Studien samlet inn over 3600 annonser (Brookings, "Understanding the beginning of advertising on ChatGPT", tidlig i oktober 2026).
Slik ble sokkedukke-revisjonen gjennomført
Inntektsfunnet kommer fra 53 kontoer som fikk minst én annonse. Inntekten deres samlet seg rundt en typisk verdi nær 60000 dollar, mens kontoene som aldri fikk en, toppet seg rundt 80000 dollar. Resultatet er signifikant etter studiens målestokk, men det beskriver et lite utvalg kontoer fra én tidlig periode.
Studien ble også avsluttet tidlig. Omtrent en måned inn sluttet alle kontoene å få flere annonser. Forfatterne sier at OpenAI kan ha oppdaget dem. Det er en advarsel til alle som kopierer metoden: en plattform som oppdager revisjonskontoer, kan endre hva de ser, så dataene de gir, er ikke et nøytralt utvalg. Studien fant ingen tegn til at vernet for sensitive emner sviktet, og forfatterne advarer også mot å lese for mye inn i det.
Ingen offentlig studie har så langt vist at de gjør det, og ingen studie kan ennå bevise at de ikke gjør det. OpenAI sier at annonser ikke påvirker svarene. De tre studiene registrerer hvor annonser vises og hvem som ser dem, ikke om et svar ville sett annerledes ut uten dem.
Eksterne forskere kan ikke skru av annonser for et enkelt svar, så de kan ikke kjøre en ren kontrollgruppe. Det nærmeste de kan komme, er å sammenligne svar på samme prompt på tvers av dager eller kontoer. Den sammenligningen er forurenset: annonser vises hovedsakelig på kommersielle prompter, og kommersielle prompter gir allerede ulike svar, med flere produktlister, sammenligninger og egne kilder. En forskjell i siteringer mellom svar med og uten annonse ville ikke i seg selv vise påvirkning.
En rettferdig test ville holde prompt, plan, sted og dag konstante, registrere siteringene i hvert svar og gjenta testen nok ganger til å se forbi rotasjonen av annonser. Selv da måler du hva assistenten gjorde, ikke hvorfor. Inntil OpenAI publiserer data, eller en uavhengig revisjon tester påstanden, bør du behandle "ads do not influence answers" som selskapets standpunkt. De offentlige studiene bekrefter verken eller motbeviser den.
Hva studiene kan og ikke kan fortelle deg
De tre studiene bruker tre metoder: et fast promptpanel, innspilte brukbarhetsøkter og sokkedukke-kontoer. Hver besvarer ett spørsmål godt og overser de andre, så sammenlign dem etter metode og ikke etter overskriftstallet. OpenAI sin egen uttalelse er en fjerde type belegg, et selskapskrav snarere enn en måling.
Prinsippet: kjør en fast liste med prompter gjennom hver plattform og registrer hvert svar og hver annonse. Når du bruker den: når du trenger andeler på tvers av mange emner og vil sammenligne plattformer. Fordel: skala, og de samme promptene kan kjøres på nytt. Begrensning: promptsettet bestemmer resultatet. SE Ranking advarer selv om at annonsørrangeringer er følsomme for valg av søkeord, at annonser roterer slik at samme prompt ved gjentakelse kan få en annen annonse eller ingen, og at annonsørpoolen endrer seg raskt. Eksempel: gapet innen helse (28,69 % mot 2,64 %) finnes bare fordi de samme helsepromptene ble kjørt på begge plattformene.
Prinsippet: ekte deltakere bruker sine egne AI-verktøy mens de tenker høyt, og skjermen tas opp. Seer samplet hver opptak annethvert sekund med tekstgjenkjenning på enheten for å finne annonseenheter, og sjekket deretter hver enhet for hånd mot det deltakeren sa. Når du bruker den: når du vil vite hva en person faktisk ser på skjermen. Fordel: annonsen var virkelig på skjermen, og deltakerens egne ord er med. Begrensning: 161 økter er ikke et representativt utvalg, og bare to av de ni studiene spurte deltakerne direkte om annonser. I én studie stemte den automatiske skanningen overens med manuell gjennomgang for hver økt og hvert antall annonser, men den underkonterte noen kreative varianter. Seer merker seg også at Gemini, Claude og Grok bare ble skannet i noen studier, så et fravær der betyr "det vi observerte", ikke "finnes ikke".
Prinsippet: kontrollerte kontoer med faste profiler får de samme promptene, så forskjeller kan føres tilbake til profilen. Når du bruker den: når du vil vite hvem som blir målrettet. Fordel: variablene er kontrollert, noe de to andre metodene ikke kan. Begrensning: små grupper, geografi som stand-in for inntekt og rase, og risikoen for å bli oppdaget, som avsluttet denne studien tidlig. Eksempel: de 53 kontoene som fikk en annonse, samlet rundt lavere inntekter, mot dem som aldri fikk noen.
| Metode | Studie | Målt enhet | Beste spørsmål | Største blinde flekk |
|---|---|---|---|---|
| Fast promptpanel | SE Ranking | Prompt og svar | Hvor ofte, og passer den? | Avhenger av promptsettet; et øyeblikksbilde |
| Innspilte økter | Seer Interactive | Økt og bruker | Hva en ekte bruker ser | Lite, ikke representativt, få direkte spørsmål om annonser |
| Sokkedukke-revisjon | Brookings | Konto | Hvem som får annonser | Små grupper, oppdagelse, tidlig slutt |
Tallene avviker av grunner du kan nevne: ulike prompter (bare kommersielle, eller en bredere blanding), ulike enheter (svar, økter, brukere), ulike perioder (én dag i juli, mars til september, januar til mars) og ulike plannivåer. Noen sekundære oppsummeringer tilskriver Seer en andel på 38 % på emnet, av omtrent 55000 svar. Seer-artikkelen vi leste, rapporterer ingen slik fordeling og dekker 161 økter, så vi kunne ikke bekrefte tallet. Ikke siter det før du finner det på utgiverens egen side.
Når dataene ble samlet inn, og når de ble publisert
Kjør en fast liste med 30 til 50 kjøperprompter fra én innlogget Free-konto, samme dag og i samme marked, og registrer hver annonse og hver siterte henvisning til domenet ditt. Annonsefrekvensen er antallet svar som hadde en annonse, delt på alle svar. Gjenta kjøringen på minst tre dager, fordi annonsene roterer.
Før du kjører testen
Advarsel
Ikke opprett et sett med kontoer for å kopiere Brookings-revisjonen. Forfatterne sier at alle kontoene deres sluttet å få flere annonser omtrent en måned inn. Bruk én konto du eier, kjør promptene for hånd, og les OpenAI sine vilkår før du gjør noen automatisert innsamling. En manuell test er tregere, men den holder kontoen trygg og resultatet ærlig.
=ANTALL.HVIS(F2:F51;"ja")/ANTALLV(A2:A51)Tips
Før du bruker penger, sjekk om ChatGPT allerede nevner merkevaren din i organiske svar. Vårt gratis ChatGPT Visibility Checker spør ChatGPT med nettsøk på og viser om domenet ditt siteres som kilde, og om merkevaren din nevnes i svaret.
En annonse kjøper en merket plass ved siden av svaret, ikke en plass inni det. OpenAI sier at annonser ikke påvirker svarene, så siteringen i det organiske svaret kan ikke kjøpes med en kampanje. Studiene viser også at det sponsede kortet ofte kommer fra et annet selskap enn det brukeren spurte om. Planlegg for begge kanalene, og mål dem hver for seg.
Betalt annonse eller organisk sitering
Merkevareprompter trenger ekstra oppmerksomhet. Hvis selskapet ditt er temaet for et spørsmål, må du regne med at annonseplassen går til noen andre. Følg merkevareprompter for annonser på samme måte som du følger merkevaresøk på Google, og sjekk minst én gang i uken annonsen du ser for ditt eget navn under en kampanje.
Test med små budsjetter, og sammenlign kostnaden per kunde med søke- og sosiale kampanjene dine før du flytter penger. Vår forklaring om AI-annonser sammenligner annonser i AI-svar med andre betalte formater, og annonsetekster dekker hvordan du skriver korte annonser som passer samtalen.
For den organiske siden, følg en fast liste med prompter over tid i stedet for å sjekke for hånd. Sorank sin AI Mention Tracking kjører promptene dine i ChatGPT, Claude og Gemini hver måned og viser hvilke svar som nevner merkevaren din, og hvilke kilder de siterer. Hvis du heller vil starte for hånd, forklarer vår guide til en AI-synlighetsrevisjon trinnene, og ordlisteoppføringen om AI-siteringer definerer hva som regnes som en sitering.
De vanligste feilene er å behandle et utvalg som hele markedet, å blande svar med brukere, og å siterer et tall uten enhet eller kilde. Hver av dem er lett å fange når du kjenner spørsmålet du skal stille.
Å lese en studie feil og riktig
Hva det er: en overskrift som sier "ChatGPT viser annonser på X % av svarene" når utvalget er en liste med kommersielle prompter, eller 16 forsikringsøkter. Slik oppdager du det: les utvalgslinjen før resultatet, og sjekk om promptene, nisjene, øktene eller kontoene er beskrevet. Slik retter du det: skriv påstanden om med utvalget sitt, for eksempel "i SE Rankings utvalg på 50006 kommersielle prompter i 20 amerikanske nisjer".
Hva det er: å sette en andel av svar ved siden av en andel av brukere, som om de målte det samme. Seers 45 % er en andel av svar i ett område, og trenden fra 2 av 22 til 12 av 19 er en andel av brukere. Slik oppdager du det: se etter ordene "av svarene", "av øktene", "av brukerne" eller "av kontoene" ved siden av hvert tall. Slik retter du det: skriv enheten ved siden av hvert tall du siterer.
Hva det er: å kalle en enkelt dags andel for en trend, eller å sammenligne to studier gjort i ulike måneder som om de var én serie. SE Ranking advarer selv om at annonser roterer og at annonsørpoolen endrer seg raskt. Slik oppdager du det: sjekk innsamlingsdatoene. En andel fra én dag, eller fra en periode på noen få uker, er en måling. Slik retter du det: gjenta de samme promptene på flere datoer, og sammenlign bare andeler for de samme promptene.
Hva det er: å konkludere at annonser dytter svar mot eller bort fra merkevarer fordi de dukker opp sammen. Annonser vises i hovedsak på kommersielle prompter, og de svarene ser uansett annerledes ut. Slik oppdager du det: enhver setning som sier at annonser "øker", "reduserer" eller "former" anbefalinger uten en kontrollgruppe. Slik retter du det: skriv "forekommer sammen med", og nevn de forstyrrende faktorene: type prompt, emne og plan.
Hva det er: å gjenta et tall som står i flere oppsummeringer, der ingen lenker til primærsiden, eller der utvalget ikke stemmer med utgiverens. Slik oppdager du det: søk etter tallet på utgiverens side. Hvis det ikke står der, hører det ikke til den studien. Slik retter du det: åpne primærsiden, finn setningen, og siter ordlyden. Tallet 38 % om emnet over er et eksempel: vi fant det ikke på Seers side, så vi brukte det ikke.
Gjør en liten test før du tar en budsjettbeslutning. Mål annonsefrekvensen for dine egne prompter, registrer dine egne siteringer, og bestem deretter om en betalt test gir mening for kategorien din.
En plan for én uke
Forskningen vil fortsette å endre seg etter hvert som utrullingen brer seg. Metoden du bruker for å lese den, varer lenger enn ethvert enkelt tall, så behold utvalget, enheten og datoen ved siden av hvert tall du siterer.
Ja. Siden 9. februar 2026 har OpenAI testet sponsede plasseringer i ChatGPT for innloggede voksne på gratisplanene Free og Go. Plus, Pro, Business, Enterprise og Education har ingen annonser, og OpenAI sier at annonser ikke påvirker svarene.
I SE Rankings utvalg fra august 2026 fikk 25,94 % av de kommersielle promptene en annonse i ChatGPT, mot 29,45 % i Google AI Mode. Andelen varierer mye etter emne, og helse har det største gapet, så tallet gjelder bare dette utvalget.
Ingen offentlig studie har vist at de gjør det, og ingen kan bevise at de ikke gjør det. OpenAI sier at annonser ikke påvirker svarene, men eksterne studier registrerer bare hvor annonser vises og hvem som ser dem.
Vi analyserer konkurrentene dine, nettstedet ditt og synligheten din i AI for å lage en skreddersydd innholdsplan, gratis.
 KI-generator for innholdsbrief
 Generator for FAQ-schema
 Generator for blogg-ideer med AI
 Validator for strukturerte data (schema-validator)
 Sjekk av alt-tekst
 Analyse av interne lenker
 Lenkeutfordringen
 KI-generator for metabeskrivelser
 KI-generator for bloggtitler
 Indekserbarhetssjekker for Google
 KI-generator for bloggdisposisjon
 Generator for UTM-lenker
 Verktøy for gruppering av søkeord
 Sjekk av kanonisk tagg
 XML-sitemap-generator
 Sjekk av ødelagte lenker
 KI-generator for SEO-tittel
 Overskriftsanalyse
 SERP-forhåndsvisning
 Kontroll av omdirigeringer
 Generator for hreflang-tagger
 Analyse av overskriftsstruktur
 Kontroll av HTTP-headere
 Favikon-henter
 SERP CTR-kalkulator
 Sparekalkulator: SEO mot betalt søk
 Kalkulator for SEO-synlighetsandel
 ROI-kalkulator for SEO
 SEO-prognosekalkulator for trafikk og inntekter
 SEO-budsjettkalkulator
 SEO-nullpunktkalkulator
 ROI-kalkulator for SaaS-SEO
 ROAS-kalkulator
 Lesetidskalkulator
 Simulator for rangeringsgevinst
 Kalkulator for verdien av organisk trafikk
 Estimator for organisk trafikk og sjekk av nettstedstrafikk
 Kalkulator for LTV til CAC-forhold
 Kalkulator for avkastning på lokal SEO
 Kalkulator for kostnad ved lenkebygging
 Kalkulator for søkeordverdi
 Kalkulator for poengsum for søkeordmuligheter
 Kalkulator for tetthet av søkeord
 Kalkulator for GEO-avkastning
 Kalkulator for investering i GEO-innhold
 Kalkulator for SEO-avkastning i netthandel
 Kalkulator for kundens levetidsverdi
 Kalkulator for kundeanskaffelseskostnad
 CTR-kalkulator
 Kalkulator for kostnad per artikkel
 Kalkulator for konverteringsrate
 Kalkulator for ROI i innholdsmarkedsføring
 Estimator for ChatGPT-trafikk
 Kalkulator for avvisningsrate
 Kalkulator for backlink-ROI
 Kalkulator for AI-synlighetspoeng
 Kalkulator for verdien av AI-trafikk
 Kalkulator for AI-synlighetsandel
 Kalkulator for kostnaden av AI-usynlighet
 Kalkulator for AI-siteringsrate
 llms.txt-validator
 AI Overview-sjekker og rangeringssjekker for AI Overviews
 Robots.txt-sjekker
 KI-SEO-revisjon
 Sjekk av lesbarhet for LLM
 Sjekk av klargjøring for SearchGPT
 Revisjon av strukturerte data for LLM
 KI-revisjon av crawlbarhet
 Hvorfor ChatGPT ikke anbefaler nettstedet mitt
 Gemini-rangeringsverktøy
 Sjekk av rangering i Perplexity
 Sjekk av LLM-sitater
 AEO-revisjon
 GEO-revisjon
 Test av synlighet i AI-søk
 Sjekk av synlighet i ChatGPT
 llms.txt-generator
 URL-uttrekker
 Nettside til Markdown
 Sjekk av sitemap
 Sensor for SERP-volatilitet
 Sidestørrelsessjekk
 Ordteller
 Slug-generator
 Schema-generator
 Robotgenerator
 OG-forhåndsvisning
 Generator for metatagger
 Bildekomprimerer
 Favicon-generator
 Revisjon av on-page SEO: SEO-sjekk og SEO-analyse
 Verktøy for analyse av tilbakelenker
 Verktøy for søkeordforslag
 Sjekk av domeneautoritet
 “Jeg testet Sorank på et ekte kundenettsted, og det er helt utrolig. Det gjør alt et byrå ville tatt deg $1500 i måneden for. Nå går det i produksjon på den kunden.”

 Guillaume Guersanguersanguillaume.com“Vi er et annonsebyrå, og vi ville få SEO-en vår på rett spor en gang for alle. Sorank ga oss en tydelig oversikt over nettstedet vårt, hjalp oss å prioritere optimaliseringene og å strukturere innholdet vårt på riktig måte. Verktøyet er enkelt å bruke, godt utformet for et team, og veldig praktisk for å samle oppfølgingen på ett sted uten å jonglere med flere plattformer. Et veldig solid grunnlag for å starte på nytt med SEO.”
 Gaspard MadouiAnnonsebyrå
 “Jeg lot bare Sorank-programvaren gjøre jobben sin, og nå er DR-en min 25, og siden min rangerer høyere.”
 Lucas Flandrefoundertrace.fr“Jeg spesialiserte meg på GEO takket være Sorank. GEO-rangeringen lar meg vise kundene mine hvor de står mot konkurrentene på ChatGPT. Det er en reell kommersiell fordel.”
 MélanieSEO-frilanser“Kjempebra service, den fungerer godt for nettstedet vårt og hjelper oss å forstå hvordan vi kan forbedre det for å rangere bedre på Google og andre steder. Gratulerer, fortsett slik, jeg anbefaler det.”
 Hugo T.Netthandler