Preferensi
Privasi penting bagi kami, sehingga Anda dapat menonaktifkan jenis penyimpanan tertentu yang tidak diperlukan untuk fungsi dasar situs web. Memblokir kategori tertentu dapat memengaruhi pengalaman Anda di situs web. Informasi lebih lanjut
Privasi penting bagi kami, sehingga Anda dapat menonaktifkan jenis penyimpanan tertentu yang tidak diperlukan untuk fungsi dasar situs web. Memblokir kategori tertentu dapat memengaruhi pengalaman Anda di situs web. Informasi lebih lanjut

 ChatGPT: Apa Kata Penelitian dan Cara Membacanya
Apa yang diukur studi iklan ChatGPT, di mana hasilnya berbeda, dan cara membaca angkanya sebelum Anda mengubah strategi iklan atau merek Anda.

Singkatnya
Iklan ChatGPT adalah penempatan bersponsor yang ditampilkan OpenAI kepada pengguna dewasa yang sudah masuk di paket Free dan Go. Tiga studi yang terbit antara Agustus dan November 2026 mengukur seberapa sering iklan ini muncul, apakah sesuai dengan pertanyaan, dan siapa yang mendapatkannya. Tidak satu pun membuktikan apakah iklan mengubah jawabannya sendiri, dan sebagian besar sampelnya kecil atau singkat.
Ingin tahu lebih banyak? Tanyakan kepada
Kuis singkat
Bagaimana agar disebut oleh ChatGPT dan AI lainnya?
Sorank cocok dengan jawaban Anda


Coba selama 3 hari di situs Anda sendiri dan lihat posisi Anda di Google, ChatGPT, dan AI lainnya.
Mulai uji coba gratis 3 hari3 hari gratis, lalu berhenti kapan saja. Garansi hasil 90 hari, syarat dan ketentuan berlaku.
Iklan ChatGPT adalah penempatan berlabel sponsor yang tampil di samping jawaban asisten. Iklan ini menjangkau pengguna dewasa yang sudah masuk di paket Free dan Go, dan tidak ada paket berbayar yang melihatnya. Setiap studi di bawah ini berangkat dari aturan tersebut, jadi Anda perlu memahaminya sebelum membaca angka apa pun.
OpenAI menerbitkan pengumuman uji cobanya pada 9 Februari 2026. Halamannya menyebut uji coba mencakup "pengguna dewasa yang sudah masuk di paket langganan Free dan Go", sedangkan Plus, Pro, Business, Enterprise, dan Education tidak memiliki iklan. Iklan "selalu diberi label jelas sebagai sponsor dan dipisahkan secara visual dari jawaban organik". OpenAI juga menyatakan bahwa "iklan tidak memengaruhi jawaban yang diberikan ChatGPT kepada Anda", dan pengiklan menerima data kinerja gabungan seperti tayangan atau klik, bukan percakapan atau data pribadi Anda. Pengumuman OpenAI tentang uji coba iklan di ChatGPT adalah rujukan yang dikutip setiap tulisan, jadi baca itu lebih dulu.
Aturan paket penting untuk pengukuran. Studi yang dijalankan pada akun Plus tidak akan menemukan iklan, dan itu tidak berkata apa-apa tentang pasar. Itu mencerminkan paketnya saja. Jika Anda ingin gambaran lebih luas tentang cara asisten menyusun jawaban, mulailah dari cara kerja ChatGPT, dari pelatihan hingga pencarian web dan sitasi dan halaman model ChatGPT. Untuk sisi pembeli dari sistem iklan, panduan kami tentang iklan ChatGPT dan OpenAI Ads Manager membahas pengaturan dan pengukuran.
Tiga studi yang terbit antara Agustus dan November 2026 adalah pengukuran publik paling rinci tentang iklan ChatGPT yang bisa kami telusuri hingga halaman penerbitnya sendiri. Mereka mengajukan pertanyaan yang berbeda, sehingga angkanya tidak sama. Tabel menunjukkan apa yang diukur masing-masing dan apa yang tidak dicakupnya.
| Studi | Terbit | Data | Yang diukur | Yang tidak tercakup |
|---|---|---|---|---|
| SE Ranking | 10 Agustus 2026 | 50006 prompt komersial dari 20 niche di AS, data dikumpulkan 23 Juli 2026 | Tingkat iklan per prompt, relevansi iklan dengan prompt, perbandingan dengan Google AI Mode | Plus dan paket berbayar lainnya, pengaruh iklan terhadap jawaban, tren apa pun (satu potret) |
| Seer Interactive | 12 November 2026 | 161 sesi pencarian AI yang direkam dari sembilan studi kegunaan tanpa moderator, Maret hingga September 2026 | Apakah pengguna nyata melihat iklan di layar, dan apakah iklan itu sesuai dengan prompt | Sampel pengguna yang representatif (hanya dua dari sembilan studi yang bertanya tentang iklan) |
| Brookings | Awal Oktober 2026 | 91 akun sock-puppet yang sudah masuk, lebih dari 3600 iklan dikumpulkan, akun dibuat Januari hingga Maret 2026 | Siapa yang menerima iklan, diuji menurut pendapatan dan menurut ras atau etnis | Ukuran kelompok (hanya beberapa akun per kombinasi), dan periode setelah akun berhenti menerima iklan tambahan |
Sampel di balik studi-studi ini
Sumber: SE Ranking, 10 Agustus 2026; Seer Interactive, 12 November 2026; Brookings, Oktober 2026
Tulisan lain tentang topik ini berasal dari alat GEO, dan kami tidak dapat memeriksa angkanya terhadap sumber primer, jadi kami tidak memasukkannya. Kutip hanya angka yang bisa Anda telusuri ke halaman penerbitnya, dan periksa baris sampelnya sebelum mengulang angka apa pun.
Dalam sampel SE Ranking, 25,94% prompt komersial menghasilkan iklan di ChatGPT, dibandingkan 29,45% di Google AI Mode. Angkanya sangat bergantung pada topik, jadi satu angka keseluruhan hanya sedikit memberi tahu tentang jawaban yang dilihat pembeli Anda.
SE Ranking memakai 50006 prompt komersial dari 20 niche di AS, sekitar 2500 per niche. Untuk setiap prompt, mereka mencatat jawaban yang dihasilkan, sumber yang dikutip, dan penempatan bersponsor jika ada. Secara total, 12974 prompt menghasilkan iklan. Prompt-prompt itu berasal dari studi AI Mode sebelumnya oleh penerbit yang sama, sehingga kedua platform bisa dibandingkan. Data dikumpulkan pada 23 Juli 2026, dan studi diterbitkan pada 10 Agustus 2026 (SE Ranking, studi iklan ChatGPT, 10 Agustus 2026).
Selisih menurut topik jauh lebih besar daripada selisih antarplatform. Di bidang kesehatan, studi menemukan iklan pada 28,69% prompt ChatGPT dibandingkan 2,64% di AI Mode, lebih dari sepuluh kali lipat. Di kategori Berita dan Politik, angkanya 28,76% di ChatGPT dibandingkan 6,8% di AI Mode. Angka keseluruhannya tampak mirip, dan perbedaan antarplatform terletak pada campuran topiknya.
Contoh
Bayangkan seorang pembeli bertanya kepada ChatGPT perangkat lunak akuntansi mana yang cocok untuk freelancer. Jawaban organiknya mencantumkan tiga alat, dan sebuah kartu bersponsor untuk produk keempat muncul di sampingnya. Itulah situasi yang diukur tingkat tersebut: iklan dalam jawaban yang sama dengan rekomendasi organik, bukan iklan yang menggantikannya. Ini ilustrasi, bukan kasus yang diukur.
Seer Interactive menempuh jalan yang berbeda. Artikelnya tanggal 12 November 2026 melaporkan 161 sesi pencarian AI yang direkam saat peserta memakai asisten mereka sendiri sambil berpikir keras. Dalam studi asuransi, 34 dari 76 jawaban yang dapat diamati (45%) memuat iklan. Angka itu mencakup satu vertikal dengan 16 sesi, jadi bukan angka untuk ChatGPT secara umum.
Seer juga melaporkan tren di tingkat pengguna: proporsi pengguna ChatGPT dalam sesinya yang melihat iklan di dalam jawaban naik dari 2 dari 22 pada Maret menjadi 12 dari 19 pada Juli hingga September 2026. Ini adalah orang, bukan jawaban, jadi menunjukkan bahwa lebih banyak peserta melihat iklan, bukan berapa banyak jawaban yang memuatnya. Tren ini adalah sinyal paling berguna dari tiga studi, sekaligus yang paling tidak presisi, karena kelompoknya berbeda dari bulan ke bulan. Jawaban dan iklan berubah dari minggu ke minggu, itulah sebabnya satu pembacaan adalah potret, bukan vonis.
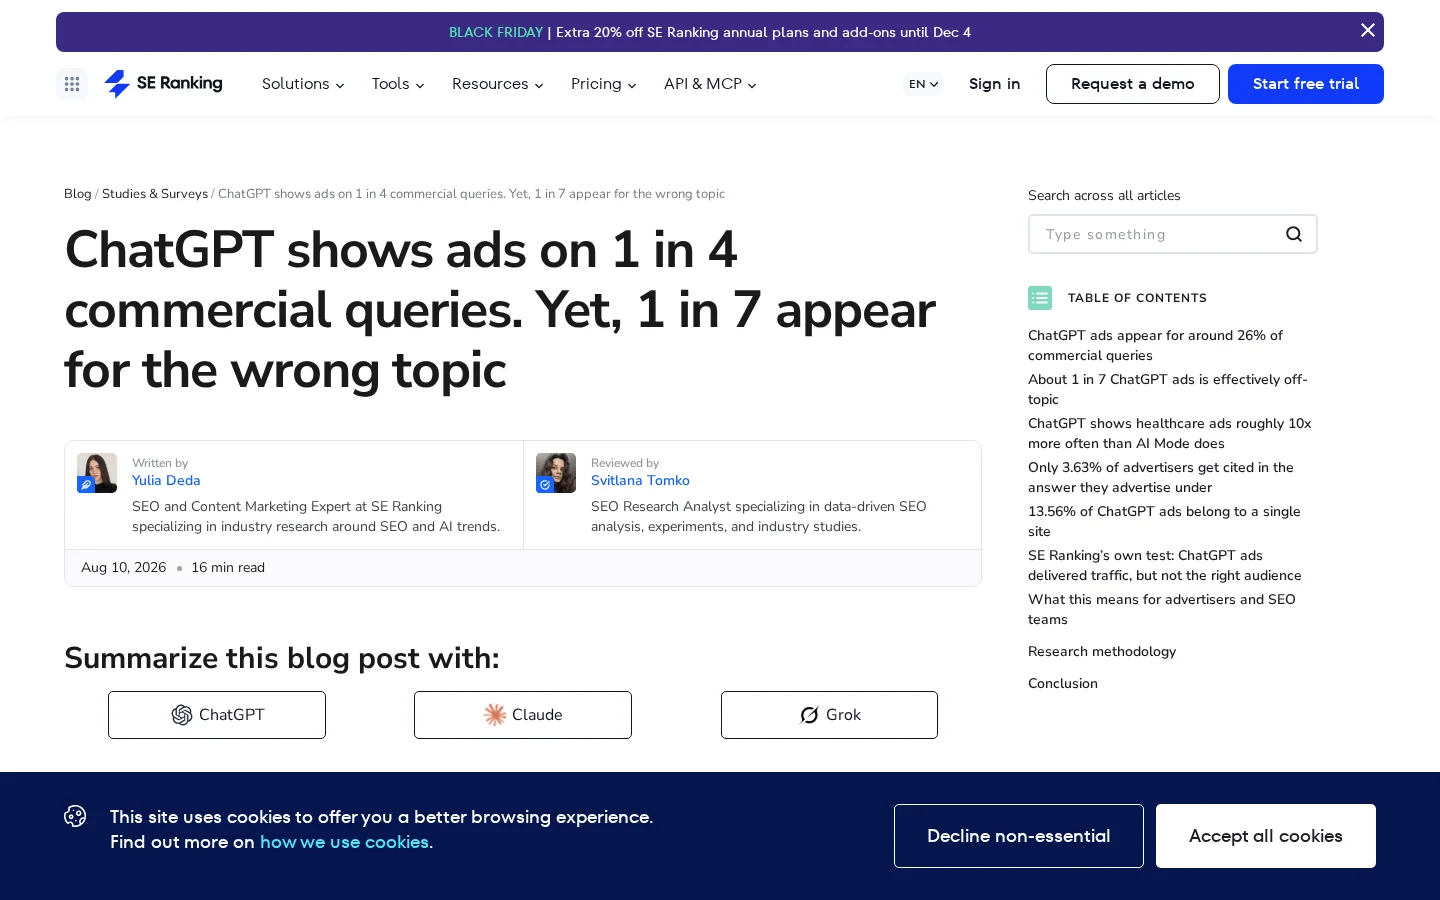
Sering, tetapi tidak selalu. SE Ranking memperkirakan 14,35% tayangan iklan tidak lebih relevan dengan prompt-nya dibandingkan iklan yang dipasangkan secara acak. Seer mendapati bahwa setiap iklan dalam studi asuransinya relevan dengan prompt. Kedua hasil itu berasal dari sampel dan pengujian yang berbeda, jadi keduanya menggambarkan hal yang berbeda, bukan saling bertentangan.
Pengujian SE Ranking bekerja seperti ini: menghitung kemiripan kosinus berbasis embedding antara prompt, iklan, dan jawaban, lalu membandingkan setiap pasangan prompt dan iklan yang sebenarnya dengan pasangan yang diacak. Iklan dihitung sebagai tidak sesuai hanya jika kemiripannya berada dalam rentang yang dihasilkan pasangan acak. Sampel kasus yang ditandai kemudian ditinjau secara manual. Berikut versi sederhana dari logikanya:
sim_real   = cos(embed(prompt), embed(ad))
sim_random = cos(embed(prompt), embed(ad_from_another_prompt))   # pasangan acak
off_target = sim_real berada dalam rentang yang dihasilkan sim_random
Ini adalah pengujian yang konservatif. Sebuah iklan harus tampak tidak lebih terkait daripada iklan acak agar ditandai, jadi iklan yang kurang relevan tetapi tampak agak terkait lolos sebagai relevan. Para penulis mengatakan 14,35% kemungkinan merupakan angka yang terlalu rendah, karena tinjauan manual menemukan lebih banyak iklan yang kurang relevan daripada yang berhasil ditangkap pengujian. Sebarannya antartopik lebar: 2,6% untuk Hewan Peliharaan, 51,1% untuk Hubungan, dan 54,2% untuk Berita dan Politik.
Dua ukuran relevansi dan paparan dari dua studi
Sumber: SE Ranking, 10 Agustus 2026; Seer Interactive, 12 November 2026
Seer menambahkan satu poin yang penting bagi merek. Dalam lima dari enam vertikal dengan tugas bermerek, kartu bersponsor berasal dari perusahaan yang berbeda dengan merek yang disebut pengguna. Jadi prompt yang menyebut nama perusahaan Anda bisa menampilkan iklan pesaing Anda dalam jawaban yang sama. Artikel Seer juga mencatat bahwa pengiklan berubah mengikuti pertanyaannya, yang berarti pengiklan yang Anda lihat bergantung pada cara prompt disusun.
Audit Brookings menemukan bahwa akun berpendapatan lebih rendah secara signifikan lebih mungkin menerima iklan, dan tidak menemukan bukti bahwa ras atau etnis mengubah apakah sebuah akun mendapat iklan. Para penulis memperingatkan bahwa sampelnya kecil, jadi hasil ras, yang merupakan temuan nol, perlu dibaca dengan hati-hati ke kedua arah. Anggap hasil pendapatan sebagai yang lebih kuat.
Desainnya layak dipahami, karena ini satu-satunya dari tiga studi yang mengendalikan profil. Para peneliti membuat 91 akun yang sudah masuk di tiga kelompok ras dan etnis (Kulit Hitam, Hispanik, dan kulit putih) serta tiga tersil pendapatan, dengan setidaknya sembilan akun di setiap kombinasi ras dan pendapatan. Karena platform tidak menampilkan pendapatan atau ras, mereka memakai wilayah geografis sebagai proksi, dengan mengakses setiap akun dari kode pos yang memiliki karakteristik tersebut. Setiap hari akun diberi prompt di banyak kategori topik. Sebagian kategorinya adalah yang kemungkinan menampilkan iklan, seperti resep lasagna, dan sebagian adalah yang menurut OpenAI tidak akan menampilkan iklan, seperti kesehatan mental. Studi ini mengumpulkan lebih dari 3600 iklan (Brookings, "Understanding the beginning of advertising on ChatGPT", awal Oktober 2026).
Cara audit sock-puppet dijalankan
Temuan pendapatan berasal dari 53 akun yang menerima setidaknya satu iklan. Pendapatan mereka berkumpul di sekitar modus dekat 60000 dolar AS, sementara akun yang tidak pernah menerima iklan memuncak dekat 80000 dolar AS. Hasilnya signifikan menurut ukuran studi, tetapi ini menggambarkan sekumpulan kecil akun dari satu periode awal.
Studi ini juga berakhir lebih awal. Sekitar sebulan kemudian, setiap akun berhenti ditampilkan iklan tambahan. Para penulis mengatakan OpenAI mungkin telah mendeteksi mereka. Ini peringatan bagi siapa pun yang menyalin metodenya: platform yang mengenali akun audit dapat mengubah apa yang dilihat akun tersebut, sehingga datanya bukan sampel yang netral. Studi ini tidak menemukan bukti bahwa perlindungan pada topik sensitif gagal, dan para penulis juga memperingatkan agar tidak menafsirkan hal itu terlalu jauh.
Belum ada studi publik yang menunjukkan bahwa iklan mengubahnya, dan belum ada studi yang dapat membuktikan bahwa iklan tidak mengubahnya. OpenAI mengatakan iklan tidak memengaruhi jawaban. Ketiga studi mencatat di mana iklan muncul dan siapa yang melihatnya, bukan apakah jawabannya akan berbeda tanpa iklan.
Peneliti dari luar tidak dapat mematikan iklan untuk satu jawaban, jadi mereka tidak bisa menjalankan kontrol yang bersih. Hal terdekat yang bisa mereka lakukan adalah membandingkan jawaban untuk prompt yang sama dari hari atau akun yang berbeda. Perbandingan itu bias. Iklan muncul terutama pada prompt komersial, dan prompt komersial sudah menghasilkan jawaban yang berbeda, dengan lebih banyak daftar produk, perbandingan, dan sumber sendiri. Perbedaan sitasi antara jawaban dengan iklan dan tanpa iklan saja tidak akan menunjukkan pengaruh.
Pengujian yang adil akan menjaga prompt, paket, lokasi, dan harinya tetap, lalu mencatat sitasi setiap jawaban dan mengulanginya cukup banyak kali untuk melewati rotasi iklan. Bahkan dengan begitu, Anda hanya mengukur apa yang dilakukan asisten, bukan mengapa. Sampai OpenAI menerbitkan data atau audit independen menguji klaimnya, perlakukan "iklan tidak memengaruhi jawaban" sebagai posisi perusahaan. Studi publik tidak membenarkan maupun membantahnya.
Apa yang bisa dan tidak bisa diberitahukan studi-studi ini
Ketiga studi memakai tiga metode: panel prompt tetap, sesi kegunaan yang direkam, dan akun sock-puppet. Masing-masing menjawab satu pertanyaan dengan baik dan melewatkan yang lain, jadi bandingkan berdasarkan metodenya, bukan judul beritanya. Pernyataan OpenAI sendiri adalah jenis bukti keempat, klaim perusahaan, bukan pengukuran.
Prinsipnya: jalankan daftar prompt tetap melalui setiap platform dan catat setiap jawaban dan setiap iklan. Kapan dipakai: saat Anda membutuhkan tingkat di banyak topik dan ingin membandingkan platform. Keunggulan: skala, dan prompt yang sama bisa dijalankan ulang. Batasan: kumpulan prompt menentukan hasilnya. SE Ranking sendiri memperingatkan bahwa peringkat pengiklan sensitif terhadap pilihan kata kunci, bahwa iklan berputar sehingga prompt yang sama bisa mendapat iklan berbeda atau tidak sama sekali saat diulang, dan bahwa kumpulan pengiklan berubah dengan cepat. Contoh: selisih kesehatan (28,69% lawan 2,64%) hanya muncul karena prompt kesehatan yang sama dijalankan di kedua platform.
Prinsipnya: peserta nyata memakai alat AI mereka sendiri sambil berpikir keras, dan layarnya direkam. Seer memindai setiap rekaman setiap dua detik dengan pengenalan teks di perangkat untuk menemukan unit iklan, lalu memeriksa setiap unit dengan mata terhadap apa yang dikatakan peserta. Kapan dipakai: saat Anda ingin tahu apa yang benar-benar dilihat seseorang di layar. Keunggulan: iklannya benar-benar ada di layar, dan kata-kata peserta tercatat. Batasan: 161 sesi bukan sampel yang representatif, dan hanya dua dari sembilan studi yang menanyakan peserta tentang iklan secara langsung. Dalam satu studi, pemindaian otomatis cocok dengan tinjauan manual di setiap sesi dan jumlah iklan, tetapi kurang menghitung beberapa variasi kreatif. Seer juga mencatat bahwa Gemini, Claude, dan Grok hanya dipindai dalam sebagian studi, jadi ketiadaan di sana berarti "yang kami amati", bukan "tidak ada".
Prinsipnya: akun terkontrol dengan profil yang ditetapkan menerima prompt yang sama, sehingga perbedaan dapat dilacak ke profilnya. Kapan dipakai: saat Anda ingin tahu siapa yang menjadi sasaran. Keunggulan: variabelnya terkontrol, yang tidak bisa dilakukan dua metode lainnya. Batasan: kelompok kecil, geografi sebagai pengganti pendapatan dan ras, serta risiko deteksi yang mengakhiri studi ini lebih awal. Contoh: 53 akun yang menerima iklan, berkumpul di pendapatan yang lebih rendah, dibandingkan dengan akun yang tidak pernah menerimanya.
| Metode | Studi | Unit yang diukur | Pertanyaan terbaik | Titik buta utama |
|---|---|---|---|---|
| Panel prompt tetap | SE Ranking | Prompt dan jawaban | Seberapa sering, dan apakah sesuai? | Bergantung pada kumpulan prompt; sebuah potret |
| Sesi yang direkam | Seer Interactive | Sesi dan pengguna | Apa yang dilihat pengguna nyata | Kecil, tidak representatif, sedikit pertanyaan langsung tentang iklan |
| Audit sock-puppet | Brookings | Akun | Siapa yang menerima iklan | Kelompok kecil, deteksi, berakhir lebih awal |
Angkanya berbeda karena alasan yang bisa Anda sebutkan: prompt yang berbeda (hanya komersial atau campuran yang lebih luas), unit yang berbeda (jawaban, sesi, pengguna), periode yang berbeda (satu hari di Juli, Maret hingga September, Januari hingga Maret), dan tingkat paket yang berbeda. Beberapa ringkasan sekunder menyebut Seer memiliki proporsi sesuai topik sebesar 38% dari sekitar 55000 jawaban. Artikel Seer yang kami baca tidak melaporkan pembagian seperti itu dan mencakup 161 sesi, jadi kami tidak bisa mengonfirmasi angkanya. Jangan kutip sampai Anda menemukannya di halaman penerbitnya.
Kapan data dikumpulkan dan kapan diterbitkan
Jalankan daftar tetap berisi 30 hingga 50 prompt pembeli dari satu akun Free yang sudah masuk, pada hari yang sama dan di pasar yang sama, lalu catat setiap iklan dan setiap sitasi domain Anda. Tingkat iklan adalah jumlah jawaban yang memuat iklan dibagi seluruh jawaban. Ulangi setidaknya tiga hari, karena iklan berputar.
Sebelum menjalankan tes
Peringatan
Jangan membuat sekumpulan akun untuk menyalin audit Brookings. Para penulis mengatakan bahwa sekitar sebulan kemudian, semua akun mereka berhenti ditampilkan iklan tambahan. Gunakan satu akun milik Anda, jalankan prompt secara manual, dan baca ketentuan OpenAI sebelum pengumpulan otomatis apa pun. Tes manual lebih lambat, tetapi menjaga akun tetap aman dan hasilnya jujur.
=COUNTIF(F2:F51,"yes")/COUNTA(A2:A51)Tips
Sebelum mengeluarkan biaya, periksa apakah ChatGPT sudah menyebut merek Anda dalam jawaban organik. Pemeriksa Visibilitas ChatGPT gratis kami bertanya kepada ChatGPT dengan pencarian web aktif, lalu melaporkan apakah domain Anda dikutip sebagai sumber dan apakah merek Anda disebut dalam jawaban.
Iklan membeli slot berlabel di samping jawaban, bukan tempat di dalam jawaban. OpenAI mengatakan iklan tidak memengaruhi jawaban, jadi sitasi dalam jawaban organik tidak bisa dibeli dengan kampanye. Studi-studi ini juga menunjukkan bahwa kartu bersponsor sering berasal dari perusahaan yang berbeda dari yang ditanyakan pengguna. Rencanakan kedua kanal dan ukur keduanya secara terpisah.
Iklan berbayar atau sitasi organik
Prompt bermerek butuh perhatian ekstra. Jika perusahaan Anda menjadi topik pertanyaan, bersiaplah bahwa slot iklan akan jatuh ke pihak lain. Pantau prompt bermerek untuk iklan seperti Anda memantau pencarian bermerek di Google, dan periksa iklan yang muncul untuk nama Anda sendiri setidaknya seminggu sekali selama kampanye.
Uji anggaran kecil dan bandingkan biaya akuisisi dengan kampanye pencarian dan media sosial Anda sebelum memindahkan uang. Penjelasan iklan AI kami membandingkan iklan di dalam jawaban AI dengan format berbayar lainnya, dan copywriting iklan menjelaskan cara menulis iklan singkat yang sesuai dengan percakapan.
Untuk sisi organik, pantau daftar prompt tetap dari waktu ke waktu, alih-alih memeriksanya secara manual. AI Mention Tracking dari Sorank menjalankan prompt Anda di ChatGPT, Claude, dan Gemini setiap bulan, dan menunjukkan jawaban mana yang menyebut merek Anda serta sumber mana yang dikutip. Jika Anda lebih suka mencoba manual dulu, panduan kami tentang audit visibilitas AI menjelaskan langkahnya, dan entri glosarium tentang sitasi AI mendefinisikan apa yang dihitung sebagai sitasi.
Kesalahan yang paling umum adalah menganggap sampel sebagai seluruh pasar, mencampuradukkan jawaban dengan pengguna, dan mengutip angka tanpa satuan atau sumbernya. Setiap kesalahan mudah dikenali setelah Anda tahu pertanyaan yang harus diajukan.
Membaca studi dengan cara yang salah dan benar
Apa itu: judul yang menyatakan "ChatGPT menampilkan iklan pada X% jawaban" padahal sampelnya adalah daftar prompt komersial, atau 16 sesi asuransi. Cara mengenalinya: baca baris sampel sebelum hasilnya, dan periksa apakah prompt, niche, sesi, atau akunnya dijelaskan. Cara memperbaikinya: tulis ulang klaimnya bersama sampelnya, misalnya "dalam sampel SE Ranking berisi 50006 prompt komersial dari 20 niche di AS".
Apa itu: menaruh proporsi jawaban di sebelah proporsi pengguna seolah keduanya mengukur hal yang sama. Angka 45% dari Seer adalah proporsi jawaban dalam satu vertikal, dan tren dari 2 dari 22 ke 12 dari 19 adalah proporsi pengguna. Cara mengenalinya: cari kata "dari jawaban", "dari sesi", "dari pengguna", atau "dari akun" di sebelah setiap angka. Cara memperbaikinya: tulis unitnya di sebelah setiap angka yang Anda kutip.
Apa itu: menyebut tingkat satu hari sebagai tren, atau membandingkan dua studi dari bulan berbeda seolah itu satu seri. SE Ranking sendiri memperingatkan bahwa iklan berputar dan kumpulan pengiklan berubah dengan cepat. Cara mengenalinya: periksa tanggal pengumpulan data. Tingkat dari satu hari, atau dari periode beberapa minggu, adalah sebuah pembacaan. Cara memperbaikinya: ulangi prompt yang sama pada beberapa tanggal, dan bandingkan tingkatnya hanya untuk prompt yang sama.
Apa itu: menyimpulkan bahwa iklan mendorong jawaban ke arah merek atau menjauhinya karena keduanya muncul bersamaan. Iklan muncul terutama pada prompt komersial, dan jawaban-jawaban itu memang sudah tampak berbeda. Cara mengenalinya: kalimat apa pun yang mengatakan iklan "meningkatkan", "menurunkan", atau "membentuk" rekomendasi, tanpa kontrol. Cara memperbaikinya: tulis "muncul bersamaan dengan", dan sebutkan faktor pengganggunya: jenis prompt, topik, dan paket.
Apa itu: mengulang angka yang muncul di beberapa tulisan, tanpa satu pun menautkan halaman primernya, atau sampelnya tidak cocok dengan milik penerbit. Cara mengenalinya: cari angkanya di halaman penerbit. Jika tidak ada di sana, itu bukan milik studi tersebut. Cara memperbaikinya: buka halaman primernya, temukan kalimatnya, dan kutip sesuai kata-katanya. Angka 38% kesesuaian topik di atas adalah contohnya: kami tidak menemukannya di halaman Seer, jadi kami tidak memakainya.
Jalankan tes kecil sebelum Anda membuat keputusan anggaran. Ukur tingkat iklan untuk prompt Anda sendiri, catat sitasi Anda sendiri, dan baru setelah itu putuskan apakah uji coba berbayar masuk akal untuk kategori Anda.
Rencana satu minggu
Riset ini akan terus berubah seiring meluasnya peluncuran. Metode yang Anda gunakan untuk membacanya akan bertahan lebih lama daripada angka tunggal mana pun, jadi simpan sampel, unit, dan tanggal di sebelah setiap angka yang Anda kutip.
Ya. Sejak 9 Februari 2026, OpenAI menguji penempatan bersponsor di ChatGPT untuk pengguna dewasa yang sudah masuk di paket Free dan Go. Plus, Pro, Business, Enterprise, dan Education tidak memiliki iklan, dan OpenAI menyatakan iklan tidak memengaruhi jawaban.
Dalam sampel SE Ranking Agustus 2026, 25,94% prompt komersial menghasilkan iklan di ChatGPT, dibandingkan 29,45% di Google AI Mode. Tingkatnya sangat bervariasi menurut topik, dengan kesehatan menunjukkan selisih terbesar, jadi angkanya hanya menggambarkan sampel tersebut.
Belum ada studi publik yang menunjukkannya, dan tidak ada yang bisa membuktikan bahwa iklan tidak mengubahnya. OpenAI menyatakan iklan tidak memengaruhi jawaban, tetapi studi dari luar hanya mencatat di mana iklan muncul dan siapa yang melihatnya.
Kami menganalisis pesaing, website, dan visibilitas AI Anda untuk membuat rencana konten yang disesuaikan secara gratis.
 Generator Brief Konten AI
 Generator FAQ Schema
 Generator Ide Artikel Blog AI
 Validator Data Terstruktur (Validator Schema)
 Pemeriksa Teks Alt
 Penganalisis Tautan Internal
 Tantangan Backlink
 Generator Meta Description AI
 Generator Judul Blog AI
 Pemeriksa Indexability Google
 Generator Kerangka Blog AI
 Pembuat Tautan UTM
 Alat Pengelompokan Kata Kunci
 Pemeriksa Tag Canonical
 Generator Sitemap XML
 Pemeriksa Tautan Rusak
 Generator Judul SEO AI
 Penganalisis Headline
 Alat Pratinjau SERP
 Pemeriksa Pengalihan
 Generator Tag Hreflang
 Penganalisis Struktur Heading
 Pemeriksa HTTP Header
 Ekstraktor Favicon
 Kalkulator CTR SERP
 Kalkulator Penghematan SEO vs Pencarian Berbayar
 Kalkulator Share of Voice SEO
 Kalkulator ROI SEO
 Kalkulator Prakiraan Trafik dan Pendapatan SEO
 Kalkulator Anggaran SEO
 Kalkulator Titik Impas SEO
 Kalkulator ROI SEO untuk SaaS
 Kalkulator ROAS
 Kalkulator Waktu Baca
 Simulator Kenaikan Peringkat
 Kalkulator Nilai Trafik Organik
 Estimator Trafik Organik dan Pengecek Trafik Website
 Kalkulator Rasio LTV terhadap CAC
 Kalkulator ROI SEO Lokal
 Kalkulator Biaya Link Building
 Kalkulator Nilai Kata Kunci
 Kalkulator Skor Peluang Kata Kunci
 Kalkulator Kepadatan Kata Kunci
 Kalkulator ROI GEO
 Kalkulator Investasi Konten GEO
 Kalkulator ROI SEO E-commerce
 Kalkulator Nilai Seumur Hidup Pelanggan
 Kalkulator Biaya Akuisisi Pelanggan
 Kalkulator CTR
 Kalkulator Biaya per Artikel
 Kalkulator Tingkat Konversi
 Kalkulator ROI Content Marketing
 Estimator Trafik Rujukan ChatGPT
 Kalkulator Bounce Rate
 Kalkulator ROI Backlink
 Kalkulator Skor Visibilitas AI
 Kalkulator Nilai Trafik AI
 Kalkulator Pangsa Suara AI
 Kalkulator Biaya Ketidakterlihatan di AI
 Kalkulator Tingkat Sitasi AI
 Validator llms.txt
 Pengecek AI Overview dan Pengecek Peringkat AI Overviews
 Pengecek Robots.txt
 Audit SEO AI
 Pengecek Keterbacaan LLM
 Pengecek Kesiapan SearchGPT
 Audit LLM untuk Data Terstruktur
 Audit Crawlability Situs untuk AI
 Mengapa ChatGPT Tidak Merekomendasikan Situs Web Saya
 Alat Peringkat Gemini
 Pengecek Peringkat Perplexity
 Pengecek Sitasi LLM
 Audit Answer Engine Optimization
 Audit GEO
 Tes Visibilitas Pencarian AI
 Pengecek Visibilitas ChatGPT
 Generator llms.txt
 Pengekstrak URL
 Halaman Web ke Markdown
 Pemeriksa Sitemap
 Sensor Volatilitas SERP
 Pemeriksa Ukuran Halaman
 Penghitung Kata
 Generator Slug
 Generator Schema
 Generator Robots
 Pratinjau OG
 Generator Meta Tag
 Kompresor Gambar
 Generator Favicon
 Audit SEO On-Page: SEO Checker dan SEO Analyzer
 Alat Analisis Backlink
 Alat Riset Kata Kunci
 Pengecek Domain Authority
 “Saya menguji Sorank pada situs klien sungguhan dan hasilnya luar biasa. Sorank mengerjakan semua yang akan ditagihkan agensi kepada Anda sebesar $1500 per bulan. Kini Sorank mulai dipakai secara produksi untuk klien tersebut.”

 Guillaume Guersanguersanguillaume.com“Kami adalah agensi iklan dan kami ingin SEO kami kembali ke jalur yang benar untuk selamanya. Sorank memberi kami gambaran yang jelas tentang situs kami, membantu kami memprioritaskan optimasi, dan menyusun konten kami dengan benar. Alatnya mudah digunakan, dirancang dengan baik untuk tim, dan sangat praktis untuk memusatkan pemantauan tanpa harus berpindah-pindah banyak platform. Fondasi yang sangat kokoh untuk memulai SEO kami dari awal.”
 Gaspard MadouiAgensi Iklan
 “Saya hanya membiarkan software Sorank bekerja, dan kini DR saya mencapai 25 dan halaman saya berada di peringkat yang lebih tinggi.”
 Lucas Flandrefoundertrace.fr“Saya berspesialisasi di GEO berkat Sorank. Papan Peringkat GEO memungkinkan saya menunjukkan kepada klien posisi mereka dibandingkan pesaing di ChatGPT. Ini benar-benar pembeda secara komersial.”
 MélanieFreelancer SEO“Layanan yang bagus, berjalan baik untuk website kami dan membantu kami memahami cara memperbaikinya agar peringkat lebih baik di Google dan platform lain. Selamat, teruskan, saya merekomendasikannya.”
 Hugo T.Pemilik toko e-commerce