La privacy è importante per noi, quindi hai la possibilità di disabilitare alcuni tipi di archiviazione che potrebbero non essere necessari per il funzionamento di base del sito web. Il blocco delle categorie può influire sulla tua esperienza sul sito web. Ulteriori informazioni (Politica sui cookie)
Copertina dell’articolo «SEO per editori», con uno screenshot del software Sorank accanto al titolo
Strumenti
In questa pagina
In breve
La SEO per editori è l'insieme delle pratiche che aiutano siti di notizie e media a ottenere traffico dalla ricerca Google, da Top Stories, Google News, Discover e, ormai, dagli assistenti IA. Si basa su quattro pilastri: indicizzazione rapida degli articoli freschi (sitemap di notizie, URL puliti, link interni), segnali di fiducia (firme, date, correzioni, pagine degli autori), markup tecnico (Article, requisiti per paywall e immagini) e una politica deliberata verso i crawler IA e le licenze. I contenuti evergreen e i canali di audience diretta proteggono il business quando calano i visitatori dai motori di ricerca.
3 giorni gratis, poi smetti quando vuoi. Garanzia risultati o rimborsati di 90 giorni.
La SEO per editori si distingue dalla SEO classica perché un sito di notizie pubblica decine o centinaia di pagine al giorno, la maggior parte delle quali perde valore in 48 ore, mentre il suo archivio evergreen continua a portare visite per anni. La posta in gioco è cresciuta: il rapporto Journalism, Media and Technology Trends and Predictions 2026 del Reuters Institute (gennaio 2026) cita dati di Chartbeat secondo cui il traffico di ricerca Google verso più di 2500 siti di notizie è calato del 33% su base annua tra novembre 2024 e novembre 2025. I 280 dirigenti dei media intervistati prevedono un ulteriore calo del 43% delle referenze dai motori di ricerca in tre anni. Ottimizzare bene oggi significa conservare il traffico che resta ed essere citati dove i lettori vanno dopo. Questa guida copre cosa cambia per le aziende editoriali e dei media, dalle superfici di notizie alle risposte IA.
Cos'è la SEO per editori e in cosa differisce?
La SEO per editori applica l'ottimizzazione per i motori di ricerca a siti il cui prodotto è il contenuto editoriale: quotidiani, riviste, media nati sul digitale, pubblicazioni di settore e grandi blog che vivono di pubblicità o abbonamenti. Tre vincoli la distinguono.
Velocità: una notizia dell'ultimo minuto vale di più nelle prime ore. Google deve scoprirla, scansionarla e indicizzarla in pochi minuti, quindi percorsi di scansione e sitemap contano più che su un sito vetrina.
Volume: migliaia di articoli, pagine di tag, pagine di autore e archivi creano pagine duplicate o sottili che sprecano il crawl budget e causano keyword cannibalization tra più articoli sullo stesso fatto.
Fiducia: attualità e temi di interesse pubblico sono ambiti in cui Google pesa molto l'affidabilità. Autori visibili, fonti chiare e correzioni sostengono l'E-E-A-T (esperienza, competenza, autorevolezza e affidabilità).
Un editore dipende anche da superfici che la maggior parte dei siti non vede mai: i caroselli di Top Stories, la scheda Notizie, l'app Google News e Discover, un feed che propone contenuti agli utenti senza alcuna ricerca.
Quali superfici Google contano per gli editori?
Ogni superficie ha una sua logica di selezione. La tabella riassume cosa genera visibilità e dove misurarla.
Superficie
Come entra un contenuto
Leve principali
Dove misurare
Risultati di ricerca (link blu)
Scansione e ranking standard
Pertinenza, profondità, link, esperienza della pagina
Search Console, tipo di ricerca: Web
Top Stories
Automatico, per query con intento di attualità
Freschezza, autorevolezza sul tema, reportage originale
Search Console, filtri per aspetto della ricerca
App Google News e scheda Notizie
Automatico, nel rispetto delle politiche di contenuto di Google News
Trasparenza, date, firme, conformità alle politiche
Search Console, rapporto Google News
Discover
Automatico, in base agli interessi dell'utente
Immagini grandi, titoli onesti, storie tempestive o uniche
Search Console, rapporto Discover
Panoramiche IA e assistenti IA
Recupero da pagine indicizzate o scansionate
Fatti chiari, risposte strutturate, accesso dei crawler, autorevolezza del marchio
Monitoraggio dei prompt, analytics dei referral
Google indica nel suo centro assistenza per editori che non esiste un modulo di candidatura: i siti trovati con la scansione normale sono considerati automaticamente per Top Stories e per la scheda Notizie se producono contenuti di qualità e rispettano le politiche di contenuto di Google News. Il Publisher Center resta utile per gestire il nome della testata, il logo e le sezioni nell'app Google News.
Come far indicizzare gli articoli in fretta?
1. Pubblicare una sitemap di notizie
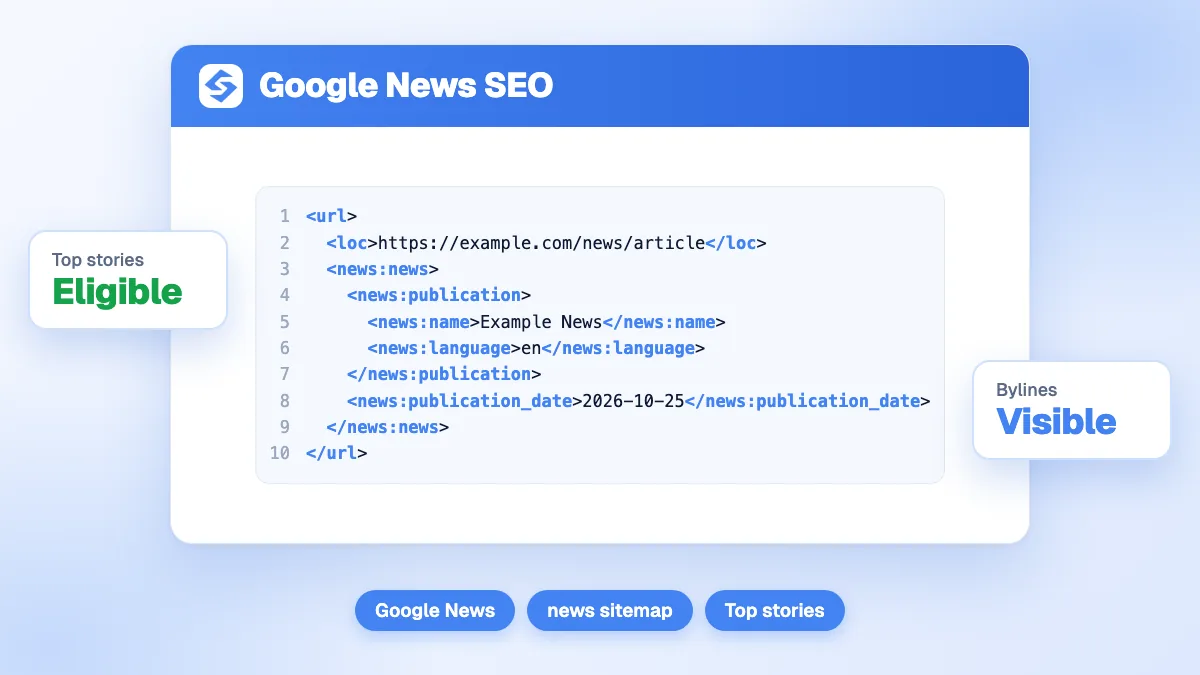
Una sitemap di notizie elenca solo gli articoli recenti. La documentazione Google sulle sitemap di notizie chiede di includere solo URL di articoli creati negli ultimi due giorni, fino a 1000 voci news:news per file, e richiede i tag news:publication (nome e lingua), news:publication_date e news:title. Il nome della pubblicazione deve corrispondere a quello mostrato in Google News. Mantieni affiancata una normale sitemap XML per l'intero archivio.
2. Collegare le nuove notizie da hub già scansionati
Googlebot torna spesso sulla homepage e sulle pagine di sezione. Collegare ogni nuova notizia da questi hub e dalle pagine attive correlate la fa scansionare più in fretta di qualsiasi ping di sitemap. Le pagine di argomento (una per tema ricorrente, persona o squadra) raccolgono link e danno a Google un URL stabile su cui posizionarsi per le query che tornano.
3. Tenere un solo URL per storia
Aggiorna una storia in evoluzione sullo stesso URL invece di pubblicare un nuovo articolo per ogni sviluppo, e mostra sia la data di pubblicazione sia quella dell'ultimo aggiornamento. Quando più testate di un gruppo riprendono lo stesso pezzo, un tag canonical che punti all'originale evita duplicati in concorrenza tra loro.
4. Limitare lo spreco di scansione
Combinazioni infinite di tag, pagine di ricerca interna, archivi di calendario e parametri di tracciamento diluiscono la scansione. Blocca o imposta noindex su ciò che non ha valore di ricerca, e controlla le pagine di tag sottili (un tag con due soli articoli non aiuta nessuno).
Suggerimento
Controlla il rapporto Statistiche di scansione in Search Console dopo una grande giornata di notizie. Se il tempo medio di risposta sale, Googlebot rallenta e le tue storie fresche aspettano in coda dietro le pagine d'archivio.
Quale dato strutturato dovrebbe usare un sito di notizie?
Tre tipi di markup fanno la maggior parte del lavoro per gli editori.
Article o NewsArticle: titolo, immagini, datePublished, dateModified e author con un link alla pagina dell'autore. Aiuta Google a mostrare la data giusta e ad attribuire la storia.
Markup per paywall: per i contenuti in abbonamento, le linee guida Google sui contenuti a pagamento chiedono di impostare isAccessibleForFree su false e di far puntare hasPart alla sezione riservata con un cssSelector. Così Googlebot legge il testo completo, e Google distingue il tuo paywall dal cloaking, che viola le sue politiche antispam.
Organization e Person: identità dell'editore, logo, profili social e profili degli autori, che collegano i tuoi contenuti a entità note.
I dati strutturati non fanno posizionare un articolo da soli, ma eliminano l'ambiguità su chi ha scritto cosa e quando, per Google e per i modelli linguistici che analizzano le tue pagine. La nostra guida sui dati strutturati per la ricerca IA spiega quali proprietà usano davvero i sistemi IA.
Come ottenere traffico da Google Discover?
Discover è una fonte di traffico importante per molti editori di notizie e di lifestyle, ed è anche la più volatile. La documentazione Discover di Google (aggiornata a marzo 2026) fissa condizioni chiare:
usa immagini grandi larghe almeno 1200 px, oltre 300.000 pixel, in formato 16x9, attivate con l'impostazione robots max-image-preview:large;
evita loghi e immagini piene di testo come visual principale;
scrivi titoli che colgano l'essenza della storia ed evita clickbait, esagerazioni o informazioni trattenute;
pubblica storie tempestive, angolazioni originali e una buona esperienza di pagina.
Il rapporto Discover in Search Console mostra clic, impressioni e CTR per 16 mesi una volta raggiunta una soglia minima, e include il traffico da Chrome. La nostra guida dedicata all'ottimizzazione per Google Discover approfondisce i test su immagini e titoli.
Attenzione
I titoli sensazionalistici possono far salire i clic da Discover per una settimana, per poi ridurre la tua portata. Google elenca esplicitamente i titoli fuorvianti e le tattiche che sfruttano indignazione o curiosità tra i motivi per mostrare meno i contenuti di un sito.
Cosa rende un editore affidabile agli occhi di Google?
La fiducia si costruisce pagina per pagina e a livello di sito.
Firme e pagine degli autori con biografie reali, competenze, contatti e link ai loro lavori.
Date visibili vicino al titolo, coerenti con il markup e la sitemap.
Trasparenza editoriale: una pagina chi siamo, la proprietà, una policy editoriale, una policy sulle correzioni e un modo per contattare la redazione.
Reportage originale invece di lanci d'agenzia riscritti: Top Stories tende a privilegiare la testata che ha scoperto o arricchito la storia.
Monetizzazione pulita: una densità pubblicitaria che mantenga i Core Web Vitals nel verde, e script di tracciamento caricati in modo asincrono.
Anche le sezioni monetizzate richiedono attenzione. Le politiche antispam di Google definiscono l'abuso della reputazione del sito come la pubblicazione di contenuti di terze parti principalmente per sfruttare i segnali di ranking dell'host. Sezioni di coupon, recensioni di prodotti o contenuti sponsorizzati gestite da partner esterni senza integrazione editoriale espongono l'intero dominio, mentre una sezione curata dalla redazione e chiaramente segnalata non è interessata.
Come bilanciare notizie dell'ultima ora e contenuti evergreen?
Le notizie dell'ultima ora portano picchi, i contenuti evergreen portano una base. Un editore sano pianifica entrambi.
Approfondimenti e guide («cos'è», «come», cronologie, glossari) che rispondono alle domande stabili dietro le notizie ricorrenti. Vedi la nostra guida ai contenuti evergreen.
Hub tematici che collegano le ultime notizie ad articoli di approfondimento.
Aggiornamenti regolari delle pagine d'archivio più visitate: aggiorna fatti, date e link invece di pubblicare un quasi duplicato. Il nostro metodo di aggiornamento dei contenuti si applica direttamente agli archivi di notizie.
Ricerca di parole chiave sugli eventi ricorrenti (elezioni, bilanci, stagioni sportive, lanci di prodotto), così che la spiegazione esista prima del picco.
Come cambiano le risposte IA la SEO per editori?
Le panoramiche IA di Google, ChatGPT, Perplexity e Gemini riassumono le notizie e rispondono direttamente alle domande fattuali, il che riduce i clic su molte query informative (vedi Google AI Overviews). Gli editori oggi prendono tre decisioni.
Accesso dei crawler
Il file robots.txt permette di autorizzare o bloccare ogni crawler IA separatamente: GPTBot per l'addestramento di OpenAI, OAI-SearchBot per la ricerca di ChatGPT, PerplexityBot, ClaudeBot e altri. Google-Extended è un token separato che controlla l'uso dei tuoi contenuti per l'addestramento e l'ancoraggio di Gemini; Google precisa che non influisce sull'inclusione né sul ranking nella ricerca Google. Bloccare i crawler orientati alla ricerca ti toglie dalle loro risposte, per questo molti editori bloccano i crawler di addestramento e autorizzano quelli di ricerca. La nostra guida al robots.txt per i crawler IA elenca gli user agent.
Licenze
Grandi aziende di IA hanno firmato accordi sui contenuti con editori (OpenAI con l'Associated Press e Axel Springer, per esempio), e stanno comparendo modelli a pagamento per scansione. La concessione di licenze è una decisione di business quanto di SEO: un accordo può portare ricavi e attribuzione, mentre un blocco generalizzato protegge l'esclusività al prezzo della visibilità.
Citabilità
Gli assistenti IA citano le fonti che espongono i fatti con chiarezza, in alto, con date e fonti nominate. Dati originali, citazioni esclusive e spiegazioni ben strutturate vengono citati più dei lanci riscritti. Il nostro studio sulle citazioni dei media da parte delle IA mostra quali testate gli assistenti IA citano più spesso.
Come misurare la SEO per editori?
Separa i report per superficie e per tipo di contenuto: ultima ora, evergreen, hub tematici. In Search Console segui separatamente i rapporti Web, Discover e Google News, il ritardo di indicizzazione dei nuovi articoli (tempo tra pubblicazione e prime impressioni) e la quota di traffico proveniente dalle pagine evergreen. Per la visibilità IA, segui un elenco fisso di domande sui tuoi temi e verifica se la tua testata viene citata e quale concorrente lo è al posto tuo.
Sorank riunisce questi segnali: la dashboard GEO e SEO segue clic, impressioni e posizioni da Search Console, e il monitoraggio delle menzioni IA controlla ogni mese se ChatGPT, Claude e Gemini citano la tua testata sulle domande che fanno i tuoi lettori. Il software scrive e pubblica anche articoli evergreen in autopilot, il che si adatta alla parte esplicativa di una redazione più che alle notizie dell'ultima ora.
La SEO per editori oggi significa farsi trovare in fretta su Google ed essere la fonte che gli assistenti IA citano. Sistema prima indicizzazione e fiducia, proteggi il traffico evergreen, poi definisci con la direzione la tua politica sui crawler IA e sulle licenze. Per seguire visibilità Google e visibilità IA in un solo posto, vedi i piani Sorank, con una prova gratuita di 3 giorni.
Domande frequenti
Bisogna fare domanda per comparire in Google News?
No. Google trova i siti di notizie con la scansione normale e li considera automaticamente per Top Stories, la scheda Notizie e l'app Google News, se pubblicano contenuti di qualità e rispettano le politiche di contenuto di Google News. Il Publisher Center è facoltativo e serve a gestire il nome della testata, il logo e le sezioni.
Un sito di notizie dovrebbe bloccare i crawler IA?
Dipende dal modello di business. Bloccare i crawler di addestramento come GPTBot protegge i contenuti dall'addestramento dei modelli, mentre bloccare i crawler di ricerca come OAI-SearchBot o PerplexityBot toglie il sito dalle risposte e dalle citazioni di quegli assistenti. Molti editori bloccano i crawler di addestramento, autorizzano quelli di ricerca e negoziano le licenze a parte.
Quanto tempo impiega Google a indicizzare un articolo di notizie?
Gli articoli ben collegati su siti di notizie affermati vengono spesso scansionati e indicizzati in pochi minuti, mentre i siti nuovi o lenti possono aspettare ore o giorni. Collegare le nuove notizie dalla homepage e dalle pagine di sezione, inserirle in una sitemap di notizie e mantenere bassi i tempi di risposta del server riduce il ritardo.
y!
Audit SEO e GEO gratuito
Ricevi gratis il tuo piano di contenuti per 30 giorni
Analizziamo i tuoi concorrenti, il tuo sito web e la tua visibilità nelle IA per creare gratuitamente un piano di contenuti su misura.
“Ho testato Sorank sul sito reale di un cliente ed è pazzesco. Fa tutto quello che un'agenzia fa pagare 1.500 € al mese. Ora va in produzione su quel cliente.”Guillaume Guersanguersanguillaume.com
“Siamo un'agenzia pubblicitaria e volevamo rimettere in carreggiata il nostro SEO una volta per tutte. Sorank ci ha dato una visione chiara del nostro sito, ci ha aiutato a dare priorità alle ottimizzazioni e a strutturare correttamente i nostri contenuti. Lo strumento è facile da usare, ben progettato per un team e molto pratico per centralizzare il monitoraggio senza dover destreggiarsi tra più piattaforme. Una base molto solida per ripartire da zero con il nostro SEO.”Gaspard MadouiAgenzia Pubblicitaria
“Mi sono specializzata in GEO grazie a Sorank. Il GEO Leaderboard mi permette di mostrare ai miei clienti il loro posizionamento rispetto ai concorrenti su ChatGPT. È un vero differenziatore commerciale.”MélanieFreelancer SEO
Crescita organicaGenerazione di lead per installatori
“Ottimo servizio, funziona bene per il nostro sito web e ci aiuta a capire come migliorarlo per posizionarci meglio su Google e altrove. Complimenti, continuate così, ve lo consiglio.”Hugo T.Commerciante e-commerce