Prywatność jest dla nas ważna, dlatego możesz wyłączyć niektóre rodzaje przechowywania danych, które nie są niezbędne do podstawowego działania strony. Zablokowanie kategorii może wpłynąć na Twoje doświadczenie podczas korzystania z witryny. Więcej informacji (Polityka cookies)
Okładka artykułu „SEO dla wydawców” ze zrzutem ekranu oprogramowania Sorank obok tytułu
Narzędzia
Na tej stronie
W skrócie
SEO dla wydawców to zestaw praktyk, dzięki którym serwisy informacyjne i medialne zdobywają ruch z wyszukiwarki Google, z Top Stories, Google News, Discover i coraz częściej z asystentów AI. Opiera się na czterech filarach: szybkim indeksowaniu świeżych artykułów (sitemapa newsowa, czytelne adresy URL, linkowanie wewnętrzne), sygnałach zaufania (autorzy, daty, sprostowania, strony autorów), oznaczeniach technicznych (Article, wymagania dotyczące paywalla i obrazów) oraz przemyślanej polityce wobec crawlerów AI i licencji. Treści ponadczasowe i bezpośredni kontakt z odbiorcami chronią biznes, gdy ruch z wyszukiwarek spada.
3 dni za darmo, potem rezygnujesz, kiedy chcesz. 90-dniowa gwarancja wyników lub zwrotu pieniędzy.
SEO dla wydawców różni się od klasycznego SEO, ponieważ serwis informacyjny publikuje dziennie dziesiątki albo setki stron, z których większość traci wartość w ciągu 48 godzin, a jego archiwum ponadczasowe przez lata przyciąga odwiedzających. Stawka wzrosła: raport Journalism, Media and Technology Trends and Predictions 2026 Reuters Institute (styczeń 2026) przywołuje dane Chartbeat, według których ruch z wyszukiwarki Google do ponad 2500 serwisów informacyjnych spadł o 33% rok do roku między listopadem 2024 a listopadem 2025. Ankietowani 280 liderów mediów spodziewają się kolejnego spadku odesłań z wyszukiwarek o 43% w ciągu trzech lat. Dobra optymalizacja oznacza dziś utrzymanie ruchu, który został, i bycie cytowanym tam, dokąd czytelnicy idą dalej. Ten poradnik pokazuje, co się zmienia dla firm wydawniczych i medialnych, od miejsc z wiadomościami po odpowiedzi AI.
Czym jest SEO dla wydawców i czym się różni?
SEO dla wydawców stosuje optymalizację pod wyszukiwarki w serwisach, których produktem są treści redakcyjne: gazetach, magazynach, mediach powstałych w internecie, wydawnictwach branżowych i dużych blogach utrzymujących się z reklam lub prenumeraty. Trzy ograniczenia odróżniają je od innych.
Szybkość: wiadomość z ostatniej chwili ma największą wartość w pierwszych godzinach. Google musi ją odkryć, zaindeksować i zindeksować w ciągu minut, dlatego ścieżki indeksowania i sitemapy są ważniejsze niż w serwisie wizytówkowym.
Skala: tysiące artykułów, stron tagów, stron autorów i archiwów tworzą zduplikowane lub ubogie strony, które marnują budżet indeksowania i powodują kanibalizację słów kluczowych między kilkoma artykułami o tym samym wydarzeniu.
Zaufanie: wiadomości i tematy ważne społecznie to obszary, w których Google mocno waży wiarygodność. Widoczni autorzy, jasne źródła i korekty wspierają E-E-A-T (doświadczenie, wiedzę, autorytet i zaufanie).
Wydawca zależy też od miejsc, których większość serwisów nigdy nie widzi: karuzel Top Stories, zakładki Wiadomości, aplikacji Google News oraz Discover, kanału, który podsuwa treści użytkownikom bez żadnego zapytania.
Które miejsca w Google są ważne dla wydawców?
Każde miejsce ma własną logikę wyboru. Tabela podsumowuje, co napędza widoczność i gdzie ją mierzyć.
Miejsce
Jak treść się tam dostaje
Główne dźwignie
Gdzie mierzyć
Wyniki wyszukiwania (niebieskie linki)
Standardowe indeksowanie i ranking
Trafność, głębia, linki, doświadczenie strony
Search Console, typ wyszukiwania: Web
Top Stories
Automatycznie, dla zapytań o charakterze newsowym
Świeżość, autorytet w temacie, oryginalne relacje
Search Console, filtry wyglądu wyników
Aplikacja Google News i zakładka Wiadomości
Automatycznie, zgodnie z zasadami treści Google News
Przejrzystość, daty, autorzy, zgodność z zasadami
Search Console, raport Google News
Discover
Automatycznie, na podstawie zainteresowań użytkownika
Duże obrazy, uczciwe tytuły, aktualne lub unikalne historie
Search Console, raport Discover
Przeglądy AI i asystenci AI
Pobieranie ze stron zindeksowanych lub zindeksowanych przez crawlery
Jasne fakty, uporządkowane odpowiedzi, dostęp crawlerów, autorytet marki
Śledzenie promptów, analityka odesłań
Google informuje w centrum pomocy dla wydawców, że nie ma formularza zgłoszeniowego: strony znalezione w zwykłym indeksowaniu są automatycznie brane pod uwagę w Top Stories i zakładce Wiadomości, jeśli publikują wysokiej jakości treści i przestrzegają zasad treści Google News. Publisher Center nadal przydaje się do zarządzania nazwą publikacji, logo i działami w aplikacji Google News.
Jak szybko indeksować artykuły?
1. Opublikuj sitemapę newsową
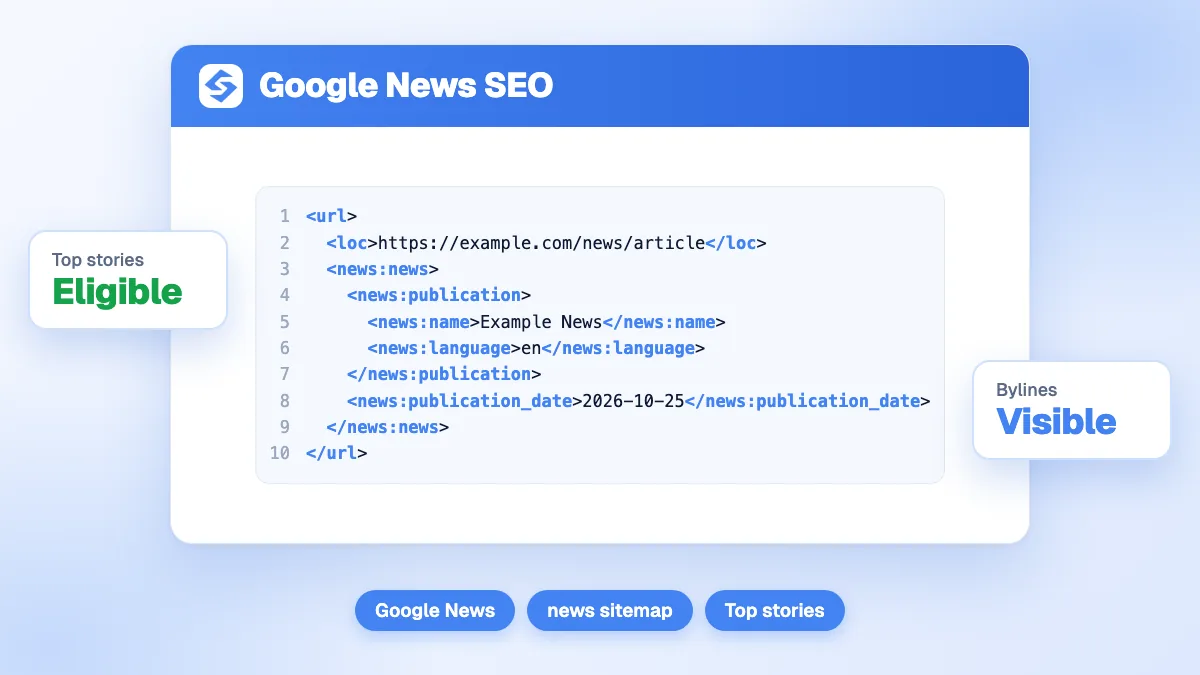
Sitemapa newsowa zawiera wyłącznie świeże artykuły. Dokumentacja Google dotycząca sitemap newsowych wymaga, by uwzględniać tylko adresy artykułów utworzonych w ciągu ostatnich dwóch dni, do 1000 wpisów news:news w pliku, oraz tagów news:publication (nazwa i język), news:publication_date i news:title. Nazwa publikacji musi być zgodna z tą, która pojawia się w Google News. Obok niej utrzymuj zwykłą sitemapę XML dla całego archiwum.
2. Linkuj nowe historie z indeksowanych hubów
Googlebot często odwiedza stronę główną i strony działów. Linkowanie każdej nowej historii z tych hubów oraz z powiązanych aktywnych stron sprawia, że jest indeksowana szybciej niż po jakimkolwiek zgłoszeniu w sitemapie. Strony tematyczne (jedna na powracający temat, osobę lub zespół) zbierają linki i dają Google stabilny adres, na który może się pozycjonować w powtarzających się zapytaniach.
3. Zachowaj jeden adres URL na historię
Aktualizuj rozwijającą się historię pod tym samym adresem, zamiast publikować nowy artykuł przy każdym etapie, i pokazuj zarówno datę publikacji, jak i datę ostatniej aktualizacji. Gdy kilka redakcji z jednej grupy przedrukowuje ten sam tekst, znacznik canonical wskazujący oryginał zapobiega konkurującym duplikatom.
4. Ogranicz marnowanie indeksowania
Nieskończone kombinacje tagów, strony wyszukiwania wewnętrznego, archiwa kalendarzowe i parametry śledzące rozmywają indeksowanie. Zablokuj lub oznacz noindex to, co nie ma wartości dla wyszukiwania, i sprawdzaj ubogie strony tagów (tag z dwoma artykułami nikomu nie pomaga).
Wskazówka
Po dużym dniu wiadomości sprawdź raport Statystyki indeksowania w Search Console. Jeśli średni czas odpowiedzi rośnie, Googlebot zwalnia, a Twoje świeże historie czekają w kolejce za stronami archiwum.
Jakich danych strukturalnych powinien używać serwis informacyjny?
Trzy typy oznaczeń wykonują większość pracy dla wydawców.
Article lub NewsArticle: nagłówek, obrazy, datePublished, dateModified i author z linkiem do strony autora. Pomaga Google pokazać właściwą datę i przypisać materiał.
Oznaczenie paywalla: w przypadku treści płatnych wytyczne Google dotyczące treści płatnych wymagają ustawienia isAccessibleForFree na false oraz wskazania przez hasPart zamkniętej sekcji za pomocą cssSelector. Dzięki temu Googlebot widzi pełny tekst, a Google odróżnia paywall od cloakingu, który narusza zasady spamu.
Organization i Person: tożsamość wydawcy, logo, profile w mediach społecznościowych i profile autorów, które łączą Twoje treści ze znanymi podmiotami.
Dane strukturalne same w sobie nie sprawiają, że artykuł się pozycjonuje, ale usuwają niejasność co do tego, kto co i kiedy napisał, zarówno dla Google, jak i dla modeli językowych analizujących Twoje strony. Nasz poradnik o danych strukturalnych w wyszukiwaniu AI wyjaśnia, z jakich właściwości systemy AI faktycznie korzystają.
Jak zdobywać ruch z Google Discover?
Discover to ważne źródło ruchu dla wielu wydawców wiadomości i lifestyle, a zarazem najbardziej niestabilne. Dokumentacja Discover Google (zaktualizowana w marcu 2026) określa jasne warunki:
używaj dużych obrazów o szerokości co najmniej 1200 px, powyżej 300 000 pikseli, w proporcjach 16x9, z włączonym ustawieniem robots max-image-preview:large;
unikaj logo i obrazów przeładowanych tekstem jako głównej grafiki;
pisz tytuły oddające istotę historii i unikaj clickbaitu, przesady lub zatajania informacji;
publikuj aktualne historie, oryginalne ujęcia i dobre doświadczenie strony.
Raport Discover w Search Console pokazuje kliknięcia, wyświetlenia i CTR z 16 miesięcy, gdy osiągnięty zostanie minimalny próg, i obejmuje ruch z Chrome. Nasz poradnik o optymalizacji pod Google Discover omawia szczegółowo testy obrazów i tytułów.
Uwaga
Sensacyjne nagłówki mogą podbić kliknięcia z Discover na tydzień, a potem zmniejszyć zasięg. Google wprost wymienia mylące tytuły i taktyki żerujące na oburzeniu lub ciekawości jako powody, dla których pokazuje mniej treści danego serwisu.
Co sprawia, że wydawca jest wiarygodny dla Google?
Zaufanie buduje się strona po stronie i w skali całego serwisu.
Autorzy i strony autorów z prawdziwymi biogramami, kompetencjami, danymi kontaktowymi i linkami do ich prac.
Daty widoczne przy nagłówku, spójne z oznaczeniami i sitemapą.
Przejrzystość redakcyjna: strona o redakcji, właściciele, zasady redakcyjne, polityka sprostowań i sposób kontaktu z redakcją.
Oryginalne relacje zamiast przepisanych depesz agencyjnych: Top Stories zwykle faworyzuje redakcję, która ujawniła lub rozwinęła historię.
Czysta monetyzacja: gęstość reklam, która utrzymuje Core Web Vitals w zieleni, oraz skrypty śledzące ładowane asynchronicznie.
Zmonetyzowane działy również wymagają ostrożności. Zasady antyspamowe Google definiują nadużycie reputacji serwisu jako publikowanie treści stron trzecich głównie po to, by skorzystać z sygnałów rankingowych hosta. Działy z kuponami, recenzjami produktów lub treściami sponsorowanymi prowadzone przez zewnętrznych partnerów, bez włączenia do redakcji, narażają całą domenę, natomiast dział starannie wyselekcjonowany przez redakcję i wyraźnie oznaczony nie jest celem.
Jak zrównoważyć wiadomości z ostatniej chwili i treści ponadczasowe?
Wiadomości z ostatniej chwili przynoszą szczyty, treści ponadczasowe dają podstawę. Zdrowy wydawca planuje oba rodzaje.
Wyjaśnienia i poradniki («co to jest», «jak», osie czasu, słowniki), które odpowiadają na stałe pytania stojące za powracającymi wiadomościami. Zobacz nasz poradnik o treściach ponadczasowych.
Huby tematyczne, które łączą najnowsze wiadomości z tekstami tła.
Regularne aktualizacje najczęściej odwiedzanych stron archiwalnych: odśwież fakty, daty i linki zamiast publikować niemal identyczny tekst. Nasza metoda odświeżania treści stosuje się bezpośrednio do archiwów wiadomości.
Badanie słów kluczowych pod kątem powracających wydarzeń (wybory, budżety, sezony sportowe, premiery produktów), tak aby wyjaśnienie istniało przed szczytem zainteresowania.
Jak odpowiedzi AI zmieniają SEO dla wydawców?
Przeglądy AI, ChatGPT, Perplexity i Gemini streszczają wiadomości i odpowiadają na pytania faktograficzne bezpośrednio, co zmniejsza kliknięcia w wielu zapytaniach informacyjnych (zob. Google AI Overviews). Wydawcy podejmują dziś trzy decyzje.
Dostęp crawlerów
Plik robots.txt pozwala osobno zezwolić lub zablokować każdego crawlera AI: GPTBot do treningu OpenAI, OAI-SearchBot do wyszukiwania ChatGPT, PerplexityBot, ClaudeBot i inne. Google-Extended to odrębny token, który kontroluje wykorzystanie Twoich treści do treningu i ugruntowywania Gemini; Google zaznacza, że nie wpływa on na indeksowanie ani ranking w wyszukiwarce Google. Blokowanie botów nastawionych na wyszukiwanie usuwa Cię z ich odpowiedzi, dlatego wielu wydawców blokuje boty treningowe, a zezwala na boty wyszukiwania. Nasz poradnik o robots.txt dla crawlerów AI zawiera listę user agentów.
Licencje
Duże firmy AI podpisały umowy na treści z wydawcami (na przykład OpenAI z Associated Press i Axel Springer), a pojawiają się modele płatności za indeksowanie. Licencjonowanie treści to decyzja biznesowa równie mocno jak SEO: umowa może przynieść przychód i przypisanie autorstwa, a ogólna blokada chroni wyłączność kosztem widoczności.
Cytowalność
Asystenci AI cytują źródła, które jasno przedstawiają fakty, na początku tekstu, z datami i wymienionymi źródłami. Dane własne, ekskluzywne cytaty i dobrze uporządkowane wyjaśnienia są cytowane częściej niż przepisane depesze. Nasze badanie cytowań mediów przez AI pokazuje, które redakcje asystenci AI cytują najczęściej.
Jak mierzyć SEO dla wydawców?
Rozdziel raportowanie według miejsca i typu treści: wiadomości z ostatniej chwili, treści ponadczasowe, huby tematyczne. W Search Console śledź osobno raporty Web, Discover i Google News, opóźnienie indeksowania nowych artykułów (czas między publikacją a pierwszymi wyświetleniami) oraz udział ruchu z treści ponadczasowych. W przypadku widoczności w AI śledź stałą listę pytań o swoje tematy, sprawdzaj, czy Twoja publikacja jest cytowana, i który konkurent jest cytowany zamiast niej.
Sorank łączy te sygnały: panel GEO i SEO śledzi kliknięcia, wyświetlenia i pozycje z Search Console, a monitoring wzmianek w AI sprawdza co miesiąc, czy ChatGPT, Claude i Gemini cytują Twoją publikację w pytaniach zadawanych przez czytelników. Oprogramowanie pisze i publikuje też treści ponadczasowe na autopilocie, co lepiej pasuje do wyjaśniającej części redakcji niż do wiadomości z ostatniej chwili.
SEO dla wydawców oznacza dziś szybkie bycie znalezionym w Google i bycie źródłem, które cytują asystenci AI. Najpierw napraw indeksowanie i zaufanie, chroń ruch z treści ponadczasowych, a potem wspólnie z zarządem ustal politykę wobec crawlerów AI i licencji. Aby śledzić widoczność w Google i w AI w jednym miejscu, zobacz plany Sorank, z 3-dniowym bezpłatnym okresem próbnym.
Najczęściej zadawane pytania
Czy trzeba się zgłosić, aby pojawić się w Google News?
Nie. Google znajduje serwisy informacyjne w zwykłym indeksowaniu i automatycznie bierze je pod uwagę w Top Stories, zakładce Wiadomości i aplikacji Google News, jeśli publikują wysokiej jakości treści i przestrzegają zasad treści Google News. Publisher Center jest opcjonalny i pomaga zarządzać nazwą publikacji, logo i działami.
Czy serwis informacyjny powinien blokować crawlery AI?
To zależy od modelu biznesowego. Blokowanie crawlerów treningowych, takich jak GPTBot, chroni treści przed trenowaniem modeli, natomiast blokowanie crawlerów wyszukiwania, takich jak OAI-SearchBot lub PerplexityBot, usuwa serwis z odpowiedzi i cytowań tych asystentów. Wielu wydawców blokuje boty treningowe, zezwala na boty wyszukiwania i negocjuje licencje osobno.
Ile czasu Google potrzebuje, aby zaindeksować artykuł newsowy?
Dobrze zlinkowane artykuły w ugruntowanych serwisach informacyjnych są często indeksowane w ciągu minut, natomiast nowe lub wolne serwisy mogą czekać godzinami lub dniami. Linkowanie nowych historii ze strony głównej i stron działów, umieszczanie ich w sitemapie newsowej i utrzymywanie niskiego czasu odpowiedzi serwera skraca to opóźnienie.
y!
Darmowy audyt SEO i GEO
Odbierz za darmo plan treści na 30 dni
Analizujemy Twoich konkurentów, Twoją stronę i Twoją widoczność w AI, aby bezpłatnie przygotować dla Ciebie dopasowany plan treści.
“Przetestowałem Sorank na prawdziwej stronie klienta i to jest szalone. Robi wszystko, za co agencja policzyłaby Ci $1500 miesięcznie. Teraz trafia na produkcję u tego klienta.”Guillaume Guersanguersanguillaume.com
“Jesteśmy agencją reklamową i chcieliśmy raz na zawsze uporządkować nasze SEO. Sorank dał nam przejrzysty obraz naszej strony, pomógł ustalić priorytety optymalizacji i właściwie uporządkować nasze treści. Narzędzie jest proste w obsłudze, dobrze zaprojektowane do pracy zespołowej i bardzo praktyczne do centralizacji monitoringu bez żonglowania wieloma platformami. Bardzo solidna podstawa, by zacząć SEO od nowa.”Gaspard MadouiAgencja reklamowa
“Dzięki Sorank wyspecjalizowałem się w GEO. Ranking GEO pozwala mi pokazywać klientom ich pozycję na tle konkurencji w ChatGPT. To realna przewaga handlowa.”MélanieFreelancer SEO
Wzrost organicznyGenerowanie leadów dla instalatorów
“Świetna usługa, dobrze działa dla naszej strony i pomaga zrozumieć, jak ją ulepszyć, aby lepiej pozycjonować się w Google i nie tylko. Gratulacje, tak trzymać, polecam.”Hugo T.Sprzedawca e-commerce