Налаштування
Ми цінуємо вашу приватність, тому ви можете вимкнути певні типи зберігання даних, які не потрібні для базової роботи вебсайту. Блокування категорій може вплинути на ваш досвід користування сайтом. Докладніше

Ми цінуємо вашу приватність, тому ви можете вимкнути певні типи зберігання даних, які не потрібні для базової роботи вебсайту. Блокування категорій може вплинути на ваш досвід користування сайтом. Докладніше

Посібник із SEO для видавців: Top Stories, Discover, новинні карти сайту, розмітка статей і платного доступу, цитування у відповідях ШІ та вибір ліцензій.

Інструменти

Коротко
SEO для видавців: набір практик, які допомагають новинним і медіасайтам отримувати трафік із пошуку Google, Top Stories, Google News, Discover і тепер від асистентів ШІ. Він спирається на чотири опори: швидку індексацію свіжих матеріалів (новинна карта сайту, зрозумілі URL, внутрішні посилання), сигнали довіри (авторство, дати, виправлення, сторінки авторів), технічну розмітку (Article, вимоги до платного доступу та зображень) і продуману політику щодо ШІ-краулерів та ліцензування. Вічнозелений контент і прямі канали зв'язку з аудиторією захищають бізнес, коли пошукові переходи падають.
Хочете дізнатися більше? Запитайте
Швидкий тест
Чи підходить вам SEO і з чого почати?
Sorank відповідає вашим відповідям


Спробуйте його 3 дні на власному сайті й дізнайтеся, де ви зараз у Google, ChatGPT та інших ШІ.
Спробувати 3 дні безкоштовно3 дні безкоштовно, потім зупиніть, коли захочете. Гарантія результату або повернення коштів протягом 90 днів.
SEO для видавців відрізняється від класичного SEO, бо новинний сайт публікує десятки або сотні сторінок на день, більшість із яких втрачає цінність за 48 годин, тоді як його архів роками продовжує приносити відвідувачів. Ставки зросли: звіт Journalism, Media and Technology Trends and Predictions 2026 Reuters Institute (січень 2026) посилається на дані Chartbeat, за якими пошуковий трафік Google на понад 2500 новинних сайтів знизився на 33% у річному вимірі між листопадом 2024 і листопадом 2025 року. Опитані 280 керівників медіа очікують, що переходи з пошуку ще на 43% зменшаться протягом трьох років. Добра оптимізація сьогодні означає збереження трафіку, який залишився, і цитування там, куди читачі йдуть далі. Цей посібник пояснює, що змінюється для видавничих і медіакомпаній: від новинних поверхонь до відповідей ШІ.
SEO для видавців застосовує пошукову оптимізацію до сайтів, продуктом яких є редакційний контент: газет, журналів, цифрових медіа, галузевих видань і великих блогів, що живуть за рахунок реклами або передплати. Три обмеження відрізняють його від інших видів SEO.
Видавець також залежить від поверхонь, які більшість сайтів ніколи не бачить: каруселі Top Stories, вкладка «Новини», застосунок Google News і Discover, стрічка, яка пропонує контент користувачам без жодного запиту.
Кожна поверхня має власну логіку відбору. Таблиця підсумовує, що впливає на видимість і де її вимірювати.
| Поверхня | Як контент потрапляє туди | Головні важелі | Де вимірювати |
|---|---|---|---|
| Результати пошуку (сині посилання) | Звичайне сканування та ранжування | Релевантність, глибина, посилання, якість сторінки | Search Console, тип пошуку: Web |
| Top Stories | Автоматично, для запитів із новинним інтентом | Свіжість, авторитет у темі, оригінальні матеріали | Search Console, фільтри зовнішнього вигляду пошуку |
| Застосунок Google News і вкладка «Новини» | Автоматично, за умови дотримання правил контенту Google News | Прозорість, дати, авторство, відповідність правилам | Search Console, звіт Google News |
| Discover | Автоматично, на основі інтересів користувача | Великі зображення, чесні заголовки, своєчасні або унікальні історії | Search Console, звіт Discover |
| Огляди ШІ та асистенти ШІ | Вилучення зі сторінок, що проіндексовані або проскановані | Чіткі факти, структуровані відповіді, доступ краулерів, авторитет бренду | Відстеження промптів, аналіз переходів |
Google повідомляє у довідці для видавців, що заявка не потрібна: сайти, знайдені під час звичайного сканування, автоматично розглядаються для Top Stories і вкладки «Новини», якщо публікують якісний контент і дотримуються правил контенту Google News. Publisher Center залишається корисним для керування назвою видання, логотипом і розділами в застосунку Google News.
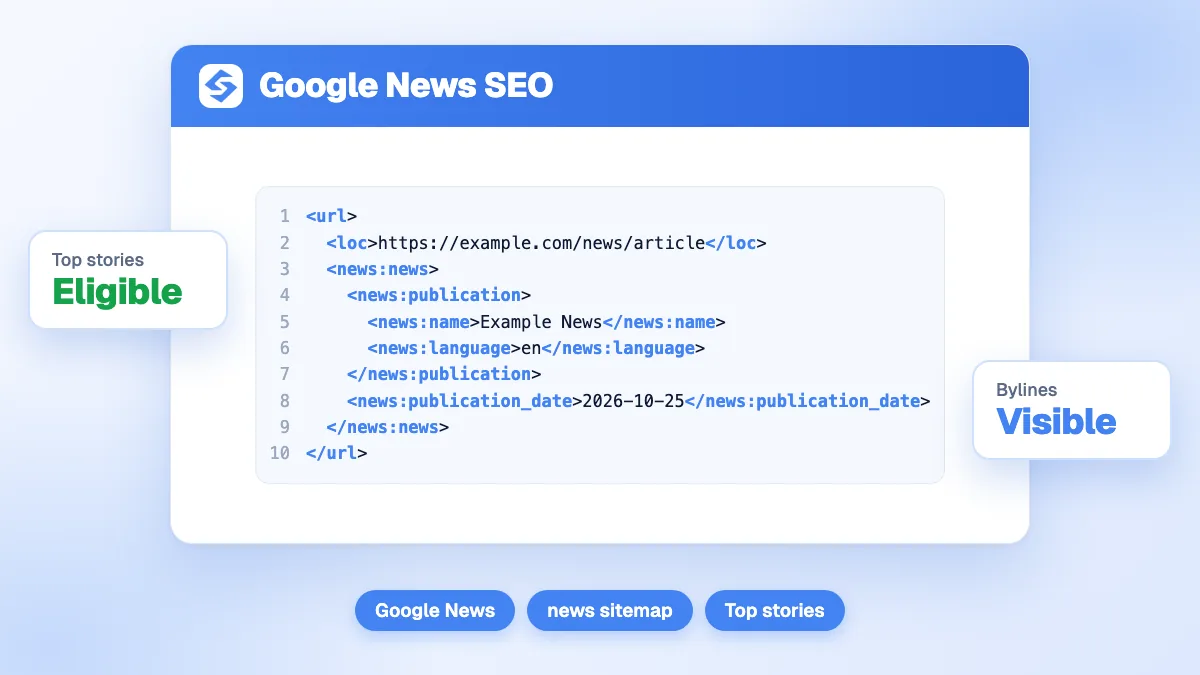
Новинна карта сайту містить лише свіжі статті. Документація Google про новинні карти сайту просить включати лише адреси статей, створених за останні два дні, до 1000 записів news:news в одному файлі, і вимагає теги news:publication (назва й мова), news:publication_date та news:title. Назва видання має збігатися з тією, що показано в Google News. Поруч тримайте звичайну XML-карту сайту для всього архіву.
Googlebot регулярно повертається на головну сторінку та сторінки розділів. Посилання на кожен новий матеріал із цих хабів і з пов'язаних активних сторінок прискорює його сканування більше, ніж будь-яке повідомлення через карту сайту. Тематичні сторінки (по одній на кожну тему, особу чи команду, що повторюється) збирають посилання та дають Google стабільну адресу для ранжування за повторюваними запитами.
Оновлюйте історію, що розвивається, за тією самою адресою, а не публікуйте нову статтю на кожен розвиток подій, і показуйте й дату публікації, і дату останнього оновлення. Коли кілька видань однієї групи публікують той самий текст, тег canonical, що вказує на оригінал, запобігає конкуруючим дублям.
Нескінченні комбінації тегів, сторінки внутрішнього пошуку, календарні архіви та параметри відстеження розмивають сканування. Закрийте або позначте noindex усе, що не має пошукової цінності, і перевіряйте слабкі сторінки тегів (тег із двома статтями нікому не допомагає).
Порада
Після великого новинного дня перевірте звіт «Статистика сканування» у Search Console. Якщо середній час відповіді зростає, Googlebot сповільнюється, і ваші свіжі історії чекають у черзі за сторінками архіву.
Три типи розмітки виконують більшу частину роботи для видавців.
datePublished, dateModified і author з посиланням на сторінку автора. Це допомагає Google показувати правильну дату й вказувати автора матеріалу.isAccessibleForFree у false і вказати через hasPart закритий розділ за допомогою cssSelector. Так Googlebot може прочитати повний текст, а Google відрізняє ваш платний доступ від клоакінгу, який порушує правила проти спаму.Структуровані дані самі по собі не виводять статтю в топ, але вони усувають неоднозначність щодо того, хто що й коли написав, як для Google, так і для мовних моделей, які розбирають ваші сторінки. Наш посібник щодо структурованих даних для пошуку ШІ пояснює, які властивості системи ШІ справді використовують.
Discover, важливе джерело трафіку для багатьох новинних і лайфстайл-видань, і водночас найнестабільніше. Документація Google щодо Discover (оновлена в березні 2026) встановлює зрозумілі умови:
max-image-preview:large;Звіт Discover у Search Console показує кліки, покази та CTR за 16 місяців, щойно досягнуто мінімального порогу, і включає трафік із Chrome. Наш окремий посібник з оптимізації для Google Discover детальніше розглядає тести зображень і заголовків.
Обережно
Сенсаційні заголовки можуть підняти кліки з Discover на тиждень, а потім скоротити ваш охоплення. Google прямо називає оманливі заголовки та тактики, що грають на обуренні чи цікавості, причинами, через які сайту показують менше контенту.
Довіра будується сторінка за сторінкою і на рівні всього сайту.
Монетизовані розділи також потребують уваги. Правила проти спаму Google визначають зловживання репутацією сайту як публікацію стороннього контенту головним чином для того, щоб скористатися сигналами ранжування хост-сайту. Розділи купонів, оглядів товарів або спонсорського контенту, які ведуть зовнішні партнери без редакційної інтеграції, ставлять під загрозу весь домен, тоді як розділ, відібраний редакцією і чітко позначений, не є мішенню.
Термінові новини дають сплески, вічнозелений контент дає основу. Здоровий видавець планує обидва типи матеріалів.
Огляди ШІ, ChatGPT, Perplexity і Gemini переказують новини та напряму відповідають на фактичні запитання, що зменшує кліки за багатьма інформаційними запитами (див. Google AI Overviews). Видавці тепер ухвалюють три рішення.
Файл robots.txt дозволяє окремо дозволяти або блокувати кожного ШІ-краулера: GPTBot для навчання OpenAI, OAI-SearchBot для пошуку ChatGPT, PerplexityBot, ClaudeBot та інші. Google-Extended, окремий токен, який керує використанням вашого контенту для навчання та обґрунтування відповідей Gemini; Google заявляє, що він не впливає на індексацію та ранжування в пошуку Google. Блокування ботів, орієнтованих на пошук, виводить вас з їхніх відповідей, тому багато видавців блокують навчальних ботів і дозволяють пошукових. Наш посібник щодо robots.txt для ШІ-краулерів наводить список користувацьких агентів.
Великі компанії ШІ уклали угоди про контент із видавцями (наприклад, OpenAI з Associated Press і Axel Springer), і з'являються моделі оплати за сканування. Ліцензування контенту, це бізнес-рішення не менше, ніж рішення SEO: угода може принести дохід і атрибуцію, тоді як загальне блокування захищає ексклюзивність ціною видимості.
Асистенти ШІ цитують джерела, які чітко викладають факти на початку тексту, з датами та названими джерелами. Оригінальні дані, ексклюзивні цитати та добре структуровані пояснення цитуються частіше, ніж переписані агентські новини. Наше дослідження цитування медіа ШІ показує, які видання асистенти ШІ цитують найчастіше.
Розділяйте звітність за поверхнею та типом контенту: термінові новини, вічнозелений контент, тематичні хаби. У Search Console відстежуйте окремо звіти Web, Discover і Google News, затримку індексації нових статей (час від публікації до перших показів) і частку трафіку з вічнозелених сторінок. Для видимості в ШІ відстежуйте сталий список запитань за вашими темами, перевіряйте, чи цитується ваше видання, і який конкурент цитується натомість.

Sorank об'єднує ці сигнали: панель GEO і SEO відстежує кліки, покази та позиції з Search Console, а відстеження згадок у ШІ щомісяця перевіряє, чи цитують ChatGPT, Claude і Gemini ваше видання за запитаннями, які ставлять читачі. Програма також пише й публікує вічнозелені статті в режимі autopilot, що краще пасує до пояснювальної частини редакції, ніж до термінових новин.
SEO для видавців сьогодні означає швидку знайдуваність у Google і статус джерела, яке цитують асистенти ШІ. Спершу виправте індексацію та довіру, захистіть вічнозелений трафік, а потім разом із керівництвом визначте політику щодо ШІ-краулерів і ліцензій. Щоб відстежувати видимість у Google і в ШІ в одному місці, перегляньте тарифи Sorank, з безплатним пробним періодом 3 дні.

Ні. Google знаходить новинні сайти під час звичайного сканування та автоматично розглядає їх для Top Stories, вкладки «Новини» та застосунку Google News, якщо вони публікують якісний контент і дотримуються правил контенту Google News. Publisher Center необов'язковий і допомагає керувати назвою видання, логотипом і розділами.
Це залежить від бізнес-моделі. Блокування навчальних краулерів, таких як GPTBot, захищає контент від використання для навчання моделей, а блокування пошукових краулерів, таких як OAI-SearchBot або PerplexityBot, прибирає сайт з відповідей і цитат цих асистентів. Багато видавців блокують навчальних ботів, дозволяють пошукових і окремо домовляються про ліцензії.
Добре пов'язані статті на усталених новинних сайтах часто скануються та індексуються протягом кількох хвилин, тоді як нові або повільні сайти можуть чекати години чи дні. Посилання на нові матеріали з головної сторінки та сторінок розділів, включення їх до новинної карти сайту та підтримання низького часу відповіді сервера скорочують затримку.
Ми аналізуємо ваших конкурентів, ваш сайт і вашу видимість у ШІ, щоб безкоштовно скласти персоналізований контент-план.
 ШІ-генератор брифів для контенту
 Генератор FAQ-розмітки
 ШІ-генератор ідей для статей у блозі
 Валідатор структурованих даних (валідатор Schema)
 Перевірка alt-тексту
 Аналізатор внутрішніх посилань
 Челендж із зворотних посилань
 ШІ-генератор мета-описів
 ШІ-генератор заголовків для блогу
 Перевірка індексованості в Google
 ШІ-генератор плану статті для блогу
 Конструктор UTM-посилань
 Інструмент кластеризації ключових слів
 Перевірка тегу canonical
 Генератор XML-карти сайту
 Перевірка битих посилань
 ШІ-генератор SEO-заголовків
 Аналізатор заголовків
 Попередній перегляд пошукової видачі
 Перевірка перенаправлень
 Генератор тегів hreflang
 Аналізатор структури заголовків
 Перевірка HTTP-заголовків
 Екстрактор фавіконок
 Калькулятор CTR у видачі
 Калькулятор економії SEO порівняно з платним пошуком
 Калькулятор частки голосу в SEO
 Калькулятор ROI від SEO
 Калькулятор прогнозу трафіку та доходу від SEO
 Калькулятор бюджету SEO
 Калькулятор беззбитковості SEO
 Калькулятор ROI від SEO для SaaS
 Калькулятор ROAS
 Калькулятор часу читання
 Симулятор приросту позицій
 Калькулятор вартості органічного трафіку
 Оцінювач органічного трафіку та перевірка відвідуваності сайту
 Калькулятор співвідношення LTV до CAC
 Калькулятор ROI локального SEO
 Калькулятор вартості лінкбілдингу
 Калькулятор вартості ключового слова
 Калькулятор оцінки можливостей ключових слів
 Калькулятор щільності ключових слів
 Калькулятор ROI GEO
 Калькулятор інвестицій у GEO-контент
 Калькулятор ROI SEO для інтернет-магазину
 Калькулятор пожиттєвої цінності клієнта
 Калькулятор вартості залучення клієнта
 Калькулятор CTR
 Калькулятор вартості статті
 Калькулятор коефіцієнта конверсії
 Калькулятор ROI контент-маркетингу
 Оцінювач реферального трафіку з ChatGPT
 Калькулятор показника відмов
 Калькулятор ROI зворотних посилань
 Калькулятор оцінки видимості у ШІ
 Калькулятор вартості AI-трафіку
 Калькулятор частки голосу в ШІ
 Калькулятор вартості невидимості в ШІ
 Калькулятор частоти цитування в ШІ
 Валідатор llms.txt
 Перевірка AI Overview і позицій в AI Overviews
 Перевірка robots.txt
 SEO-аудит для ШІ
 Перевірка читабельності для LLM
 Перевірка готовності до SearchGPT
 Аудит структурованих даних для LLM
 ШІ-аудит доступності сайту для краулерів
 Чому ChatGPT не рекомендує мій сайт
 Інструмент позицій у Gemini
 Перевірка позицій у Perplexity
 Перевірка цитування в LLM
 Аудит оптимізації для відповідних систем (AEO)
 GEO-аудит
 Тест видимості в ШІ-пошуку
 Перевірка видимості в ChatGPT
 Генератор llms.txt
 Екстрактор URL
 Веб-сторінка в Markdown
 Перевірка карти сайту
 Сенсор волатильності видачі
 Перевірка розміру сторінки
 Лічильник слів
 Генератор слагів
 Генератор Schema
 Генератор Robots
 Попередній перегляд Open Graph
 Генератор мета-тегів
 Компресор зображень
 Генератор фавіконок
 SEO-аудит сторінки: SEO-перевірка та SEO-аналіз
 Інструмент аналізу зворотних посилань
 Інструмент підбору ключових слів
 Перевірка авторитету домену
ВОНИ ПРОБУВАЛИ SORANK ДО ВАС
 “Я протестував Sorank на реальному сайті клієнта, і це неймовірно. Він робить усе, за що агенція виставила б вам рахунок на 1500 доларів на місяць. Тепер його запускають у роботу на цьому клієнті.”

 Guillaume Guersanguersanguillaume.com“Ми рекламна агенція і хотіли раз і назавжди повернути своє SEO в нормальне русло. Sorank дав нам чітке уявлення про наш сайт, допоміг розставити пріоритети оптимізацій і належним чином структурувати наш контент. Інструмент простий у використанні, добре продуманий для команди й дуже зручний для централізованого відстеження без жонглювання кількома платформами. Дуже міцна основа, щоб почати наше SEO з нуля.”
 Gaspard MadouiРекламна агенція
 “Я просто дозволив програмі Sorank повністю робити свою справу, і тепер мій показник DR дорівнює 25, а моя сторінка піднялася вище в пошуку.”
 Lucas Flandrefoundertrace.fr“Я спеціалізувалася на GEO завдяки Sorank. Рейтинг GEO дає змогу показувати клієнтам їхню позицію щодо конкурентів у ChatGPT. Це справжня комерційна перевага.”
 MélanieSEO-фрілансерка“Чудовий сервіс, добре працює для нашого сайту й допомагає зрозуміти, як його покращити, щоб вище ранжуватися в Google та поза ним. Вітаю, так тримати, рекомендую.”
 Hugo T.Власник інтернет-магазину